0%

整理自 MIT OCW 6.004 Computation Structures(Spring 2017)L04 注解幻灯片。

源网页:4.1 Annotated Slides | Combinational Logic

讲师:Chris Terman。图片直接引用 OCW 原站链接。

L04:组合逻辑(Combinational Logic)

本讲介绍如何把功能规格落地为组合逻辑电路:真值表与布尔方程、积之和(sum-of-products)综合、宽门与反相逻辑、布尔化简与卡诺图、MUX / ROM 等实现策略。

1. 功能规格(Functional Specifications)
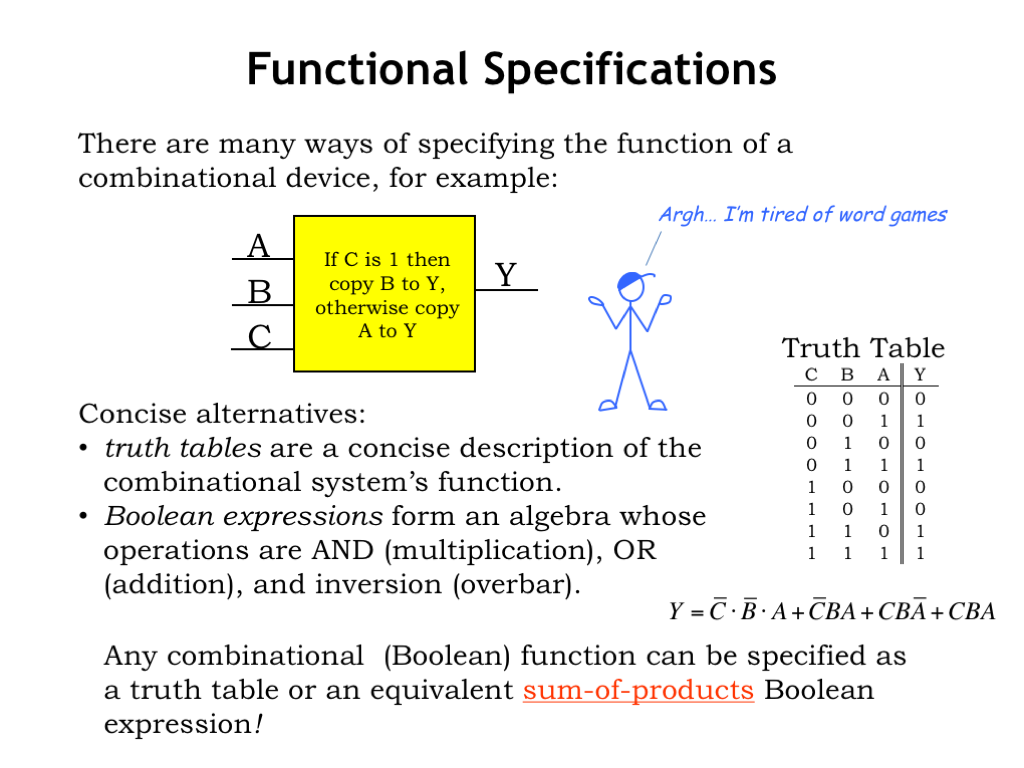
Functional Specifications

功能规格是构建组合逻辑抽象时静态纪律(static discipline)的一部分。可用自然语言描述器件行为:表达紧凑、人人能读,但措辞不严时易有歧义,也难判断是否穷尽所有情况。

更好的替代:

  • 真值表(truth table):对每种数字输入组合明确给出输出。NN 个数字输入 → 2N2^N 行。例:3 输入共 23=82^3=8 行,可系统枚举,不易漏项,输出显式,歧义少。输入很多时不实用——两个 32 位加数共 64 输入,真值表需 2642^{64} 行;若每秒填一行,约需 5840 亿年。
  • 布尔方程(Boolean equation):用 AND、OR、XOR(二元)与 NOT(一元)由输入算输出。0 ↔ FALSE,1 ↔ TRUE。

记号:输入用名字(如 A,B,CA,B,C);NOT 用上划线(如 C‾\overline{C});AND 用乘法(显式点或隐式并置);OR 用 ++。输入多时布尔方程更合适,也易于画成电路图。真值表与布尔方程可互化:代入输入求方程可填表;由真值表可写成积之和(sum-of-products, SOP)。

2. 一种设计路径(Here’s a Design Approach)
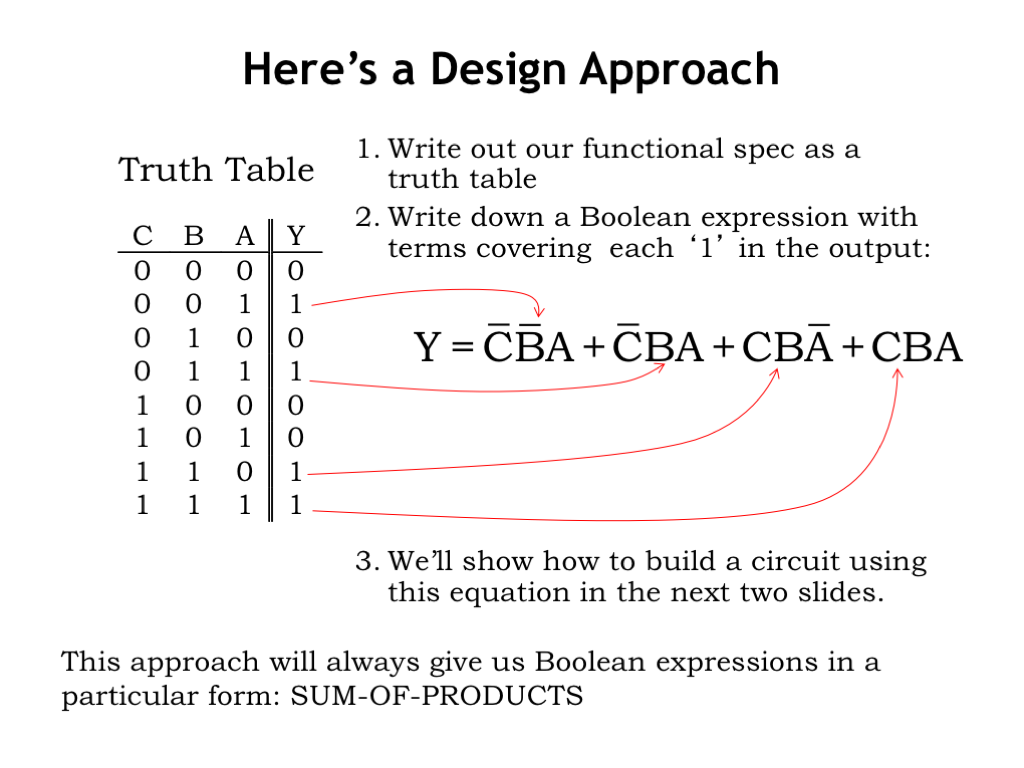
Sum-of-products from truth table

问:“何时 Y=1Y=1?”——即何时 YY 为 TRUE。若第 2、4、7、8 行 Y=1Y=1,则方程是这四项之 OR;每一项是对应该行输入组合的积项。

例:第 2 行 C=0,B=0,A=1C=0,B=0,A=1 → C‾⋅B‾⋅A\overline{C}\cdot\overline{B}\cdot A。第 4 行 → C‾⋅B⋅A\overline{C}\cdot B\cdot A,其余类似。所得恒为积之和:“和”指 OR,“积”指 AND 组。

3. 积之和的积木(Sum-of-products Building Blocks)
Sum-of-products Building Blocks

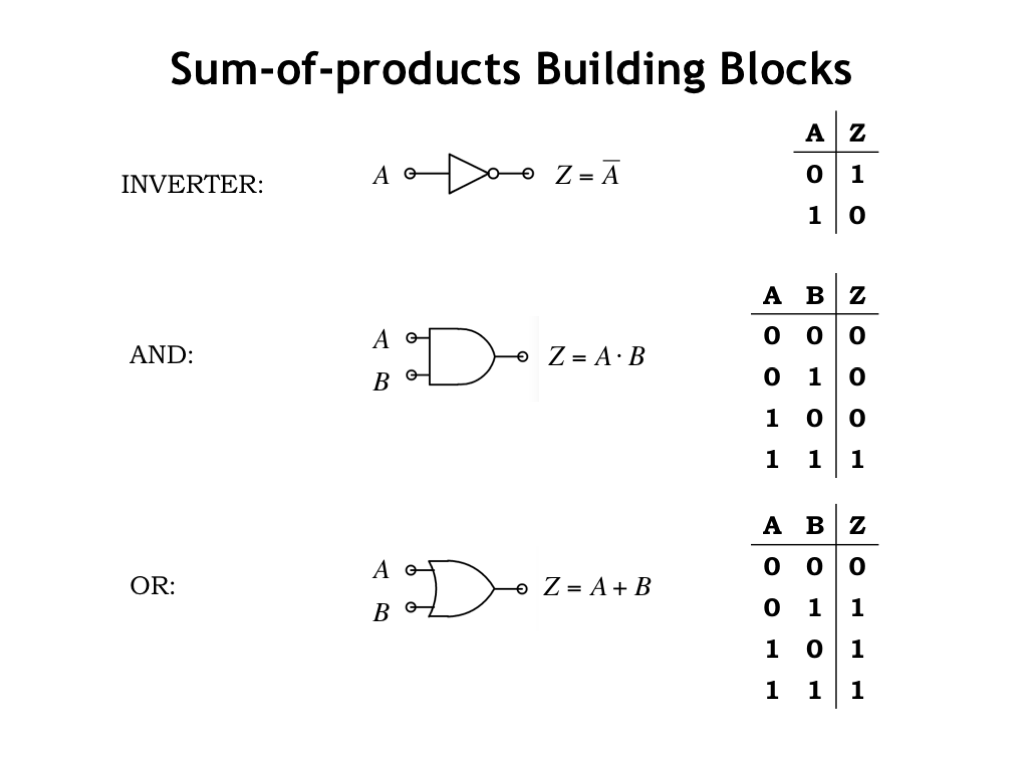
电路库由厂商提供,或自己用 NFET/PFET 做成 CMOS 门:

  • 反相器(inverter):输出小圆表示反相;实现 NOT
  • AND:全为 1 才输出 1;库中常有 3、4 输入等
  • OR:至少一个输入为 1 则输出 1;同样有多输入版本

原理图:AND 输入侧平直,OR 输入侧弯曲。

4. 直接综合(Straightforward Synthesis)
Straightforward Synthesis

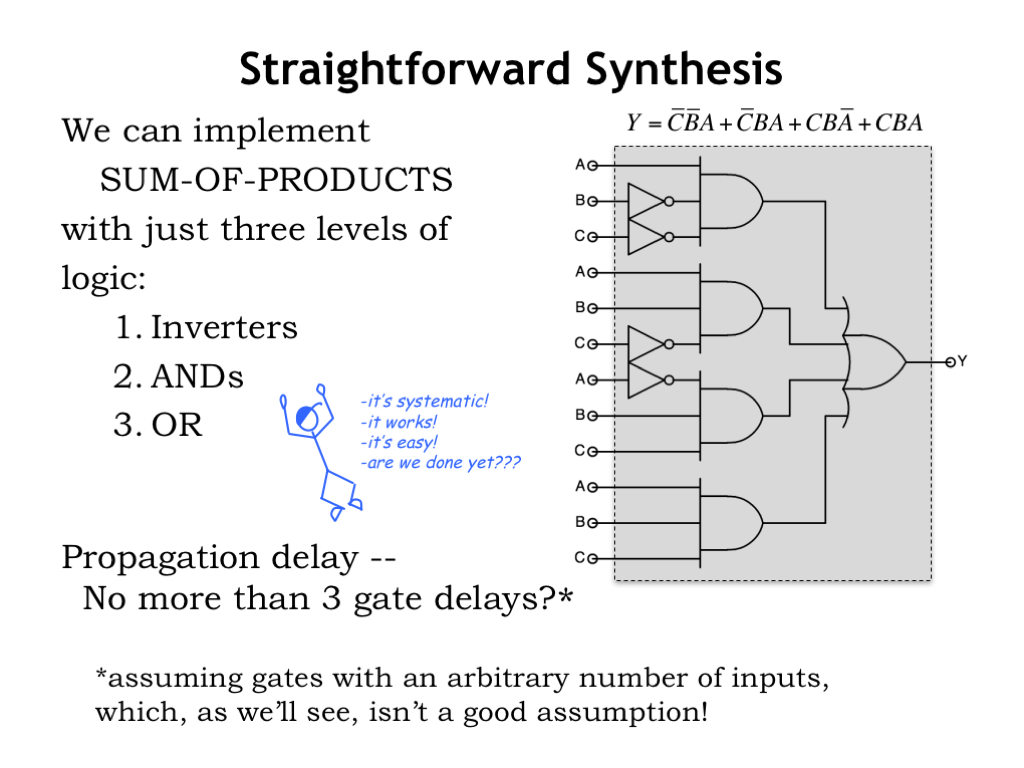
电路结构追随方程:反相器做 NOT(SOP 中常对输入取反;原理图可为每个 NOT 单独画反相器,实作可共享 C‾\overline{C} 等信号);每个积项用多输入 AND;再用多输入 OR 合并。典型层次:反相器层 → AND 层 → OR。

传播延迟 tPDt_{\mathrm{PD}} 看似短(最长路径约反相器 + AND + OR),但宽 AND/OR 往往要多层门拼出,会增加延迟。至此已有:真值表 → SOP 方程 → 门电路。

5. 多于 2 输入的 AND / OR(ANDs and ORs with > 2 Inputs)
Wide AND and OR from 2-input gates

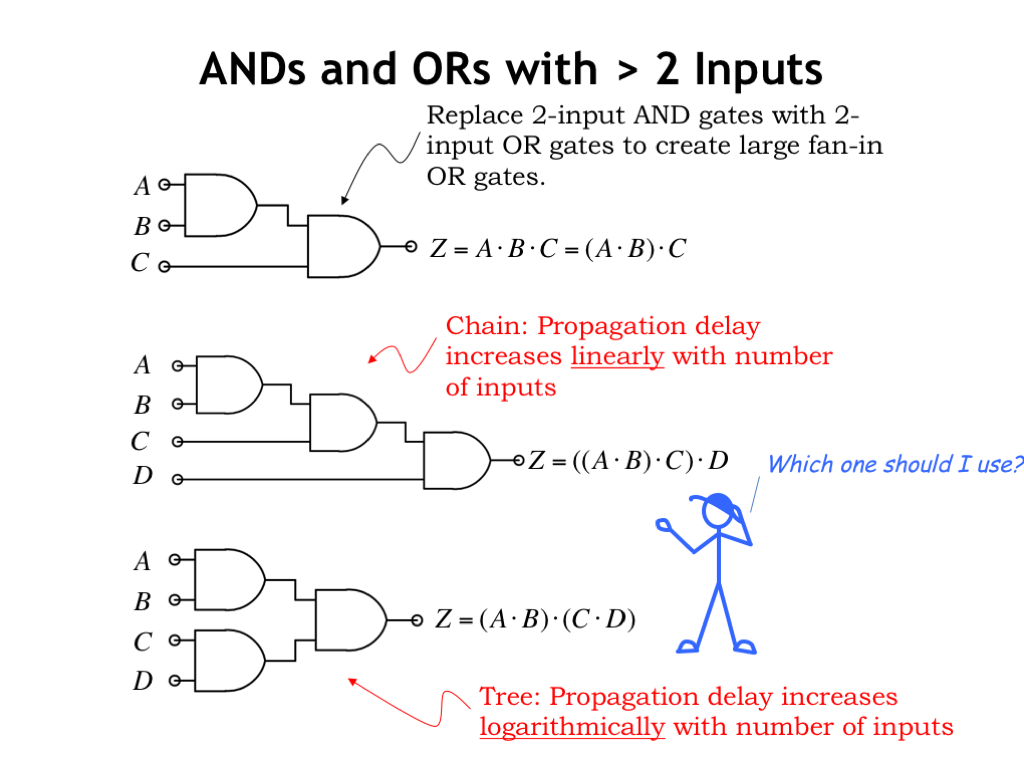
假设库只有 2 输入门。AND 满足结合律,可用两两 AND 任意顺序做 NN 路 AND;OR、XOR 同理。

  • 链(chain):NN 输入需 N−1N-1 个 2 输入门;tPDt_{\mathrm{PD}} 约 N−1N-1 级,随 NN 线性增长
  • 树(tree):先并行再合并;tPDt_{\mathrm{PD}} 约 log⁡2N\log_2 N 级,NN 大时明显更快

成本(门数)两者相同。若各输入到达时间不同(如前级 tPDt_{\mathrm{PD}} 不同),晚到输入经树可能还要多级,经链可能只多一级——子电路哪种最优,取决于输入何时到达。

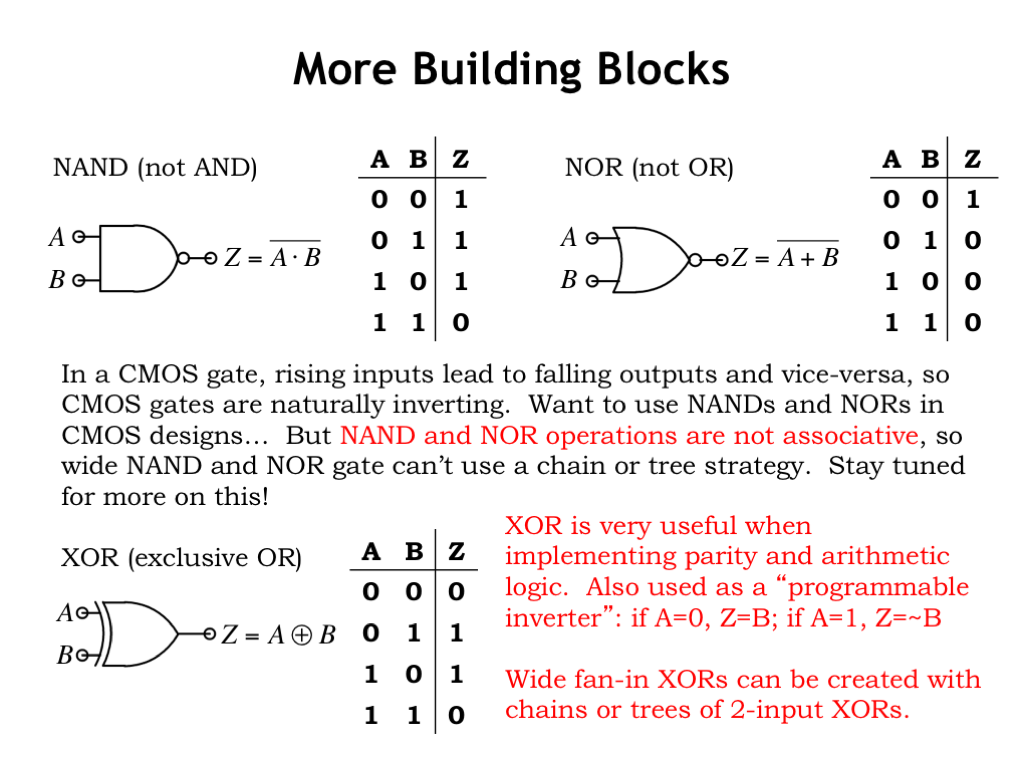
CMOS 中单级门天然反相,高性能更倾向 NAND/NOR(单级 CMOS);AND/OR 常要两级(如 NAND+反相器)。NAND、NOR 不结合:NAND(A,B,C)≠NAND(NAND(A,B),C)\mathrm{NAND}(A,B,C)\neq\mathrm{NAND}(\mathrm{NAND}(A,B),C),不能简单用 2 输入 NAND 树拼宽 NAND。

6. 更多积木(More Building Blocks)
XOR and related building blocks

异或(XOR)在算术、奇偶校验中很有用;Lab 2 会看到 2 输入 XOR 比 2 输入 NAND/NOR 消耗更多 NFET/PFET。任意真值表都可写成 SOP,再用 INVERTER、AND、OR 实现。

7. 万能积木(Universal Building Blocks)
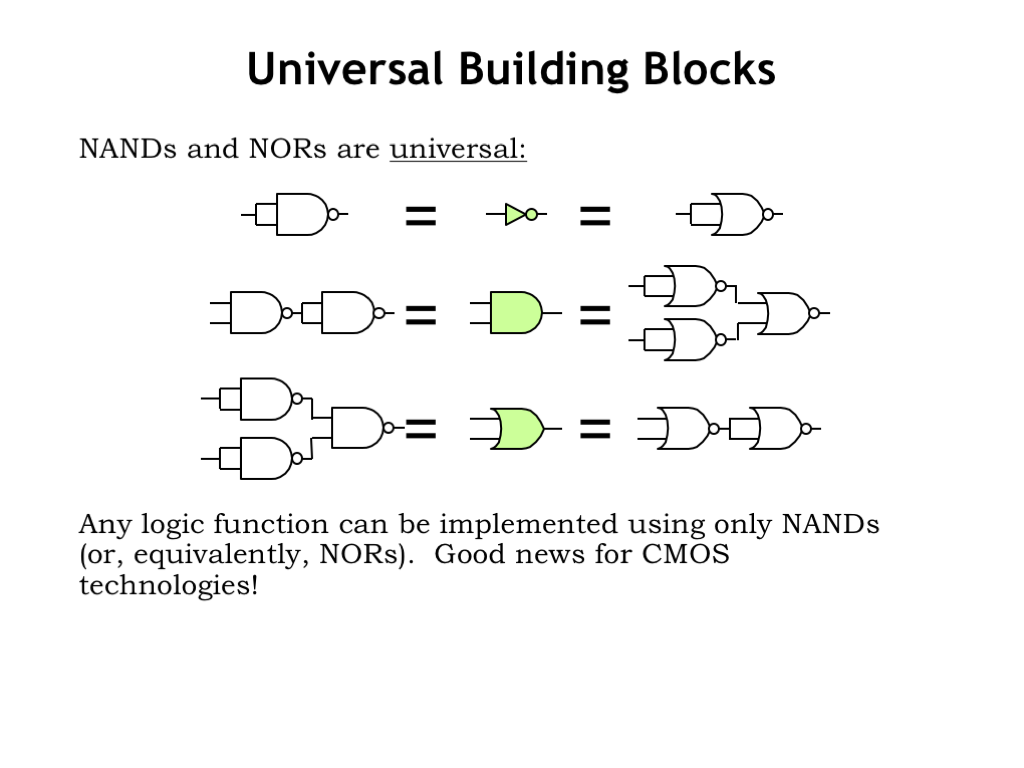
Universal Building Blocks

仅用 2 输入 NAND 即可实现任意功能——称其为万能门(universal gate)。SOP 的各积木都有 NAND-only 等价电路;2 输入 NOR 同样万能。反相逻辑初看别扭,却是 CMOS 低成本、高性能的关键。

8. CMOS 偏爱反相逻辑(CMOS Loves Inverting Logic)
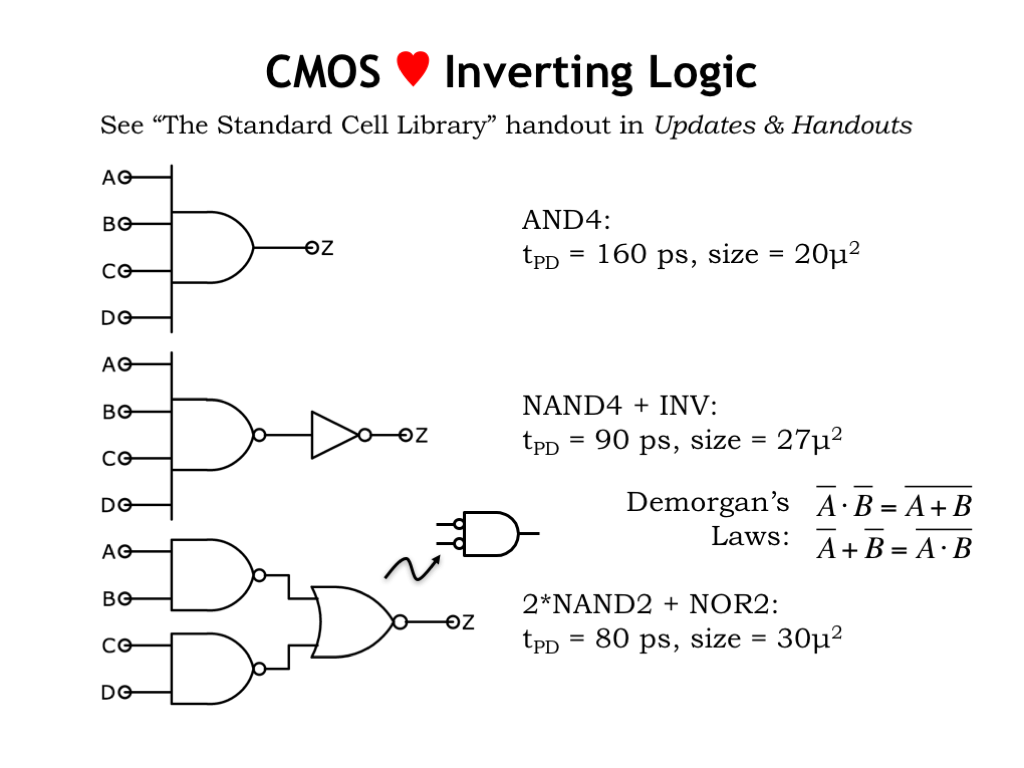
CMOS Loves Inverting Logic

库中既有反相门(反相器、NAND、NOR),也有非反相门(缓冲器、AND、OR)。对比 4 输入 AND 的三种实现(数值以库文档为例,重在相对比较):

实现 约 tPDt_{\mathrm{PD}} 约面积
库中 4 输入 AND 160 ps 20 µm²
4 输入 NAND + 反相器 90 ps 稍大
2 输入门树(NAND + NOR) 再省约 10 ps 再大一点

非反相门常做成小而慢(MOSFET 更窄);反相门做成快。整电路 tPDt_{\mathrm{PD}} 由最长路径决定:非关键路径可用更小更慢的门省面积。底层树电路还用到 DeMorgan 定律:A+B‾=A‾⋅B‾\overline{A+B}=\overline{A}\cdot\overline{B} 等,可把 NOR 看成带反相输入的 AND,使第一层反相输出与第二层反相输入“对消”,等价于 AND 树。

9. 宽 NAND / NOR(Wide NANDs and NORs)
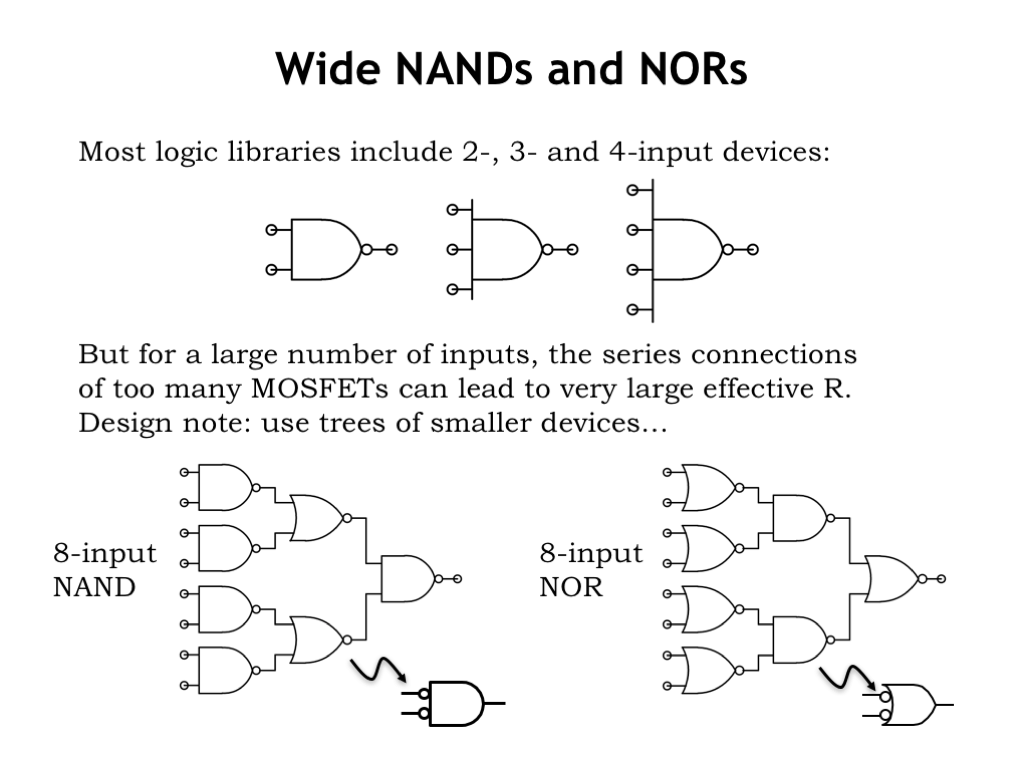
Wide NANDs and NORs

库中反相门通常做到约 4 输入:4 输入 NAND 的下拉链有 4 个串联 NFET,电阻累加;加宽管子又增大面积与输入电容。尺寸–速度权衡迅速变复杂,故库常止于 4 输入,更宽由设计者用 DeMorgan:交替 NAND/NOR 树拼 8 输入 NAND、NOR 等。中间层 NOR 可视为带反相输入的 AND,整体像带反相输出的 AND 树;中间层 NAND 则对应 OR 树。

10. CMOS 积之和实现(CMOS Sum-of-products Implementation)
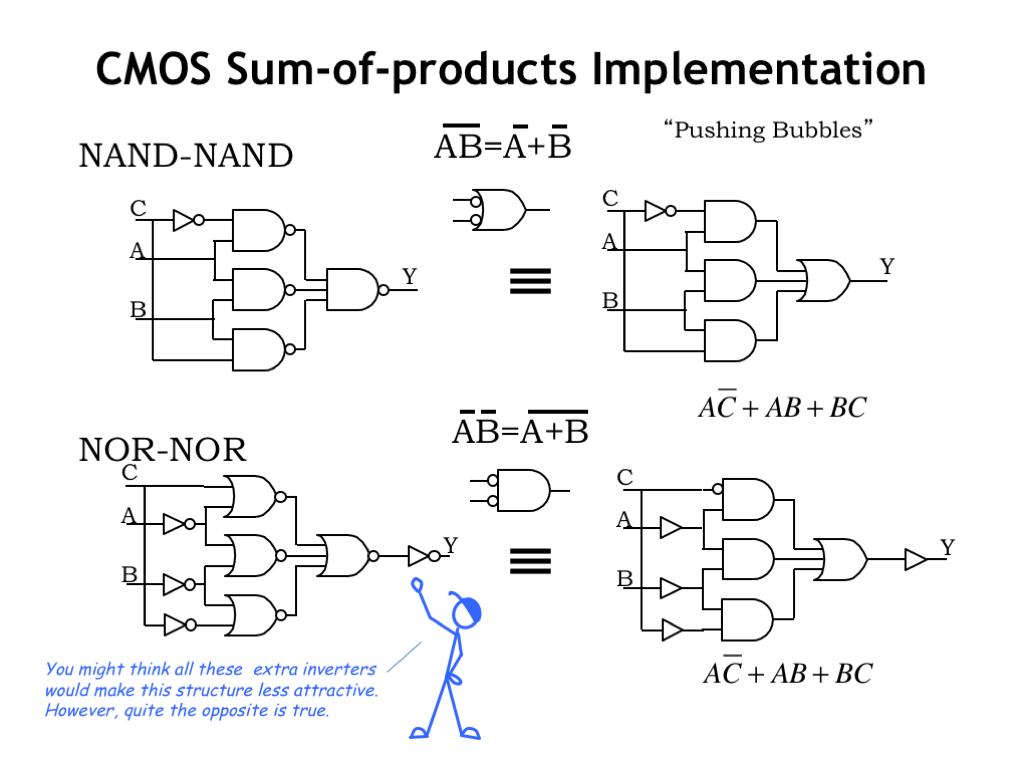
CMOS Sum-of-products Implementation

同一 SOP 可用两层 NAND 或两层 NOR 实现。对输出侧 NAND 用 DeMorgan 变成“带反相输入的 OR”,再与第一层反相输出对消气泡,即得:反相器层 + AND 层 + OR。NOR/NOR 同理。

NOR/NOR 往往更多反相器;但可能减轻输入负载(例:NAND/NAND 中 AA 接 4 个 MOSFET,NOR/NOR 中 AA 只经反相器接 2 个)。需要快的 AND/OR 型 SOP 时,优先试 NAND/NAND,通常比 AND/OR 明显更快。

11. 逻辑化简(Logic Simplification)
Logic Simplification

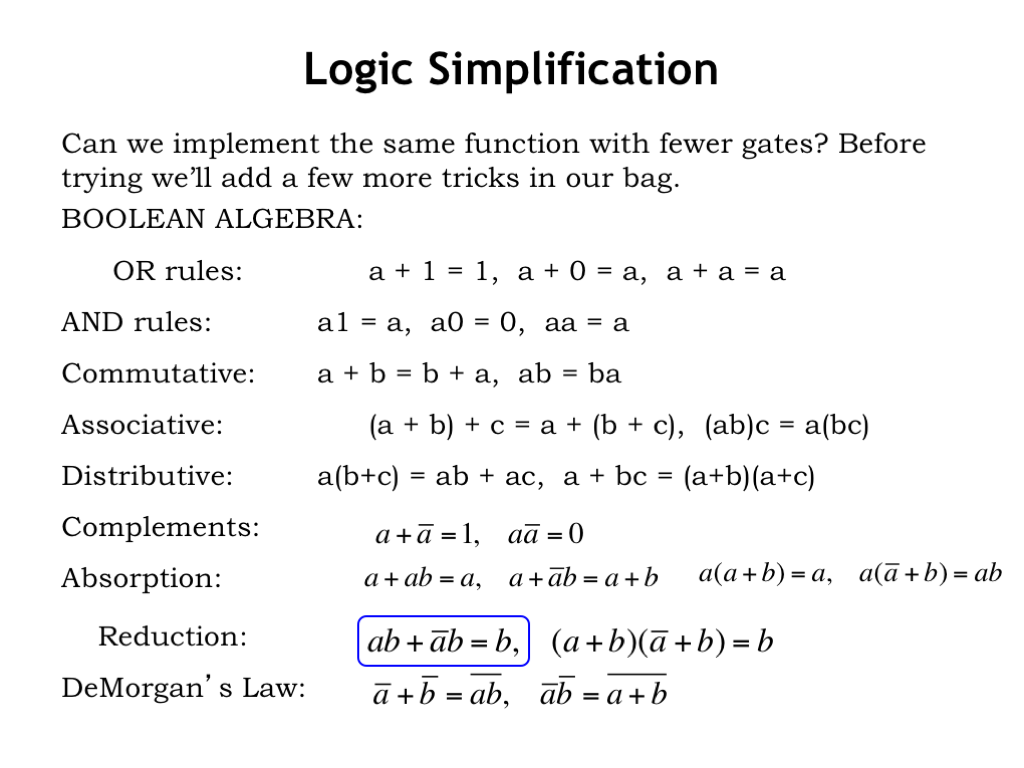
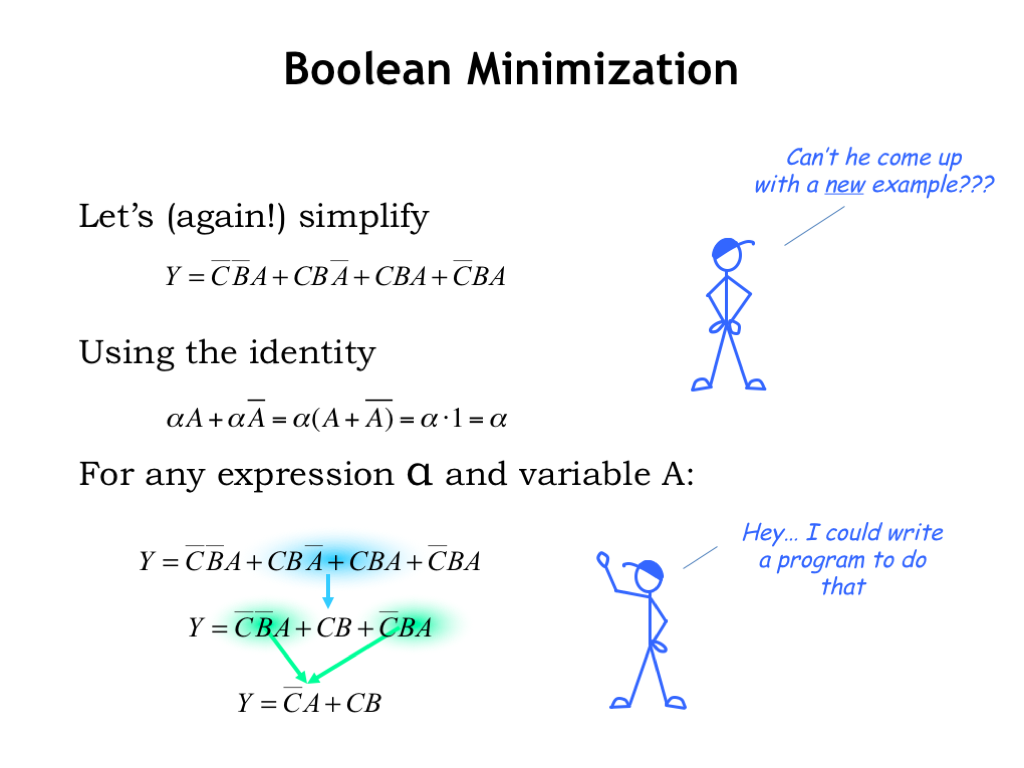
能否用更少/更小的门实现同一功能?布尔恒等式可变换表达式。归约恒等式(reduction identity)等可把含两变量、多次运算的式子压成更简单形式。例:四积项方程中,中间两项令 α=C⋅B\alpha=C\cdot B,消去 AA;再对另两项令 α=C‾⋅A\alpha=\overline{C}\cdot A 继续归约——运算次数可从约 14 降到约 4,电路更便宜、tPDt_{\mathrm{PD}} 更小。手工化简繁琐易错,实际多用程序;最优形式搜索随输入数超指数增长,大方程靠启发式,结果很好但不一定最优。

12. 布尔最小化(Boolean Minimization)
Boolean Minimization

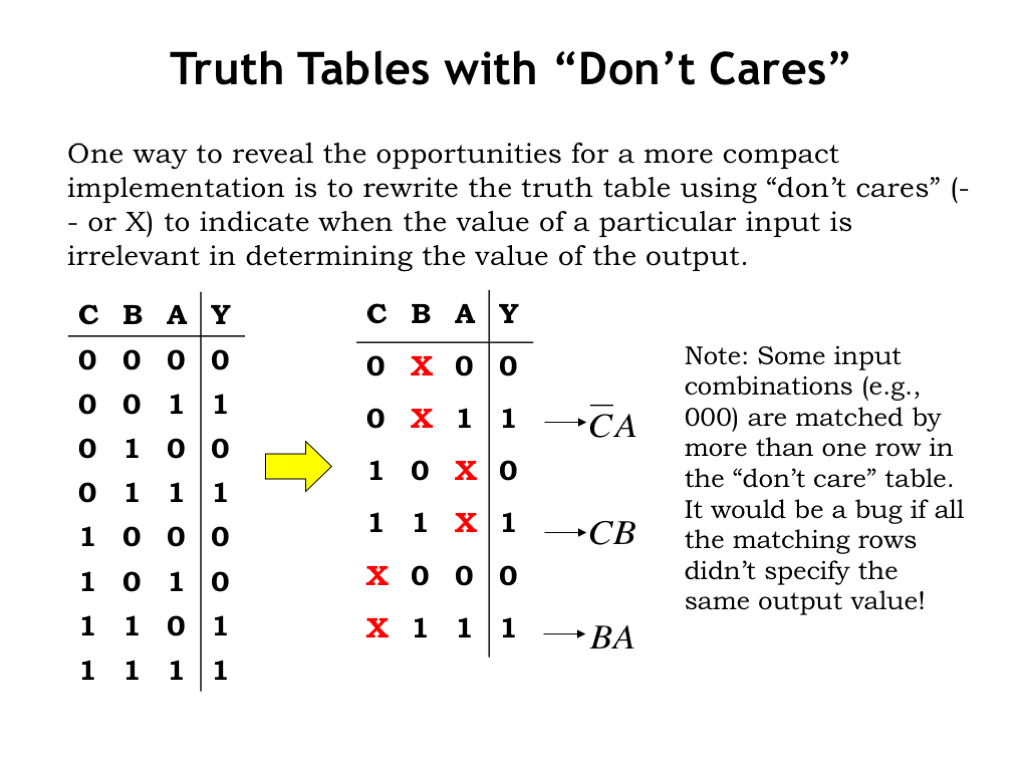
另一种思路:在真值表中找无关(don’t-care)情形。例如原表第 1、3 行:A=0A=0、C=0C=0、Y=0Y=0,仅 BB 不同 → 当 A,CA,C 皆 0 时 BB 无关,在压缩表中把该行的 BB 记为 XX。比较 YY 相同的行,可继续找出其他 don’t-care。

13. 带无关项的真值表(Truth Tables with Don’t Cares)
Truth Tables with Don't Cares

带 don’t-care 的表中,Y=1Y=1 的行往往更少。有的行冗余:例如某行匹配的输入组合(如 011 与 111)已被其他行覆盖。由第 2、4 行导出的积项,正是用归约恒等式得到的那些积项——几何/表格视角与代数归约殊途同归。

14. 为何不一定用最小 SOP(The Case for a Non-minimal SOP)
Glitches and non-minimal SOP

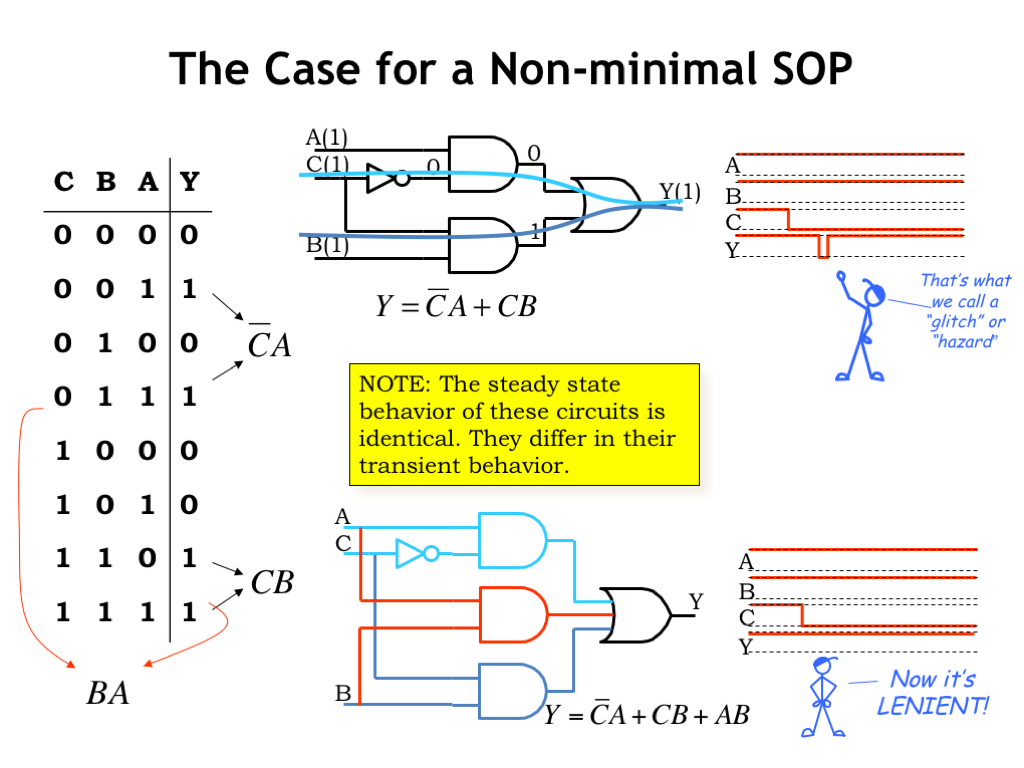
最小电路是否总最好?看 A=1,B=1A=1,B=1、CC 从 1→0:原先由下 AND 维持 Y=1Y=1,过渡后上 AND 经反相器延迟才打开,中间可能两 AND 都关,YY 短暂变 0——即 毛刺(glitch),传播会耗电。若保留第三积项 BABA,则 A,BA,B 同高时 YY 与 CC 无关,CC 翻转不引起 YY 毛刺。上一章称此类电路为宽容的(lenient)。

15. 卡诺图:几何方法(Karnaugh Maps)
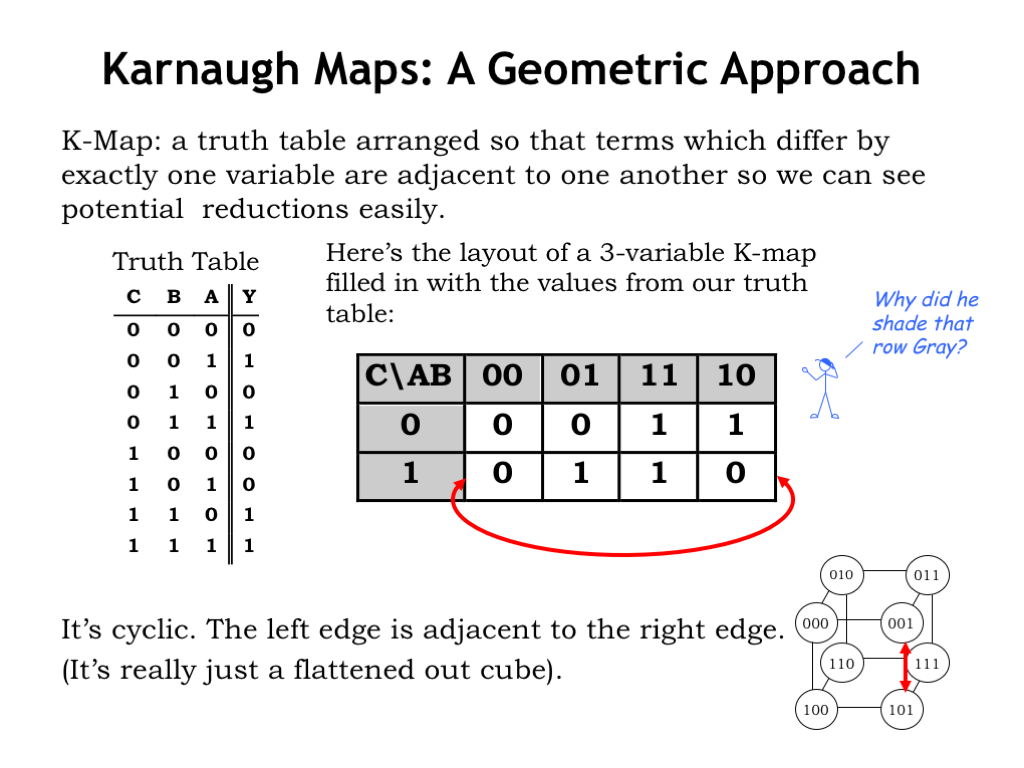
Karnaugh Maps

最小化时要找可合并的相邻积项。卡诺图(Karnaugh map, K-map)把真值表排成二维:行/列用输入取值标记,格内为输出。列序用 Gray 码:相邻标签恰差一位;左右列也视为相邻(想成圆柱)。立方体上相邻的 3 位输入,在表中也相邻。

16. 扩展到 4 变量(Extending K-maps to 4-variable Tables)
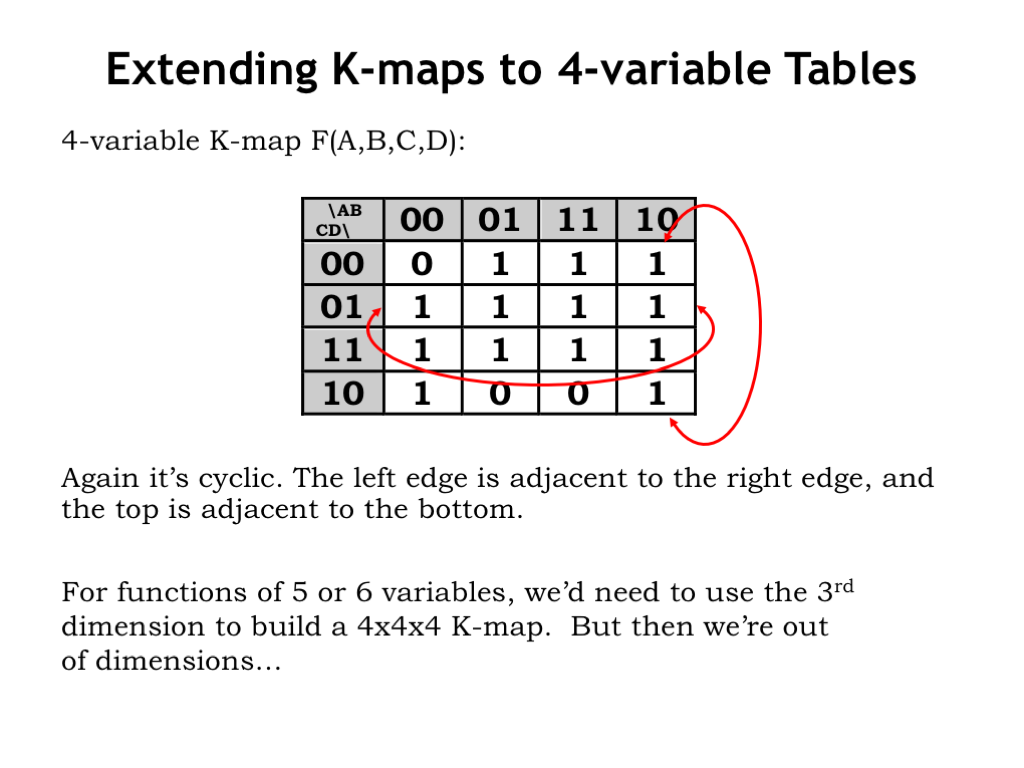
4-variable K-maps

4 变量:行、列皆 Gray 码;左右列、上下行相邻。6 变量需 4×4×44\times4\times4 三维,难画;更多维更不现实。实践上 K-map 适合 ≤4 变量;思想可推广到更高维(计算机处理)。

17. 寻找蕴涵项(Finding Implicants)
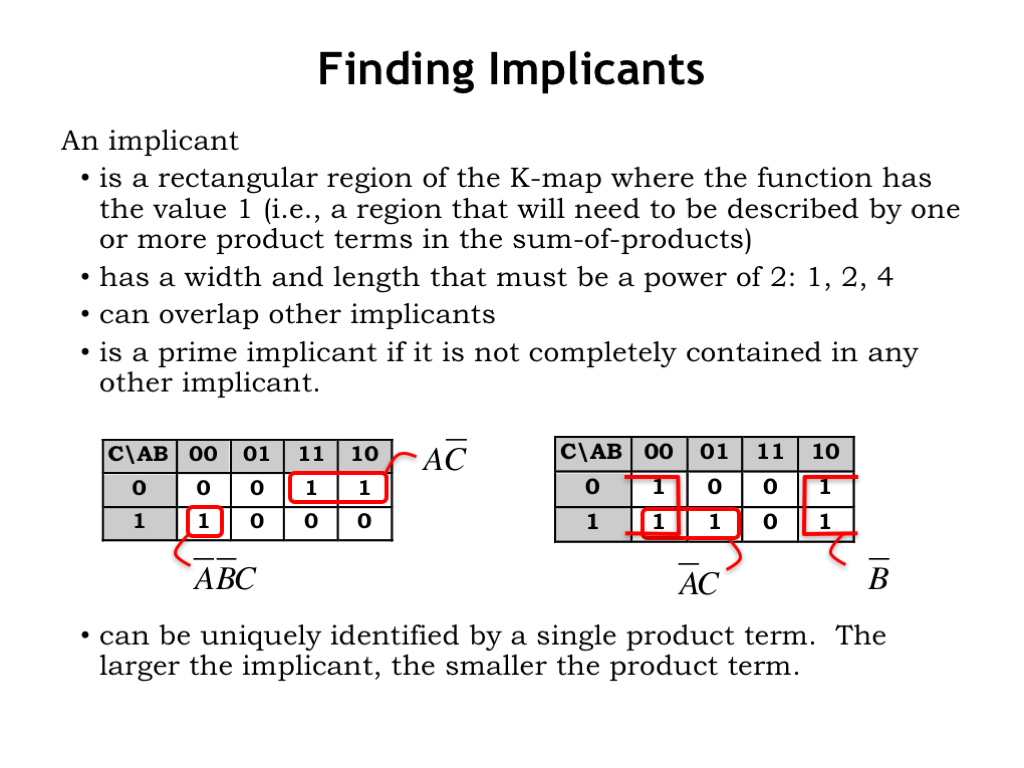
Finding Implicants

蕴涵项(implicant):K-map 中全为 1 的矩形区域;宽、高须为 2 的幂(1、2 或 4)。可重叠。素蕴涵项(prime implicant):不被任何更大蕴涵项完全包含。最终最小 SOP 的每个积项对应某个素蕴涵项。

18. 寻找素蕴涵项(Finding Prime Implicants)
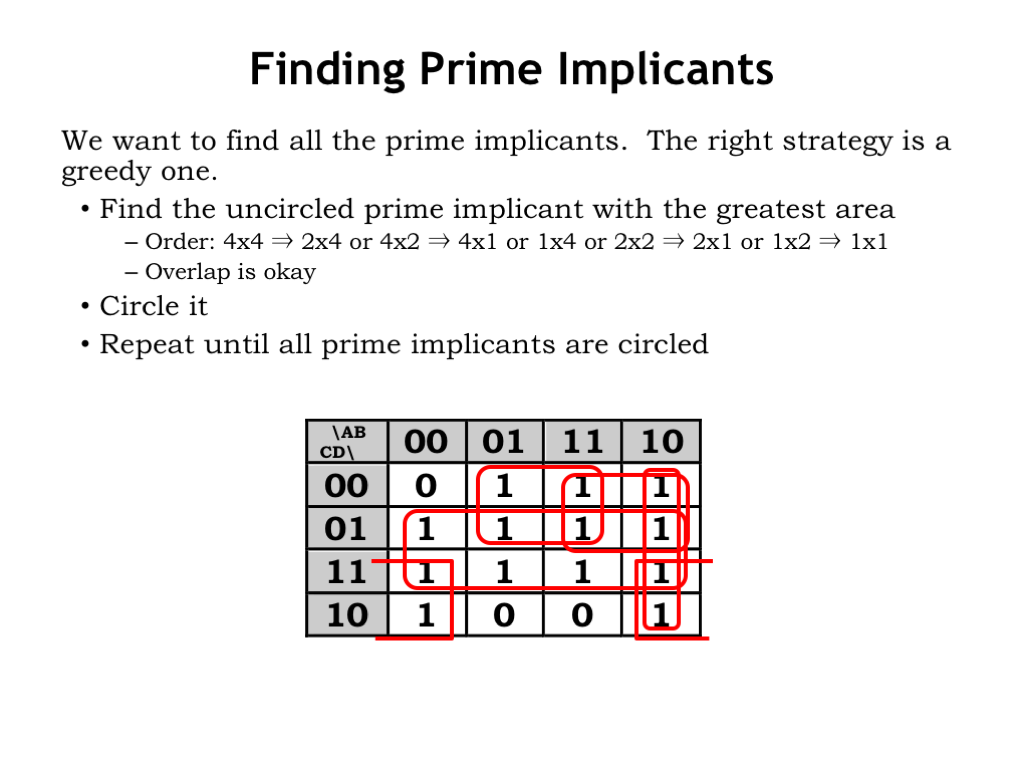
Finding Prime Implicants

例:孤立的 1 → 1×11\times1;右上相邻两个 1 → 1×21\times2。记得左右列相邻,可得到 2×22\times2 等。对未圈住的 1,应找包含它的最大合法蕴涵项——更大素蕴涵项对应更短积项。

19. 写出方程(Write Down Equations)
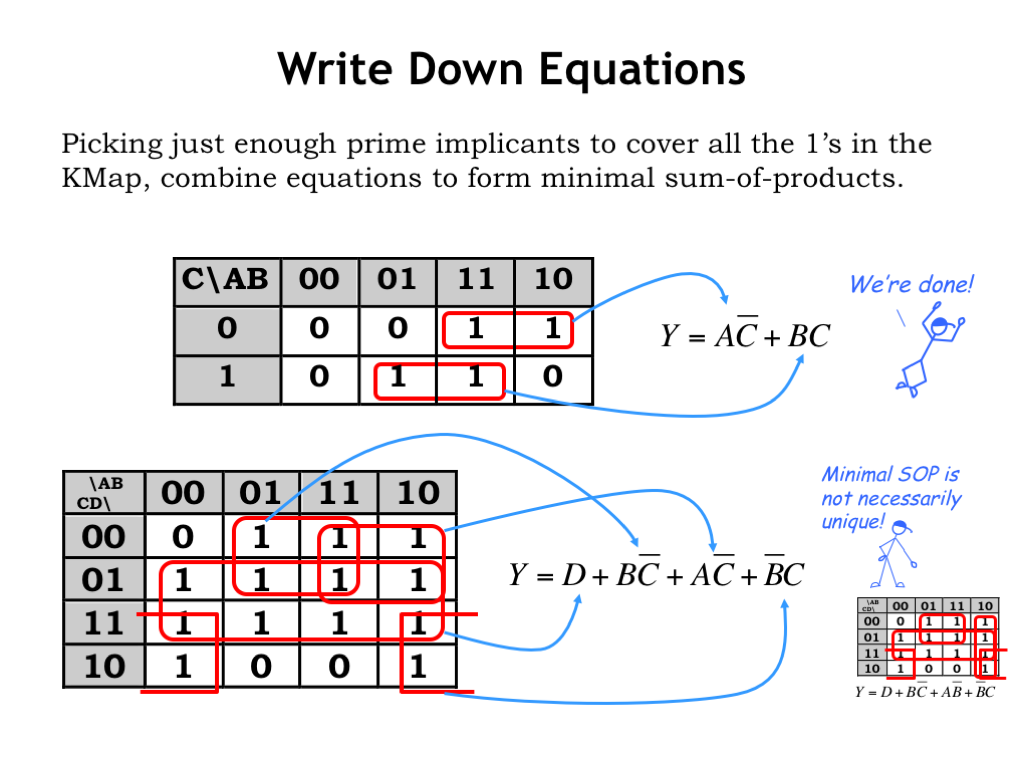
Write Down Equations

每个蕴涵项对应一个积项:只对在区域内保持不变的输入写文字。例:A=0,B=0,C=1A=0,B=0,C=1 的单格 → A‾⋅B‾⋅C\overline{A}\cdot\overline{B}\cdot C;1×21\times2 且 C=0,A=1C=0,A=1 不变 → A⋅C‾A\cdot\overline{C}。素蕴涵项越大,积项越短。

做法:找未圈 1 → 圈包含它的最大合法矩形 → 重复,直至覆盖所有 1;再只保留覆盖所需的素蕴涵项,写出 SOP。最小 SOP 不必唯一(不同素蕴涵项组合可等价),运算次数通常相同。≤4 变量时,K-map 比手搓恒等式更快、更不易错。

20. 素蕴涵项、毛刺与宽容性(Prime Implicants, Glitches & Leniency)
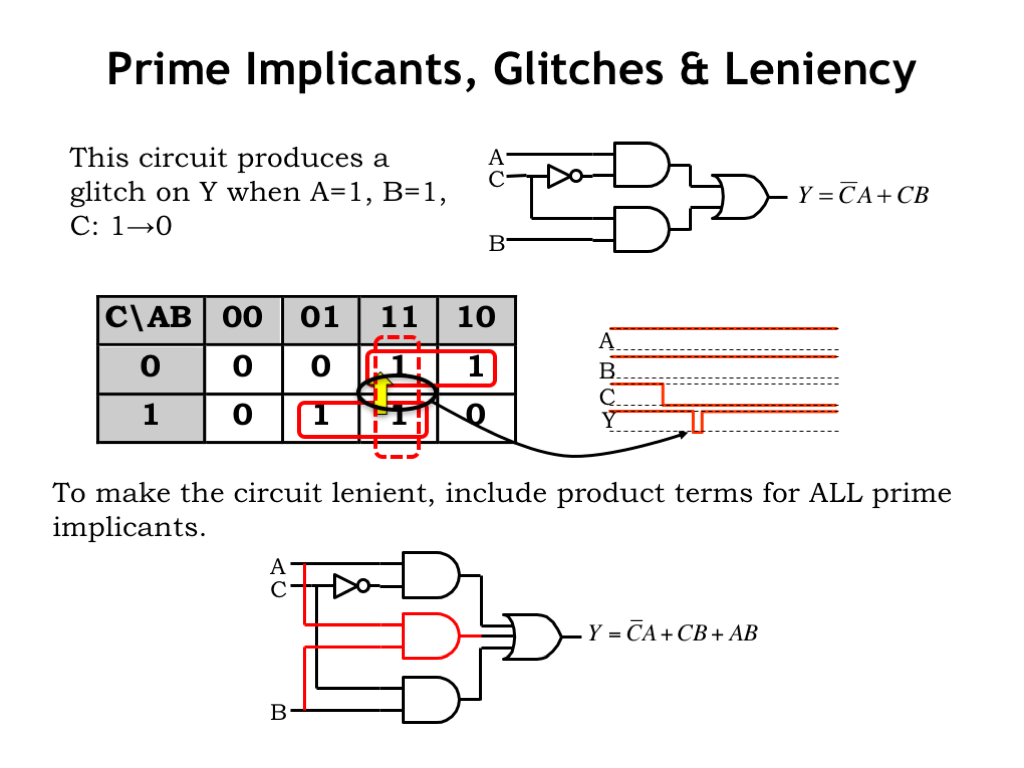
Prime Implicants Glitches Leniency

K-map 上也可见毛刺:从一蕴涵项跳到另一蕴涵项、中间有“缝”,输出可能毛刺。补上覆盖该过渡的素蕴涵项(哪怕功能上冗余),可堵住缝隙。要宽容:把所有素蕴涵项都写进 SOP。

21. 其实在设计多路选择器(We’ve Been Designing a MUX)
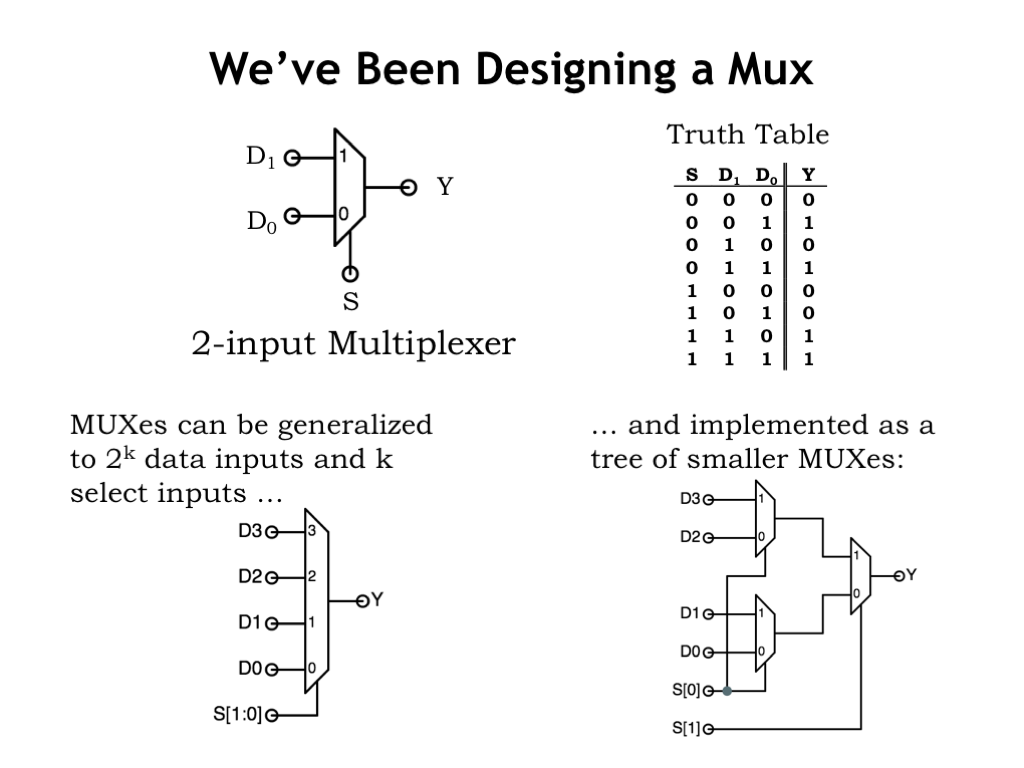
Multiplexer

示例真值表描述的是 2 选 1 多路选择器(multiplexer, MUX):选择端 S=0S=0 时 Y=D0Y=D_0,S=1S=1 时 Y=D1Y=D_1。KK 个选择端 → 在 2K2^K 个数据输入中选一;大 MUX 可用 2 选 1 树搭建。

22. 系统实现策略(Systematic Implementation Strategies)
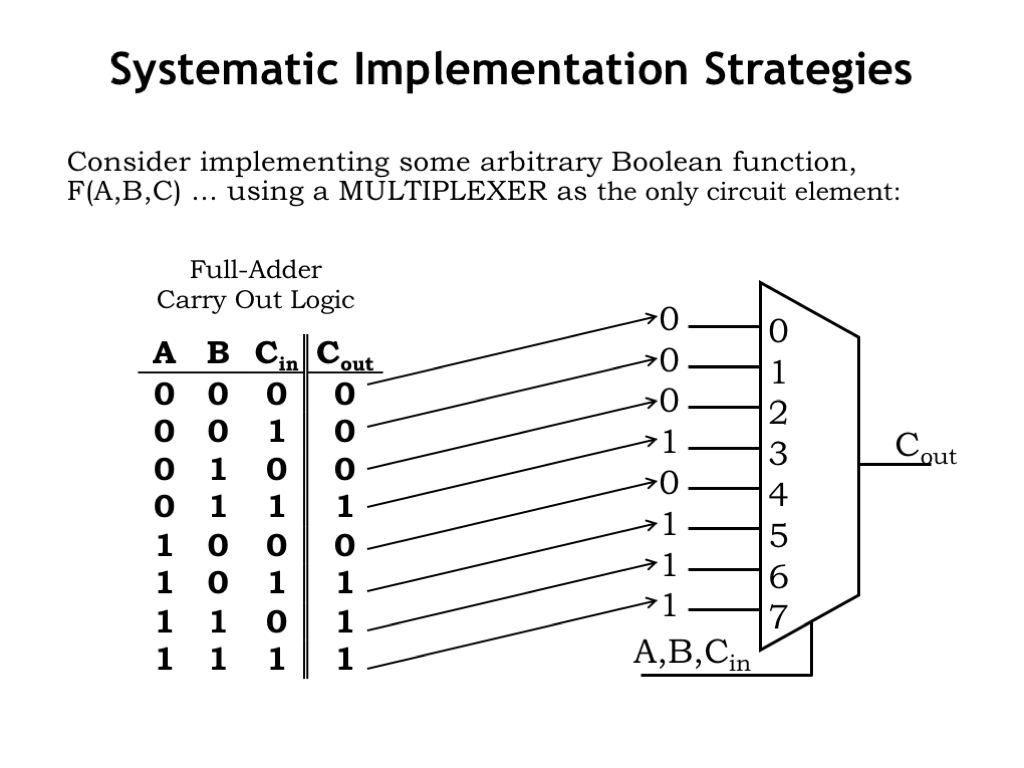
MUX as systematic implementation

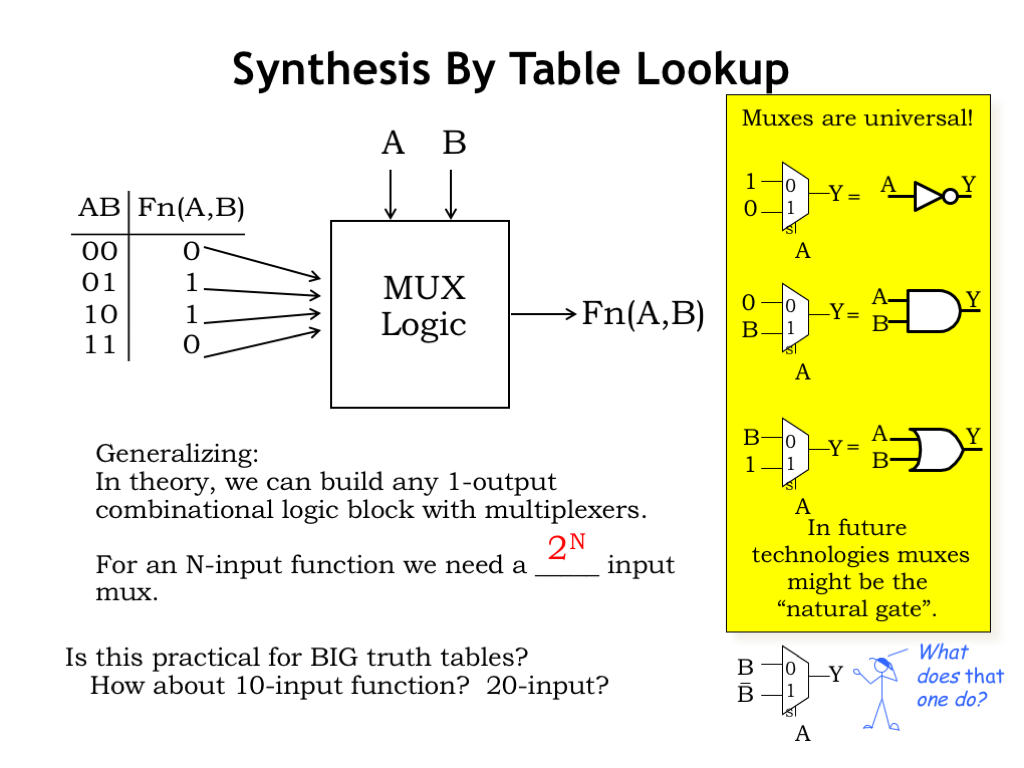
MUX 是实现逻辑的优雅通法:把函数输入接到选择端,把真值表输出列接到数据端常量。改功能只需改常量,不必重设计复杂 SOP。这是可编程逻辑的思路——制造后由用户配置功能;现代器件可替代数百万门,利于原型。NN 选择端 MUX 可代替任意 NN 输入逻辑,但数据端 2N2^N 个,NN 很大时面积爆炸;实用约到 5–6。MUX 也是万能的;分子尺度逻辑中或许更自然。XOR 用单个 2 选 1 MUX 即可。

23. 查表综合(Synthesis By Table Lookup)
Synthesis By Table Lookup

(承上)MUX 本质是可编程查表;适合少输出列。多输出、同输入集合时,更适合下一节的 ROM——有限状态机中很常见。

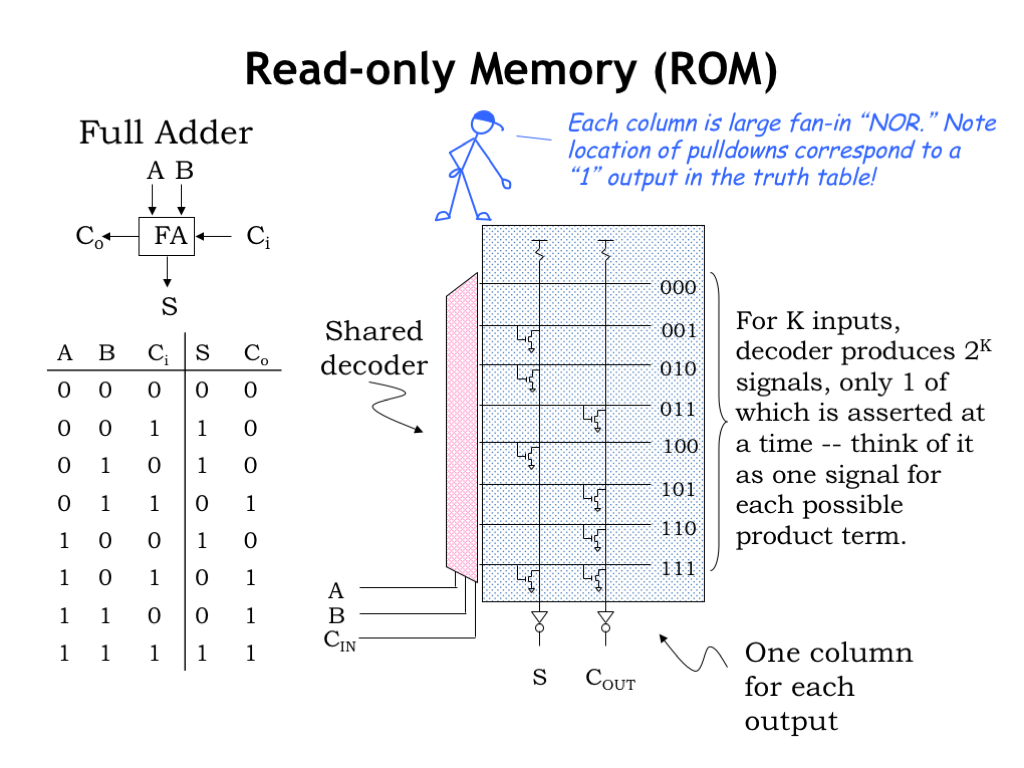
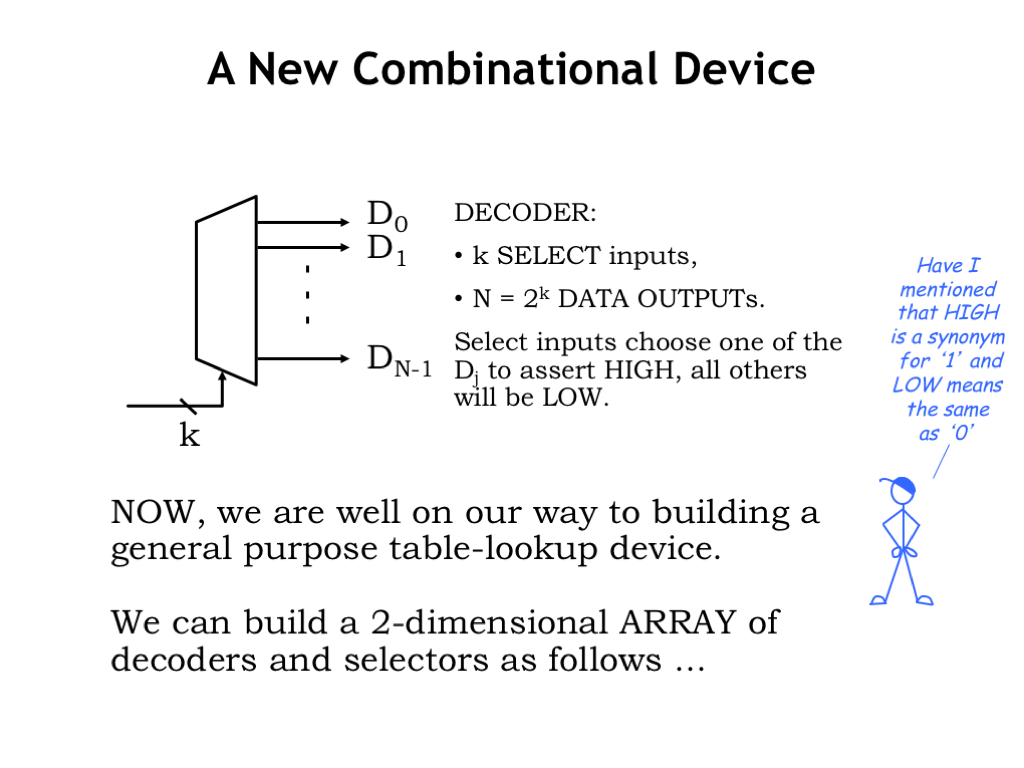
24. 只读存储器(Read-only Memory, ROM)
Read-only Memory

ROM 核心之一是译码器(decoder):KK 个选择端、2K2^K 个数据输出;任意时刻恰有一个输出为 1,由选择端的二进制值决定第 JJ 路。

25. ROM 示例(ROM Example)

ROM Example

以 2 输出真值表(如全加器)为例:A,B,CIA,B,CI 接 3-to-8 译码器选择端;8 条水平线对应各输入组合。竖直列为各输出;NFET 下拉开关矩阵:某开关导通则该列被拉到地(LOW);若无下拉则为 HIGH;再经反相得最终输出。某输入组合使唯一译码输出 HIGH → 打开该行开关 → 写出该行输出。改开关位置即可编程任意 3 入 2 出函数。

26. ROM 示例(续)(ROM Example continued)
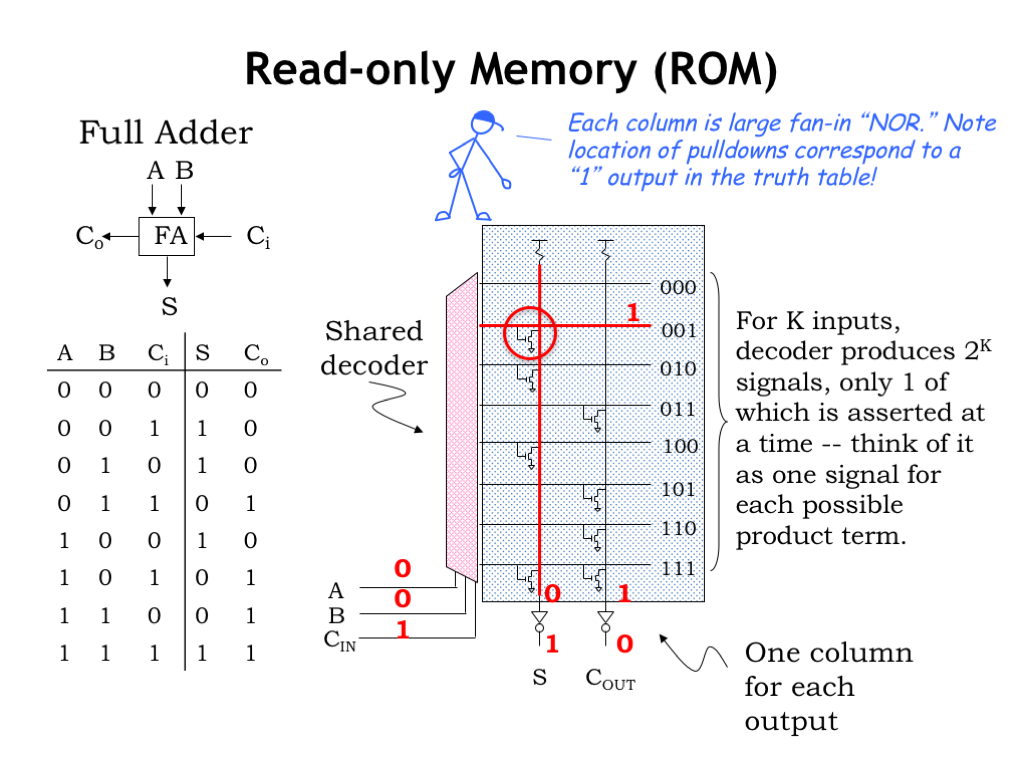
ROM Example continued

例:输入 001 时,标为 001 的译码线 HIGH,拉低 SS 列而不拉 COUTC_{\mathrm{OUT}},经输出反相后得 S=1S=1、COUT=0C_{\mathrm{OUT}}=0。

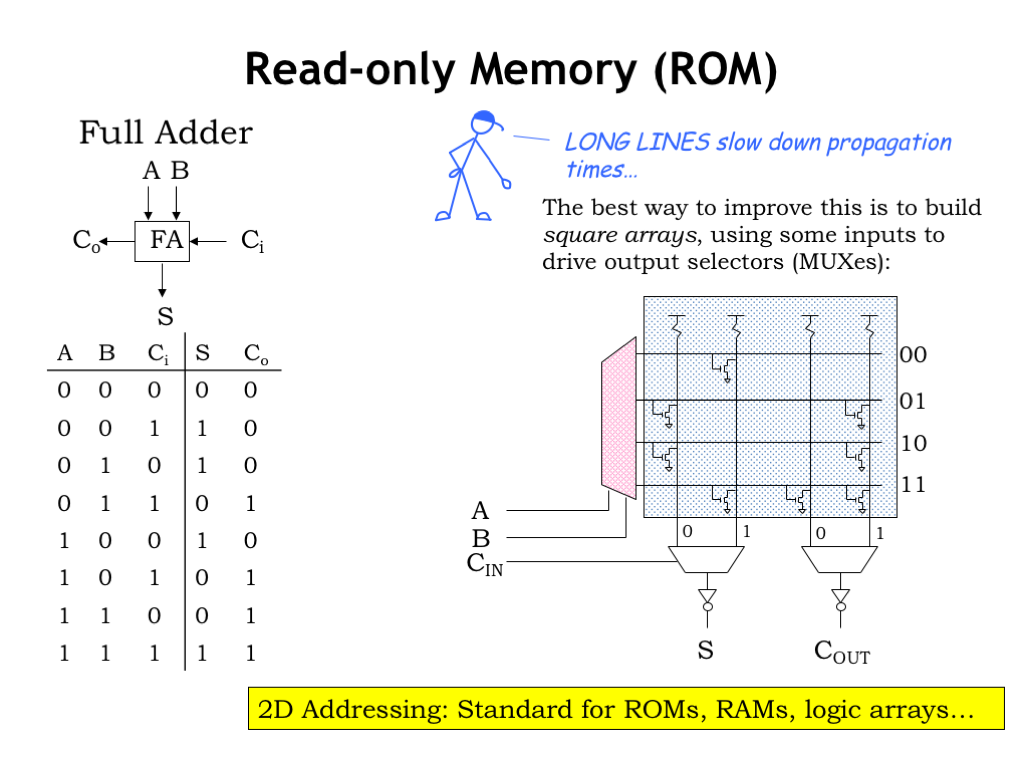
27. 更快的 ROM(Faster ROMs)

Faster ROMs

输入很多时,译码输出多、竖直列很长很慢。可把部分输入给译码器,其余输入用 MUX 在多段较短较快的竖直列之间选择——小译码器 + 输出 MUX 是常见做法。

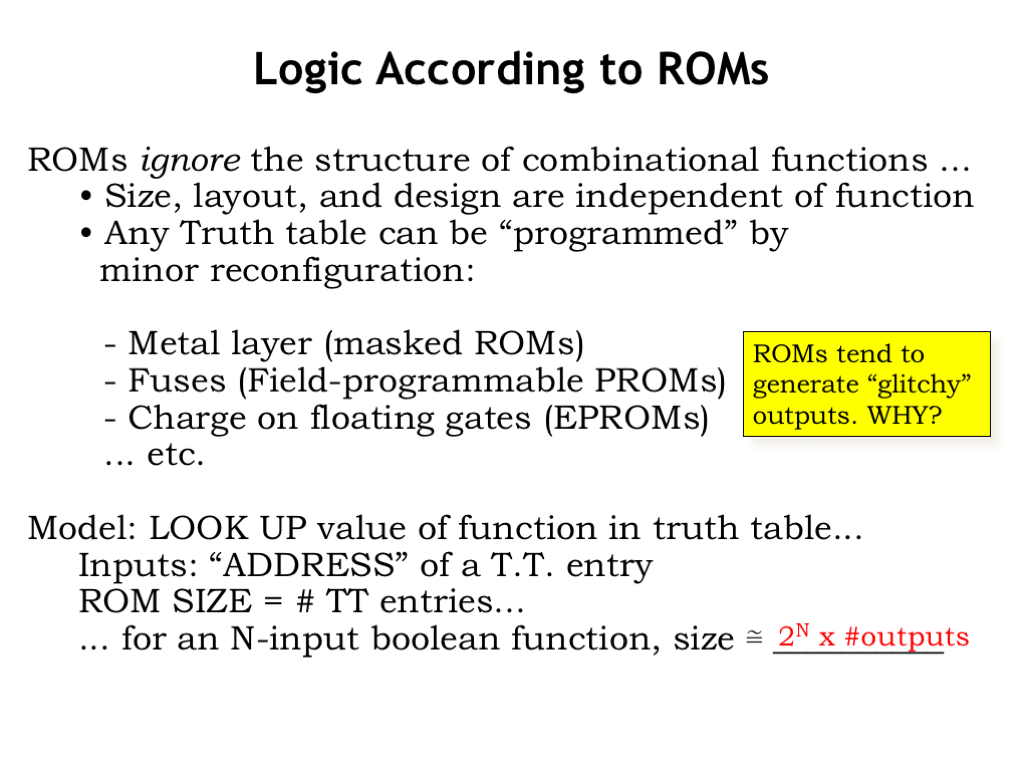
28. 从 ROM 看逻辑(Logic According to ROMs)
Logic According to ROMs

ROM 策略基本不看布尔结构:规模由输入/输出个数决定。开关矩阵常全填充,再物理/电气编程决定哪些受控、哪些永久关断。NN 入 MM 出 → 矩阵约 2N2^N 行、MM 列,与真值表同阶。输入变化时译码线翻转时序略有差异,输出可能多次抖动才稳定——ROM 不宽容,可能有毛刺。

29. 小结(Summary)
Summary
策略 特点
积之和 + 反相逻辑 按具体函数定制;可做得又快又小;适合高性能或大批量
MUX / ROM 结构大体与具体函数无关;功能靠后续编程;适合原型、小批量、或出厂后需更新功能

本讲是组合逻辑实现技术的速览:从规格到 SOP,再到化简、K-map、MUX 与 ROM。
整理自 MIT OCW 6.004 Computation Structures(Spring 2017)L03 注解幻灯片。

源网页:3.1 Annotated Slides | CMOS

讲师:Chris Terman。图片直接引用 OCW 原站链接。

L03:CMOS 技术(CMOS Technology)

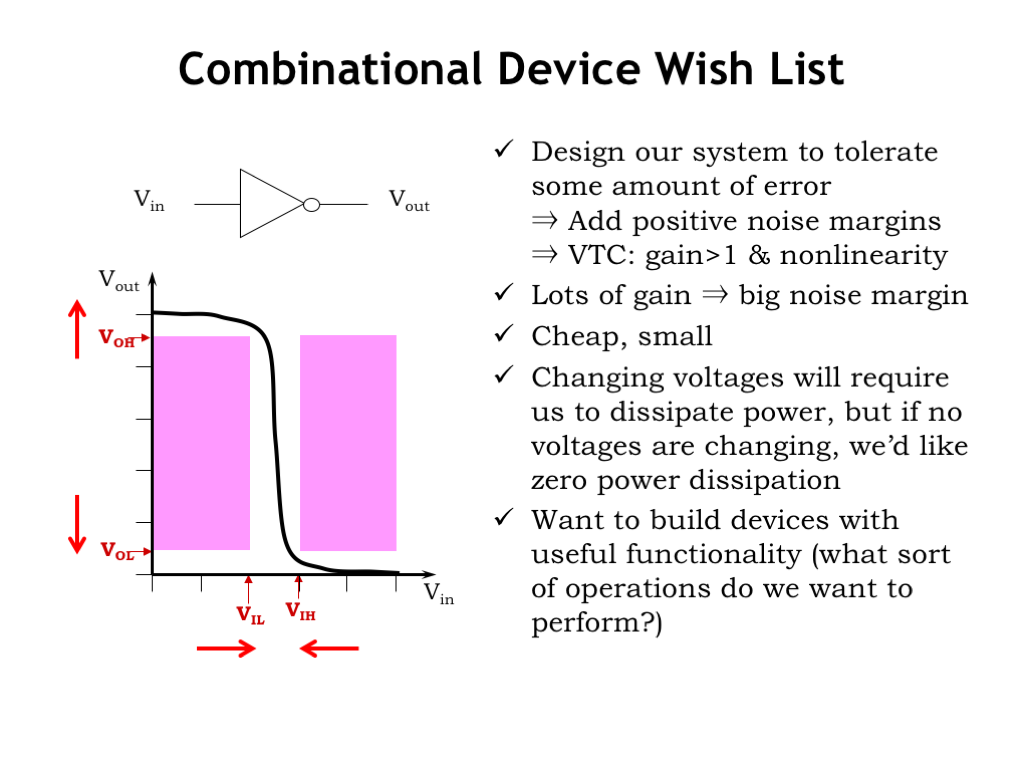
1. 组合器件愿望清单(Combinational Device Wish List)

Combinational Device Wish List

回顾组合器件(combinational device)应具备的特性。上一讲用电压表示信息,并允许信息在处理元件系统中流动时承受一定误差。

规定了四个信号阈值(signaling thresholds):

  • VOLV_{\mathrm{OL}}、VOHV_{\mathrm{OH}}:分别是组合器件输出端表示 0、1 的电压上/下界
  • VILV_{\mathrm{IL}}、VIHV_{\mathrm{IH}}:分别用于解释组合器件输入端电压时的对应角色

并要求 VOLV_{\mathrm{OL}} 严格小于 VILV_{\mathrm{IL}},二者之差称为低噪声容限(low noise margin)——输出信号可叠加的噪声量,仍能在相连输入端被正确解释。同理要求 VIHV_{\mathrm{IH}} 严格小于 VOHV_{\mathrm{OH}}。

在电压传输特性(voltage transfer characteristic, VTC)——即 VOUTV_{\mathrm{OUT}} 对 VINV_{\mathrm{IN}} 的曲线——中,这些阈值意味着:稳态下有效输入必须产生有效输出,因此 VTC 中存在禁区(forbidden regions)。合法组合器件的 VTC 不能落入这些区域。由四个阈值围成的中心区域“宽度小于高度”,因此合法 VTC 必须有一段增益大于 1,且整体非线性。图中所示即为反相器(inverter)的 VTC。

若电路技术增益高、输出电压贴近地与电源轨,可将 VOLV_{\mathrm{OL}}、VOHV_{\mathrm{OH}} 向外推向电源轨,将 VILV_{\mathrm{IL}}、VIHV_{\mathrm{IH}} 向内收,从而增大噪声容限。

此外还希望:

  • 器件便宜且小(数字系统需要数十亿器件)
  • 空闲且内部电压不变时尽量零功耗(zero power dissipation)
  • 能实现有用逻辑功能的器件目录

满足上述愿望的技术,正是本讲主题。

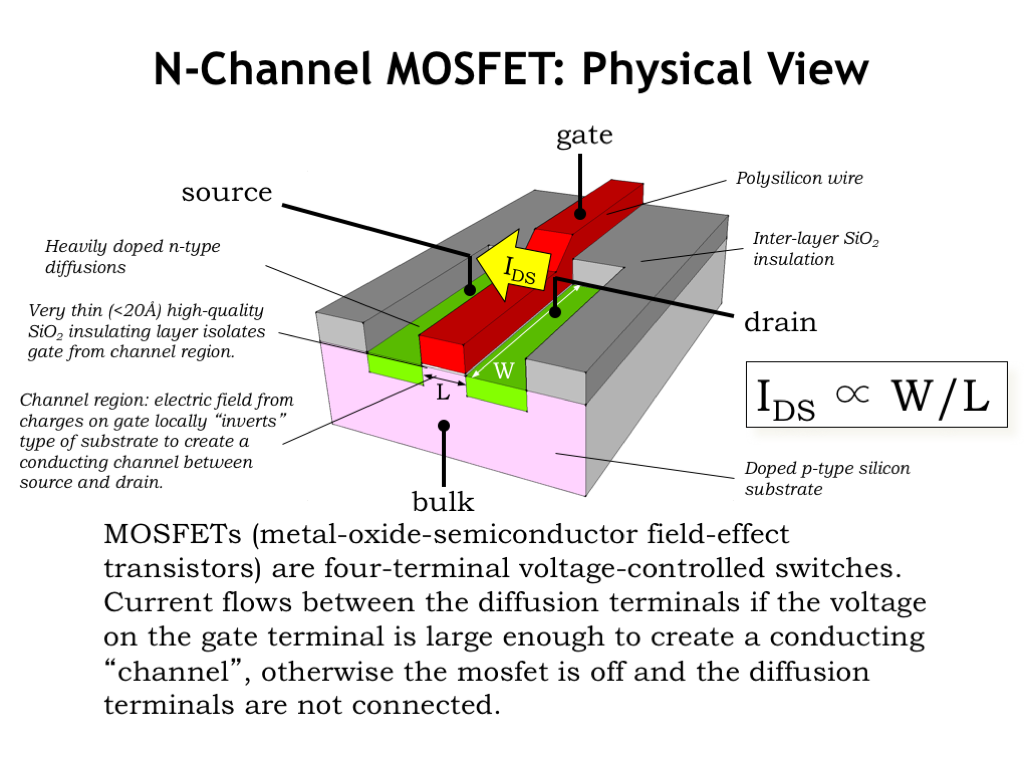
2. N 沟道 MOSFET:物理视角(N-Channel MOSFET: Physical View)

N-Channel MOSFET Physical View

主角是金属–氧化物–半导体场效应晶体管(metal-oxide-semiconductor field-effect transistor, MOSFET)。

图为 MOSFET 三维剖面:由多层电学材料构成的“三明治”,作为集成电路(integrated circuit, IC)的一部分,在同一套制造步骤中批量制成。

现代工艺中,图示块边长约数十纳米——约为细发丝厚度的 1/1000。尺寸小于可见光波长(约 400–750 nm),普通光学显微镜无法分辨。工程师约每 24 个月将特征尺寸缩小一半左右,即 摩尔定律(Moore’s Law,Gordon Moore,1965)。尺寸缩小 50%,同面积可集成约 4 倍器件,器件本身也更快。1975 年一块 IC 约有 2500 个器件;今日可达二三十亿。

结构要点:

  • 衬底(substrate):硅晶圆掺入杂质导电。图中掺入受主(acceptor)如硼(Boron),形成 P 型半导体(p-type semiconductor)。IC 对 P 型衬底有一处电接触(electrical contact),该端称为 bulk 端(bulk terminal),用于控制衬底电压。
  • 绝缘:用二氧化硅(SiO₂)。隔离栅极(gate,图中红色)与衬底的氧化层极薄,使栅上电荷的电场易于影响下方衬底。
  • 栅极(gate):导体,此处为多晶硅(polycrystalline silicon)[1]。栅、薄氧与 P 型衬底构成电容;改变栅压会改变栅下衬底的电学状态。早期栅极为金属,“金属–氧化物–半导体”(metal-oxide-semiconductor, MOS)即指该结构。
  • 栅极做好后,在栅两侧矩形区注入施主(donor)如磷(Phosphorous),形成 N 型(n-type)区,即 MOSFET 另两端:源极(source)与漏极(drain)。二者物理上通常相同,按工作中的角色区分。

MOSFET 可视为连接源、漏的压控开关(voltage-controlled switch)。导通时,电流经栅电容“下极板”形成的导电沟道从漏流向源。关键尺寸:

  • 沟道长度 LL(channel length):漏到源电流需跨越的距离
  • 沟道宽度 WW(channel width):可供导电的沟道多少

漏–源电流 IDSI_{\mathrm{DS}} 与 W/LW/L 成正比。设计常取尽量短的 LL(新闻中“14 nm 工艺”的 14 nm 多指最小允许沟道长度),用 WW 设定所需电流。IDSI_{\mathrm{DS}} 大则源/漏节点电压翻转快,但器件物理更大。

小结:MOSFET 有四个电学端子——bulk、gate、source、drain;设计者可控尺寸为沟道长度(通常尽量小)与沟道宽度(设定电流)。它是固态开关,无机械运动,由四端相对电压决定的电场控制。

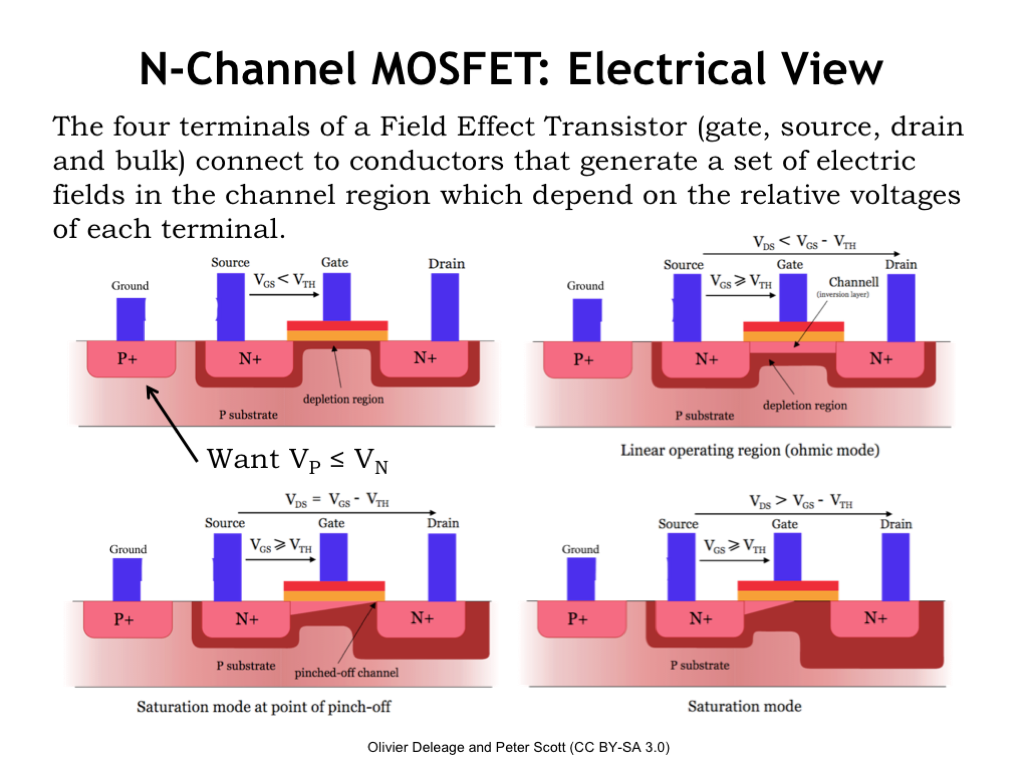
3. N 沟道 MOSFET:电学视角(N-Channel MOSFET: Electrical View)

N-Channel MOSFET Electrical View

约定:两侧扩散区中电位较高的称为漏(drain),较低的称为源(source);若有电流,则从漏流向源。

器件有阈值电压(threshold voltage)VTHV_{\mathrm{TH}}:开关从断路(non-conducting / OFF / OPEN)变为导通(conducting / ON / CLOSED,即路径闭合)的分界。现代工艺中 N 沟道 MOSFET 的 VTHV_{\mathrm{TH}} 约 0.5 V0.5\,\mathrm{V}。

图左侧的 P+ 端(terminal)即通往 P 型衬底的连接(connection)。正常工作时,衬底电压须始终 ≤\le 源、漏电压。

开关由栅源电压差控制:VGS=VG−VSV_{\mathrm{GS}} = V_{\mathrm{G}} - V_{\mathrm{S}}。

  • 当 VGS<VTHV_{\mathrm{GS}} < V_{\mathrm{TH}}:开关开路,源漏无电连接。N 型与 P 型材料物理接触(physical contact)处形成耗尽区(depletion region,图中深红),载流子迁离结区,起到绝缘作用;源/漏相对衬底电压越高,该绝缘层越宽,并填满源漏之间,使二者电隔离。
  • 当 VGSV_{\mathrm{GS}} 增大:栅上正电荷电场吸引衬底电子。达到阈值后,电子从价带进入导带,聚集在薄氧化层下,足够时半导体由 P 型反转为 N 型,形成连接源漏的反型层(inversion layer)[2]。开关闭合;电流与漏源电压差 VDSV_{\mathrm{DS}} 成比例。此时反型层近似电阻,遵循欧姆定律 IDS=VDS/RI_{\mathrm{DS}} = V_{\mathrm{DS}} / R。过程可逆:VGSV_{\mathrm{GS}} 低于阈值则反型层消失,开关截止。
  • 当 VDS>VGSV_{\mathrm{DS}} > V_{\mathrm{GS}}:沟道电场几何改变,漏端附近反型层夹断(pinch-off)[3];电子仍可隧穿夹断点到达源侧导电沟道。对 IDSI_{\mathrm{DS}} 的影响见下一节曲线。

4. N 沟道 MOSFET:IDS 与 VDS

N-Channel MOSFET IDS vs VDS

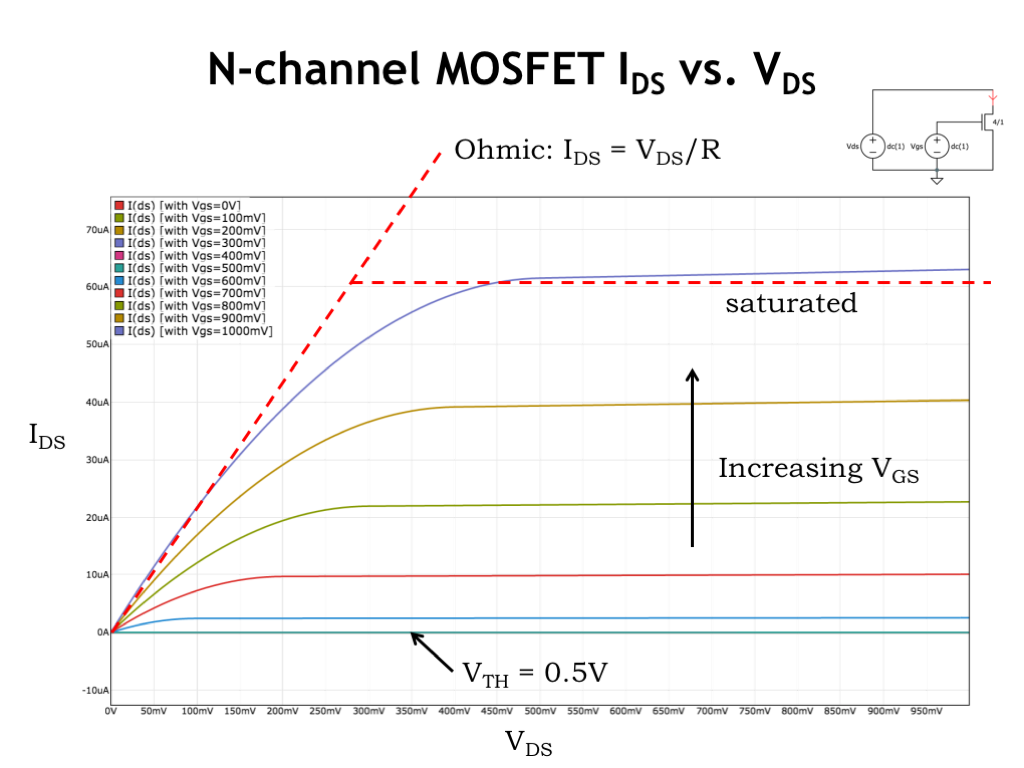
每条曲线是固定 VGSV_{\mathrm{GS}} 下 IDSI_{\mathrm{DS}} 对 VDSV_{\mathrm{DS}} 的关系。

  • VGS≤VTHV_{\mathrm{GS}} \le V_{\mathrm{TH}} 时 IDS=0I_{\mathrm{DS}} = 0(前几条曲线叠在横轴上)
  • 超过阈值后,IDSI_{\mathrm{DS}} 随 VGSV_{\mathrm{GS}} 增大而增大(反型层更厚,导电更强)
  • VDSV_{\mathrm{DS}} 较小时,器件呈电阻特性:曲线左侧线性段斜率与沟道电阻成反比;VGSV_{\mathrm{GS}} 越大斜率越陡、电阻越小
  • VDSV_{\mathrm{DS}} 较大时沟道在漏端夹断,IDSI_{\mathrm{DS}} 近似不再随 VDSV_{\mathrm{DS}} 增加,曲线近乎水平——进入饱和区(saturation)

饱和段并非完全水平,IDSI_{\mathrm{DS}} 仍略随 VDSV_{\mathrm{DS}} 上升,称为沟道长度调制(channel-length modulation)。[4]

MOSFET 工作机理相当复杂!好在作为设计者,只要在设计 MOSFET 电路时遵守若干简单规则,就可以改用简单得多的开关模型。

5. 两种 FET(FETs Come in Two Flavors)

FETs Come in Two Flavors

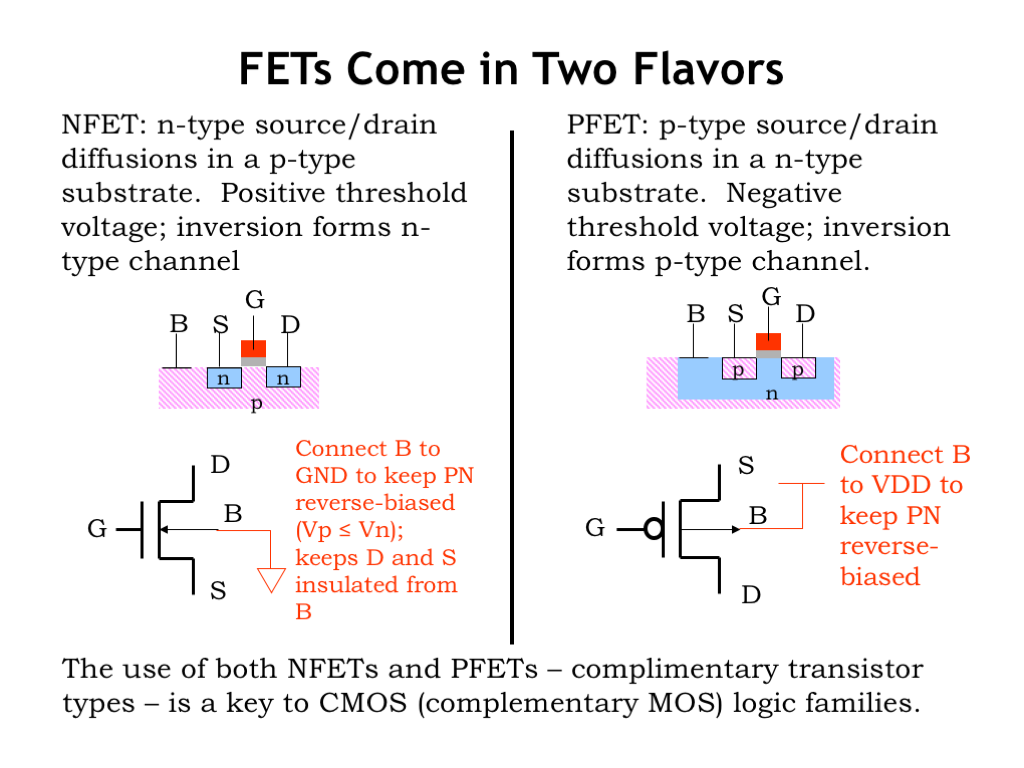
此前讨论的是:P 型衬底上的 N 型源/漏扩散——N 沟道 MOSFET(n-channel MOSFET / NFET),反型层为 N 型。电路中将 bulk(B)接 GND,使 Vp≤VnV_{\mathrm{p}} \le V_{\mathrm{n}},源漏–衬底 PN 结反向偏置(外加电场与内建电场同向,耗尽区变宽),从而源/漏相对衬底保持绝缘。

对调所有材料类型:N 型衬底(或 N 阱)上的 P 型源/漏——P 沟道 MOSFET(p-channel MOSFET / PFET)。同样是压控开关,但电位关系相反:B 接 VDDV_{\mathrm{DD}} 以保持 PN 结反向偏置;使 N 沟道导通的控制电压往往使 P 沟道截止,反之亦然。

两类开关行为互补,故使用二者的电路称为互补 MOS(complementary MOS, CMOS)。

6. CMOS 指南(CMOS Recipe)

CMOS Recipe

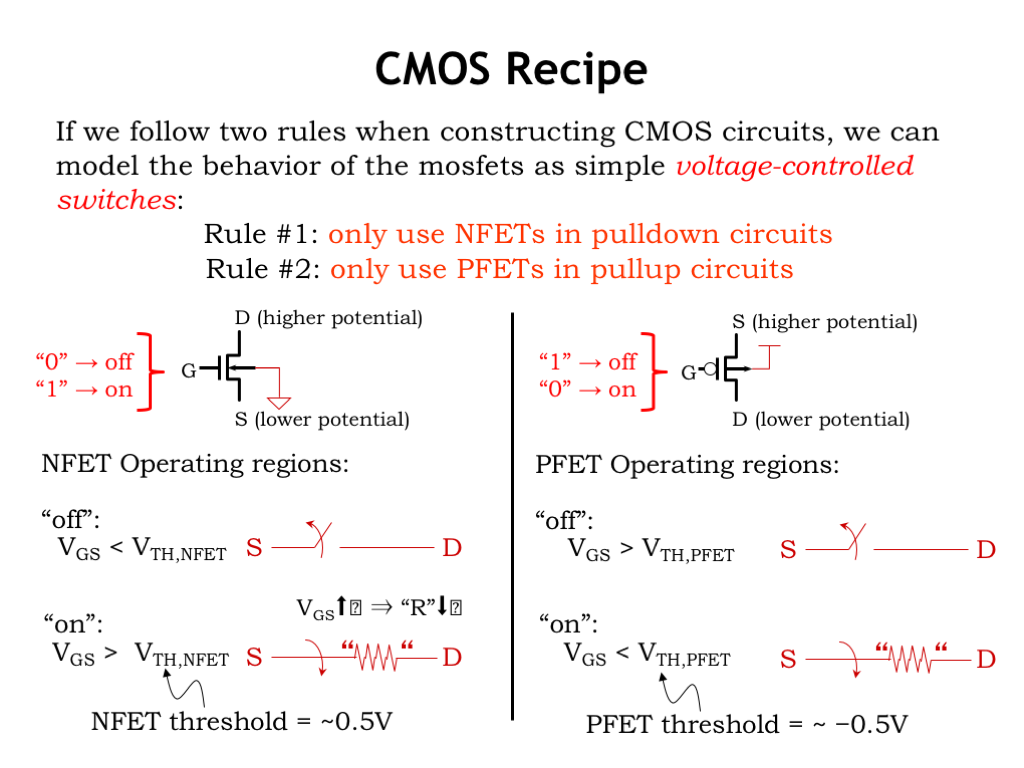
用 MOSFET 处理数字编码信息时,遵守两条规则,即可把 MOSFET 抽象为压控开关:

  1. N 沟道 MOSFET(NFET)仅用于下拉电路(pulldown),把信号节点接到电源地(GND)。下拉导通时节点约 0 V0\,\mathrm{V},记为数字 0。可记作:栅为数字 0 → 关;栅为数字 1 → 开。VGSV_{\mathrm{GS}} 越大,有效电阻越小,IDSI_{\mathrm{DS}} 越大。
  2. P 沟道 MOSFET(PFET)仅用于上拉电路(pullup),把信号节点接到电源电压 VDDV_{\mathrm{DD}}。上拉导通时节点为 VDDV_{\mathrm{DD}},记为数字 1。PFET 阈值为负,VGSV_{\mathrm{GS}} 须小于阈值才导通。与 NFET 相反:栅为 0 → 开;栅为 1 → 关。

为何不能用 NFET 做上拉、PFET 做下拉?简答:信号电平会退化,噪声容限受损(实验课会展开)。

7. CMOS 反相器 VTC(CMOS Inverter VTC)

CMOS Inverter VTC

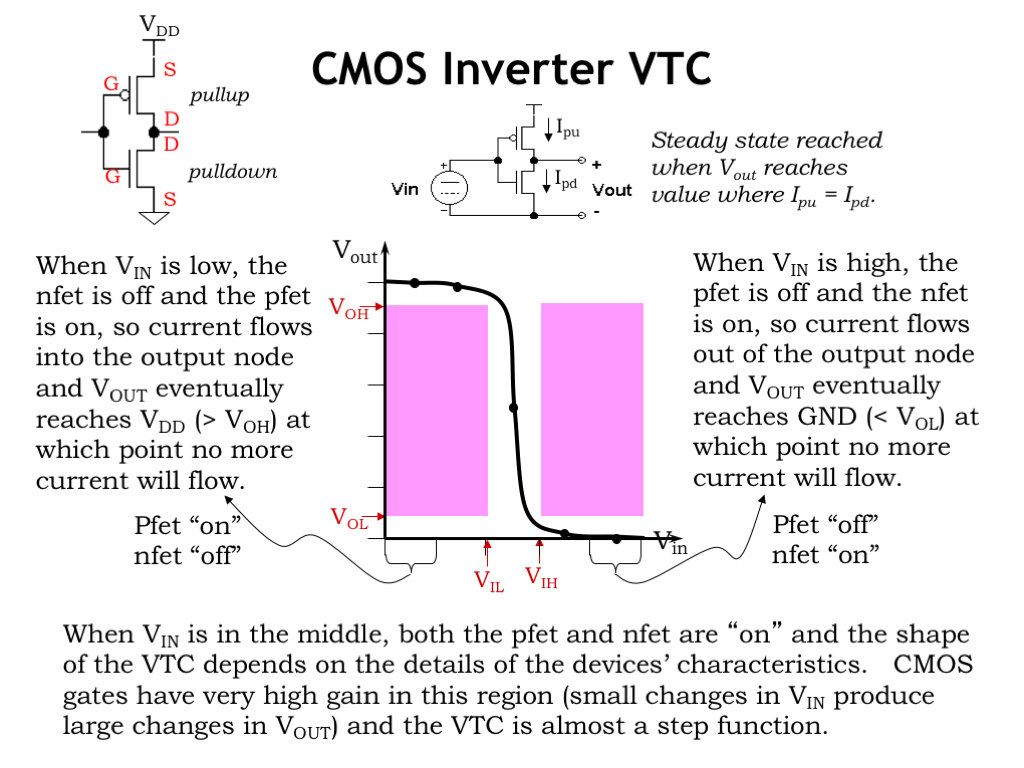
CMOS 反相器:输入 0 → 输出 1,反之亦然。电路由一个 NFET 下拉(输出到 GND)与一个 PFET 上拉(输出到 VDDV_{\mathrm{DD}})组成,两管栅极同接输入。

  • 输入为数字 0:NFET 关、PFET 开,输出充至 VDDV_{\mathrm{DD}}(数字 1);源漏同为 VDDV_{\mathrm{DD}} 后无压差,电流停止
  • 输入为数字 1:NFET 开、PFET 关,输出放至 0 V0\,\mathrm{V};达 0 V0\,\mathrm{V} 后电流停止
  • 输入处于中间电平时,视电源与阈值,上拉与下拉可能短暂同时导通。此时输入小变化可引起输出大变化,形成 CMOS 的高增益,从而可选取宽松噪声容限

这是第一个 CMOS 组合逻辑门(combinational logic gate)。[5]

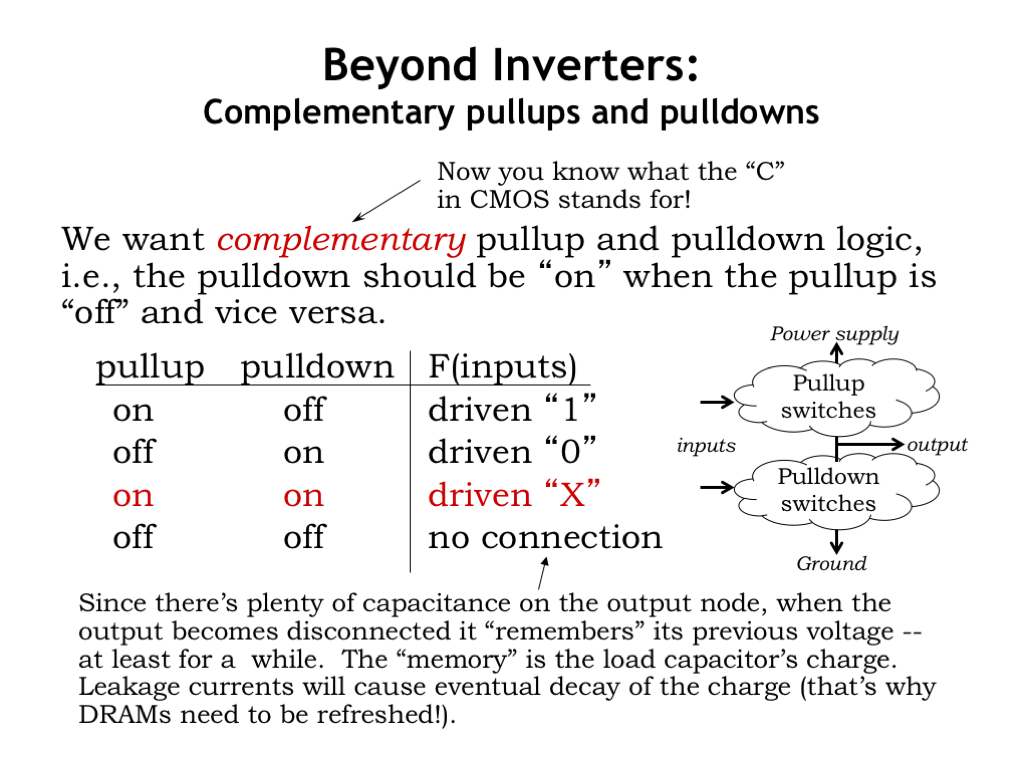
8. 超越反相器(Beyond Inverters)

Beyond Inverters

构建其他逻辑门:设计互补的上拉与下拉网络(complementary pullup / pulldown)。“互补”指一个导通时另一个不导通。

  • 上拉导通、下拉截止 → 输出接 VDDV_{\mathrm{DD}} → 数字 1
  • 下拉导通、上拉截止 → 输出接 GND → 数字 0
  • 二者长时间同时导通 → VDDV_{\mathrm{DD}} 到 GND 有大短路电流;简单开关模型下输出记为 X(未知)(unknown)
  • 二者都不导通 → 输出浮空(floating),节点电容上的电荷可暂存——这是一种存储形式,后续讲座再谈

目前只关注互补上拉/下拉的器件。

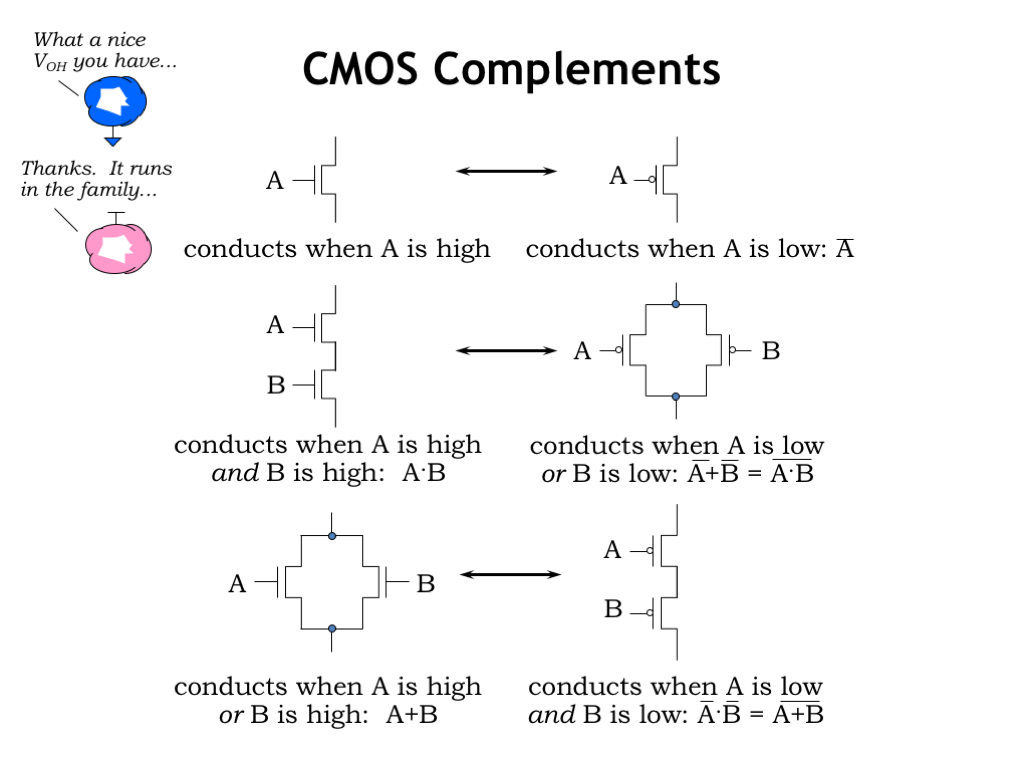
9. CMOS 互补结构(CMOS Complements)

CMOS Complements

最简单互补对:单个 NFET 下拉 + 单个 PFET 上拉,同一信号控制时,一开则另一必关。

  • 串联 NFET:仅当 A=1 且 B=1 时整条路径导通。其互补是并联 PFET:A=0 或 B=0 时导通。对 AB = 00, 01, 10, 11 逐一验证可知总有一个网络导通、另一个截止。
  • 并联 NFET 与 串联 PFET 同理互补。

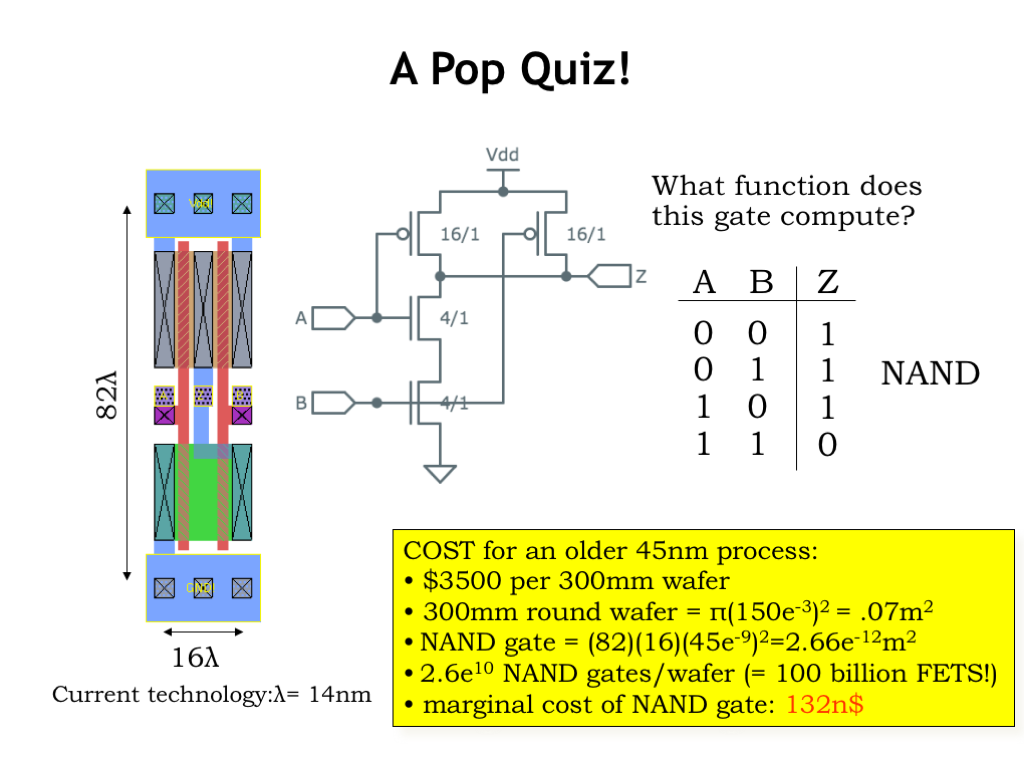
10. 小测验:NAND 门(A Pop Quiz!)

NAND Gate

串联 NFET 下拉 + 并联 PFET 上拉。用真值表(truth table)列出所有 A、B 组合下的 Z:

A B Z
0 0 1
0 1 1
1 0 1
1 1 0

仅当 A、B 皆为 1 时 Z=0,否则 Z=1——即 NAND(NOT-AND)门。

左图为俯视版图示意:蓝为金属(上下大走线接 VDDV_{\mathrm{DD}} / GND),红为多晶硅栅,绿为 NFET 的 N 型扩散,棕黄为 PFET 的 P 型扩散。可看出 NFET 串联、PFET 并联。

成本直觉(讲义信封估算):一块 300 mm 晶圆上约可做 260 亿个 NAND;旧工艺材料与制造约 $3500,约合每门百纳美元量级——确属又小又便宜。

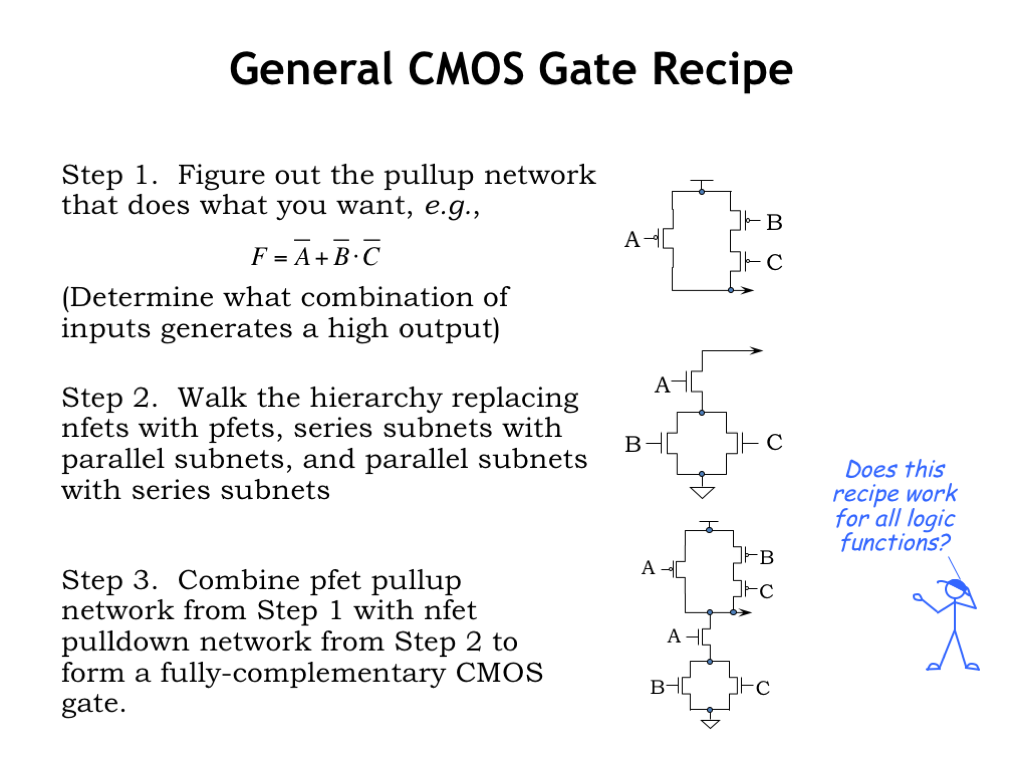
11. 通用 CMOS 门指南(General CMOS Gate Recipe)

General CMOS Gate Recipe

更复杂逻辑:用串联/并联开关网络实现。

设计步骤:

  1. 先设计 PFET 上拉:输出为 1 的输入条件如何接到 VDDV_{\mathrm{DD}}。例:F=1 当 A=0 或(B=0 且 C=0)。OR → 并联,AND → 串联。
  2. 构造互补下拉:沿上拉层次结构,PFET→NFET,串联↔并联。例:上拉为“A 控制管并联于 B–C 串联”;下拉则为“A 控制管串联于 B–C 并联”,且全部为 NFET。
  3. 合并上拉与下拉,得到全互补 CMOS 实现。

该指南并非对一切逻辑函数都适用,见下一节。

12. CMOS 门天然反相(CMOS Gates Are Naturally Inverting)

CMOS Gates Are Naturally Inverting

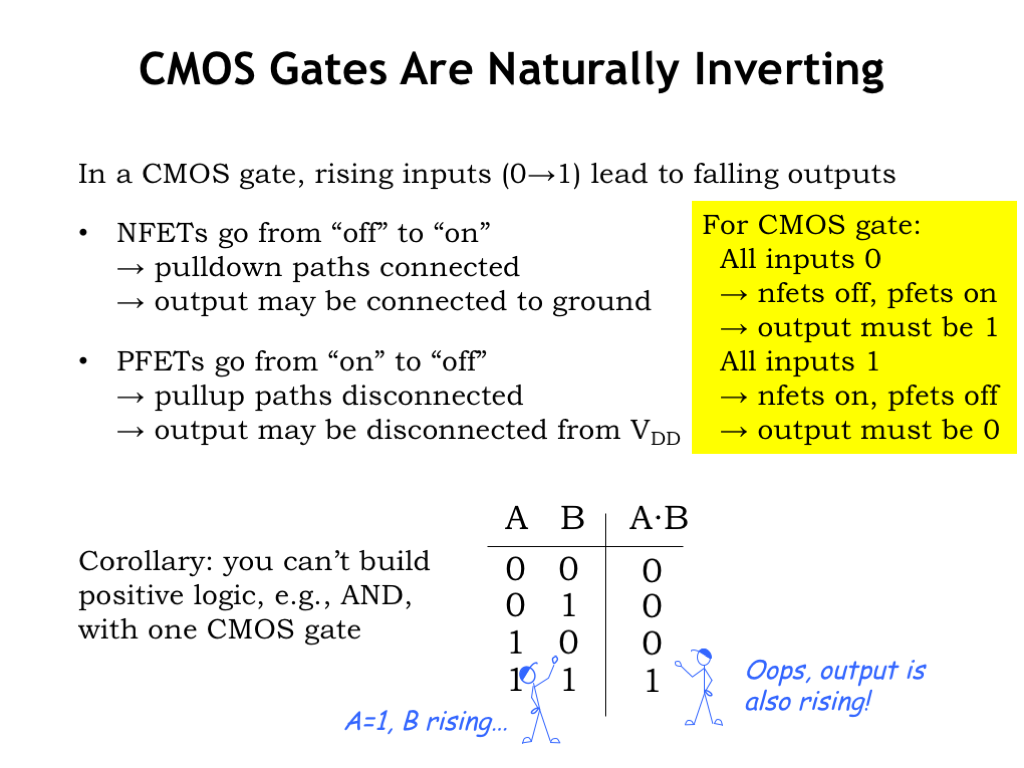
单个 CMOS 门(一个上拉网络 + 一个下拉网络)只能实现反相函数(inverting functions):输入上升导致输出下降,反之亦然。

理由:某输入从 0→1 时,受其控制的 NFET 由关→开(可能接通到 GND 的路径),PFET 由开→关(可能切断到 VDDV_{\mathrm{DD}} 的路径)。若输出因此变化,必是下拉被启用、上拉被禁用,即输出从 1→0。同理,输入下降对应输出上升。

对非常数 CMOS 门:全部输入为 0 时输出必为 1(全部 NFET 关、全部 PFET 开);全部输入为 1 时输出必为 0。因此正逻辑(positive logic,如 AND)不能用单个 CMOS 门实现——AND 真值表在全 0 / 全 1 时与上述结论矛盾,且 A=1、B 从 0→1 时输出上升而非下降。CMOS 设计者需熟练用反相逻辑拼出所需功能。

13. CMOS 时序规格(CMOS Timing Specifications)

CMOS Timing Specifications

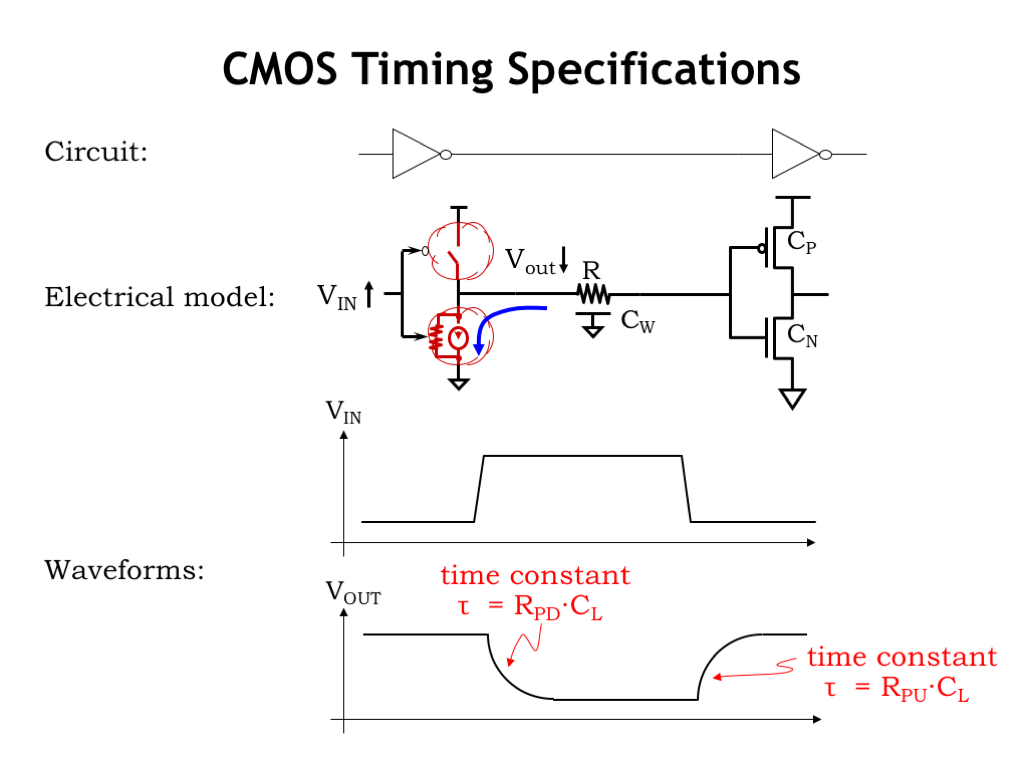
两级 CMOS 反相器串联,用来刻画左级反相器的时序。建立改变 VINV_{\mathrm{IN}} 时的电学模型。

  • VINV_{\mathrm{IN}} 从数字 0→1:上拉 PFET 关、下拉 NFET 开,左级输出节点接到 GND。该节点的电学模型包括:连接左级输出与右级输入的物理导线的分布电阻与分布电容,以及右级 MOSFET 栅端电容(图中常标为 CWC_W、CPC_P、CNC_N 等)。输出接到 GND 后,电容上的电荷经导线电阻与导通 NFET 的沟道电阻泄放到 GND,导线电压最终达到地电位 0 V0\,\mathrm{V}。
  • VINV_{\mathrm{IN}} 下降时过程对称:上拉 PFET 开、下拉 NFET 关,输出节点经导线与 PFET 沟道电阻向 VDDV_{\mathrm{DD}} 充电。

再看随时间变化的电压波形。上图给出 VINV_{\mathrm{IN}} 先升后降;输出呈电容经电阻充/放电的典型指数形状,由 R–C 时间常数刻画:

  • 下拉(放电):τ=RPD⋅CL\tau = R_{\mathrm{PD}} \cdot C_L
  • 上拉(充电):τ=RPU⋅CL\tau = R_{\mathrm{PU}} \cdot C_L

其中 RR 为导线与 MOSFET 沟道的等效总电阻,CLC_L 为导线与后级栅端的等效总电容。输入、输出翻转都不是瞬时的,量测反相器延迟时需约定起止时刻——信号阈值正好提供这一约定。

14. 传播延迟(Propagation Delay)

Propagation Delay

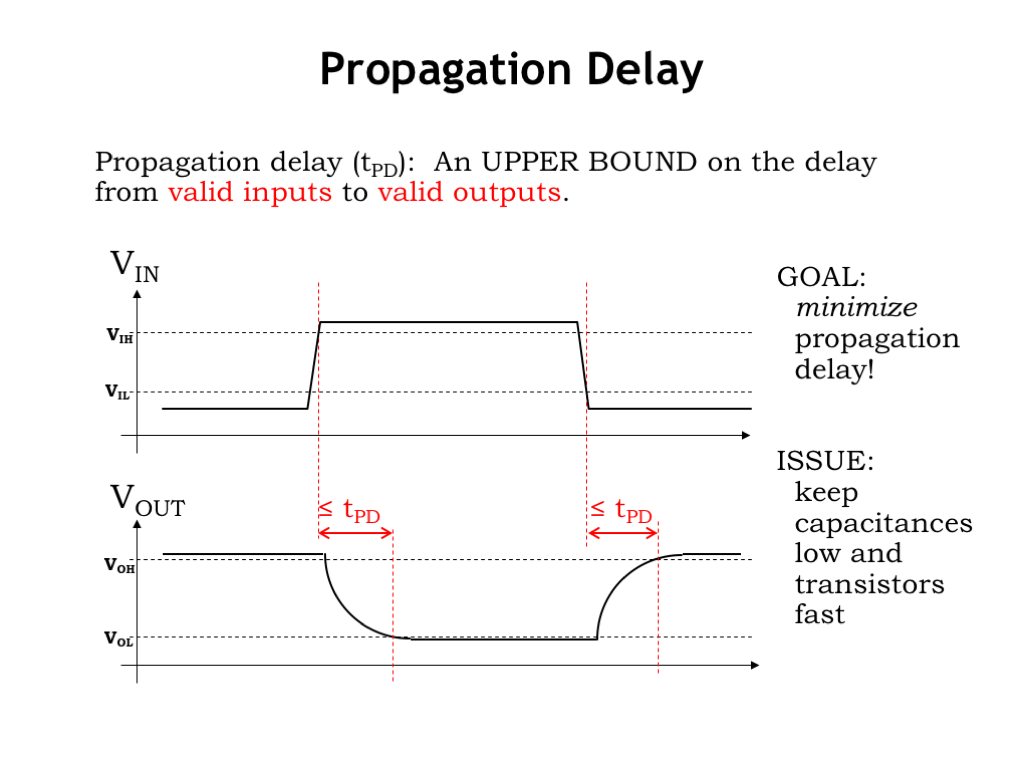
用信号阈值定义延迟的起止。

传播延迟(propagation delay)tPDt_{\mathrm{PD}}:从有效输入到有效输出的延迟上界 [6]。有效输入由 VILV_{\mathrm{IL}}、VIHV_{\mathrm{IH}} 界定;有效输出由 VOLV_{\mathrm{OL}}、VOHV_{\mathrm{OH}} 界定。

  • 上升输入:从 VINV_{\mathrm{IN}} 越过 VIHV_{\mathrm{IH}},到 VOUTV_{\mathrm{OUT}} 越过 VOLV_{\mathrm{OL}} 的时间间隔
  • 下降输入:从 VINV_{\mathrm{IN}} 越过 VILV_{\mathrm{IL}},到 VOUTV_{\mathrm{OUT}} 越过 VOHV_{\mathrm{OH}} 的时间间隔

tPDt_{\mathrm{PD}} 须 ≥\ge 上述任意测得延迟;厂商还需覆盖工艺、温度、电源等变化,使客户实测延迟不超过该规格。

设计者可用各组件的 tPDt_{\mathrm{PD}} 估算系统延迟。要减小延迟,需减小电阻与电容:加宽 MOSFET 可降有效电阻,但增大栅电容、拖慢驱动该栅的前级——这是晶体管尺寸优化问题。

15. 污染延迟(Contamination Delay)

Contamination Delay

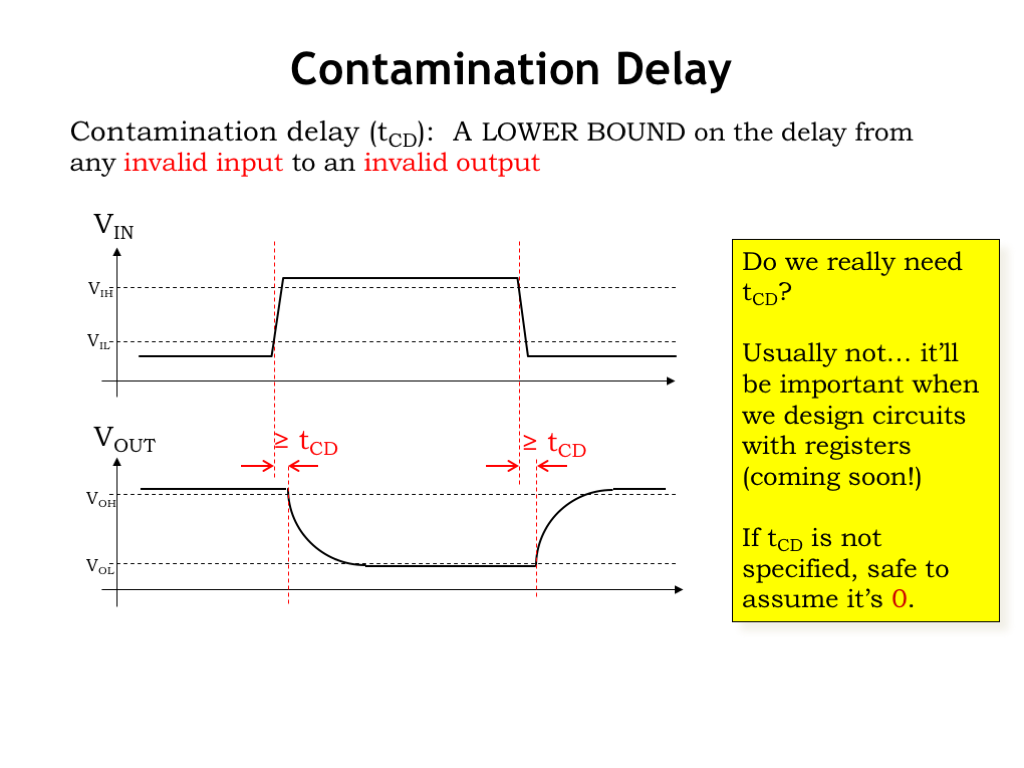
污染延迟(contamination delay)tCDt_{\mathrm{CD}}:输入开始变化、变为无效之后,输出仍保持原先有效值的时间。技术上是从无效输入到无效输出的延迟下界 [7]。

  • 上升输入:从 VINV_{\mathrm{IN}} 越过 VILV_{\mathrm{IL}}(不再是有效 0),到 VOUTV_{\mathrm{OUT}} 越过 VOHV_{\mathrm{OH}}(不再是有效 1)
  • 下降输入:做对称测量

tCDt_{\mathrm{CD}} 须 ≤\le 任意测得该间隔。静态纪律并不强制要求 tCDt_{\mathrm{CD}};未给出时,设计者应保守取 tCD=0t_{\mathrm{CD}} = 0(输入一无效,输出即可立即无效)。厂商常称其为“最小传播延迟”(minimum propagation delay)。

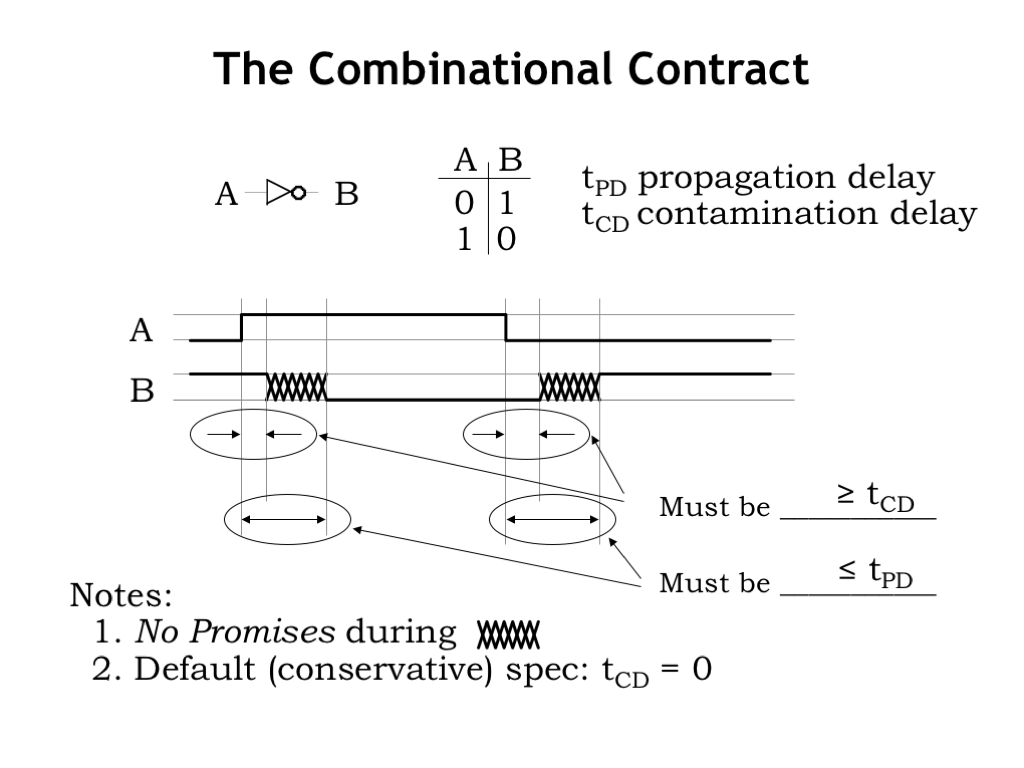
16. 组合契约(The Combinational Contract)

The Combinational Contract

时序规格小结(输入波形 A,输出波形 B):

  • tCDt_{\mathrm{CD}}:旧输出值保持有效的最短时间下界;保守可取 0,表示输入一变输出即可变
  • tPDt_{\mathrm{PD}}:输出重新有效并稳定的最长时间上界

一般而言,在输入跳变后的 (tCD,tPD)(t_{\mathrm{CD}}, t_{\mathrm{PD}}) 区间内,对输出行为不作保证:可多次翻转,也可出现非数字电压。后文对一类特殊组合器件可再说得更细;通常设计者不应对该区间内 B 的值做假设。

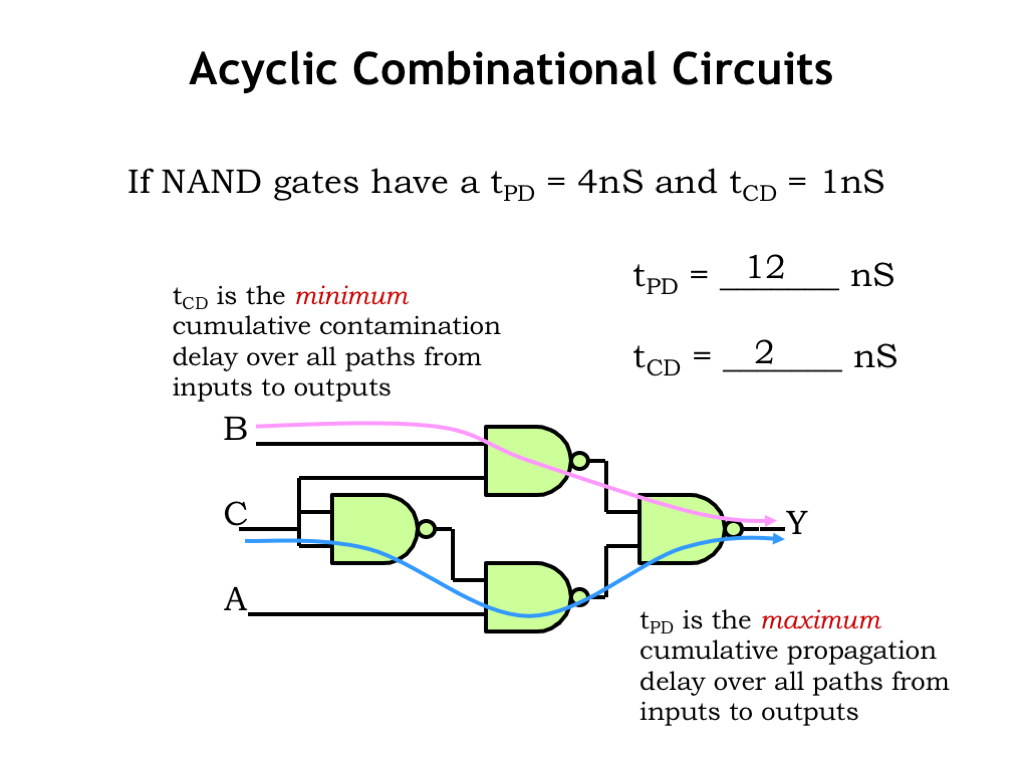
17. 无环组合电路(Acyclic Combinational Circuits)

Acyclic Combinational Circuits

由组件规格推大电路规格的例子:四个 NAND,每个 tPD=4 nst_{\mathrm{PD}} = 4\,\mathrm{ns},tCD=1 nst_{\mathrm{CD}} = 1\,\mathrm{ns}。

  • 整体 tPDt_{\mathrm{PD}}:枚举从输入 A/B/C 到输出 Y 的每条路径,累加路径上各门 tPDt_{\mathrm{PD}},取最大。例中最长路径经 3 个 NAND → 12 ns12\,\mathrm{ns}(Y 保证在输入跳变后 12 ns 内稳定有效)
  • 整体 tCDt_{\mathrm{CD}}:同样枚举路径,累加各门 tCDt_{\mathrm{CD}},取最小。例中最短路径经 2 个 NAND → 2 ns2\,\mathrm{ns}(输入无效后 Y 至少再保持旧值 2 ns)

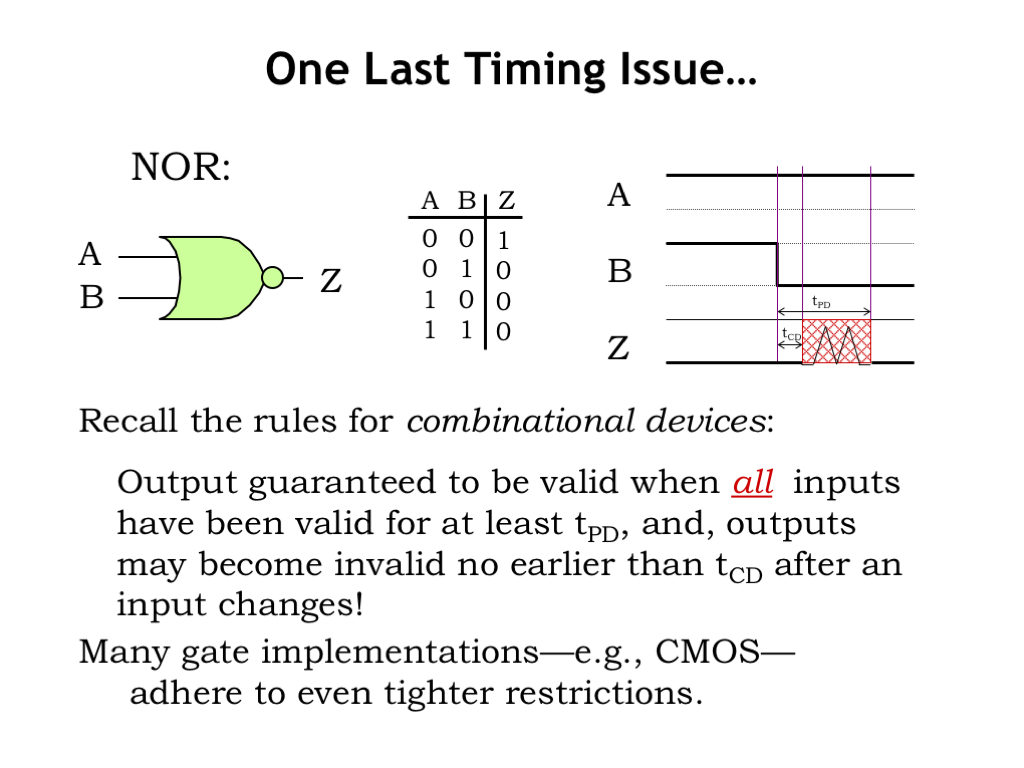
18. 最后一个时序问题(One Last Timing Issue)

One Last Timing Issue

非 CMOS 的 NOR 组合器件:A、B 初为 0,Z=1;B:0→1 后 Z 最终 1→0,跳变落在 (tCD,tPD)(t_{\mathrm{CD}}, t_{\mathrm{PD}}) 窗口内(图中红阴影表示该区间无保证)。[8]

另一情形:A、B 初为 1,Z=0。真值表显示 A=1 时 Z 恒为 0,与 B 无关。B:1→0 后,经 tPDt_{\mathrm{PD}} 后 Z 仍应为 0;但一般在中间区间仍不能假设 Z 的行为——合法组合器件可在该窗口任意表现。

许多工艺(如 CMOS)遵守更严的约束。

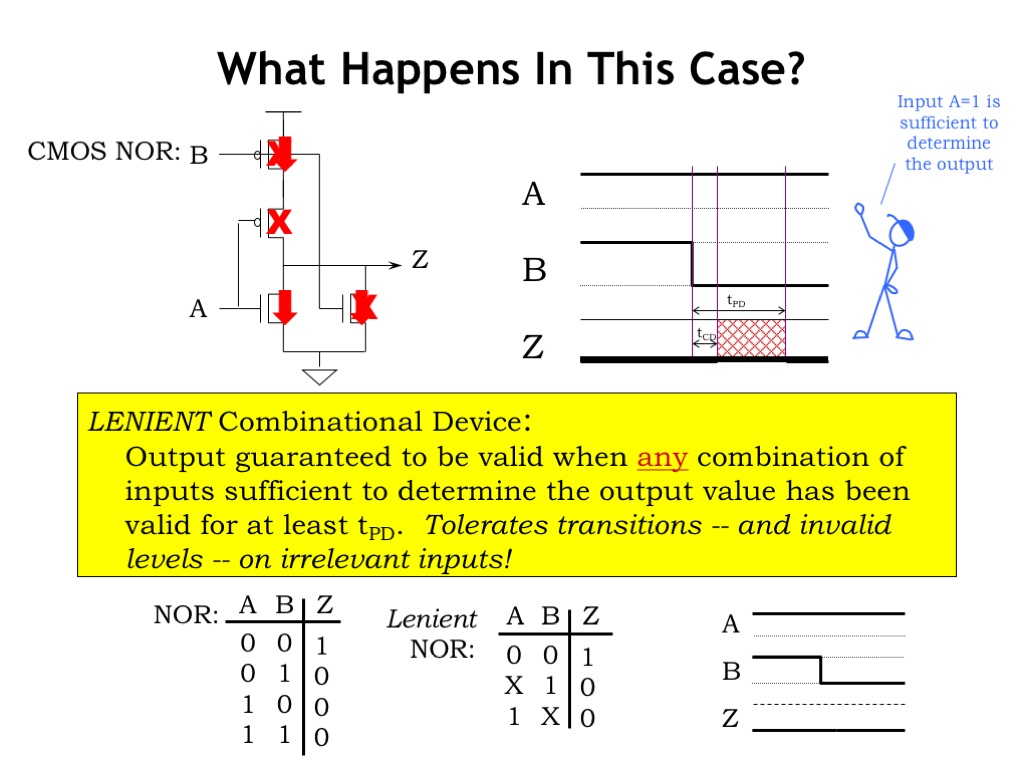
19. 宽容门(Lenient Gates)

Lenient Gates

CMOS NOR:两输入皆为 1 时,NFET 导通、PFET 截止,Z 接 GND。B:1→0 时 B 控制的开关翻转,但上拉仍不导通,Z 到 GND 仍有路径——只是路径从两条减为一条,Z 全程保持有效稳定的 0。即:一输入为 1 时,另一输入跳变不影响输出有效性。

宽容组合器件(lenient combinational device):只要足以决定输出的那组输入已有效至少 tPDt_{\mathrm{PD}},输出就保证有效;触发该行为时,其余输入的跳变不影响输出有效性。多数 CMOS 逻辑门天然宽容。

真值表可用 X 标出无关输入:宽容 NOR 中,A=1 时 B 无关,B=1 时 A 无关;无关输入的跳变不触发通常的 tCDt_{\mathrm{CD}} / tPDt_{\mathrm{PD}} 输出时序。构建存储元件时会需要宽容组件。

20. 小结(Summary)

Summary

本讲要点:

  • MOSFET 作为压控开关;N/P 沟道互补构成 CMOS
  • 规则:NFET 只做下拉,PFET 只做上拉;上拉与下拉网络互补
  • 单个 CMOS 门天然实现反相逻辑;复杂函数由串并联网络按指南设计
  • 时序用 tPDt_{\mathrm{PD}}(上界)与 tCDt_{\mathrm{CD}}(下界,可保守取 0)刻画;大电路取路径最大/最小累加
  • CMOS 门常具宽容性,利于后续存储等设计

可开始自行搭建 CMOS 门了。


  1. 为什么栅极用多晶硅?

    1. 为什么多晶硅能当导体?
      本征多晶硅导电很差;做成栅极时会重掺杂(heavily doped),载流子浓度极高,近似金属般导电。工艺上常再叠一层硅化物(silicide,如 Ti/Co/Ni 硅化物,自对准时常称 salicide),进一步降低栅电阻,同时仍能承受后续高温步骤。

    2. 为什么当年选多晶硅而不是金属?
      现代 CMOS 多用自对准栅(self-aligned gate):先做栅,再以栅为掩模注入源/漏,并做高温退火。铝等常用金属熔点低,扛不住这些高温;多晶硅熔点高、与硅工艺兼容。此外,N/P 管可用不同掺杂调节功函数(work function),便于设定阈值;栅、源漏用同一套硅基材料,步骤也更省。名称里的 “MOS” 来自早期金属栅结构;工业界改用多晶硅后,习惯上仍叫 MOS/MOSFET。

    3. 现代还用多晶硅吗?
      不完全是。 约 45 nm 起,逻辑主流程普遍改为 高 κ 介质 + 金属栅(high-k / metal gate, HKMG):金属栅消除多晶硅耗尽(poly depletion),并更好匹配 high-k。更老的节点、部分模拟/高压/存储等工艺仍可见掺杂多晶硅(或硅化物)栅。讲义示意图画多晶硅,是经典结构,便于理解,不等于最先进逻辑节点仍只用多晶硅。

    ↩︎
  2. 反型层里的电子从哪来?

    实际上,栅极吸引的电子绝大部分正是来自源极(N区)和漏极(N区),而不是仅靠衬底(P区)本征激发的少数载流子。

    讲义中提及“pull the substrate electrons from the valence band into the conduction band(将衬底电子从价带拉入导带)”,主要是为了从能带结构的角度解释“导电沟道形成/半导体表面反转”的物理机制,但在器件实际运行的动态过程中,源极和漏极才是电子的主要供给源。

    具体原因可以从以下几个维度理解:

    1. 浓度数量级的巨大悬殊(极度缺乏自由电子)

      P型衬底(Substrate):主要是空穴(多数载流子),其中的自由电子(少数载流子)数量极少(通常在 1010∼1015 cm−310^{10} \sim 10^{15}\,\mathrm{cm}^{-3} 级别)。如果仅靠热激发或电场把 P 区价带上的电子拉到导带,产生的自由电子数量极慢且极少,根本不足以快速形成强导电沟道。

      N区(源极 Source / 漏极 Drain):经过高浓度重掺杂(N+),内部充满了海量的自由电子(通常在 1019∼1020 cm−310^{19} \sim 10^{20}\,\mathrm{cm}^{-3} 级别)。

    2. 势垒降低与电子注入(PN结的作用)

      源极(N区)与 P 型衬底之间存在 PN 结。在未加栅极电压时,PN 结的内建电场(势垒)阻止了 N 区的自由电子向 P 区扩散。

      当栅极加正电压(VGS>VTHV_{\mathrm{GS}} > V_{\mathrm{TH}})时,栅极电场会渗透到硅表面,降低了源极 N 区与 P 型衬底表面之间的势垒(Potential Barrier)。

      势垒一旦降低,源极(N区)中海量的自由电子就会在电场吸引下,像“闸门放水”一样迅速扩散并漂移注入到栅极下方的表面区域,迅速填满沟道。

    3. 器件响应速度的必然要求(微秒 vs 纳秒)

      如果反转层(沟道)中的电子完全依赖 P 型衬底热激发生成(产生-复合过程),这个过程非常缓慢,通常需要毫秒(ms)到微秒(μs)级别。

      但现代 MOSFET(CMOS)的开关速度在皮秒(ps)到纳秒(ns)级别(GHz 频率)。如此高频的开关响应,必须依靠源极和漏极这两个“电子大水库”在瞬间提供大量电子。

    4. 总结

      概念层面(能带物理):描述“P型衬底表面反转为N型沟道”时,教材/文献常说“衬底表面的能带弯曲,使表面电子从价带跃迁到导带”(即原本的 P 型区在表面变成了 N 型)。

      实际物理过程(载流子来源):建立沟道所需的海量自由电子,绝大多数都是由源极(和漏极)的高掺杂 N 区瞬间注入供给的。源极正是因此被称为 Source(源极 = 电子的来源)。

    ↩︎
  3. 为什么随着 VDSV_{\mathrm{DS}} 增加,沟道夹断?

    在 MOSFET 中,沟道夹断(Channel Pinch-off)的本质原因,是栅极到沟道各点之间的“有效垂直电场(VGDV_{\mathrm{GD}})”沿沟道方向不均匀导致的。

    我们可以从以下几个关键点逐步拆解其物理原理:

    1. 栅电场的真实驱动力:VGC(x)V_{\mathrm{GC}}(x)

      下标 C\mathrm{C} 表示沟道(channel);xx 为沿沟道位置(源端 x=0x = 0,漏端 x=Lx = L)。VGC(x)V_{\mathrm{GC}}(x) 是栅极到沟道上该点的电压差。下文 V(x)V(x) 即该点相对源极的电压 VCS(x)V_{\mathrm{CS}}(x)。

      当 VDS=0 VV_{\mathrm{DS}} = 0\,\mathrm{V} 时,整个沟道从源极(Source)到漏极(Drain)的电势都是 0 V0\,\mathrm{V}。此时,栅极对沟道各点的垂直电压差都是固定的 VGSV_{\mathrm{GS}},因此产生的反转层(沟道)厚度是均匀的。

    2. VDSV_{\mathrm{DS}} 增加打破了电压分布的均匀性

      当我们在漏极加上正电压 VDS>0 VV_{\mathrm{DS}} > 0\,\mathrm{V} 时,电流从漏极流向源极(电子从源极流向漏极)。

      由于沟道本身具有电阻,从源极(x=0x = 0,V=0 VV = 0\,\mathrm{V})到漏极(x=Lx = L,V=VDSV = V_{\mathrm{DS}}),沟道内部的电势 V(x)V(x) 沿路径逐渐升高。

      此时,沟道上某一点 xx 处的实际栅-沟道电压差为:

      VGC(x)=VGS−V(x)V_{\mathrm{GC}}(x) = V_{\mathrm{GS}} - V(x)

    3. 漏极端的“垂直电场”被削弱

      在源极端(x=0x = 0):V(0)=0 VV(0) = 0\,\mathrm{V},栅-沟电位差为 VGSV_{\mathrm{GS}}(大于开启电压 VTHV_{\mathrm{TH}}),保持很强的导电沟道。

      在漏极端(x=Lx = L):V(L)=VDSV(L) = V_{\mathrm{DS}},此时漏极附近的栅-沟电位差被削弱为:

      VGD=VGS−VDSV_{\mathrm{GD}} = V_{\mathrm{GS}} - V_{\mathrm{DS}}

      随着 VDSV_{\mathrm{DS}} 的增加,VGDV_{\mathrm{GD}} 会越来越小。这意味吸引电子形成反转层的“有效垂直电场”在漏极端急剧减弱,导致靠近漏极端的沟道厚度越来越薄。

    4. 临界夹断条件:VDS=VGS−VTHV_{\mathrm{DS}} = V_{\mathrm{GS}} - V_{\mathrm{TH}}

      当 VDSV_{\mathrm{DS}} 增加到使漏极端的电位差恰好等于开启电压 VTHV_{\mathrm{TH}} 时,即:

      VGS−VDS=VTH  ⟹  VDS=VGS−VTHV_{\mathrm{GS}} - V_{\mathrm{DS}} = V_{\mathrm{TH}} \implies V_{\mathrm{DS}} = V_{\mathrm{GS}} - V_{\mathrm{TH}}

      此时,漏极极小区域内的垂直电场已经不足以维持该处的电子反转层,沟道在该点厚度变为 0,这就是夹断(Pinch-off)。

    ↩︎
  4. 夹断后为什么还有电流?(进入饱和区)

    很多初学者会误以为“沟道断了,电流就变成了 0”,其实不然:

    • 强电势差(水平电场)的存在:夹断只发生在靠近漏极的一个极窄的“耗尽区/夹断区”。在这个极窄的区域两侧,存在巨大的水平电压差(高强度的水平电场)。
    • 电子“漂移/穿隧”过区:电子从源极出发,沿着未夹断的沟道一路加速到达夹断点;一旦到达夹断点边缘,就会瞬间被该区域极强的水平电场拉(扫)过去,流入漏极。
    • 电流饱和:即使进一步增大 VDSV_{\mathrm{DS}},夹断点只会稍微向源极方向移动一点点(沟道长度调制效应),但未夹断沟道两端的有效电压差始终被“锁死”在 VGS−VTHV_{\mathrm{GS}} - V_{\mathrm{TH}}。因此,通过沟道的电子流量不再随 VDSV_{\mathrm{DS}} 的增加而显著增加,电流达到饱和状态(IDSI_{\mathrm{DS}} 保持恒定)。
    ↩︎
  5. 为什么一定要用两个 MOSFET 做开关?单管不行吗?

    比如只用 NFET:看起来「G=0G{=}0 时断开、G=1G{=}1 时导通」也像开关。这里先分清两种用法的端子角色——二者的 VinV_{\mathrm{in}} / VoutV_{\mathrm{out}} 不是接到同一类引脚:

    模式 输入信号 VinV_{\mathrm{in}} 输出信号 VoutV_{\mathrm{out}} 控制信号
    单管通路开关(pass transistor) D(或 S) S(或 D) G(栅极)
    CMOS 逻辑门(如反相器) G(栅极) D(上/下拉公共漏端) 内部由电源 / 接地经沟道驱动输出

    单管开关里,栅极只作通断控制,信号从源/漏一端传到另一端;CMOS 门里,栅极才是逻辑输入,输出由电源轨经导通管强驱动,并不把输入信号“传”过去。单管开关在特定场景确实存在,但在 CMOS 逻辑中,单管传导存在严重的电压衰减,无法满足数字电路对信号恢复与抗噪的要求。

    1. 单管无法传导“强信号”

      MOSFET 导通取决于 VGS=VG−VSV_{\mathrm{GS}} = V_{\mathrm{G}} - V_{\mathrm{S}} 是否大于阈值 VTHV_{\mathrm{TH}}:

      • NFET 擅长传导低电平(强 0),不擅长传导高电平:栅为 VDDV_{\mathrm{DD}} 时,输出随充电上升,VGS=VDD−VoutV_{\mathrm{GS}} = V_{\mathrm{DD}} - V_{\mathrm{out}} 逐渐减小;当 VoutV_{\mathrm{out}} 升至 VDD−VTHV_{\mathrm{DD}} - V_{\mathrm{TH}} 时 VGS=VTHV_{\mathrm{GS}} = V_{\mathrm{TH}},NFET 关断,停止充电。结果输出最高只能到 VDD−VTHV_{\mathrm{DD}} - V_{\mathrm{TH}}(弱 1)。
      • PFET 擅长传导高电平(强 1),不擅长传导低电平:传导 0 V0\,\mathrm{V} 时,输出降至约 ∣VTH∣|V_{\mathrm{TH}}| 就会提前关断,最低只能到 ∣VTH∣|V_{\mathrm{TH}}|(弱 0)。

      同一结论也可从第 4 节的 IDSI_{\mathrm{DS}}–VDSV_{\mathrm{DS}} 曲线直接读出:固定栅压下,VGSV_{\mathrm{GS}} 越接近 VTHV_{\mathrm{TH}},对应曲线越贴近横轴(IDS→0I_{\mathrm{DS}} \to 0)。NFET 上拉充电时,有效 VGSV_{\mathrm{GS}} 随 VoutV_{\mathrm{out}} 升高而下降,工作点不断跳到更“矮”的曲线,直至 VGS≤VTHV_{\mathrm{GS}} \le V_{\mathrm{TH}} 时电流彻底为 0——曲线上再也没有充电电流,电平卡在 VDD−VTHV_{\mathrm{DD}} - V_{\mathrm{TH}}。PFET 下拉同理。

    2. 信号衰减与级联失效

      若只用单管(如 NFET)做开关:第一级输出已从 VDDV_{\mathrm{DD}} 降到 VDD−VTHV_{\mathrm{DD}} - V_{\mathrm{TH}};把该“弱 1”再送给下一级,输出可能进一步掉到 VDD−2VTHV_{\mathrm{DD}} - 2V_{\mathrm{TH}}。多级串联后电平迅速塌缩,最终逻辑判决失败。

    3. 噪声裕度被破坏

      数字电路靠明确的高低电平界限抵御噪声。完整 CMOS 输出可在 0 V0\,\mathrm{V} 与 VDDV_{\mathrm{DD}} 之间轨到轨摆动,噪声容限大;“弱 1 / 弱 0”会大幅压缩噪声裕度,使电路对电源波动与干扰极为敏感——与第 1 节愿望清单及合法 VTC 的要求相悖。

    4. 解法:互补配对

      • CMOS 逻辑门(上拉 + 下拉):NFET 组只做下拉,把输出接到 GND,提供强 0;PFET 组只做上拉,把输出接到 VDDV_{\mathrm{DD}},提供强 1。二者互补,输出始终是标准的 0 V0\,\mathrm{V} 或 VDDV_{\mathrm{DD}}。
      • 传输门(transmission gate):若需要能双向传信号的独立开关,将 NFET 与 PFET 并联(控制信号互补相位)。导通时低电平靠 NFET(强 0)、高电平靠 PFET(强 1),才接近无阈值损失的“理想开关”。
    ↩︎
  6. 译者注:也就是说,在 tPDt_{\mathrm{PD}} 时间后,输出被保证进入新稳态。 ↩︎

  7. 译者注:也就是说,在 tCDt_{\mathrm{CD}} 时间内,输出被保证依然有效(此时段输入已经无效)。 ↩︎

  8. 译者注:非 CMOS 的 NMOS 逻辑 NOR 门电路示意如下。

    NMOS 逻辑 NOR 门电路图

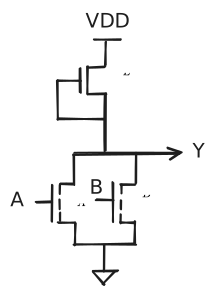
    • 上拉负载(MLM_L):使用耗尽型 NMOS(通道为连贯实线),将其栅极与源极短接(Gate-to-Source Short),使其恒定工作在饱和状态,充当一个高阻值的上拉电阻。
    • 下拉驱动(MAM_A、MBM_B):使用两个增强型 NMOS(通道为断开虚线),它们的漏极(D)并联在一起连接到输出端 YY,源极(S)并联接地。
    • 工作机制:当 AA 或 BB 任意一个为高电平时,对应的增强型晶体管导通,提供一条低阻抗通路将输出 YY 拉低到 GND(0);只有当 AA 和 BB 均输入低电平时,MAM_A 和 MBM_B 全部截止,输出 YY 才会被负载管 MLM_L 上拉至高电平 VDDV_{\mathrm{DD}}(1)。
    ↩︎

整理自 MIT OCW 6.004 Computation Structures(Spring 2017)L02 注解幻灯片。

源网页:2.1 Annotated Slides | The Digital Abstraction

讲师:Chris Terman。图片直接引用 OCW 原站链接。

L02:数字抽象(The Digital Abstraction)

上一讲讨论了如何把信息编码成比特序列。本讲转向:为比特寻找有用的物理表示,这是构建信息处理器件的第一步。

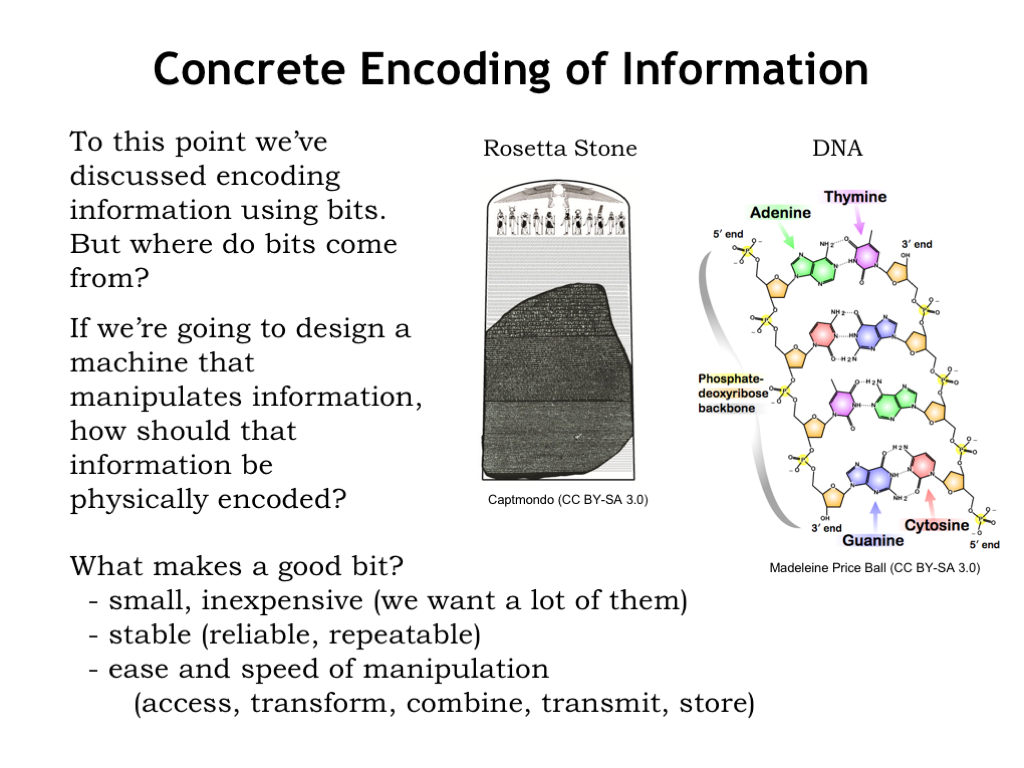
1. 编码信息(Encoding Information)

Encoding Information

好的比特表示应具备哪些性质?

  • 小且便宜:随身携带数十亿比特(如音乐文件),网上还有海量比特可供访问,因此比特必须体积小、成本低。
  • 长期稳定:一旦是 0,就应长期保持为 0。罗塞塔石碑(Rosetta Stone,约公元前 196 年)近 2000 年后仍可辨读——但石刻稳定却难改写。
  • 便于操作:能快速访问、变换、组合、传输与存储所编码的信息。

自然界的启发:DNA 用腺嘌呤(Adenine)、胸腺嘧啶(Thymine)、鸟嘌呤(Guanine)、胞嘧啶(Cytosine)编码遗传信息,分子尺度满足“小”的要求,也有人研究用生命化学做大规模计算。但我们既不想提着黏糊糊的 DNA,也不想带着石凿——那么该用什么表示比特?

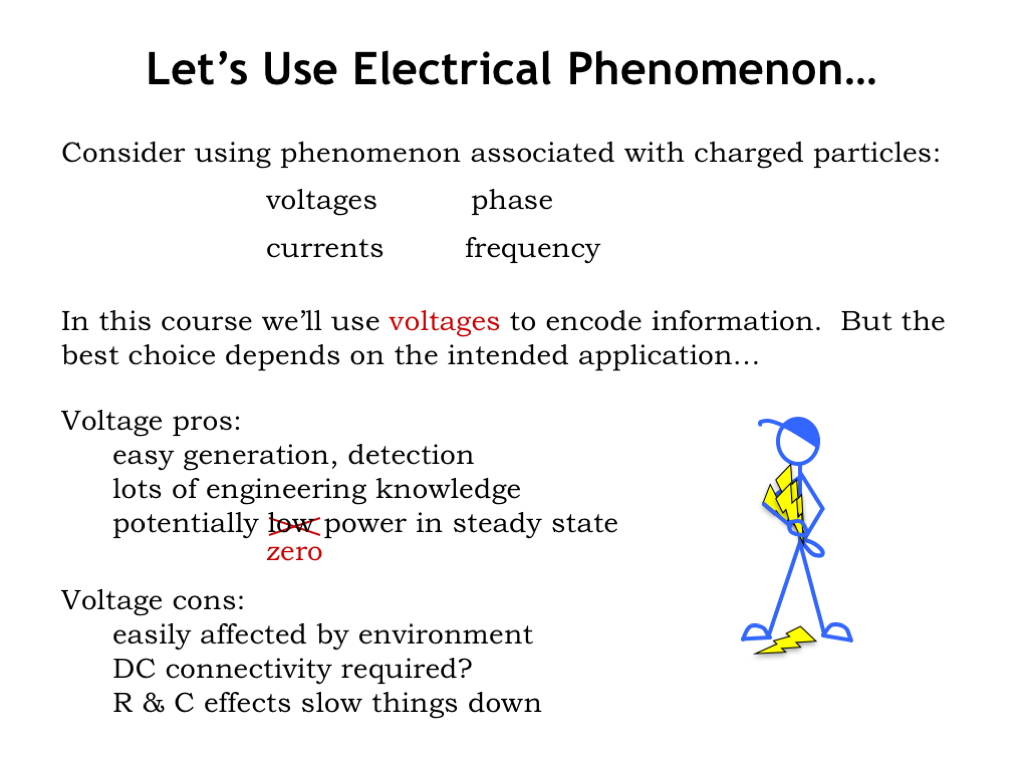
2. 电来救急(Electricity to the Rescue)

Electricity to the Rescue

可用带电粒子相关的电现象表示信息:

  • 电荷造成电势差 → 电压(voltage)
  • 电荷流动 → 电流(current)
  • 电磁场的相位与频率 → 无线通信的基础

本课程用电压表示比特。例如 0 V0\,\mathrm{V} 表示 0,1 V1\,\mathrm{V} 表示 1;比特序列可用多根线上的多路电压,或单线上随时间变化的电压序列。

电压表示的优点:市电与电池供应相对便宜可靠;百余年积累的工程知识使我们能造出极小、极低功耗的存取与处理电路——稳态下信息不变时,功耗可接近零。

挑战:电压易受环境电磁场影响;远距离传输需导线;改变线上电压需时间,由导线的电阻与电容决定 RC 时间常数(现代集成电路中很小,但非零)。这些问题有成熟工程对策。

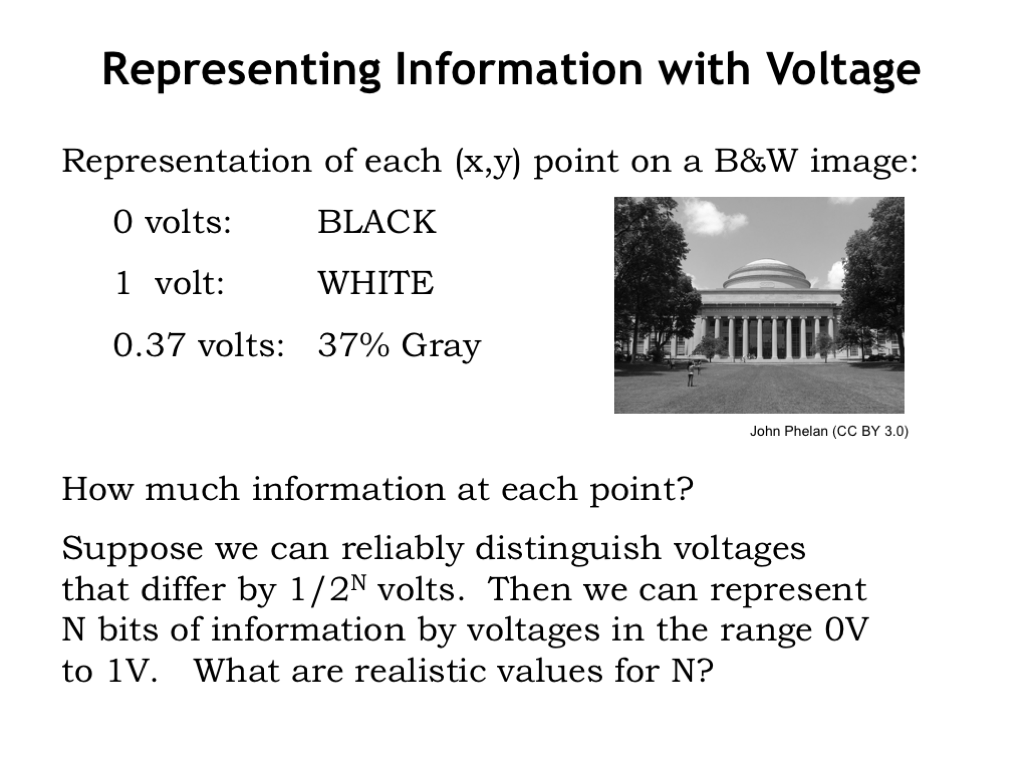
3. 用电压表示信息(Representing Information with Voltage)

Representing Information with Voltage

考虑用电压表示黑白图像:每个 (x,y)(x,y) 点有强度(黑最弱、白最强)。可把强度映到电压,如 0 V0\,\mathrm{V} 为黑、1 V1\,\mathrm{V} 为白,中间强度用中间电压。

每个点含多少信息?取决于能区分多少强度(电压)。若能分辨任意小差异,则每点信息量理论上无穷;工程上可分辨的差异存在下界。

要用 NN 比特表示的信息量,需在 0 V0\,\mathrm{V}–1 V1\,\mathrm{V} 内区分 2N2^N 个电压。例如 N=2N=2 需区分四个电平(如 00、1/31/3、2/32/3、1 V1\,\mathrm{V}),廉价电压表即可。NN 任意大在理论上可行,但微伏乃至纳伏级精度既昂贵又慢,热噪声等还会模糊“瞬时电压”的含义。

因此,电压编码能力受限于能否可靠、快速地区分某一时刻的电压。

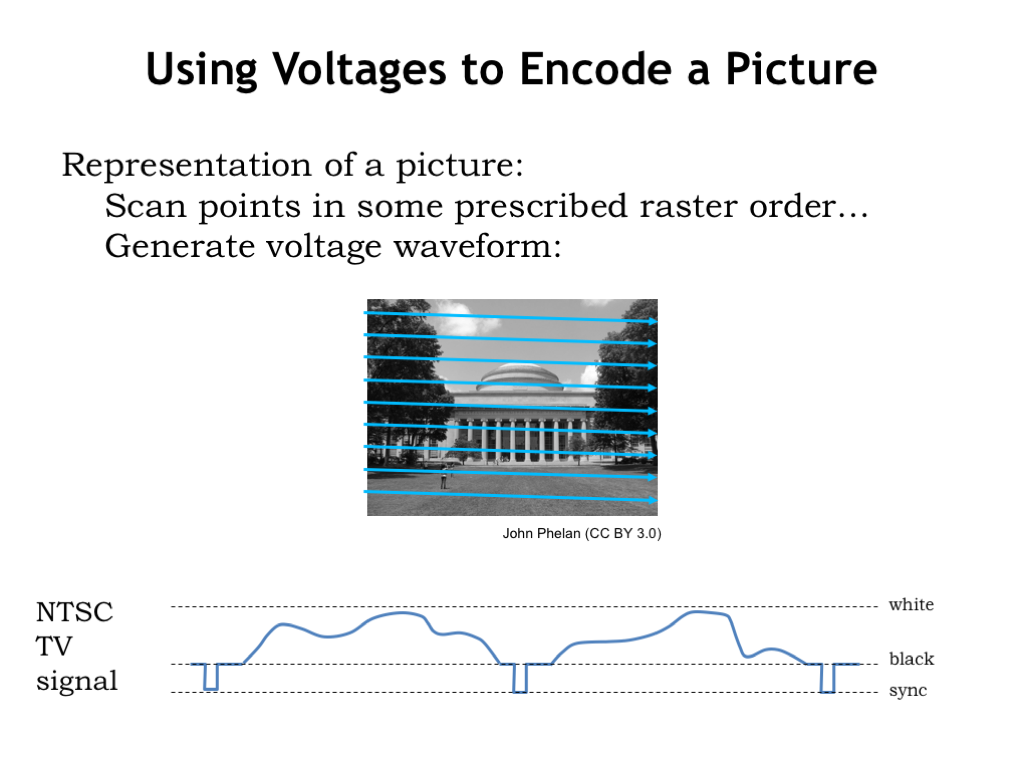
4. 用电压编码一幅图(Using Voltages to Encode a Picture)

Using Voltages to Encode a Picture

按约定光栅顺序(如左→右、上→下)扫描图像,把强度转为电压,得到随时间变化的电压序列。早期电视即如此:画面编成在黑白表示之间变化的电压波形,并扩展电压范围以携带行同步、帧同步等同步信号(sync signals)。这种可取指定范围内任意值的波形称为连续波形(continuous waveform)。

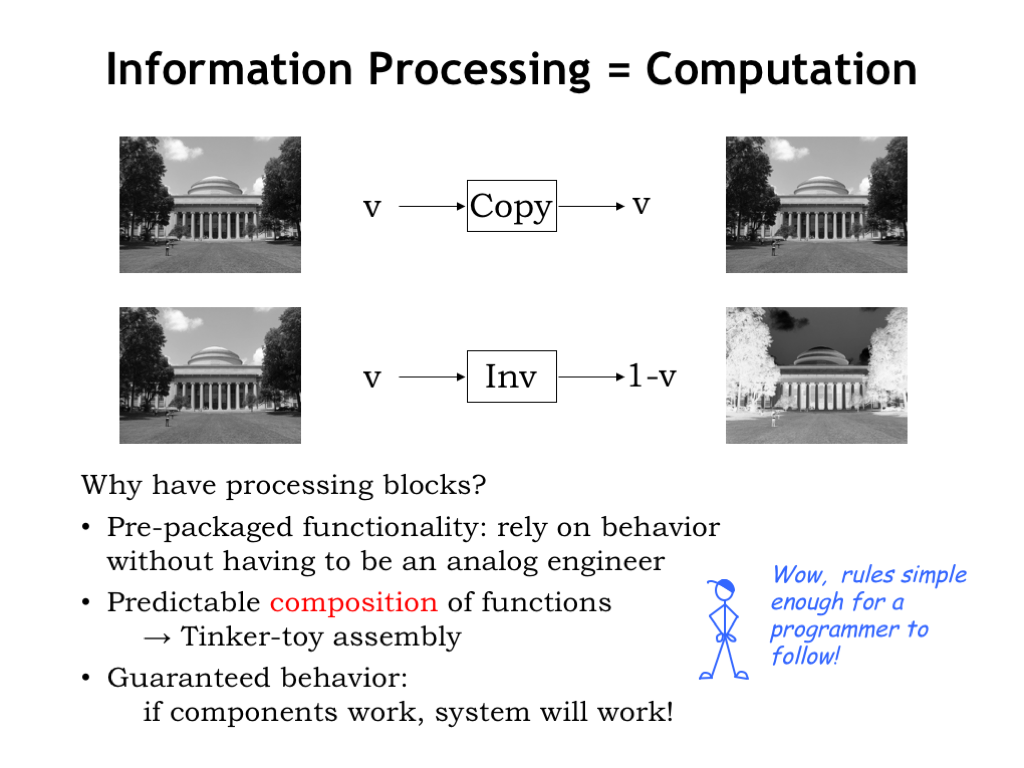
5. 信息处理 = 计算(Information Processing = Computation)

Information Processing = Computation

用两个简单处理模块搭系统:

  • COPY:输出复现输入电压 → 图像不变
  • INVERTING:输入为 VV 时输出 1−V1-V → 黑白反转

使用预封装模块是构建大电路的常见方式:按规则连接即可,无需理解每个模块内部细节;不同配置下也可根据模块行为预测系统行为——像搭积木一样组装,即使不熟悉模拟电路细节的程序员也能搭建处理任务。前提是:组件正确、连接遵守规则时,系统行为应可预期。

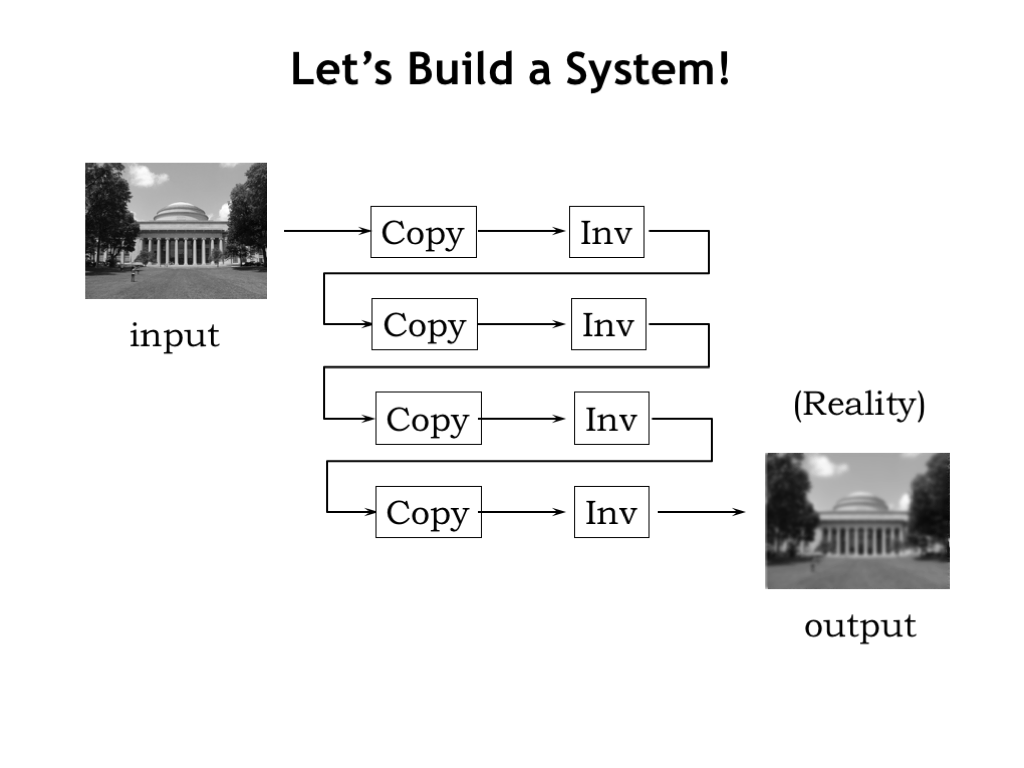
6. 动手搭一个系统!(Let’s Build a System!)

Let's Build a System

用若干 COPY 与 INVERTING 模块组成图像处理系统。COPY 不改图像,INVERTING 为偶数个,理论上输出应与输入相同。

实际上输出略糊:强度有偏差,剧烈变化被抹平。出了什么问题?

7. 系统为何失败?(Why Did Our System Fail?)

Why Did Our System Fail

COPY / INVERTING 很难严格服从数学描述:制造偏差与环境差异使 COPY 对 VV 输入输出 V+εV+\varepsilon,INVERTING 同理。在连续值强度表示下,V+εV+\varepsilon 仍是合法输出——只是对应另一幅略不同的合法图像。我们无法区分“略受损的信号”与“略不同图像的完美信号”。

更致命的是:误差会沿链路累积。系统越大,累积误差越大。若必须限制“还能做多少次计算才结果不可用”,系统将很难扩展。

噪声与不精确不可避免;无法可靠复现无限信息。必须设计系统在允许一定误差时仍能可靠处理信息——要能察觉处理引入的误差,并在误差累积前恢复正确值。这就是下一主题。

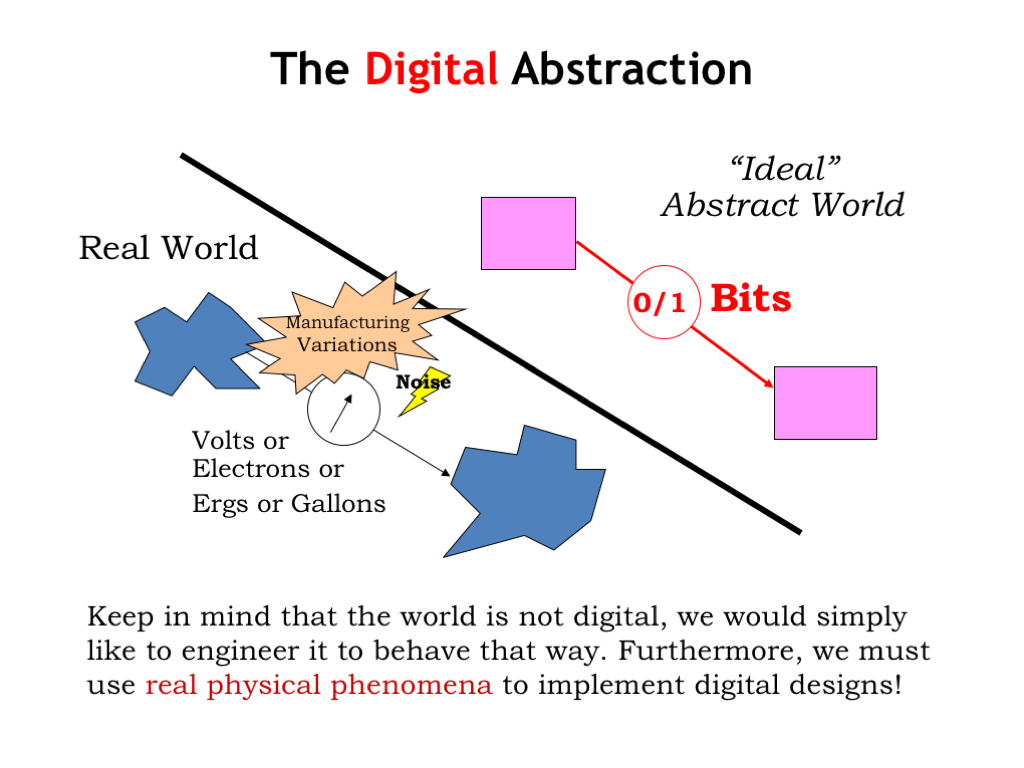
8. 数字抽象(The Digital Abstraction)

The Digital Abstraction

引入数字抽象(digital abstraction):用连续的电压世界表示一个小的有限值集合——此处即二进制的 0 与 1。世界本身并非天生数字;我们是用连续物理现象去工程出数字行为。

旁注:有些物理量天然离散(如电子自旋);量子计算正研究如何利用量子物理做计算。本课程聚焦于如何用经典连续现象构建数字系统。

9. 用电压做数字表示(Using Voltages Digitally)

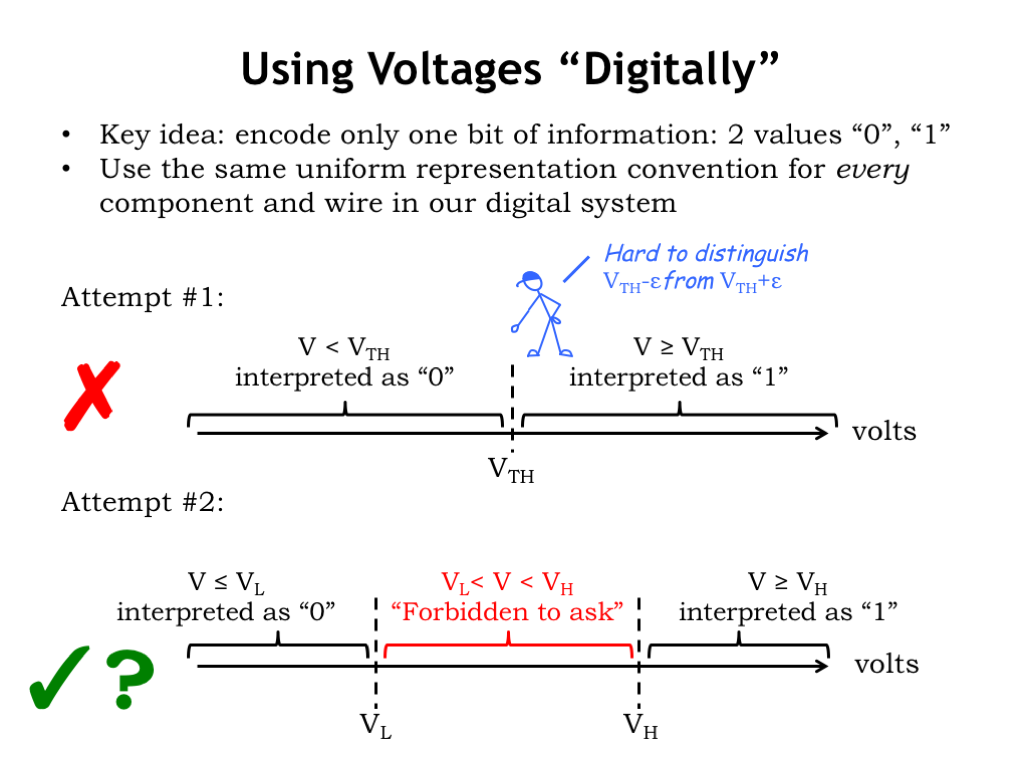
Using Voltages Digitally

核心:约定信令,每次只编码 1 比特(0 或 1),系统中各组件与导线使用统一表示。到达可用方案需三轮尝试。

第一版:用阈值 VthV_{\mathrm{th}} 把电压范围一分为二——V<VthV < V_{\mathrm{th}} 为 0,V≥VthV \ge V_{\mathrm{th}} 为 1。数学上简洁,但阈值附近的电压极难可靠判读:电路需精密元件与严格受控环境,与低成本、多环境使用目标不符。→ 不可行(大红叉)。

第二版:引入两个阈值 VLV_{\mathrm{L}}、VHV_{\mathrm{H}}:

  • V≤VLV \le V_{\mathrm{L}} → 解释为 0
  • V≥VHV \ge V_{\mathrm{H}} → 解释为 1
  • VLV_{\mathrm{L}} 与 VHV_{\mathrm{H}} 之间为禁区(forbidden zone):系统可将该区电压解为 0 或 1,不必一致,甚至可不给出解释

这样可用高增益运放加禁区内粗略参考电压做“快而糙”的电压→比特转换;参考不必极准(如 10% 精度电阻分压),温度与电源漂移也可容忍——只需保证在 VLV_{\mathrm{L}} 以下或 VHV_{\mathrm{H}} 以上时行为正确。→ 暂给绿勾;稍后再做一次小修正。

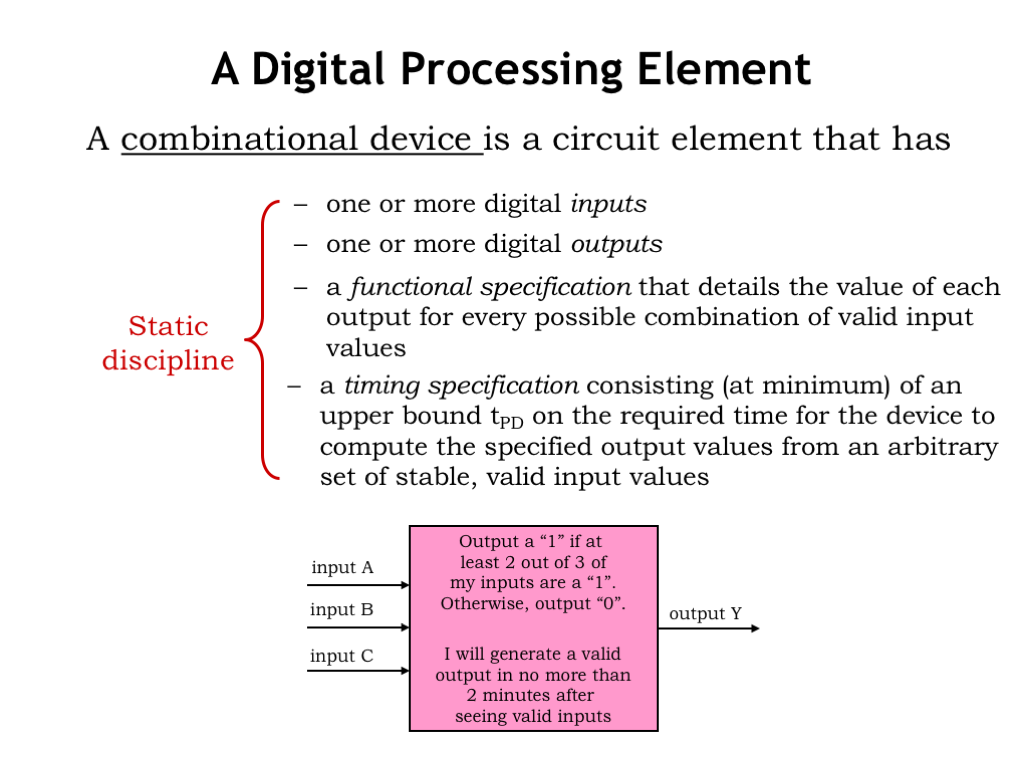
10. 组合器件(Combinational Devices)

Combinational Devices

满足以下四条的器件称为组合器件(combinational device):

  1. 数字输入:按信令约定,V≤VLV \le V_{\mathrm{L}} 为 0,V≥VHV \ge V_{\mathrm{H}} 为 1
  2. 数字输出:输出 0 时电压 ≤VL\le V_{\mathrm{L}},输出 1 时电压 ≥VH\ge V_{\mathrm{H}}
  3. 功能规格:对每种可能的数字输入组合,规定各输出的值(例:三输入有 23=82^3=8 种组合,可用 8 行真值表)
  4. 时序规格:至少给出传播延迟(propagation delay)tPDt_{\mathrm{PD}}——从输入到达稳定有效数字值,到输出保证稳定有效的时间上界

合称静态纪律(static discipline),所有组合器件必须遵守。

11. 组合数字系统(A Combinational Digital System)

A Combinational Digital System

由组合组件组成更大组合系统的规则:

  1. 每个组件本身是组合器件
  2. 每个组件的每个输入:接系统输入、恰好接另一器件的一个输出,或接表示 0/1 的恒定电压
  3. 互连无有向环——从系统输入到输出的路径中,任一组件最多出现一次

主张:按此规则构建的系统本身也是组合器件;系统可任意大,仍服从静态纪律(不同于本节开头脆弱的模拟链路)。

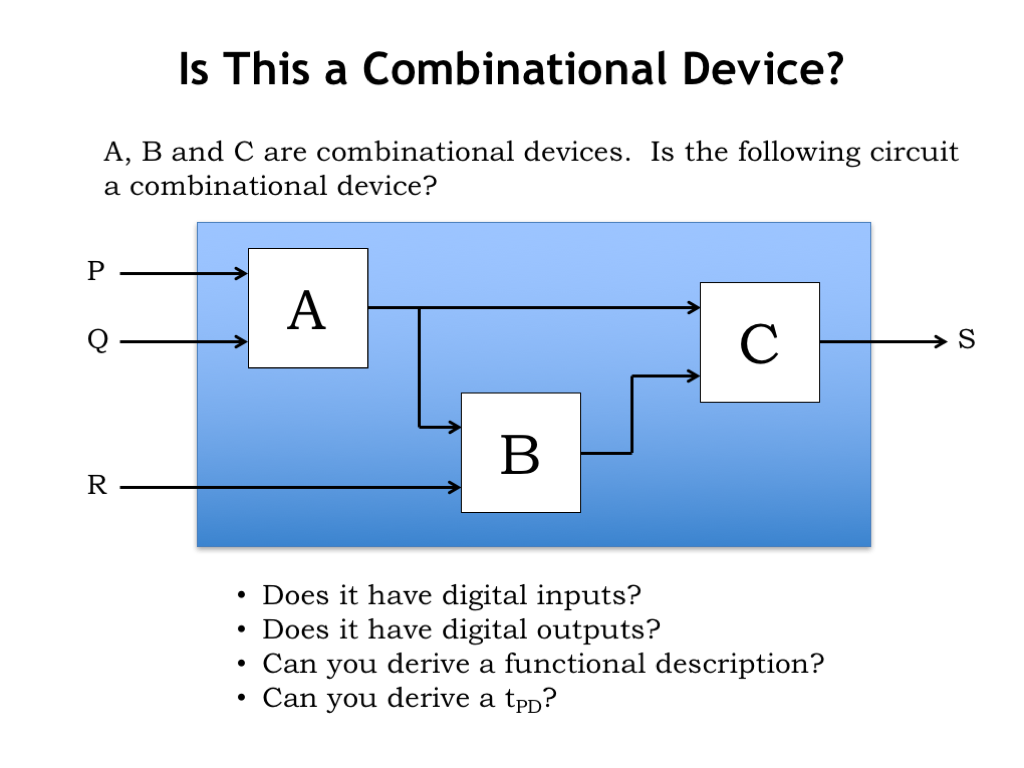
12. 这是组合器件吗?(Is This a Combinational Device?)

Is This a Combinational Device

以由组合器件 A、B、C 组成的系统为例,验证整体是否服从静态纪律:

  1. 数字输入? 是——系统输入即某些组件的输入,组件组合 ⇒ 系统输入数字。
  2. 数字输出? 是——同理由组件继承。
  3. 功能规格? 可——无环,按拓扑顺序用各组件功能规格逐步求出内部信号与输出。
  4. tPDt_{\mathrm{PD}}? 可——枚举输入到输出的有限路径,路径延迟为沿途各组件 tPDt_{\mathrm{PD}} 之和;系统 tPDt_{\mathrm{PD}} 取所有路径中的最大值(最长路径)。

因此整体是组合器件。可用组合规则构建任意复杂度的组合器件。

13. 应对噪声(Dealing With Noise)

Dealing With Noise

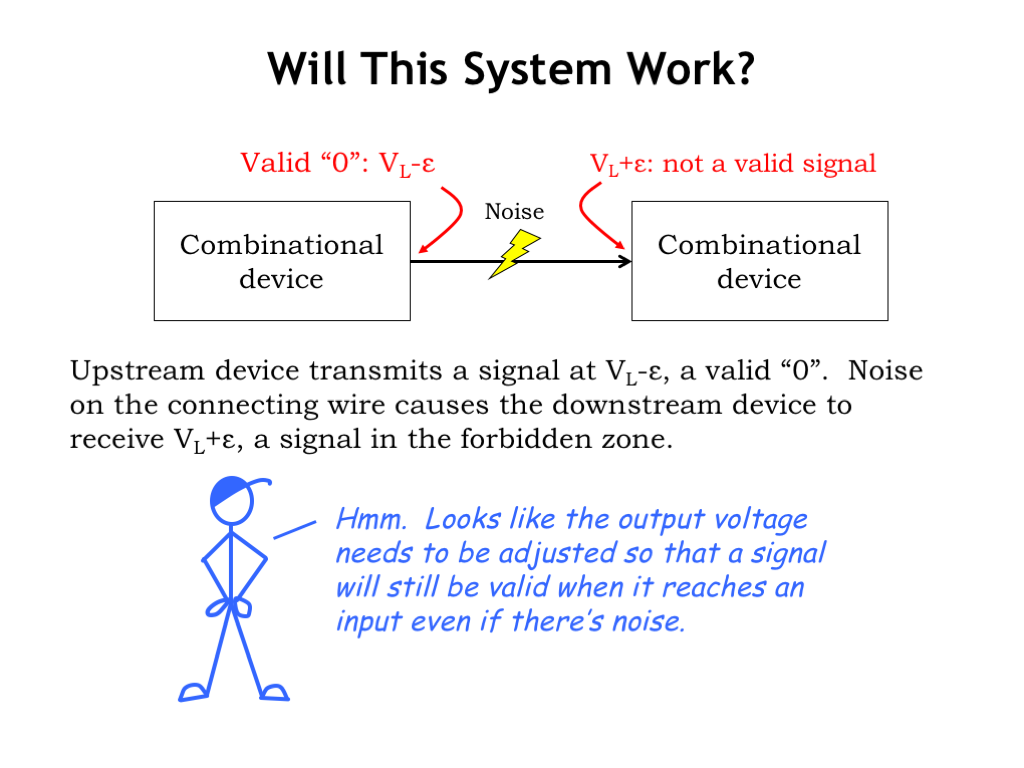
定稿信令前还有问题:上游器件输出略低于 VLV_{\mathrm{L}} 的合法 0;线上噪声使下游看到略高于 VLV_{\mathrm{L}} 的电压——不再是有效数字输入,下游组合行为不再有保证。

对策:让输出约束严于输入——合法输出可叠加一定噪声后,仍落在合法输入范围内。能否靠“消灭噪声”一劳永逸?用电学组件时做不到。

14. 噪声从哪来?(Where Does Noise Come From?)

Where Does Noise Come From

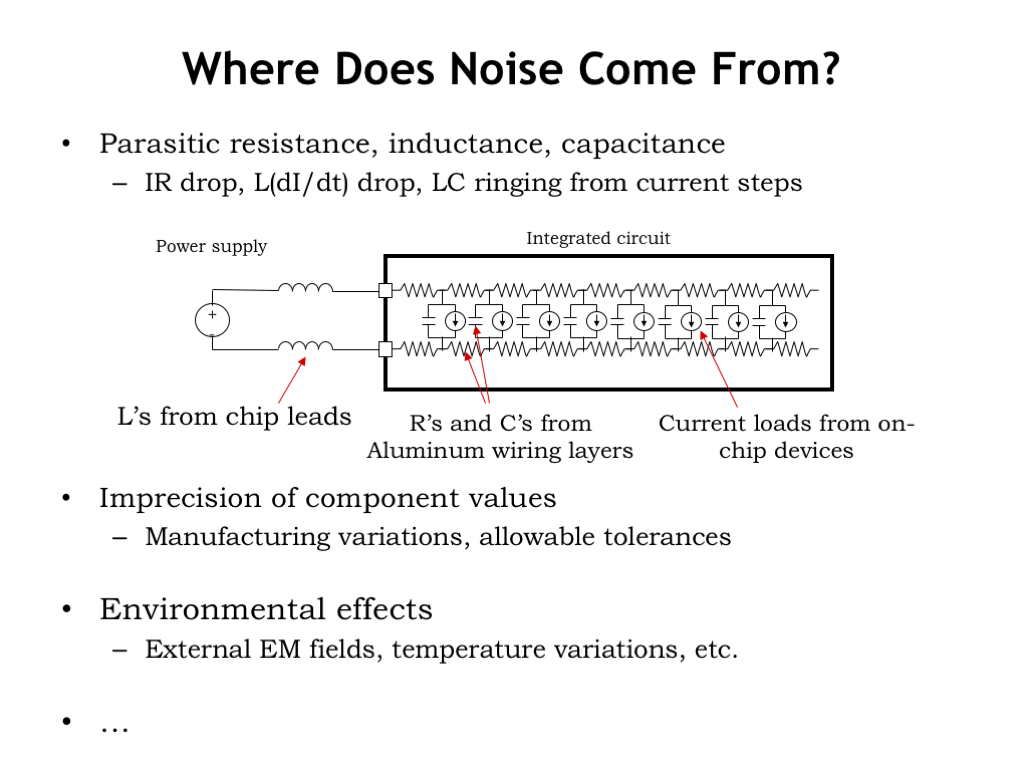
电压噪声(偏离标称电压)来源包括:

  • 电学效应:导体 IR 压降(欧姆定律)、导体间电容耦合、引线电感与变电流引起的 L(dI/dt)L(\mathrm{d}I/\mathrm{d}t) 等
  • 制造偏差:器件参数相对标称值的偏差导致器件间电学行为差异
  • 环境因素:热噪声、外部电磁场等

许多噪声来自电路正常工作或材料/工艺固有性质,无法消除;但可估计幅度并相应调整信令规格。

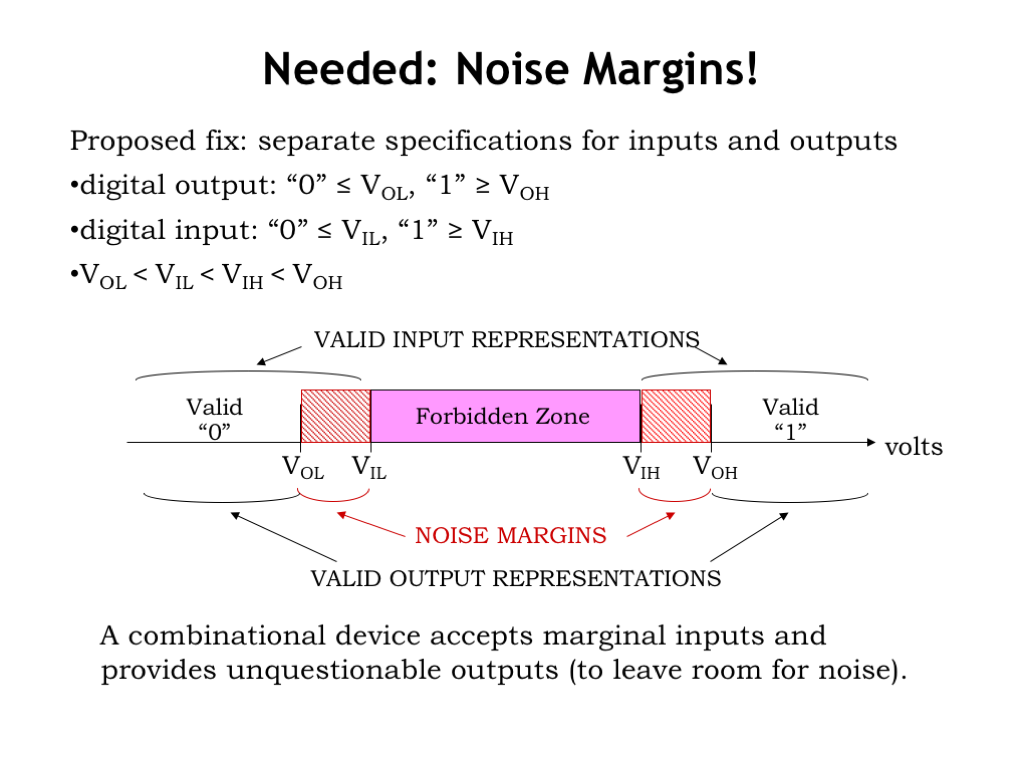
15. 噪声容限(Noise Margins)

Noise Margins

最终信令:输入与输出使用不同阈值。

输出:

  • 送出 0:电压 ≤VOL\le V_{\mathrm{OL}}
  • 送出 1:电压 ≥VOH\ge V_{\mathrm{OH}}

输入:

  • 电压 ≤VIL\le V_{\mathrm{IL}} → 解释为 0
  • 电压 ≥VIH\ge V_{\mathrm{IH}} → 解释为 1

约束:VILV_{\mathrm{IL}} 严格大于 VOLV_{\mathrm{OL}},VIHV_{\mathrm{IH}} 严格小于 VOHV_{\mathrm{OH}}。输入与输出阈值之间的间隙称为噪声容限(noise margins):

  • 低噪声容限:VIL−VOLV_{\mathrm{IL}} - V_{\mathrm{OL}}
  • 高噪声容限:VOH−VIHV_{\mathrm{OH}} - V_{\mathrm{IH}}

二者中较小者称为该信令规格的噪声免疫(noise immunity)。服从该规格的组合器件会在误差累积前“清洗”输入噪声——数字信令不再重蹈前文模拟例子的覆辙。

16. 电压传输特性(Voltage Transfer Characteristic)

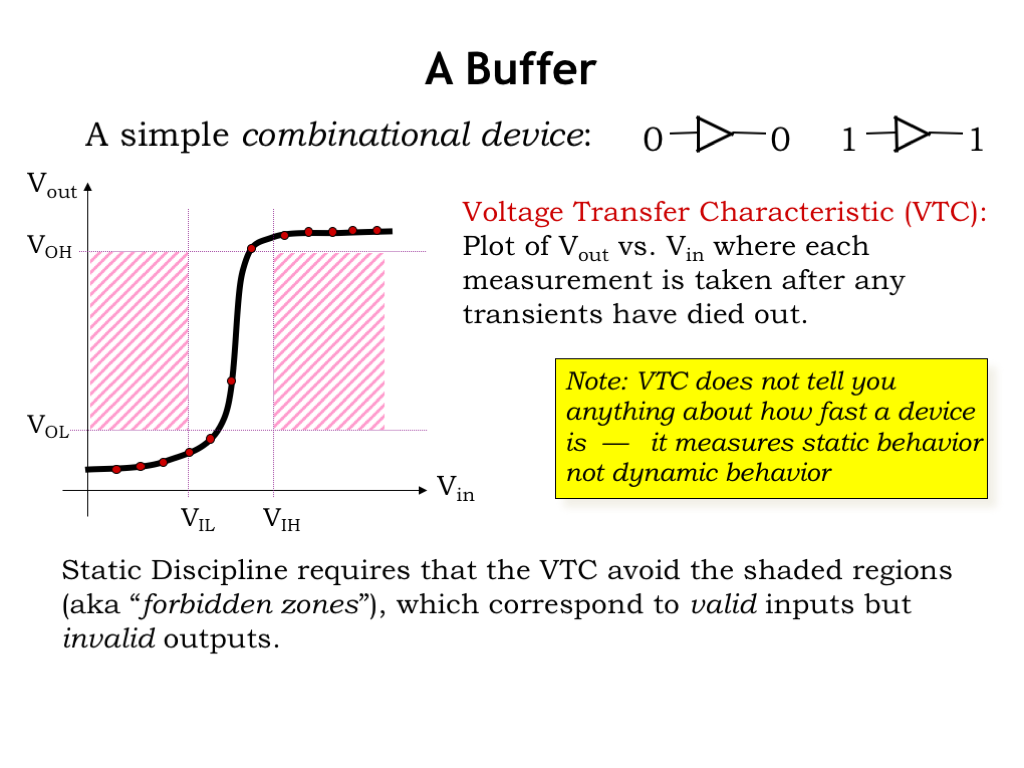
Voltage Transfer Characteristic

以最简单的组合器件——缓冲器(buffer,单输入单输出,输出经传播延迟后复现输入数字值)为例测量。它服从静态纪律,并使用含高低噪声容限的修订信令。

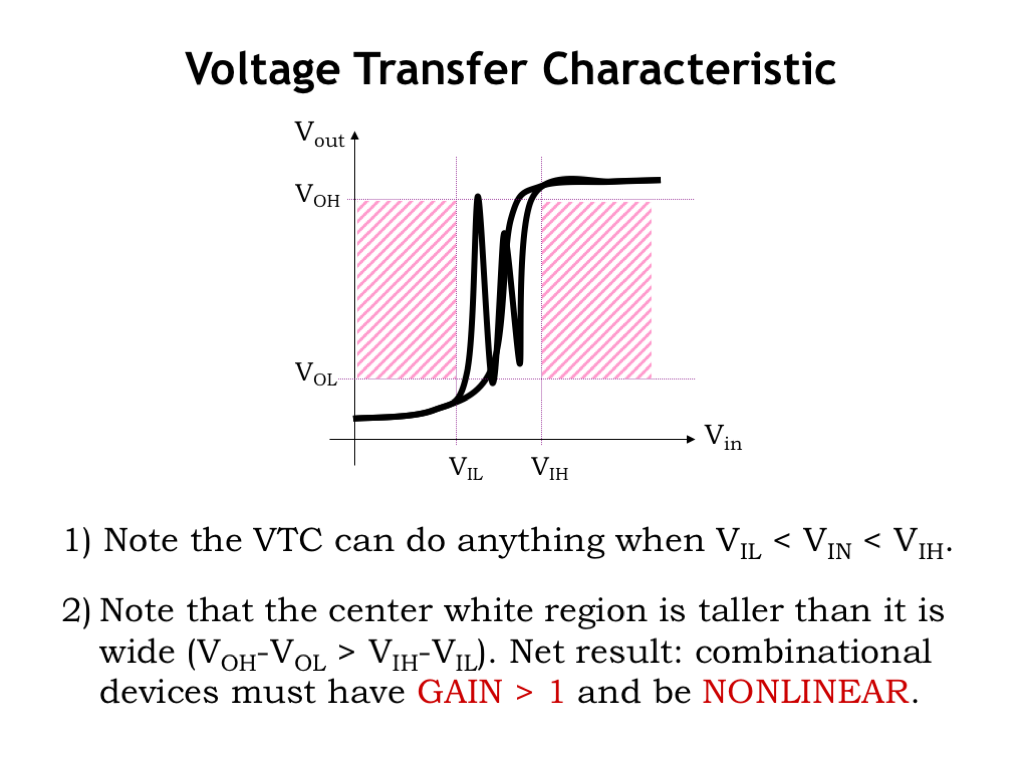
测量:将输入设为从 0 V0\,\mathrm{V} 到电源电压的一系列值,每次等待输出稳定(即等满 tPDt_{\mathrm{PD}}),在横轴 VINV_{\mathrm{IN}}、纵轴 VOUTV_{\mathrm{OUT}} 上描点,得到电压传输特性(voltage transfer characteristic, VTC)。

静态纪律约束合法组合器件的 VTC:有效输入必须产生有效输出(“valid in, valid out”)。图上可标出禁区——有效数字输入却对应无效数字输出;合法器件的 VTC 不得落入这些区域。缓冲器的实测曲线(黑线)不穿过阴影区,符合要求。这些测量刻画的是静态行为,不直接给出速度。

17. VTC 推论(VTC Deductions)

VTC Deductions

关于 VTC 的两点观察:

  1. 中心白色区域对应输入在 VILV_{\mathrm{IL}}–VIHV_{\mathrm{IH}}(禁区)。静态纪律只约束有效输入,禁区输入下输出可任意。
  2. 由正噪声容限,VOH−VOLV_{\mathrm{OH}} - V_{\mathrm{OL}} 严格大于 VIH−VILV_{\mathrm{IH}} - V_{\mathrm{IL}},故中心白区高大于宽。穿过该区的曲线必有一段斜率绝对值 大于 1——输入小变化引起输出更大变化,即器件增益(gain)>1>1 或 <−1<-1。

若组件可互连,则 VINV_{\mathrm{IN}} 与 VOUTV_{\mathrm{OUT}} 范围相同,VTC 图画在正方形内。因存在 ∣斜率∣>1|\text{斜率}|>1 的区段,又不能全程 ∣斜率∣>1|\text{斜率}|>1,曲线斜率必须改变——这种器件称为非线性器件(nonlinear devices)。

结论:仅用电阻、电容、电感等线性器件无法构成组合器件;需要增益 >1>1 的非线性器件。寻找这类器件是下一讲主题。

18. VTC 实例(VTC Example)

VTC Example

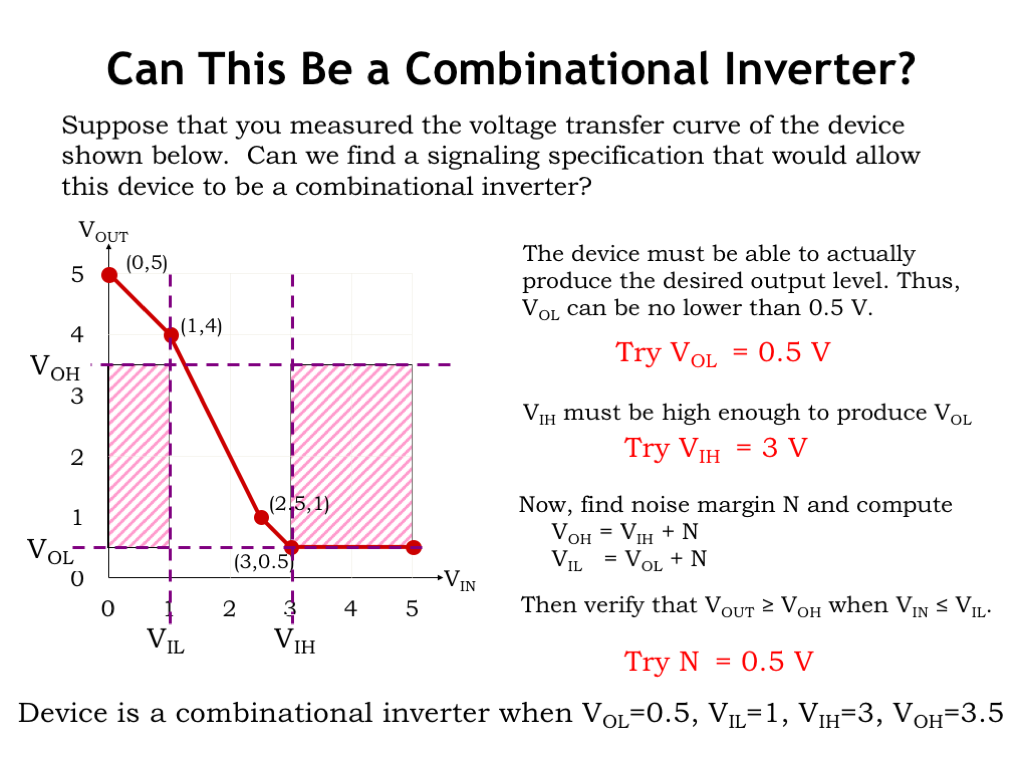
给定某器件的 VTC,能否选 VOLV_{\mathrm{OL}}、VILV_{\mathrm{IL}}、VIHV_{\mathrm{IH}}、VOHV_{\mathrm{OH}} 使其成为合法组合反相器?

反相器:数字 0 入 → 数字 1 出,反之亦然。该器件低输入时输出高,有希望。

选取示例:

  • 器件最低输出约 0.5 V0.5\,\mathrm{V} ⇒ 取 VOL≥0.5 VV_{\mathrm{OL}} \ge 0.5\,\mathrm{V}(取 0.5 V0.5\,\mathrm{V})
  • 输入高于约 3 V3\,\mathrm{V} 时输出 ≤VOL\le V_{\mathrm{OL}} ⇒ 取 VIH=3 VV_{\mathrm{IH}} = 3\,\mathrm{V}(尽量低以留高噪声容限)
  • 设噪声容限 N=0.5 VN = 0.5\,\mathrm{V},则 VIL=VOL+N=1 VV_{\mathrm{IL}} = V_{\mathrm{OL}} + N = 1\,\mathrm{V},VOH=VIH+N=3.5 VV_{\mathrm{OH}} = V_{\mathrm{IH}} + N = 3.5\,\mathrm{V}

在图上标出阈值与禁区后,VTC 合法。因此可用规格 VOL=0.5 VV_{\mathrm{OL}}=0.5\,\mathrm{V}、VIL=1 VV_{\mathrm{IL}}=1\,\mathrm{V}、VIH=3 VV_{\mathrm{IH}}=3\,\mathrm{V}、VOH=3.5 VV_{\mathrm{OH}}=3.5\,\mathrm{V} 把该器件当作组合反相器。

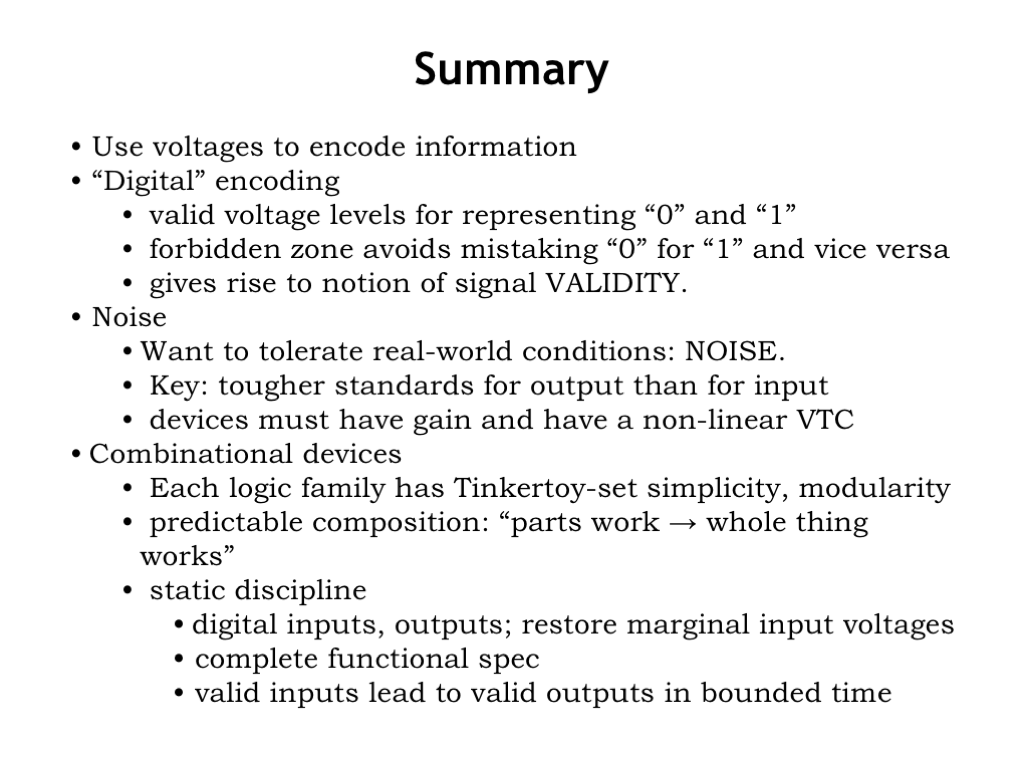
19. 小结(Summary)

Summary

本讲要点:

  • 用电压表示信息可行,但连续模拟链路中误差会累积,难以扩展
  • 数字抽象:用连续电压只表示有限符号(0/1),并引入禁区与统一信令
  • 组合器件服从静态纪律:数字 I/O、功能规格、传播延迟 tPDt_{\mathrm{PD}}
  • 组合组件按规则(无环等)互连 → 更大组合系统
  • 输入/输出分离阈值 → 噪声容限,抗噪声累积
  • 合法组合器件的 VTC 避开禁区,且必含增益 >1>1 的非线性区段;下一讲寻找可用的物理器件(CMOS)

整理自 MIT OCW 6.004 Computation Structures(Spring 2017)L01 注解幻灯片。

源网页:1.1 Annotated Slides | Basics of Information

讲师:Chris Terman。图片直接引用 OCW 原站链接。

L01:信息基础(Basics of Information)

本讲从工程视角定义信息与不确定性,引入 Shannon 信息量与熵,讨论定长/变长编码、Huffman、整数与补码表示,以及 Hamming 距离下的检错与纠错。

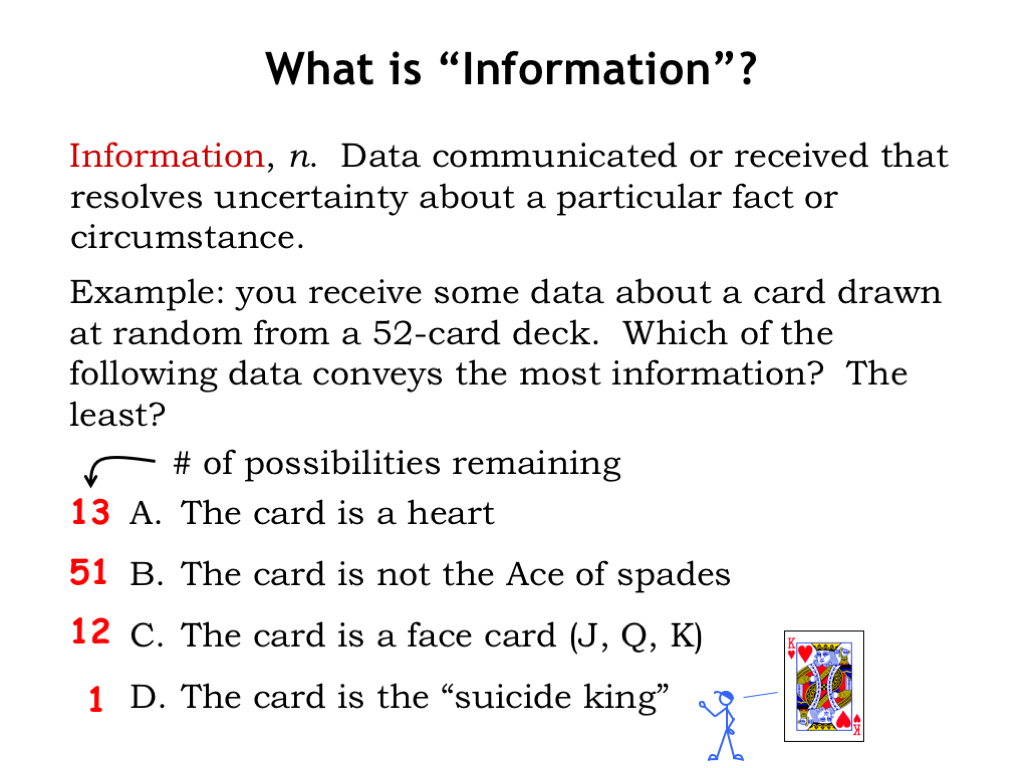
1. 什么是信息?(What is Information?)

What is Information

工程定义:信息 = 被传送或接收、并能消除关于某事实/情形之不确定性的数据。消除的不确定性越大,传达的信息越多。

例:从 52 张牌中随机抽一张。无任何数据时有 52 种可能。若得知:

  • 是红心 → 剩 13 种
  • 不是黑桃 A → 剩 51 种
  • 是人头牌(J/Q/K)→ 剩 12 种
  • 是“自杀国王”(红心 K)→ 完全确定

哪条数据信息量最大/最小?下节用公式回答。

2. 量化信息(Quantifying Information)

Quantifying Information

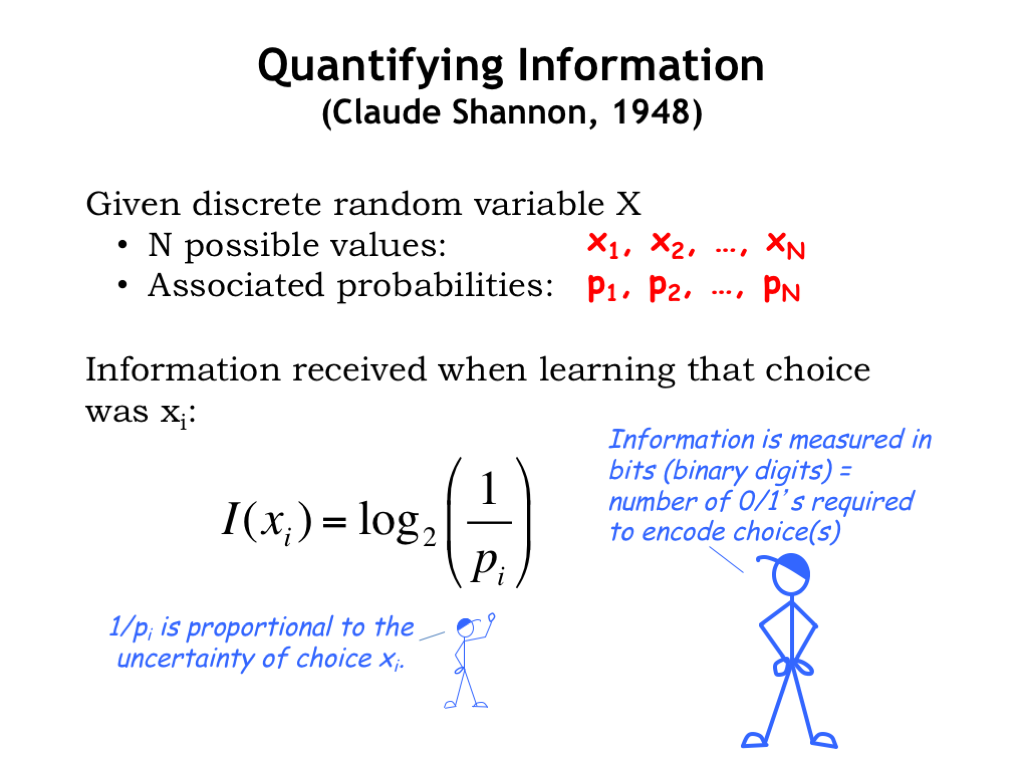
用离散随机变量 XX 建模:可取 NN 个值 {x1,…,xN}\{x_1,\ldots,x_N\},概率分别为 p1,…,pNp_1,\ldots,p_N。概率越小,该取值越不确定。

Shannon 定义:得知 X=xiX=x_i 时收到的信息量为

I(xi)=log⁡21pi bits.I(x_i)=\log_2\frac{1}{p_i}\ \textrm{bits}.

1/pi1/p_i 刻画不确定性;log⁡2\log_2 把度量落到 bit(可取 0/1 的量)。可把信息量理解为“编码该选择所需的比特数”。

3. 数据传达的信息(Information Conveyed by Data)

Information Conveyed by Data

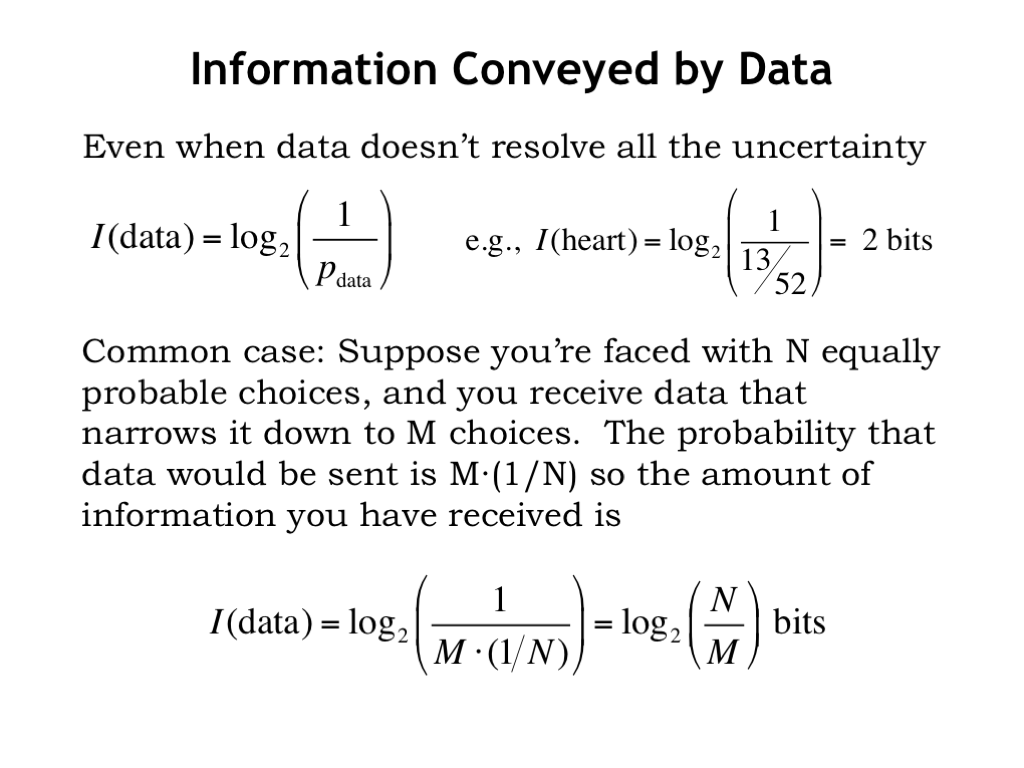
数据未必消除全部不确定性。推广为

I(data)=log⁡21pdata bits.I(\textrm{data})=\log_2\frac{1}{p_{\textrm{data}}}\ \textrm{bits}.

例:得知是红心,p=13/52=0.25p=13/52=0.25,

I(heart)=log⁡210.25=2 bits.I(\textrm{heart})=\log_2\frac{1}{0.25}=2\ \textrm{bits}.

等概 NN 种选择被缩到 MM 种时:p=M/Np=M/N,

I(N→M)=log⁡2NM bits.I(N\rightarrow M)=\log_2\frac{N}{M}\ \textrm{bits}.

4. 信息量例子(Example: Information Content)

Example: Information Content
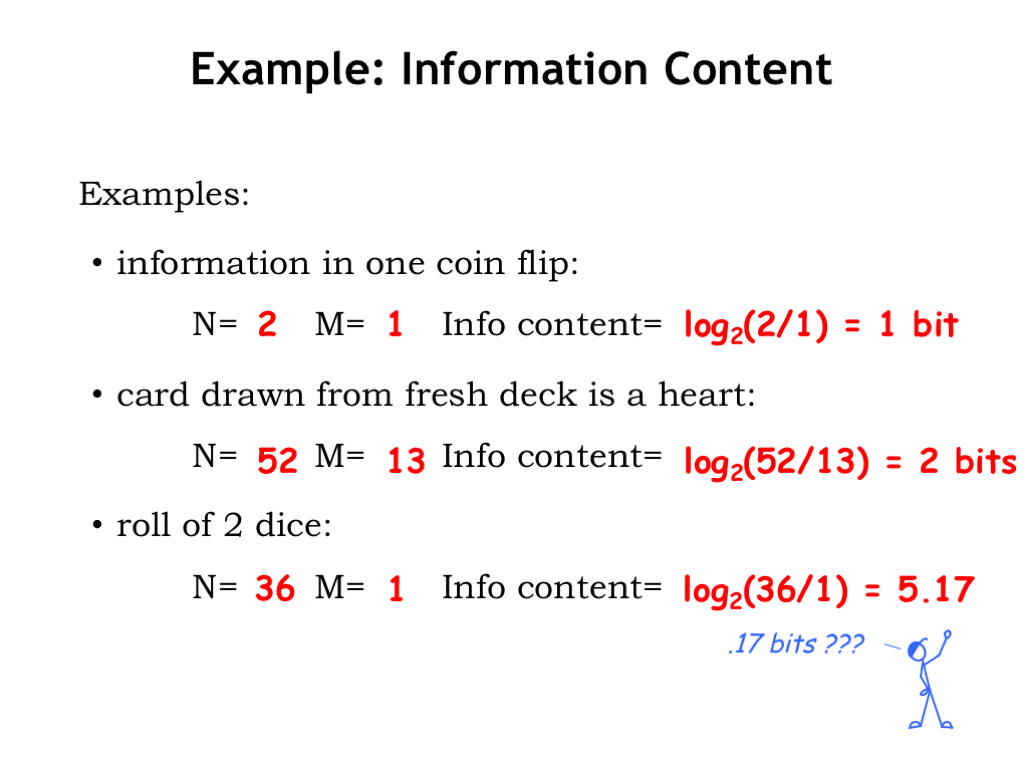
  • 公平硬币正反面:2→12\to 1 → log⁡2(2/1)=1\log_2(2/1)=1 bit
  • 抽牌得知红心:52→1352\to 13 → log⁡2(52/13)=2\log_2(52/13)=2 bits
  • 两枚骰子(红+绿)36 种结果:36→136\to 1 → log⁡236≈5.17\log_2 36\approx 5.17 bits

分数比特含义:单次结果数字系统需用整比特(如 6 bit);但若记录 10 次投掷,公式说总共约 52 bit 即可无损编码,而非 10×6=6010\times 6=60——能否达到下界是编码问题。

5. 概率与信息量(Probability and Information Content)

Probability and Information Content

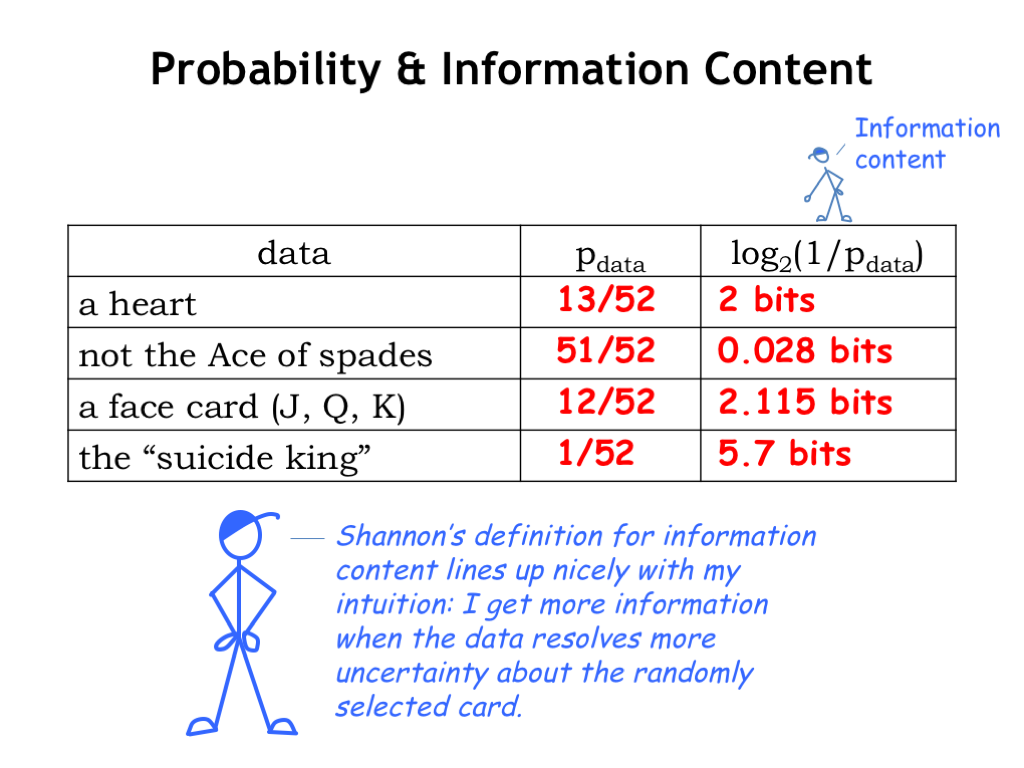
回到抽牌例子:表格列出各数据事件的概率与信息量,与直觉一致——消除不确定性越多,信息量越大。自杀国王信息量最大;“不是黑桃 A”信息量最小。

6. 熵(Entropy)

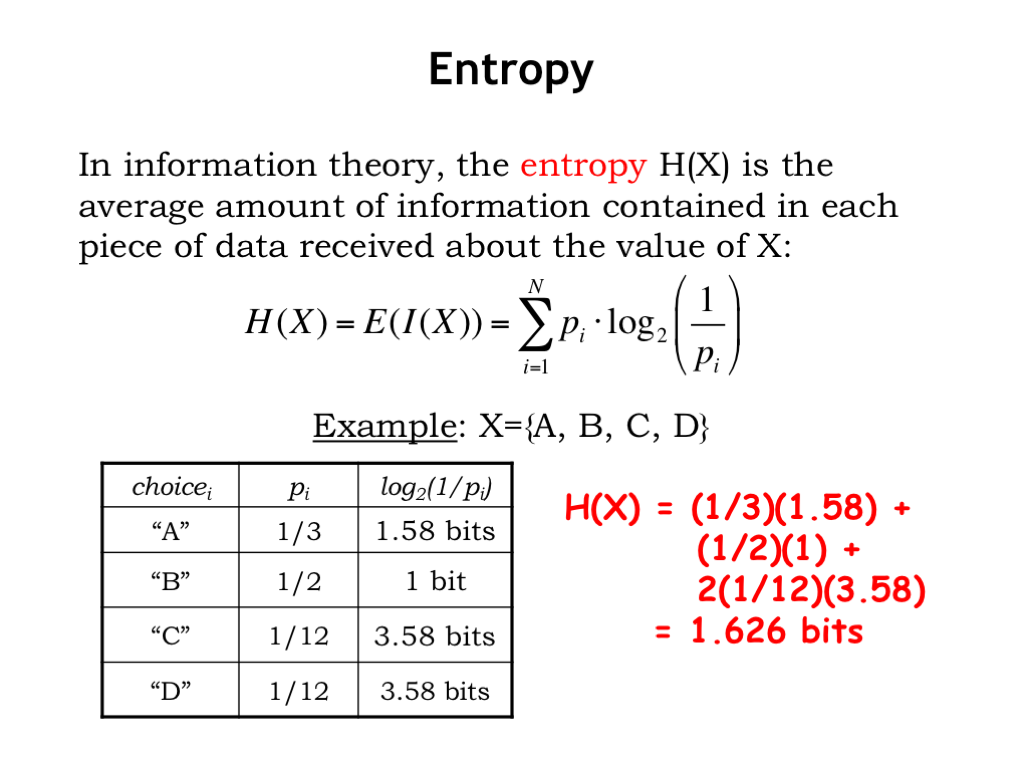
Entropy

离散随机变量 XX 的熵 H(X)H(X) 是得知 XX 取值时的平均信息量:

H(X)=E(I(X))=∑ipilog⁡21pi.H(X)=E(I(X))=\sum_i p_i\log_2\frac{1}{p_i}.

例:{A,B,C,D}\{A,B,C,D\} 概率分别为 1/3,1/2,1/12,1/121/3,1/2,1/12,1/12,

H(X)=(1/3)(1.58)+(1/2)(1)+(1/12)(3.58)+(1/12)(3.58)=1.626 bits.H(X)=(1/3)(1.58)+(1/2)(1)+(1/12)(3.58)+(1/12)(3.58)=1.626\ \textrm{bits}.

提示:聪明编码平均可比“每符号固定 2 bit”更短。

7. 熵的含义(Meaning of Entropy)

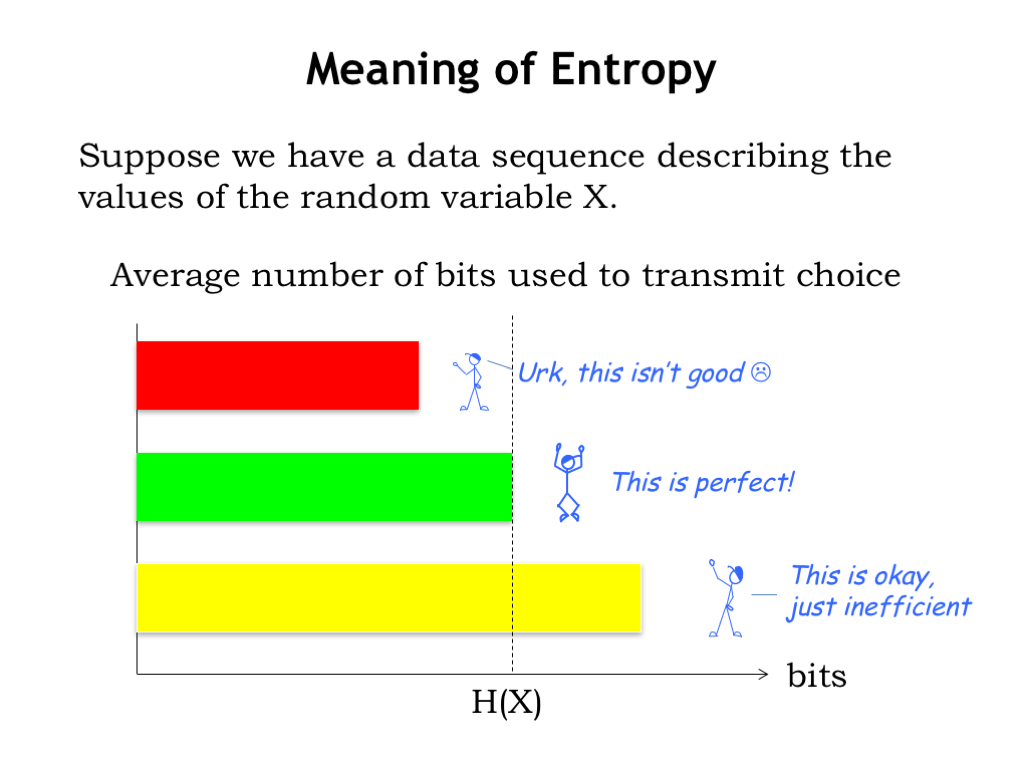
Meaning of Entropy

对 XX 的取值序列:

  • 平均每符号少于 H(X)H(X) bit → 不足以消除不确定性(无法无歧义描述)
  • 平均多于 H(X)H(X) bit → 资源未用尽,可能还能压缩
  • 恰好 H(X)H(X) → 理想编码(实践上多求接近)

熵是无歧义传输所需比特数的下界。

8. 编码(Encodings)

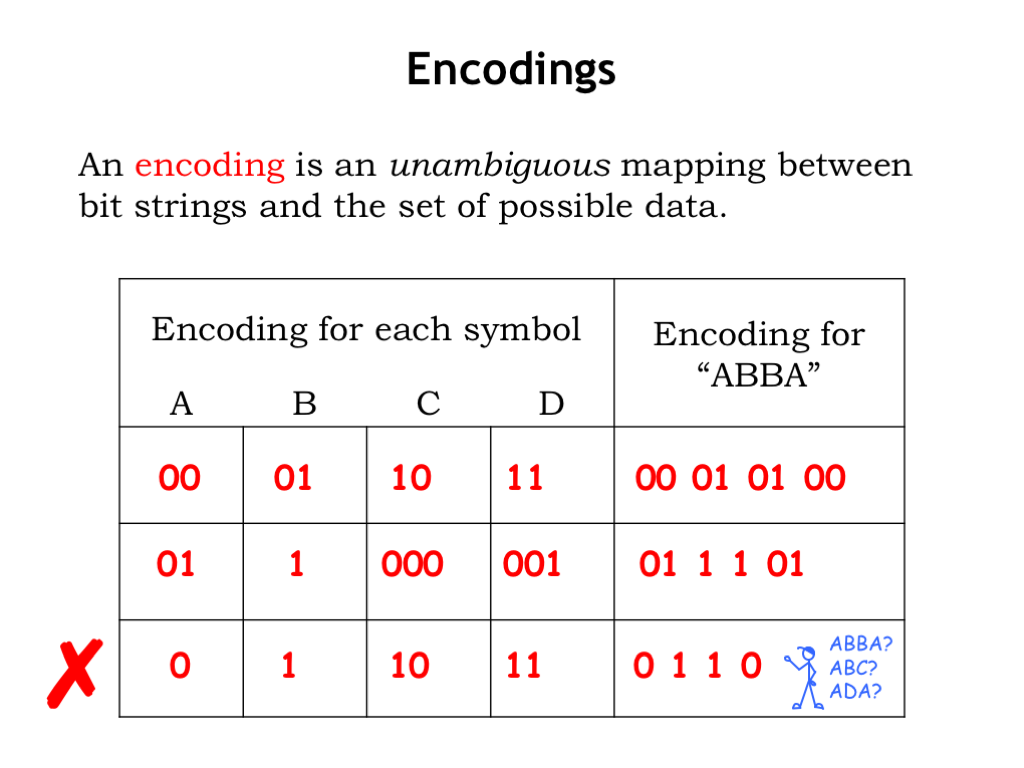
Encodings

编码 = 比特串与待编码集合元素之间的无歧义映射。

  • 定长编码(fixed-length):如 A=00, B=01, C=10, D=11;“ABBA”→ 00 01 01 00
  • 变长编码(variable-length):如 A=01, B=1, C=000, D=001;适合概率不均
  • 坏例子:A=0, B=1, C=10… → “ABBA”编成 0110 可解成 ABBA / ADA / ABC 等多种 → 有歧义,非法编码

9. 编码与二叉树(Encodings as Binary Trees)

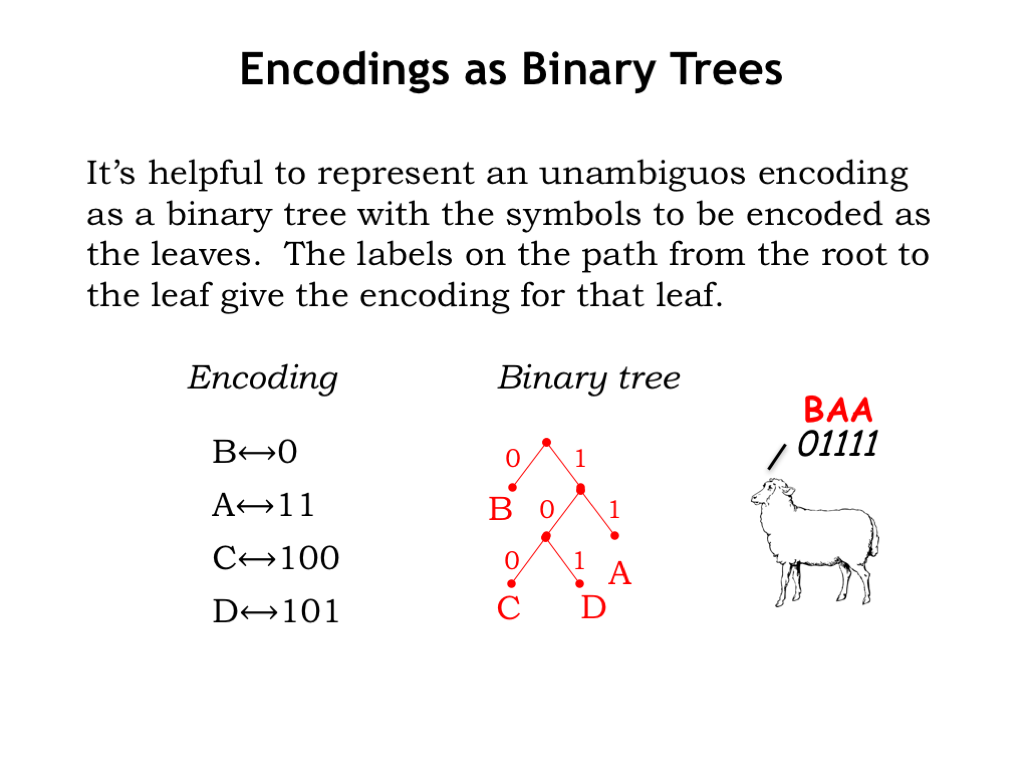
Encodings as Binary Trees

无歧义编码 ↔ 二叉树:边标 0/1,符号只在叶子;内部节点无符号。

解码:从根出发,按比特下行到叶子输出符号,再回根继续。例:01111 → B, A, A(“BAA”)。

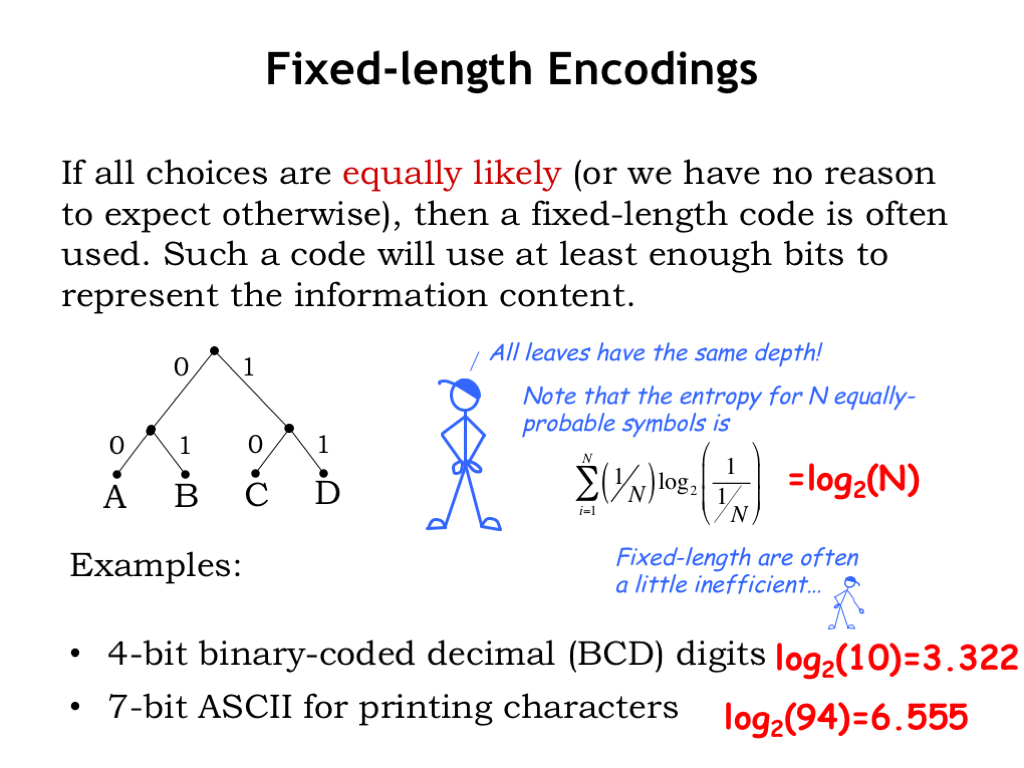
10. 定长编码(Fixed-length Encodings)

Fixed-length Encodings

符号等概(或无先验)时用定长:所有叶子到根距离相同。优点:随机访问——第 nn 个符号可跳过固定比特数后解码。

等概 NN 种结果:H(X)=log⁡2NH(X)=\log_2 N。

  • BCD:10 个十进制数字 → 4 bit 定长;H=log⁡210≈3.322H=\log_2 10\approx 3.322,1000 位数字用 4000 bit,熵提示或可压到约 3322 bit
  • ASCII:94 可打印字符,H=log⁡294≈6.555H=\log_2 94\approx 6.555 → 常用 7 bit 定长

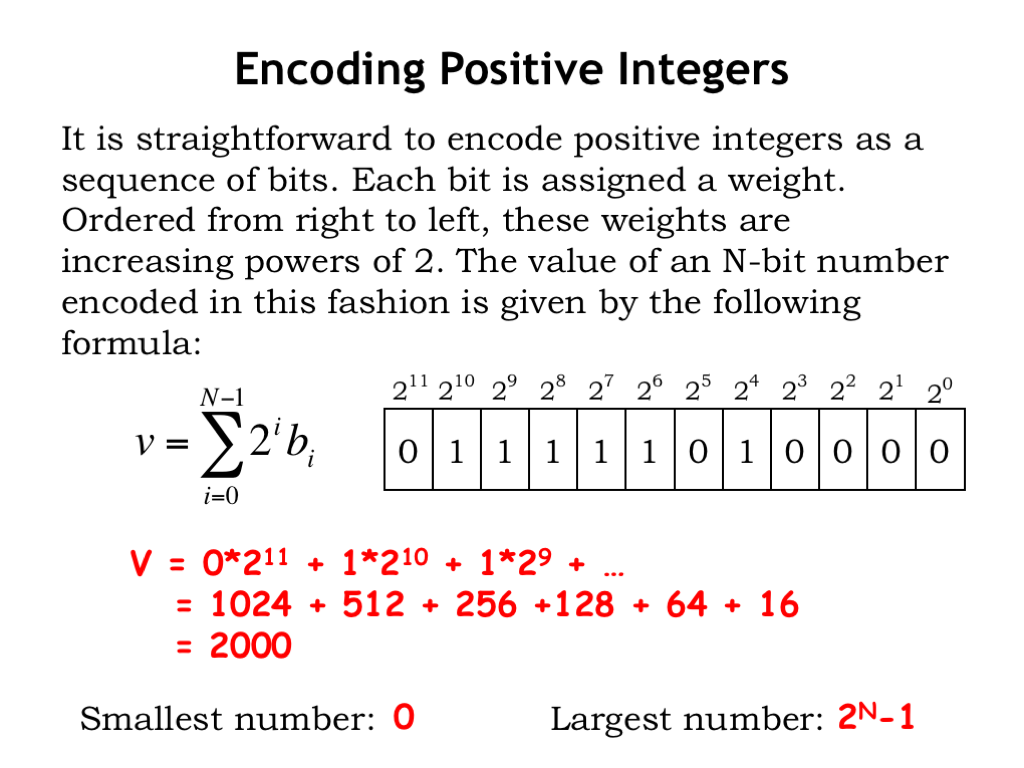
11. 编码正整数(Encoding Positive Integers)

Encoding Positive Integers

无符号整数用二进制(base-2):各位权重 2N−1,…,202^{N-1},\ldots,2^0。例:12 位 011111010000 = 1024+512+256+128+64+16=20001024+512+256+128+64+16=2000。

NN bit 范围:00 到 2N−12^N-1。固定字长(如 32/64 bit)系统对超大数需多步运算。

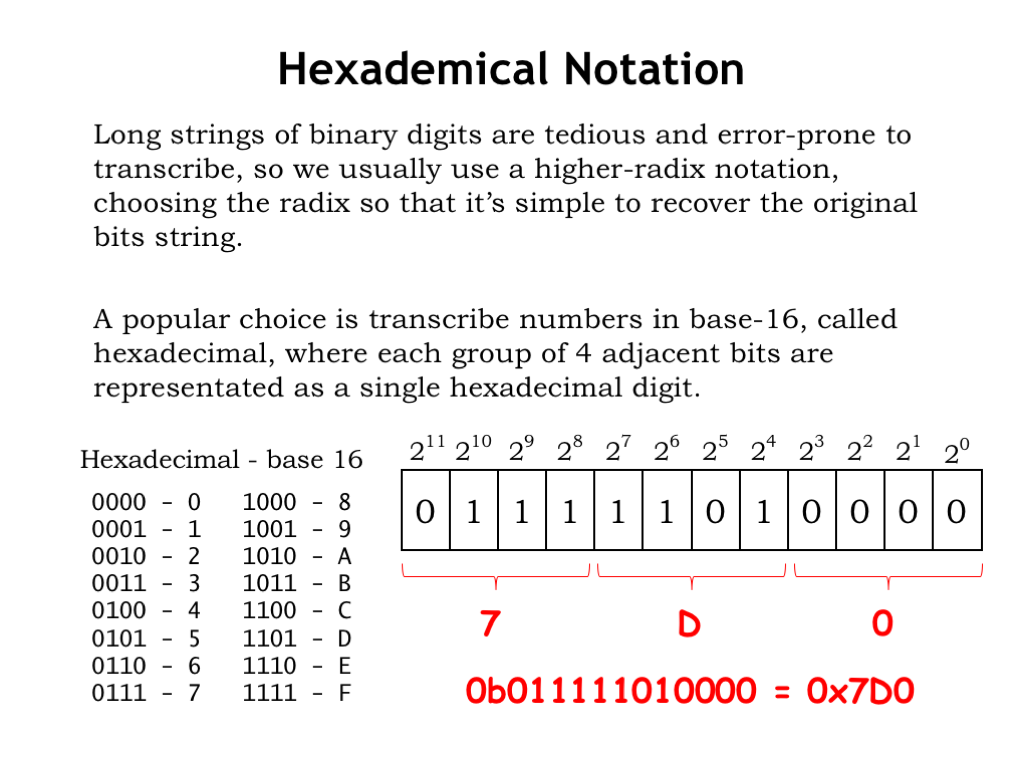
12. 十六进制记法(Hexadecimal Notation)

Hexadecimal Notation

长二进制串易抄错 → 用 hex(radix-16):每 4 bit 一个十六进制数字(0–9, A–F)。从最低位起按 4 位分组。

例:0111 1101 0000 → 0x7D0。前缀 0x 标明十六进制(多语言惯例)。

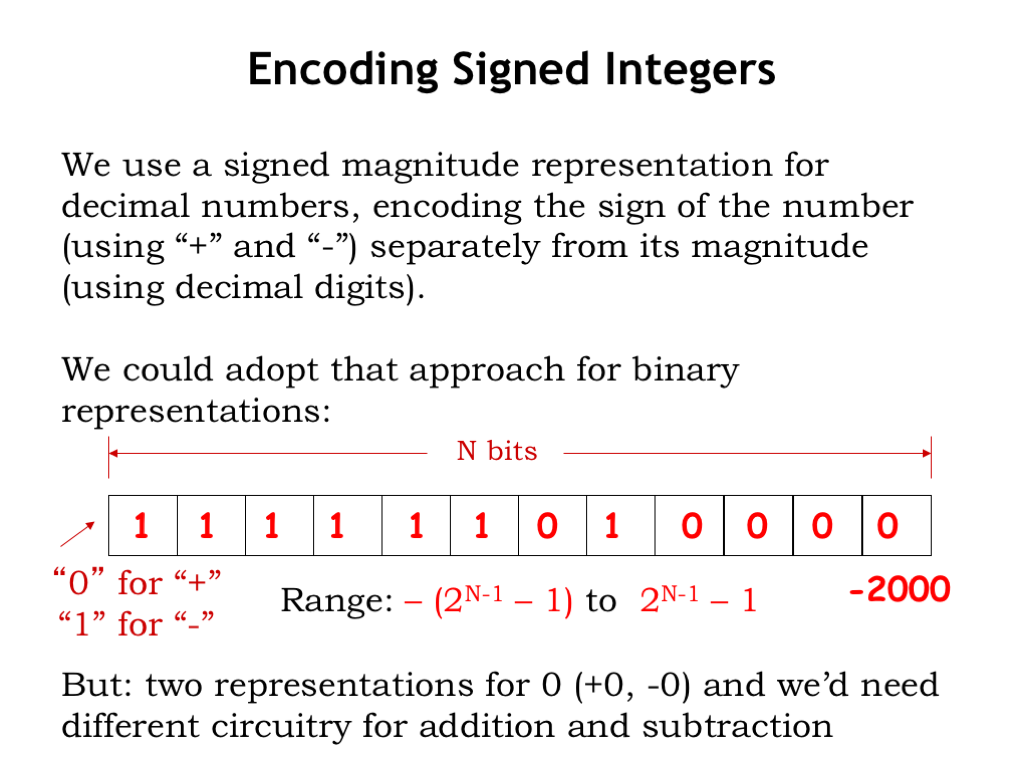
13. 编码有符号整数(Encoding Signed Integers)

Encoding Signed Integers

原码(signed magnitude):最高位作符号(0 正 / 1 负),其余为幅度。例:−2000-2000 = 符号位 1 + 2000 的二进制。

问题:存在 +0+0 与 −0-0 两套零;加减法电路不同(与小学加减分法类似)。

14. 补码编码(Two’s Complement Encoding)

Two's Complement Encoding

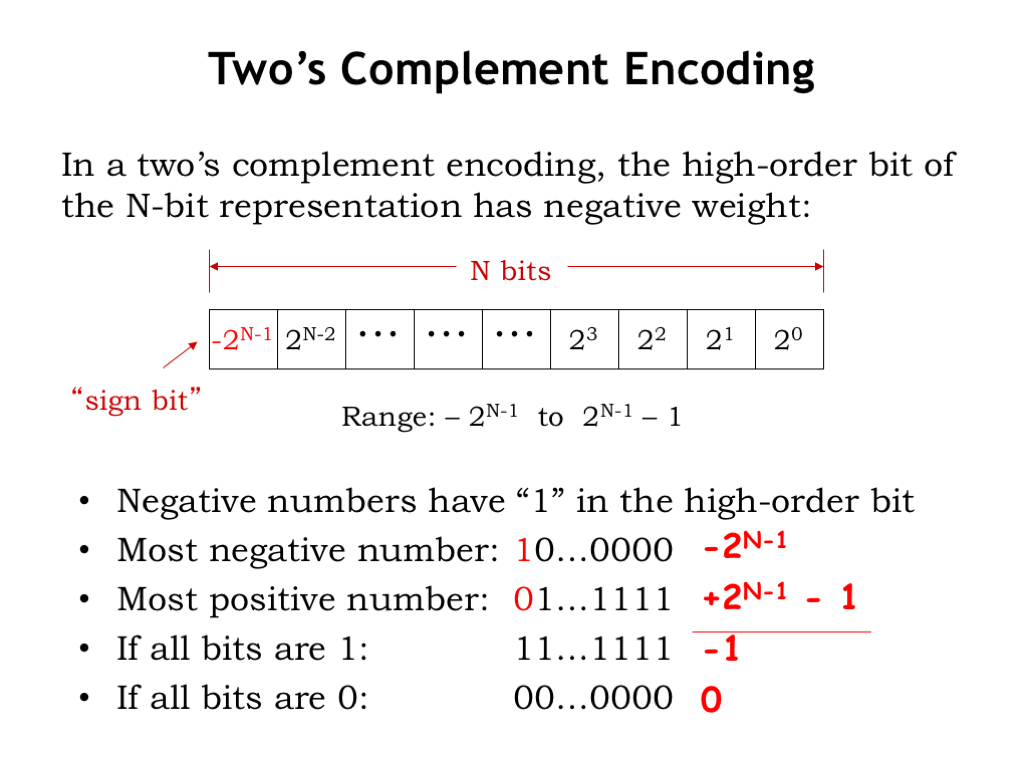
现代系统多用 two’s complement:NN bit 最高位权重为 负 −2N−1-2^{N-1}。最高位 1 → 负数(兼作符号位)。

  • 最负:−2N−1-2^{N-1}(仅最高位为 1)
  • 最正:2N−1−12^{N-1}-1
  • 8 bit:−128∼127-128\sim 127
  • 全 1:−1-1;全 0:唯一的 00

15. 补码更多性质(More Two’s Complement)

More Two's Complement

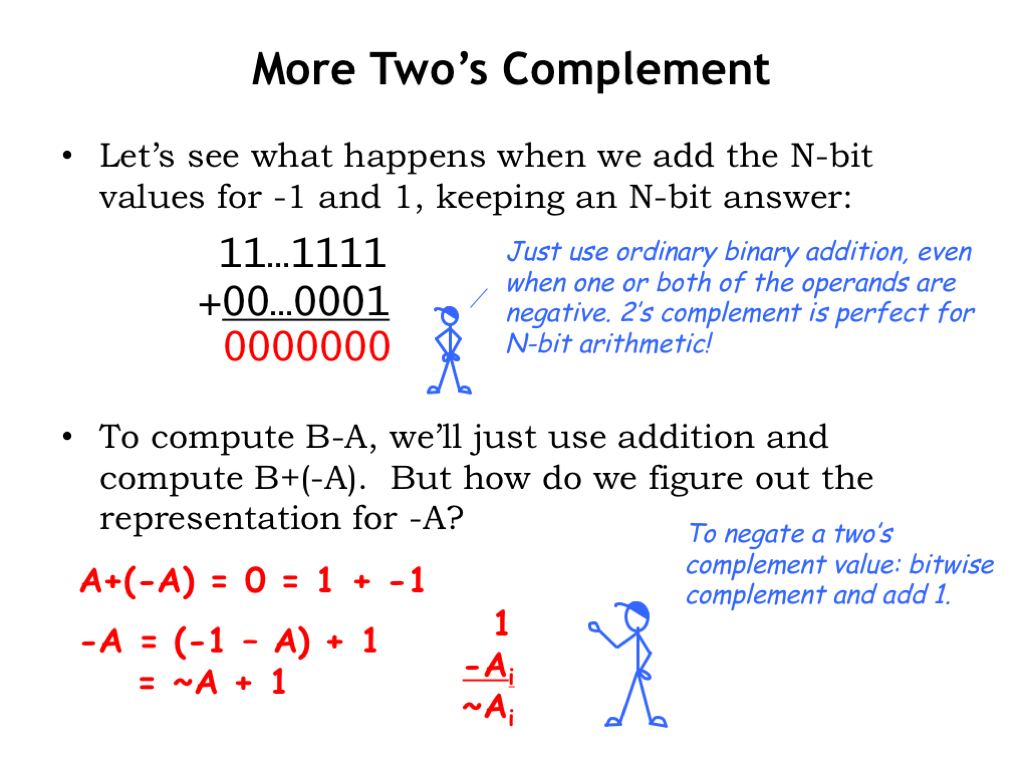
−1+1-1+1 用普通二进制加法得全 0 → 补码算术统一。B−A=B+(−A)B-A=B+(-A)。

求 −A-A:因 A+(−A)=0=1+(−1)A+(-A)=0=1+(-1),且 −1-1 为全 1,故

−A=∼A+1-A=\sim A+1

(按位取反再加 1)。只需会二进制加法与补码取负即可练习。

16. 变长编码(Variable-length Encodings)

Variable-length Encodings

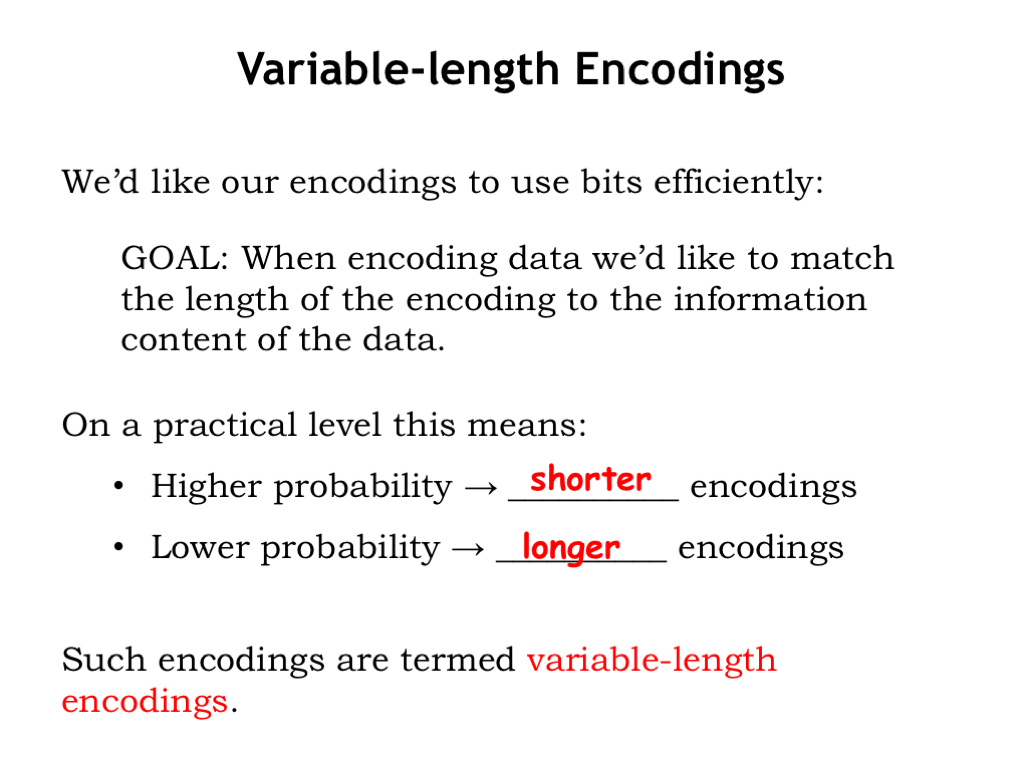
概率不等时,定长非最优。看期望码长:∑ipi⋅(len of xi)\sum_i p_i\cdot(\textrm{len of }x_i)。希望逼近 H(X)H(X)。

策略:高概率(信息量小)→ 短码;低概率 → 长码 → 变长编码。

17. 变长编码例子(Example: Variable-length Encoding)

Example: Variable-length Encoding

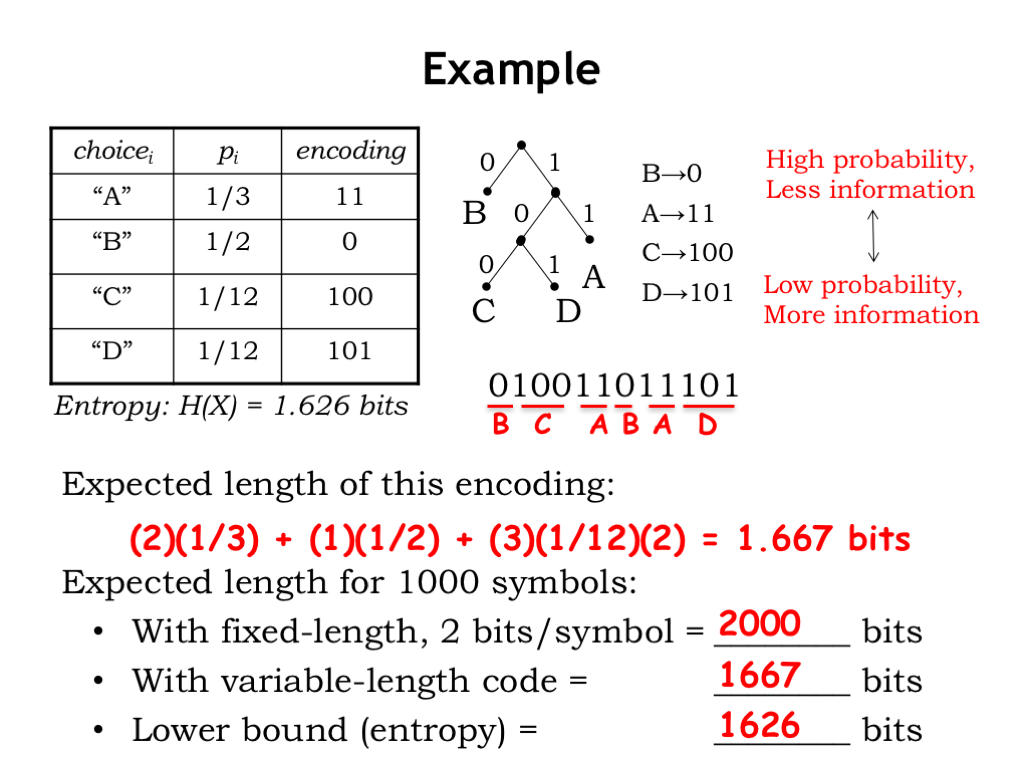
A,B,C,D 概率如前;编码使符号皆在叶子 → 无歧义。例:0 100 11 0 11 101 → BCABAD。

期望码长 =2⋅(1/3)+1⋅(1/2)+3⋅(1/12)+3⋅(1/12)=5/3≈1.667=2\cdot(1/3)+1\cdot(1/2)+3\cdot(1/12)+3\cdot(1/12)=5/3\approx 1.667 bit。

1000 符号:定长需 2000 bit;变长期望 1667;1000⋅H(X)=16261000\cdot H(X)=1626 为下界——已更接近,是否还有更优?下一节 Huffman。

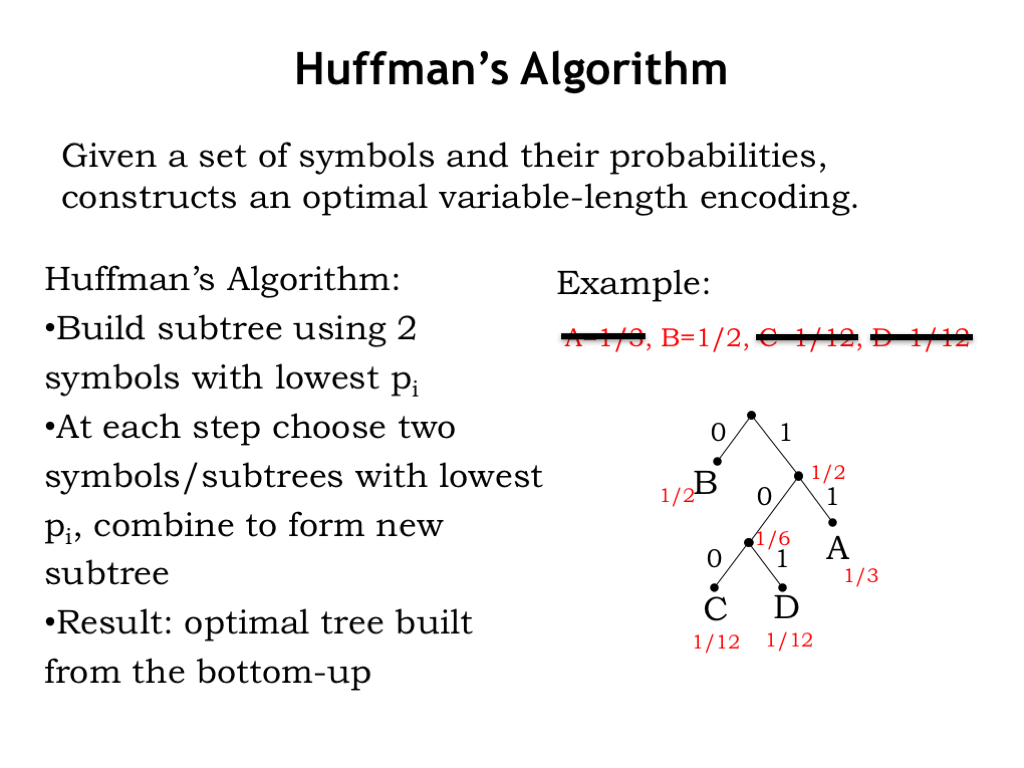
18. Huffman 算法(Huffman’s Algorithm)

Huffman's Algorithm

给定符号与概率,Huffman 算法自底向上建最优变长码(逐符号编码时期望码长最短):

  1. 选概率最小的两个符号/子树,并成一棵子树(边标 0/1 任意)
  2. 用子树替换二者,根概率为二者之和
  3. 重复直到合成一棵树

0/1 标签互换得到不同码,但期望码长相同(取决于到根距离)。

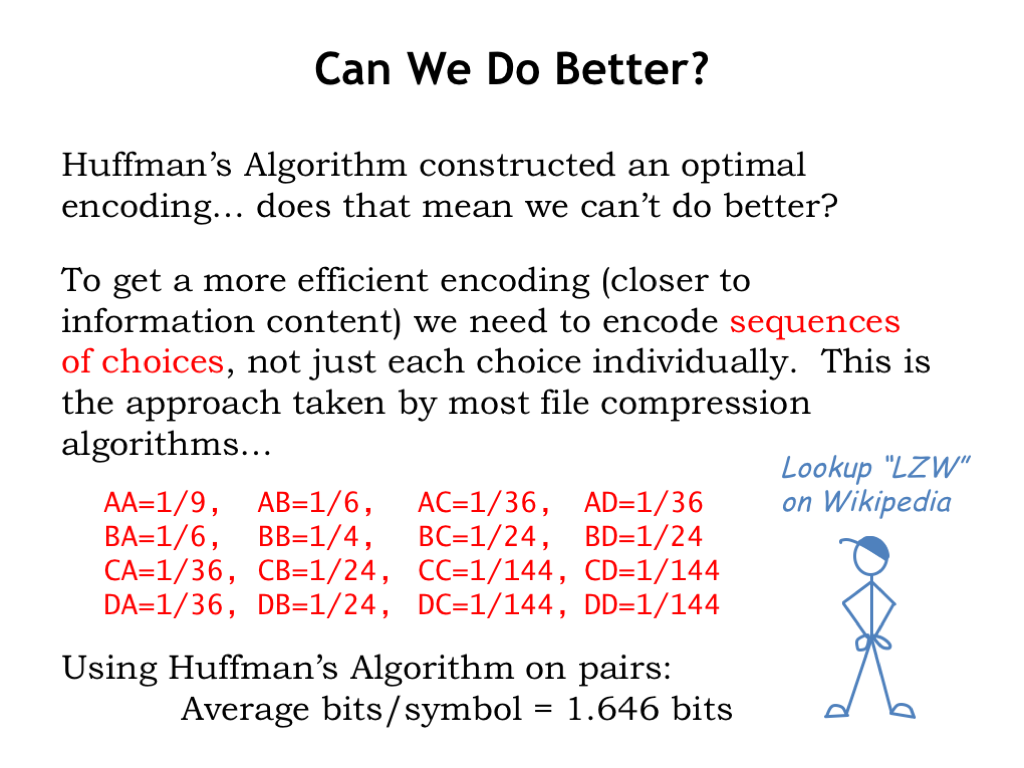
19. 还能更好吗?(Can We Do Better?)

Can We Do Better

逐符号 Huffman 已最优;若对符号对/更长块编码,可进一步逼近熵。例:按对编码期望约 1.646 bit/符号(优于 1.667)。

现代压缩(如 LZW)自适应发现高频序列并赋短码,对自然语言等重复多的数据效果显著。

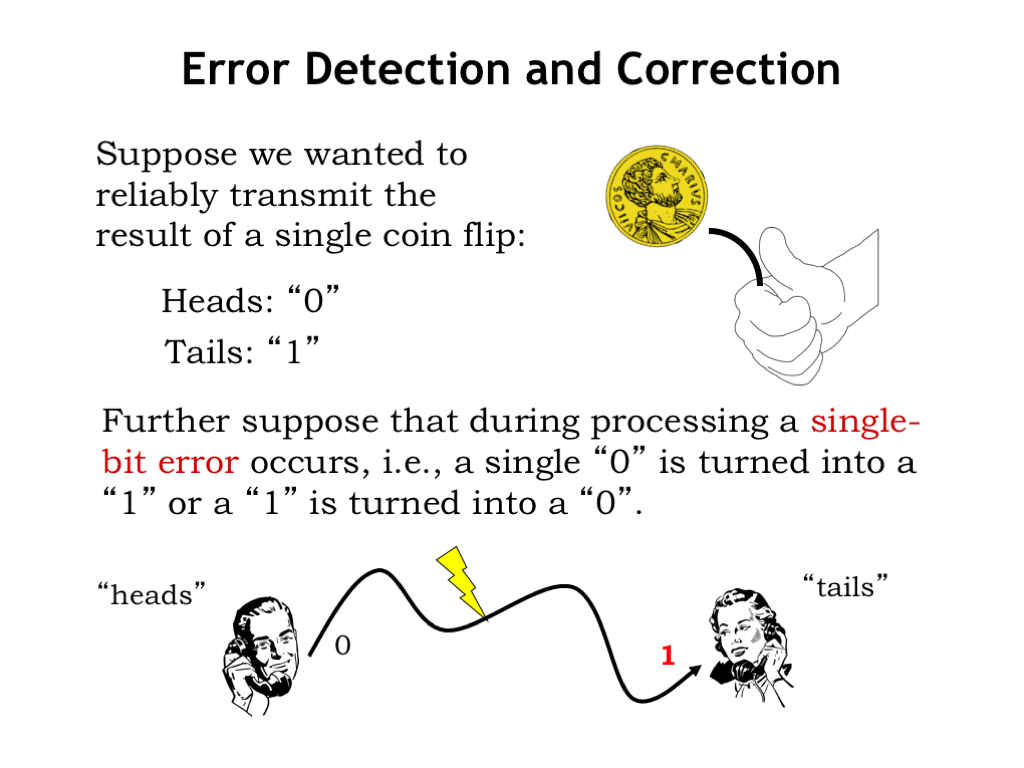
20. 检错(Error Detection)

Error Detection

比特可能在传输中翻转。简单编码:heads=0, tails=1。Bob 发 0 被翻成 1 → Alice 收到 tails,无法区分“无错的 tails”与“出错的 heads”→ 无法检测单比特错。

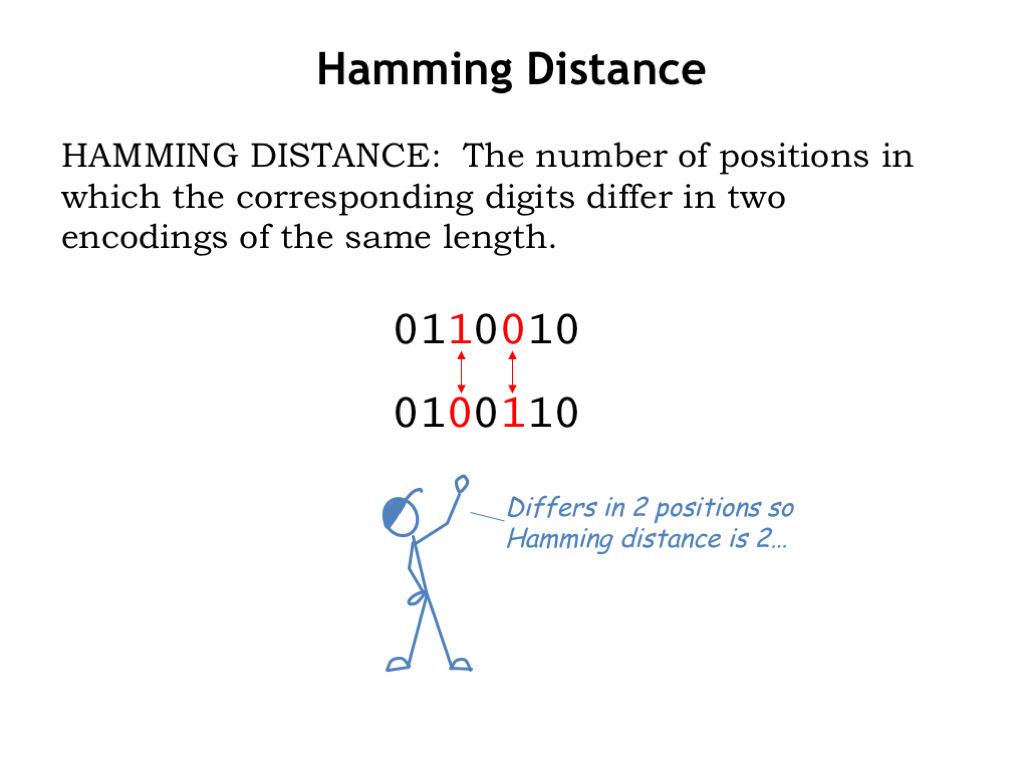
21. Hamming 距离(Hamming Distance)

Hamming Distance

Hamming distance:两等长编码对应位不同的个数。例:两 7 bit 码差第 3、5 位 → 距离 2。距离 0 → 完全相同。

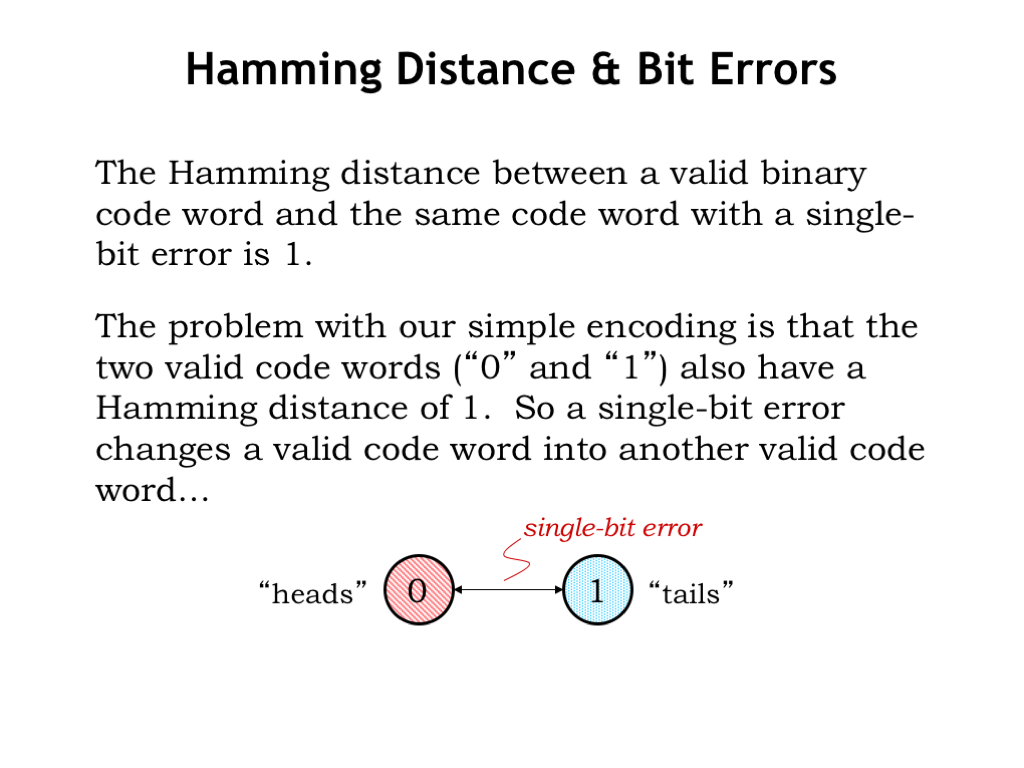
22. Hamming 距离与比特错误(Hamming Distance and Bit Errors)

Hamming Distance and Bit Errors

单比特错把码字推到 Hamming 距离为 1 的邻点。若合法码字之间最小距离也是 1(如 0 与 1),则错误把合法码变成另一合法码 → 不可检测。图中箭头表示距离 1 的邻接。

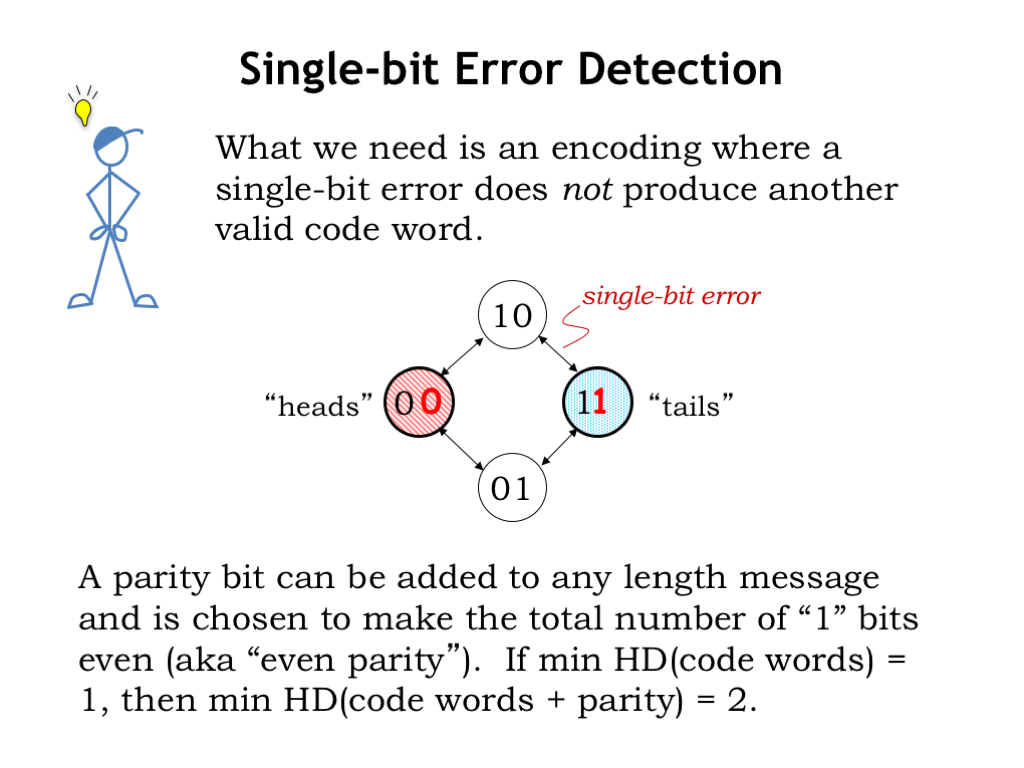
23. 单比特检错(Single-bit Error Detection)

Single-bit Error Detection

要检测单错:合法码字间最小 Hamming 距离至少为 2。做法:加奇偶校验位(parity bit)。偶校验使码字中 1 的个数为偶:heads 0→00,tails 1→11,最小距离升为 2。

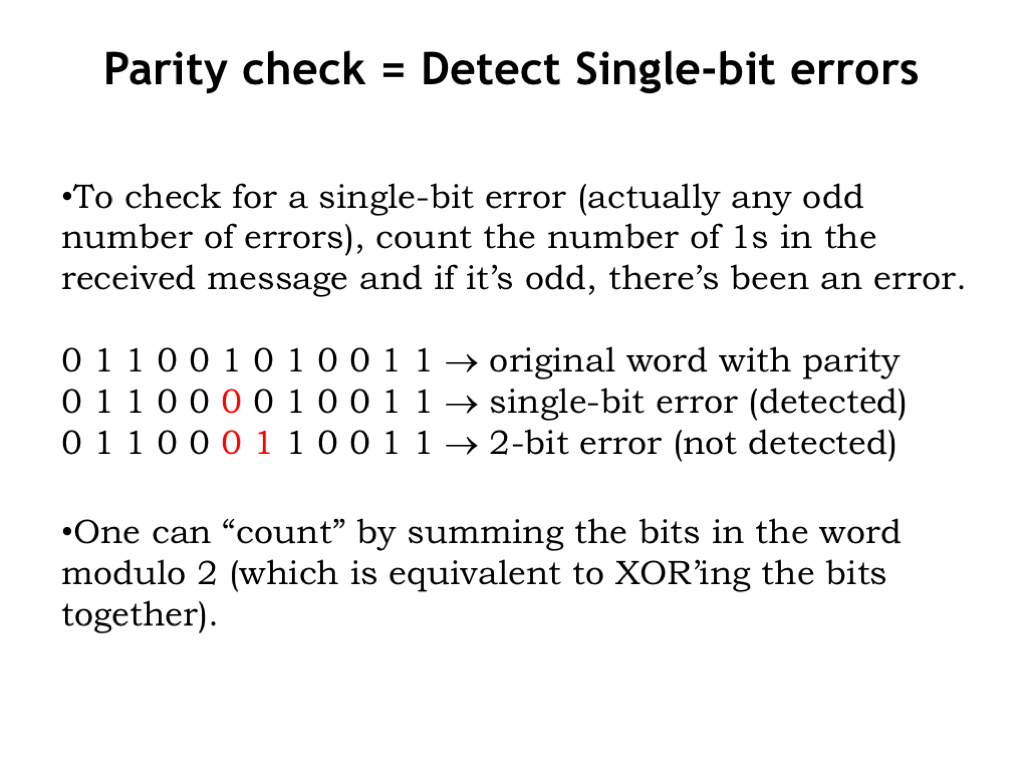
24. 奇偶校验(Parity Check)

Parity Check

单错:00→01/10,皆非法 → 可检出。合法码偶个 1,出错后奇个 1 → parity error。数 1 的个数(或用 XOR)即可校验。

偶次比特错会保持偶校验 → 奇偶校验主要对单错有效;多错需更强编码。

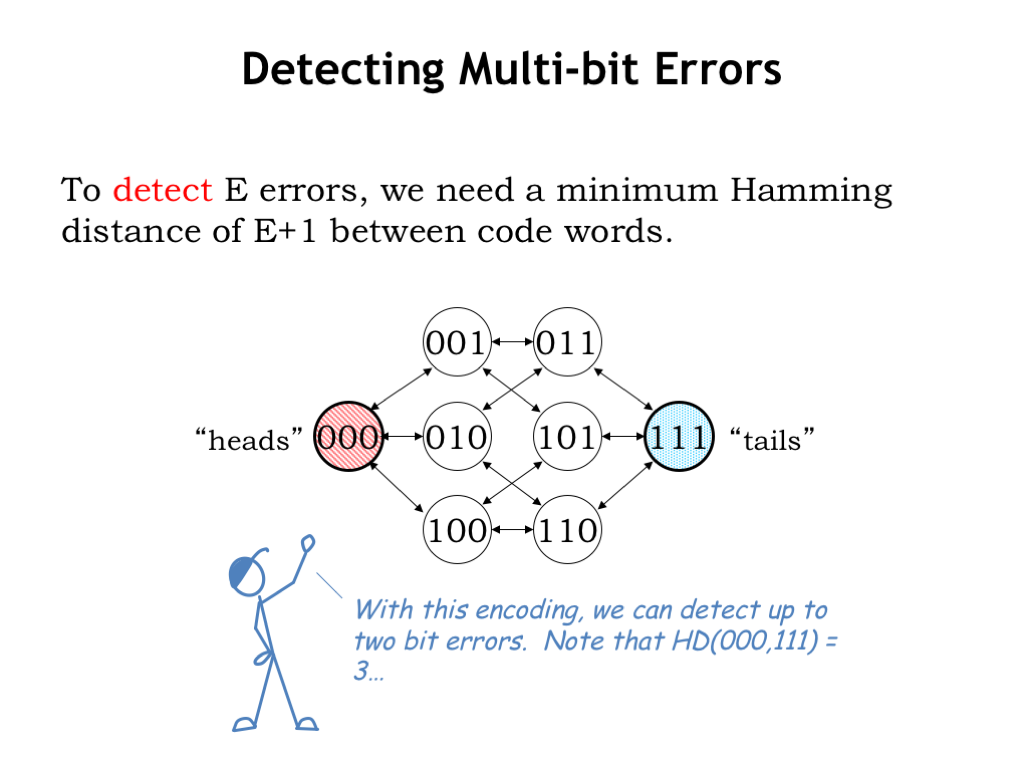
25. 检测多比特错误(Detecting Multi-bit Errors)

Detecting Multi-bit Errors

一般:检测至多 EE 个错误,需最小 Hamming 距离 ≥E+1\ge E+1。例:000 与 111 距离 3 → 可检测最多 2 错(长度 2 的路径到不了另一合法码)。

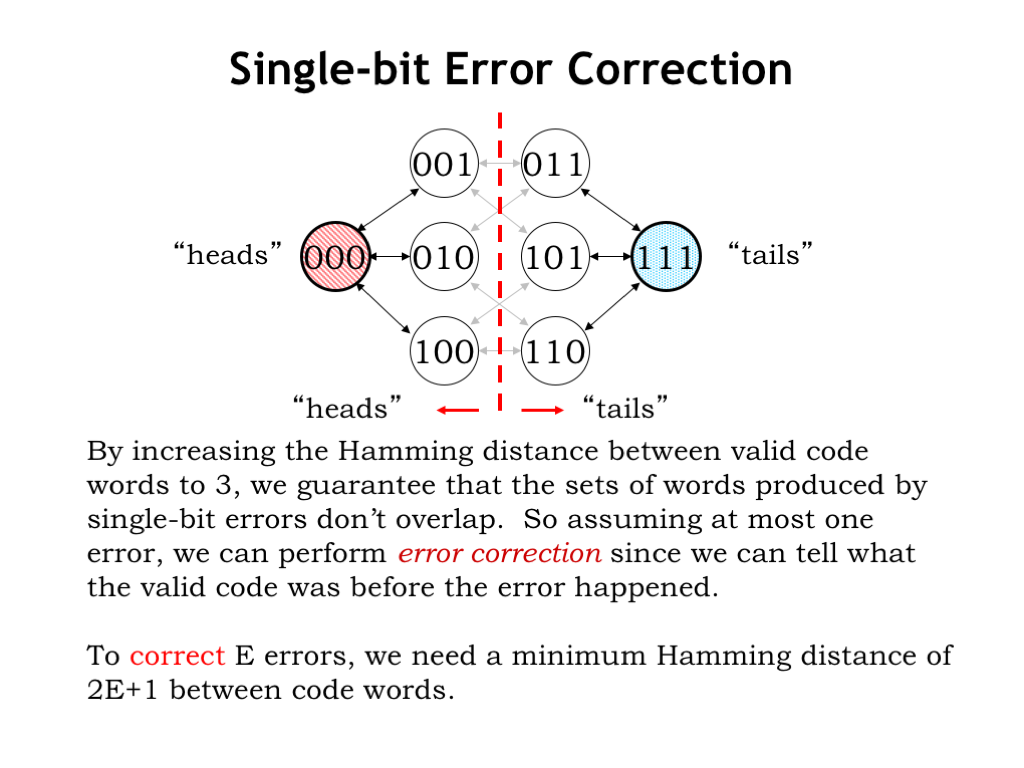
26. 纠错(Error Correction)

Error Correction

最小距离升到 3:各合法码的单错邻域互不重叠 → 可纠正单错(收到 001 则判原码为 000)。

一般:纠正至多 EE 错,需最小距离 ≥2E+1\ge 2E+1。编码理论研究如何系统构造此类码;本课只需把握:码字在 Hamming 空间中“隔得够远”即可检错乃至纠错。

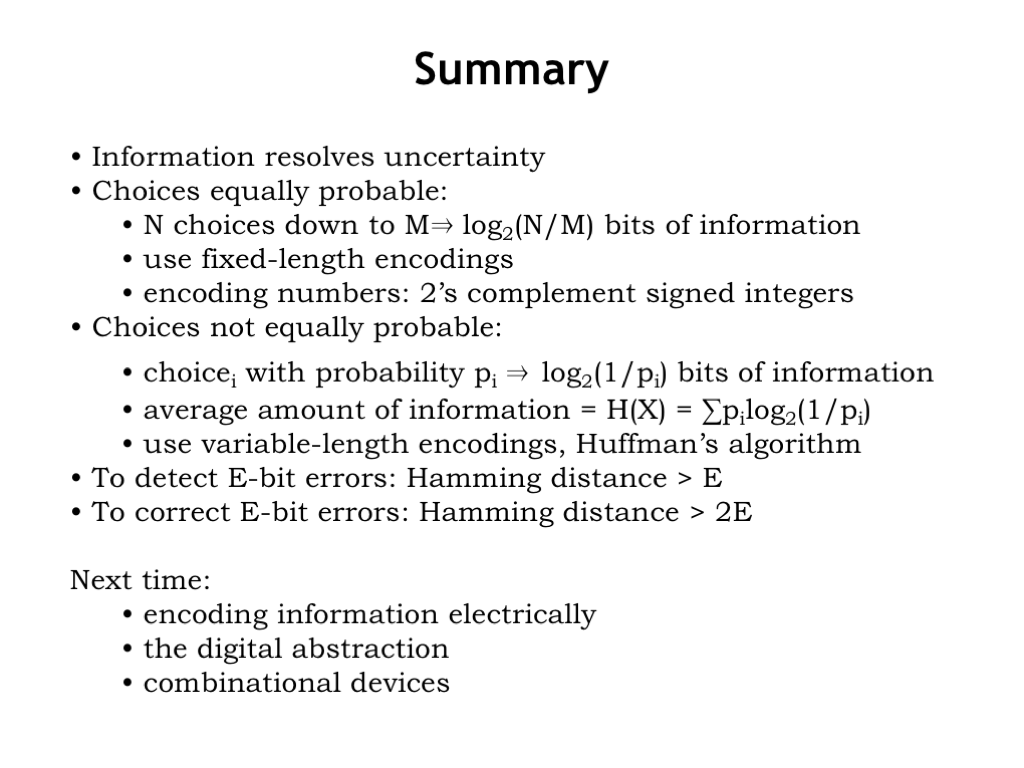
27. 小结(Summary)

Summary

要点回顾:

  • 信息量化:I=log⁡2(1/p)I=\log_2(1/p);熵 H(X)H(X) 是平均信息量与编码下界
  • 定长/变长编码;Huffman 在逐符号意义下最优;块编码可更逼近熵
  • 整数:二进制、hex、补码(取负 =∼A+1=\sim A+1)
  • Hamming 距离:距离 ≥E+1\ge E+1 可检 EE 错;≥2E+1\ge 2E+1 可纠 EE 错;奇偶校验是简单单错检测

现象

同一多线程工具、同一版本、同一份输入,在两台机器上跑完后,日志里的峰值内存对不上:

机器 Peak RSS Peak Virt Virt / RSS
机器 A 473 GB 518 GB 1.09
机器 B 478 GB 5485 GB 11.5

RSS 只差约 5 GB,Virt 却差约 4967 GB(近 5 TB)。两次运行都正常结束(exit status 0),结果也正确。机器 B 多带了 -mc,并行度更高,但后文估算表明两机线程数接近(约 144),单凭执行路径解释不了 Virt 差这么多。

问题变成:日志里的 Virt 异常,是不是真出了内存问题?

排查

排除 OOM 与泄漏

机器 freeSwap / totalSwap 退出码
机器 A 126 GB / 128 GB 0
机器 B 128 GB / 128 GB 0

RSS 接近、swap 几乎没动、结果正确——更像监控数字异常,而不是进程把物理内存吃爆了。

对比 ulimit

机器 ulimit -s(kbytes) 约合每线程栈
机器 A 42768 ~42 MB
机器 B 33554432 32 GB

栈限制相差约 785 倍。若程序用的是默认线程栈,这条差异值得顺着查。

定量估算

输入相同、RSS 接近,可近似认为线程数 (N) 差不多。若线程走默认栈,Virt 差应主要来自「每线程栈预留」之差:

1
2
3
ΔVirt          = 5485 − 518 = 4967 GB
Δstack/thread = 32.000 − 0.041 = 31.959 GB
N(上界) = 4967 / 31.959 ≈ 155

上界假设除线程栈外其余 Virt 完全相同。日志里还有更早的一段:多线程计算启动前、内存库刚加载完时,两机 Virt 已经差约 377 GB(A:Virt 252 GB / RSS 251 GB;B:Virt 629 GB / RSS 251 GB)。差额来源未完全确认,可能是分配器预留,也可能含少量早期线程。从总差里扣掉后再估:

1
N(下界)= (4967 − 377) / 31.959 ≈ 144

(N) 大约在 144~155。两种估法都指向同一方向:Virt 膨胀的主体,可以用 ulimit -s 造成的栈预留差解释。

根因

未调用 pthread_attr_setstacksize 时,pthread_create 默认取 RLIMIT_STACK(即 ulimit -s)。内核为每个线程预留对应大小的虚拟地址区间:

  1. 预留立刻计入进程 VSZ(日志里的 Virt)
  2. 不立即分配物理页,故不计入 RSS
  3. 线程真正写入栈时,才缺页映射物理页

按约 144 线程估算:

机器 每线程栈 线程栈合计计入 Virt
机器 A 42 MB ≈ 6 GB
机器 B 32 GB ≈ 4608 GB

两机任务量和线程数接近,Virt 差的主因是每线程栈预留差了约 785 倍,而不是「机器 B 多干了很多活」。RSS 可以几乎不变:真正触达的页才进 RSS;未触达的栈预留只抬高 Virt。

题外话:32 位地址空间下的差异

上面「Virt 很大但仍能正常跑完」主要适用于 64 位进程。x86_64 用户态地址空间约 128 TB,本文约 5 TB 的 Virt 远没顶到天花板。

32 位用户态通常约 3 GB(Linux 默认约 3 GB / 1 GB 用户/内核分割)。这时过大的 ulimit -s 会很快耗尽地址空间:每多一个线程就多占数百 MB 虚拟地址,线程稍多,pthread_create 就会返回 EAGAIN(errno=11,Resource temporarily unavailable),程序直接失败。

用 ulimit -v 3145728 把虚拟地址空间限制为 3 GB,模拟 32 位上限,实测如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
# 异常场景:ulimit -s 262144(256 MB/线程)
ulimit -v 3145728; ulimit -s 262144; ./thread-stack-32bit-demo

ulimit -s (stack/thread) = 256 MB
ulimit -v (virtual addr) = 3072 MB
理论最大线程数 ≈ 3072 / 256 = 12

[ 0 threads] Virt = 2 MB RSS = 1 MB
[ 1 threads] Virt = 258 MB RSS = 1 MB ← 每线程 +256 MB Virt
[ 2 threads] Virt = 514 MB RSS = 1 MB ← RSS 始终只有 1 MB
[ 3 threads] Virt = 770 MB RSS = 1 MB
...
[ 11 threads] Virt = 2818 MB RSS = 1 MB

pthread_create 在第 12 个线程时失败: Resource temporarily unavailable (errno=11, EAGAIN)
^^^^^^^^^^^^^^^^^^^^
虚拟地址空间耗尽,内核无法为新线程栈执行 mmap,返回 EAGAIN
成功创建线程数: 11

# 对照组:ulimit -s 8192(8 MB/线程,正常值)
ulimit -v 3145728; ulimit -s 8192; ./thread-stack-32bit-demo

[ 1 threads] Virt = 10 MB RSS = 1 MB ← 每线程仅 +8 MB Virt
[ 2 threads] Virt = 18 MB RSS = 1 MB
...(可正常创建 300+ 个线程)

两组对比很清楚:RSS 全程只有约 1 MB(栈几乎没真正用起来),Virt 却按 ulimit -s 的步长往上加,直到地址空间耗尽报错。对 32 位程序,过大的 ulimit -s 是实质故障;对 64 位程序,同类配置多半只让日志里的 Virt「看起来吓人」。复现程序:

title:thread-stack-32bit-demo.cview raw
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
/*
* thread-stack-32bit-demo.c
*
* 演示:ulimit -s 过大时,有限虚拟地址空间内线程创建失败的过程。
*
* ============================================================
* 测试 32-bit 虚拟地址受限场景的两种方法
* ============================================================
*
* 【方法一】真正编译为 32-bit 二进制(最真实)
*
* 前提:需安装 32-bit 开发库
* RHEL/CentOS: sudo yum install glibc-devel.i686 libgcc.i686
* Ubuntu/Debian: sudo apt install gcc-multilib
*
* 编译:
* gcc -m32 -o thread-stack-32bit-demo thread-stack-32bit-demo.c -lpthread
*
* 运行:进程天然受 32-bit 用户态 ~3 GB 地址空间限制,无需 ulimit -v
* ulimit -s 262144 # 每线程栈 256 MB
* ./thread-stack-32bit-demo
*
* ------------------------------------------------------------
*
* 【方法二】64-bit 二进制 + ulimit -v 模拟(无需额外依赖)
*
* ulimit -v 限制进程的最大虚拟地址空间(RLIMIT_AS),
* 效果与 32-bit 地址空间受限完全等价:mmap 超出上限时同样返回 EAGAIN,
* pthread_create 因无法为新线程栈分配地址而失败。
*
* 编译:
* gcc -o thread-stack-32bit-demo thread-stack-32bit-demo.c -lpthread
*
* 运行:
* ulimit -v 3145728 # 限制虚拟地址空间为 3 GB(模拟 32-bit 用户态上限)
* ulimit -s 262144 # 每线程栈 256 MB
* ./thread-stack-32bit-demo
*
* ============================================================
* 对照组(正常 ulimit -s,两种方法均适用)
* ============================================================
* ulimit -v 3145728
* ulimit -s 8192 # 正常值:8 MB/线程,同样地址空间可创建 300+ 线程
* ./thread-stack-32bit-demo
*/

#include <stdio.h>
#include <stdlib.h>
#include <pthread.h>
#include <string.h>
#include <errno.h>
#include <unistd.h>
#include <sys/resource.h>

static volatile int keep_running = 1;

/* 从 /proc/self/status 读取 VmSize 和 VmRSS,单位 MB */
static void print_mem(int n_threads) {
FILE *f = fopen("/proc/self/status", "r");
if (!f) return;
char line[256];
long vmsize_kb = -1, vmrss_kb = -1;
while (fgets(line, sizeof(line), f)) {
if (strncmp(line, "VmSize:", 7) == 0) sscanf(line + 7, "%ld", &vmsize_kb);
if (strncmp(line, "VmRSS:", 6) == 0) sscanf(line + 6, "%ld", &vmrss_kb);
}
fclose(f);
printf(" [%3d threads] Virt = %6ld MB RSS = %5ld MB\n",
n_threads, vmsize_kb / 1024, vmrss_kb / 1024);
fflush(stdout);
}

static void *thread_func(void *arg) {
(void)arg;
while (keep_running)
sleep(1);
return NULL;
}

int main(void) {
/* 读取当前 ulimit 设置 */
struct rlimit rl_stack, rl_as;
getrlimit(RLIMIT_STACK, &rl_stack);
getrlimit(RLIMIT_AS, &rl_as);

long stack_mb = (long)(rl_stack.rlim_cur / 1024 / 1024);
long as_mb = (rl_as.rlim_cur == RLIM_INFINITY)
? -1
: (long)(rl_as.rlim_cur / 1024 / 1024);

printf("========================================\n");
printf("ulimit -s (stack/thread) = %ld MB\n", stack_mb);
if (as_mb < 0)
printf("ulimit -v (virtual addr) = unlimited\n");
else
printf("ulimit -v (virtual addr) = %ld MB\n", as_mb);

if (as_mb > 0 && stack_mb > 0)
printf("理论最大线程数 ≈ %ld / %ld = %ld\n",
as_mb, stack_mb, as_mb / stack_mb);
printf("========================================\n\n");

print_mem(0); /* 基线 */

pthread_t threads[1024];
int i;
for (i = 0; i < 1024; i++) {
int ret = pthread_create(&threads[i], NULL, thread_func, NULL);
if (ret != 0) {
const char *meaning = (ret == EAGAIN) ? "EAGAIN: 虚拟地址空间耗尽,无法为线程栈执行 mmap"
: (ret == ENOMEM) ? "ENOMEM: 物理内存不足"
: "其他错误";
printf("\npthread_create 在第 %d 个线程时失败\n", i + 1);
printf(" errno = %d (%s)\n", ret, strerror(ret));
printf(" 含义 : %s\n", meaning);
printf("成功创建线程数: %d\n", i);
print_mem(i);
keep_running = 0;
for (int j = 0; j < i; j++)
pthread_join(threads[j], NULL);
return 1;
}
print_mem(i + 1);
}

printf("达到测试上限 1024 个线程,未触发失败。\n");
keep_running = 0;
for (int j = 0; j < i; j++)
pthread_join(threads[j], NULL);
return 0;
}

定位方法

这次是日志对比触发的个案。若以后再看到 Virt 远大于 RSS,仍建议先定位最大的映射段,再归因(文件 mmap、分配器预留、共享内存等都可能)。

1
2
cat /proc/<PID>/status | grep -E 'VmSize|VmRSS|VmSwap'
pmap -x <PID> | sort -k3 -rn | head -10

pmap -x 里:Kbytes 是段的虚拟大小(进 Virt),RSS 是驻留页,Mapping 标明类型([stack:TID]、[heap]、路径、[anon] 等)。

本次这类场景下,ulimit -s 为 32 GB 时,排序结果通常类似:

1
2
3
4
5
Address           Kbytes       RSS   Dirty Mode  Mapping
00007f1200000000 33554432 128 0 rw--- [stack:4312]
00007f2200000000 33554432 64 0 rw--- [stack:4313]
...(约 144 行 [stack:*])
0000000001a00000 524288 263144 263144 rw--- [heap]

单段 Kbytes = 33554432 即约 32 GB 虚拟预留,RSS 往往只有几十到几百 KB。

  • [stack:N] → 查 ulimit -s 和线程数
  • 大块 [anon] → 查分配器或显式 mmap
  • 具名路径 → 查映射文件大小
1
2
3
4
awk '/\[stack/{s=1} s && /^Size/{sum+=$2; s=0} END{print sum/1024 " MB"}' \
/proc/<PID>/smaps
ulimit -s
cat /proc/<PID>/status | grep Threads

结论

机器 A 机器 B
ulimit -s 42 MB 32 GB
线程数(默认栈) ~144 ~144
线程栈合计 Virt ~6 GB ~4608 GB
Peak RSS 473 GB 478 GB
Peak Virt 518 GB 5485 GB
运行是否正常 是 是

这次日志里的 Virt「异常」,不是泄漏,也不是跑挂了。 两机默认线程栈都绑在 RLIMIT_STACK 上,而 ulimit -s 差了约 785 倍,多线程一叠加,Virt 就被放大到近 10 倍;RSS 与正确性可以保持正常。

可落地的收尾:

场景 做法
程序内工作线程 用 pthread_attr_setstacksize 设明确栈大小(如 8 MB)
机器 / 集群默认 ulimit -s 建议 8~64 MB,避免对多线程负载设 unlimited
看日志 / 告警 多线程进程优先看 RSS(和 swap),不要单凭 Virt 判内存异常
跨机对比 同二进制 Virt 差很多时,先比双方 ulimit -a

P型与N型半导体的形成与导电原理(含PN结延伸)

一、 基本概念

  1. P型半导体(Positive-type):又称空穴型半导体。通过在本征半导体(如硅)中掺入三价元素形成,其主要依靠带正电的空穴导电。
  2. N型半导体(Negative-type):又称电子型半导体。通过在本征半导体(如硅)中掺入五价元素形成,其主要依靠带负电的自由电子导电。

二、 本征硅晶体的基本结构

  1. 价电子特征:纯净的硅(Si)原子最外层有 4个价电子。
  2. 共价键结合:1个硅原子与周围 4个相邻硅原子 各共用一对电子,形成4个共价键,构成稳定的正四面体立体网状结构。

三、 P型半导体的形成原理(以掺硼为例)

  1. 原子替代:三价杂质硼(B)原子直接替代晶格中某些硅原子的位置。
  2. 价电子不匹配:硼原子最外层只有 3个价电子,比硅原子少1个。
  3. 空穴的产生:
    • 硼原子与周围4个硅原子中的 3个 形成完整的共价键。
    • 与第4个硅原子结合时,由于缺少1个电子,无法形成完整的电子对,从而留下一个电子空位,即形成 “空穴” 。
  4. 受主原子(Acceptor):硼原子极易吸引并捕获邻近硅原子的价电子。接受电子后,硼原子自身变成带负电、无法移动的负离子。
  5. 导电原理:邻近电子跳入该空穴时,会在原位留下新空穴。这种空穴的连续移动形成电流,其多数载流子(多子)为空穴。

四、 N型半导体的形成原理(以掺磷为例)

  1. 原子替代:五价杂质磷(P)原子直接替代晶格中某些硅原子的位置。
  2. 价电子不匹配:磷原子最外层有 5个价电子,比硅原子多1个。
  3. 自由电子的产生:
    • 磷原子的4个价电子与周围的 4个硅原子 形成完整的共价键。
    • 多出来的第5个价电子不受共价键的束缚,其能量极高,极易脱离磷原子核的束缚,在晶格中运动,成为自由电子。
  4. 施主原子(Donor):磷原子因为能够向导带提供(施予)电子,被称为施主杂质。提供电子后,磷原子自身变成带正电、无法移动的正离子。
  5. 导电原理:在晶格中存在大量的自由电子。在外加电场作用下,这些电子会发生定向移动形成电流,其多数载流子(多子)为自由电子。

五、 P型与N型半导体核心参数对比

对比项目 P型半导体 N型半导体
掺杂元素 三价元素(如硼 B、铟 In、镓 Ga) 五价元素(如磷 P、砷 As、锑 Sb)
杂质类型 受主杂质(吸纳电子) 施主杂质(释放电子)
多数载流子(多子) 空穴(带正电) 自由电子(带负电)
少数载流子(少子) 自由电子(热激发产生) 空穴(热激发产生)
电离后的杂质离子 固定不动的负离子 固定不动的正离子
电中性 整体呈电中性 整体呈电中性

六、 PN结的形成与单向导电原理

1. 空间电荷区的形成(平衡态)

  • 载流子扩散:当P型和N型半导体接触时,由于交界面两侧存在浓度差,P区的空穴会向N区扩散,N区的自由电子会向P区扩散。
  • 复合与离子区:扩散过去的电子和空穴在交界面附近相遇并复合消失。
  • 内建电场:
    • P区一侧失去空穴,留下带负电的杂质离子。
    • N区一侧失去电子,留下带正电的杂质离子。
    • 这部分没有自由载流子的区域称为空间电荷区(或阻挡层/耗尽层),它产生了一个由N区指向P区的内建电场,阻止载流子继续扩散,最终达到动态平衡。

2. 单向导电原理

  • 正向偏置(外加正向电压):
    • 接法:电源正极接P区,负极接N区。
    • 原理:外加电场与内建电场方向相反,削弱了内建电场,使空间电荷区变窄。P区多子(空穴)和N区多子(电子)能够轻易通过交界面,形成较大的正向电流(PN结导通)。
  • 反向偏置(外加反向电压):
    • 接法:电源正极接N区,负极接P区。
    • 原理:外加电场与内建电场方向相同,加强了内建电场,使空间电荷区变宽。多子无法通过,此时只有两区极少数的少子在外电场作用下形成微弱的漂移电流,称为反向饱和电流(PN结截止)。

一、现象

在两台 64 位 Linux 主机上运行同一段代码,结果截然不同:

命令 主机 A(RHEL 9.4,内核 5.14) 主机 B(RHEL 8.10,内核 4.18)
malloc(64 GiB) ./probe_malloc_failure mmap[1] 返回 NULL,errno = ENOMEM 返回有效指针,成功
物理内存 grep MemTotal /proc/meminfo 约 7.5 GiB 约 3.0 TiB
Swap grep SwapTotal /proc/meminfo 约 8.0 GiB 约 128 GiB
overcommit 模式 cat /proc/sys/vm/overcommit_memory mode 0(默认) mode 0(默认)

直觉上,64 位进程拥有约 128 TiB 的虚拟地址空间,为什么请求区区 64 GiB 会返回"内存不足"?


二、背景:Linux 的"先承诺、后兑现"内存模型

理解这个问题,需要先搞清楚 Linux 的内存分配不是"直接给你物理内存":

  • malloc 调用 mmap:请求的块超过约 128 KiB 时,glibc 内部不通过 brk 扩堆,而是调用 mmap 系统调用申请匿名内存。
  • 承诺(commit)在先,物理页在后:mmap 成功时,内核只是"承诺"了一段虚拟地址区间,物理页面要等到程序真正读写时才分配(缺页异常触发)。
  • 承诺也有上限:内核在 mmap 时会检查"这次的承诺量是否合理",超过限制直接拒绝,返回 ENOMEM——即使此刻物理 RAM 还没用完。

因此 ENOMEM 不一定意味着"内存满了",可能只是内核在承诺阶段预判"将来可能兑现不了"而提前拒绝。


三、排查过程

3.1 确认失败发生在哪一层:malloc 还是 mmap?

malloc 失败可能有两种情况:glibc 内部逻辑拒绝,或底层 mmap 系统调用已失败。先分层确认:

probe_malloc_failure.cpp:32-48view raw
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
// §3.1:确认失败发生在 mmap 层而非 malloc 层
static void probe_mmap_vs_malloc()
{
size_t sz = 64 * kGiB;
errno = 0;
void* mp = mmap(NULL, sz, PROT_READ | PROT_WRITE,
MAP_PRIVATE | MAP_ANONYMOUS, -1, 0);
printf("mmap(64 GiB): %s errno=%d (%s)\n",
mp == MAP_FAILED ? "FAIL" : "OK", errno, strerror(errno));
if (mp != MAP_FAILED) munmap(mp, sz); // 释放本次 mmap 申请的虚拟内存

errno = 0;
void* p = malloc(sz);
printf("malloc(64 GiB): %s errno=%d (%s)\n",
p ? "OK" : "NULL", errno, strerror(errno));
if (p) free(p); // 释放本次 malloc 申请的内存
}
1
2
3
# 配套测试程序见第六节,编译:
# g++ -O0 -o probe_malloc_failure probe_malloc_failure.cpp
./probe_malloc_failure mmap
调用 主机 A 主机 B
mmap(64 GiB)(默认标志) MAP_FAILED,errno=12 成功
malloc(64 GiB) NULL,errno=12 成功

主机 A 上 mmap 系统调用本身已失败,malloc 返回 NULL 只是下游表现。排查范围收缩至内核 mmap 路径。


3.2 假设:进程虚拟地址空间受到 RLIMIT_AS 限制

Linux 可以通过 RLIMIT_AS(address space limit,进程虚拟地址空间上限)限制单个进程可映射的虚拟地址总量。内核在 mmap_region() 中的 may_expand_vm() 检查:若当前已映射量 + 本次请求 > 上限,拒绝并返回 ENOMEM。
查看方式:

1
2
ulimit -v
cat /proc/self/limits | grep -i 'max address'
主机 A 主机 B
RLIMIT_AS unlimited unlimited

两台主机均无限制,排除此假设。

3.3 假设:内核 overcommit 检查拒绝了本次请求

Linux 允许全系统"承诺"的虚拟内存总量超过物理 RAM,这叫超量承诺(overcommit)。策略由 /proc/sys/vm/overcommit_memory 控制,共三种模式:

mode 值 行为
启发式(默认) 0(OVERCOMMIT_GUESS) 单次 mmap 请求的页数 > 物理 RAM 页数 + Swap 页数,则拒绝(Linux v5.14及以后)[2]
始终允许 1(OVERCOMMIT_ALWAYS) 无条件同意所有分配
严格限制 2(OVERCOMMIT_NEVER) 全系统累计承诺量 < 上限时才允许

两台主机均为默认的 mode 0。其核心判断逻辑(Linux v5.14,mm/util.c L884–891):

1
2
3
4
5
// __vm_enough_memory()
if (sysctl_overcommit_memory == OVERCOMMIT_GUESS) {
if (pages > totalram_pages() + total_swap_pages)
goto error; // 返回 -ENOMEM
}

在主机 A 上代入数字:

数据项 值
请求页数(64 GiB ÷ 4 KiB/页) 16,777,216 页
totalram_pages(物理 RAM) 1,967,521 页
total_swap_pages(Swap) 2,097,151 页
系统容量合计 4,064,672 页(约 15.5 GiB)
判断 16,777,216 > 4,064,672 → 拒绝

在主机 B 上代入数字:

数据项 值
系统容量合计(RAM + Swap) 约 825,719,106 页(约 3.1 TiB)
判断 16,777,216 ≪ 825,719,106 → 通过

这直接解释了两台主机的差异。

用实验验证边界:

probe_malloc_failure.cpp:71-85view raw
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
// §3.3:探测 overcommit 检查的边界(RAM+Swap 附近逐步测试)
static void probe_threshold()
{
// 15360 MiB=15 GiB;15872 MiB=15.5 GiB;15880 MiB=15.5078125 GiB;
// 16384 MiB=16 GiB;65536 MiB=64 GiB
for (int mb : {15360, 15872, 15880, 16384, 65536}) {
size_t sz = static_cast<size_t>(mb) * 1024 * 1024;
errno = 0;
void* p = mmap(NULL, sz, PROT_READ | PROT_WRITE,
MAP_PRIVATE | MAP_ANONYMOUS, -1, 0);
printf("%5d MiB: %s errno=%d\n",
mb, p == MAP_FAILED ? "FAIL" : "OK", errno);
if (p != MAP_FAILED) munmap(p, sz); // 释放本次 mmap 申请的虚拟内存
}
}
1
./probe_malloc_failure threshold
1
2
3
4
5
15360 MiB: OK errno=0
15872 MiB: OK errno=0
15880 MiB: FAIL errno=12
16384 MiB: FAIL errno=12
65536 MiB: FAIL errno=12
请求大小 请求页数 与系统容量比较 实测结果
15,872 MiB 4,063,232 ≤ 4,064,672(通过) 成功
15,880 MiB 4,065,280 > 4,064,672(超限) 失败
64 GiB 16,777,216 > 4,064,672(超限) 失败

实测边界与公式完全吻合,确认 mode 0 overcommit 检查是根因。


3.4 排除:mode 2 的累计承诺量限制

两台主机的 overcommit_memory 都是 0,本不该走到 mode 2。仍用实验确认当前失败不是「全系统累计承诺量超限」。

下面按 Linux v5.14 源码(mm/mmap.c accountable_mapping / mmap_region、mm/util.c __vm_enough_memory)画出承诺检查:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
mmap_region()
│
├─ accountable_mapping()? // 私有可写且无 VM_NORESERVE
│ ├─ 否 → 跳过 __vm_enough_memory(不进入承诺检查)
│ └─ 是 → security_vm_enough_memory_mm()
│ └─ __vm_enough_memory(pages)
│ │
│ ① vm_acct_memory(pages)
│ (先把本次 pages 计入 Committed_AS)
│ │
│ ② 按 overcommit_memory 三选一(互斥,只走一条)
│ ┌─────────────────────┼─────────────────────────┐
│ │ == 0 GUESS │ == 1 ALWAYS │ == 2 NEVER
│ │ (当前主机) │ │
│ ▼ ▼ ▼
│ pages > 直接通过 allowed = vm_commit_limit()
│ totalram + total_swap? return 0 (再减去 admin/user reserve)
│ │是 │否 (保留记账) │
│ │ │ ▼
│ │ │ vm_committed_as(已含本次)
│ │ │ < allowed ?
│ │ │ │否(超限) │是(未超)
│ ▼ │ ▼ │
│ goto error │ goto error │
│ │ │
│ └─────────────────────────┬──────────────────────────┘
│ ▼
│ return 0
│ (保留①的记账)
│ mmap 继续成功路径
│
│ goto error:
│ ③ vm_unacct_memory(pages) ← 仅失败路径
│ 回滚刚才的记账
│ return -ENOMEM

简化版(只看主干):

1
2
3
4
5
6
accountable_mapping?  // 私有可写且无 VM_NORESERVE
├─ 否 → 跳过承诺检查,mmap 继续(仍可能因其它原因失败)
└─ 是 → 先记账,再按 overcommit_memory:
├─ 0 → 单次 pages > RAM+Swap? 是→失败(回滚) / 否→检查通过
├─ 1 → 始终通过承诺检查
└─ 2 → Committed_AS 超限? 是→失败(回滚) / 否→检查通过
  1. mode 0 不检查 CommitLimit。
  2. mode 2 不检查 pages > RAM + Swap。
  3. 记账是「先加;仅失败才回滚」,故失败时 Committed_AS 净不变。

第一步:读出 CommitLimit。

1
2
grep CommitLimit /proc/meminfo
# CommitLimit: 12323644 kB → 11.75 GiB

要排除 mode 2,需要选一个同时满足的请求大小:

  1. 大于 CommitLimit(11.75 GiB)——否则即使用 mode 2 也不会因这次请求触顶
  2. 不超过 mode 0 的拒绝条件——即请求 ≤ RAM + Swap(主机 A 为 4,064,672 页 / 15.5 GiB),否则会先被 mode 0 拦下,看不清 mode 2

§3.3 实测 15872 MiB(=15.5 GiB) 正好落在该区间内(> 11.75 GiB 且 ≤ 15.5 GiB),用作本实验的主探测点。另用 16 GiB(=16384 MiB)(> 15.5 GiB)作对照,确认超 mode 0 边界时拒绝且不记账。

probe_malloc_failure.cpp:87-121view raw
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
// §3.4:观察 Committed_AS 变化,排除 mode 2 累计限制
// 主探测:15872 MiB(> CommitLimit 且 ≤ RAM+Swap);对照:16 GiB(> RAM+Swap)
static void probe_committed()
{
auto kib_to_gib = [](long kib) {
return static_cast<double>(kib) / (1024.0 * 1024.0);
};
// Committed_AS:AS = Address Space(地址空间承诺量),随 mmap/munmap 等动态升降
auto committed = []() { return read_meminfo_kb("Committed_AS:"); };

long limit = read_meminfo_kb("CommitLimit:");
printf("CommitLimit: %ld KiB (%.2f GiB)\n", limit, kib_to_gib(limit));

// ① 15872 MiB = 15.5 GiB:> CommitLimit 且 ≤ RAM+Swap → 应通过;若 Committed_AS 超过 CommitLimit 仍成功 → 非 mode 2
long c0 = committed();
size_t sz_ok = kPassCapMiB * 1024ULL * 1024; // 15872 MiB = 15.5 GiB
void* p_ok = mmap(NULL, sz_ok, PROT_READ | PROT_WRITE,
MAP_PRIVATE | MAP_ANONYMOUS, -1, 0);
long c1 = committed();
printf("mmap(15872 MiB / 15.5 GiB): %s Committed_AS %ld KiB (%.2f GiB) -> %ld KiB (%.2f GiB)\n",
p_ok == MAP_FAILED ? "FAIL" : "OK",
c0, kib_to_gib(c0), c1, kib_to_gib(c1));
if (p_ok != MAP_FAILED) munmap(p_ok, sz_ok); // 释放本次 mmap 申请的虚拟内存

// ② 16 GiB = 16384 MiB:> RAM+Swap → mode 0 拒绝,且 Committed_AS 应不变
c0 = committed();
size_t sz_fail = kFailCapGiB * kGiB; // 16 GiB = 16384 MiB
void* p_fail = mmap(NULL, sz_fail, PROT_READ | PROT_WRITE,
MAP_PRIVATE | MAP_ANONYMOUS, -1, 0);
c1 = committed();
printf("mmap(16384 MiB / 16 GiB): %s Committed_AS %ld KiB (%.2f GiB) -> %ld KiB (%.2f GiB)\n",
p_fail == MAP_FAILED ? "FAIL" : "OK",
c0, kib_to_gib(c0), c1, kib_to_gib(c1));
if (p_fail != MAP_FAILED) munmap(p_fail, sz_fail); // 释放本次 mmap 申请的虚拟内存
}
1
./probe_malloc_failure commit
1
2
3
CommitLimit: 12323644 KiB (11.75 GiB)
mmap(15872 MiB / 15.5 GiB): OK Committed_AS 6953140 KiB (6.63 GiB) -> 23206068 KiB (22.13 GiB)
mmap(16384 MiB / 16 GiB): FAIL Committed_AS 6953140 KiB (6.63 GiB) -> 6953140 KiB (6.63 GiB)
步骤 请求 与条件的关系 结果 Committed_AS 说明
① 读 CommitLimit 上限 = 11.75 GiB — — 划定「须大于此值」
② 15872 MiB(=15.5 GiB) 11.75 < 15.5 ≤ 15.5(RAM+Swap) 成功 6.63 → 22.13 GiB 记账后已超过 CommitLimit 仍成功 → 不是 mode 2
③ 16384 MiB(=16 GiB) 16 > 15.5(超 mode 0 边界) 失败 6.63 → 6.63 GiB(不变) 未记账即拒绝 → mode 0 单次页数检查

排除 mode 2 累计承诺量限制。


3.5 排除:地址空间碎片化,找不到连续区域

mmap(NULL, size) 要求内核在进程虚拟地址空间中找到一段连续的、长度为 size 的未映射区域。如果已有映射将地址空间切得过碎,即使未映射区域总量够,也可能找不到一段连续 64 GiB 的空闲区间。

区分方法:MAP_NORESERVE 标志会让内核跳过 overcommit 承诺检查,但不会跳过"寻找连续区域"这一步。因此:

  • 加了 MAP_NORESERVE 后 mmap 成功 → 连续区域是有的,失败只因承诺检查
  • 加了 MAP_NORESERVE 后 mmap 仍失败 → 可能确实找不到连续区域
probe_malloc_failure.cpp:50-69view raw
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
// §3.5:MAP_NORESERVE 绕过承诺检查,确认失败不是地址碎片化
static void probe_noreserve()
{
for (size_t gb : {16ULL, 64ULL}) {
size_t sz = gb * kGiB;
errno = 0;
void* d = mmap(NULL, sz, PROT_READ | PROT_WRITE,
MAP_PRIVATE | MAP_ANONYMOUS, -1, 0);
printf("%zu GiB default: %s errno=%d\n",
gb, d == MAP_FAILED ? "FAIL" : "OK", errno);
if (d != MAP_FAILED) munmap(d, sz); // 释放本次 mmap 申请的虚拟内存

errno = 0;
void* n = mmap(NULL, sz, PROT_READ | PROT_WRITE,
MAP_PRIVATE | MAP_ANONYMOUS | MAP_NORESERVE, -1, 0);
printf("%zu GiB NORESERVE: %s errno=%d\n",
gb, n == MAP_FAILED ? "FAIL" : "OK", errno);
if (n != MAP_FAILED) munmap(n, sz); // 释放本次 mmap 申请的虚拟内存
}
}
1
./probe_malloc_failure noreserve
请求大小 默认 mmap mmap + MAP_NORESERVE
16 GiB 失败,errno=12 成功
64 GiB 失败,errno=12 成功

加上 MAP_NORESERVE 后立即成功,说明连续未映射区域完全够用,排除地址空间碎片化。


四、内核调用链全貌

下图展示 malloc(64 GiB) 到返回 NULL 的完整内核路径,以及各排查步骤对应的检查点:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
                        malloc(64 GiB)
│
glibc: size > MMAP_THRESHOLD
→ 转为 mmap() 系统调用
│
┌─────▼─────┐
│ do_mmap() │
└─────┬─────┘
│
┌───────────────▼───────────────┐
│ 有 MAP_NORESERVE │
│ 且 overcommit_memory ≠ 2? │
└──────┬────────────────┬───────┘
是│ │否
▼ ▼
置 VM_NORESERVE vm_flags 不变
│ │
└────────┬───────┘
│
┌─────▼──────┐
│mmap_region │
└─────┬──────┘
│
┌───────────────▼────────────────┐
│ RLIMIT_AS 检查 │
│ total_vm + pages > 上限? │ §3.2 已排除
└──────┬─────────────────┬───────┘
超限│ │通过
▼ │
ENOMEM │
(VA 上限) │
┌─────────▼────────────┐
│ accountable_mapping()│
│ VM_NORESERVE 已置位? │
└──────┬────────────────┘
已置位(MAP_NORESERVE 路径)
│
┌──────────────────────┤
│ 未置位(默认路径) │已置位(跳过承诺检查)
▼ │
__vm_enough_memory() │
mode 0: │
pages > RAM + Swap? │
┌────┬───────────────────┐ │
│是 │否 │ │
▼ ▼ │ │
ENOMEM 通过 │ │
主机A ────────────────────┘ │
失败点 │
┌──────────────────────┘
▼
get_unmapped_area() §3.5 已排除
查找连续未映射区域
┌────┬──────────────┐
│未找到 │找到
▼ ▼
ENOMEM 建立 VMA
(碎片化) malloc 返回有效指针

主机 A 的默认路径(止于 overcommit 检查):

1
2
3
4
5
6
7
8
malloc(64 GiB)
└─> glibc: mmap(64 GiB) ← 无 MAP_NORESERVE
└─> do_mmap() ← VM_NORESERVE 未置位
└─> mmap_region()
└─> accountable_mapping() == true
└─> __vm_enough_memory()
└─> 16,777,216 > 4,064,672 → ENOMEM
malloc 返回 NULL

MAP_NORESERVE 路径(绕过 overcommit 检查,主机 A 也成功):

1
2
3
4
5
6
mmap(64 GiB, MAP_NORESERVE)
└─> do_mmap() ← VM_NORESERVE 置位
└─> mmap_region()
└─> accountable_mapping() == false ← 跳过承诺检查
└─> get_unmapped_area() ← 找到连续区域
└─> 建立 VMA,返回地址

五、根因总结

项目 内容
直接原因 Linux mode 0 overcommit 检查:单次 mmap 请求页数 > 物理 RAM 页数 + Swap 页数
内核函数 __vm_enough_memory()(mm/util.c,Linux v5.14 L885–886)
主机 A 64 GiB(16,777,216 页) > RAM + Swap(4,064,672 页,约 15.5 GiB) → ENOMEM
主机 B 64 GiB 仅占约 3.1 TiB 容量的 2%,检查通过
已排除 进程 VA 上限(RLIMIT_AS)、地址空间碎片化、mode 2 累计承诺量限制

六、测试程序

编译与运行

1
2
3
4
5
6
# 源码展示名:probe_malloc_failure.cpp
g++ -O0 -o probe_malloc_failure probe_malloc_failure.cpp
./probe_malloc_failure mmap # §3.1 定位失败层
./probe_malloc_failure threshold # §3.3 验证 overcommit 边界
./probe_malloc_failure commit # §3.4 排除 mode 2
./probe_malloc_failure noreserve # §3.5 排除地址碎片化

预期输出对照

子命令 主机 A 主机 B
mmap mmap FAIL errno=12;malloc NULL 均成功
threshold ≥15880 MiB 失败,≤15872 MiB 成功 均成功
commit 16 GiB 失败时 Committed_AS 不变;15872 MiB 成功后 Committed_AS 超 CommitLimit 也不报错 均成功
noreserve 默认失败;加 MAP_NORESERVE 成功 均成功

源码

probe_malloc_failure.cppview raw
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
#include <cerrno>
#include <cstdio>
#include <cstdlib>
#include <cstring>
#include <fstream>
#include <string>
#include <sys/mman.h>
#include <unistd.h>

namespace {

constexpr size_t kGiB = 1024ULL * 1024 * 1024;
// §3.4 主探测点:> CommitLimit 且 ≤ RAM+Swap(mode 0 不拒绝)→ 15872 MiB = 15.5 GiB
constexpr size_t kPassCapMiB = 15872;
// 对照:> RAM+Swap,由 mode 0 拒绝
constexpr size_t kFailCapGiB = 16; // 16 GiB = 16384 MiB

static long read_meminfo_kb(const char* key)
{
std::ifstream f("/proc/meminfo");
std::string line;
while (std::getline(f, line)) {
if (line.find(key) == 0) {
long v = 0;
sscanf(line.c_str(), "%*s %ld", &v);
return v;
}
}
return -1;
}

// §3.1:确认失败发生在 mmap 层而非 malloc 层
static void probe_mmap_vs_malloc()
{
size_t sz = 64 * kGiB;
errno = 0;
void* mp = mmap(NULL, sz, PROT_READ | PROT_WRITE,
MAP_PRIVATE | MAP_ANONYMOUS, -1, 0);
printf("mmap(64 GiB): %s errno=%d (%s)\n",
mp == MAP_FAILED ? "FAIL" : "OK", errno, strerror(errno));
if (mp != MAP_FAILED) munmap(mp, sz); // 释放本次 mmap 申请的虚拟内存

errno = 0;
void* p = malloc(sz);
printf("malloc(64 GiB): %s errno=%d (%s)\n",
p ? "OK" : "NULL", errno, strerror(errno));
if (p) free(p); // 释放本次 malloc 申请的内存
}

// §3.5:MAP_NORESERVE 绕过承诺检查,确认失败不是地址碎片化
static void probe_noreserve()
{
for (size_t gb : {16ULL, 64ULL}) {
size_t sz = gb * kGiB;
errno = 0;
void* d = mmap(NULL, sz, PROT_READ | PROT_WRITE,
MAP_PRIVATE | MAP_ANONYMOUS, -1, 0);
printf("%zu GiB default: %s errno=%d\n",
gb, d == MAP_FAILED ? "FAIL" : "OK", errno);
if (d != MAP_FAILED) munmap(d, sz); // 释放本次 mmap 申请的虚拟内存

errno = 0;
void* n = mmap(NULL, sz, PROT_READ | PROT_WRITE,
MAP_PRIVATE | MAP_ANONYMOUS | MAP_NORESERVE, -1, 0);
printf("%zu GiB NORESERVE: %s errno=%d\n",
gb, n == MAP_FAILED ? "FAIL" : "OK", errno);
if (n != MAP_FAILED) munmap(n, sz); // 释放本次 mmap 申请的虚拟内存
}
}

// §3.3:探测 overcommit 检查的边界(RAM+Swap 附近逐步测试)
static void probe_threshold()
{
// 15360 MiB=15 GiB;15872 MiB=15.5 GiB;15880 MiB=15.5078125 GiB;
// 16384 MiB=16 GiB;65536 MiB=64 GiB
for (int mb : {15360, 15872, 15880, 16384, 65536}) {
size_t sz = static_cast<size_t>(mb) * 1024 * 1024;
errno = 0;
void* p = mmap(NULL, sz, PROT_READ | PROT_WRITE,
MAP_PRIVATE | MAP_ANONYMOUS, -1, 0);
printf("%5d MiB: %s errno=%d\n",
mb, p == MAP_FAILED ? "FAIL" : "OK", errno);
if (p != MAP_FAILED) munmap(p, sz); // 释放本次 mmap 申请的虚拟内存
}
}

// §3.4:观察 Committed_AS 变化,排除 mode 2 累计限制
// 主探测:15872 MiB(> CommitLimit 且 ≤ RAM+Swap);对照:16 GiB(> RAM+Swap)
static void probe_committed()
{
auto kib_to_gib = [](long kib) {
return static_cast<double>(kib) / (1024.0 * 1024.0);
};
// Committed_AS:AS = Address Space(地址空间承诺量),随 mmap/munmap 等动态升降
auto committed = []() { return read_meminfo_kb("Committed_AS:"); };

long limit = read_meminfo_kb("CommitLimit:");
printf("CommitLimit: %ld KiB (%.2f GiB)\n", limit, kib_to_gib(limit));

// ① 15872 MiB = 15.5 GiB:> CommitLimit 且 ≤ RAM+Swap → 应通过;若 Committed_AS 超过 CommitLimit 仍成功 → 非 mode 2
long c0 = committed();
size_t sz_ok = kPassCapMiB * 1024ULL * 1024; // 15872 MiB = 15.5 GiB
void* p_ok = mmap(NULL, sz_ok, PROT_READ | PROT_WRITE,
MAP_PRIVATE | MAP_ANONYMOUS, -1, 0);
long c1 = committed();
printf("mmap(15872 MiB / 15.5 GiB): %s Committed_AS %ld KiB (%.2f GiB) -> %ld KiB (%.2f GiB)\n",
p_ok == MAP_FAILED ? "FAIL" : "OK",
c0, kib_to_gib(c0), c1, kib_to_gib(c1));
if (p_ok != MAP_FAILED) munmap(p_ok, sz_ok); // 释放本次 mmap 申请的虚拟内存

// ② 16 GiB = 16384 MiB:> RAM+Swap → mode 0 拒绝,且 Committed_AS 应不变
c0 = committed();
size_t sz_fail = kFailCapGiB * kGiB; // 16 GiB = 16384 MiB
void* p_fail = mmap(NULL, sz_fail, PROT_READ | PROT_WRITE,
MAP_PRIVATE | MAP_ANONYMOUS, -1, 0);
c1 = committed();
printf("mmap(16384 MiB / 16 GiB): %s Committed_AS %ld KiB (%.2f GiB) -> %ld KiB (%.2f GiB)\n",
p_fail == MAP_FAILED ? "FAIL" : "OK",
c0, kib_to_gib(c0), c1, kib_to_gib(c1));
if (p_fail != MAP_FAILED) munmap(p_fail, sz_fail); // 释放本次 mmap 申请的虚拟内存
}

} // namespace

int main(int argc, char* argv[])
{
const char* mode = argc > 1 ? argv[1] : "all";
if (!strcmp(mode, "mmap") || !strcmp(mode, "all")) probe_mmap_vs_malloc();
if (!strcmp(mode, "threshold") || !strcmp(mode, "all")) probe_threshold();
if (!strcmp(mode, "commit") || !strcmp(mode, "all")) probe_committed();
if (!strcmp(mode, "noreserve") || !strcmp(mode, "all")) probe_noreserve();
return 0;
}

七、参考资料

资源 链接
__vm_enough_memory、vm_commit_limit(v5.14) https://github.com/torvalds/linux/blob/v5.14/mm/util.c
__vm_enough_memory(v4.18) https://github.com/torvalds/linux/blob/v4.18/mm/util.c
mmap_region、accountable_mapping(v5.14) https://github.com/torvalds/linux/blob/v5.14/mm/mmap.c
overcommit 机制文档 https://github.com/torvalds/linux/blob/v5.14/Documentation/vm/overcommit-accounting.rst
proc(5) 手册 https://man7.org/linux/man-pages/man5/proc.5.html

  1. 配套测试程序 probe_malloc_failure.cpp 见第六节。 ↩︎

  2. 此行为为 Linux 5.14 及以后的实现(mm/util.c L885–886, v5.14)。5.14 之前(如本文主机 B 的 4.18)mode 0 改用基于系统空闲页的启发式估算(mm/util.c, v4.18),公式不同,但对本次场景的结论一致。排查时须先用 uname -r 确认内核主版本号再对照源码。 ↩︎

Sand / 沙子 (SiO₂)
↓ High-temperature reduction with carbon in electric arc furnace / 矿热炉高温碳强力还原
Metallurgical Grade Silicon (MGS) / 冶金级硅
↓ Chlorination with HCl and fractional distillation / 通入 HCl 气体并反复精馏提纯
Trichlorosilane Gas (SiHCl₃) / 三氯氢硅气体
↓ Modified Siemens Process (CVD) / 改良西门子法(化学气相沉积)
Electronic Grade Silicon (EGS) / 电子级多晶硅(硅原料)
↓ Czochralski (CZ) crystal pulling method / 柴可拉斯基法(单晶旋转提拉)
Silicon Ingot (Silicon Crystal) / 单晶硅棒(硅晶体)
↓ Diamond wire sawing and CMP / 钻石线锯切片与化学机械抛光
Wafer (Bare Wafer) / 晶圆(裸晶圆)
↓ Photolithography, Etching, Ion Implantation / 光刻、刻蚀、离子注入(反复几十次)
Processed Wafer (Patterned Wafer) / 满布电路的晶圆(有图形晶圆)
↓ Wafer testing and Dicing / 晶圆测试与芯片切割
Die (Bare Die) / 管芯(裸片/晶粒)
↓ Wire bonding and Packaging / 金属打线连接与引脚封装保护
Chip (IC / Integrated Circuit) / 芯片(集成电路)

💡 同一个 Wafer 上的各个 Die 电路一样吗?

  • 量产时(绝大多数情况):完全一样。 像盖章一样复制同一套设计图纸(如批量生产某款特定 CPU 或内存),以实现规模化量产。
  • 研发时(极少数情况):可能不一样(MPW,多项目晶圆)。 俗称"拼车"或"班车",几家公司或实验室为了平摊昂贵的模具费,把各自不同的芯片设计拼在同一块 Wafer 上制造,此时的 Die 各不相同。

💡 晶圆非有效区域

  • 划片槽(Scribe Line): 切割 Die 的必需间隙,与省料无关。槽内刻测试图形(Test Structures)做工艺监控,反正划片时会变成粉末,不占良品面积。
  • 边缘残缺区(Edge Dice): Wafer 按网格划片切成方形 Die,但 Wafer 是圆的,最外圈凑不出完整 Die;边缘缺陷率也高,本就无法出货。降级刻对齐标记、测试图案等,榨干辅助价值后报废。

变量约定:

  • LIB:要解析的 *.so 绝对或相对路径(请换成你的文件)。
  • OFF:栈里 +0x... 的十六进制偏移;下文示例中 OFF = 0x8fa860(与 addr2line 所用一致)。
  • PC:栈里 [0x...] 的进程内虚拟地址;示例 PC = 0x15182684b860(会随每次运行/ASLR 变化
    ,仅为与下组 BASE 配套的一例)。
  • BASE:与上式满足 PC - BASE = OFF 的映射基址;示例 BASE = 0x151825f51000。具体取
    maps 中哪一段以实际进程为准。

场景

栈回溯里常见这种形式:

1
/path/to/libapp.so(+0x8fa860)[0x15182684b860]

含义:

  • libapp.so:出问题的共享库(例名,请替换为实际名)。
  • +0x8fa860:相对该次映射基址的偏移(示例中固定为上述 OFF)。
  • [0x15182684b860]:当时的绝对虚拟地址(示例;单独用时需配合 maps 中的 BASE)。

调试时通常先用 +0x... 偏移 对 磁盘上的 .so 文件 做解析。


首选:addr2line

在带有 debug info(-g,且未 strip 掉调试信息)的 .so 上:

1
addr2line -e /path/to/libapp.so -f -C 0x8fa860

形态示例(你本机实跑时会是你的函数与路径):

1
2
myapp::CommandHandler(int, char const**, long, char const*)
/path/to/src/cli/handler.cpp:42

addr2line 可能把路径记成编译时目录(如 out/../handler.cpp),以 DWARF 记录为准;若行号对不上
,多半是二进制与当前源码不是同一版构建。

选项 作用
-e FILE 指定 ELF(.so 或可执行文件)
-f 同时打印函数名
-C Demangle C++ 符号

从「PC + 映射基址」反算并调用(注意 64 位运算)

addr2line 需要的是相对该 ELF 文件布局的偏移,通常就是栈上 +0x...,此处即
0x8fa860。若你只有 PC 和 BASE,应得到 OFF = PC - BASE(在 64 位下计算)。

Bash 的 $(( ... )) 对很大的十六进制字面量会溢出;大地址用 Python 等做减法后再喂给
addr2line。

脚本形态(数值与上节 PC / OFF / BASE 一致):

1
2
3
4
5
6
7
8
9
python3 <<'PY'
import subprocess
so = "/path/to/libapp.so" # 换成你的 LIB
pc = 0x15182684b860
off = 0x8fa860 # 与栈中 +0x8fa860 相同
base = pc - off
print(f"BASE = 0x{pc:x} - 0x{off:x} = 0x{base:x}")
subprocess.run(["addr2line", "-e", so, "-f", "-C", hex(pc - base)], check=False)
PY

形态示例(BASE 行与上式为算术一致的一例;函数名/路径为占位):

1
2
3
BASE = 0x15182684b860 - 0x8fa860 = 0x151825f51000
myapp::CommandHandler(int, char const**, long, char const*)
/path/to/src/cli/handler.cpp:42

当 pc - base 与栈中 +0x8fa860 一致时,与直接 addr2line -e ... -C 0x8fa860 等价。


补充:nm / objdump(看落在哪个符号里)

无行号信息或想确认符号边界时,可按地址排序查看。全量往往很长,可只取前几行,或用 grep 搜已知子
串(来自 demangle 后的名字片段)。

1
nm -n --defined-only /path/to/libapp.so | head -5

形态示例:

1
2
3
4
5
0000000000000000 n _GLOBAL_OFFSET_TABLE_
000000000000a000 t _ZN3App6WidgetC1Ev
000000000000a030 t _ZN3App6WidgetD1Ev
000000000000a060 t _ZN3App4InitEi
000000000000a090 t _ZN3App3RunEv

粗判:在排序列表里找 地址不大于目标 0x8fa860 的最后一个对应函数符号。精确行号仍以 addr2line
为准。

符号条数可能很大,例如某次对同一类大 .so 的统计(仅作数量级参考):

1
nm -n --defined-only /path/to/libapp.so | wc -l

形态示例:

1
86817

用 objdump 在符号表里按短关键字辅助定位;下面地址与偏移 0x8fa860 配套(符号起点略小于该
PC,落在函数体内):

1
objdump -t /path/to/libapp.so | grep 'CommandHandler' | head -3

形态示例:

1
00000000008fa71a l     F .text	0000000000000abc              _ZN5myapp15CommandHandlerEiPPKclS1_

行首 0x8fa71a 为该符号的起点,大小 0xabc;0x8fa860 落在区间 [0x8fa71a, 0x8fa71a+0xabc)
内。精确行号仍以 addr2line 为准。

readelf:查看 LOAD 段

下面来自与上述 0x8fa860 同一 ELF 样例的 readelf -l | head -20(段尺寸因库而异,此组与示
例偏移同时出现时便于对照;若你换库则整段以本机为准):

1
readelf -l /path/to/libapp.so | head -20

配套示例输出:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20

Elf file type is DYN (Shared object file)
Entry point 0x0
There are 9 program headers, starting at offset 64

Program Headers:
Type Offset VirtAddr PhysAddr
FileSiz MemSiz Flags Align
LOAD 0x0000000000000000 0x0000000000000000 0x0000000000000000
0x00000000007aa408 0x00000000007aa408 R 0x1000
LOAD 0x00000000007ab000 0x00000000007ab000 0x00000000007ab000
0x00000000007bf251 0x00000000007bf251 R E 0x1000
LOAD 0x0000000000f6b000 0x0000000000f6b000 0x0000000000f6b000
0x0000000000317c05 0x0000000000317c05 R 0x1000
LOAD 0x0000000001282e20 0x0000000001283e20 0x0000000001283e20
0x00000000000c67c8 0x00000000000e2b68 RW 0x1000
DYNAMIC 0x00000000012ec758 0x00000000012ed758 0x00000000012ed758
0x0000000000000530 0x0000000000000530 RW 0x8
NOTE 0x0000000000000238 0x0000000000000238 0x0000000000000238
0x0000000000000024 0x0000000000000024 R 0x4

不同 readelf 版本与不同 ELF 细节可能略有差异,以本机实跑为准。


C++ 符号 demangle

1
echo '_ZN5myapp15CommandHandlerEiPPKclS1_' | c++filt

形态示例:

1
myapp::CommandHandler(int, char const**, long, char const*)

(上式 mangled 名须换成你从 nm/objdump/栈上看到的真实字符串。)


文件是符号链时

1
file /path/to/libapp.so

形态示例:

1
/path/to/libapp.so: symbolic link to ../../build/obj/libapp.so

addr2line 应针对实际打开的那份 ELF(解析符号链后的目标或你确认参与调试的那份);若安装目录下链
到构建树,以 inode 与更新时间为准,避免对旧副本解析。


常见问题

  1. ?? 或明显不对

    • 二进制被 strip、或 debug 在单独文件且工具未找到 → 需带 debug 的构建物或 DEBUGINFOD 等。
  2. 行号与当前仓库不一致

    • 对应栈的二进制与当前源码版本/配置不同 → 以构建该库时的源码为准。
  3. 大地址用 Bash 做 PC - BASE

    • 易 32 位溢出;用 python3 或能表示 64 位无符号/有符号整数的工具计算后再调 addr2line。

最小复现(变量 + 一次 addr2line)

1
2
3
4
SO=/path/to/libapp.so
OFF=0x8fa860

addr2line -e "$SO" -f -C "$OFF"

形态示例:

1
2
myapp::CommandHandler(int, char const**, long, char const*)
/path/to/src/cli/handler.cpp:42

将 SO 换成你的库路径;偏移若与栈上一致,可继续用 0x8fa860 作对照。函数名、源路径与行号以
你本机 addr2line 输出为准(受调试信息与构建一致性约束)。