0%

C++17 引入的 PMR(Polymorphic Memory Resource,多态内存资源)位于 <memory_resource>,核心类型包括 std::pmr::memory_resource、std::pmr::polymorphic_allocator,以及一组绑定了该分配器的容器别名(如 std::pmr::vector、std::pmr::string)。本文先剖析传统容器分配器模型的弊端,再说明 PMR 的统一性设计,以及内存池的上游回退机制。

传统容器的弊端

STL 容器将 Allocator 作为模板参数,在编译期固化分配策略:

1
2
template<class T, class Allocator = std::allocator<T>>
class vector;

这在类型系统上精确,却带来三个工程症结。

接口无法在类型层面统一。 std::vector<T, A1> 与 std::vector<T, A2> 是不同的类型。要在同一函数签名或同一容器中容纳“元素类型相同、分配策略不同”的对象,只能二选一:

  • 函数写成模板——把 Allocator 留作模板参数,编译器为每种分配器各生成一份函数:

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    template<class Alloc>
    void print_size(const std::vector<int, Alloc>& v) {
    std::cout << v.size() << '\n';
    }

    struct PoolAlloc { /* ... 满足 Allocator 要求 ... */ };

    std::vector<int> a;
    std::vector<int, PoolAlloc> b;
    print_size(a); // 实例化 print_size<std::allocator<int>>
    print_size(b); // 实例化 print_size<PoolAlloc>

    代价:接口必须进头文件;模板函数不能是虚函数,进不了抽象基类的多态接口。

  • 类型擦除包装——自己造一层非模板外壳,用虚函数把具体 vector<T, Alloc> 藏起来。所谓类型擦除,就是抹掉编译期可见的 Alloc 差异,只保留运行期可调用的公共行为:

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    class AnyIntVector {
    struct Concept {
    virtual ~Concept() = default;
    virtual std::size_t size() const = 0;
    };
    template<class Alloc>
    struct Model : Concept {
    std::vector<int, Alloc> v;
    explicit Model(std::vector<int, Alloc> x) : v(std::move(x)) {}
    std::size_t size() const override { return v.size(); }
    };
    std::unique_ptr<Concept> self_;
    public:
    template<class Alloc>
    AnyIntVector(std::vector<int, Alloc> v)
    : self_(std::make_unique<Model<Alloc>>(std::move(v))) {}
    std::size_t size() const { return self_->size(); }
    };

    void print_size(const AnyIntVector& v) { std::cout << v.size() << '\n'; }

    std::vector<AnyIntVector> bag;
    bag.emplace_back(std::vector<int>{1, 2});
    bag.emplace_back(std::vector<int, PoolAlloc>{3, 4});

    代价:每个操作都要在 Concept 里声明;多一层虚调用与堆上 Model;为每个容器手写包装工程量大。标准库中的 std::function、std::any 也是同类手法。

与虚函数机制冲突。 虚函数在运行期决议类型,模板参数必须在编译期确定,二者无法直接组合:不能声明“元素类型固定、分配器可变”的虚接口再让派生类各自绑定不同 Allocator。

嵌套结构中分配策略难以贯通。 外层容器与内层元素各自持有默认分配器时,一次深拷贝会触发大量彼此无关的堆分配,无法共享缓存池,也难以统一生命周期与局部性。默认分配器下的典型情形:

1
2
std::vector<std::string> vec1 = /* ... */;
std::vector<std::string> vec2 = vec1; // 深拷贝:每个 string 各走一次堆分配

vec2 = vec1 至少分裂为两层互不相关的分配(示意):

1
2
3
4
5
6
7
8
9
10
// 外层 vector:自己的 std::allocator,一次申请 N 个 string 对象的连续区
std::string* elems = vector_alloc.allocate(N); // 第 1 次堆分配

for (std::size_t i = 0; i < N; ++i) {
// 内层每个 string:自己的 std::allocator,与 vector 互不知情
// 超 SSO 阈值时再向全局堆要字符缓冲(SSO:libstdc++/MSVC ≈15 char,libc++ ≈22 char)
// placement new:在 elems[i] 已有的存储上就地构造,不再为「对象本身」申请内存;
// 但 string 拷贝构造若超 SSO,仍会另向堆申请字符缓冲
new (elems + i) std::string(vec1[i]);
}

PMR 的统一性设计

PMR 将“如何分配”从编译期模板参数剥离,下沉为运行期可替换的 memory_resource,再由类型擦除后的 polymorphic_allocator 统一挂接(对 memory_resource* 做类型擦除,标准库已实现)。容器类型因此保持一致——std::pmr::vector、std::pmr::string 等别名固定,变化的是构造时绑定的 memory_resource*——分配策略在运行期注入。于是非模板函数与虚接口可直接传递同一族容器,多级嵌套也可共享同一资源,分别对应上一节的三个症结。

以嵌套深拷贝为例,外层与内层绑定同一预分配资源:

1
2
3
std::pmr::monotonic_buffer_resource pool{/* 预分配缓冲区 */};
std::pmr::vector<std::pmr::string> vec1{&pool};
std::pmr::vector<std::pmr::string> vec2{vec1, &pool}; // 深拷贝,仍走同一 resource

外层 pmr::vector 与内层每个 pmr::string 均通过同一套 polymorphic_allocator 向 pool 取内存。monotonic_buffer_resource 在缓冲未耗尽时的分配,本质就是游标推进(示意):

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
// pool 内部:一块预分配缓冲 + 游标
std::byte* current_ = buffer;
std::byte* end_ = buffer + buffer_size;

void* allocate(std::size_t n, std::size_t /*align*/) {
// 省略对齐;缓冲不够时走 upstream(见下一节)
void* p = current_;
current_ += n; // 只改指针,不调用 malloc / ::operator new
return p;
}

void deallocate(void*, std::size_t, std::size_t) {
// 单调缓冲:单次释放为空操作,整块在 pool 析构时回收
}

// 深拷贝 vec2 = vec1 时,多次 allocate 都落在同一块 buffer 上,例如:
// allocate(N * sizeof(pmr::string)); // 外层:N 个 string 对象的连续区
// allocate(len0); // 内层:string[0] 的字符缓冲(超 SSO 时)
// allocate(len1); // 内层:string[1] 的字符缓冲
// ...
维度 传统 Allocator 模板参数 PMR
策略绑定时机 编译期,刻入类型 运行期,经指针注入
接口统一 不同分配器 → 不同类型 容器类型可保持一致
与虚函数 难以直接组合 可在多态边界传递同一族类型
嵌套深拷贝 易退化为多次独立堆分配 可共享同一资源,降低分配开销

内存池的上游回退机制

上一节案例依赖有限预分配缓冲。缓冲用尽时,程序不会无故崩溃;行为由该资源绑定的 upstream(上游) 决定。monotonic_buffer_resource 等标准池化实现普遍支持这种链式退路。

配置 Buffer 耗尽后 适用场景
默认(未指定 upstream) 向 get_default_resource() 续借,初始即为 new_delete_resource() 通用:本地加速,超出后平滑降级
null_memory_resource() 抛出 std::bad_alloc,绝不碰堆 硬实时 / 嵌入式 / 禁止堆分配
自定义 upstream 转向指定的二级资源 多级 / 异构内存架构

默认续借。 只传缓冲、不指定 upstream 时,未满则在 buffer 内指针推进;已满则向上游申请更大的新块再划出本次所需。程序继续正确运行,超出部分退化为普通堆分配速度。

1
2
3
std::array<std::byte, 1024> buffer;
std::pmr::monotonic_buffer_resource pool(buffer.data(), buffer.size());
std::pmr::vector<std::pmr::string> vec(&pool);

禁止堆分配。 将 upstream 设为 null_memory_resource(),超限即抛异常,不会私自向系统申请堆内存:

1
2
3
4
5
6
7
8
9
10
11
std::pmr::monotonic_buffer_resource pool(
buffer.data(), buffer.size(),
std::pmr::null_memory_resource());

std::pmr::vector<int> vec(&pool);
try {
for (int i = 0; i < 10000; ++i)
vec.push_back(i);
} catch (const std::bad_alloc&) {
// 预分配已耗尽
}

增长策略。 上游为默认堆时,并不是每缺一字节就 malloc 一次,而是几何扩容:先耗尽给定 Buffer(如 1KB),再向上游要约 2KB、4KB……把对 ::operator new 的调用压到对数级。

实现原理。 本质是基类多态与组合式链式代理:memory_resource 为抽象基类;具体池既继承它(“我是资源”),又持有另一个 memory_resource*(“后备资源”)。基类采用 NVI——对外 allocate,对内纯虚 do_allocate:

1
2
3
4
5
6
7
8
9
10
11
12
13
namespace std::pmr {
class memory_resource {
public:
virtual ~memory_resource() = default;
void* allocate(std::size_t bytes,
std::size_t alignment = alignof(std::max_align_t)) {
return do_allocate(bytes, alignment);
}
private:
virtual void* do_allocate(std::size_t bytes, std::size_t alignment) = 0;
virtual void do_deallocate(void* p, std::size_t bytes, std::size_t alignment) = 0;
};
}

monotonic_buffer_resource 示意(非标准库原文):

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
class monotonic_buffer_resource : public memory_resource {
void* current_ptr_;
std::size_t remaining_;
memory_resource* upstream_; // 默认 get_default_resource()

public:
monotonic_buffer_resource(void* buffer, std::size_t size,
memory_resource* upstream = get_default_resource())
: current_ptr_(buffer), remaining_(size), upstream_(upstream) {}

protected:
void* do_allocate(std::size_t bytes, std::size_t alignment) override {
if (/* 当前块装得下 */)
return /* 对齐并推进游标 */;

std::size_t next = /* calculate_next_block_size(bytes) */;
void* new_block = upstream_->allocate(next, alignment);
current_ptr_ = new_block;
remaining_ = next;
return /* 从新块划出本次所需 */;
}
};

调用链:

1
2
3
4
5
6
7
8
vec.push_back()
→ polymorphic_allocator::allocate()
→ pool->allocate()
├─ Buffer 够用 → 指针偏移返回
└─ 不够 → upstream_->allocate(下一块)
├─ new_delete_resource → ::operator new
├─ null_memory_resource → throw std::bad_alloc
└─ 其它自定义资源 → 其 do_allocate

池无需知晓上游具体类型,只依赖虚接口。因此可将 Pool A 的 upstream 设为 Pool B、再把 B 接到堆上,自然嵌套出多级分配器。
本章介绍图的存储方式。

边集

方法

使用一个数组来存储边,数组中每个元素都包含一条边的起点和终点(带边权的图还包括边权)。
(或者使用多个数组来分别存储起点、终点和边权)。

复杂度

  • 查询是否存在某条边:𝑂(𝑚)
  • 遍历一个点的所有出边:𝑂(𝑚)
  • 遍历整张图:𝑂(𝑛𝑚)
  • 空间复杂度:𝑂(𝑚)

应用

由于直接存边的遍历效率低下,一般不用于遍历图.

在 Kruskal 算法 中,由于需要将边按边权排序,需要直接存边.

在有的题目中,需要多次建图(如建一遍原图,建一遍反图),此时既可以使用多个其它数据结构来同时存储多张图,也可以将边直接存下来,需要重新建图时利用直接存下的边来建图.

邻接矩阵

TODO

邻接表

链式前向星(静态邻接表)

链式前向星是一种利用数组模拟链表来实现的图存储结构,也常被称为“静态邻接表”。它完美结合了邻接表(节省空间、方便遍历出边)和数组(内存连续、常数极小)的优点,是算法竞赛和图论编程中最常用的建图方式之一。


1. 核心数据结构

链式前向星由一个边计数器和若干数组组成。理解关键在于分清下标:head 按节点索引,其余按边索引。

  • cnt(边计数器):当前边数,用于分配下一条边的编号,通常从 0 起。
数组 下标 存值 作用
head 节点 u 边编号 i 节点 u 出边链表的入口(桥接到 to/next)
to 边 i 节点 v 第 i 条边的终点
next 边 i 边编号 j 当前边 i(以 head[u] 为共同起点)的下一条边
weight 边 i 边权 第 i 条边的权重(可选)

注:u 可从 1 开始,故 head 大小至少为 N + 1(竞赛常取 N + 5 防越界,如 MAXN = 10005)。

注:节点编号若是巨大离散数(如 1000000007)或字符串(如 "Beijing"),不能直接作数组下标,需先离散化:

  1. 用哈希表(如 std::unordered_map<string, int>)给每个新节点分配连续整数 ID(从 0 或 1 起);
  2. 用该 ID 作为 u,再代入 head 建图。

2. 举例说明

我们以一个包含 4个节点、5条边 的例子,通过图解直观地“看”到链式前向星在内存中的样子和逻辑上的链表样子。

1. 逻辑上的图

这是我们人类大脑中理解的图结构(括号内为边的编号 cnt):

digraph G { rankdir=TB; bgcolor=transparent; nodesep=0.7; ranksep=0.8; node [shape=circle, width=0.55, fixedsize=true, fontname="sans-serif", fontsize=14, style=filled, fillcolor=white, color="#262626"]; edge [fontname="sans-serif", fontsize=12, color="#262626", arrowsize=0.8];

{ rank=same; 1 }
{ rank=same; 2; 3 }
{ rank=same; 4 }

1 -> 2 [label=<边0>];
2 -> 3 [label=<边1>];
1 -> 3 [label=<边2>];
3 -> 4 [label=<边3>];
1 -> 4 [label=<边4>];
}


2. 内存中的物理结构(数组存储)

在计算机内存中,它们是三排紧挨着的格子。我们把相同下标(边编号)的格子对齐:

起点的头指针(head):

1
2
3
节点 u:     [ 1 ]    [ 2 ]    [ 3 ]    [ 4 ]
--------------------------------------------
head[u]: [ 4 ] [ 1 ] [ 3 ] [-1 ]

边的属性(平行数组 to, weight, next):

1
2
3
4
5
边编号 i:     [ 0 ]    [ 1 ]    [ 2 ]    [ 3 ]    [ 4 ]
-------------------------------------------------------
to[i]: [ 2 ] [ 3 ] [ 3 ] [ 4 ] [ 4 ]
weight[i]: [ 10] [ 20] [ 30] [ 40] [ 50]
next[i]: [-1 ] [-1 ] [ 0 ] [-1 ] [ 2 ]

3. 链式前向星的灵魂:指针跳转图解

这是最核心的部分。我们将 head 数组作为入口,next 数组作为指针,把上面的物理内存在逻辑上连成多条单链表。

每一个方块代表一条边,格式为 [ 边编号 | 终点 to | 权重 w | 下一条边 next ]。

🔹 节点 1 的出边链表(倒序连接)

当你访问 head[1] 时,顺藤摸瓜的轨迹如下:

1
2
3
4
5
6
         +-------------+      +-------------+      +-------------+
head[1] | 边 4 | | 边 2 | | 边 0 |
------> | to: 4 | | to: 3 | | to: 2 |
| w : 50 | | w : 30 | | w : 10 |
| next: 2 --+----> | next: 0 --+----> | next:-1 (终)+----> NULL
+-------------+ +-------------+ +-------------+

你可以看到,由于是“头插法”,最后输入的“边4”排在链表最前面,它指向“边2”,然后指向最早输入的“边0”。

🔹 节点 2 的出边链表
1
2
3
4
5
6
         +-------------+
head[2] | 边 1 |
------> | to: 3 |
| w : 20 |
| next:-1 --+----> NULL
+-------------+
🔹 节点 3 的出边链表
1
2
3
4
5
6
         +-------------+
head[3] | 边 3 |
------> | to: 4 |
| w : 40 |
| next:-1 --+----> NULL
+-------------+
🔹 节点 4 的出边链表
1
2
3
head[4]
------> -1 (即 NULL,表示没有任何以节点 4 为起点的边)


4. 建图过程

核心代码

1
2
3
4
5
6
7
8
9
10
11
// head[u] 和 cnt 的初始值都为 -1
void add(int u, int v) {
nxt[++cnt] = head[u]; // 当前边(以 head[u] 为共同起点)的下一条边
head[u] = cnt; // 起点 u 的第一条边
to[cnt] = v; // 当前边的终点
}

// 遍历 u 的出边
for (int i = head[u]; ~i; i = nxt[i]) { // ~i 表示 i != -1
int v = to[i];
}
参考代码
graph-storage-01.cppview raw
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
#include <iostream>
#include <vector>

using namespace std;

int n, m;
vector<bool> vis;
vector<int> head, nxt, to;

void add(int u, int v) {
nxt.push_back(head[u]); // 头插法:新边的 nxt 指向原第一条边
head[u] = to.size(); // 头插法:更新 u 的第一条边为当前新边(下标等于即将 push 的 to 下标)
to.push_back(v); // 记录当前新边的终点
}

bool find_edge(int u, int v) {
for (int i = head[u]; ~i; i = nxt[i]) { // ~i 表示 i != -1
if (to[i] == v) {
return true;
}
}
return false;
}

void dfs(int u) {
if (vis[u]) return;
vis[u] = true;
for (int i = head[u]; ~i; i = nxt[i]) dfs(to[i]);
}

int main() {
cin >> n >> m;

vis.resize(n + 1, false);
head.resize(n + 1, -1);

for (int i = 1; i <= m; ++i) {
int u, v;
cin >> u >> v;
add(u, v);
}

return 0;
}

参考

简介

Schemdraw 是一个用 Python 绘制电路原理图的库。使用时逐一添加元件并设置其朝向与标签,库按添加顺序维护画笔位置,自动完成连线衔接,最终导出 SVG 或 PNG。

与 KiCad、Fritzing 等图形化工具不同,Schemdraw 没有交互式编辑器,图形完全由代码生成。这一特点使它天然适合需要版本控制与可复现性的场景——文档、讲义、论文附图等,图形随代码一起纳入版本管理。

1
pip install schemdraw

放置元件前,可先对照官方图示了解各符号的外形与默认朝向:Basic Elements(electrical)。

核心对象:Drawing 与 Element

画图时主要打交道的是两个类:

类 含义 在程序中的角色
schemdraw.Drawing 一张原理图画布 容器:持有已添加的元件、全局样式,以及当前画笔位置 here
schemdraw.elements.Element 及其子类 单个电路符号 Resistor、PFet、Line、Ground 等都是 Element 的子类;先构造实例,再交给 Drawing 放置

Drawing 支持上下文管理器(with ... as d):进入时创建画布,退出时按配置显示或保存。常用写法:

1
2
3
4
5
6
7
8
import schemdraw
import schemdraw.elements as elm

with schemdraw.Drawing() as d: # d 是 Drawing 实例
d.config(fontsize=12, color='black', bgcolor='white')
r = d.add(elm.Resistor().right().label('1k')) # 构造 Element,再加入画布
d.add(elm.Capacitor().down().at(r.end).label('10uF'))
d.save('out.svg')

要点:

  1. elm.Resistor() 等只构造符号对象(可链式设置朝向、标签),尚未上画布。
  2. d.add(...) 才真正放置:按入笔(Placement)/ 出笔(Drop)更新 d.here,并返回已放置的元件,便于用 r.end、MP.gate 等锚点继续布线。
  3. 整张图的画笔状态(d.here、全局样式)在 Drawing 上;单个符号的几何与锚点在 Element 上。后续各节(坐标系、朝向、链式接口)均在说明这两者如何配合。

坐标系与画笔

Drawing 维护一个全局画笔坐标 d.here。每次 d.add() 放置元件时,有两件独立的事情发生:

概念 含义 控制方式
Placement(入笔) 元件以哪个引脚对齐到起始坐标;起始坐标默认为当前 d.here .at(坐标或锚点) 改起始坐标;.anchor(名) 改对齐引脚
Drop(出笔) 放置完成后将 d.here 更新为哪个引脚的坐标 .drop(名) 换端子;.hold() 保持 d.here 不变

顺序串联时只需逐个 d.add:每颗元件的出笔(drop)自动成为下一颗的入笔,d.here 链式推进。跨支路或非串联走线时,用 .at(锚点) 显式指定位置,独立于 d.here。

Placement(入笔)

  • 未指定时,放置点为当前 d.here(上一元件的出笔,或画布初始位置)。
  • .at(p) 将放置点设为坐标或另一元件的锚点(如 M.drain),相当于跳过默认入笔、改钉别处。
  • .anchor(name) 指定以该引脚对齐到放置点(即「用哪个端子入笔」)。

典型默认放置锚点:二端元件为 start;PFet 为 source;NFet 为 drain。

Drop(出笔)

元件加入画布后,d.here 更新为该元件 drop 端子的坐标。

官方文档一般不标注 “drop”,仅给出锚点名称。推断规则:

  1. 二端元件(Element2Term:电阻、电容、二极管、导线等):默认 drop = end,即沿绘制方向的出口端(.right() 时在右端,.down() 时在下端)——与包围盒的「最右」「最下」无关,取决于绘制方向。
  2. 多端元件:默认 drop 由库内 elmparams['drop'] 决定,需对照锚点或运行时验证。

常见多端默认(元件默认朝向):

元件 默认 drop(出笔端子) 说明
PFet drain θ = 0 时位于竖直沟道下端
NFet source 同上,便于自上而下串联
PFet2 / NFet2 end 二端件风格;.right() 时在右端
BjtNpn collector 非沟道下端
Opamp out 输出端
JFetN / JFetP gate 栅极
Ground / Vdd 等 连接点 出笔几乎不动,下一入笔仍在原处

可覆盖默认行为:

1
2
d.add(elm.PFet().right().reverse().drop('gate'))  # 出笔改到栅极(下一默认入笔亦在此)
d.add(elm.Resistor().right().hold()) # 不出笔:d.here 保持入笔处

运行时核对:

1
2
print(d.here)
print(m.source, m.drain, m.gate)

朝向:旋转与镜像

Placement / Drop 回答「从哪入、从哪出」;朝向回答「符号在纸面上怎么转」。.right() / .up() / .left() / .down() 设置元件旋转角 θ,参考系为画布 x 正半轴(θ = 0°):

方法 θ
.right() 0°
.up() 90°
.left() 180°
.down() 270°

等价写法:.theta(角度)。

语义说明:

  • 二端元件本地几何沿 +x 定义,故 .right() 表示主体沿 +x 延伸。
  • PFet / NFet 在本地坐标中沟道沿 −y 方向。θ = 0 意为不旋转,沟道保持竖直,所以对这两种元件 .right() 的外观是竖直沟道——「right」只代表旋转角为 0°,并非表示沟道朝右延伸。
  • .reverse() 为沿元件轴向的镜像(MOS 上常用于切换栅极左右);.flip() 为另一方向翻转。二者与 θ 旋转相互独立。

改变 θ 后,drop 仍绑定同一命名端子,其在纸面上的方位会随旋转改变。

常用 API 接口

构造 Element 时常用的方法:

方法 作用
.right() / .left() / .up() / .down() / .theta(θ) 旋转
.at(p) 指定放置点
.anchor(name) 指定对齐引脚
.to(p) 连线终点(如 Line)
.length(n) 长度
.label(...) 标注
.reverse() / .flip() 镜像 / 翻转
.drop(...) / .hold() 覆盖出笔端子 / 冻结 d.here(不出笔)

非串联连接时,优先用已放置元件的锚点绝对坐标(.at / .to),不必依赖 d.here 顺序。

示例:CMOS 反相器

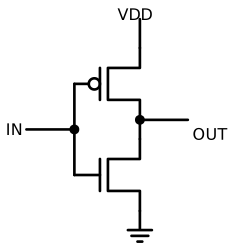
结构:电源侧 PFet 与地侧 NFet 串联,栅极共接 IN,中间节点引出 OUT。下面脚本把前述对象与规则串起来:Drawing 作画布,PFet / NFet / Line 等为 Element,串联靠入笔 / 出笔衔接,跨支路靠锚点 .at / .to。

schemdraw-basics-01.pyview raw
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
# 用 schemdraw 绘制 CMOS 反相器:PFet 上拉 + NFet 下拉,标注 VDD / GND / IN / OUT,并导出 SVG。
import schemdraw
import schemdraw.elements as elm

with schemdraw.Drawing() as d:
d.config(fontsize=12, color='black', bgcolor='white')

# PFet: placement at source; θ=0 → vertical channel; reverse → gate on left
MP = d.add(elm.PFet().right().reverse())
d.add(elm.Line().down().at(MP.drain).length(0.4))
# NFet: align drain to current pen for series stack
MN = d.add(elm.NFet().right().reverse().anchor('drain'))

d.add(elm.Line().up().at(MP.source).length(0.6))
d.add(elm.Label().label('VDD'))
d.add(elm.Ground().at(MN.source))

d.add(elm.Line().at(MP.gate).to(MN.gate))
mid = 0.5 * (MP.gate + MN.gate)
d.add(elm.Dot().at(mid))
d.add(elm.Line().left().at(mid).length(1).label('IN', loc='left'))

d.add(elm.Dot().at(MP.drain))
d.add(elm.Line().right().at(MP.drain).length(1).label('OUT', loc='end'))

d.save('schemdraw-basics-01.svg')
1
python3 schemdraw-basics-01.py

生成的 CMOS 反相器原理图如下:

CMOS 反相器原理图

与上述概念的对应关系:

  1. elm.PFet().right().reverse():θ = 0(竖直沟道),.reverse() 将栅极置于左侧;默认自 source 入笔,出笔(drop)至 drain。
  2. elm.NFet(...).anchor('drain'):以 drain 对齐当前笔尖(上一出笔),完成漏极侧串联。
  3. Line().at(MP.gate).to(MN.gate) 与中点引出:基于锚点坐标布线,独立于画笔串联的入/出笔路径。

整理自 MIT OCW 6.004 Computation Structures(Spring 2017)L21 注解幻灯片。

源网页:21.1 Annotated Slides | Parallel Processing

讲师:Chris Terman。图片直接引用 OCW 原站链接。

L21:并行处理(Parallel Processing)

本讲从单核性能公式出发,讨论更深/更宽流水线、ILP、乱序超标量的极限;再转向 DLP(向量/GPU)与 TLP(多核);用 Amdahl’s Law 框定加速比;最后讲共享内存多核的缓存一致性:sequential consistency、MESI snoopy 协议与 barrier。

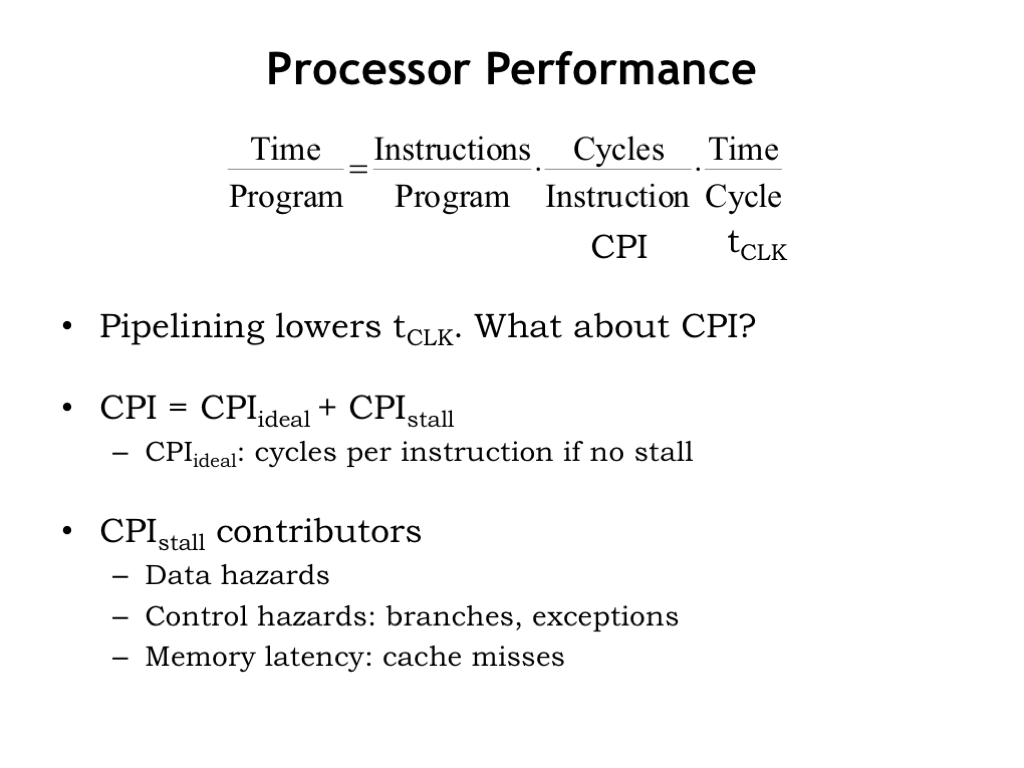
1. 处理器性能(Processor Performance)

Processor Performance

程序运行时间 = 指令数 × 平均每指令周期(CPI)× 时钟周期 tCLKt_{\mathrm{CLK}}。指令数由 ISA/编译器决定;本讲聚焦后两项。流水线减小 tCLKt_{\mathrm{CLK}}。理想 5 级 Beta 每周期完成 1 条 → CPIideal=1\mathrm{CPI}_{\mathrm{ideal}}=1,但分支、紧接使用 LD、cache miss 引入 NOP bubble → CPIstall\mathrm{CPI}_{\mathrm{stall}}。

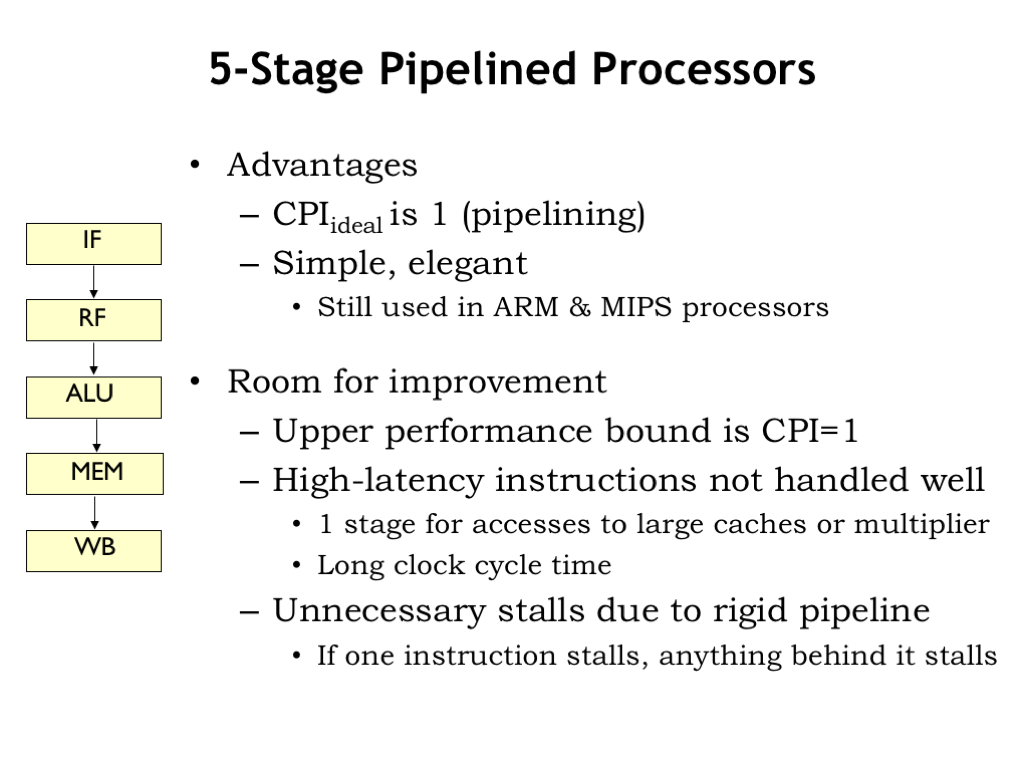
2. 五级流水线处理器(5-Stage Pipelined Processors)

5-Stage Pipelined Processors

经典 5 级是 tCLKt_{\mathrm{CLK}} 与 CPIstall\mathrm{CPI}_{\mathrm{stall}} 的折中。局限:每级同时只处理一条 → CPIideal=1\mathrm{CPI}_{\mathrm{ideal}}=1;慢操作(乘、大 cache)迫使 tCLKt_{\mathrm{CLK}} 变长;流水线内指令顺序固定——LD 在 MEM 因 miss 停住时,前面无关指令也被拖住。如何放松这些约束?

3. 改进五级流水线性能(Improving 5-Stage Pipeline Performance)

Improving Pipeline Performance

加深流水:拆瓶颈(如 MEM1/MEM2),可缩短时钟,但 LD 数据冒险需更多 bubble → CPIstall\mathrm{CPI}_{\mathrm{stall}} 升。更深意味着更多指令并行执行。

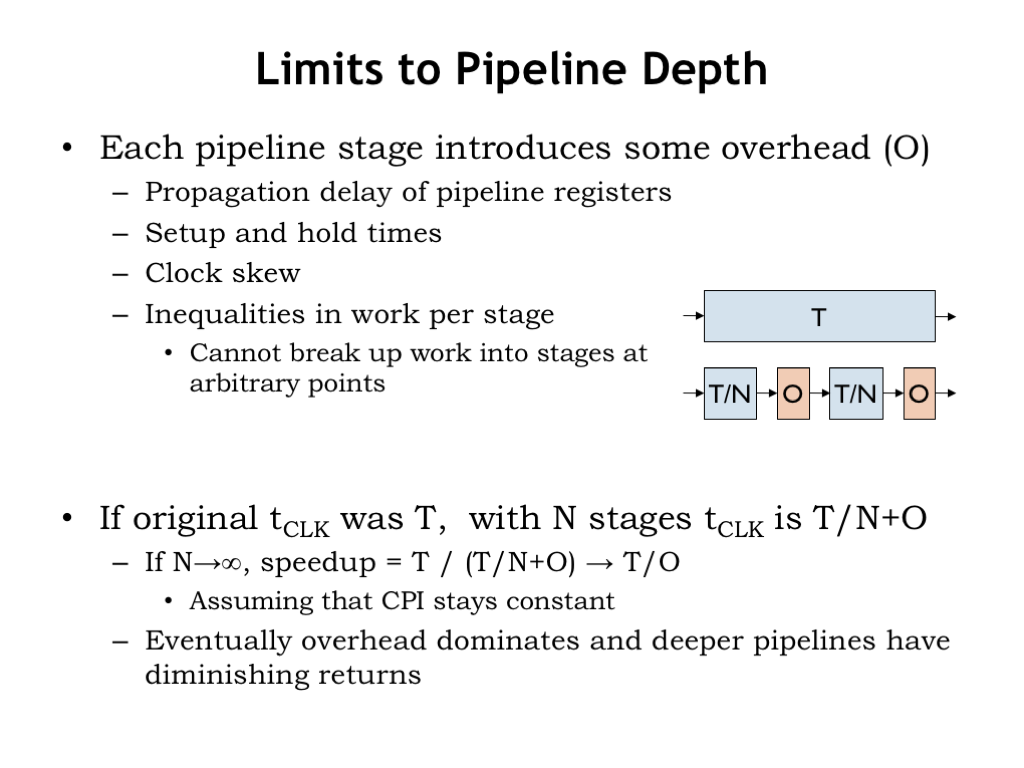
4. 流水线深度的极限(Limits to Pipeline Depth)

Limits to Pipeline Depth

每级额外开销 OO:寄存器 tPDt_{\mathrm{PD}}/setup/hold、clock skew、工作量不均的浪费。原周期 TT、NN 级后周期 ≈T/N+O\approx T/N+O;大 NN 时加速比逼近 T/OT/O——开销主导。Intel Core-2(Nehalem)约 14 级执行流水。

5. 继续改进清单(Improving 5-Stage Pipeline Performance)

Improving Pipeline Performance 2
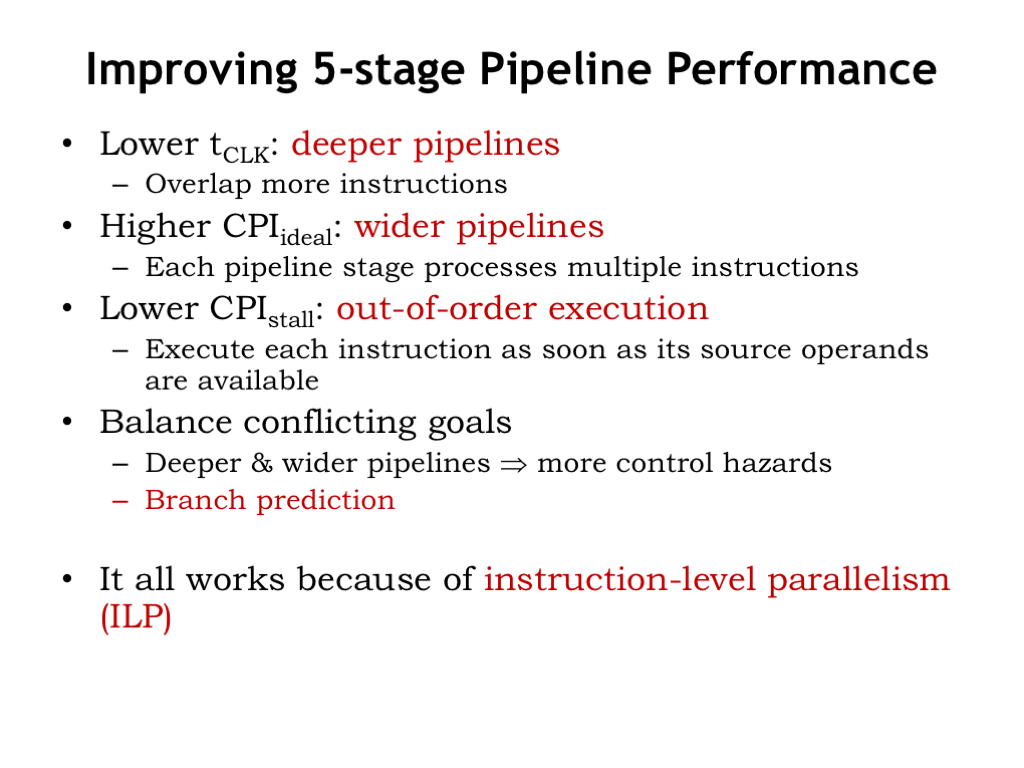
  • 多发射:独立指令并行 → 提高 CPIideal\mathrm{CPI}_{\mathrm{ideal}},级更复杂
  • Out-of-order:冒险阻塞时允许后续无关指令越过
  • 更深更宽放大控制冒险代价 → 需 branch prediction 降低 CPIstall\mathrm{CPI}_{\mathrm{stall}}

可并行/可重排的指令量合称 instruction-level parallelism(ILP)。

6. 指令级并行(Instruction-level Parallelism (ILP))

Instruction-level Parallelism

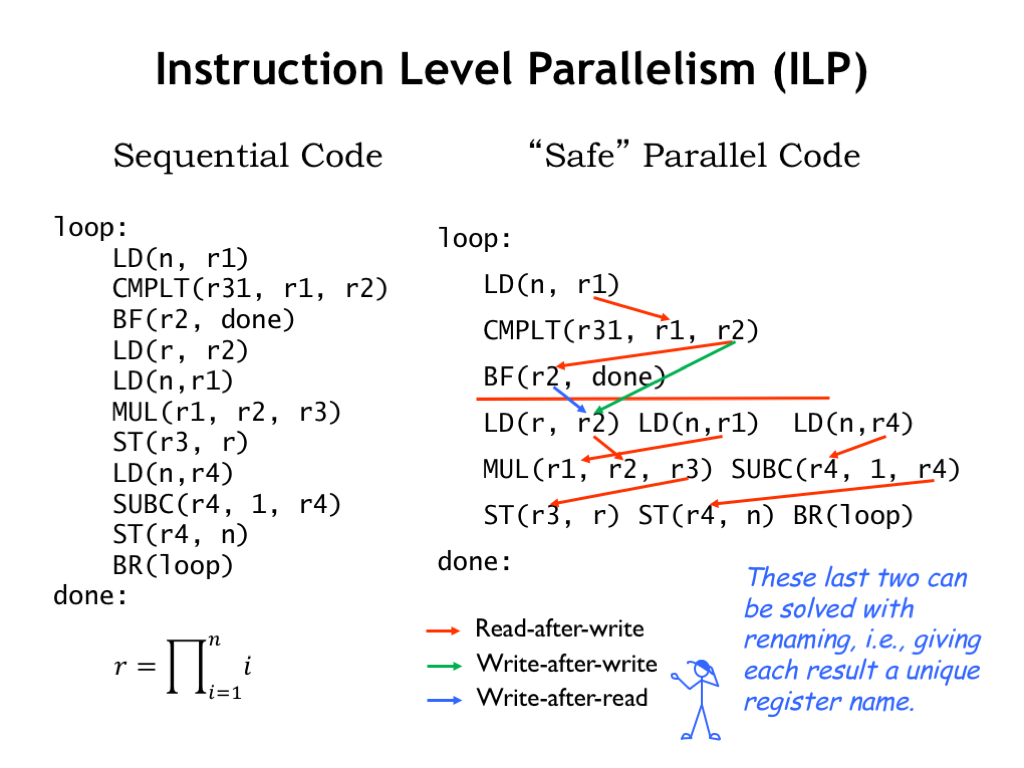
阶乘循环例:同行可并发;BF 下方指令仅在未跳转时有效(可投机执行但须能丢弃)。约束:

  • RAW(红):读依赖先前写——旁路可解,但仍需产生结果的指令先执行
  • WAW(绿)、WAR(蓝):可用寄存器重命名消除

本例中 BF 后潜在并发其实不少。

7. 更宽或超标量流水线(Wider or Superscalar Pipelines)

Wider or Superscalar

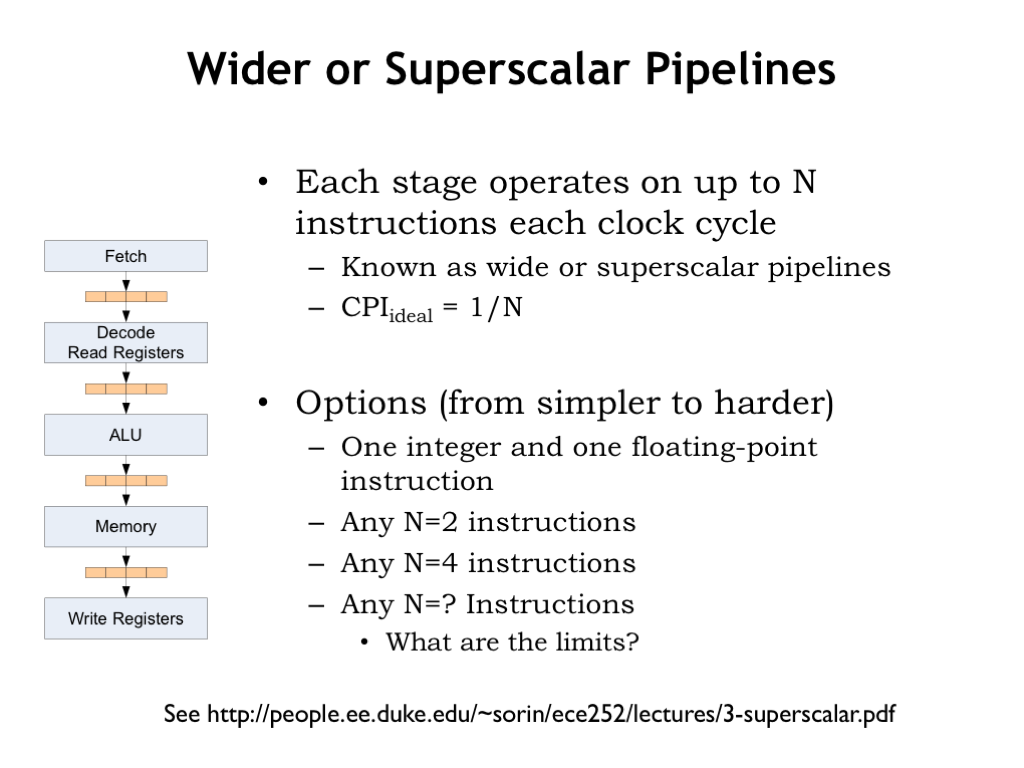
并行执行 NN 条时,CPIideal=1/N\mathrm{CPI}_{\mathrm{ideal}}=1/N。不同功能单元(ADD/SHIFT、整/浮点、LD/ST 地址单元)易并行;多加法器、多端口寄存器堆/内存支撑并发。Nehalem 每周期最多完成约 4 个 micro-op(≈ 简单 RISC 指令)。

8. 现代乱序超标量(A Modern Out-of-Order Superscalar Processor)

Modern OoO Superscalar

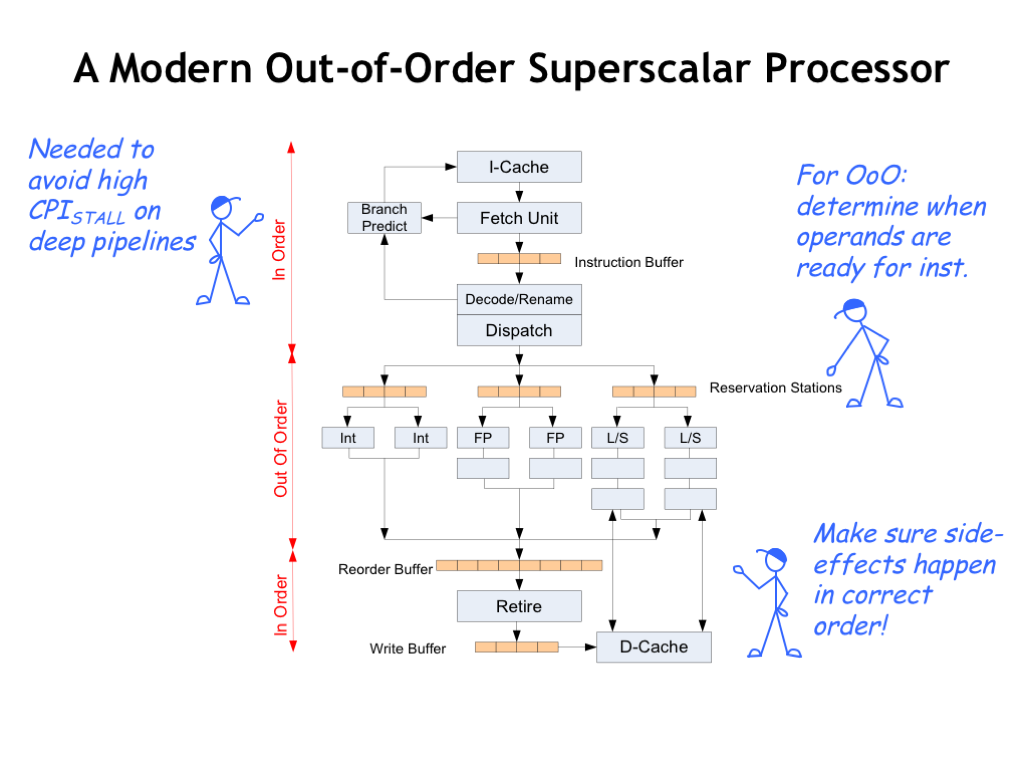
取指/译码一次多条;强依赖分支预测。译码时 register renaming,再派发到功能单元队列,操作数齐则执行——顺序可不同于程序序。结果广播唤醒等待者,并进 reorder buffer 按正确顺序 retire。电路量大;相对单发按序,平均加速约 2×(理想上界约 4)。

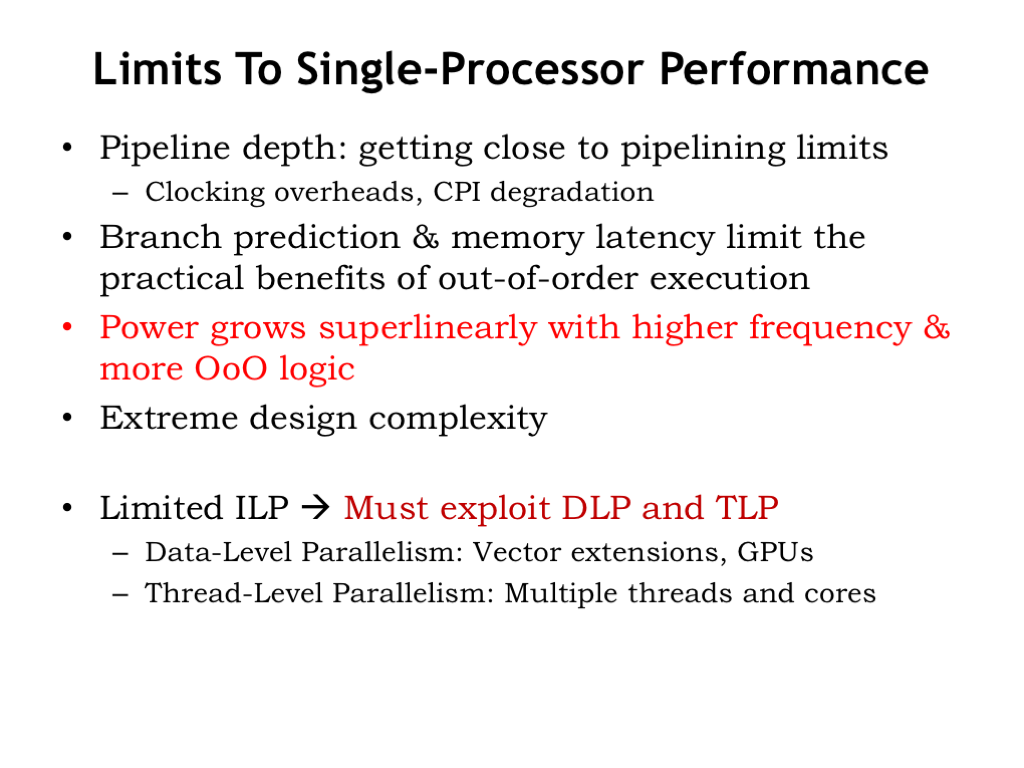
9. 单处理器性能极限(Limits to Single-Processor Performance)

Limits to Single-Processor Performance

再加深:tCLKt_{\mathrm{CLK}} 收益不抵 CPIstall\mathrm{CPI}_{\mathrm{stall}}/开销上升;再加宽乱序亦然;功耗涨得比性能快;分支预测与并发硬件愈发复杂。结论:乱序超标量难再大幅跃进 → 转向 DLP 与 TLP。

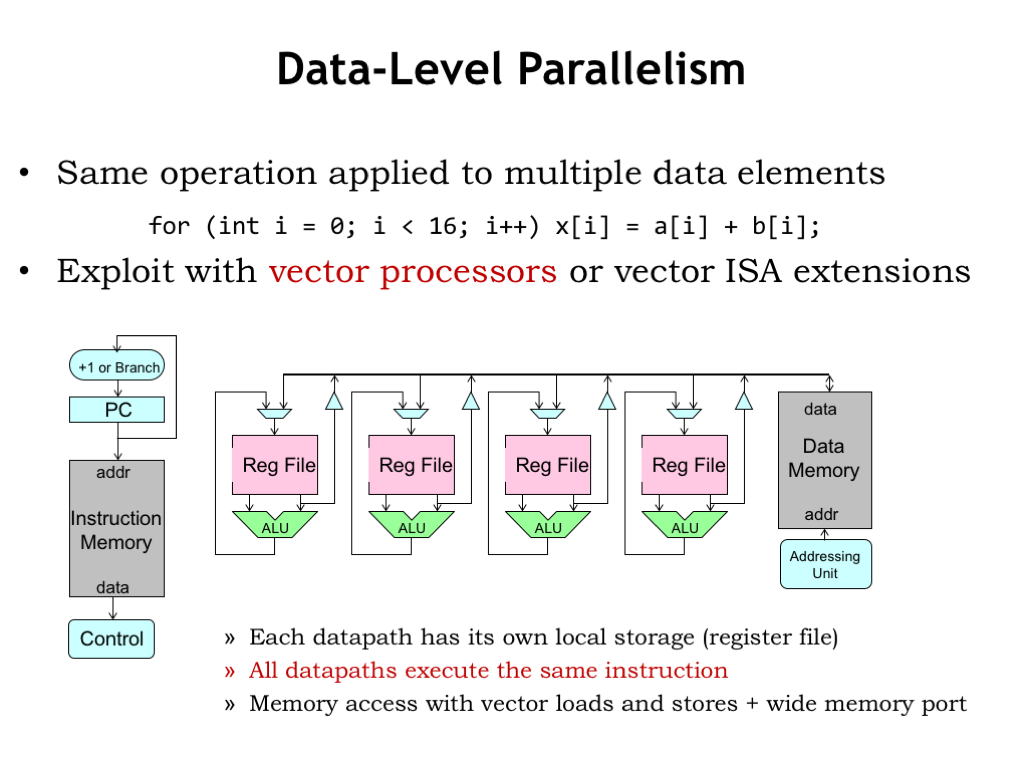
10. 数据级并行(Data-Level Parallelism)

Data-Level Parallelism

音频向量、图像像素矩阵常对每元素做相同运算。复制 datapath,共享译码控制 → 向量处理器:块取存(似 cache line),总线一次送多字。一条指令 ≈ 标量机 NN 条,并行性“编进”程序,无需乱序发现。

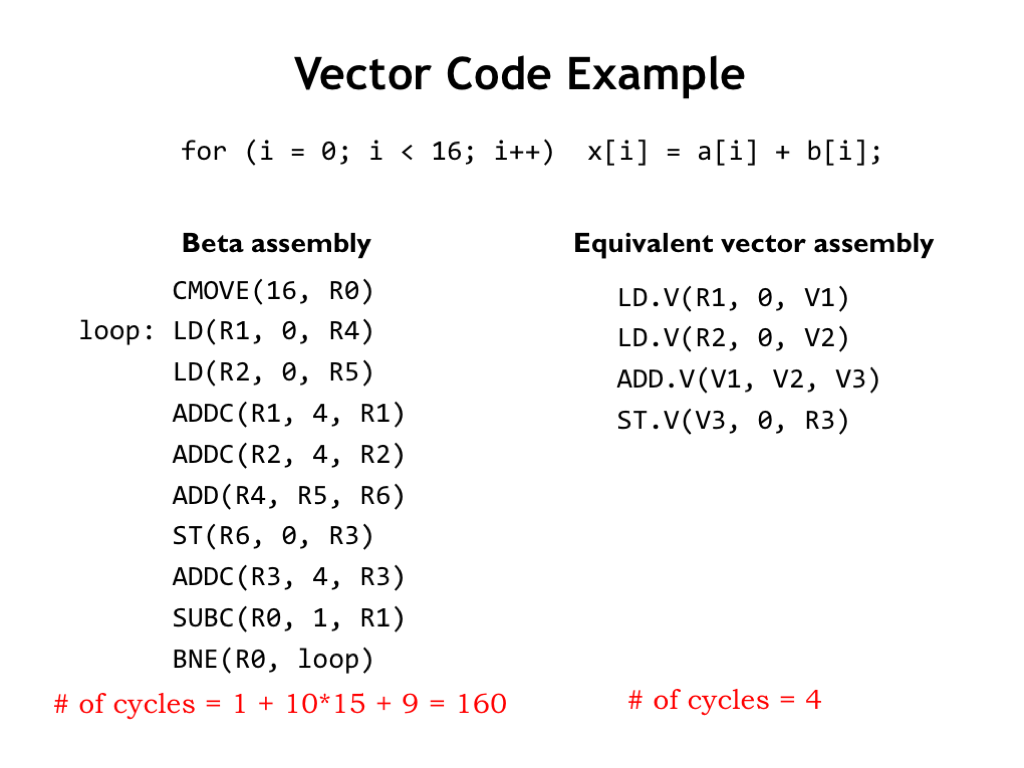
11. 向量代码例(Vector Code Example)

Vector Code Example

16 路向量机做向量加:Beta 循环约 9 指令/10 周期 ×16 ≈ 160 周期;向量码约 4 周期 → 加速约 40(理想情况)。关键是能否 vectorize;音视频与 DSP 通常可以。内存块访问也摊薄开销。

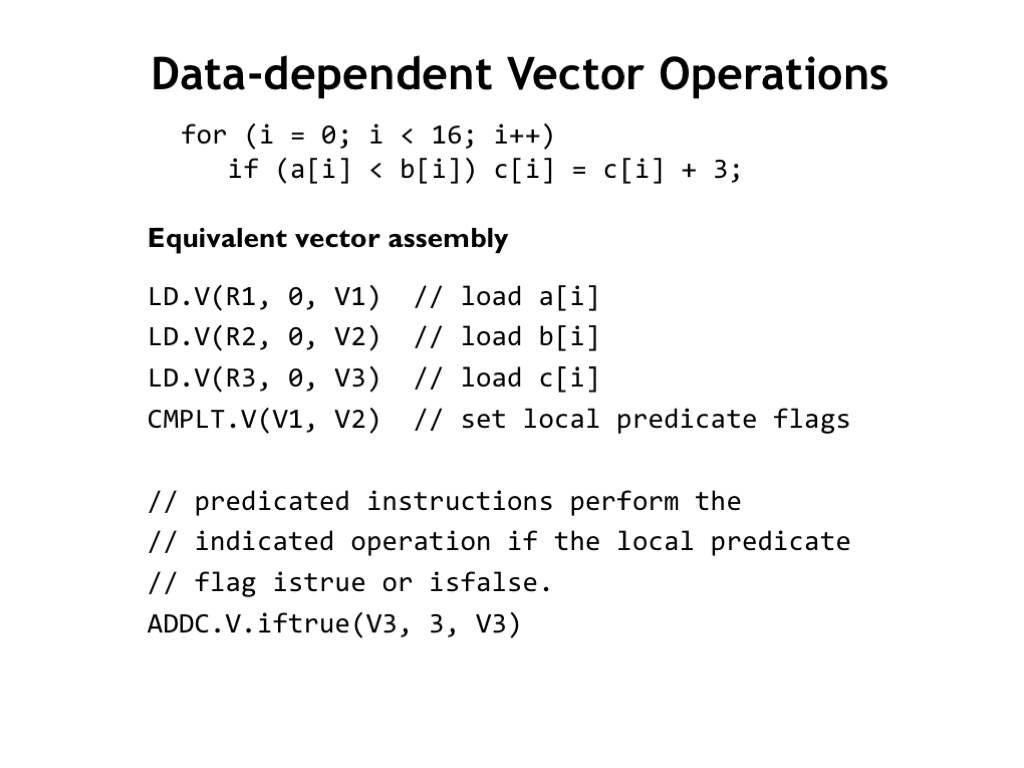
12. 数据相关的向量操作(Data-Dependent Vector Operations)

Data-Dependent Vector Operations

条件执行:各 datapath 设本地 predicate;CMPLT.V 并行比较并置谓词;ADDC.V.iftrue 仅谓词为真时执行。Predication 在非向量 ISA 也用于避免短条件分支的误预测代价(x86 CMOV、ARM 条件执行)。

13. 向量处理实现(Vector Processing Implementations)

Vector Processing Implementations

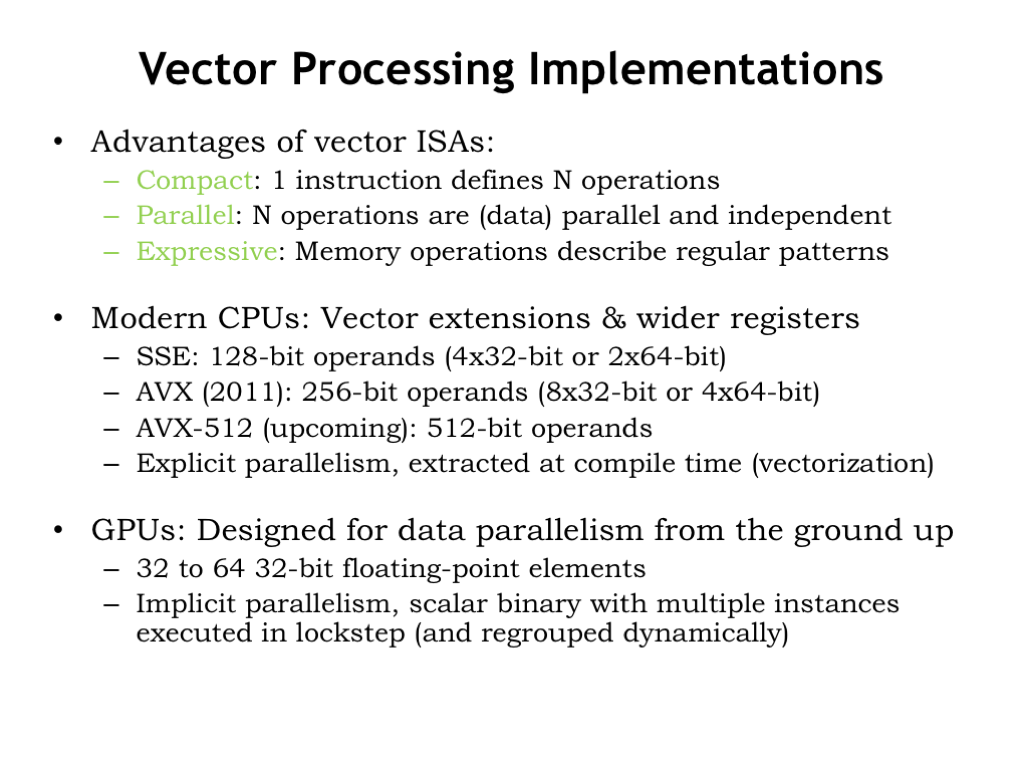
现代 CPU 常有 SIMD/向量扩展(128/256/512-bit 打包 8–64-bit 元素)。GPU 是极端多 datapath,专长 3D 渲染中“尴尬并行”的浮点变换/着色/纹理;亦用于生物信息、大数据、深度学习等。DLP 在多种场景显著加速,未来 ISA 几乎都会保留向量支持。

14. 多核处理器(Multicore Processors)

Multicore Processors

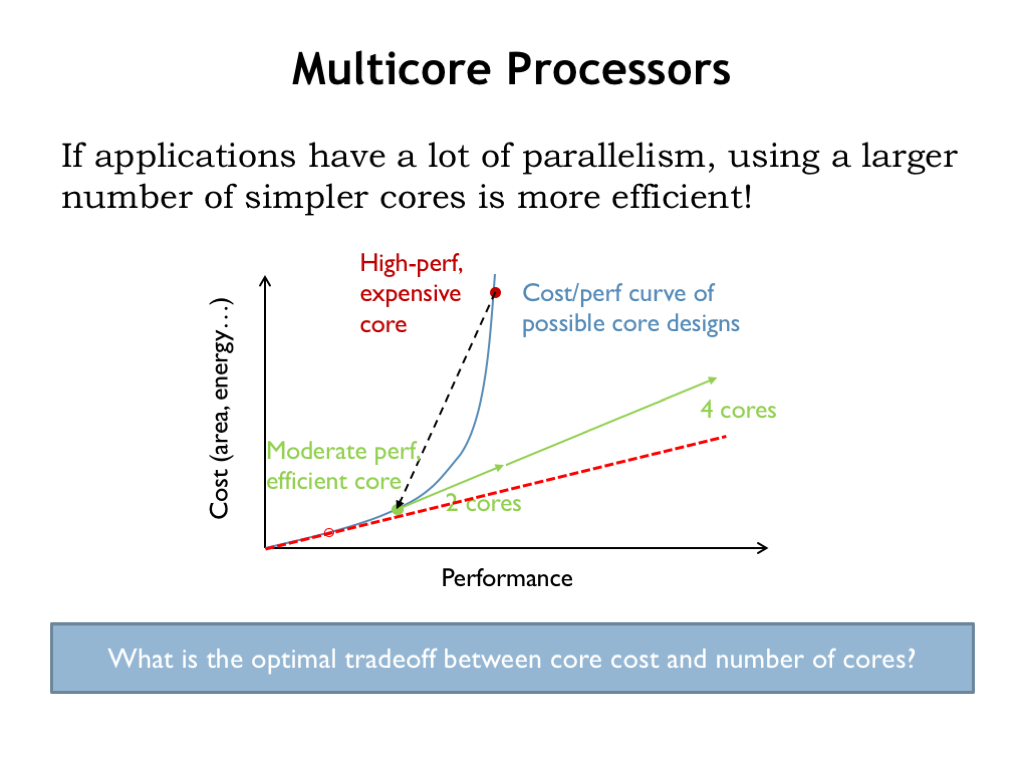
单核成本–性能曲线陡:半性能可能只需 1/4 成本。任务可拆成独立子任务时,多个更小核可达相近总性能且更便宜;并行可扩展时性能近似随核数线性。最优点数受分发/聚合开销制约,但“更多更高效小核”仍有吸引力。

15. Amdahl 定律(Amdahl’s Law)

Amdahl's Law

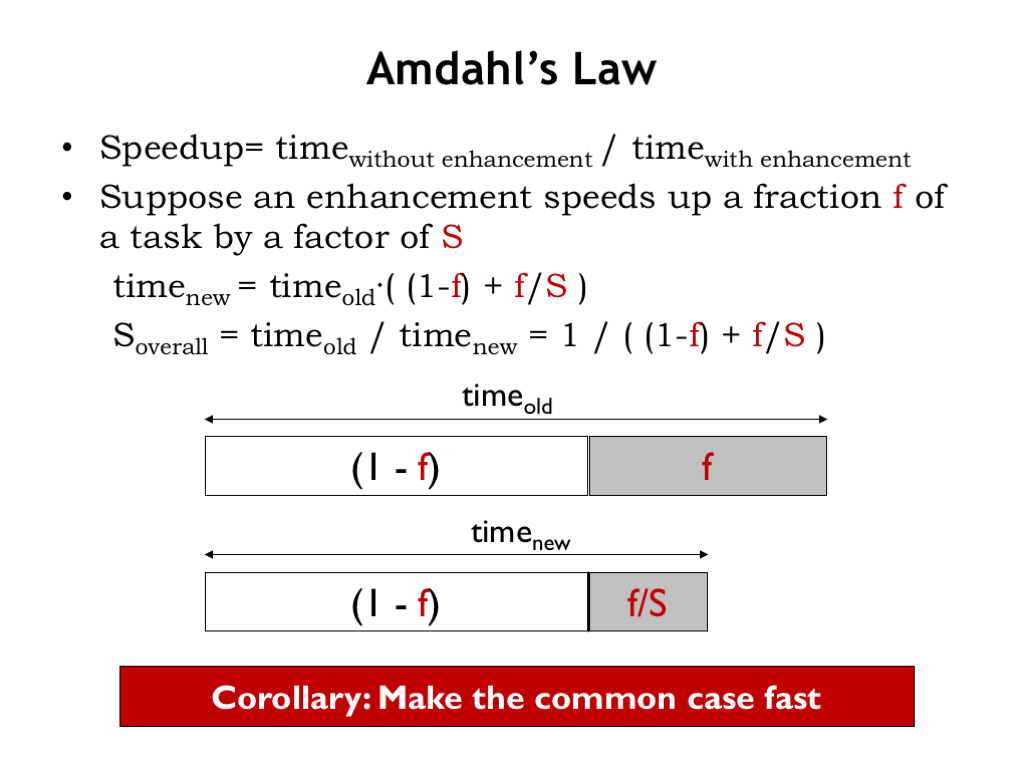
Gene Amdahl(1967):加速任务中比例 FF 的部分 SS 倍,整体加速比 =1/((1−F)+F/S)=1\big/\big((1-F)+F/S\big)。应优先加速占比大的部分(做大 FF)。

16. Amdahl 与并行(Amdahl’s Law and Parallelism)

Amdahl's Law and Parallelism

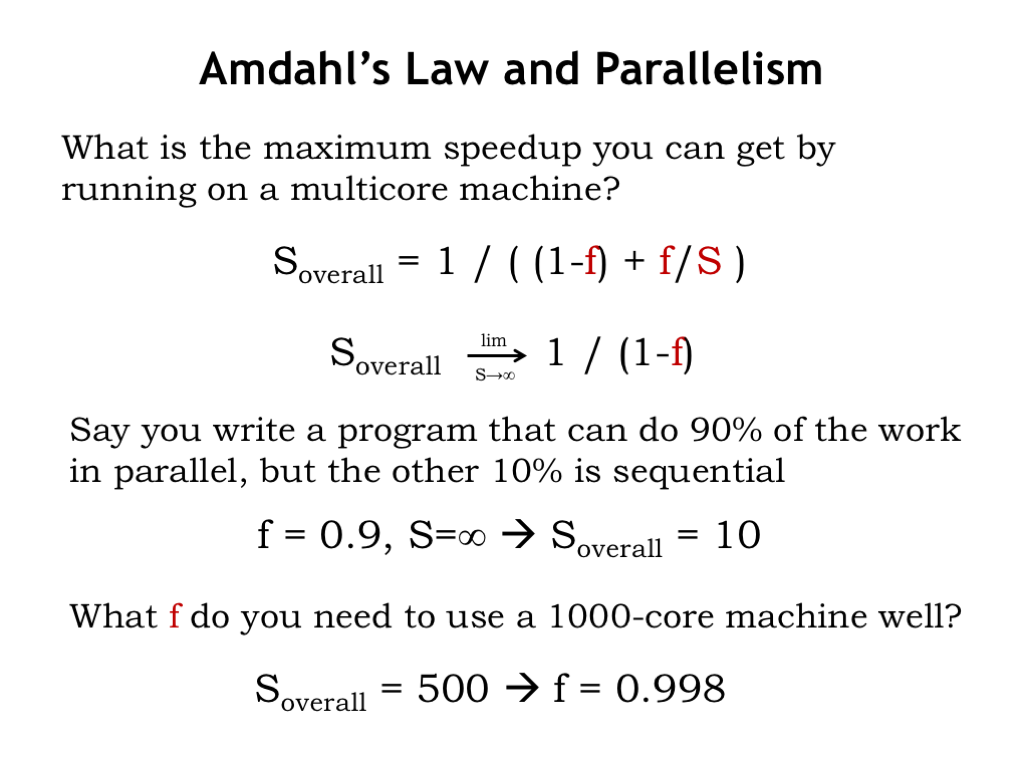
并行部分 FF 可任意加速时,整体加速上界 1/(1−F)1/(1-F)。90% 可并行 → 最多 10×;想在 1000 核上拿 500×,需并行化约 99.8%。多核最适合天然高并行任务。

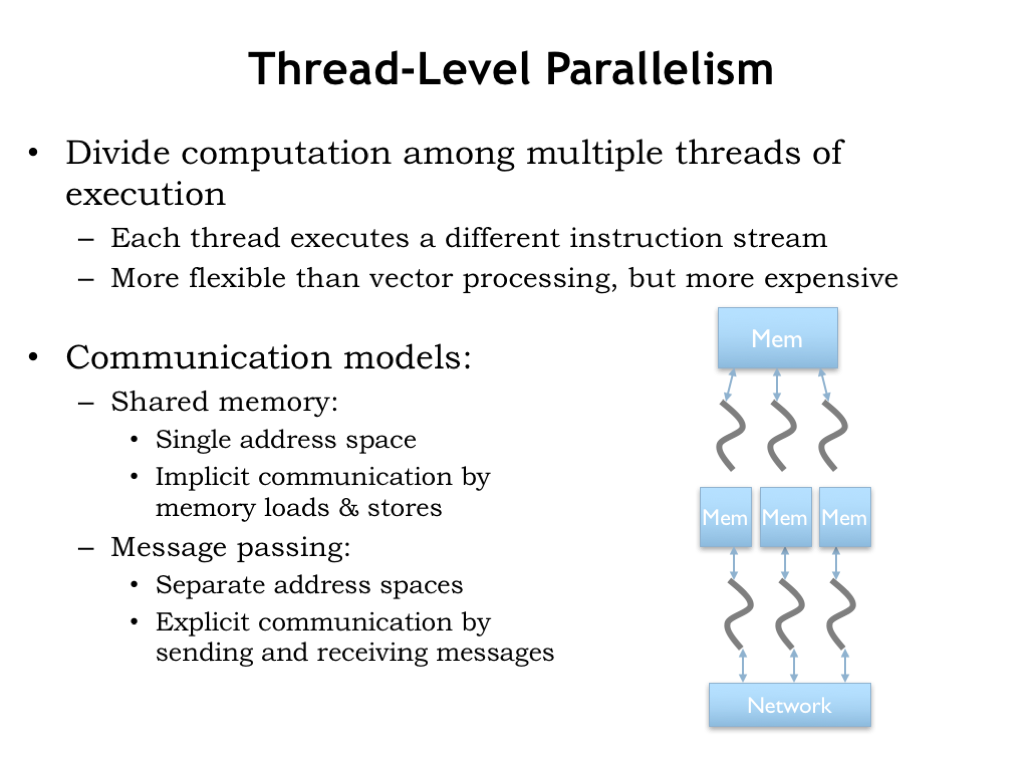
17. 线程级并行(Thread-Level Parallelism)

Thread-Level Parallelism

TLP:每核跑独立线程,比向量的锁步更灵活。少核时常 共享内存 通信;数十/数百核则共享内存带宽成瓶颈,改用消息网络(片上 mesh、集群 MPI / InfiniBand)。以下聚焦共享内存多核问题。

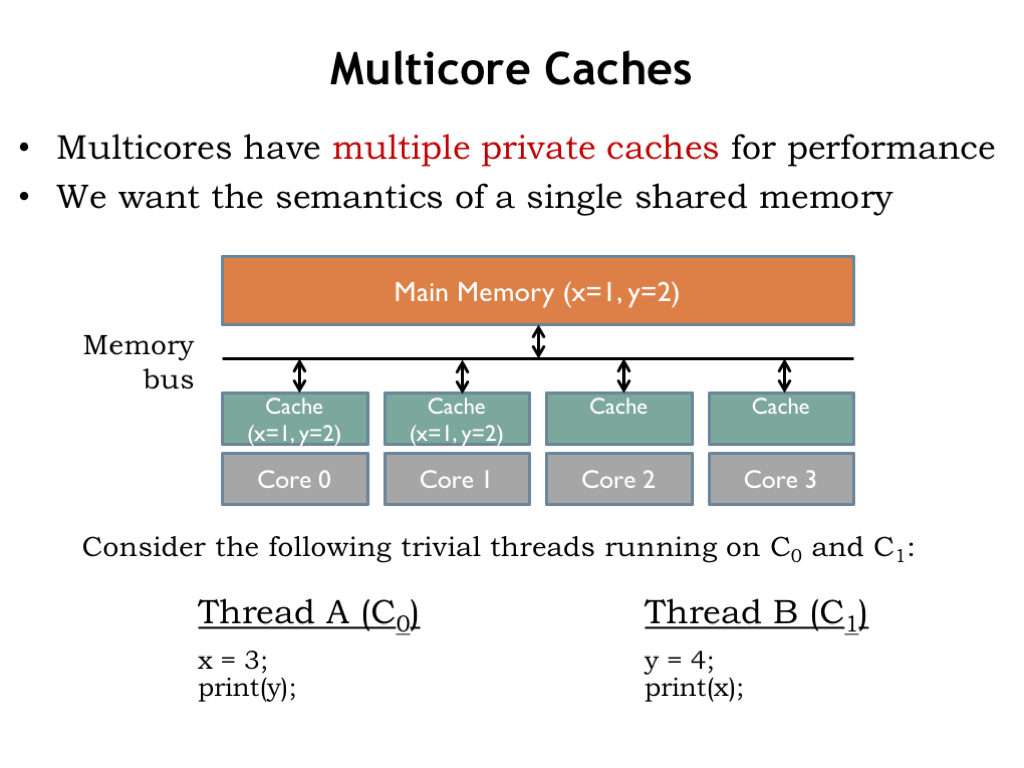
18. 多核缓存(Multicore Caches)

Multicore Caches

每核私有 cache(写回)降低平均访存;miss 才打共享主存。目标:一核对共享变量的修改应对所有核可见。例:核 0/1 各跑线程 A/B,共享 X=1X=1、Y=2Y=2,并已缓存在两核。

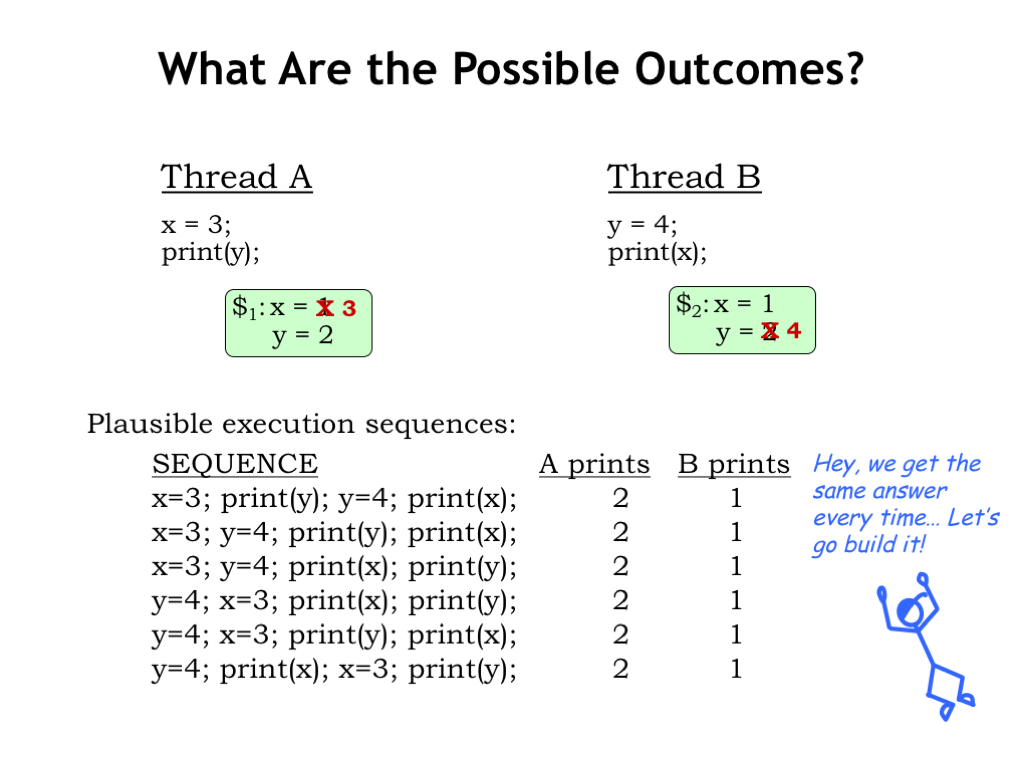
19. 可能的结果?(What Are the Possible Outcomes)

What Are the Possible Outcomes

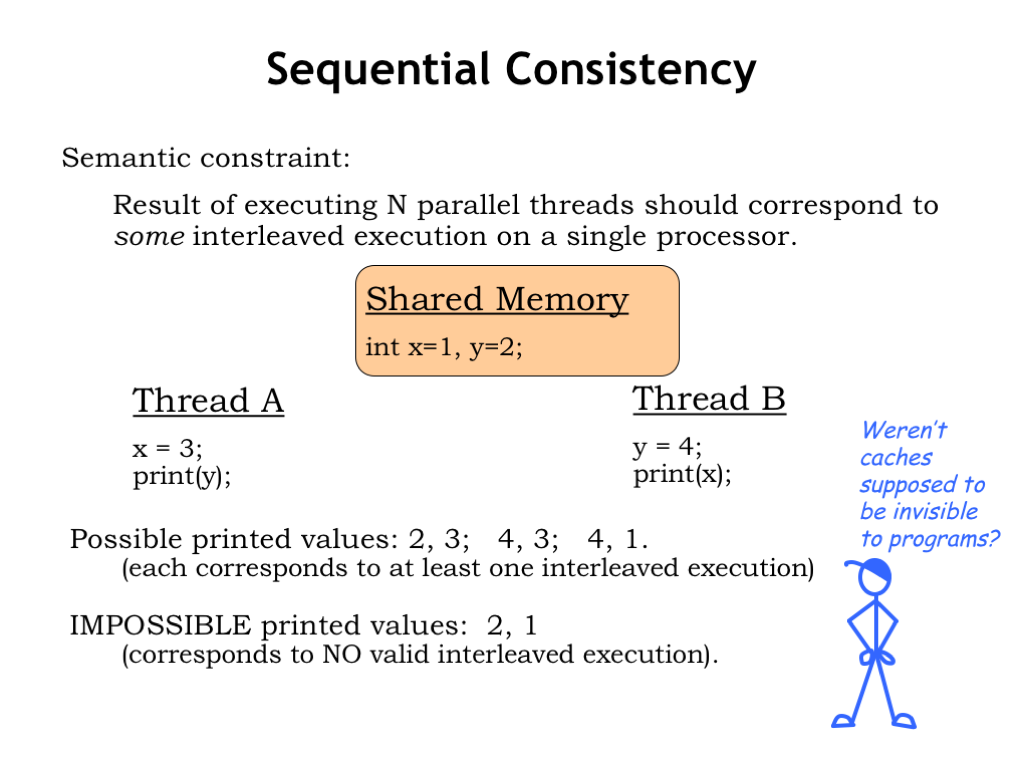
各线程只更新本地 cache:打印结果可一致(A 打 2、B 打 1),但结束后两核对 X,YX,Y 的缓存副本可分歧——不再像单一共享内存。去掉 cache 又会毁掉多核性能。

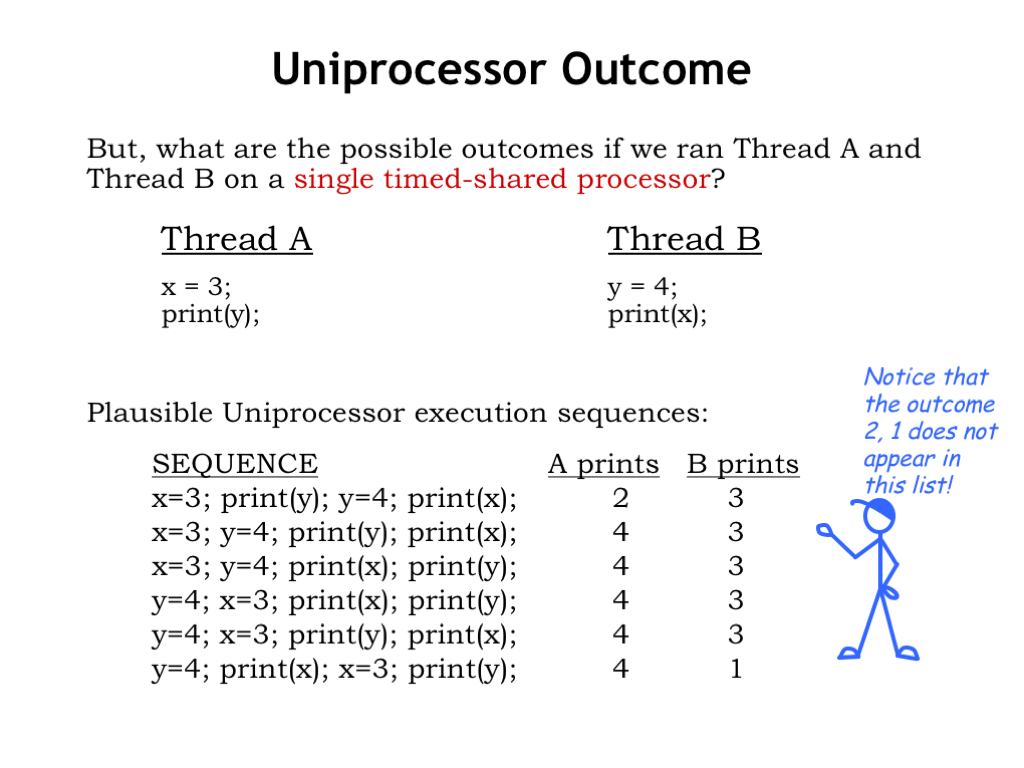
20. 单处理器结果(Uniprocessor Outcome)

Uniprocessor Outcome

正确性基准:同一分时单核上交错执行的可能结果集。程序员知结果不唯一,需用 semaphore 等加约束。简单多核出现的 (2,1) 不在该交错结果表中。

21. 顺序一致性(Sequential Consistency)

Sequential Consistency

Sequential consistency:并行执行 NN 线程 ≡ 某次单核交错。简单多核两败:① 共享变量副本不一致;② 因而也不满足顺序一致性。需要修复。

22. 顺序一致性的替代?(Alternatives to Sequential Consistency?)

Alternatives to Sequential Consistency

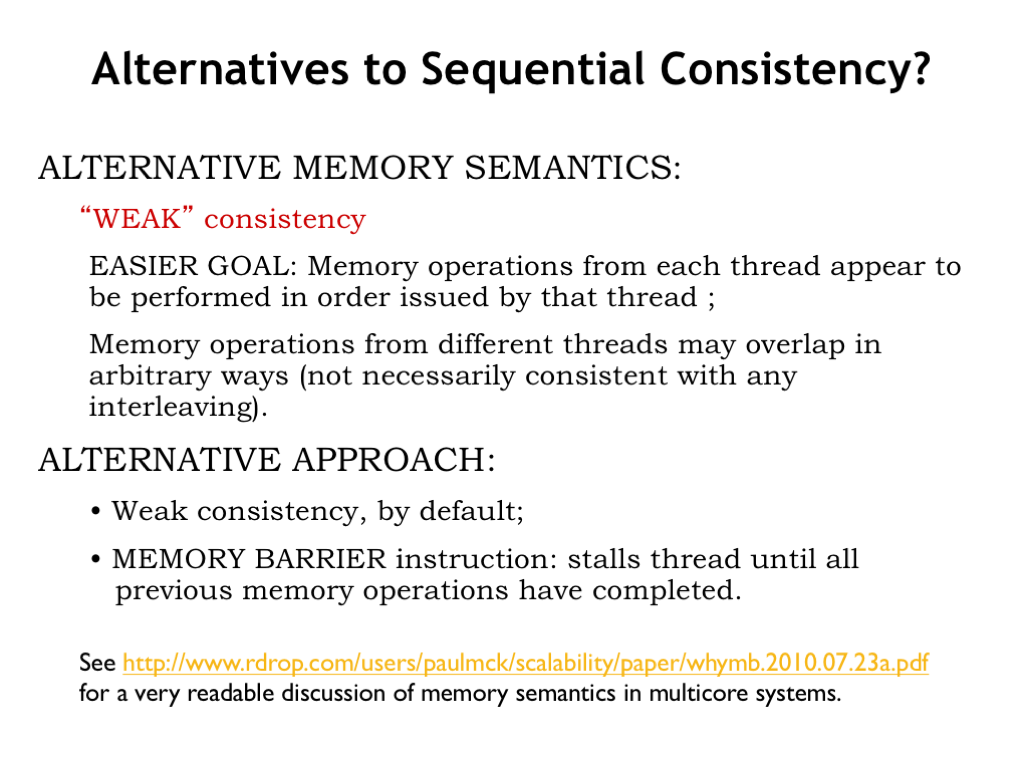
Weak consistency:只保证单线程内发出的访存按该线程顺序对外可见(写 X 再写 Y → 无人会看到新 Y 旧 X);他线程操作可任意重叠。私有写回 cache 连弱一致性也不自动保证(脏 Y 可能先于脏 X 写回)。乱序核提供 BARRIER:屏障前访存完成才执行屏障后访存。各商用多核语义各异——须读 ISA 手册。

23. 修复:侦听缓存一致性(Fix: “Snoopy” Cache Coherence Protocol)

Snoopy Cache Coherence

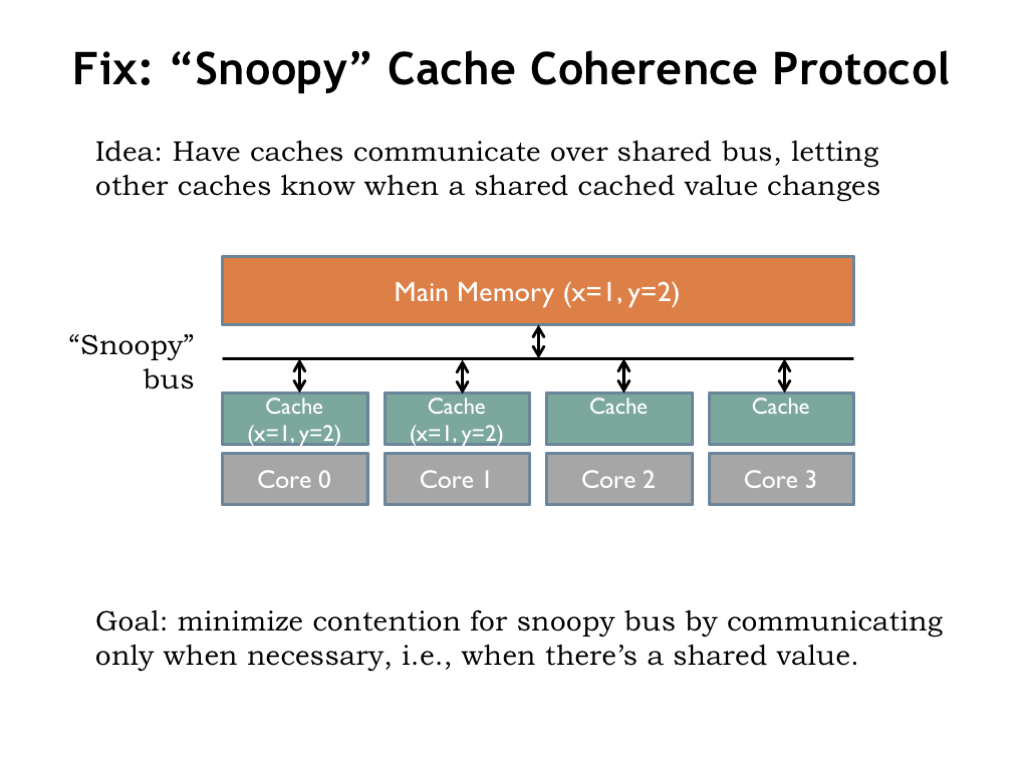
缺通信:改共享变量时他核不知。在共享总线上让各 cache snoop,更新本地状态 → cache coherence protocol。希望仅在真正共享时才付通信开销。

24. 例:MESI 协议(Example: MESI Cache Coherence Protocol)

MESI Protocol

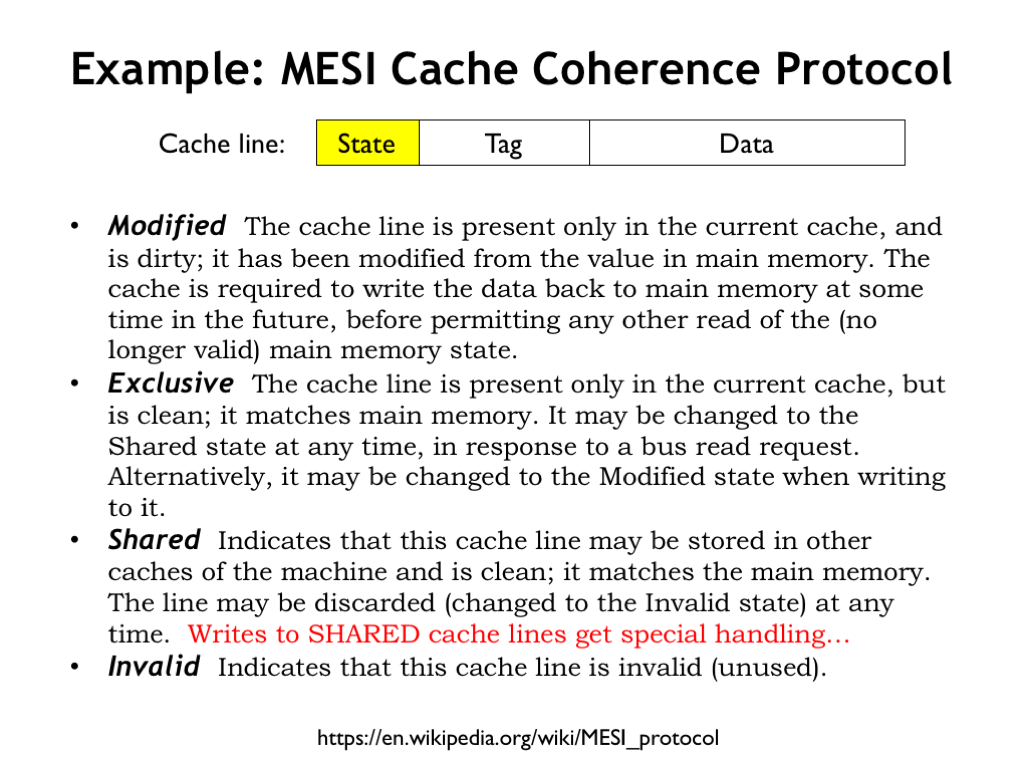
每 cache line 状态:

状态 含义
Invalid 无效(原 valid=0)
Exclusive 独有且与主存一致
Modified 独有且已改(脏)
Shared 多副本,未改

读 miss:无他核 → 自内存装入置 E;他核有 E/S → 供应数据并标 S;他核有 M → 供应脏数据并写回内存,双方标 S。写:若 S 则发 INVALIDATE 使他核失效后独占再改;已是 E 则可本地改而无广播。

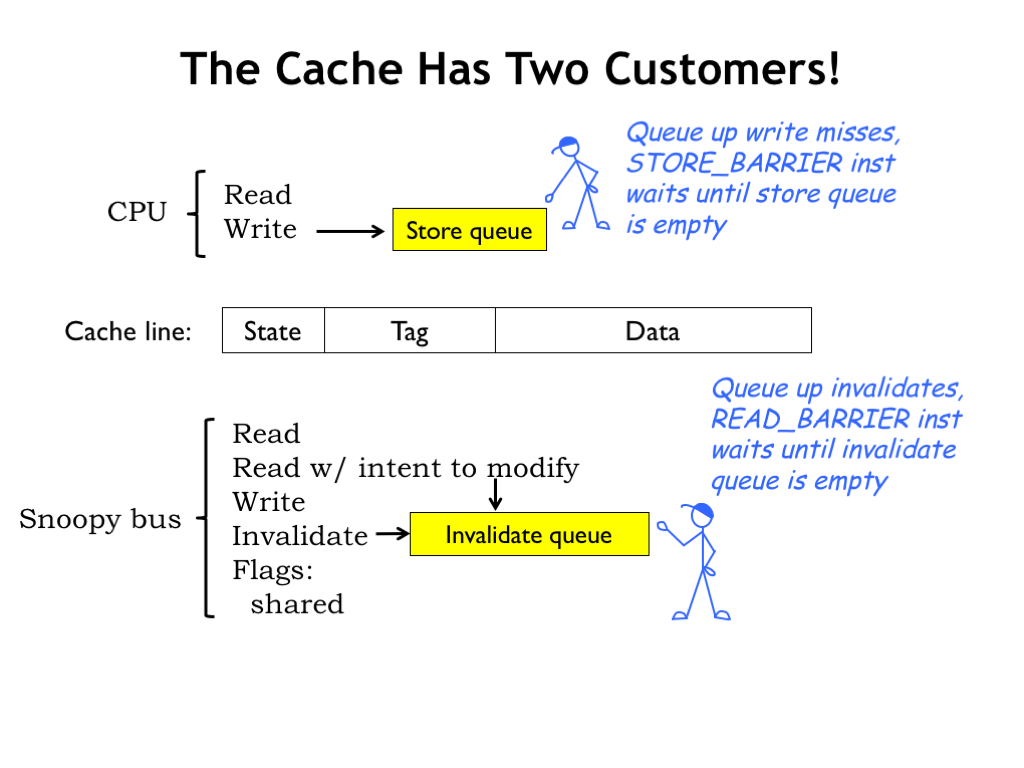
25. Cache 有两位“顾客”!(The Cache Has Two Customers!)

Cache Has Two Customers

硬件服务两路请求:CPU 侧(含 store 队列,miss 时 CPU 可继续;读须先看 store 队列)与 snoopy 总线侧(失效/供应/改状态)。STORE_BARRIER 等到 store 队列空;READ_BARRIER 等到 invalidate 队列空。“read with intent to modify” = READ 紧接 INVALIDATE。

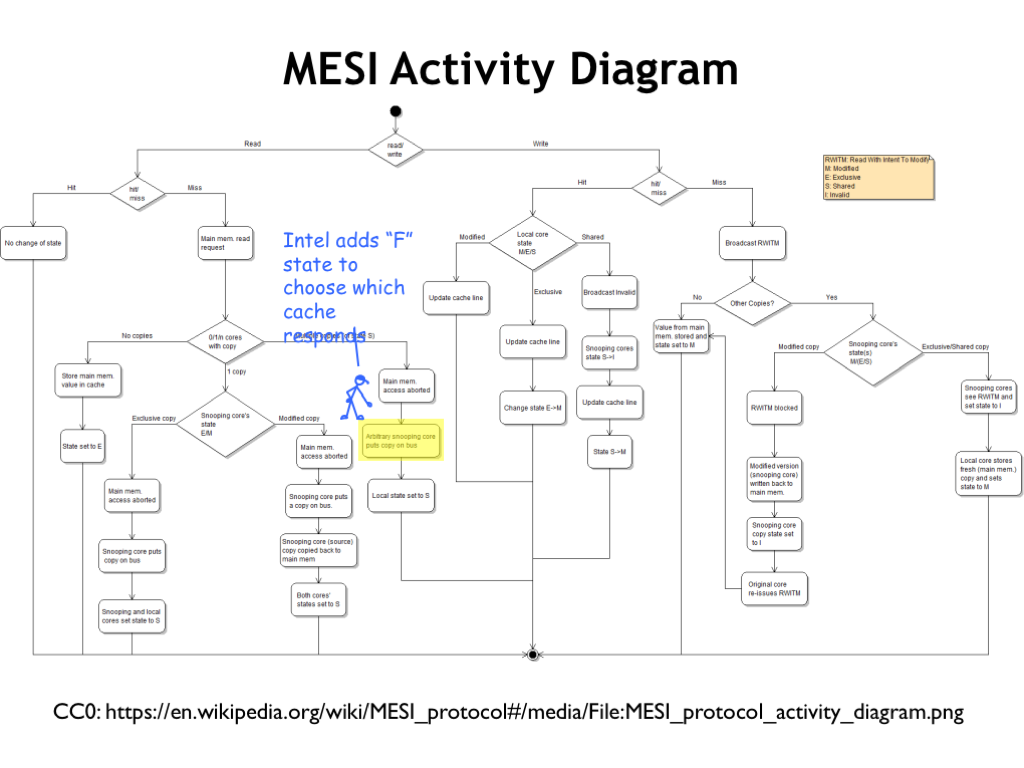
26. MESI 活动图(MESI Activity Diagram)

MESI Activity Diagram

流程图(字极小)给出 CPU/总线事务如何改状态。Intel 另加 F 态,在多份 SHARED 中指定谁响应读请求。下面用前述例子走一遍 MESI。

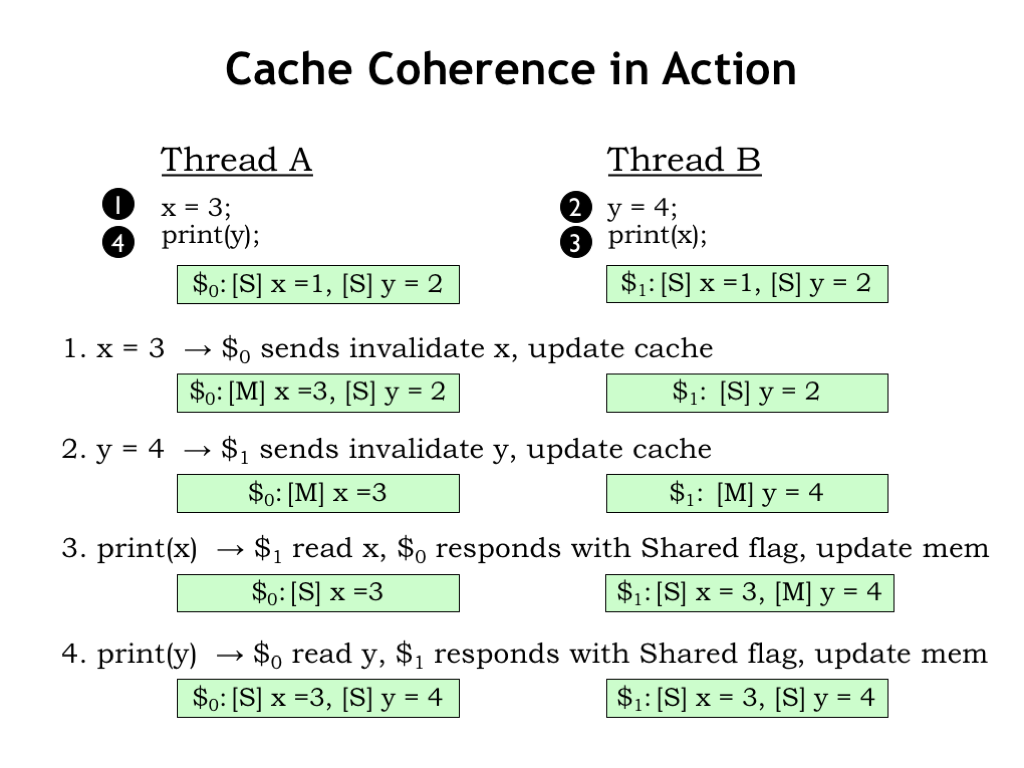
27. 缓存一致性实战(Cache Coherence in Action)

Cache Coherence in Action

X,YX,Y 初始 SHARED。顺序 (1)–(4):

  1. A 写 X=3X=3:发 INVALIDATE → 独占改写;核 1 失去 XX
  2. B 写 Y=4Y=4:同理独占 YY
  3. B 读 XX:miss → 核 0 供应新值,双方标 S,主存更新
  4. A 读 YY:对称事务

结果与同序单核交错一致;两核最终对 X,YX,Y 看法一致。其他交错同样保持顺序一致性与共享语义——一致性协议尽责。

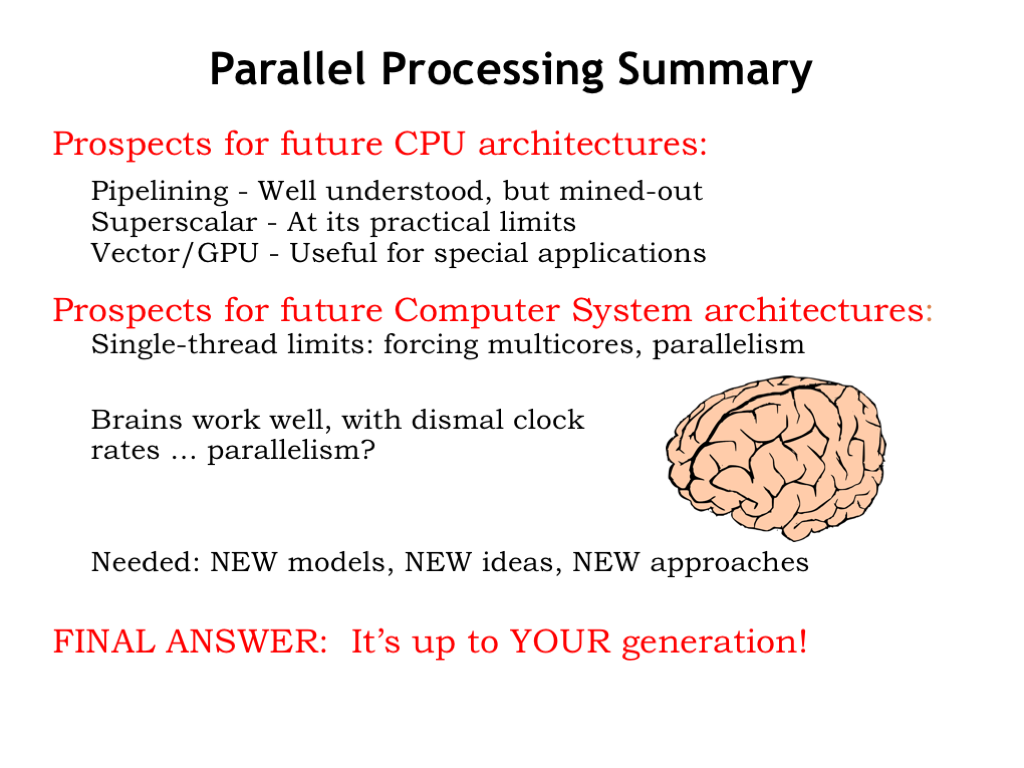
28. 并行处理小结(Parallel Processing Summary)

Parallel Processing Summary

单核流水深度与乱序超标量已近收益递减;GPU 继续为专用负载演进,但不取代通用计算。系统趋势是更多核 + 新算法挖并行。展望:大脑用很慢的机制完成非凡认知——靠大规模并行,还是不同计算模型(如神经网络)?认知类应用仍有架构与技术新边疆。

整理自 MIT OCW 6.004 Computation Structures(Spring 2017)L20 注解幻灯片。

源网页:20.1 Annotated Slides | System-level Communication

讲师:Chris Terman。图片直接引用 OCW 原站链接。

L20:系统级通信(System-level Communication)

本讲从“接口比实现更长久”出发,回顾背板 bus 的电气与时序困境(传输线、反射、clock skew),总结网络经验:单驱动、点对点、差分、时钟恢复(8b/10b);再看 PCIe/QPI 等串行链路,并以渐近复杂度比较 ring / mesh / hypercube 等拓扑。

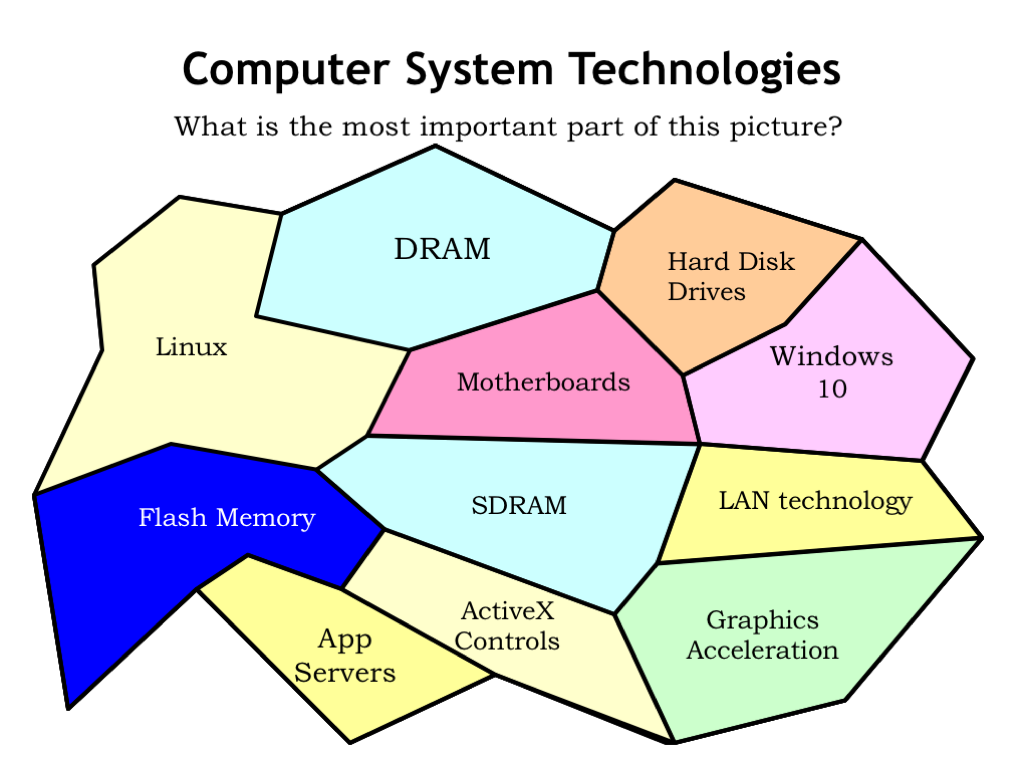
1. 计算机系统中的技术(Computer System Technologies)

Computer System Technologies

系统拼合多种技术;各部件有功能与接口规格。设计者按规格集成,不必深究内部实现。技术换代(更小更快更省电)时,接口不变即可几乎无痛替换——架构中真正长久的是接口。

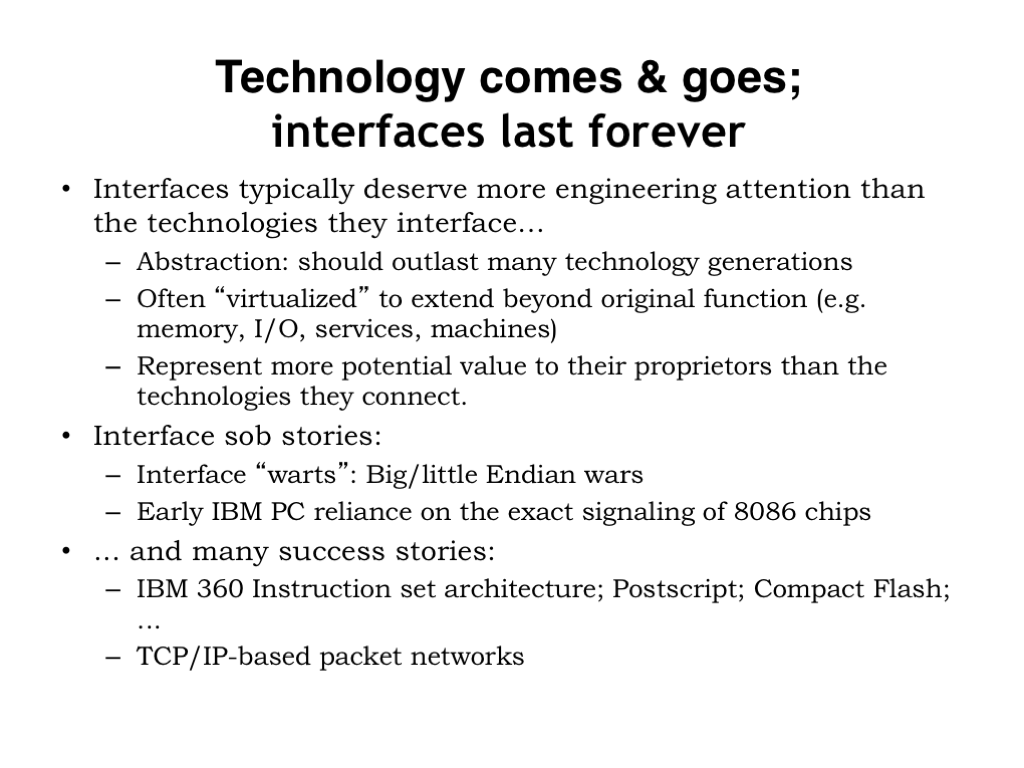
2. 接口天长地久(Interfaces Last Forever)

Interfaces Last Forever

长寿接口靠有用抽象:可靠字节流网络、窗口图形、日志文件系统等,屏蔽包/错误恢复/存储阵列细节。晶体管翻倍、网络 1→10 GHz、内存×4 时,不能每次从零重写。

反例:

  • Endianness:IBM big-endian vs Intel little-endian——本地方便,联网传数值却终身麻烦(“一时方便,终身后悔”)
  • 早期 IBM PC 扩展总线直接暴露当时 x86 引脚与协议——与特定 CPU 绑定,后续升级痛苦

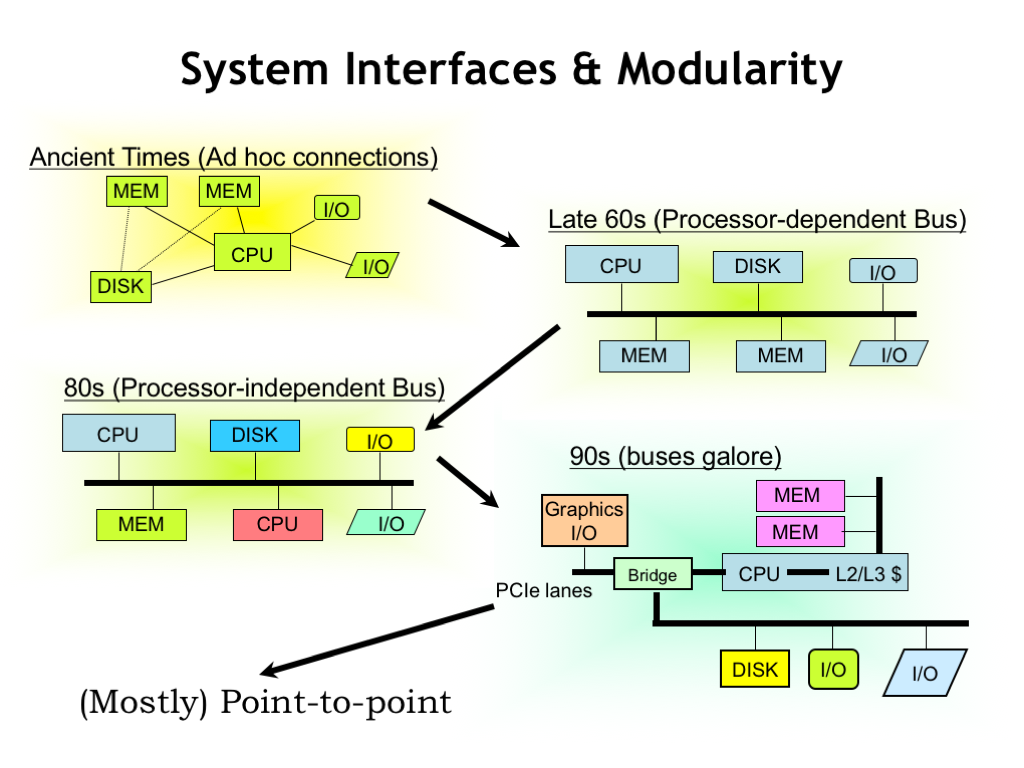
3. 系统接口与模块化(System Interfaces & Modularity)

System Interfaces and Modularity

演进:机柜间 ad-hoc 线缆 → 背板插板模块化(厂商互不兼容)→ 标准化背板促进竞争 → 性能再涨,背板带宽不够 → 又回到专用通道林立。工程现实最终推向 通用单向点对点 通道;异步点对点大体取代早期同步多信号总线。系统级通信多为线传,速率从 kHz 到 GHz 带来新电气问题。

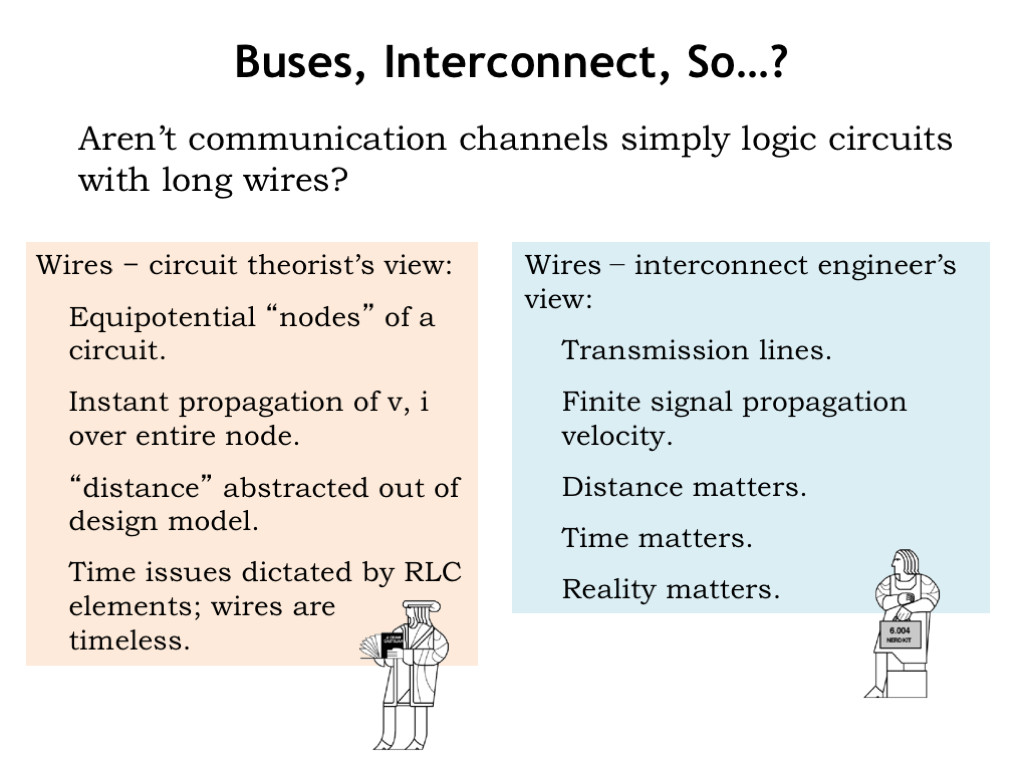
4. 总线、互连,然后呢?(Buses, Interconnect, So…?)

Buses Interconnect

电路理论里导线是等势节点:电压处处相同、变化瞬时传到各端,距离被抽象掉。当电压变化速率相对电磁波渡越时间不再“慢”时,该模型失效。Heaviside 的电报方程早已说明信号沿导线有限速传播——高速下导线是 transmission line,长度与传播必须计入。

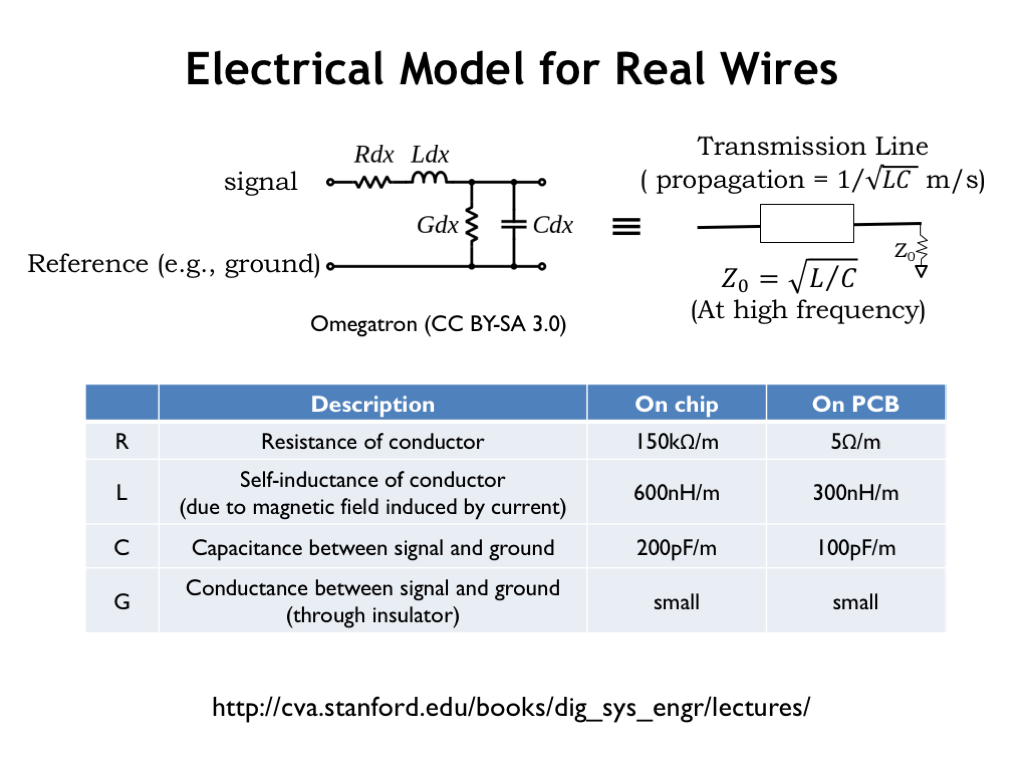
5. 真实导线的电气模型(Electrical Model for Real Wires)

Electrical Model for Real Wires

无穷小段模型参数:RR(电阻)、LL(自感)、CC(对参考的电容)、GG(绝缘泄漏)。高速、芯片/板级距离下近似无损传输线,特征阻抗 Z0Z_0,波速 ∼1/LC\sim 1/\sqrt{LC}。PCB 约 Z0∼50 ΩZ_0\sim 50\,\Omega,传播约 18 cm/ns。

电压阶跃沿导线传播;末端若不吸收能量会反射回波。需用匹配 Z0Z_0 的电阻端接;双向传播则两端都要端接。

6. 现实后果(Real-world Consequences)

Real-world Consequences

残留能量会污染后续传输。通用药方是给更多时间稳定——高性能系统不可接受,故须减小储能效应:端接不准→反射;阻抗不连续→处处小回波;容性负载限制翻转速率→runt pulse;LC ringing 需等阻尼到合法电平。精心设计布线与驱动可把性能损失压到最低。

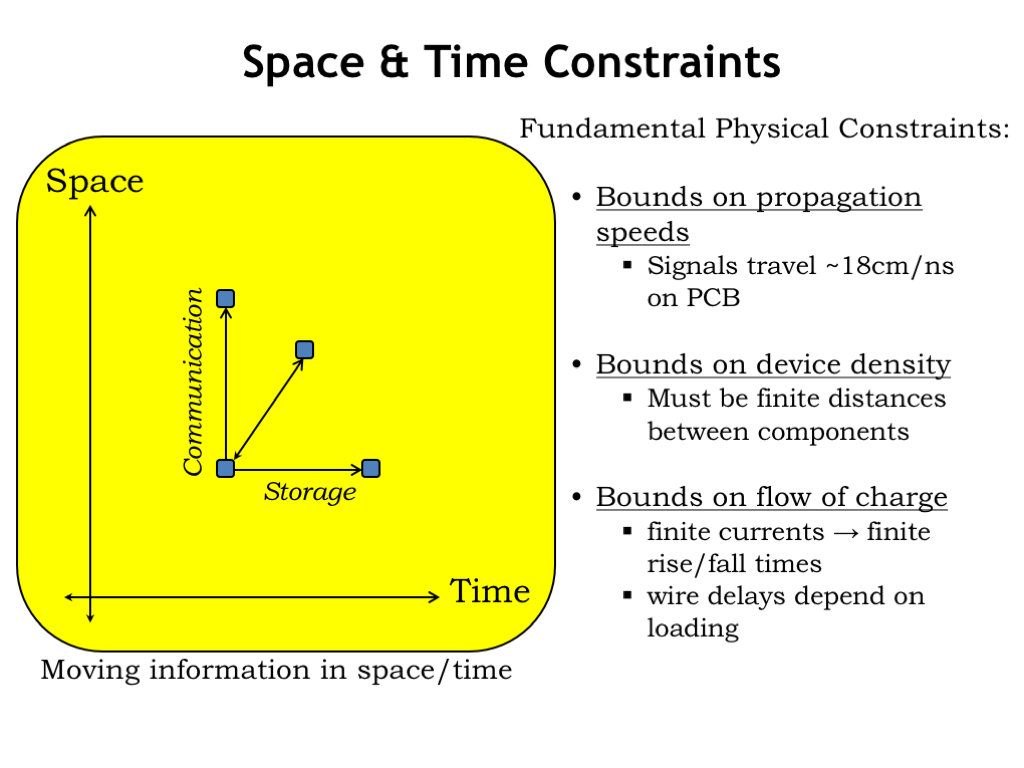
7. 空间与时间约束(Space & Time Constraints)

Space and Time Constraints

信息沿时间保持 → storage;送到另一部件 → communication。通信耗时,时序预算必须计入:传播速度上限、部件间距、翻转过快引发的效应。时序模型要显式包含 wire delay。

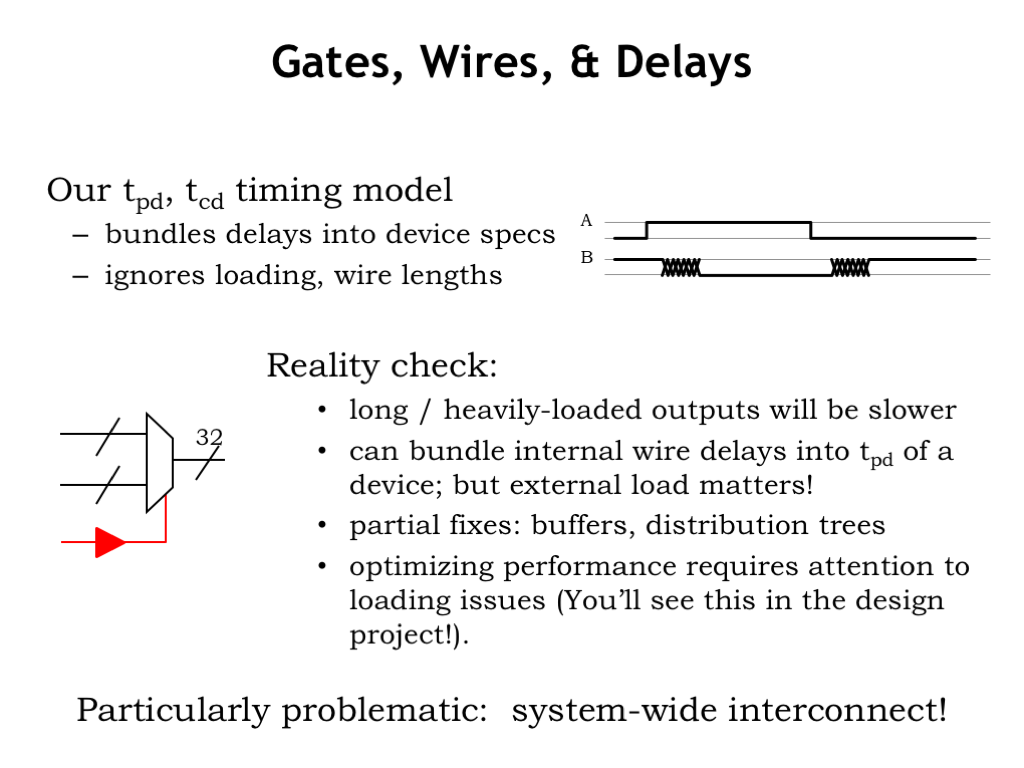
8. 门、线与延迟(Gates, Wires, & Delays)

Gates Wires and Delays

早期模型给门固定 tPDt_{\mathrm{PD}};实际输出延迟依赖负载。Jade 会按负载算有效传播延迟。减负载或加 buffer 驱动重载可加速。优化时常追踪重载慢线。以下转向系统级互连设计。

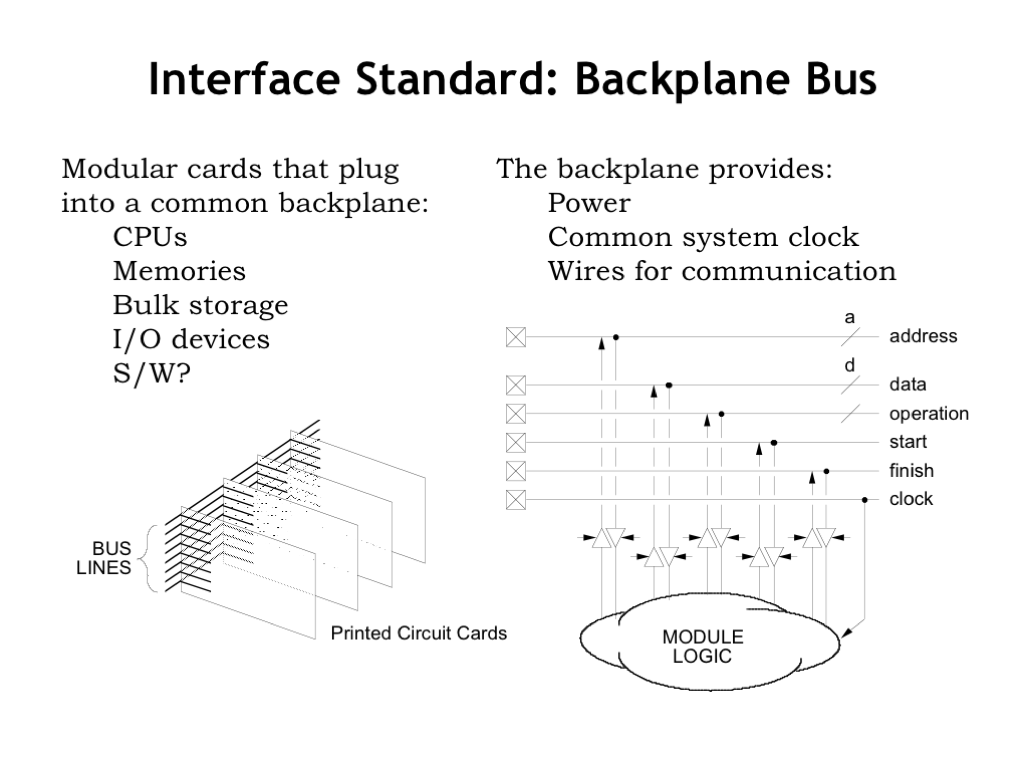
9. 接口标准:背板总线(Interface Standard: Backplane Bus)

Backplane Bus

可扩展性经典做法:主板插槽连接附加卡。信号含电源、时钟,以及:

  • 地址线:选端点(内存、控制寄存器等)
  • 数据线:传数据(早期常多比特并行)
  • 控制线:事务起止与应答

多槽可并联同一组线,靠地址区分目标。合称 system bus——按既定协议传数据的一组线。

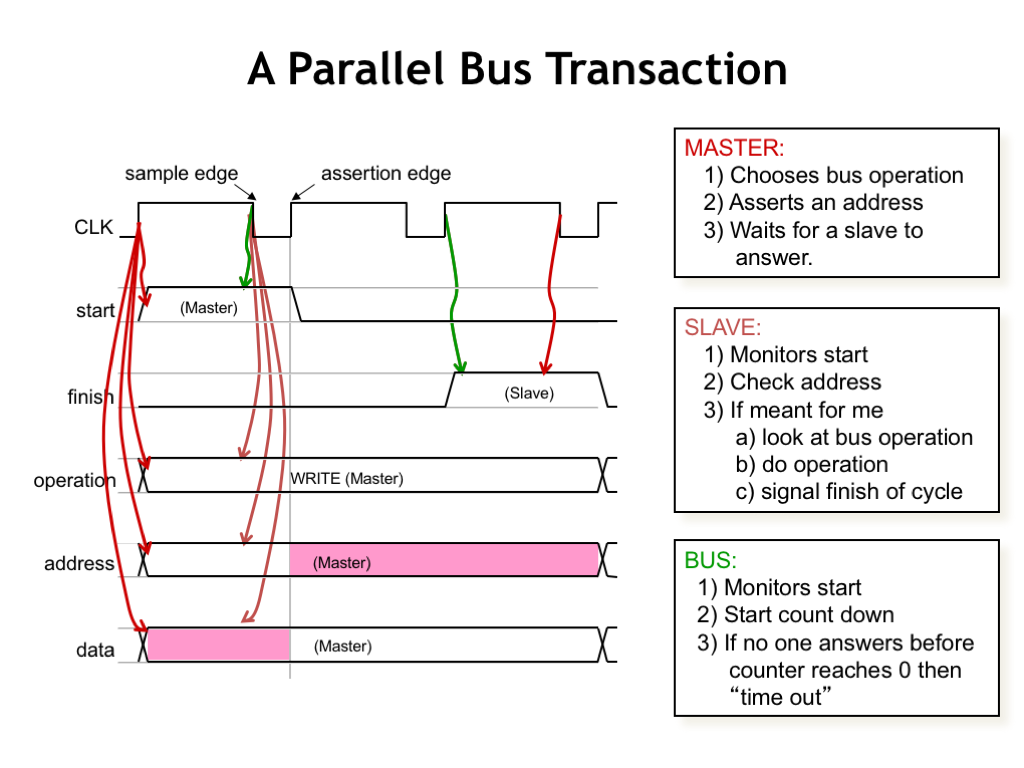
10. 并行总线事务(A Parallel Bus Transaction)

A Parallel Bus Transaction

CLK 的 assertion 边沿放信号、sample 边沿采样;周期须够传播并稳定。发起者 bus master“拥有”总线(可转移所有权);指明操作、地址、写数据。Slave 在 sample 边沿认地址后执行,完成时用控制线应答,可读回数据。无响应时总线逻辑可超时报错。事务率不太高(如 <50 MHz)时此架构很实用。

11. 总线线即传输线(Bus Lines as Transmission Lines)

Bus Lines as Transmission Lines

提速后问题放大:周期太短,主设备驱动→长总线传播→各接收端建立时间不够;clock skew 导致一卡新周期开驱动、另一卡仍在驱动 → 冲突噪声;连接器阻抗不连续产生多路小反射——像在大峡谷里喊话,回声淹没内容。总线最终留给低速,高速另寻他法。

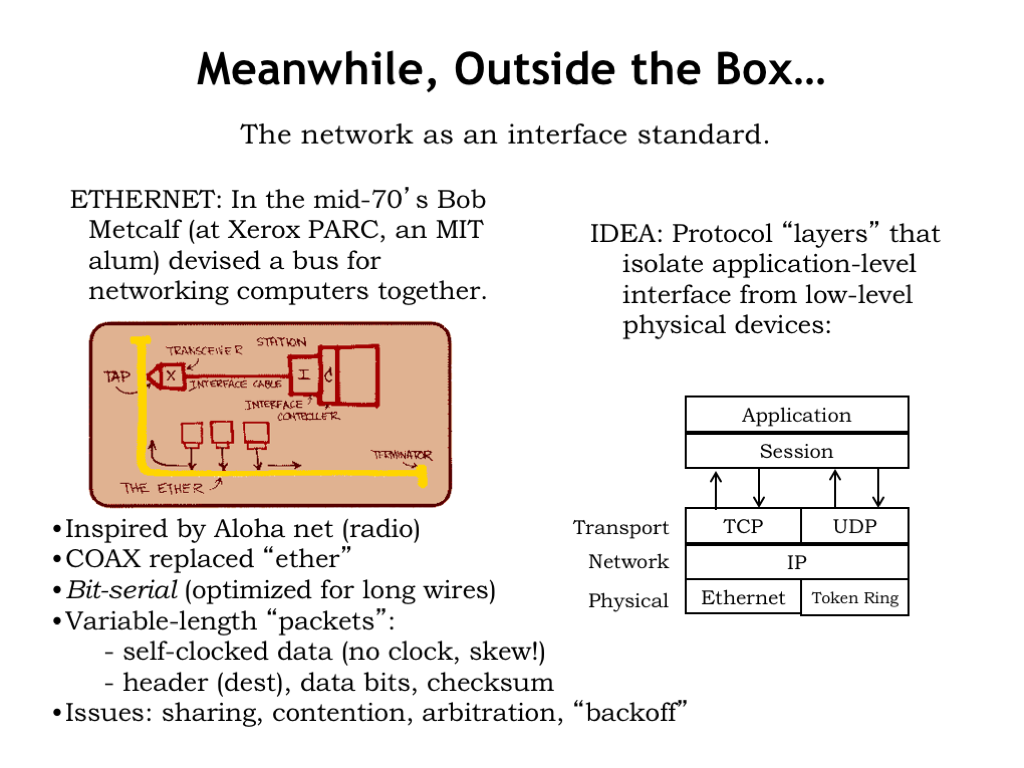
12. 与此同时,箱外……(Meanwhile, Outside the Box…)

Meanwhile Outside the Box

网络连接米级距离:比特组成带目的地址与校验的 packet,可请求重传。协议栈分层:物理层收发包并检错;网络层寻址路由;传输层提供可靠字节流与 flow control。关键思想:在 “best effort” 包网上堆可靠通道——上层可恢复下层错误,比每层 100% 可靠更便宜稳健。

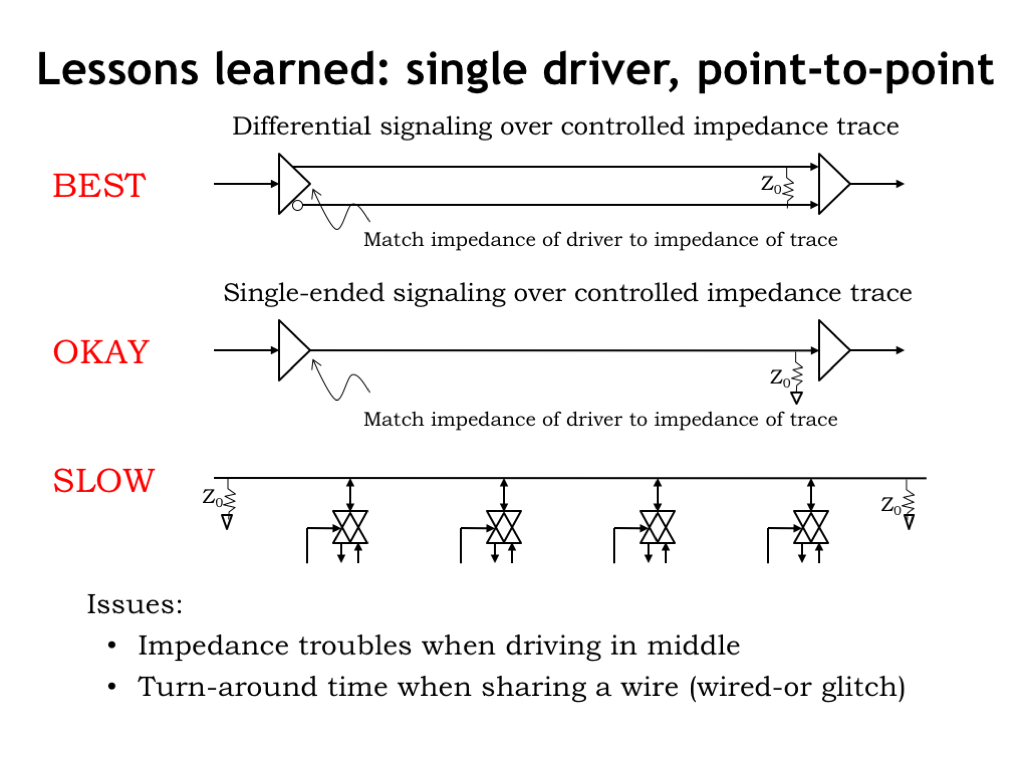
13. 经验:单驱动、点对点(Lessons learned: Single driver; point-to-point)

Single driver point-to-point

共享线上多驱动/多接收电气问题多;减速能缓解但高性能不许。网络经验:point-to-point(单驱动↔单接收)最快最干净。差分信号测两线电压差,共模噪声抵消——几乎所有高速链路都用。

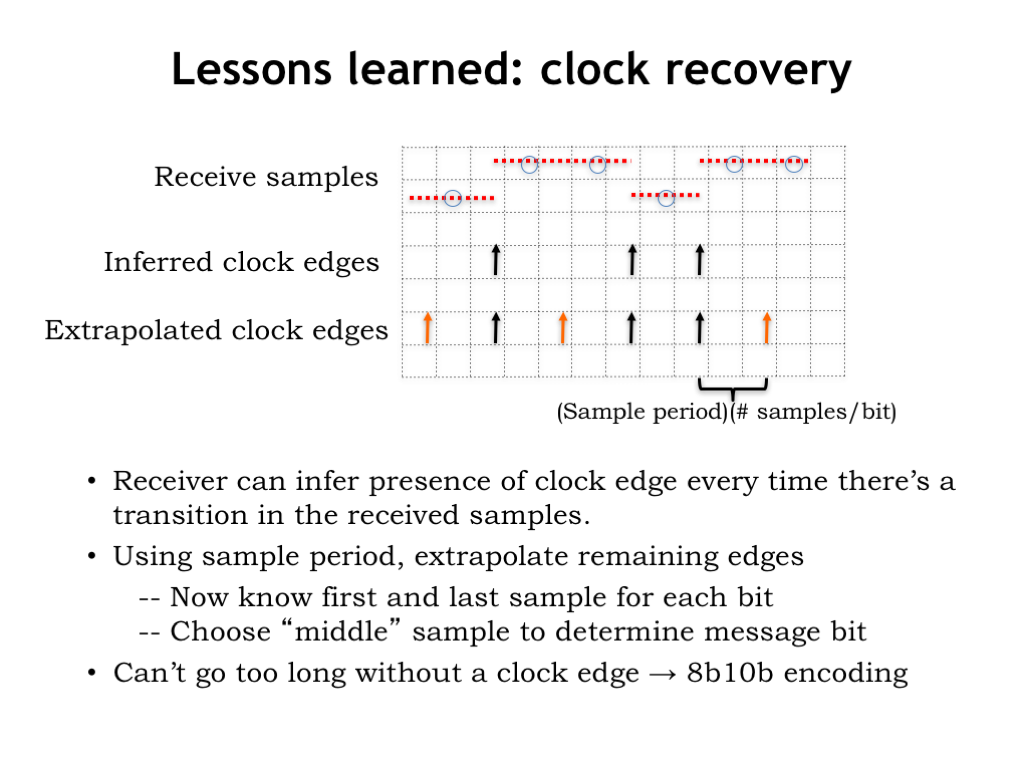
14. 经验:时钟恢复(Lessons learned: Clock recovery)

Clock recovery

不必另送时钟:接收端用跳变推断部分边沿,再以标称周期 + PLL 生成本地时钟。包前加 training sequence;特殊分隔序列标数据起点。为保足够跳变,常用 8b/10b(8 消息比特→10 传输比特,保证至多每 6 bit 时间有跳变)。真正只需一路比特流即可同时恢复时钟与数据。

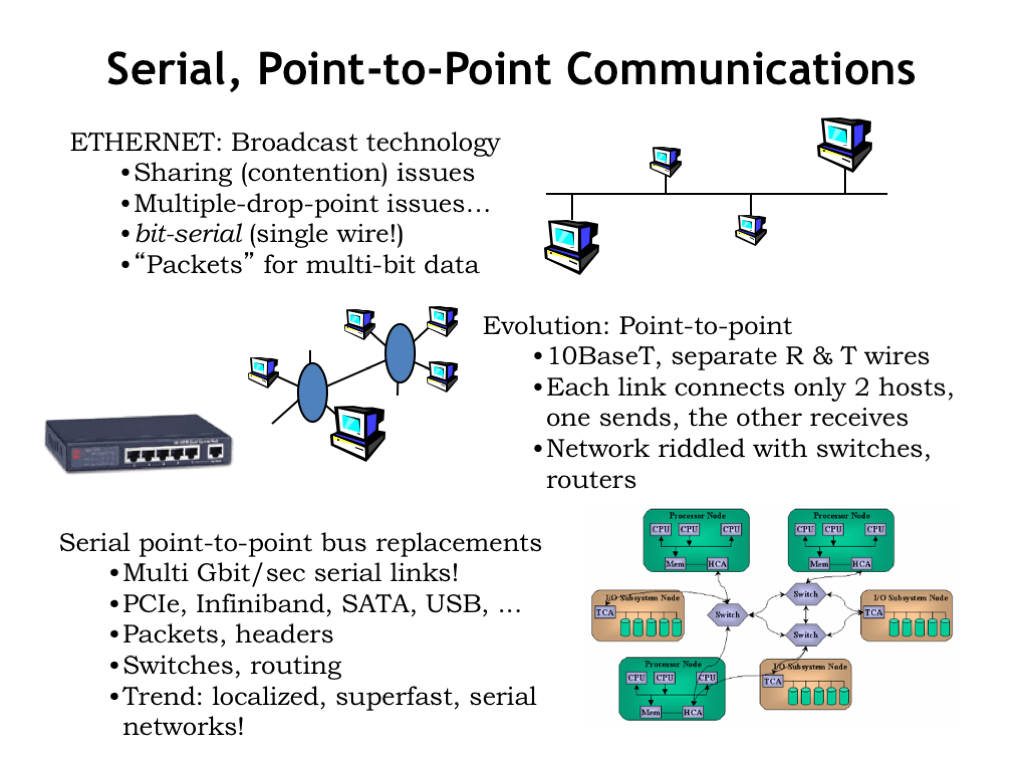
15. 串行点对点通信(Serial, Point-to-point Communications)

Serial Point-to-point

局域网从共享介质变为点对点(如 BaseT 收发各一对差分线),经交换机/路由器多跳转发。系统内互连同理:点对点 + 交换路由。各链路独立,多链路可并行提供大带宽;交换机少量缓冲处理短暂争用。

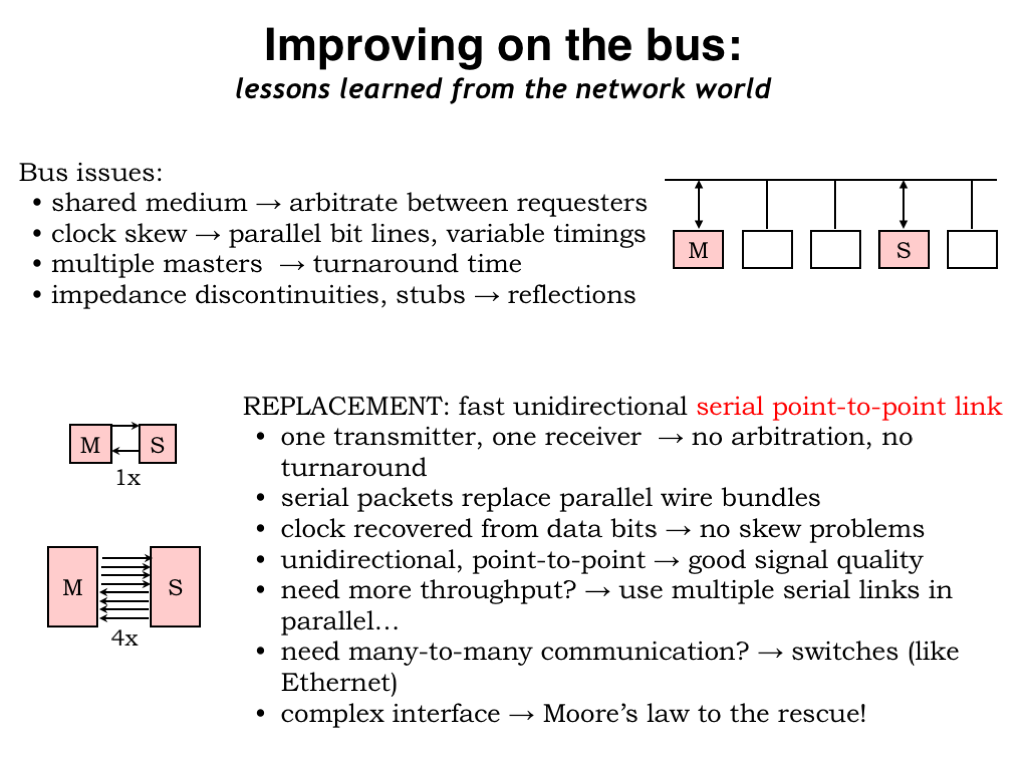
16. 改进总线(Improving on the Bus)

Improving on the Bus

串行点对点取代并行总线:无共享、无 clock skew、电气环境可控 → GHz 级。要更高吞吐可多 lane 并行,用逻辑重组分包。扩展卡仍插主板,但接到的是点对点链路而非并行总线。

17. 当今计算机中的通信(Communications in Today’s Computers)

Communications in Today Computers

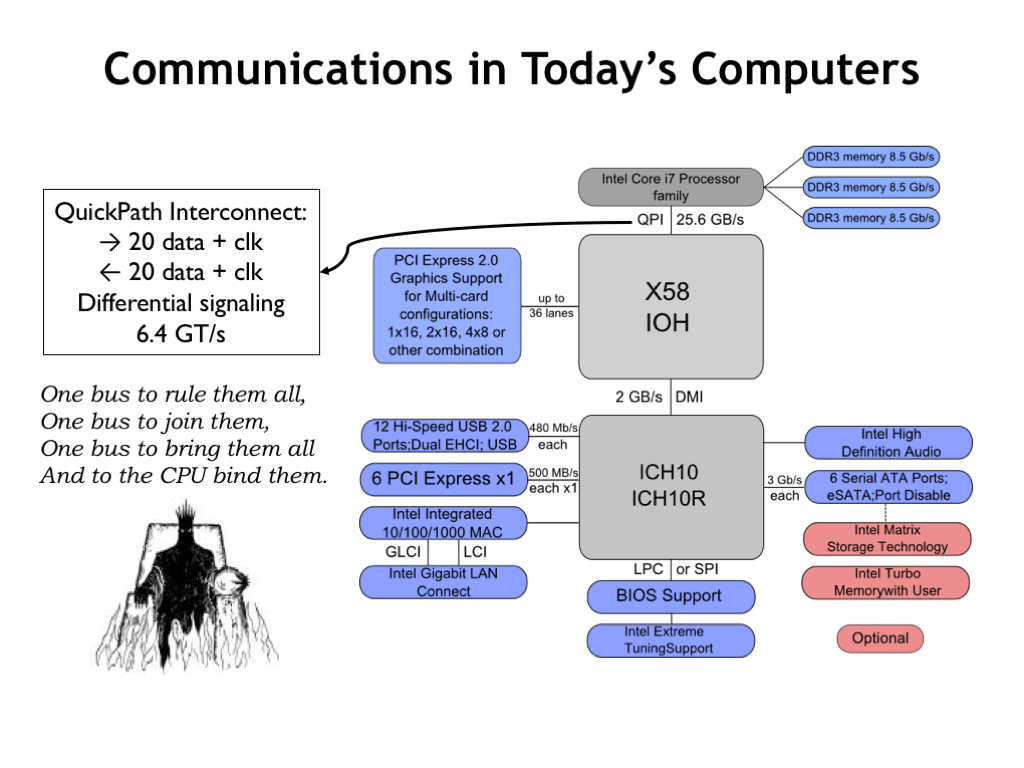
例:Intel Core i7 系——CPU 直连内存求带宽;其余经 QPI(每向 20 路差分,可达每向每秒 64 亿次 20-bit 传输)。USB、PCIe、网口、SATA、音频等亦为串行链路。有了足够强的通用互连,何必堆一堆专用通道——有如魔戒“一戒御众”。

PCI Express

PCIe Gen2 单 lane:5 Gb/s,LVDS,约 100 Ω 特征阻抗。物理层:训练序列 + 起止定界 + 载荷;链路层用序号与 CRC 检丢包并重传、做流控;事务层重组多 lane、按头识别接收方。8 lane 可达约 4 GB/s,够显卡等高性能外设。主板通信已从并行总线转向少量串行点对点——更快、更可靠、更省电、更紧凑。

19. 通信拓扑(Communication Topologies)

Communication Topologies

连接 NN 个需互发消息的部件(如多核)。约定:每点对点链路代价 1、传一跳时间 1、链路可并行。渐近看吞吐、最坏延迟、硬件代价。

  • 总线:吞吐 O(1)O(1),延迟 O(1)O(1),代价 O(n)O(n)
  • Ring:吞吐/代价 O(n)O(n),最坏延迟 O(n)O(n)——适合流水线或延迟不敏感场景

20. 二次代价拓扑(Quadratic-cost Topologies)

Quadratic-cost Topologies
  • 完全图:链路 O(N2)O(N^2) → 吞吐与代价 O(N2)O(N^2),延迟 1
  • Crossbar:每时隙每行/列一条消息,吞吐 O(n)O(n)、延迟 1,开关数 N2N^2 → 代价仍 O(N2)O(N^2)

21. 网格拓扑(Mesh Topologies)

Mesh Topologies

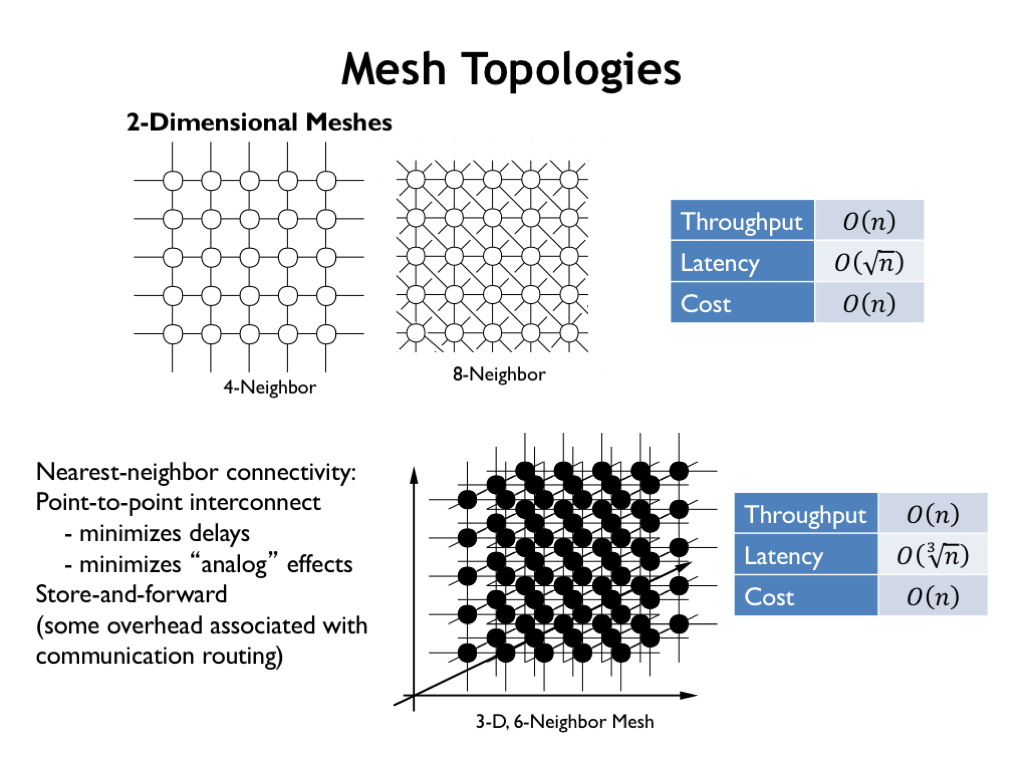
2D/3D mesh:每节点连固定邻居 → 链路数 ∝N\propto N,吞吐与代价 O(n)O(n)。最坏延迟:2D 为 O(n)O(\sqrt{n}),3D 为 O(n3)O(\sqrt[3]{n})。布局规整、每节点硬件常量、延迟适中 → 实验多核常用 2D 四邻接 mesh。

22. 对数延迟网络(Logarithmic-latency Networks)

Logarithmic-latency Networks

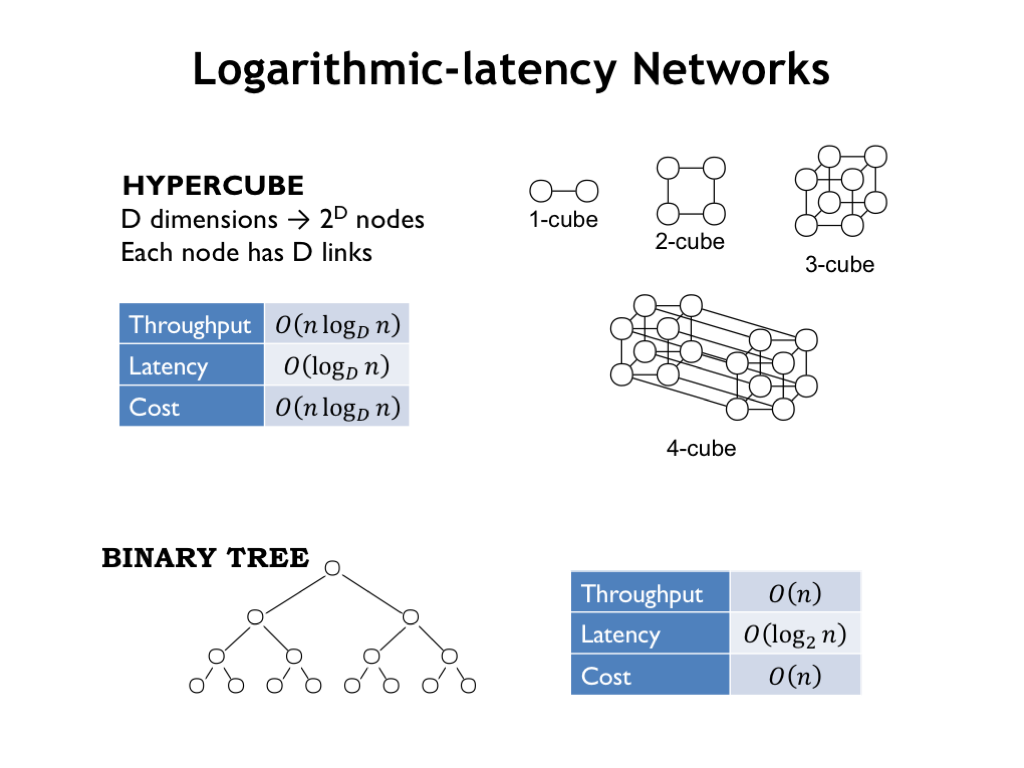
Hypercube、tree 提供对数级延迟。CM-1 Connection Machine 用超立方连接多达 65536 个简单处理器(各连 16 邻);后期改树,且靠近根的链路容量更大。

23. 通信技术:延迟(Communication Technologies: Latency)

Communication Technologies Latency

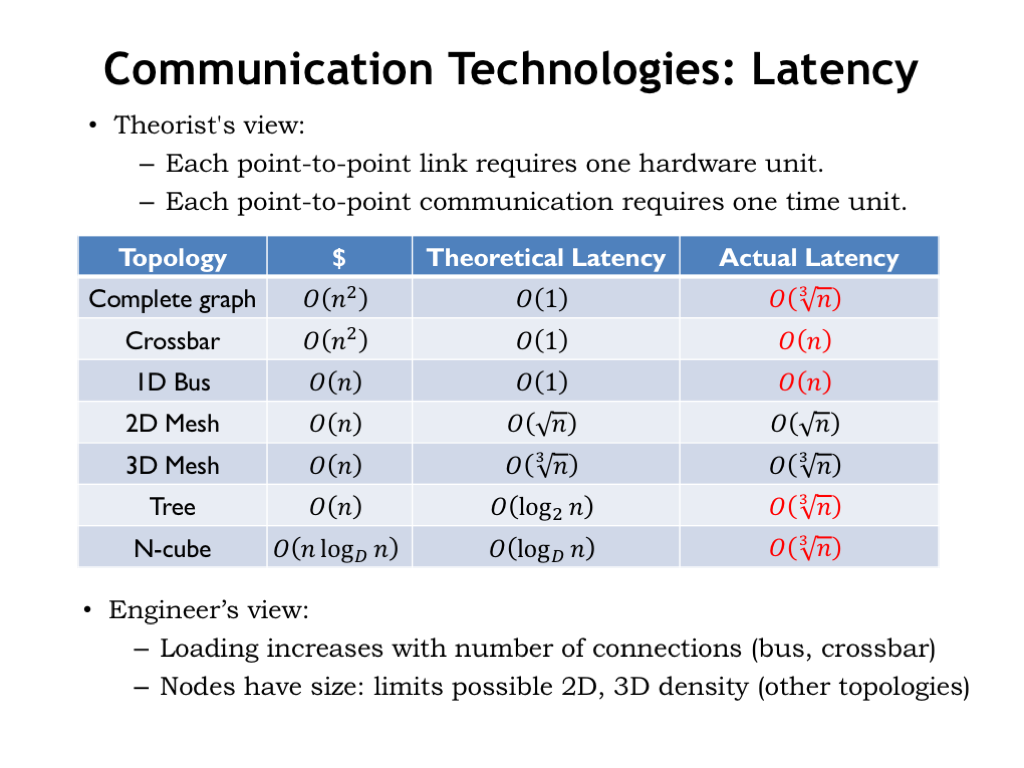
三维世界中部件最坏距离下界 O(N3)O(\sqrt[3]{N}),平面布局 O(N)O(\sqrt{N})——延迟应反映物理距离。总线/crossbar 上 NN 个连接的容性负载也抬高下界。Mesh 随 NN 增长不必强行加长线,对连接上千处理器的高容量片上网络很有吸引力。

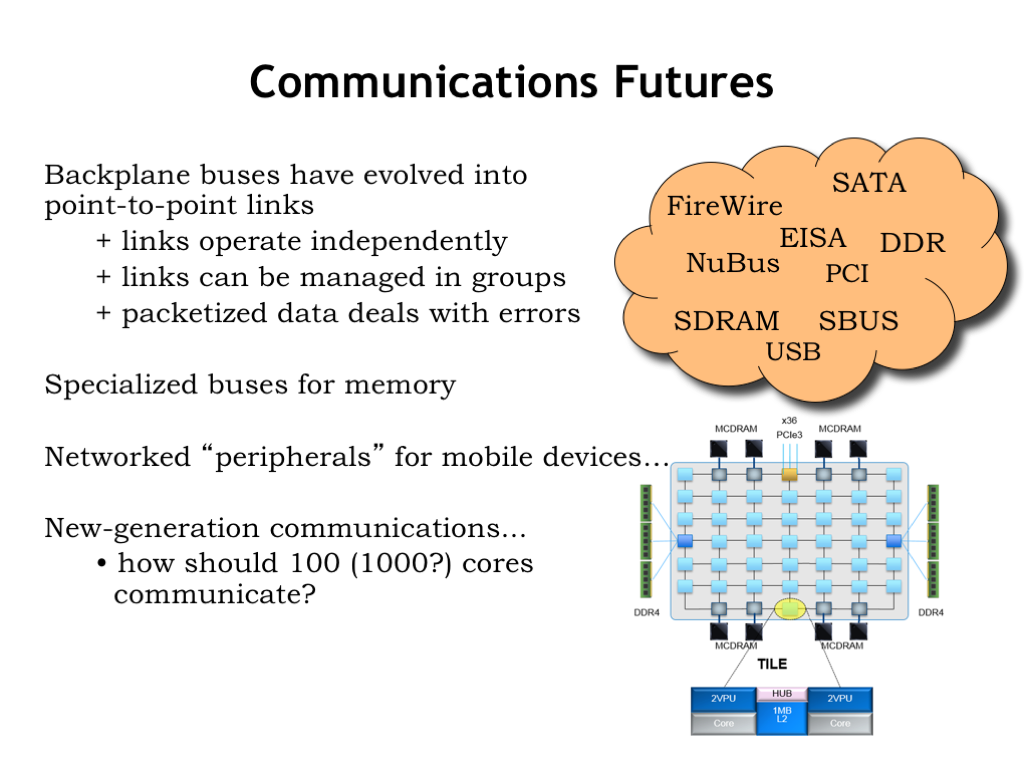
24. 通信的未来(Communications Futures)

Communications Futures

总结:点对点已成系统级主流;超高带宽内存通道仍用多信号并行但工程极谨慎。无线连接移动设备,并研究自动发现附近外设。多核将有数十到数百核,片上网络拓扑(高带宽 + 低延迟)仍是活跃研究——未来十年对片上网络工程师很有戏。

整理自 MIT OCW 6.004 Computation Structures(Spring 2017)L19 注解幻灯片。

源网页:19.1 Annotated Slides | Concurrency and Synchronization

讲师:Chris Terman。图片直接引用 OCW 原站链接。

L19:并发与同步(Concurrency and Synchronization)

本讲以 producer–consumer 为线索,引入 precedence constraint、FIFO 缓冲,以及 Dijkstra 的 semaphore(WAIT/SIGNAL);覆盖资源分配、互斥临界区、多生产者/消费者,以及用 SVC 或 TCLR(test-and-clear)实现 semaphore;最后讨论 deadlock(Dining Philosophers)与全局资源序 / 检测恢复。

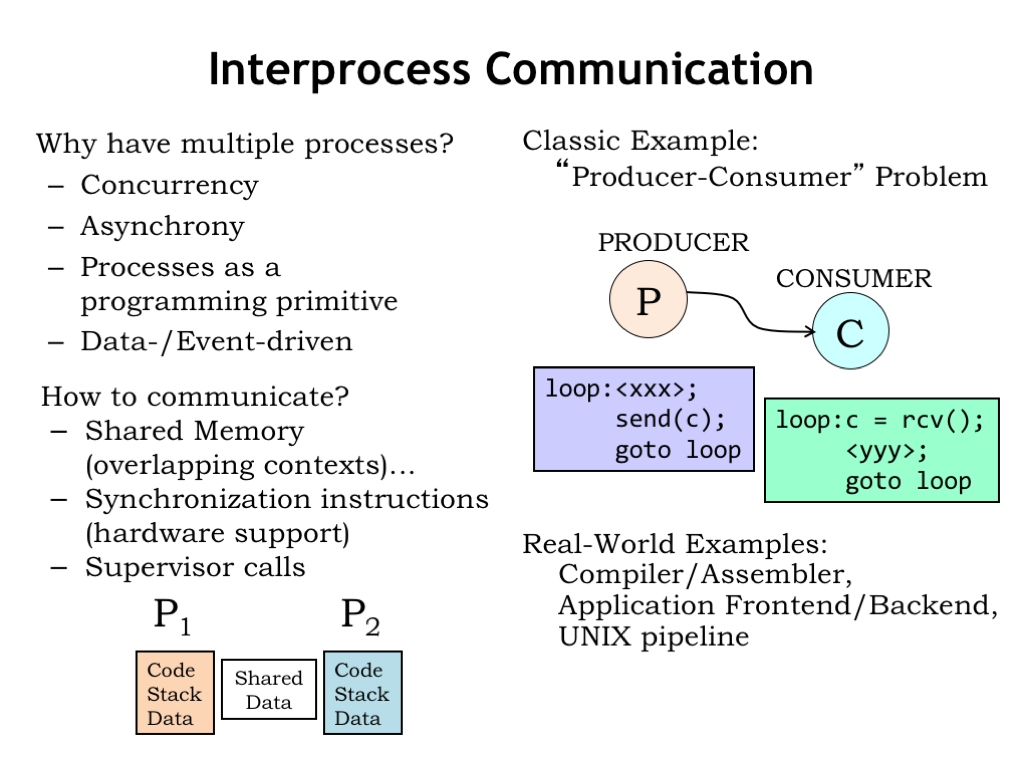
1. 进程间通信(Interprocess Communication)

Interprocess Communication

应用常拆成多进程:视频压缩可并行处理宏块;游戏分前端 UI 与后端仿真/渲染。进程封装独立状态,需要时再共享信息。

通信方式:

  • 共享内存:同一物理页映射进两进程;配合同步原语(部分 ISA 有专用指令)
  • 消息传递:经 OS SVC;开销更大,但编程模型不依赖是否同机

本讲用经典 producer–consumer 作并发同步范例。

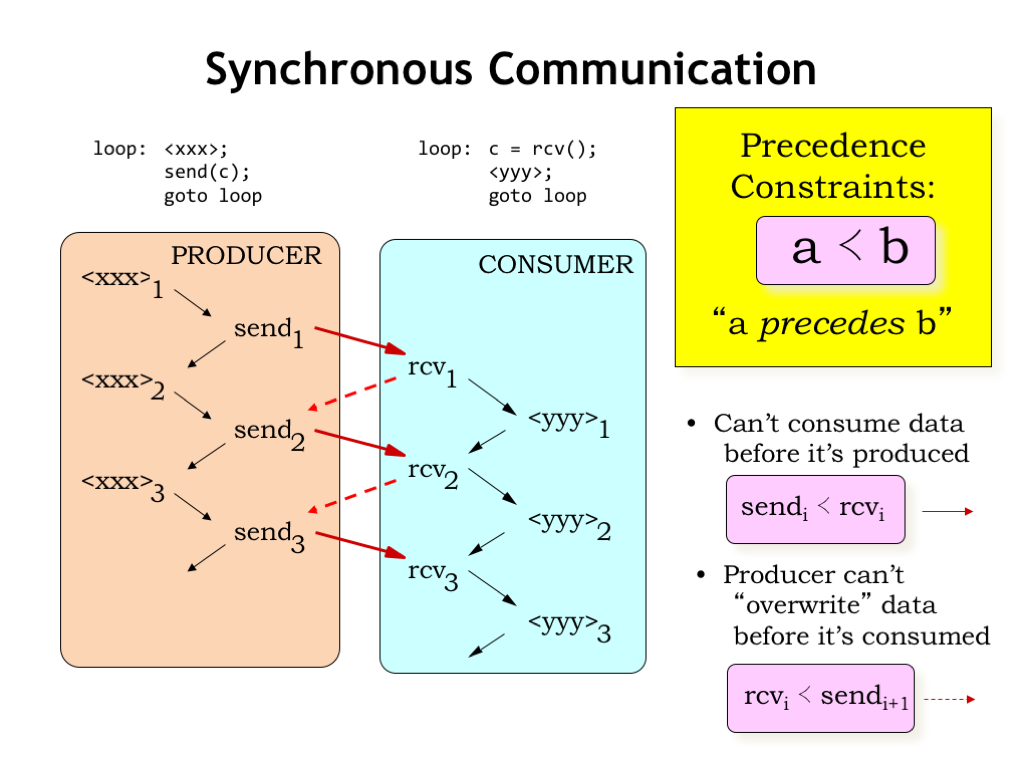
2. 同步通信(Synchronous Communication)

Synchronous Communication

单进程内程序计数器决定执行顺序。跨进程还需 precedence constraints(记号 ≺\prec):第 ii 次 send 须先于第 ii 次 receive;若共享单单元,第 ii 次 receive 须先于第 i+1i+1 次 send(防覆盖)。二者使产消紧耦合——消费完才能再生产。下一节用缓冲放松约束。

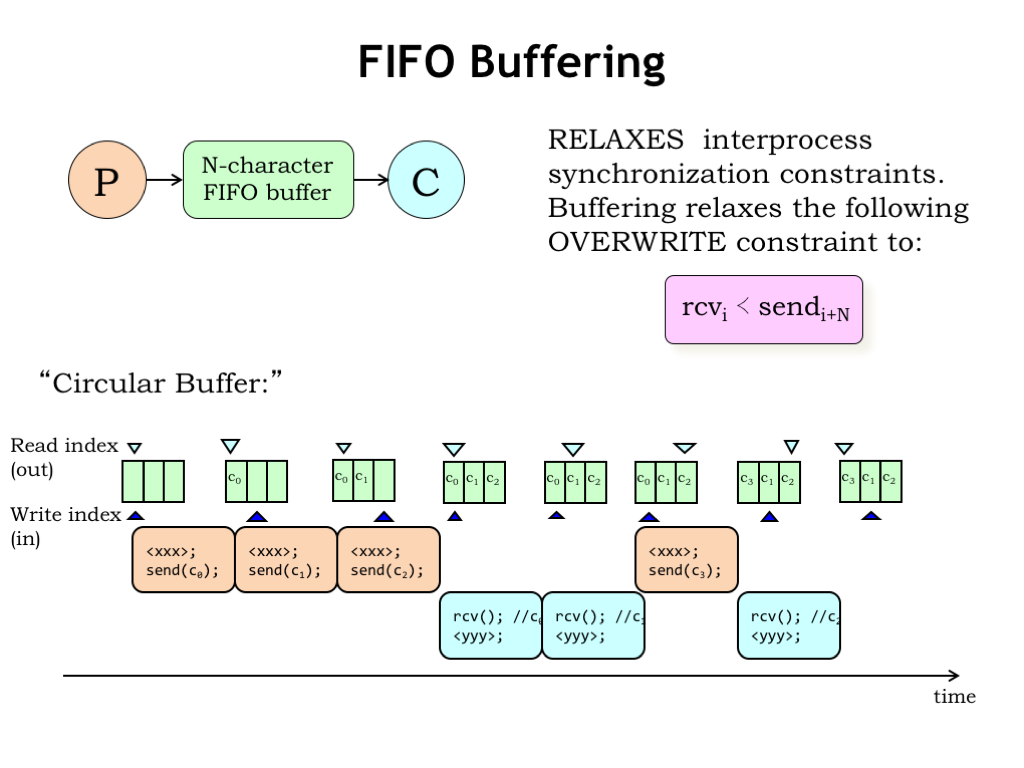
3. FIFO 缓冲(FIFO Buffering)

FIFO Buffering

NN 字符 FIFO:空则消费者等,满则生产者等。覆盖约束放宽为:第 ii 次 receive ≺\prec 第 i+Ni+N 次 send——生产者最多超前 NN 个。

实现:长度 NN 的环形数组 + 读/写下标(模 NN 递增);另需计数(图中略)。任意交错执行皆可,只要不满写、不空读。

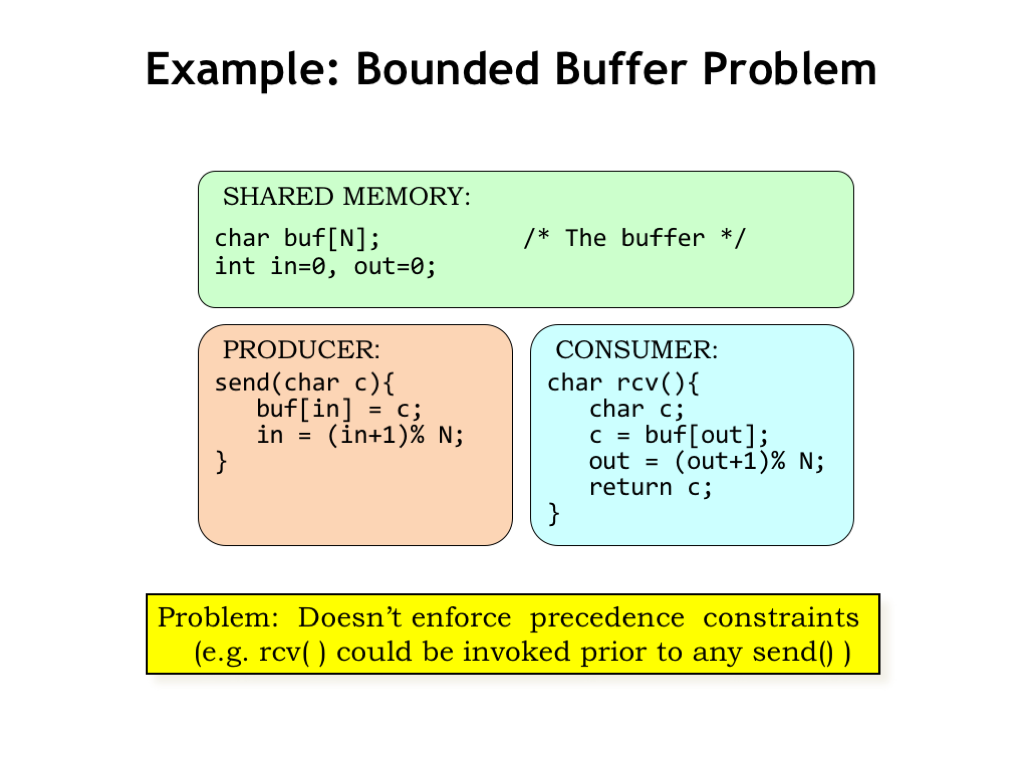
4. 例:有界缓冲问题(Example: Bounded Buffer Problem)

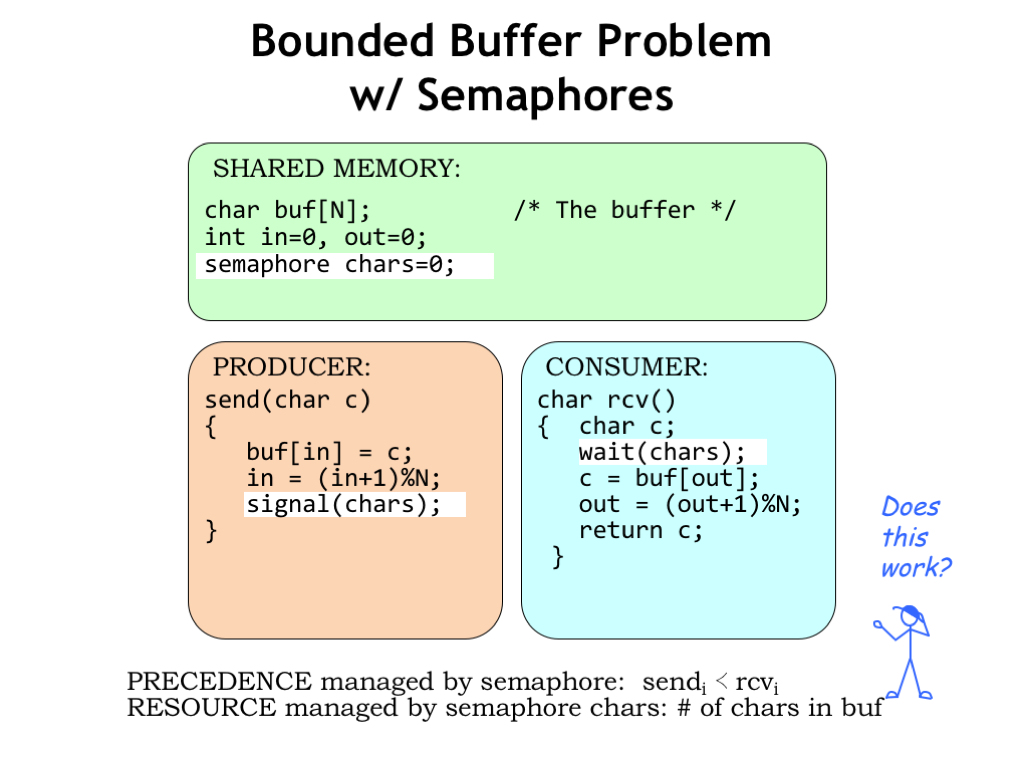
Bounded Buffer Problem

共享数组与 IN/OUT。SEND 用 IN 写,RCV 用 OUT 读,各自模 NN 递增。如图代码未强制任何 precedence——可空读、可满写。需要同步抽象。

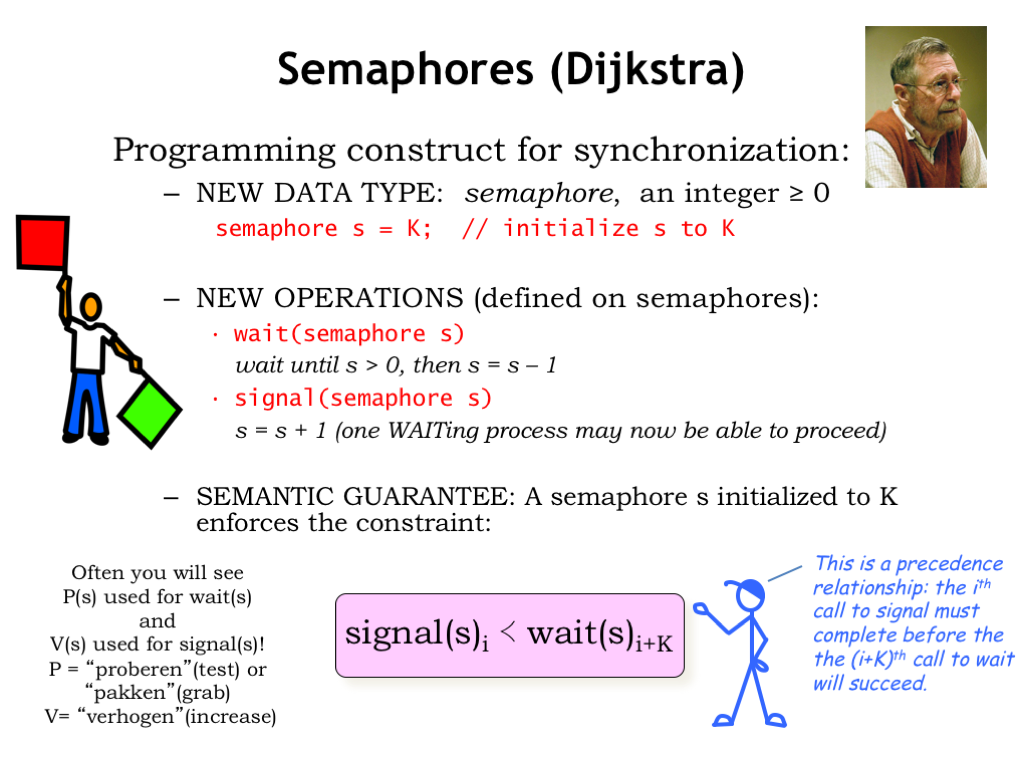
5. 信号量(Dijkstra)(Semaphores (Dijkstra))

Semaphores

Dijkstra 提出 semaphore:共享整数 ≥0;操作:

  • WAIT(s):等 s>0s>0 再减一返回(实现上可忙等或挂起)
  • SIGNAL(s):加一;若有等待者,恰好一个可继续

初值 KK 保证:第 ii 次 SIGNAL ≺\prec 第 i+Ki+K 次 WAIT 完成。本课不允许负值。文献亦称 P/V(荷兰语“测/增”)。

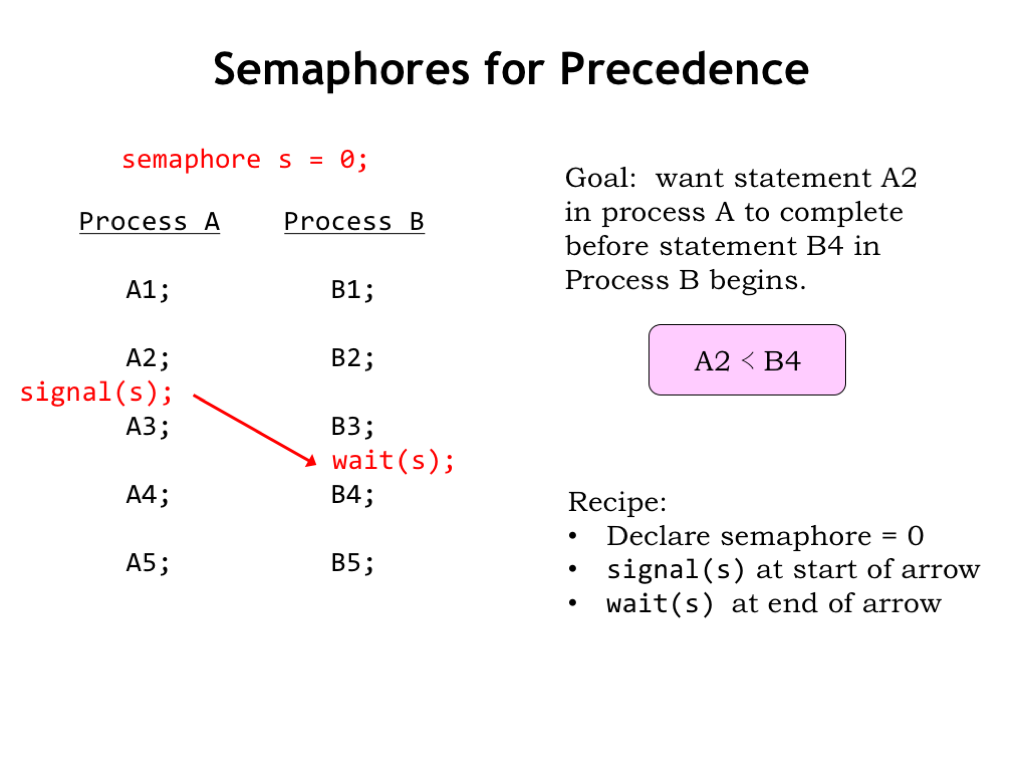
6. 用信号量表达先后(Semaphores for Precedence)

Semaphores for Precedence

指南:semaphore 初值 0;箭头起点后放 signal(s),终点前放 wait(s)。例:A2 后 signal、B4 前 wait → 保证 A2 完成才开始 B4。初值 0 强制第一次 signal 先于第一次 wait。

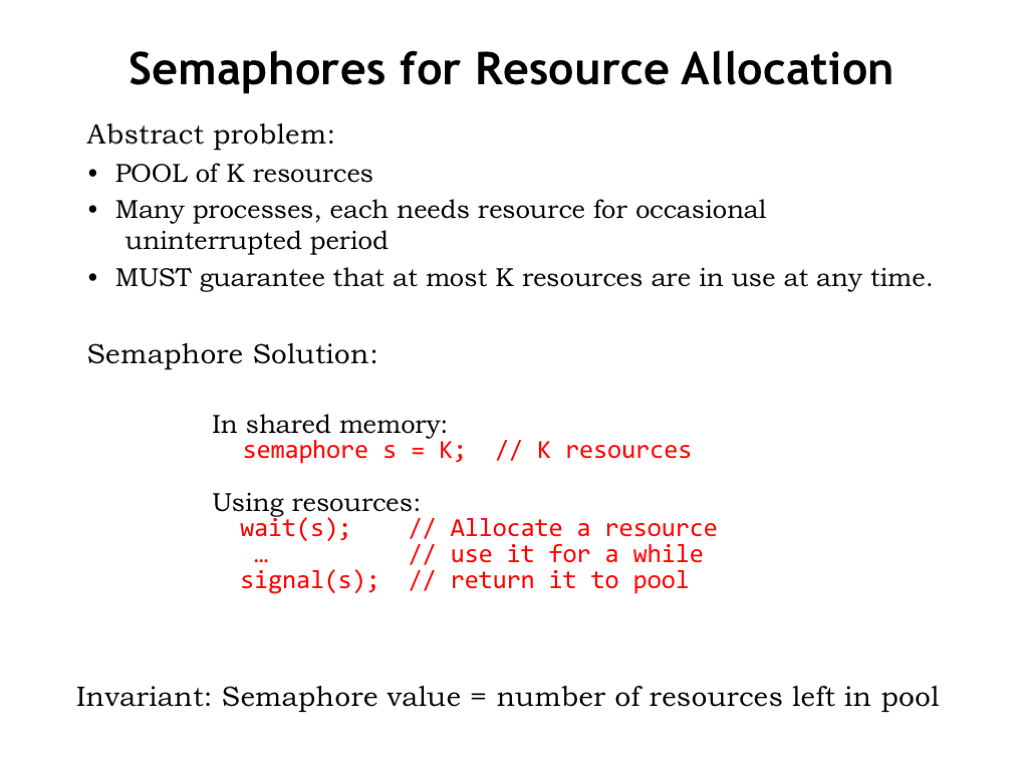
7. 用信号量做资源分配(Semaphores for Resource Allocation)

Semaphores for Resource Allocation

另一视角:初值 KK = 共享资源池大小。SIGNAL 归还/加入资源,WAIT 独占领取;当前值 = 剩余未分配数。WAIT/SIGNAL 可同进程或跨进程。

8. 有界缓冲 + 信号量(Bounded Buffer Problem with Semaphores)

Bounded Buffer with Semaphores

CHARS 初值 0:SEND 写入后 signal(CHARS);RCV 先 wait(CHARS) 再读。保证消费者不空读。但只实现了两条 precedence 中的一条。

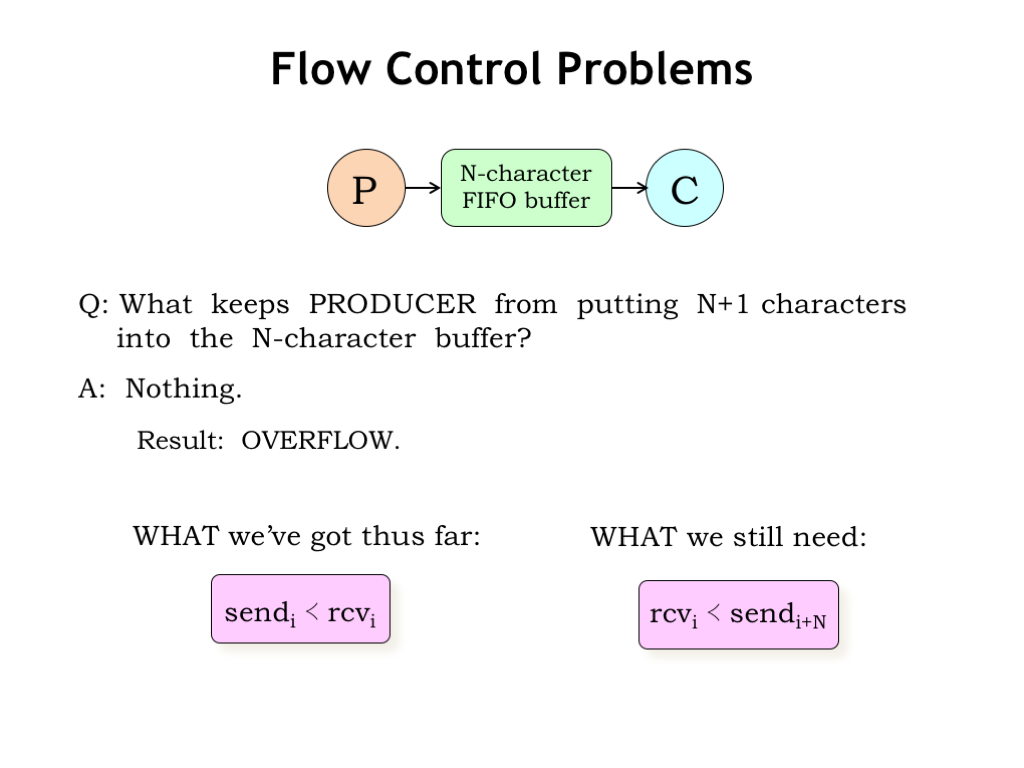
9. 流控问题(Flow Control Problems)

Flow Control Problems

仅有 CHARS 时,生产者仍可写入超过 NN 个 → buffer overflow,字符流损坏。还需:第 i+Ni+N 次 send 之前必须完成第 ii 次 receive。

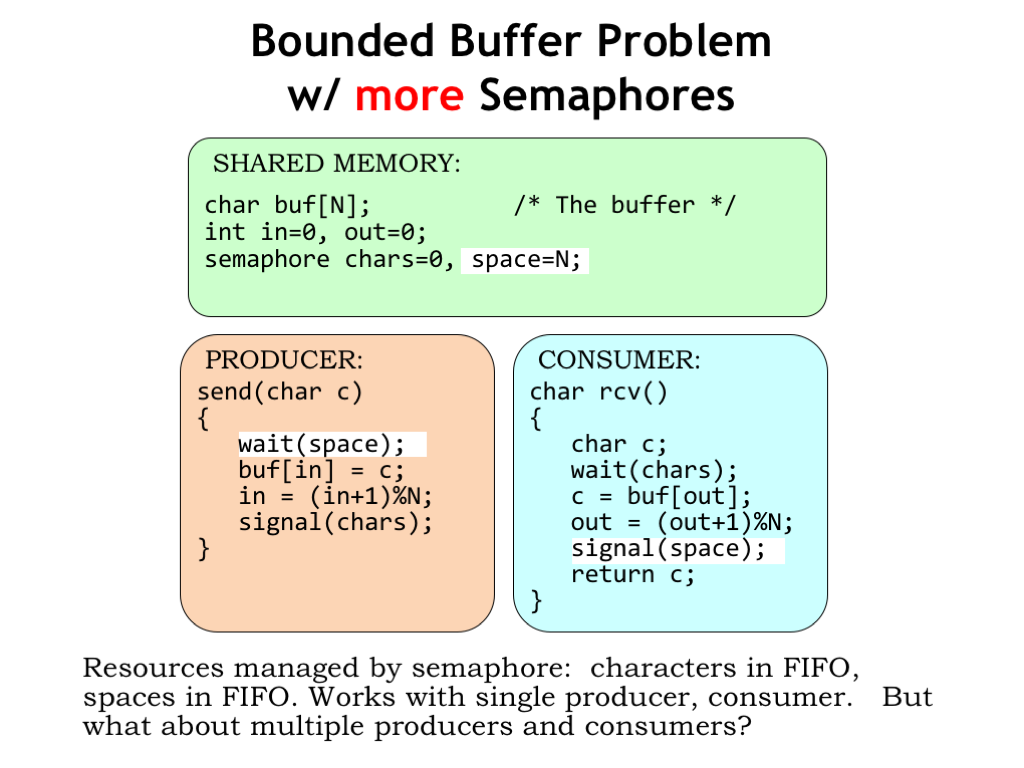
10. 更多信号量的有界缓冲(Bounded Buffer Problem with More Semaphores)

Bounded Buffer More Semaphores

加 SPACES 初值 NN:生产者 wait(SPACES) 再写;消费者读后 signal(SPACES)。对称:生产者消费空位、生产字符;消费者反之。单生产者+单消费者至此正确;多对多另有问题。

11. 同时事务(Simultaneous Transactions)

Simultaneous Transactions

两客户同时从同一账户取 $50。若两次 Debit 完整串行执行:余额减 $100,正确。

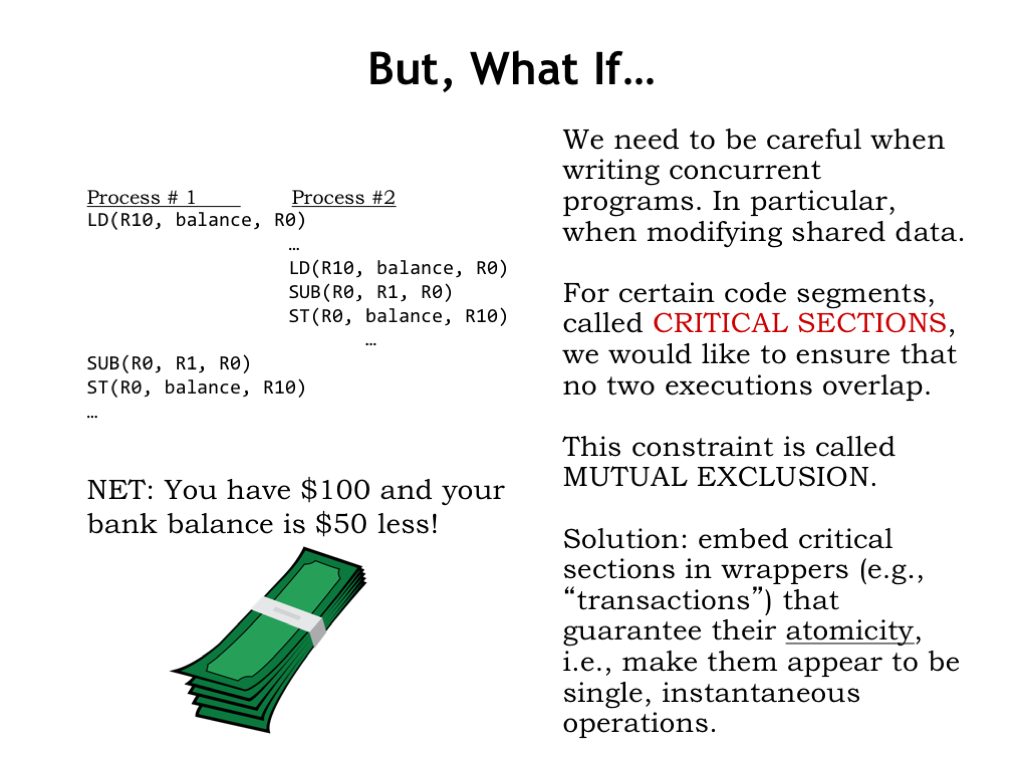
12. 但若…(But, What If…)

But What If

进程 A 读完余额后被打断,B 完成扣款,A 用过期余额写回 → 只扣了 $50。共享数据上的 LD/修改/ST 构成 critical section,需要 mutual exclusion:同时只有一个进程在临界区内。Semaphore + 临界区 ≈ transaction(期间共享数据不被他进程读写)。

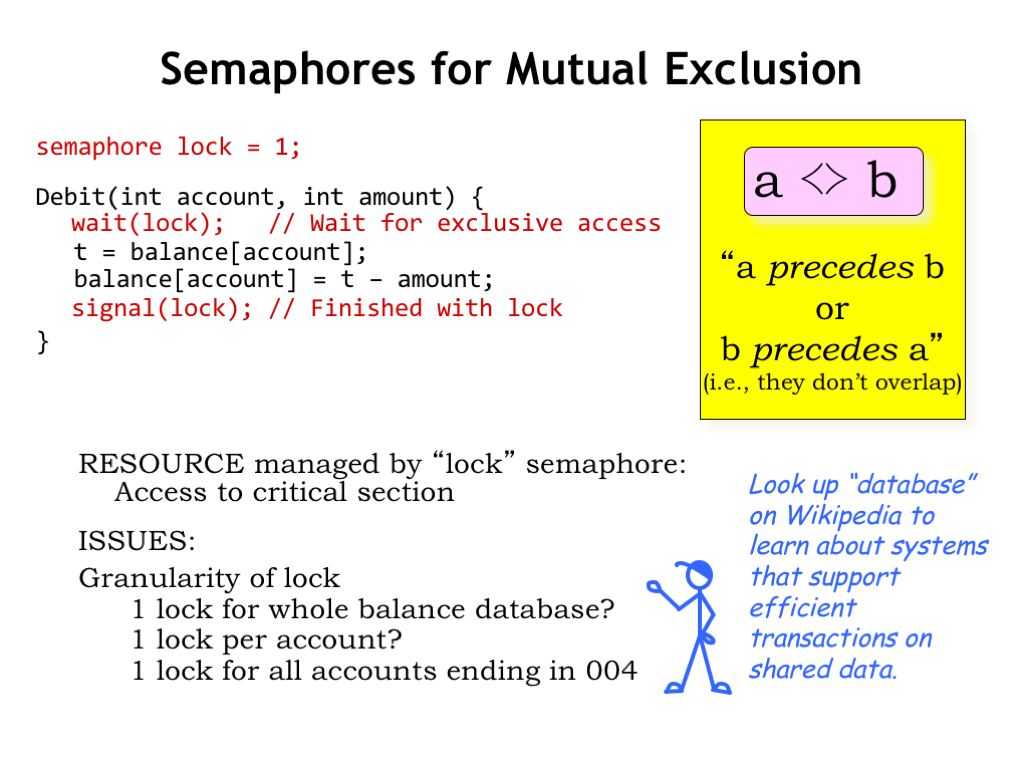
13. 互斥用信号量(Semaphores for Mutual Exclusion)

Semaphores for Mutual Exclusion

LOCK 初值 1:进临界区前 WAIT(acquire),出后 SIGNAL(release)。锁的粒度重要:全行一个锁会串行化无关账户;每账户一锁只阻塞真正冲突的事务,吞吐更好。

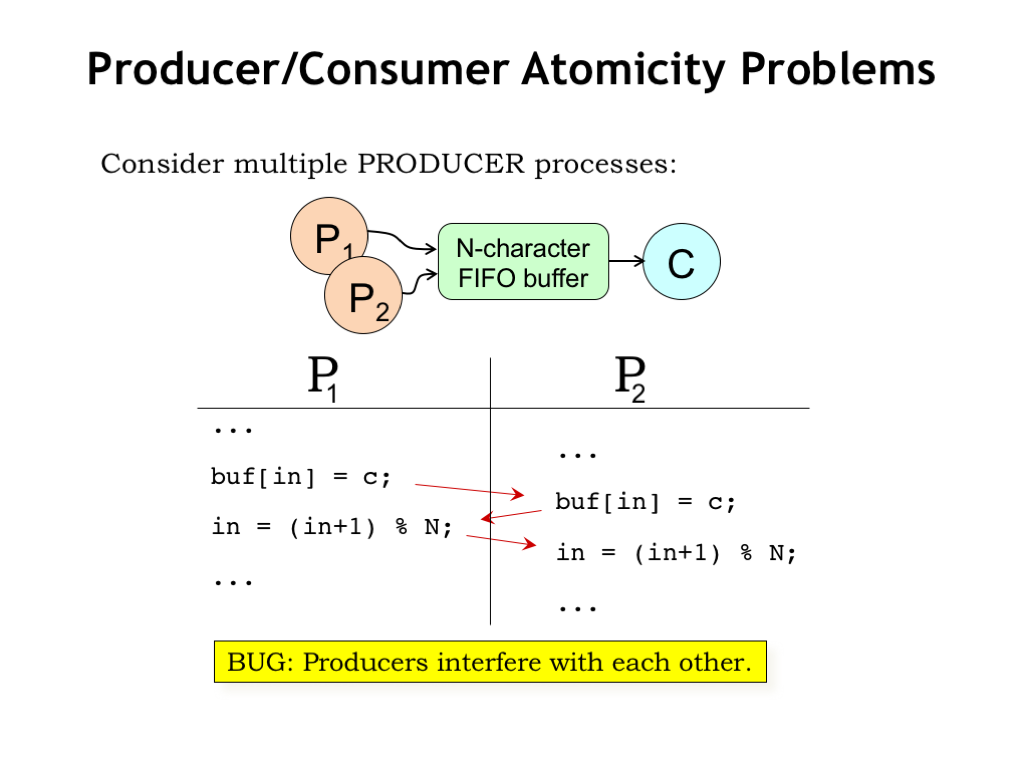
14. 产消原子性问题(Producer/Consumer Atomicity Problems)

Producer Consumer Atomicity

多生产者同时插入时,对 FIFO/IN 的更新可能交错 → 覆盖或下标错误。插入路径是临界区,须原子执行。

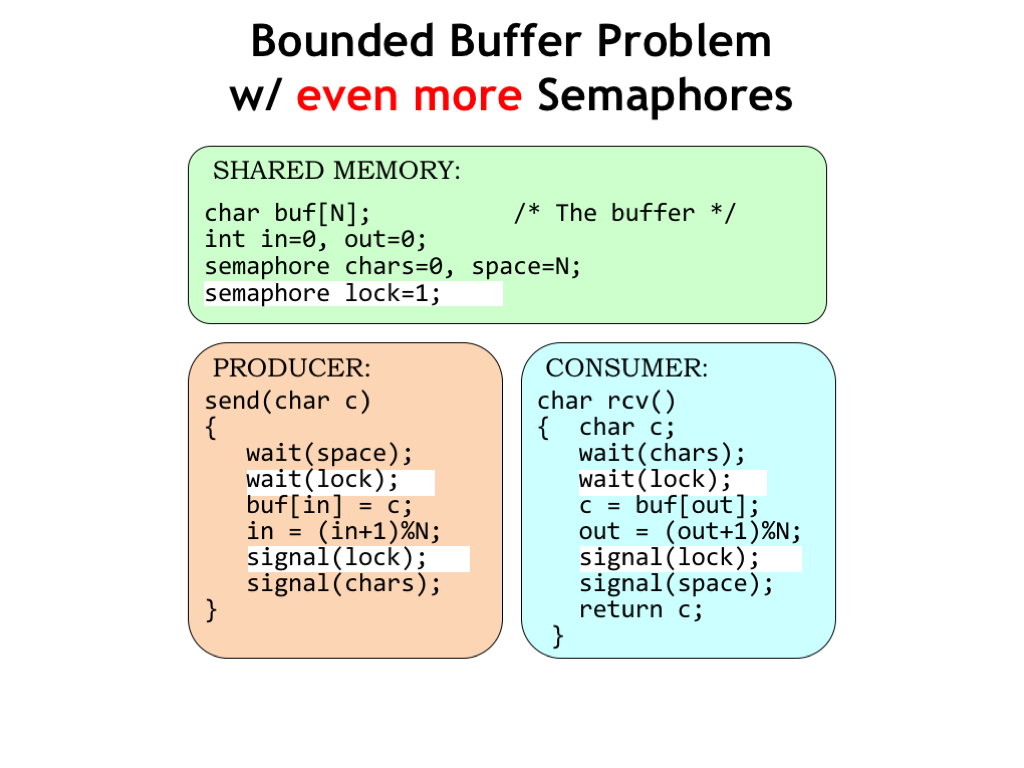
15. 再加信号量的有界缓冲(Bounded Buffer Problem with Even More Semaphores)

Bounded Buffer Even More Semaphores

第三 semaphore LOCK 保护 SEND/RCV 中操作缓冲的临界区。同锁可用于多消费者,但生产者用 IN、消费者用 OUT,共用一把锁引入多余先后约束——可拆成两把锁。

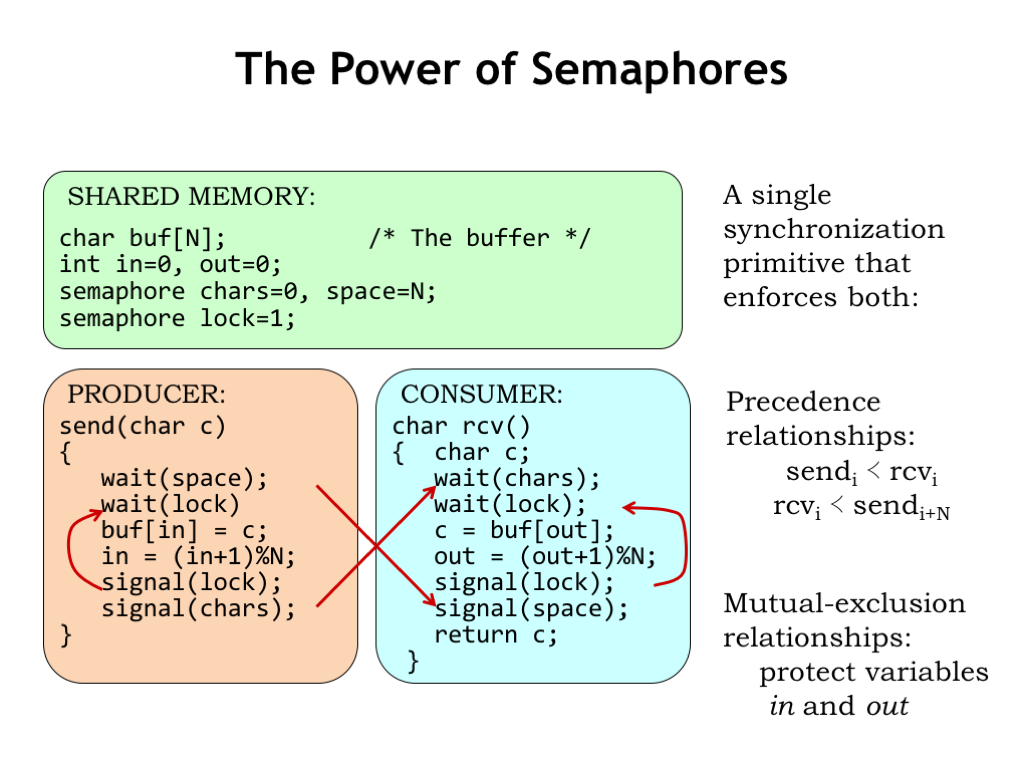
16. 信号量的威力(The Power of Semaphores)

The Power of Semaphores

Semaphore 像瑞士军刀:跨进程 WAIT/SIGNAL 保证时序(空不读、满不写);同进程内可实现临界区原子性(如 IN/OUT 的读改写不被打断)。

17. 信号量实现(Semaphore Implementation)

Semaphore Implementation

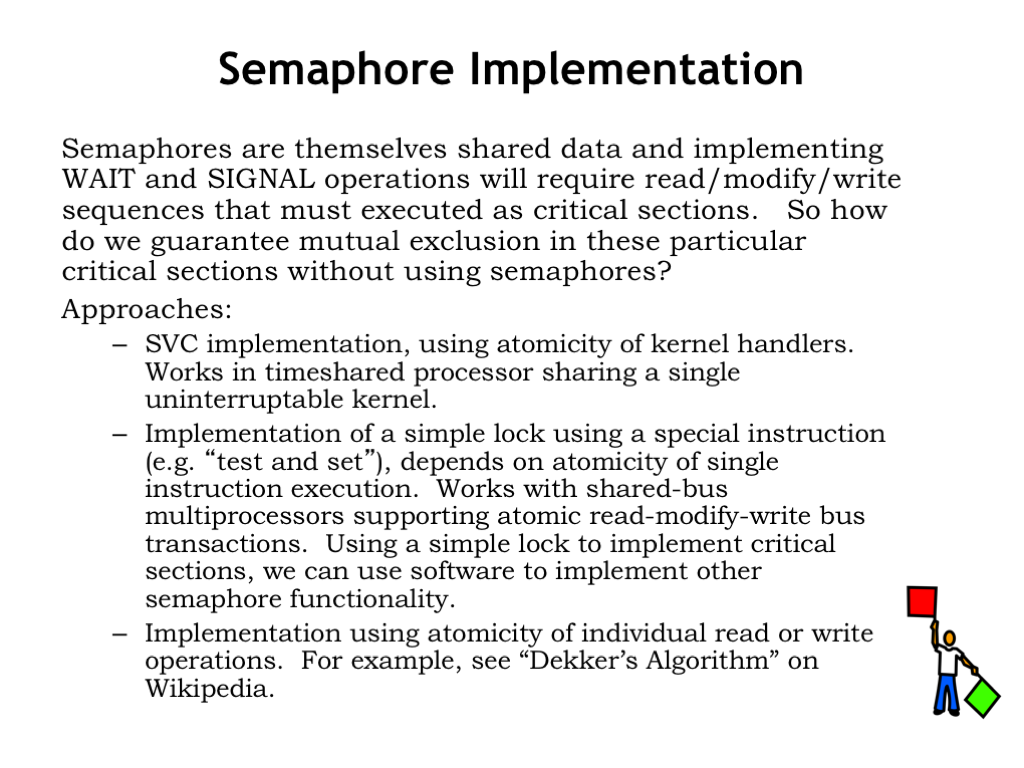
Semaphore 自身是共享数据,WAIT/SIGNAL 的读改写也是临界区——不能再用 semaphore 实现 semaphore(bootstrap)。出路:

  1. 不可中断内核上的 SVC
  2. ISA 的 test-and-set / test-and-clear,由内存原子读改写支持
  3. 纯软件算法(如 Dekker)仅依赖单次读写原子性

本讲详述前两种。

18. 作为 SVC 的信号量(Semaphores as a Supervisor Call)

Semaphores as SVC

内核态 SVC 不可中断 → handler 天然临界区。WAIT:值非零则减一并返回;为零则安排重试 SVC 并 SLEEP。SIGNAL:加一并 WAKEUP 等该 semaphore 的进程。

默认实现无公平性——调度顺序决定谁先拿到;若要公平,WAIT 可维护等待队列。

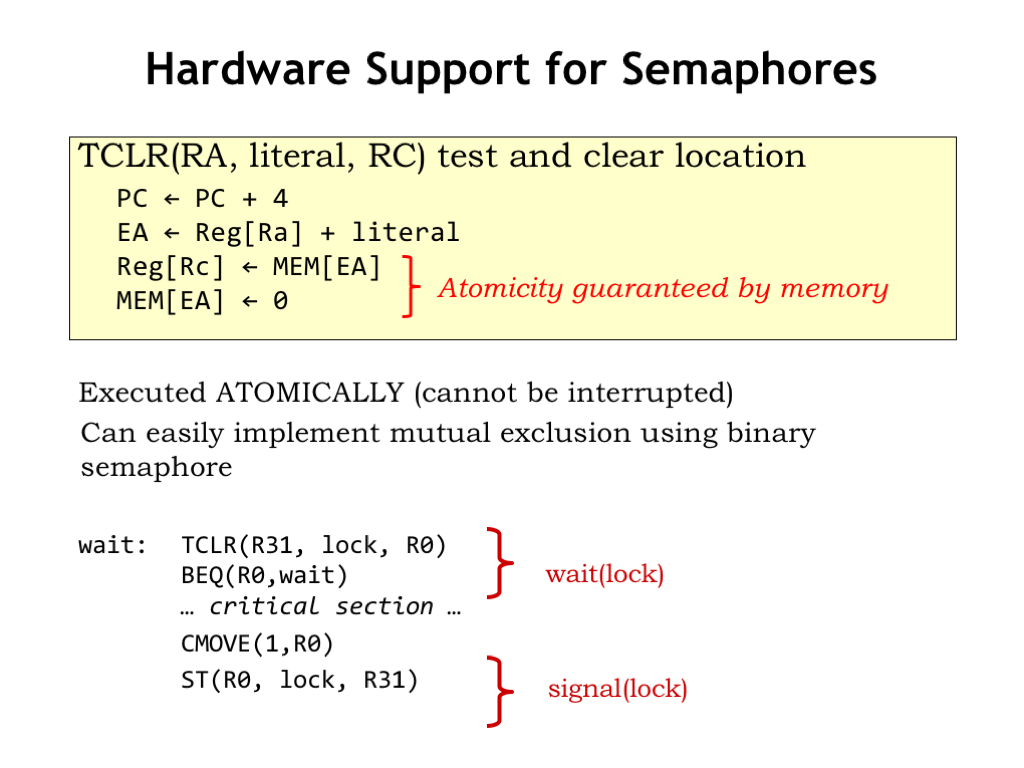
19. 硬件支持(Hardware Support for Semaphores)

Hardware Support for Semaphores

TCLR(test-and-clear):一次原子操作读内存当前值并清零。自旋:TCLR 得 0 → 别人持锁,重试;得非 0 → 已获取锁(且已把锁置 0)。临界区结束用 ST 写回非 0 释放。

20. 同步的阴暗面(Synchronization: The Dark Side)

Synchronization Dark Side

转账需拿两账户锁。两人按相反顺序各拿到第一把锁后,都等对方释放第二把 → deadlock(deadly embrace)。多资源同步需额外纪律。

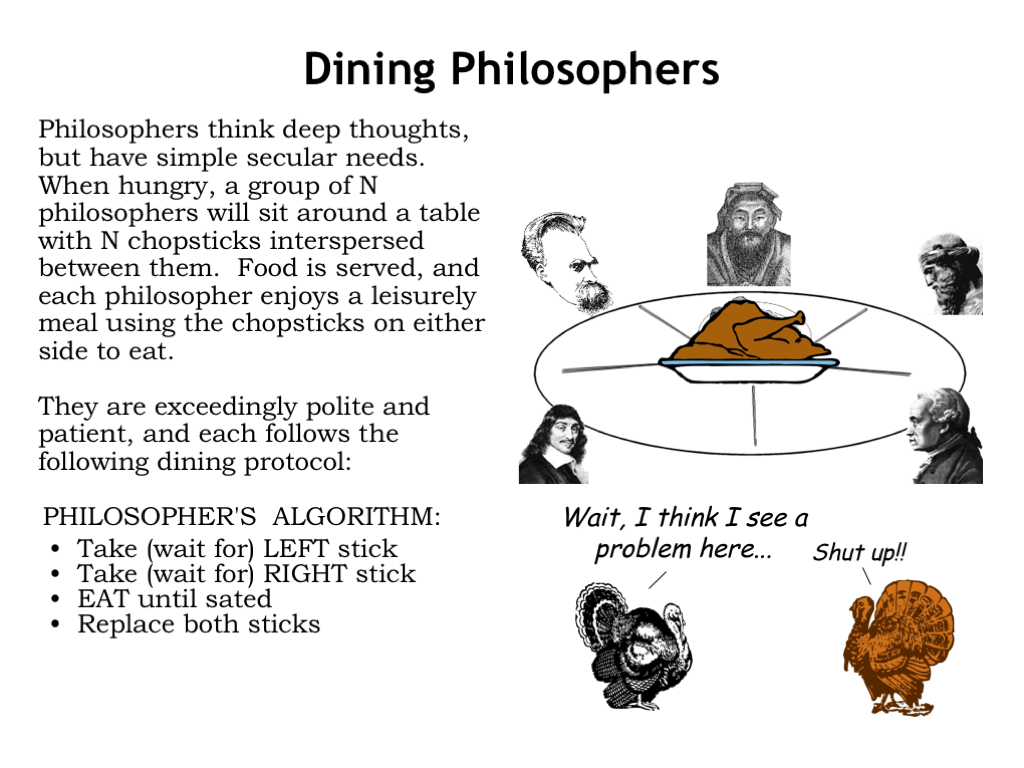
21. 哲学家就餐(Dining Philosophers)

Dining Philosophers

5 哲学家、5 筷;每人需左右两筷。算法:先左后右,吃完归还。典型的“多资源才可完成”设定。

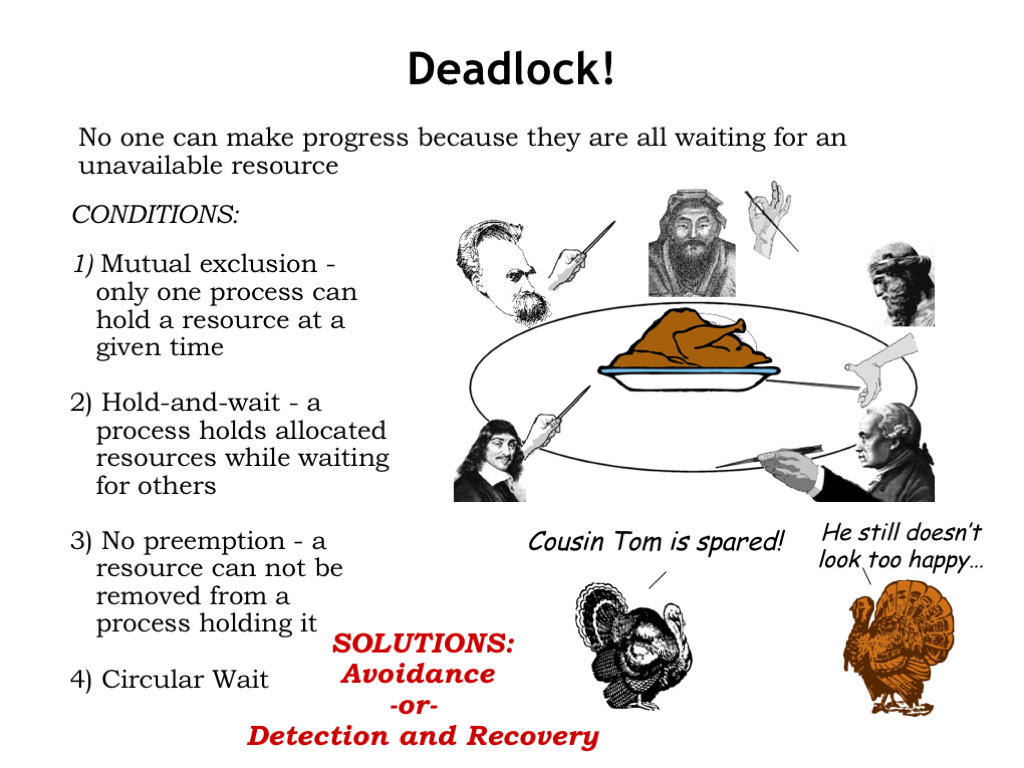
22. 死锁!(Deadlock!)

Deadlock

若人人先拿左筷,则无人能拿右筷 → 死锁。四条件:

  1. Mutual exclusion
  2. Hold-and-wait
  3. No preemption
  4. Circular wait

对策:避免,或检测 + 恢复。

23. 一种解法(One Solution)

One Solution

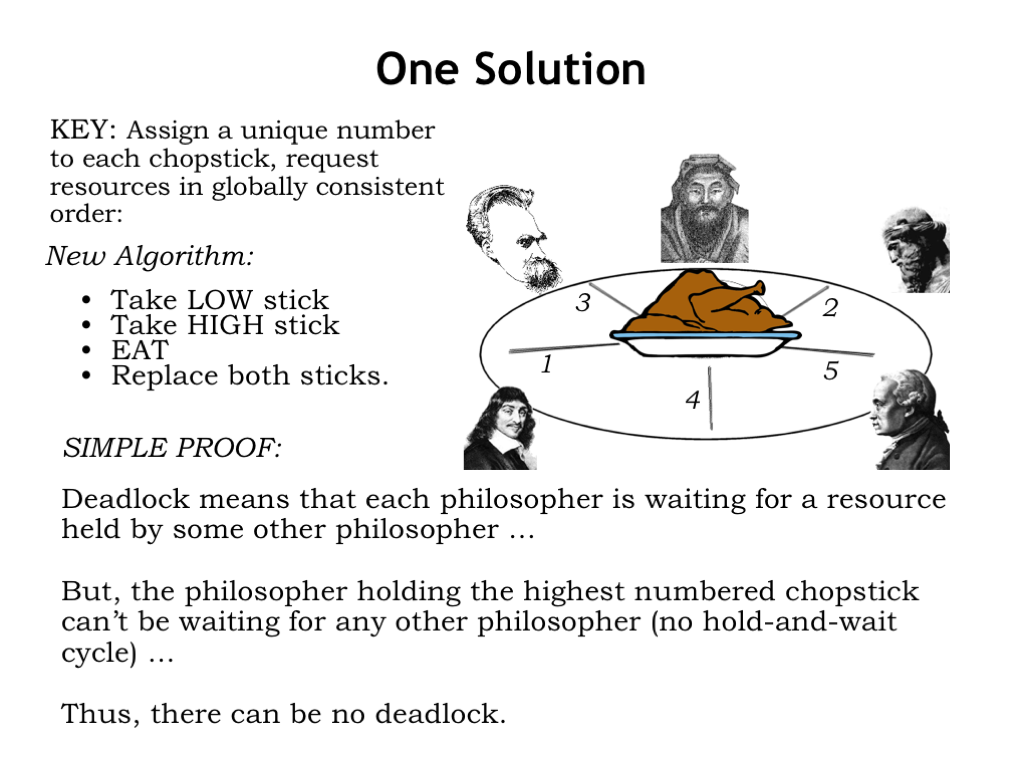
给筷子唯一编号,按全局序取资源(先低号再高号)。若全部筷子都被拿起,必有人已持有最高号筷,此前也已拿到另一侧低号筷 → 此人可吃并归还,打破 hold-and-wait 环。全系统约定资源全局序并按序获取 → 无环等待死锁。

24. 处理死锁(Dealing With Deadlocks)

Dealing With Deadlocks

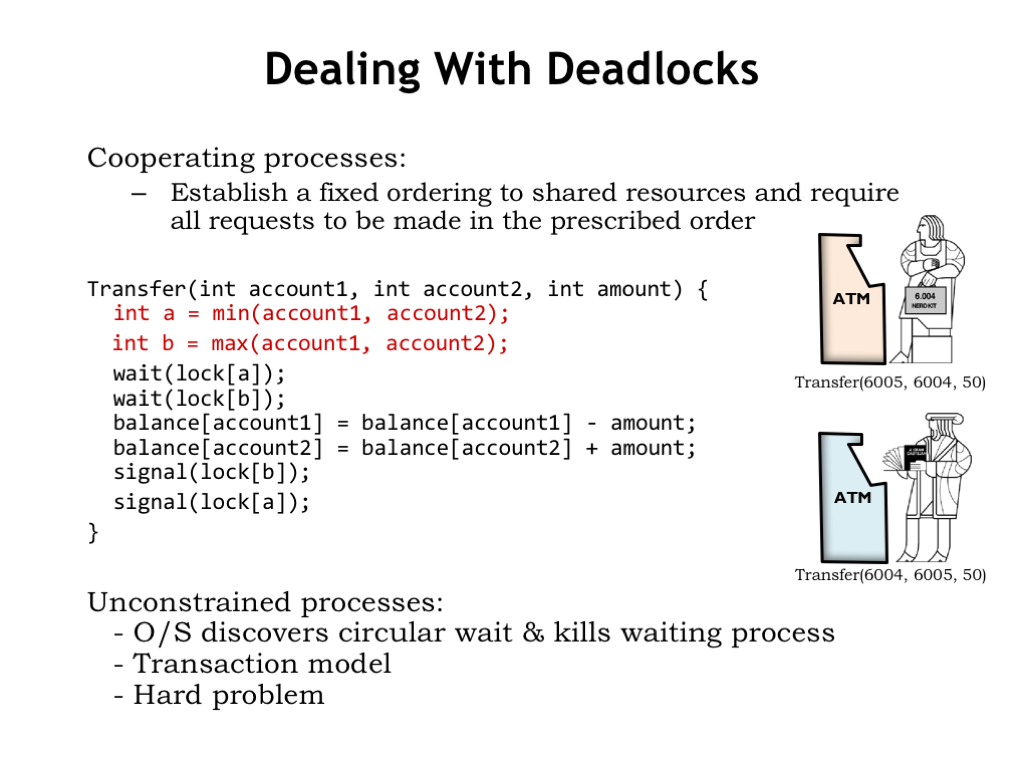
转账:先锁低账号,再锁高账号——双方先争同一把“第一资源”,胜者可安全拿齐其余。无法改应用时:OS 的 WAIT 可检测环等待并终止一进程释放资源;数据库则检测冲突、abort 事务并由程序员决定重试,提交前改动只在事务私有副本上,确认后才 commit。

25. 小结(Summary)

Summary
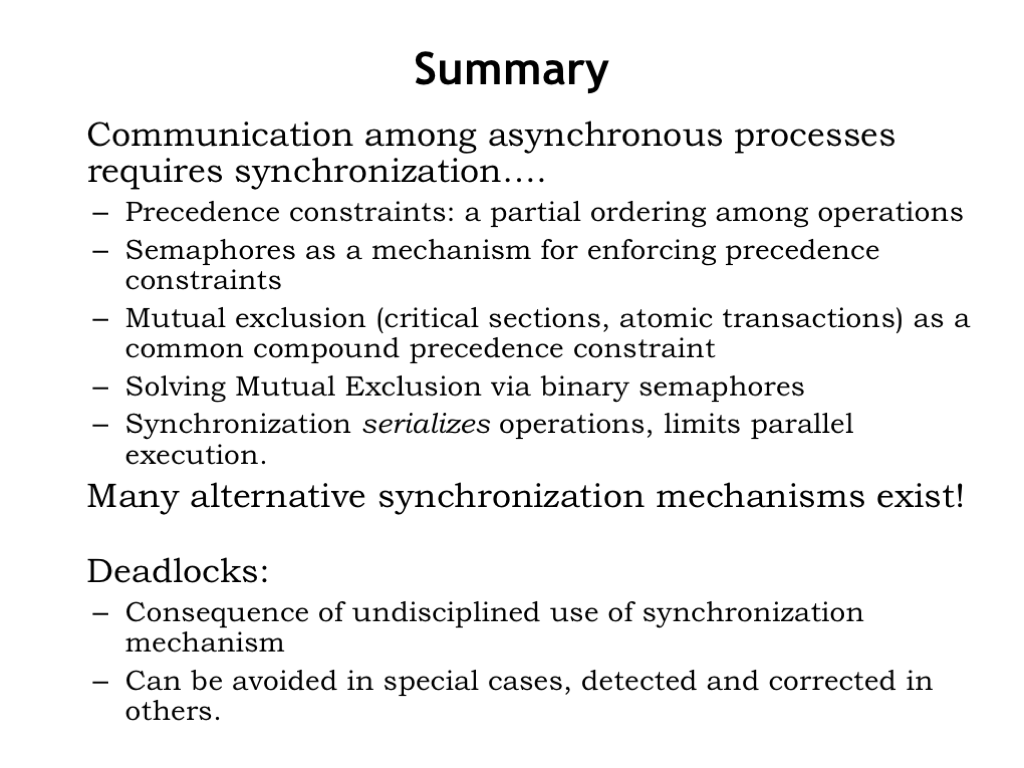
  • 多进程组织应用常更自然;用 semaphore 保证 precedence 与 mutual exclusion
  • 临界区 + 锁实现事务语义
  • 多锁可能 deadlock;全局资源序避免,或检测/重启恢复
  • 大数据与云上千进程协作时,同步是核心技能

整理自 MIT OCW 6.004 Computation Structures(Spring 2017)L18 注解幻灯片。

源网页:18.1 Annotated Slides | Devices and Interrupts

讲师:Chris Terman。图片直接引用 OCW 原站链接。

L18:设备与中断(Devices and Interrupts)

本讲讲 OS 如何用 interrupt 与内核缓冲对接 I/O,以及 blocking SVC(ReadKey)在中断禁用下的实现演进(忙等 → 重试 SVC → Scheduler → sleep/wakeup);后半转入 hard real-time:latency、weak/strong priority、周期性负载与截止期可满足性。

1. OS 组织:I/O 设备(OS Organization: I/O Devices)

OS Organization: I/O Devices

OS 与外设交互分两层:

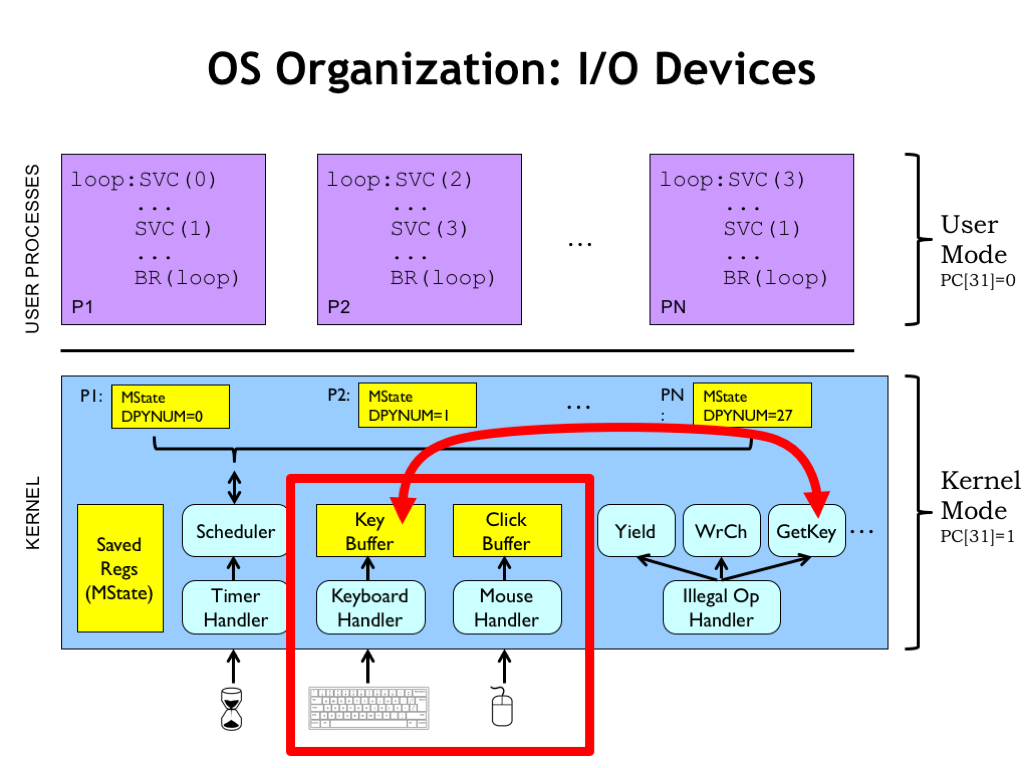
  1. 设备侧:interrupt handler + 内核缓冲,把数据搬进/搬出设备
  2. 用户侧:supervisor call(SVC)按用户进程请求访问这些缓冲

难点:SVC 发出时请求未必立刻能完成(缓冲空/满),需要阻塞与唤醒机制。

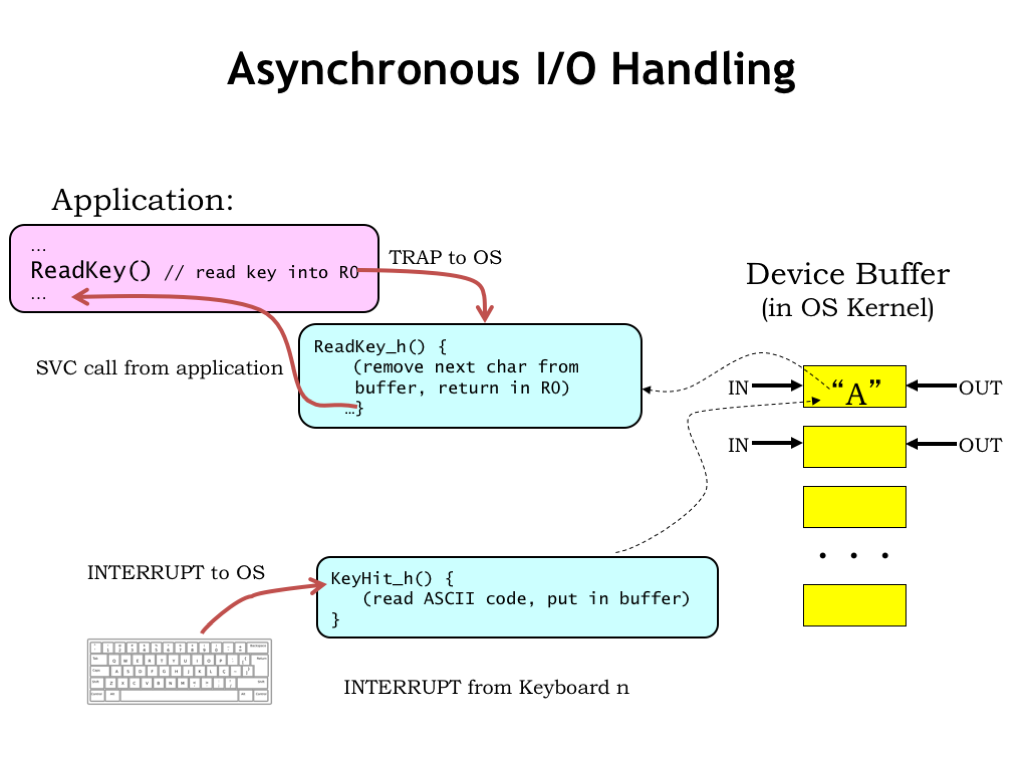
2. 异步 I/O 处理(Asynchronous I/O Handling)

Asynchronous I/O Handling

流程:按键 → 键盘触发 interrupt → 暂停当前进程 → handler 读字符写入拥有键盘焦点进程的内核缓冲 → 恢复被中断进程。人打字远慢于指令执行,及时服务即可跟上。

缓冲满时:覆盖旧字符无意义,通常丢弃新字符并蜂鸣提示。稍后用户程序调用 ReadKey() SVC,OS 从缓冲取字符放入用户 R0。

  • blocking I/O:返回时 R0 必有字符;尚无则阻塞
  • non-blocking I/O:立即返回状态标志 + 结果,程序自行决定是否稍后重试

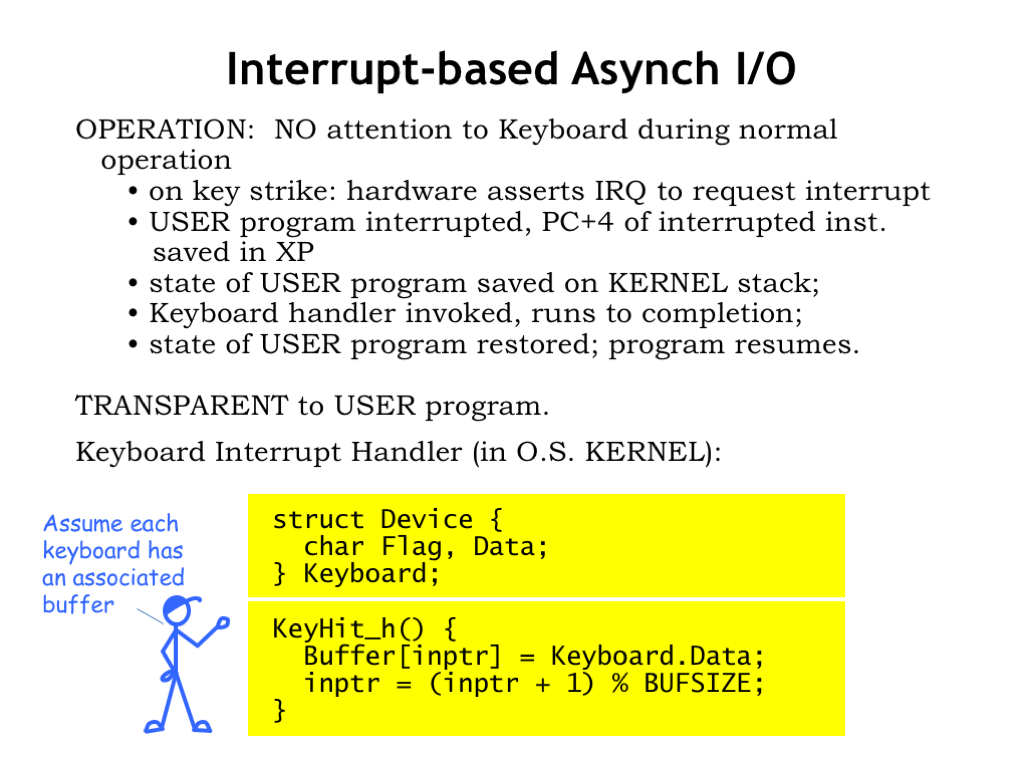
3. 基于中断的异步 I/O(Interrupt-based Asynch I/O)

Interrupt-based Asynch I/O

用户程序不轮询键盘,而是 event-driven:设备需要服务时用 interrupt 通知 OS。职责分离优雅——有活才占 CPU,对用户程序透明。

设备访问两种常见方式:

  • 专用 I/O 指令(如实验 Beta 的 RDCHAR()、CLICK())
  • memory-mapped I/O:内核地址空间一段映射到设备寄存器,用普通 LD/ST 访问

示意代码用 MMIO:结构体含 status 与 data;handler 读键码写入环形缓冲。实际还要处理 press/release、Shift/Ctrl、CTRL-ALT-DEL 等特殊组合,以及 raw vs cooked 输入模式。

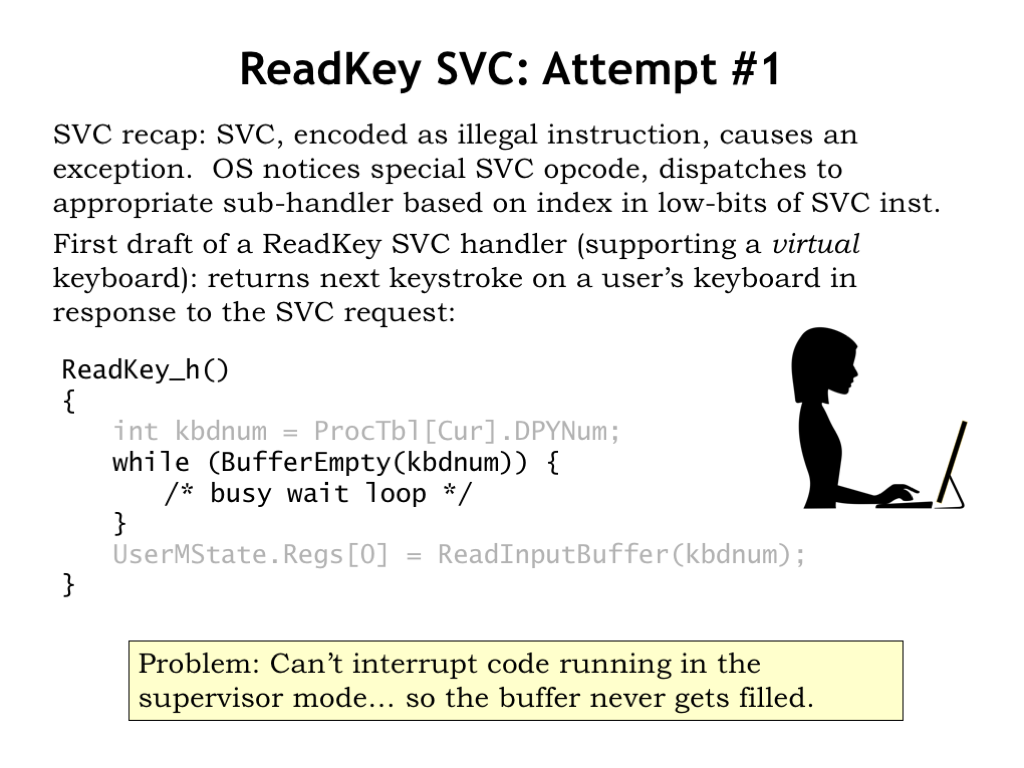
4. ReadKey SVC:尝试 #1(ReadKey SVC: Attempt #1)

ReadKey SVC: Attempt #1

ReadKey() 的 opcode 非法 → 异常进入 OS → 识别为 SVC 再分派子 handler。缓冲非空:从进程表找到对应键盘缓冲,字符写入保存的用户 R0,退出后恢复寄存器。
缓冲空时若在 handler 内 while 空转等待:SVC 在 supervisor 模式(PC[31]=1)运行,中断被禁用 → 键盘 interrupt 永远进不来 → 死循环,系统假死。失败。
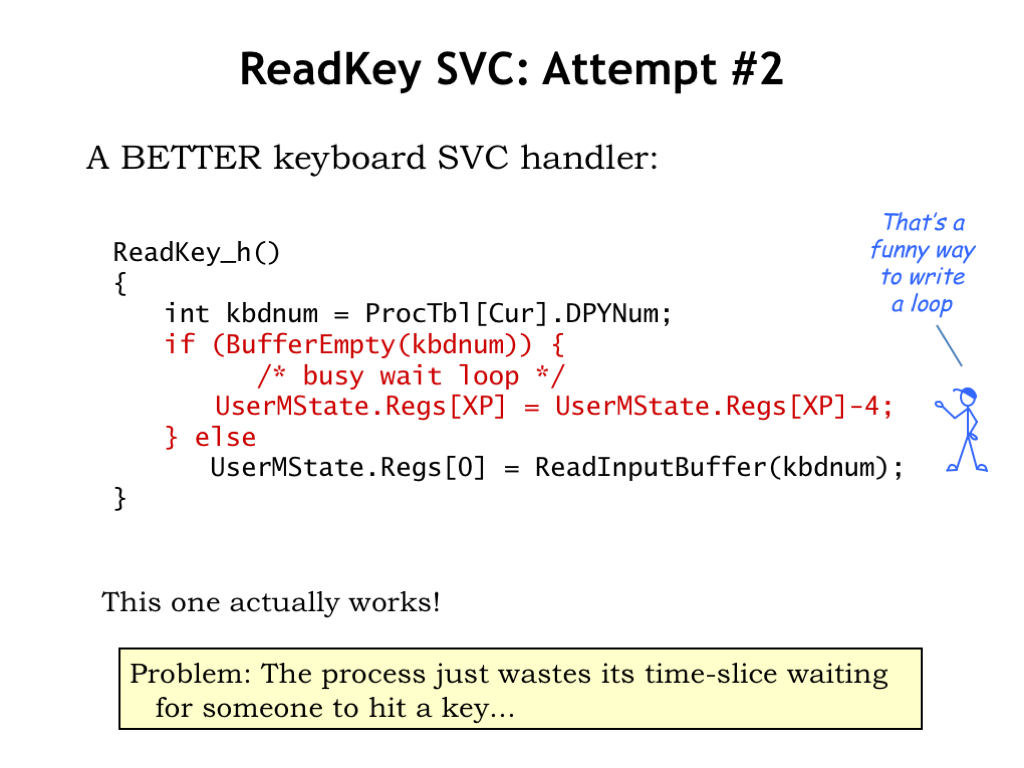
5. ReadKey SVC:尝试 #2(ReadKey SVC: Attempt #2)

ReadKey SVC: Attempt #2

修复:返回前把保存的 XP 减 4。异常时 XP 存的是非法指令的 PC+4;正常 JMP(XP) 会执行 SVC 之后的指令。XP−4 使恢复后重新执行同一条 SVC。

关键差别:重试时有一拍在 user-mode(PC[31]=0)执行,此时若有挂起键盘 interrupt,可抢占并填满缓冲;再进 SVC 就能取到字符。能工作,但空缓冲时忙等重试,浪费 CPU,直到 timer 切到别的进程。

6. ReadKey SVC:尝试 #3(ReadKey SVC: Attempt #3)

ReadKey SVC: Attempt #3

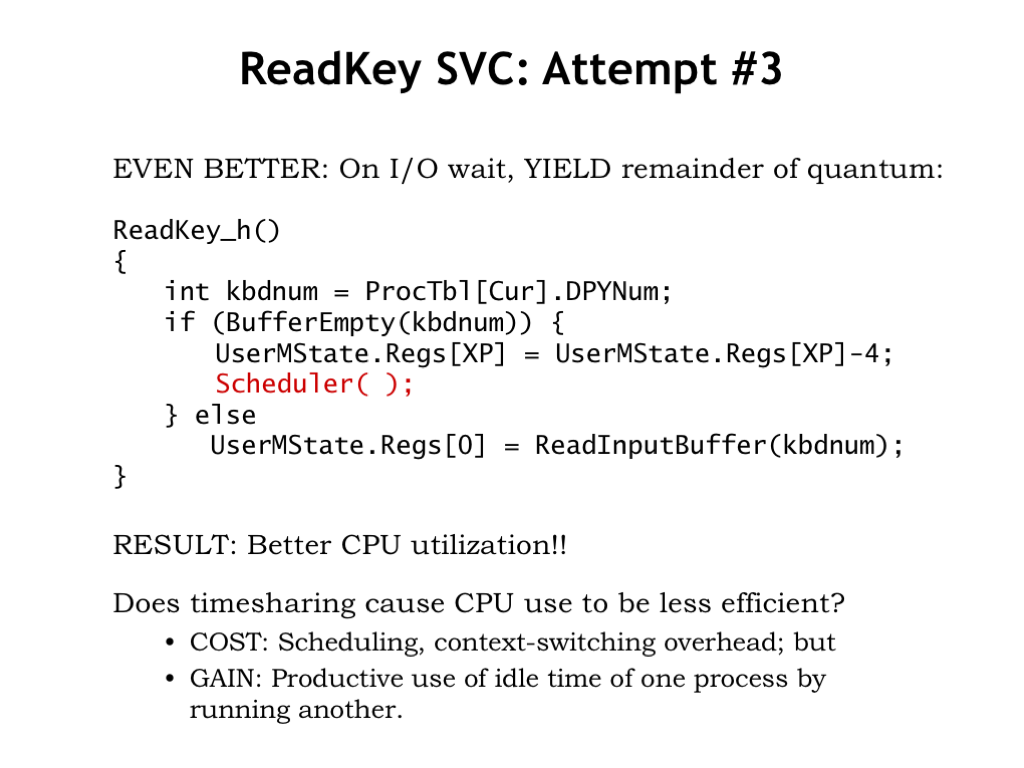
空缓冲时:安排重试 SVC 后立刻调用 Scheduler(),主动让出时间片。轮转调度回来再试。代价是打字后重启略有延迟,但时间片通常短于击键间隔,不明显。

对照 timesharing 质疑:10 个各需 1s 的作业,无分时依次完成;有分时则几乎都在 ~10s 后才完——最坏完成时间不更短。但若多数进程在等 I/O,分时把空闲周期送给能干活的进程,整体利用率更好。真实系统里大量进程处于 I/O wait。

7. 更精细的调度(Sophisticated Scheduling)

Sophisticated Scheduling

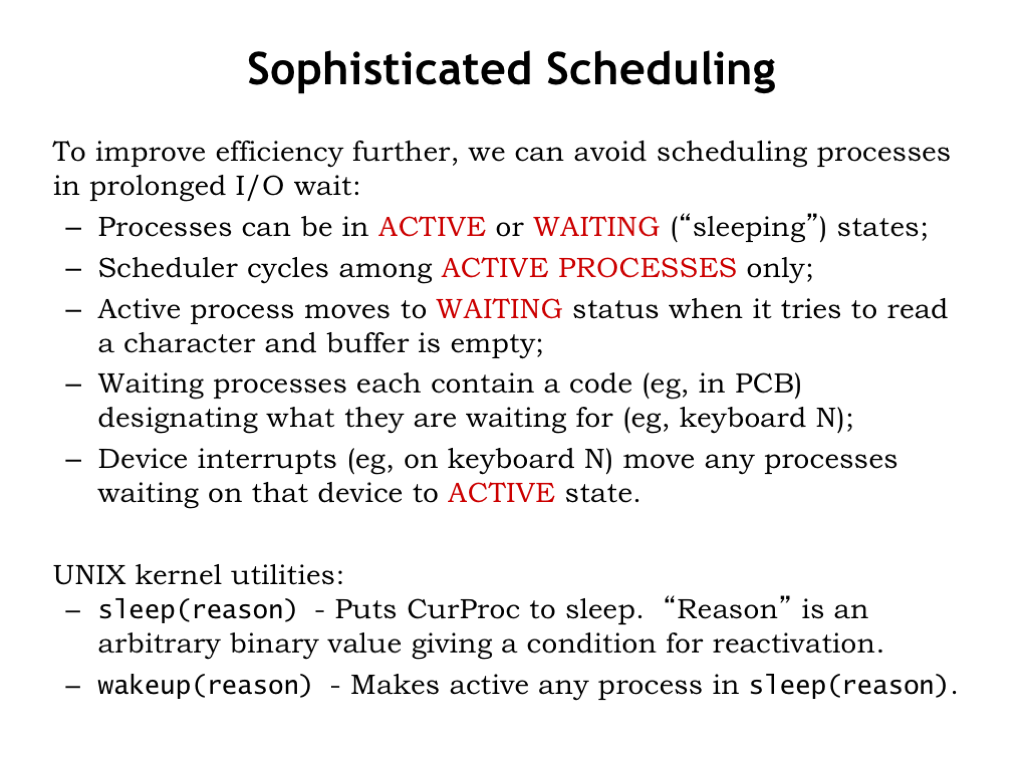
进程状态加 status:ACTIVE(0)或 WAITING(非零,不同值表示等不同事件)。Scheduler() 只跑 ACTIVE。UNIX 风格原语:sleep(event) / wakeup(event),参数即 status 标识。

8. ReadKey SVC:尝试 #4(ReadKey SVC: Attempt #4)

ReadKey SVC: Attempt #4

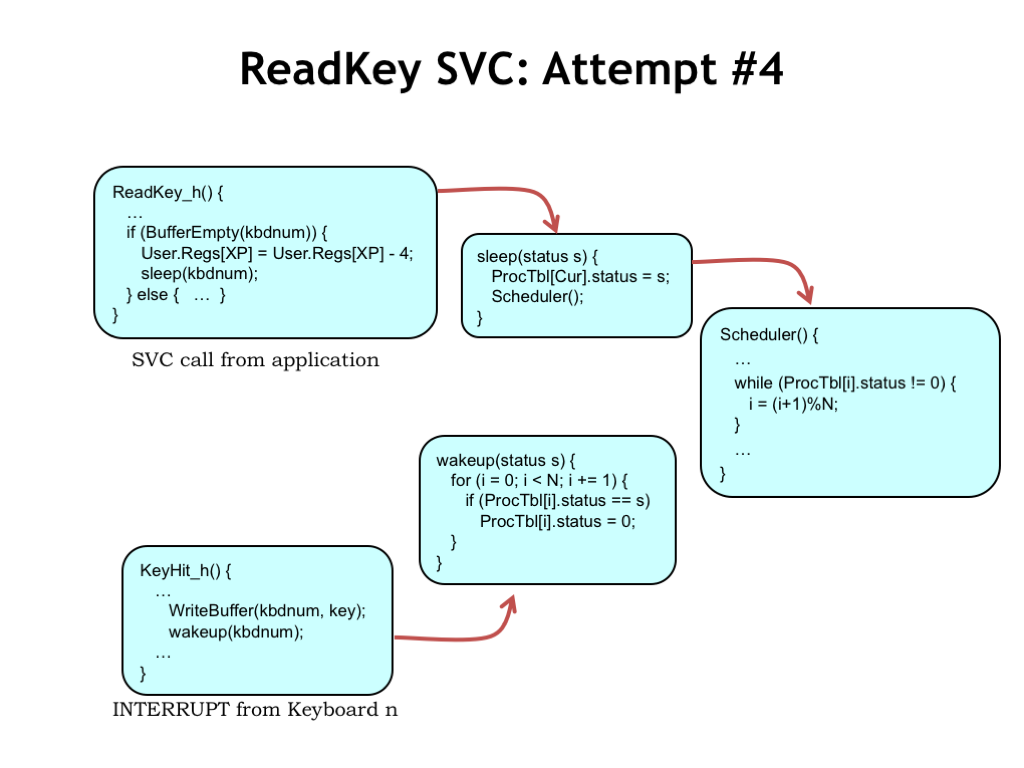
缓冲空 → sleep(kbdnum) 设 WAITING 并调度;键盘 handler 写入缓冲后 wakeup(kbdnum),把所有等该事件的进程标为 ACTIVE。睡着的进程在事件发生前完全不占 CPU——优雅且高效。

9. 例题:Handler 与 OS 配对(Example: Match Handler to OS)

Match Handler to OS

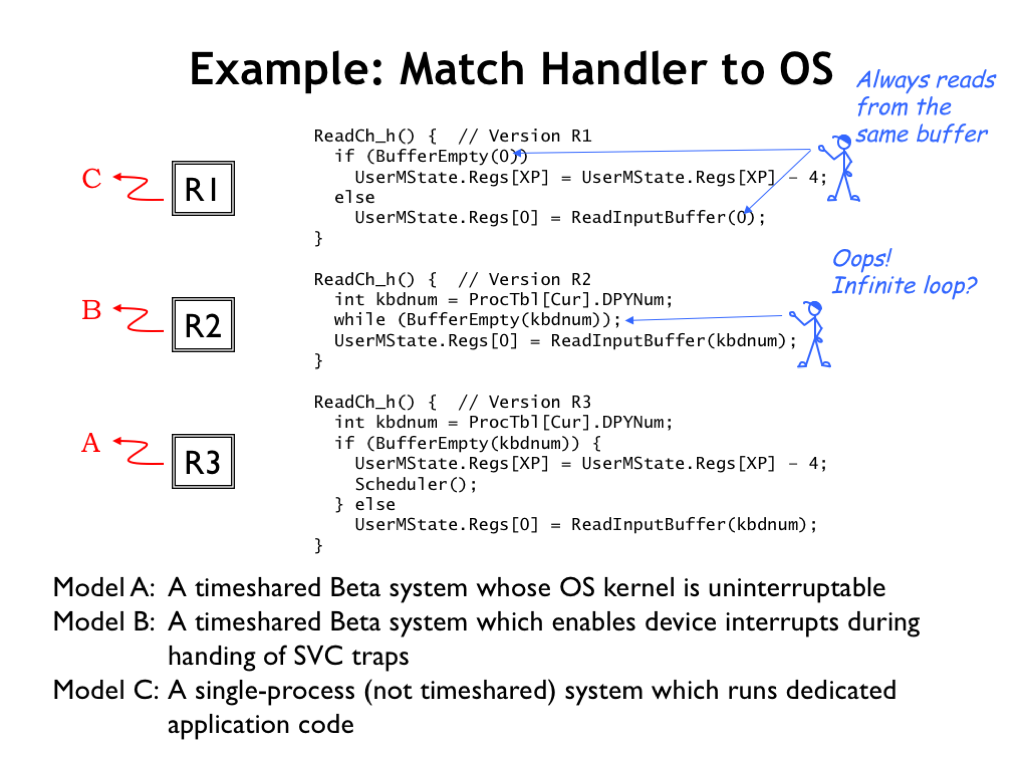
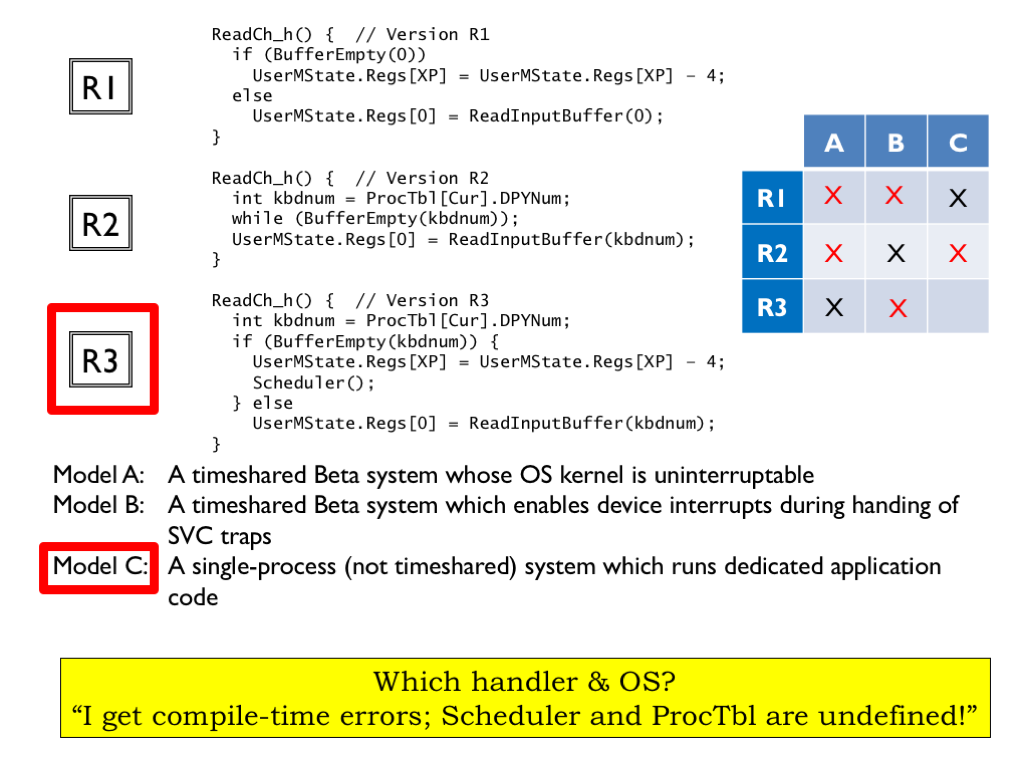
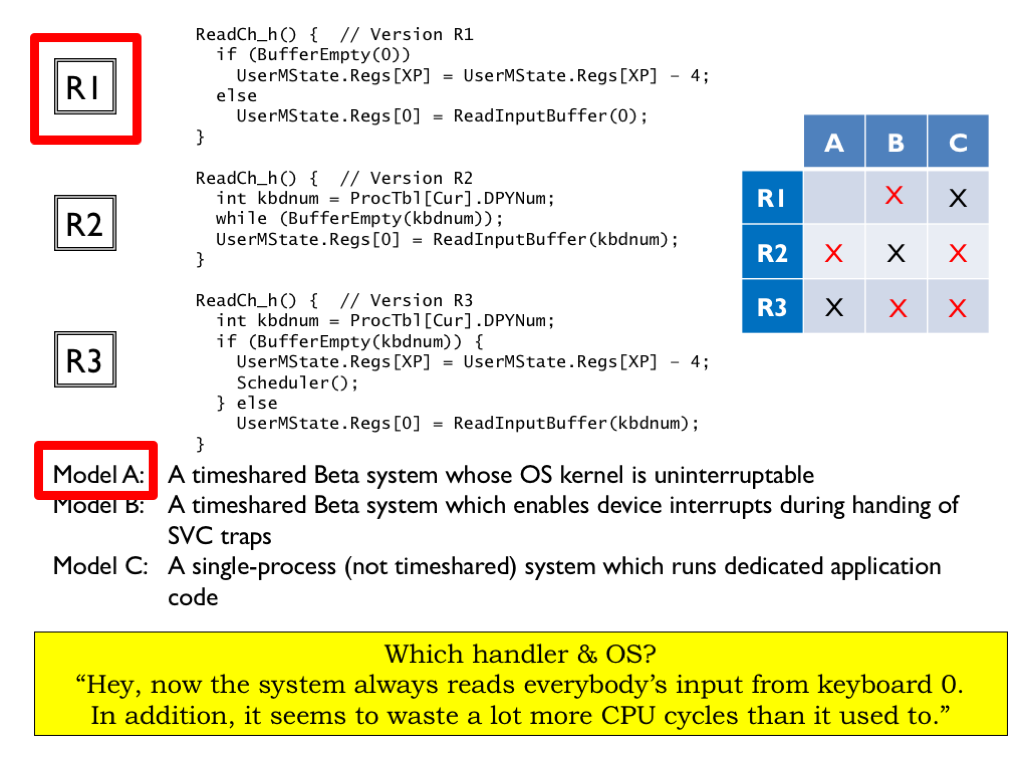
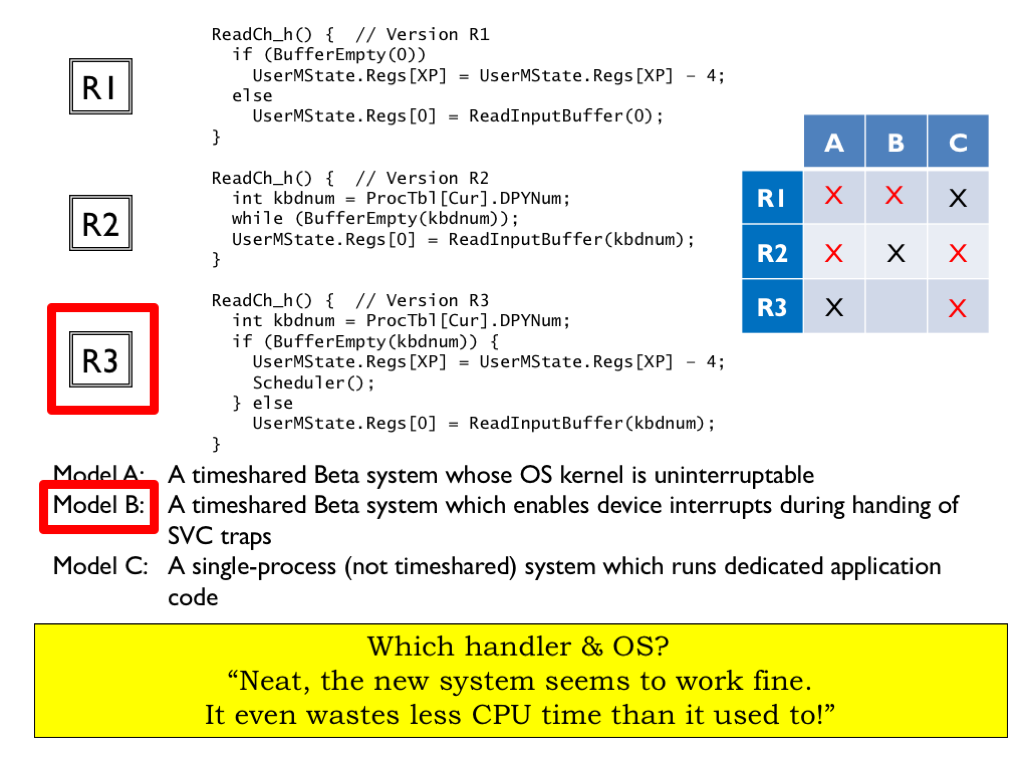
三种 ReadKey 变体 R1/R2/R3,三种系统 Model A/B/C:

  • R1(似尝试 #2,但总读键盘 0):只适合单进程 Model C(分时下会串共享输入)
  • R2(似尝试 #1 的 while 空转):只适合 Model B(SVC 内仍允许设备中断)
  • R3(尝试 #3):配对标准 Model A(内核不可中断)

10. 哪套 Handler 与 OS?#1(Which Handler and OS? #1)

Which Handler and OS #1

用户报:“编译错误,Scheduler 与 ProcTbl 未定义。” → 非分时系统无这两符号;R2 也不调用 Scheduler → R3 跑在 Model C。

11. 哪套 Handler 与 OS?#2(Which Handler and OS? #2)

Which Handler and OS #2

“现在总从键盘 0 读所有人输入,而且更浪费 CPU。” → 只有 R1 固定键盘 0;相对旧 handler 明显更费说明以前不是忙等的 R2 → R1 在 Model A。

12. 哪套 Handler 与 OS?#3(Which Handler and OS? #3)

Which Handler and OS #3

“新系统工作正常,还更省 CPU!” → 排除 R1 在分时(共享键盘可察觉)、R2/R3 在无进程表的 C、R2 在不可中断内核 A → Model B 用户现跑 R3。

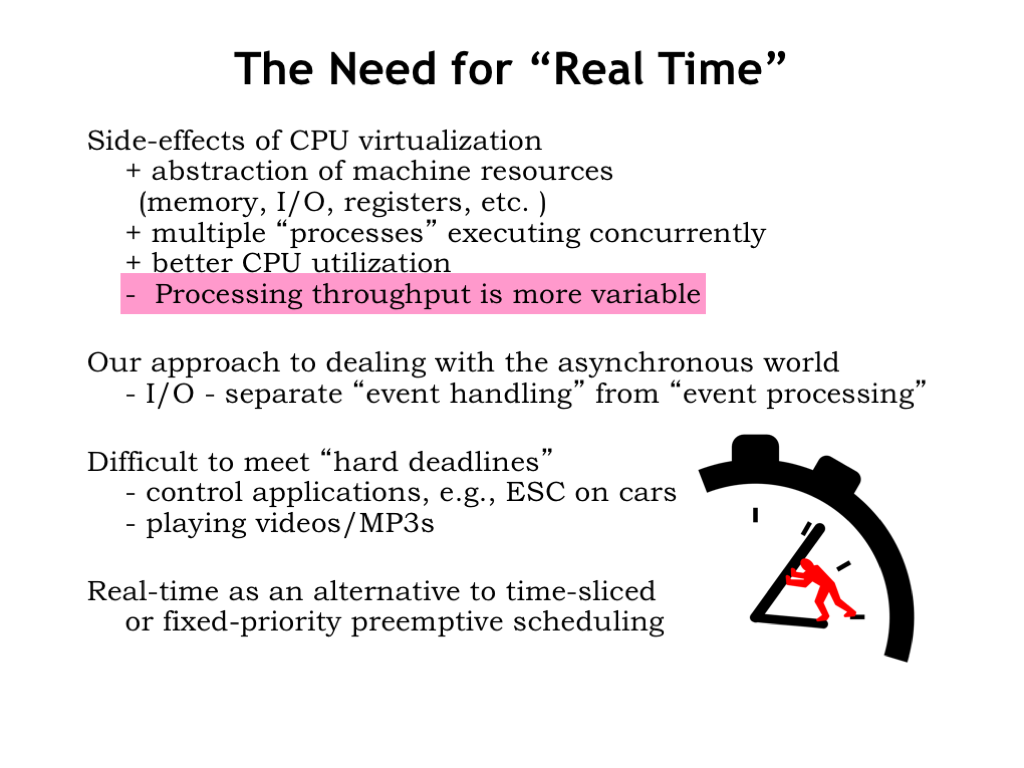
13. 对“实时”的需求(The Need for “Real Time”)

The Need for Real Time

分时给每进程独立虚拟机的错觉,利用率好,但无法保证完成时间——取决于其他进程占用。OS 把 interrupt 事件暂存与用户态处理(经 SVC)分离,更难保证在 deadline 前处理完。

汽车 ESC(电子稳定控制)等控制系统有硬截止期:测力/转向/轮速 → 判是否失控 → 单轮制动纠正航向。错过截止期可能危及安全。

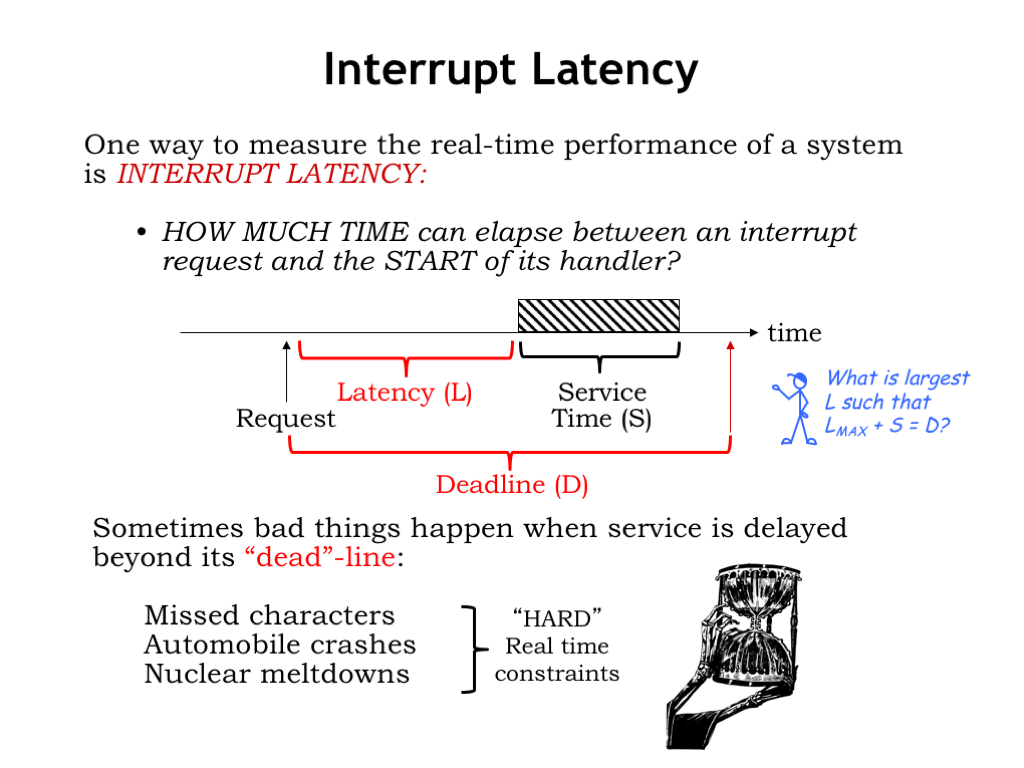
14. 中断延迟(Interrupt Latency)

Interrupt Latency

Interrupt latency LL:从请求运行某代码到代码真正开始执行的时间。服务时间 SS、截止期 DD 时,最大允许延迟满足 Lmax⁡+S=DL_{\max}+S=D。必须始终 L<Lmax⁡L < L_{\max} 的约束称 hard real-time constraints。

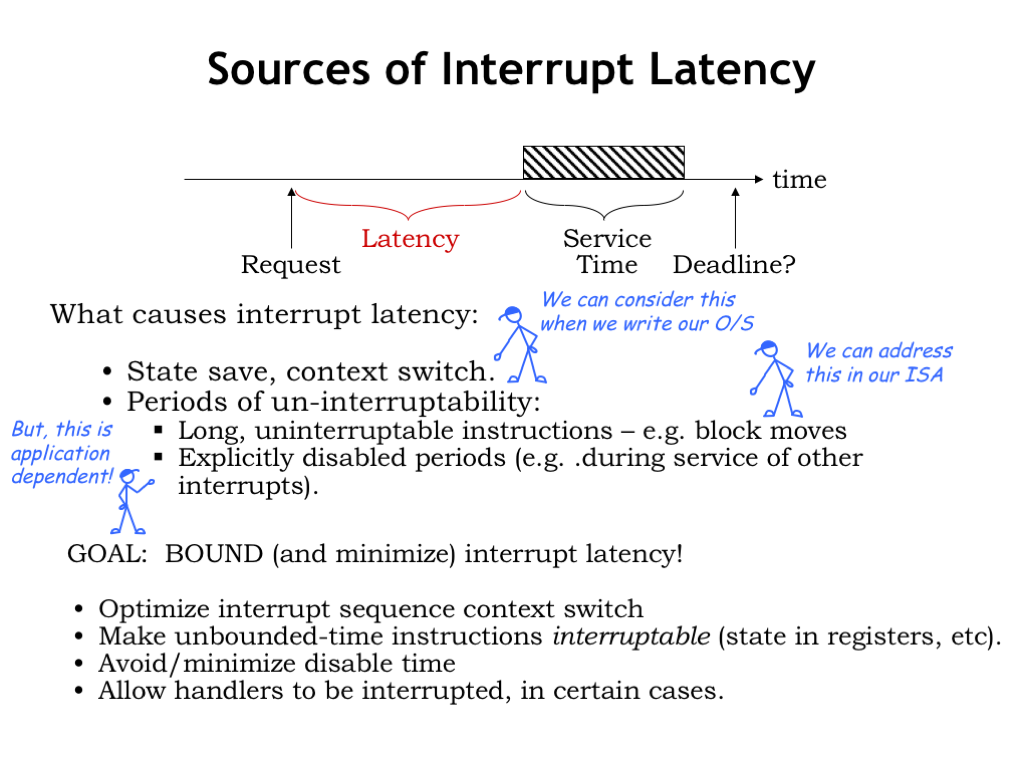
15. 延迟来源(Sources of Interrupt Latency)

Sources of Interrupt Latency

贡献因素:保存进程状态、切内核、分派 handler;不可中断的长时段(复杂多周期指令如 block move——ISA 应可中断重启);以及已在内核处理另一 interrupt(中断禁用)时的等待。

目标:界住并最小化 LL——优化取中断路径、避免数据相关长指令、缩短内核态时间;必要时允许内核内仍可被更高优先级中断。

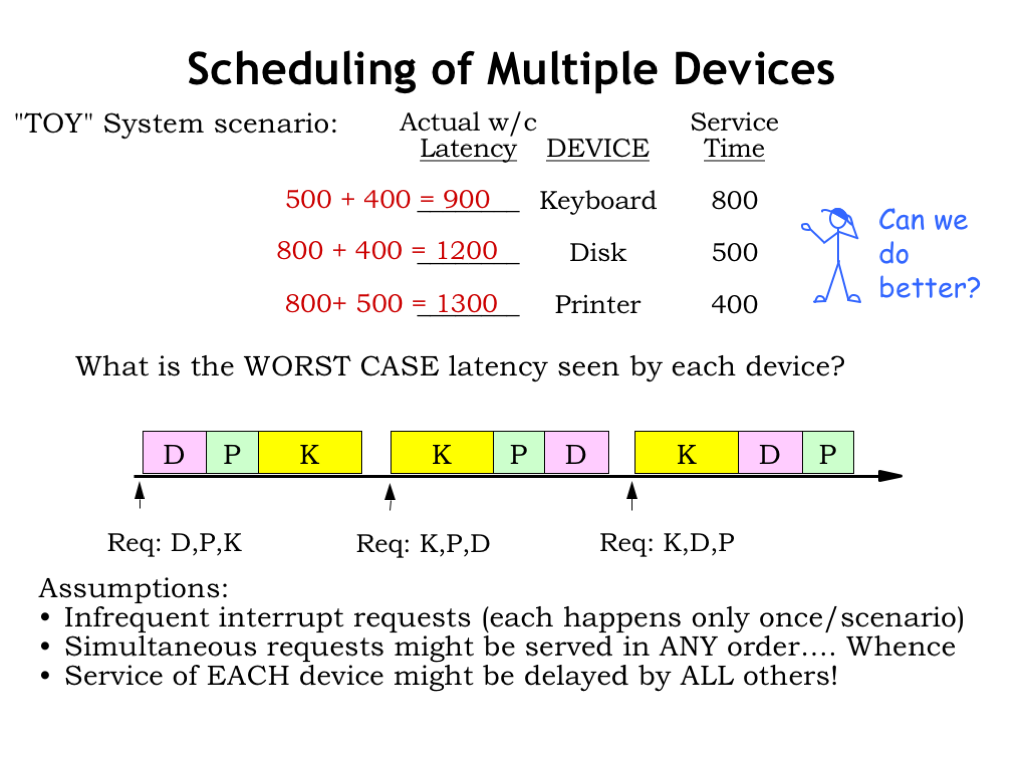
16. 多设备调度(Scheduling of Multiple Devices)

Scheduling of Multiple Devices

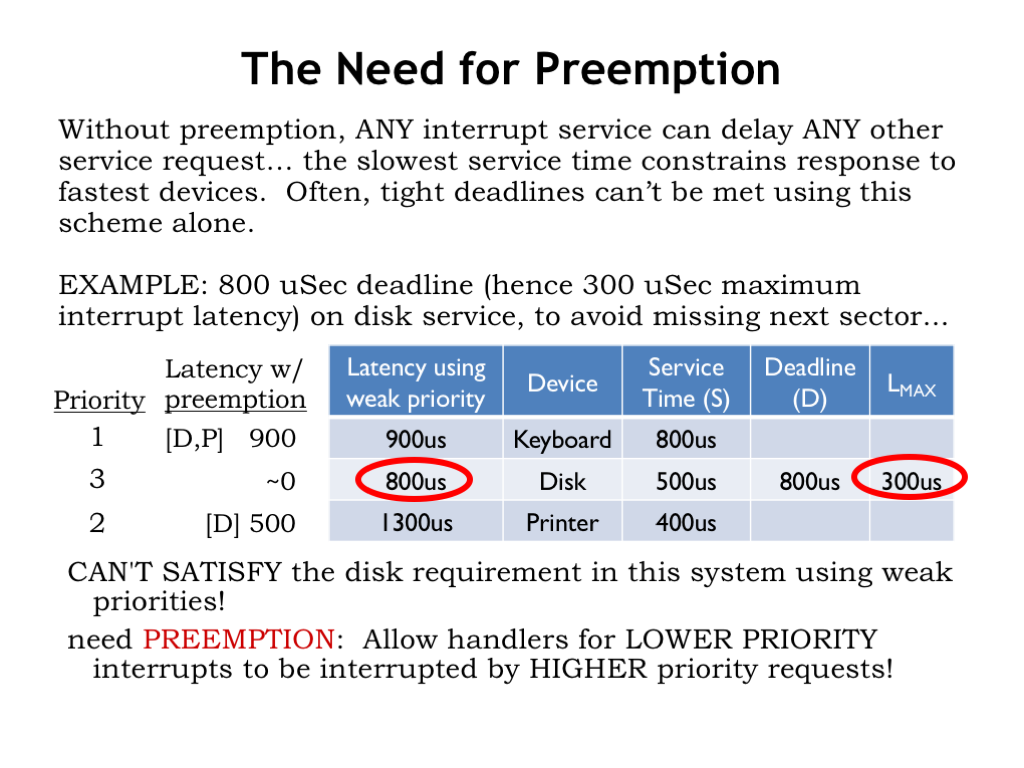
三设备服务时间:键盘 800 µs、磁盘 500 µs、打印机 400 µs。请求稀少、任意到达。FCFS 下最坏延迟 = 另两设备服务之和:键盘 900、磁盘 1200、打印机 1300 µs。长 handler 拖累他人——有无更好调度?

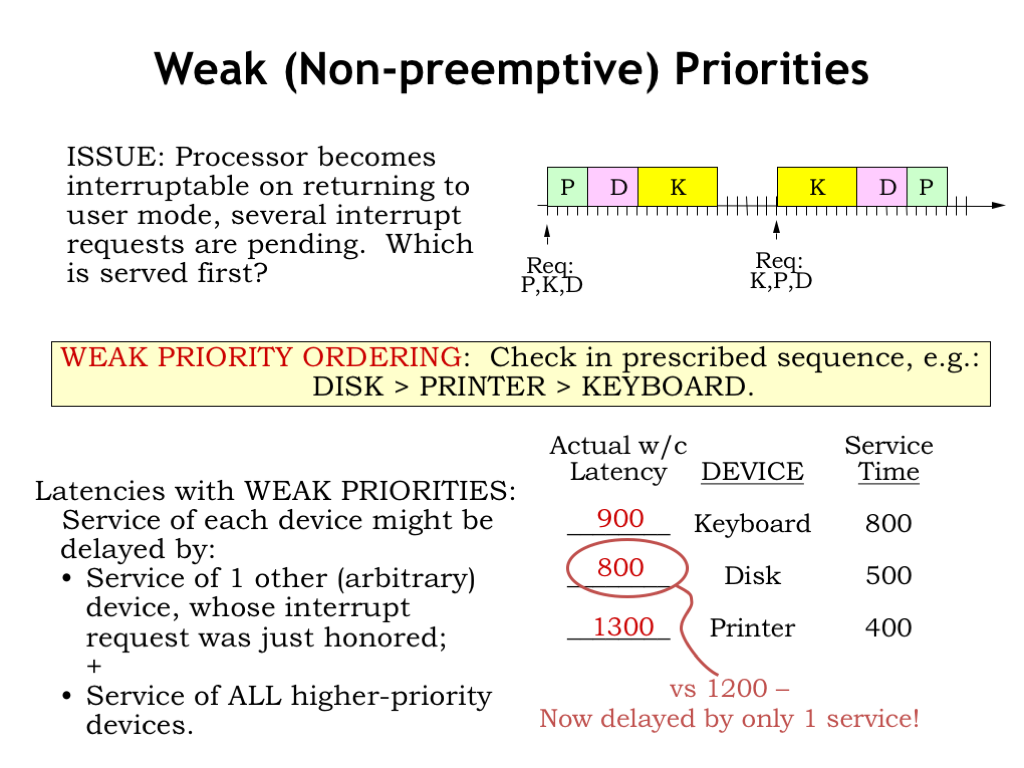
17. 弱(非抢占)优先级(Weak (Non-preemptive) Priorities)

Weak Priorities

Weak / nonpreemptive priority:当前任务跑完才按优先级选下一个;新到的更高优先级也不能打断。最坏延迟 ≈ 任意其他设备最长服务时间 + 所有更高优先级服务时间。

例:优先级 磁盘 > 打印机 > 键盘 → 键盘仍 900;磁盘只需等当前最长者(键盘)→ 800 µs;打印机最坏 800+500=1300 µs。

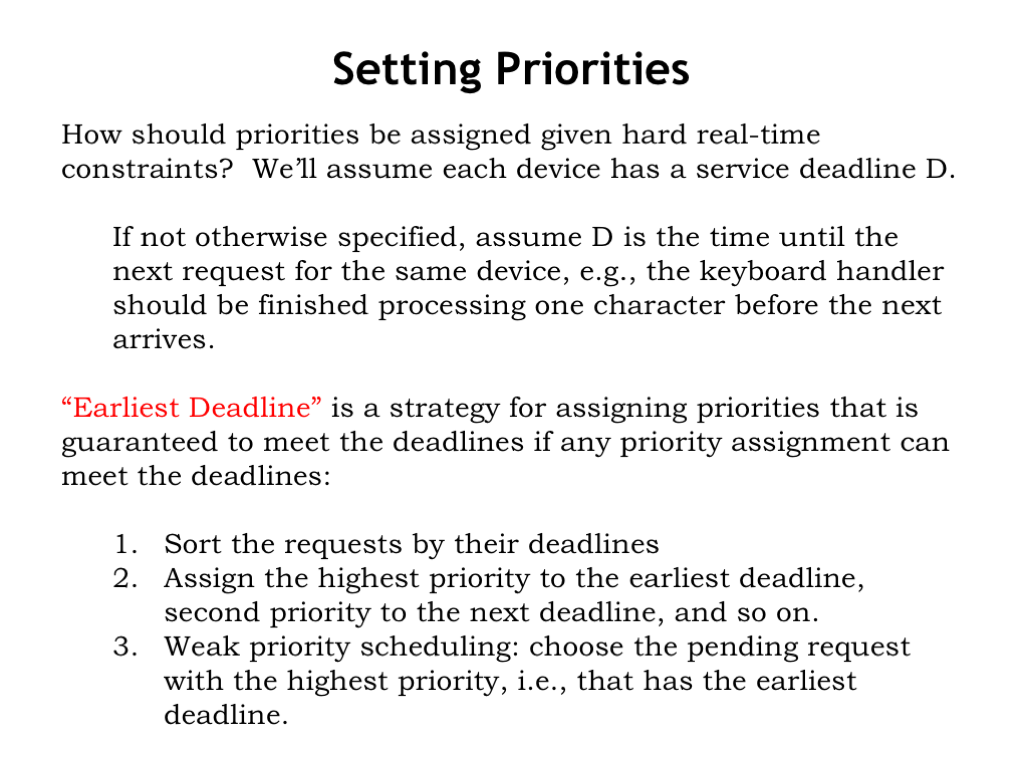
18. 设定优先级(Setting Priorities)

Setting Priorities

硬实时下:Earliest Deadline——按截止期排序,越早截止优先级越高。若存在能满足所有截止期的优先级赋值,EDF 也能满足。机场安检先办最早航班的比喻。过载时最小化“误机人数”则更复杂,超出本讲范围。

默认:未另行规定时,DD 取为到同一设备下一次请求的时间,避免系统越落越远。

19. 需要抢占(The Need for Preemption)

The Need for Preemption

弱优先级下最坏延迟总含“当前最长其他任务”。若磁盘截止期 800 µs、S=500S=500 → 允许 Lmax⁡=300L_{\max}=300 µs,但弱优先级只能保证 800 µs → 不够。

引入 strong / preemptive priority:高优先级可打断低优先级 handler。同优先级序下:磁盘 L=0L=0,打印机 500,键盘仍 900——磁盘截止期可满足。

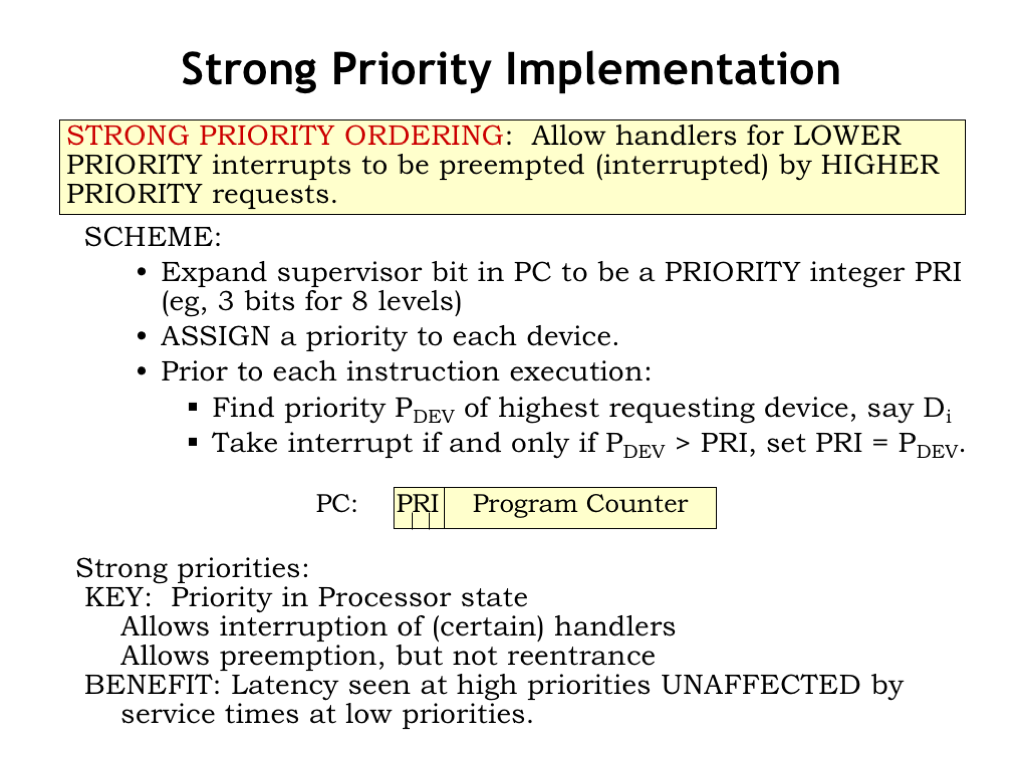
20. 强优先级实现(Strong Priority Implementation)

Strong Priority Implementation

Beta 改造:PC[31] 单比特 supervisor 改为 PC[31:29] 的 3-bit PRI(8 级)。设备请求带自己的优先级 PDEVP_{\mathrm{DEV}};优先级编码器选出最高请求,仅当 PDEV>PRIP_{\mathrm{DEV}} > \mathrm{PRI} 才接受中断。接受后旧 PC+PRI 存入 XP,新 PRI 设为 PDEVP_{\mathrm{DEV}}。高优先级最坏延迟不再受低优先级服务时间影响。

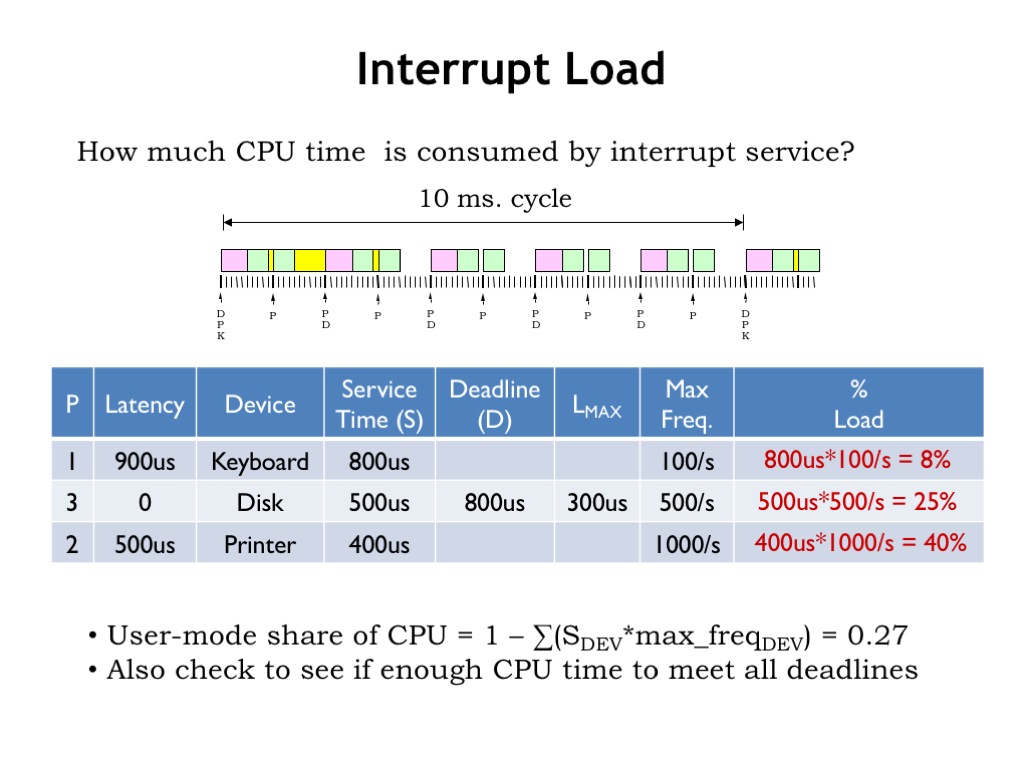
21. 重复中断(Recurring Interrupts)

Recurring Interrupts

加上最大请求频率:打印机每 1 ms、磁盘 2 ms、键盘 10 ms。强优先级下磁盘立即服务、打印机可抢占键盘。键盘开始延迟仍可 ≤900 µs,但不断被抢占,完成可能晚到请求后 3 ms——说明实时约束应用 deadline 表达,而非仅看 latency。周期需求过紧时 CPU 周期根本不够。

22. 中断负载(Interrupt Load)

Interrupt Load

周期负载:键盘 800 μs/10 ms=8%800\,\mu\mathrm{s}/10\,\mathrm{ms}=8\%,磁盘 25%,打印机 40%,合计 73%,剩 27% 给用户态。总负载 >100% 必失败。

截止期窗口内还要为更高优先级留预算:磁盘需 500/800≈67.5%500/800\approx 67.5\%;打印机有效截止 1000 µs 内需 500+400=900 µs。键盘若 D=2000D=2000 µs 需 500+2×400+800=2100 > 2000 → 不可行;D=3000D=3000 时 2×500+3×400+800=3000 → 刚好。

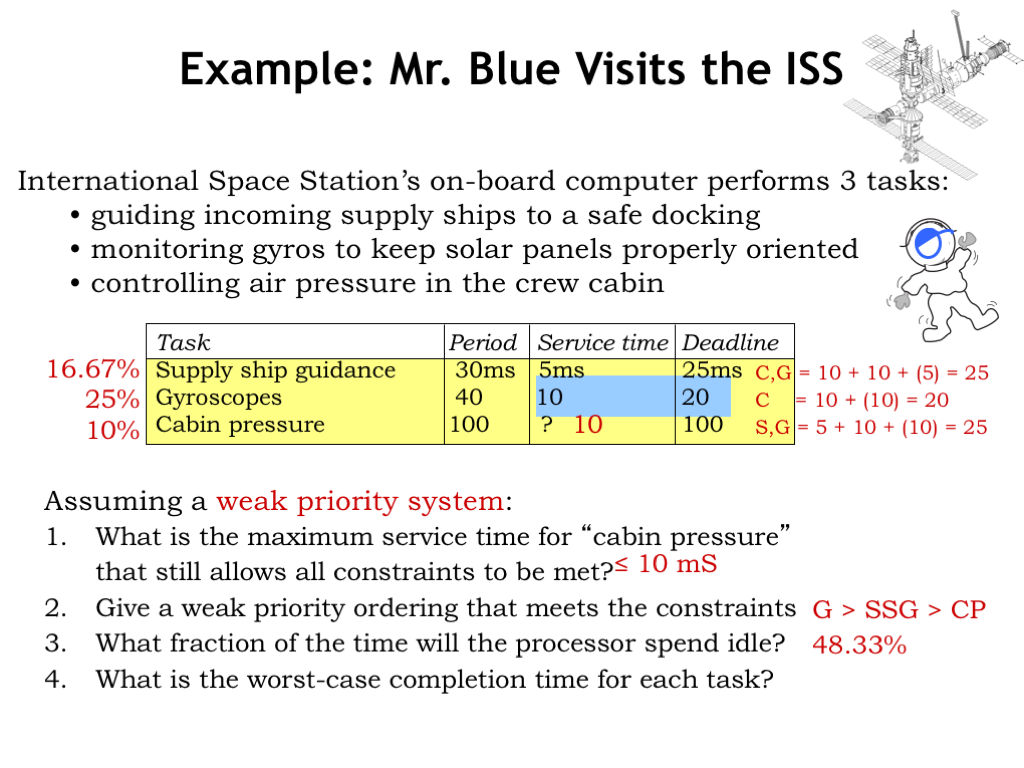
23. Mr. Blue 访问 ISS(Mr. Blue Visits the ISS)

Mr. Blue Visits the ISS

国际空间站三任务 SSG / G / CP;先分析 弱优先级:

  1. CP 最大服务时间:G 的 Lmax⁡=10L_{\max}=10 ms → 任何其他 handler ≤10 ms
  2. EDF 序:G > SSG > CP
  3. 负载:SSG 5/30≈16.7%,G 25%,CP 10% → 合计 ~51.7%,空闲 ~48.3%
  4. 最坏完成:SSG 等 CP+G 再加自身 → 25 ms;G 等 CP+自身 → 20 ms;CP 等 SSG+G+自身 → 25 ms

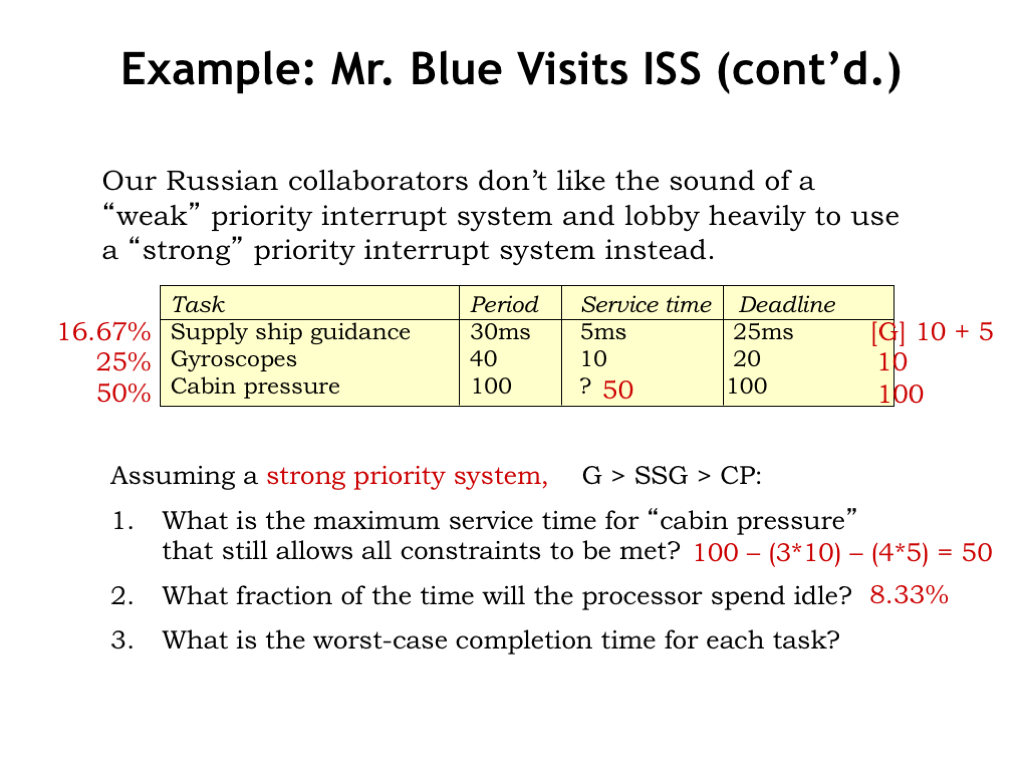
24. Mr. Blue 访问 ISS(续)(Mr. Blue Visits the ISS (cont’d.))

Mr. Blue Visits the ISS cont

改 强优先级(同序 G > SSG > CP):

  1. CP 可被抢占 → 不再受高优先级 Lmax⁡L_{\max} 限制;100 ms 窗口内最多 4 次 SSG + 3 次 G = 50 ms,故 CP 服务可达 50 ms
  2. CP 占 50% + 其余 → 总约 91.7%,空闲 ~8.3%
  3. 最坏完成:G = 自身服务时间;SSG ≤ 一次 G + 自身 = 15 ms;CP 按设计刚好压在 100 ms 截止期

25. 小结(Summary)

Summary
  • 用户与设备交互拆成:设备侧 interrupt + 内核缓冲;应用侧 SVC
  • 阻塞 I/O:经 XP−4 重试、Scheduler、最终 sleep/wakeup,避免空转
  • Hard real-time:latency、service time、deadline;weak vs strong priority
  • 实践中常多级强优先级,同级内再用弱优先级仲裁——足以应对多数 I/O 实时约束

整理自 MIT OCW 6.004 Computation Structures(Spring 2017)L17 注解幻灯片。

源网页:17.1 Annotated Slides | Virtualizing the Processor

讲师:Chris Terman。图片直接引用 OCW 原站链接。

L17:处理器虚拟化(Virtualizing the Processor)

本讲在虚拟内存之上引入 process 与 虚拟机 抽象:用定时器中断做 timesharing、在 kernel/user 模式间切换保存恢复状态;并用非法指令异常做指令仿真与 SVC(supervisor call)系统调用。

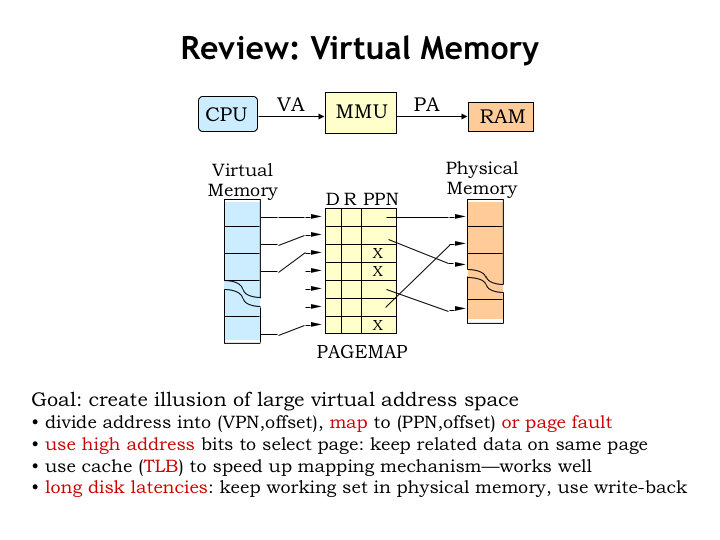
1. 回顾:虚拟内存(Review: Virtual Memory)

Review Virtual Memory

上讲引入虚拟内存与 MMU:CPU 虚地址 → 主存物理地址,多程序可各享独立大地址空间。虚/实空间都按页划分;例:页 2122^{12} 字节、32 位地址 → 2202^{20} 页,高 20 位页号、低 12 位偏移。

MMU 用页表把 VPN 映到 PPN(常多层,仅驻留活跃部分);TLB 缓存近期翻译。已分配虚存内容在辅存;不在主存则 page fault,OS 装页。实践中每程序仅活跃页驻留主存。

2. MMU 地址翻译(MMU Address Translation)

MMU Address Translation

先查 TLB;未命中再 walk 分层页表;不驻留则 page fault。映射 context 由两寄存器控制:context-number(TLB 可见哪些映射)与 page-directory(页目录所在物理页)。重载二者即可换 context。

多 context 需要够大的 TLB 同时缓存各进程热点映射,以及若干物理页存放页目录/页表段。例:两端各约 1024 页的两级页表用 3 页即可覆盖约 8MB 代码/栈/堆——对许多简单程序足够。

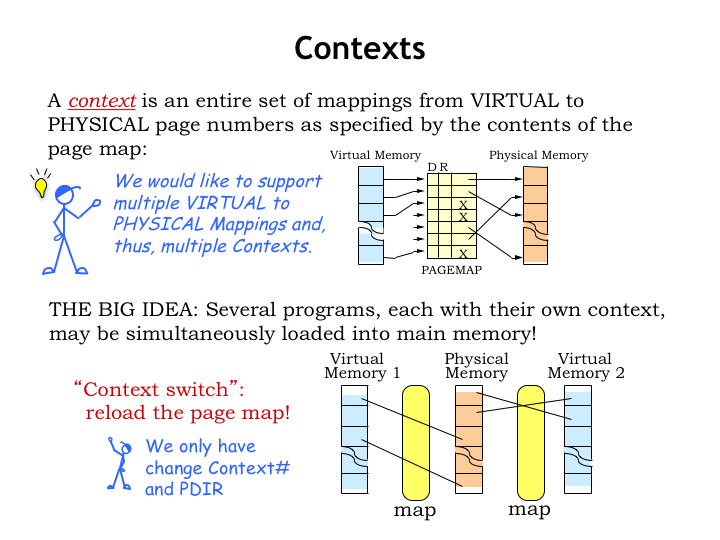
3. Context(Contexts)

Contexts

页表构造虚→实翻译所需的 context。多任务希望支持多 context 并快速切换,从而共享物理内存:两程序都可把虚地址 0 当入口,却落到不同物理页。换程序时做 context switch。接下来弄清如何共享 CPU。

4. 构建虚拟机(Building a Virtual Machine (VM))

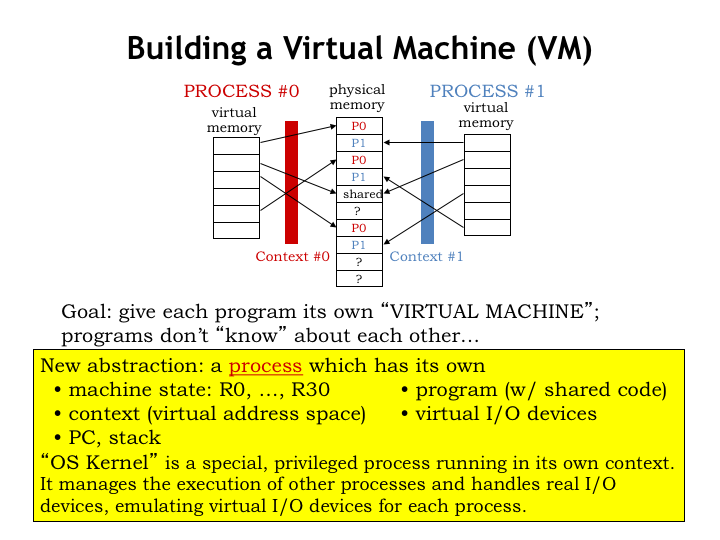
Building a Virtual Machine VM

抽象 process(进程)= 正在运行的程序及其资源(CPU、MMU、I/O 等)。进程状态包括:

  • CPU 硬件状态:寄存器与 PC
  • 虚地址空间内容:代码、数据、栈、堆对象(可在主存或辅存)
  • MMU 状态:context-number、page-directory,以及分层页表占用的页
  • I/O 相关:文件读写位置、网络缓冲、键盘/鼠标事件等

特权进程 OS 跑在 kernel context,记账并周期调度各进程,提供文件、网络、窗口等服务。换用户进程须保存/恢复完整状态(主存中已有部分、内核数据结构、CPU/MMU 硬件)。目标:让每进程以为独占一台独立 虚拟机,高效共享一台物理机。

5. 每进程一台 VM(One VM For Each Process)

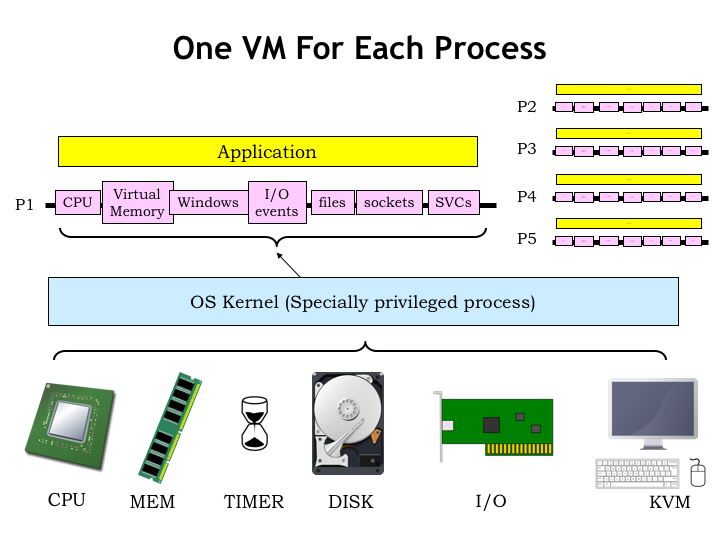
One VM For Each Process

底层是物理机:CPU + 主存,外加外设(timer、辅存、USB、网络、显示器/键鼠等)。OS 在特权 kernel context 管理外设与 MMU,为每进程造出虚拟机。

用户代码直接在物理 CPU 上跑,但可被 timer 打断,使 OS 保存当前进程、切换下一进程。经 MMU,每进程有隔离的虚地址空间。OS 提供的虚拟外设屏蔽共享细节(窗口像素、键盘焦点归属哪个进程等):进程看到的是 I/O 事件流,而非直接操纵设备。

6. 进程:多路复用 CPU(Processes: Multiplexing the CPU)

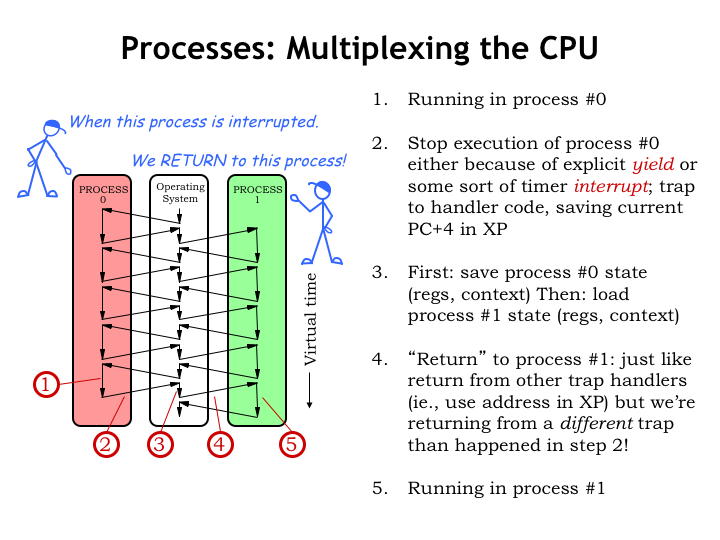
Processes Multiplexing the CPU

从进程 #0 切到 #1:用户态执行被 yield 或更常见的 timer interrupt 打断 → 进内核(PC+4 存入 XP)。OS 把 #0 状态写入内核表,再装入先前保存的 #1 状态,JMP 回到用户态——#1 从上次被打断处继续。轮转各进程。

对进程而言,虚拟时间只是指令序列;若不看实时钟,感觉不到偶尔被挂起。从外部看,真实时间在进程间与 OS 切换间穿梭。CPU 时间多路复用称 timesharing。

7. 关键技术:定时器中断(Key Technology: Timer Interrupts)

Key Technology Timer Interrupts

外设断言 Beta 的 IRQ。若在 user mode(PC 中 supervisor 位为 0),识别中断的那拍:强制部分控制信号——PCSEL=4 选内核入口(timer 为 0x80000008,同时 PC[31]=1 进入 kernel);WASEL/WDSEL/WERF 把 PC+4 写入 XP(R30);MWR=0 以正确中止可能正在进行的 ST。下一拍从中断处理程序第一条指令开始。

8. Beta 中断处理(Beta Interrupt Handling)

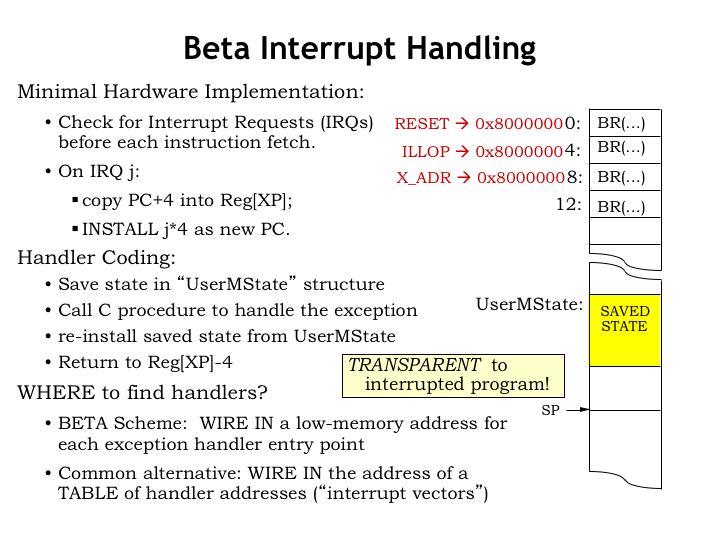
Beta Interrupt Handling

硬件极简:存 PC+4 到 XP,并把 PC 设为依中断类型而定的入口。其余由软件完成:把 R0–R30 存入内核结构 UserMState,再调 C 处理函数;返回后从 UserMState 恢复,XP 减 4 指向被打断指令,JMP(XP) 回用户态。

简单 Beta 把各类中断入口放在连续字(reset→0,非法指令→4,timer→8…),第一条常是跳到真正处理代码;PC[31]=1。也可在已知地址放向量表,由硬件取入口——功能等价。因保存/恢复完整状态,中断对用户程序透明。

9. 例:定时器中断处理(Example: Timer Interrupt Handler)

Example Timer Interrupt Handler

先用 timer 更新 OS 中的 TOD(time of day),设每 1/60 秒中断一次。用户程序无需特殊处理;周期进入内核时钟处理再恢复,宛如未发生。若需 TOD,向 OS 发服务请求。汇编桩负责保存/恢复状态,中间调 C 过程。

10. 中断处理代码(Interrupt Handler Coding)

Interrupt Handler Coding

C 侧声明 TOD、UserMState 与递增 TOD 的过程。地址 8 的 BR 转到 CLOCK_H:保存寄存器(R31 恒 0 可不存)、建内核栈、调 C;返回后恢复寄存器,XP-=4,JMP(XP)。

与分时的联系:在 timer handler 里每隔若干次(如 QUANTUM)调用 Scheduler()——分时魔法发生处。

11. 简单分时调度(Simple Timesharing Scheduler)

Simple Timesharing Scheduler

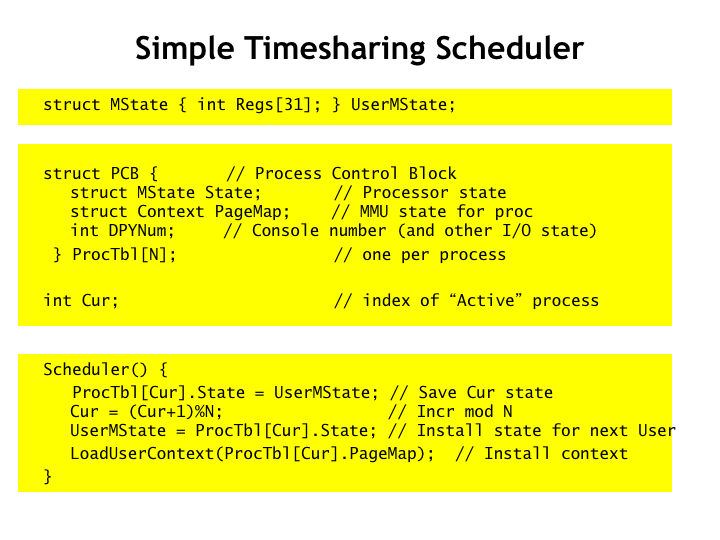
UserMState 暂存中断期间的用户寄存器;PCB(process control block)数组为每进程长期保存完整状态:寄存器副本、MMU 状态、I/O(如虚拟控制台编号)等。CUR 指向当前进程。

Scheduler():把暂存状态写入当前 PCB → CUR 轮转到下一进程(到尾回 0)→ 从新 PCB 装入暂存区并配置 MMU → 返回后 clock handler 把更新后的状态装回 CPU 并恢复执行。于是换到新进程。

12. OS 组织:进程(OS Organization: Processes)

OS Organization Processes

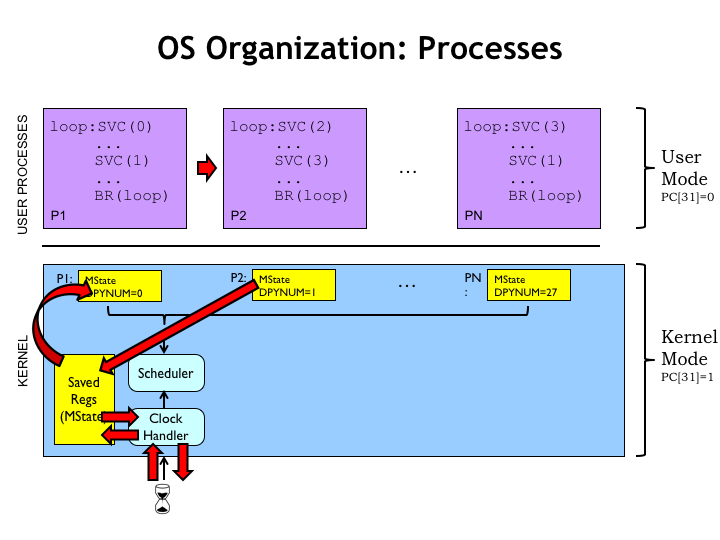
再走一遍:timer 打断用户程序 → 进 clock handler → 寄存器进 UserMState →(若调用)Scheduler 写入当前 PCB、装入下一进程暂存 → handler 装回 CPU → 从新进程继续。

13. 一次一个中断(One Interrupt at a Time)

One Interrupt at a Time

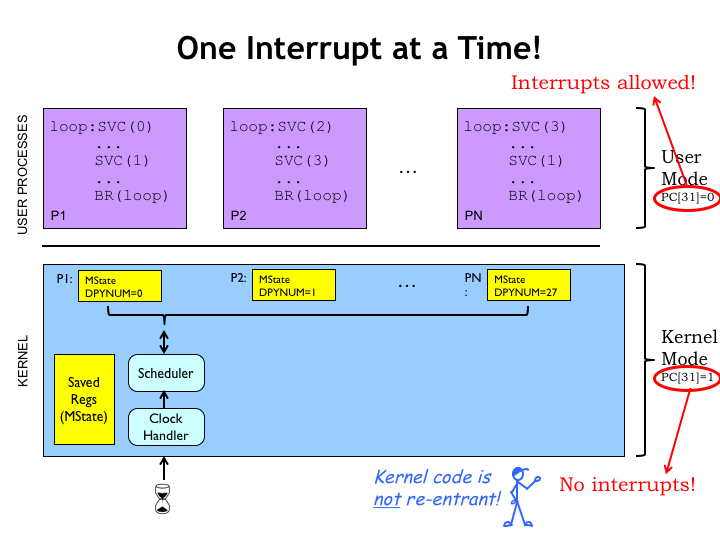
内核 supervisor 位为 1 时关中断,避免嵌套中断覆盖 UserMState。因此 OS 代码须极度小心:死循环无法被打断,机器像“冻住”,只能断电重启。用户态允许中断,失控程序仍可被键盘等打断;OS 常有热键挂起当前进程并可选保存现场供调试。

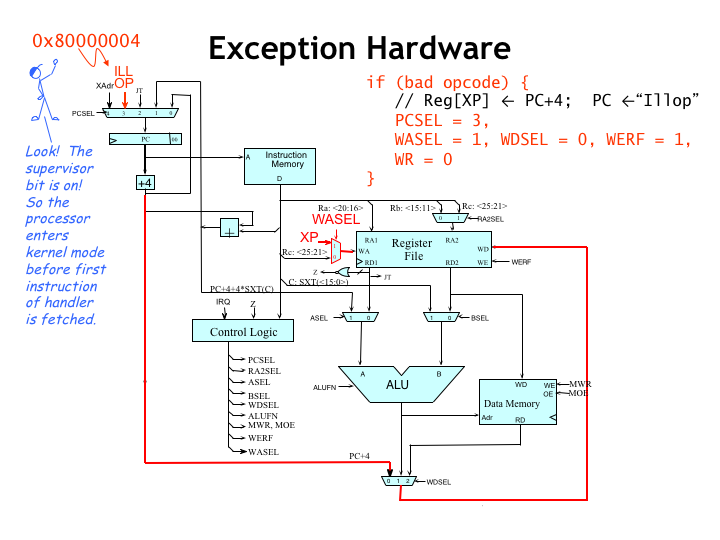
14. 异常硬件(Exception Hardware)

Exception Hardware

OS 还处理“非法”操作码(硬件未直接实现的操作,也称 UUO)。行为类似中断,但是 CPU 自身触发:挂起当前指令,把 PC+4 写入 XP,PC←0x80000004(含 supervisor 位),进入内核处理。可用软件仿真扩展指令集。

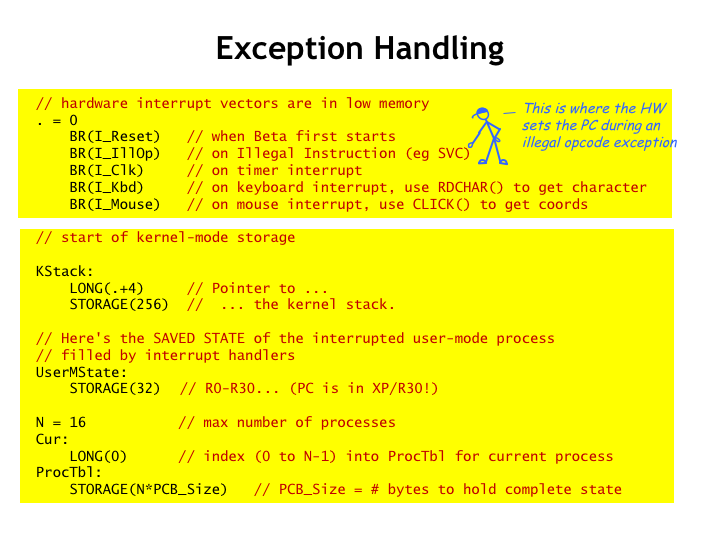
15. 异常处理(Exception Handling)

Exception Handling

类似实验用 TinyOS:地址 0 起是各类中断/异常的分支;非法指令走位置 4 的 BR(I_IllOp)。其后分配 OS 栈、UserMState、进程表等数据结构。

16. 实用宏(Useful Macros)

Useful Macros

汇编里用宏展开重复序列。例:从 32 位数提取比特域 [N..M][N..M](bit 31 为 MSB)。另有宏把 CPU 寄存器批量保存到 / 从 UserMState 恢复。

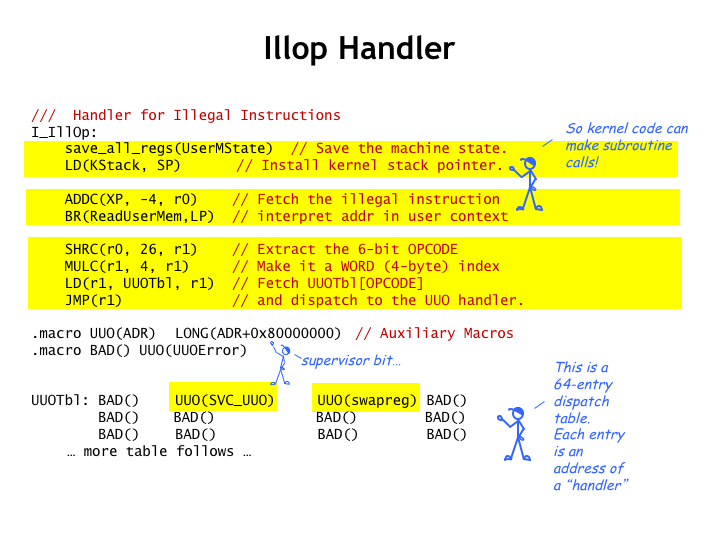
17. IllOp 处理(Illop Handler)

Illop Handler

标准开头:保存用户寄存器、初始化 OS 栈。取出非法指令——保存的 PC+4 是用户虚地址,须经 MMU 例程换成物理地址再读。用 opcode 索引 dispatch table(64 项)跳到对应处理:多数进 UUOError;opcode 1 作 supervisor call;opcode 2 仿真 SWAPREG。表驱动分派通常比长串比较更省时省空间。

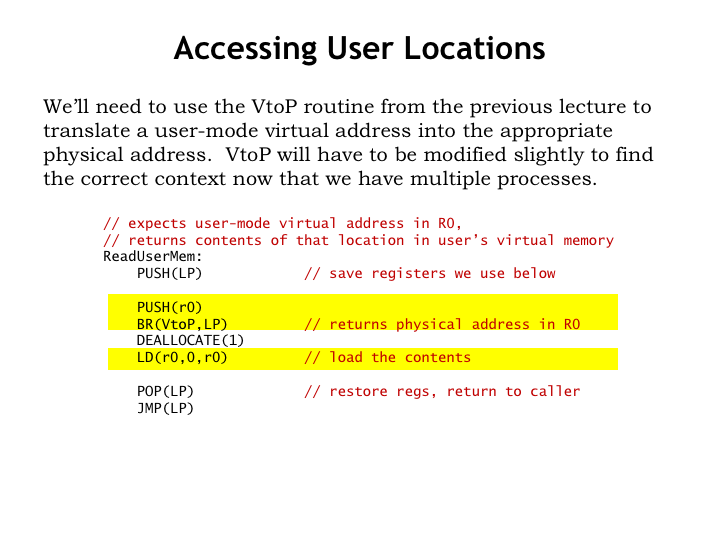
18. 访问用户地址(Accessing User Locations)

Accessing User Locations

基于上讲 VtoP:把 VPN 与偏移按约定压栈,返回物理地址于 R0,再以物理地址读主存中的用户位置。

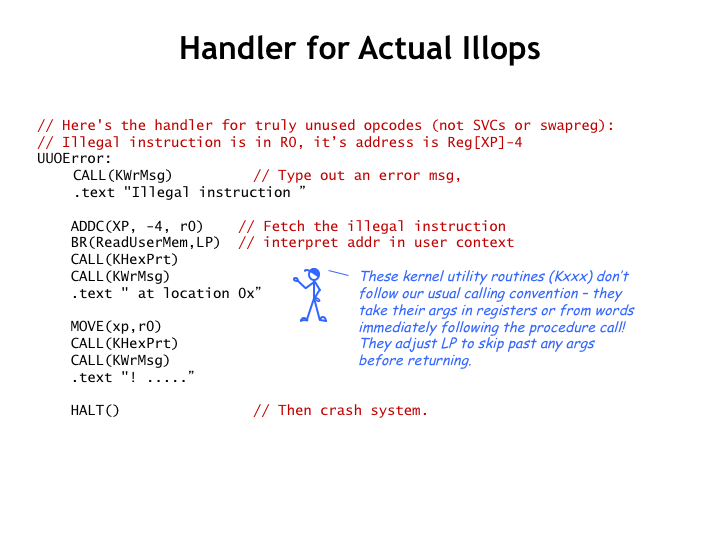
19. 真正非法操作码(Handler for Actual Illops)

Handler for Actual Illops

对真正非法的 opcode:打印错误信息并崩溃(如 Windows “蓝屏”)。更好做法:把进程状态写入调试文件(历史称 core dump),终止该进程并提示用户,稍后再用调试器查 dump——而非拖垮整机。

20. 仿真指令:swapreg(Emulated Instruction: swapreg(Ra,Rc))

Emulated Instruction swapreg

SWAPREG 交换两寄存器。先让汇编器把 swapreg(ra,rc) 编成类似 ADDC 的二进制(literal=0,opcode=2)。仿真:从指令取出 RA/RC,换成 UserMState 数组字节偏移,交换暂存中的用户寄存器值;返回时装回 CPU,程序仿佛硬件执行了该指令。

21. 与 OS 通信(Communicating with the OS)

Communicating with the OS

用户与 OS 不同 MMU context,不能直接碰 OS 代码/数据(也不应绕过安全策略)。需要在明确入口调用 OS,经寄存器或用户虚存传参——即 supervisor call / SVC,构成受控 API(如 POSIX)。

约定:opcode=1 的非法指令作 SVC,低位字段索引具体服务。

22. OS 组织:SVC(OS Organization: Supervisor Calls)

OS Organization Supervisor Calls

用户程序执行不同索引的 SVC → 硬件当非法指令进 IllOp → 保存状态 → 按 opcode 分派;SVC 子处理可读用户寄存器或用户虚地址,返回值可写回暂存(如覆盖保存的 R0)→ 恢复寄存器,从 SVC 下一条继续。

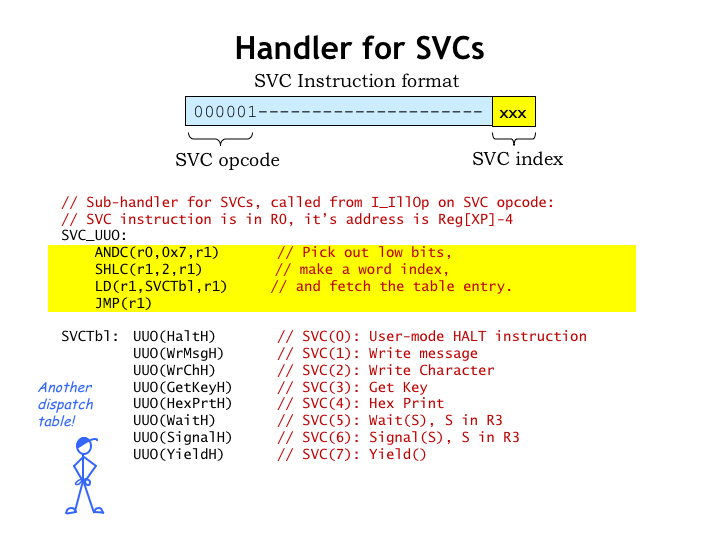
23. SVC 处理(Handler for SVCs)

Handler for SVCs

opcode=1 的子处理再用指令低位索引第二张 dispatch 表(TinyOS 仅少数简单服务)。真实 OS 会有文件、网络、虚存、创建进程等大量 SVC。

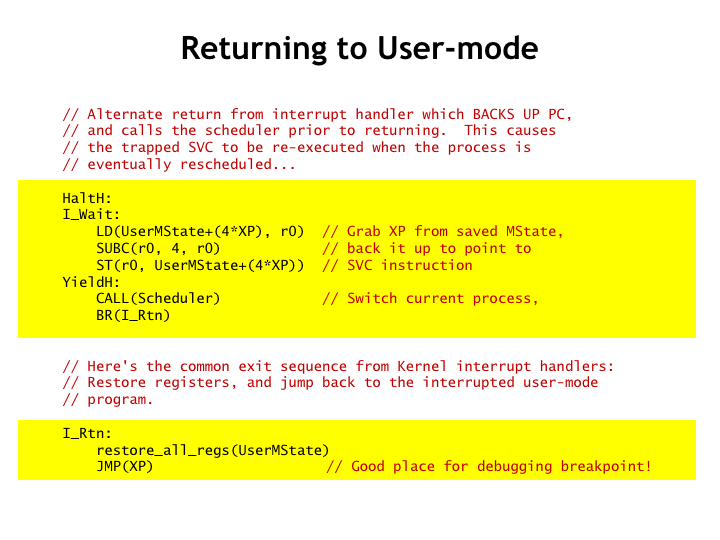
24. 返回用户态(Returning to User-mode)

Returning to User-mode

完成则恢复寄存器并对 XP 指向的下一条 JMP。若暂时无法完成(如 ReadCh 尚无字符)→ 转 I_Wait:安排下次再执行该 SVC,并 Scheduler() 让其他进程跑。

同套代码也实现:Yield() 主动放弃本时间片;Halt() 名不副实——每次被调度到都重做 Halt SVC 再调度别人,后续指令永不执行,表现为停机。

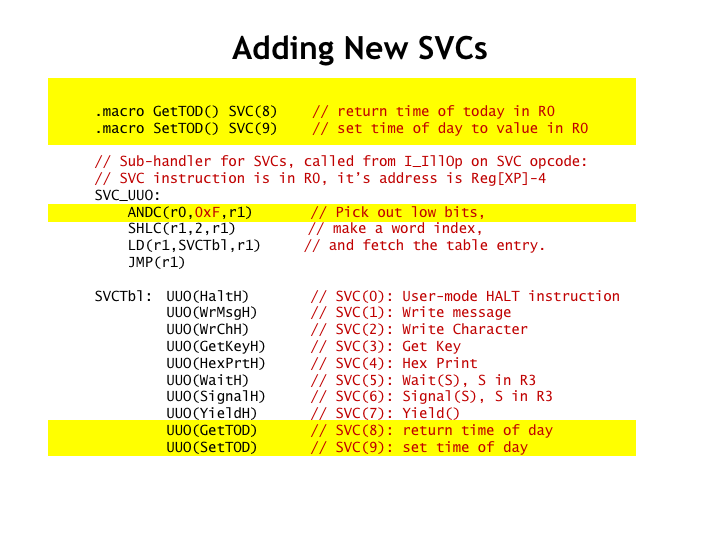
25. 添加新 SVC(Adding New SVCs)

Adding New SVCs

步骤:为用户程序定义新 SVC 宏(如 get/set TOD);微调 SVC 分派范围;在 dispatch 表末尾加项。

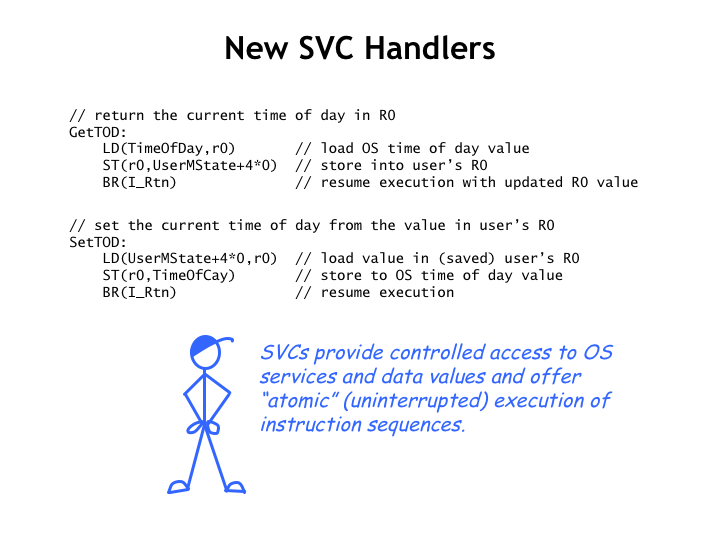
26. 新 SVC 处理程序(New SVC Handlers)

New SVC Handlers

处理程序经 UserMState 读写用户 R0 等,几条指令即可完成。SVC 提供受控的 OS 服务入口;且在 supervisor 模式关中断,处理程序不可被打断——若需 LD/ADDC/ST 原子递增主存变量,可封装为 SVC。本讲为简单分时 OS 打下基础;下讲继续看 OS 如何与外部 I/O 设备交互。

整理自 MIT OCW 6.004 Computation Structures(Spring 2017)L16 注解幻灯片。

源网页:16.1 Annotated Slides | Virtual Memory

讲师:Chris Terman。图片直接引用 OCW 原站链接。

L16:虚拟内存(Virtual Memory)

本讲把存储层次从 cache/主存延伸到辅存(secondary storage):用 MMU 做虚实地址翻译、按页(page)管理主存、用 page fault 按需装入,并用 TLB 加速页表访问;同时引入多程序 context 与保护的雏形。

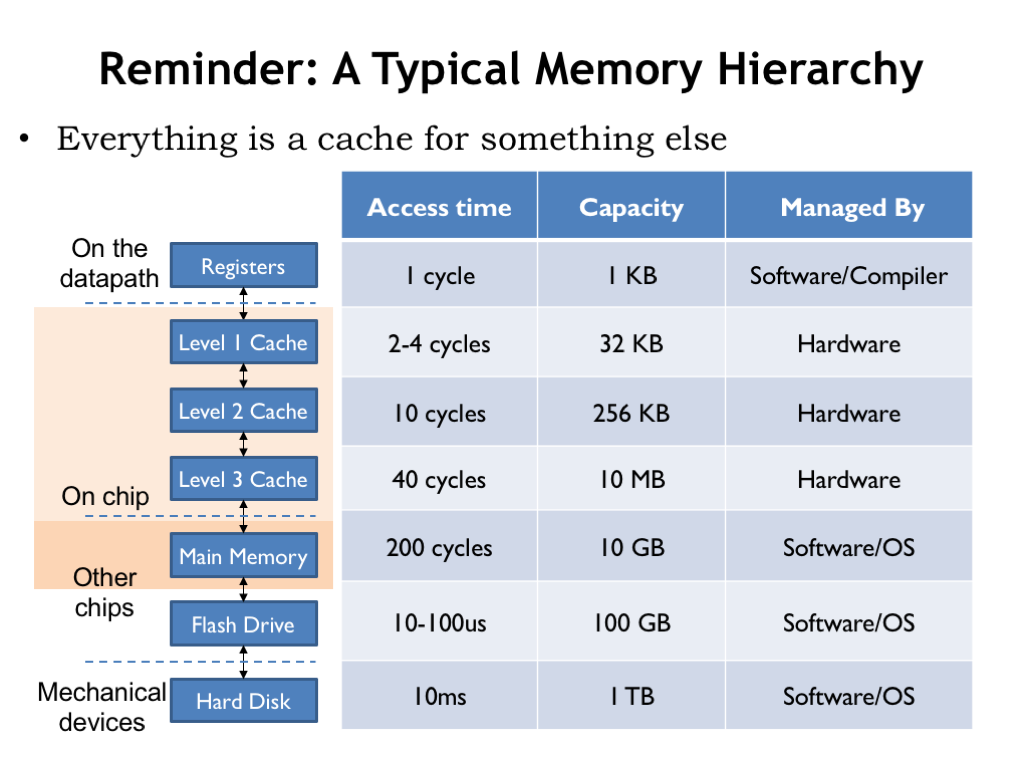
1. 回顾:典型存储层次(Reminder: A Typical Memory Hierarchy)

Reminder A Typical Memory Hierarchy

回到《The Memory Hierarchy》里的基本权衡:容量越大,访问时间往往越长。要同时做到大容量与小平均访问时间,靠夹在 CPU 与主存之间的 cache 体系。现代 CPU 常有多级 cache:一级容量不大、接近 CPU 速度;更高级容量更大、延迟更长。

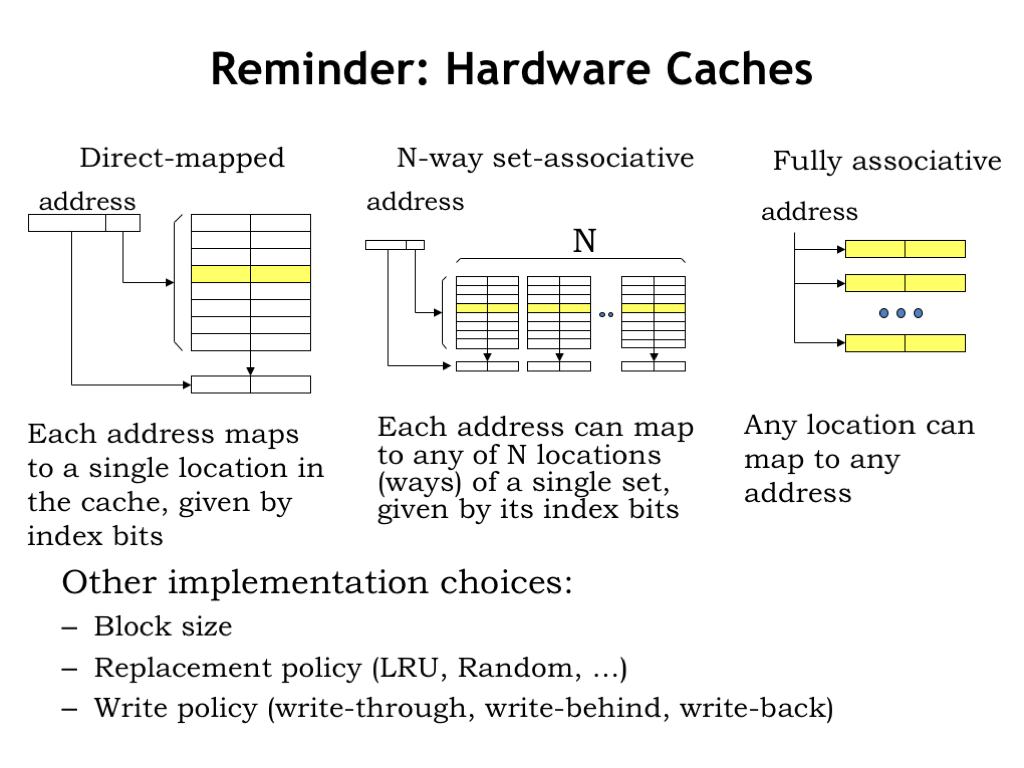
2. 回顾:硬件 Cache(Reminder: Hardware Caches)

Reminder Hardware Caches

Cache 对少量地址提供快速访问,用相联寻址装下 CPU 最近常用的位置;内容由硬件自动管理。有效性依赖局部性:访问 XX 后不久常访问邻近地址。组织上用简单索引选出候选行;引入相联度提高命中率,并讨论块大小、替换策略、写策略。本讲把层次再往下扩,会再次遇到同类设计选择。

3. 回顾:存储层次再往下(Reminder: A Typical Memory Hierarchy)

Reminder A Typical Memory Hierarchy continued

此前未谈主存数据从何而来。Flash / 硬盘等辅存容量更大且非易失:关机仍保留数据。开机时数据都在辅存;需要时再搬到主存(primary storage)。可把主存看成辅存之上的又一级 cache,并构建虚拟内存:按需自动从辅存装入主存,并控制程序可访问哪些数据——这是安全多道程序的垫脚石。

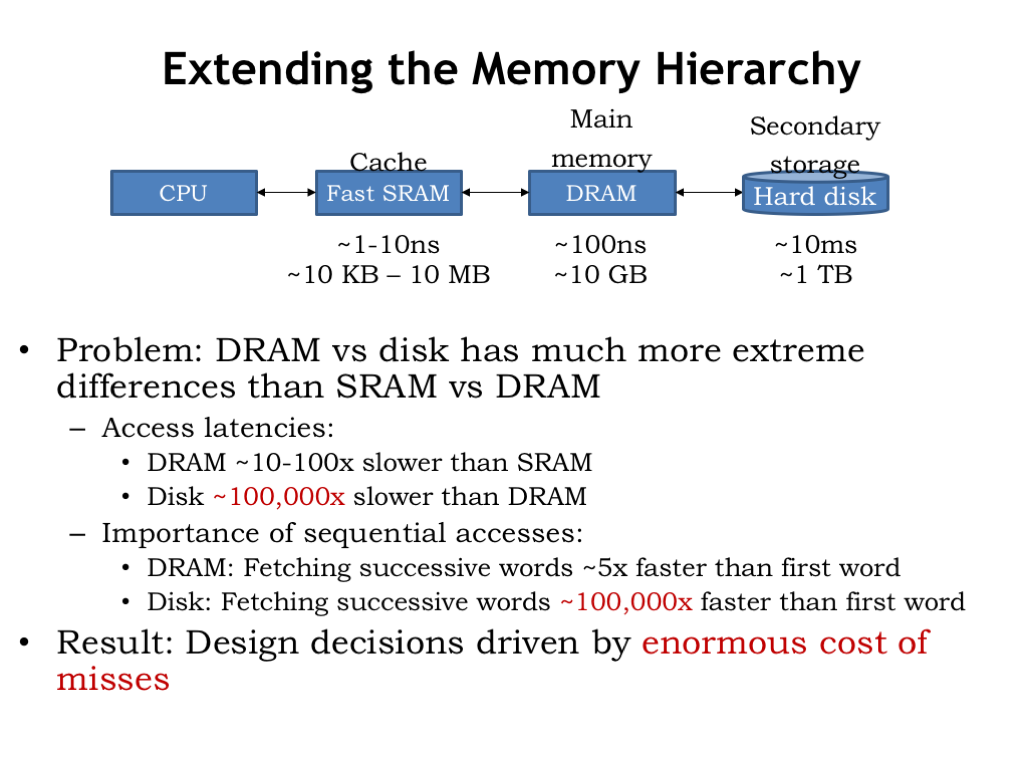
4. 扩展存储层次(Extending the Memory Hierarchy (continued))

Extending the Memory Hierarchy continued

在 L14 的 cache + 主存之上加上辅存。好处:容量极大(台式机 TB 级,云可达 PB,1 PB=10151\,\mathrm{PB}=10^{15} 字节)。坏处:磁盘访问可比 DRAM 慢约 10510^5 倍——从 DRAM 到盘的跳变远大于 cache 到 DRAM。盘上连续块的边际代价更低,因此一次读较大块。主存 miss 的代价极高,虚拟内存必须把主存 miss 率压得极低(相对指令执行率)。

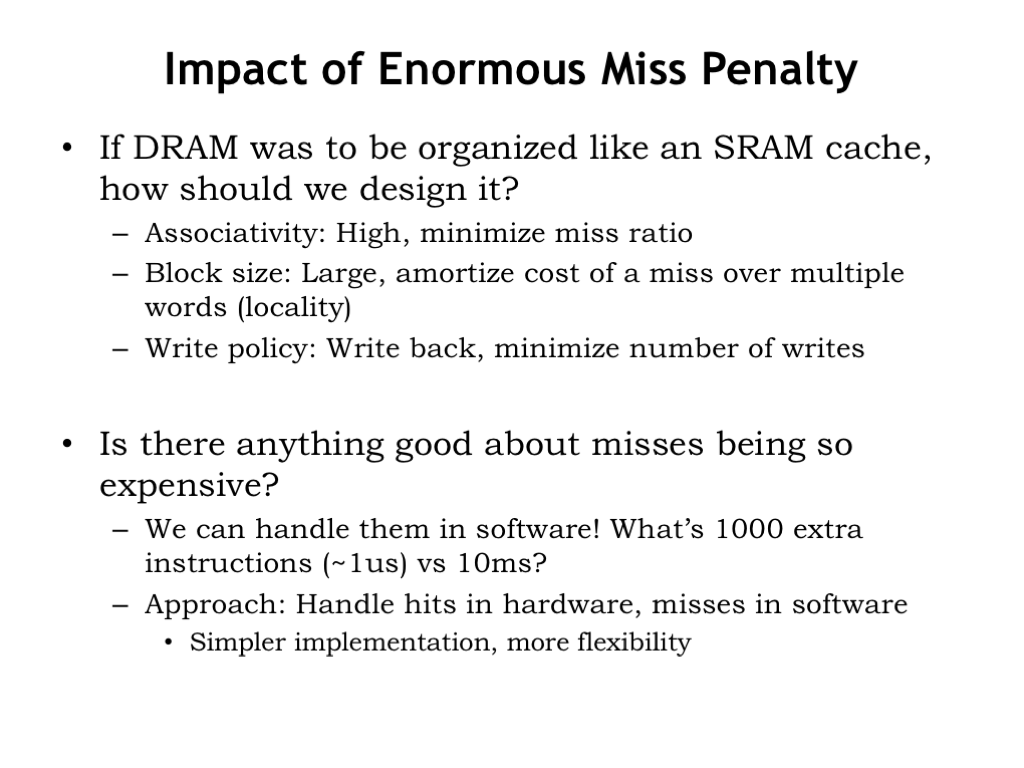
5. 巨大 Miss 惩罚的含义(Impact of Enormous Miss Penalty)

Impact of Enormous Miss Penalty

因此对“主存作辅存的 cache”要求:

  • 高相联度:工作集能放进主存时,应尽量避免无谓冲突
  • 大块(页):摊薄盘访问固定开销,并利用局部性
  • write-back:仅在脏页被替换时才写回辅存

miss 延迟极长带来一个好处:可用软件管理主存组织与盘 I/O——即便处理 miss 要执行数千条指令,仍远快于盘访问。策略:命中用硬件,miss 用软件 → MMU 硬件可较简单,miss 处理可很聪明。

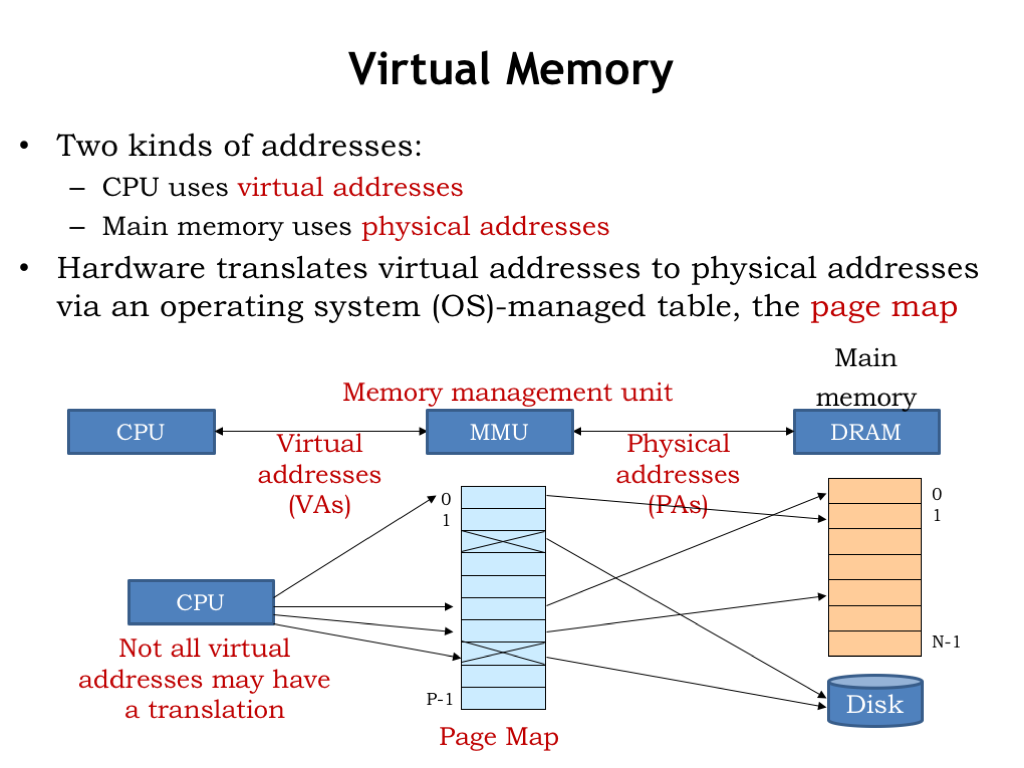
6. 虚拟内存(Virtual Memory)

Virtual Memory

CPU 产生的地址称虚地址(virtual address),主存用物理地址。中间插入 MMU(memory management unit),用页表 / page map 把虚地址翻译成物理地址(本讲暂忽略 cache,末尾再谈二者并存)。

页表允许某虚地址映射到主存任意处;正常时两虚地址不宜映到同一物理地址;允许某些虚地址无翻译——表示尚未装入主存,MMU 发存储管理异常,由 CPU 分配物理页并从辅存装入。

页表还带来控制力:换程序时换页表即可分时;一程序可见的物理页可对另一程序不可见;可用异常做按需装入,只需保证工作集在主存。

7. 实现:分页(Virtual Memory Implementation: Paging)

Virtual Memory Implementation Paging

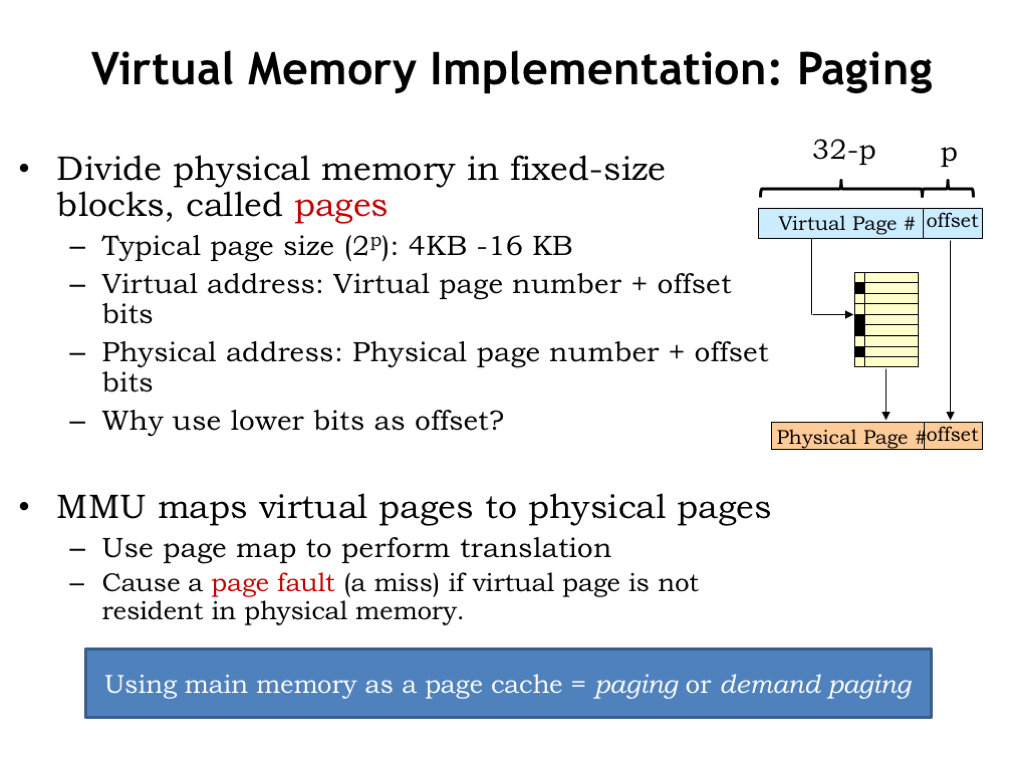
逐地址映射表过大,故把虚、实地址空间都切成固定大小的页,大小 2p2^p 字节。低 pp 位为页内偏移(page offset),其余为页号。典型 p=12∼14p=12\sim 14(4KB~16KB)。

例:32 位虚地址、p=12p=12 → 高 20 位 VPN(virtual page number),低 12 位偏移。物理地址同理拆成 PPN + 偏移。MMU 按页管理:整页从辅存搬入主存。偏移取自低位,使邻近数据多在同一页。

翻译:用 VPN 索引页表;表项指示是否在主存,若在则给出 PPN,再与偏移拼成物理地址。若不在 → page fault,由 OS 装页并更新映射。主存作页 cache 的方案称 paging / demand paging。

8. 按需分页(Demand Paging)

Demand Paging

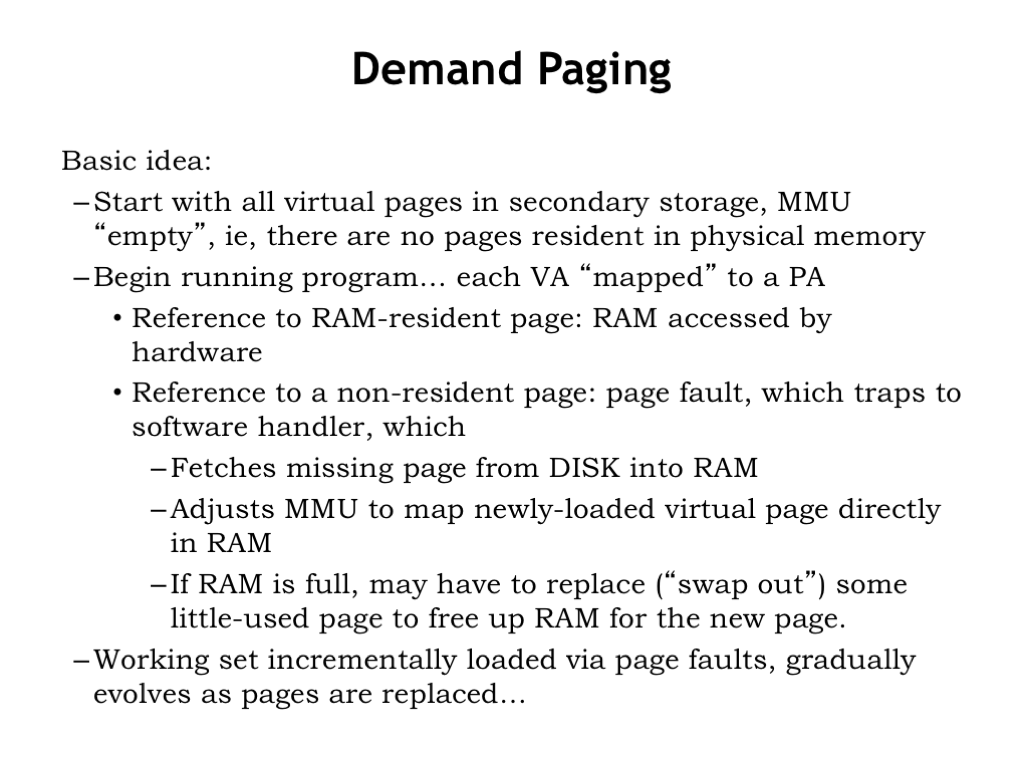
初始:程序各虚页在辅存,MMU 无驻留映射。CPU 每次访存经 MMU;命中则主存完成访问;不命中 → page fault → page fault handler:分配物理页、从辅存装入、更新页表。

若无空闲物理页,选一驻留页替换(如近期未用):脏页先写回,再标为不驻留,腾出物理页。工作集经一串 fault 装入后,若程序行为良好,fault 频率可接近零;不断 fault 称 thrashing,因辅存极慢,程序会“爬行”。

9. 简单页表设计(Simple Page Map Design)

Simple Page Map Design

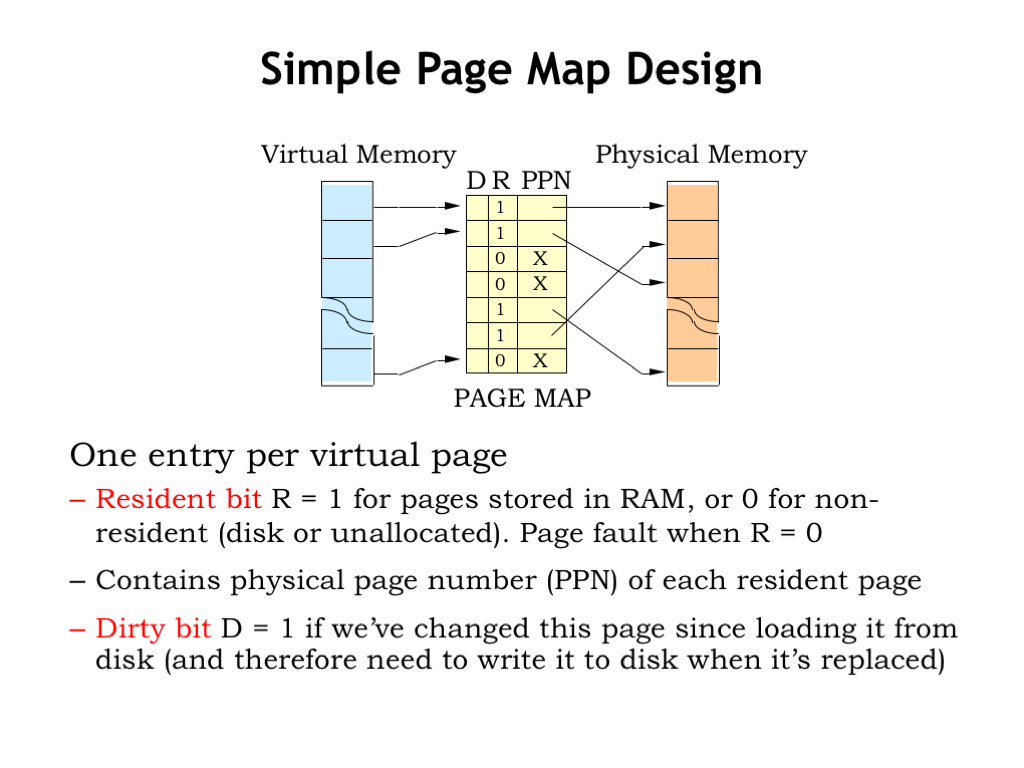
每个虚页一条表项。例:32 位虚地址、2122^{12} 字节页 → VPN 20 位 → 2202^{20} 条表项。

每项至少含:

  • R(resident):1 表示在主存;0 则访问触发 page fault
  • PPN:R=1 时给出物理页号
  • D(dirty):刚从辅存装入时 clean(D=0);CPU 写入后置 D=1;替换脏页须先写回

还可有只读位等:写只读页触发异常,利于保护代码页。

10. 例:虚→实翻译(Example: Virtual → Physical Translation)

Example Virtual to Physical Translation

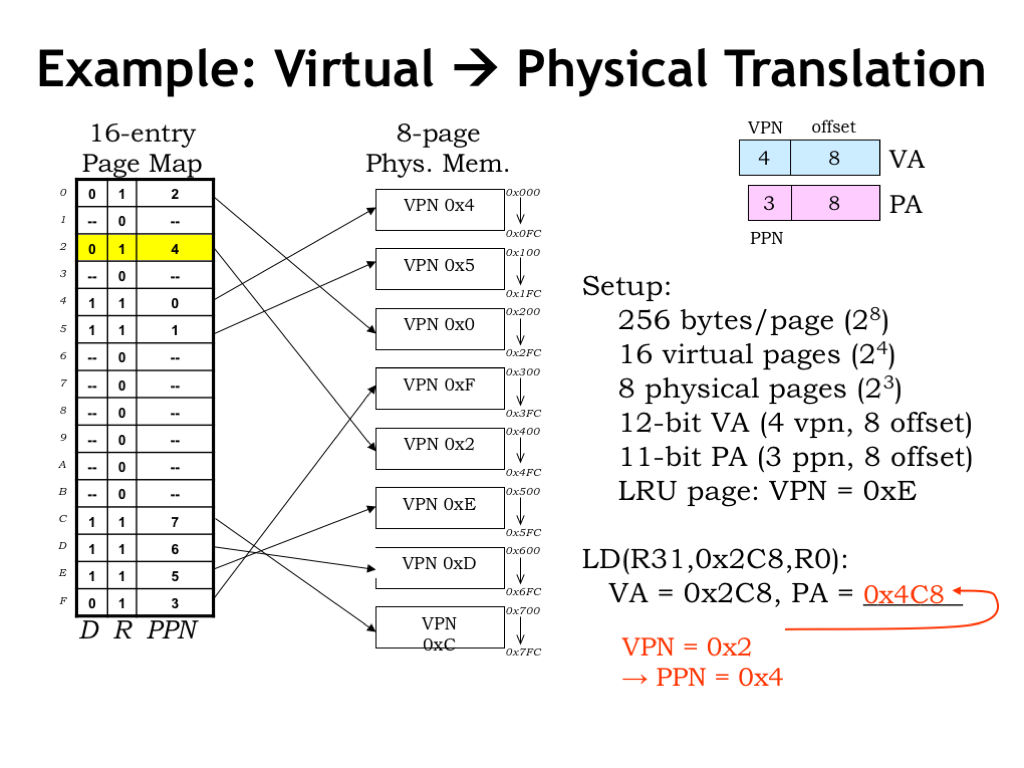
简化例:虚地址 12 位 = 4 位 VPN + 8 位偏移(16 个虚页);物理地址 11 位 = 3 位 PPN + 8 位偏移(8 个物理页)。页表 16 项 ×(D+R+3 位 PPN)= 80 比特。物理页上虚页号可任意打乱——取决于 fault 时哪页空闲。

例:LD 访问虚地址 0x2C8 → VPN=2,偏移=0xC8。表项 2:R=1,PPN=4 → 物理地址 0x4C8。偏移在翻译中不变。

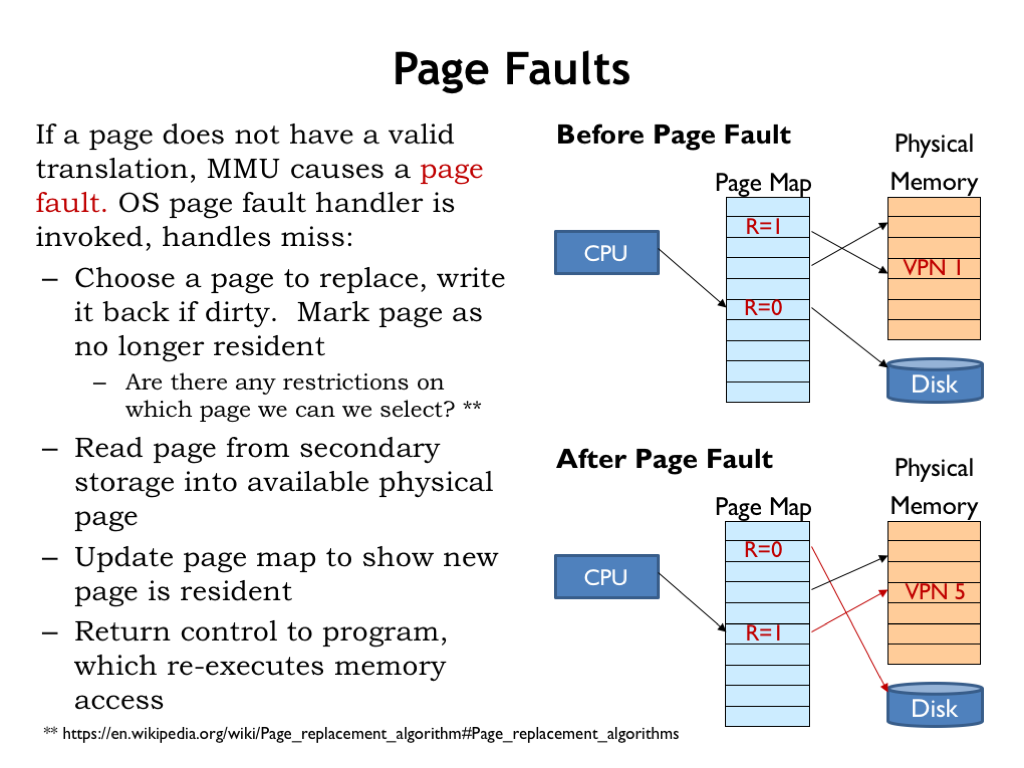
11. Page Fault(Page Faults)

Page Faults

访问 R=0 的虚页 → page fault → 挂起程序,进入 handler。找空闲物理页,或选一在用页腾出:若 D=1 则写回,再把被替虚页标为不驻留。

限制:不能换出 handler 自身所在页(wired);也不宜换出即将继续执行的代码页。理想是换“最远将来才再用”的页,但需未来信息;实践中有多种替换算法(如 aging,近似最优且实现代价适中)。

然后把目标虚页读入选定物理页,更新其 R/PPN,再重执行触发 fault 的指令——此时映射已就绪,访问成功。

12. 例:Page Fault(Example: Page Fault)

Example Page Fault

同一设定下,ST 访问虚地址 0x600(VPN 6)。表项 R=0 → fault。设选 LRU 页 VPN 0xE 替换:其 D=1,故写回 PPN 0x5 内容,再标 0xE 不驻留。从辅存把 VPN 6 装入 PPN 0x5,更新表项。恢复执行并重做 ST:0x600 → 物理 0x500,且因写入将 D 置 1。

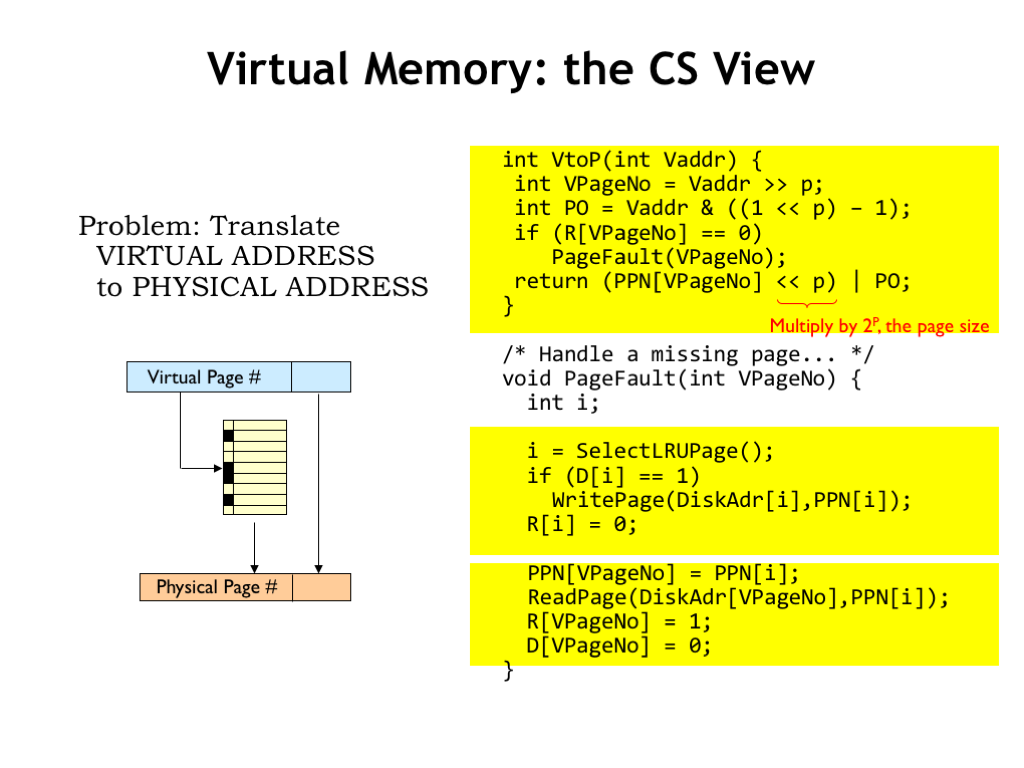
13. CS 视角(Virtual Memory: the CS View)

Virtual Memory the CS View

把 MMU 工作看成两个过程。页表信息可视为数组:R[]、D[]、PPN[]、DiskAdr[]。

  • VtoP:每次访存调用;若虚页不驻留则调 PageFault;再取 PPN,与偏移拼接得物理地址
  • PageFault:选替换页、脏则写回、标不驻留、从辅存读入目标页并更新映射

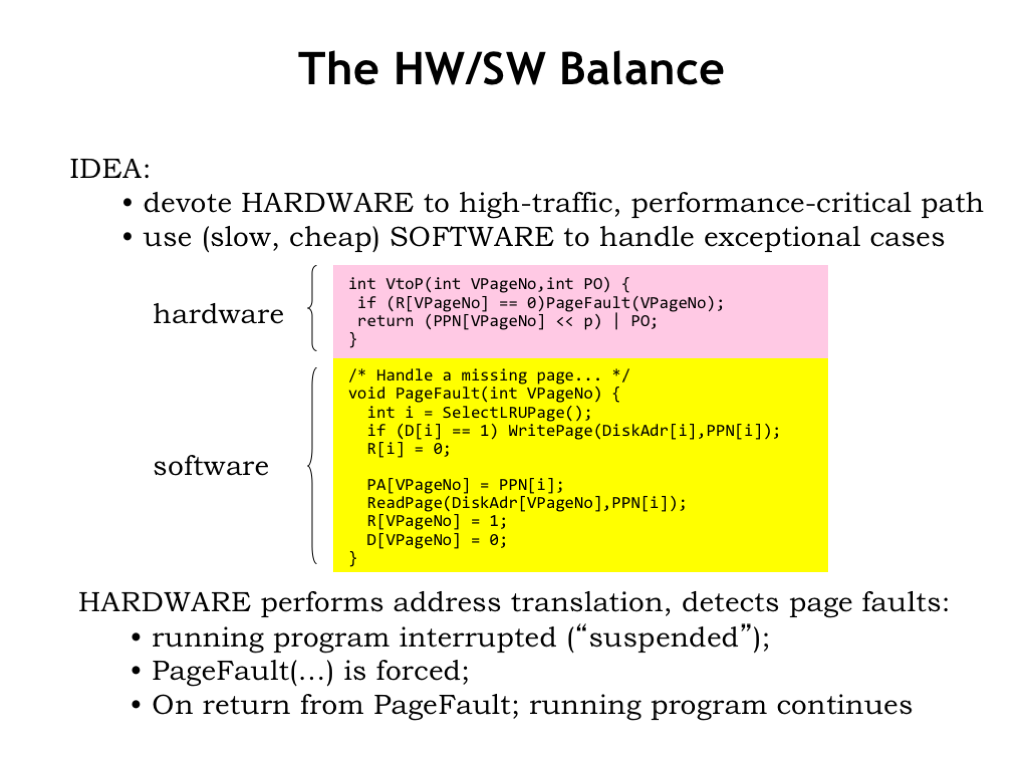
14. 硬件 / 软件分工(The HW/SW Balance)

The HW SW Balance

VtoP 用硬件(每次访存都要);PageFault 用异常进软件。通则:快路径硬件,罕发异常软件。所谓“软件”仍跑在 CPU 上,实质是专用硬件(MMU)与通用硬件(CPU)的权衡——应对“真正常见且性能关键”的操作才上专用硬件。

15. 页表参数算术(Page Map Arithmetic)

Page Map Arithmetic

三个架构参数:pp(页偏移位数)、vv(VPN 位数)、mm(PPN 位数);其余由此导出。页大小常在 4KB~16KB:太大浪费装入无用字,太小摊不薄盘开销。

虚地址宽度由 ISA 定:从 32 位(4GB)迈向 64 位(约 2642^{64} 字节,exa=1018\mathrm{exa}=10^{18})。虚地址过小曾导致许多 ISA 消亡。物理地址宽度可随实现代际调整(嵌入式约 30 位,服务器 40+ 位);程序员用虚地址,由 MMU 屏蔽物理容量差异——功能不变,性能可变。

16. 算术例(Example: Page Map Arithmetic)

Example Page Map Arithmetic

设虚 32 位、物理 30 位、页 4KB:p=12p=12,v=20v=20,m=18m=18。物理页数 2182^{18},虚页数 2202^{20},页表项数约 10610^6。每项约 m+2=20m+2=20 比特 → 页表约 20 Mbit。若用专用大 SRAM 存整表会很贵。

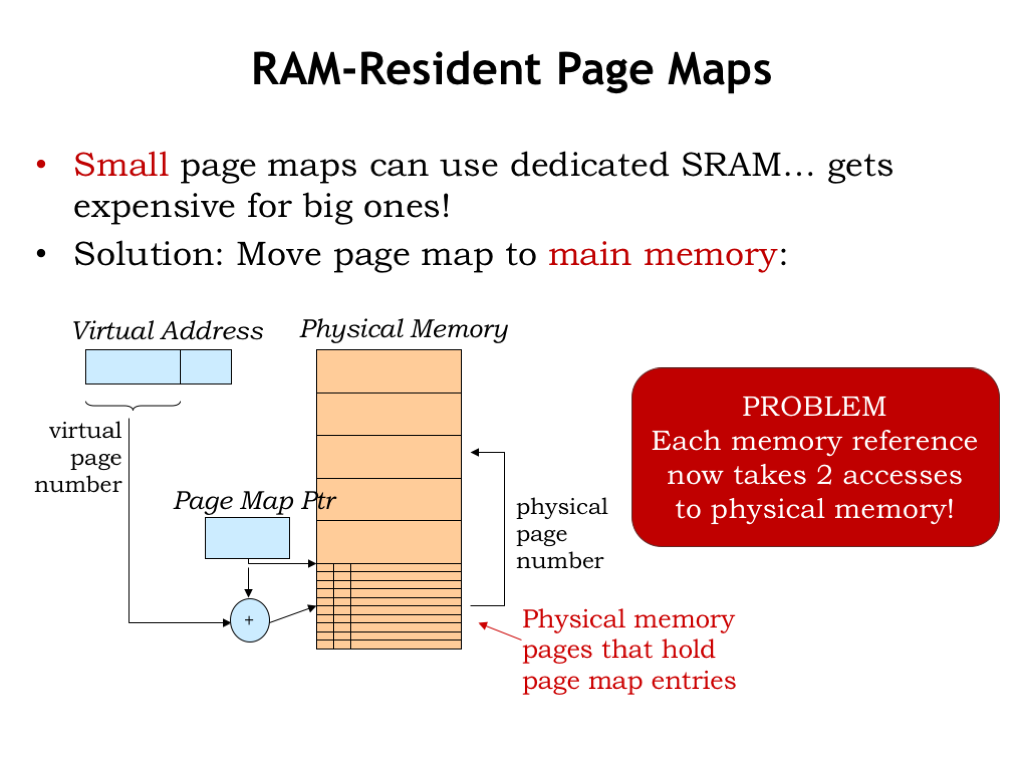
17. 页表放主存(RAM-Resident Page Maps)

RAM-Resident Page Maps

何必专用存储器?用页表指针寄存器指向主存中的页表数组,页表占若干物理页。用 VPN 做数组下标取表项即可。代价:一次虚访问需两次物理访问——先读页表项,再访问目标。

18. TLB(Translation Look-aside Buffer (TLB))

Translation Look-aside Buffer TLB

引入专用小而快的 cache——TLB,缓存 VPN→PPN。常全相联以提高命中、避免冲突。TLB 命中则可省掉读页表,虚访问回到一次物理访问。命中率常 >99%>99\%:短期工作集页数不多。基本策略不变,细节可有多种变体。

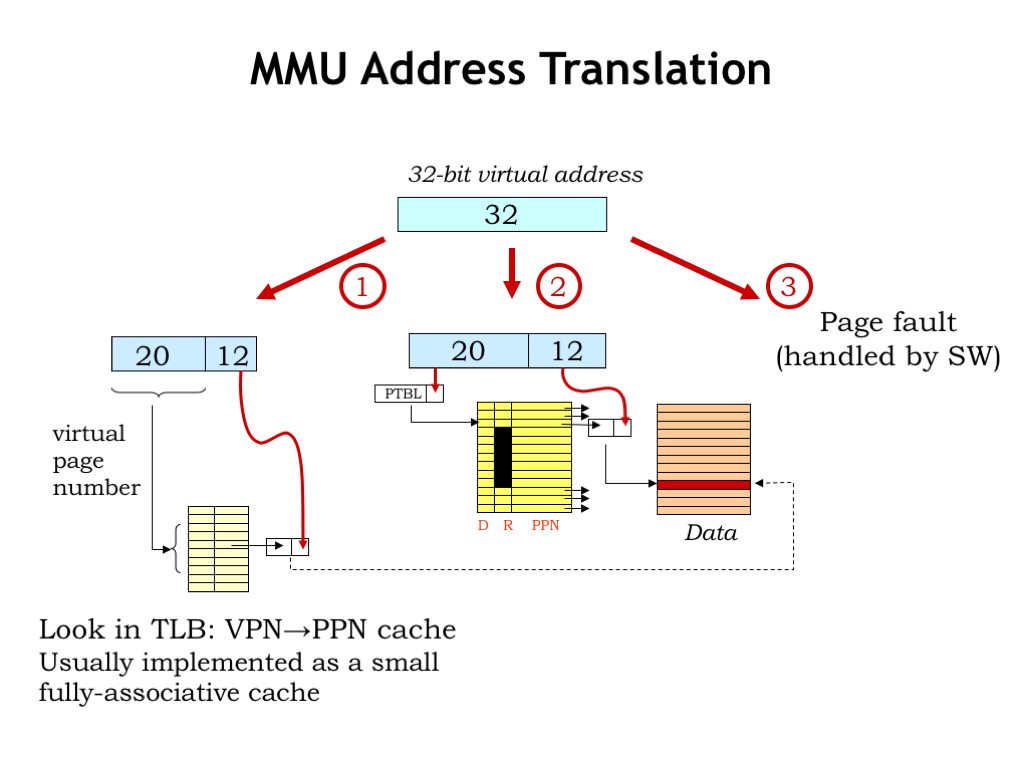
19. MMU 地址翻译流程(MMU Address Translation)

MMU Address Translation

流程:先查 TLB;命中则直接访主存。未命中则读页表:若页驻留,用 PPN 完成翻译并填入 TLB;若不驻留 → page fault,交 handler。

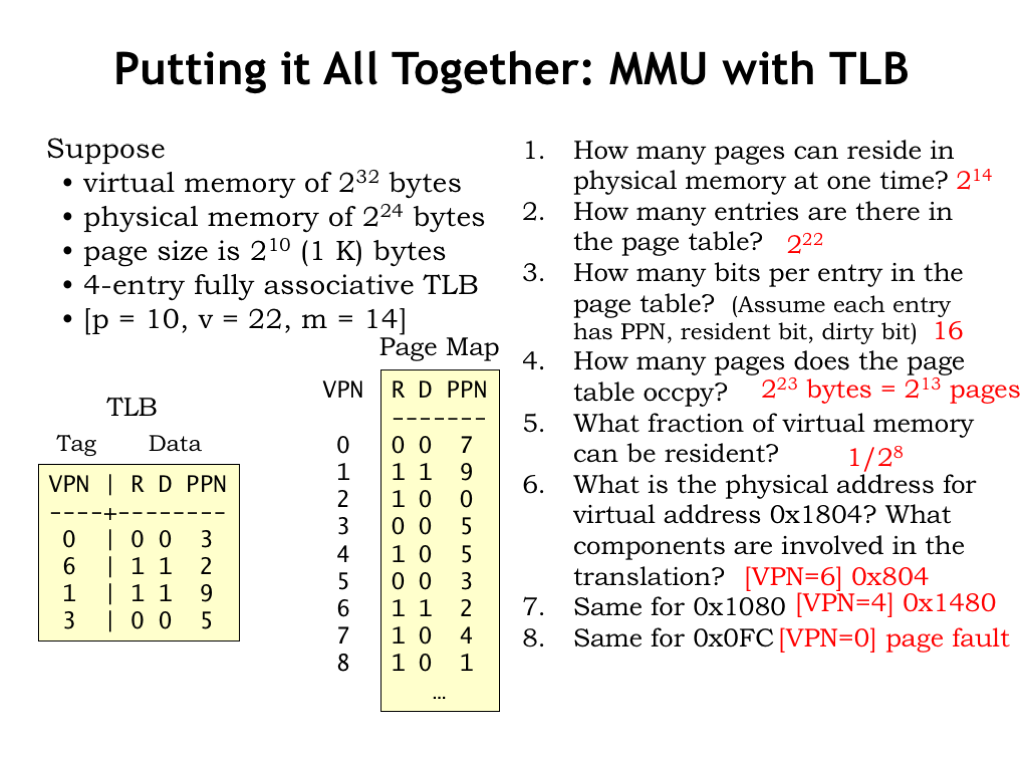
20. 综合例:带 TLB 的 MMU(Putting it All Together: MMU with TLB)

Putting it All Together MMU with TLB

例:p=10p=10,v=22v=22,m=14m=14。

  • 物理页数 2m=2142^{m}=2^{14}
  • 页表项数 2v=2222^{v}=2^{22}
  • 每项 m+2=16m+2=16 比特
  • 页表总字节约 2232^{23},占 2132^{13} 页
  • 同时可驻留比例 2m/2v=1/282^{m}/2^{v}=1/2^{8}

翻译例:虚 0x1804 → 偏移 0x004,VPN 0x6,TLB 命中 PPN 0x2 → 物理 0x804。虚 0x1080:TLB 未命中,页表给出 PPN 5 → 0x1480。虚 0x0FC:TLB/页表均显示不驻留 → page fault。注意:替换虚页时把页表 R 置 0 后,也须使对应 TLB 项失效。

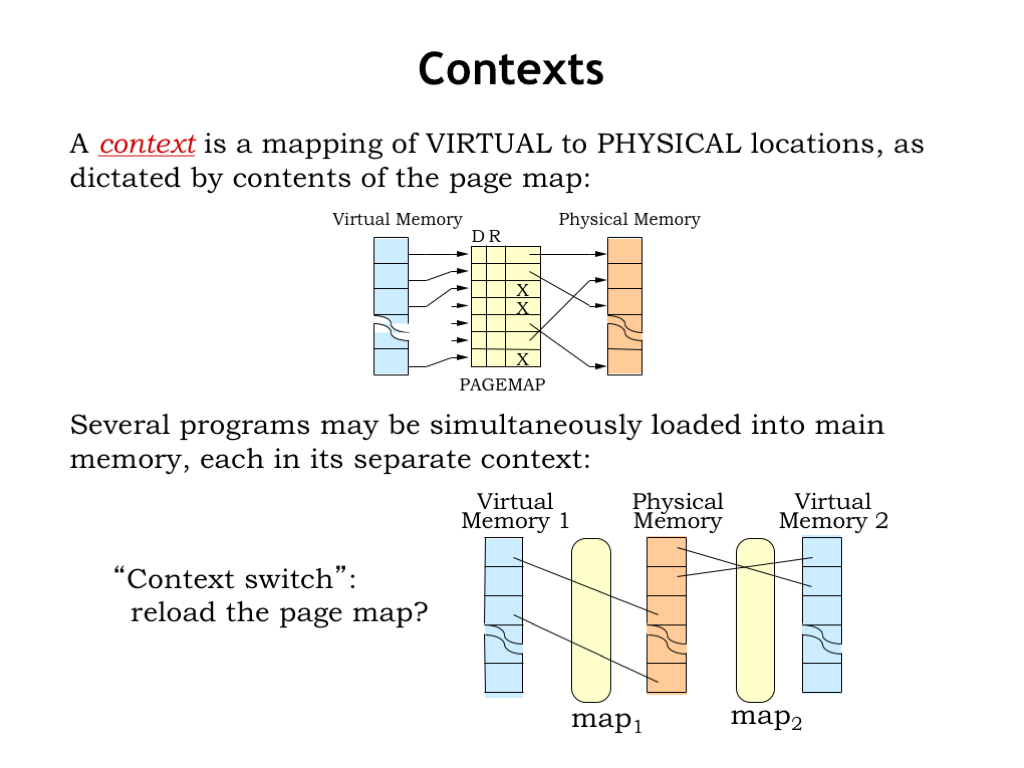
21. Context(Contexts)

Contexts

页表提供解释虚地址的 context:同一虚地址 0 在不同程序映到不同物理位置。多程序可各有独立虚地址空间并共享物理内存。换程序即换 context(重载页表相关状态)。

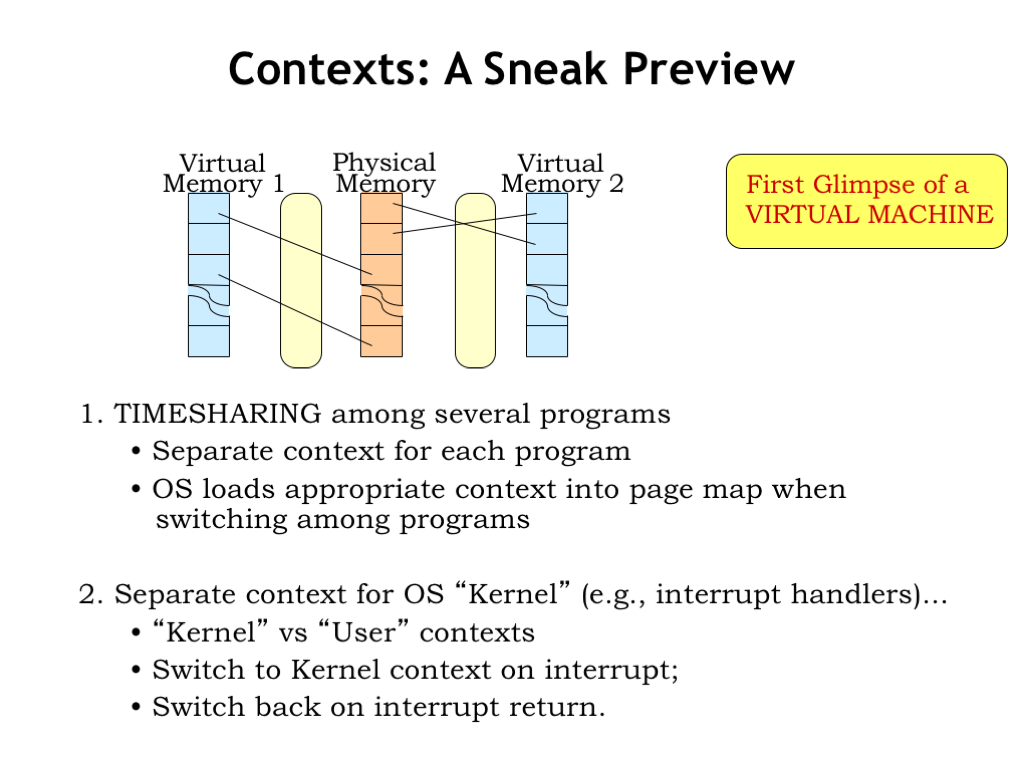
22. Context 预告:分时与 OS(Contexts: A Sneak Preview)

Contexts A Sneak Preview

分时系统周期性地在程序间切换 CPU,造成“各有一台虚拟机”的错觉——切换时同时切换 CPU 状态与 MMU context。特权代码 OS 运行在 kernel context:管理物理内存与异常;用户程序在 user mode。异常进入 kernel mode;处理完再回 user mode。内核可访问 MMU、I/O 等特权寄存器;用户要通过 OS 请求盘等服务。下讲展开。

23. 内存管理与保护(Memory Management & Protection)

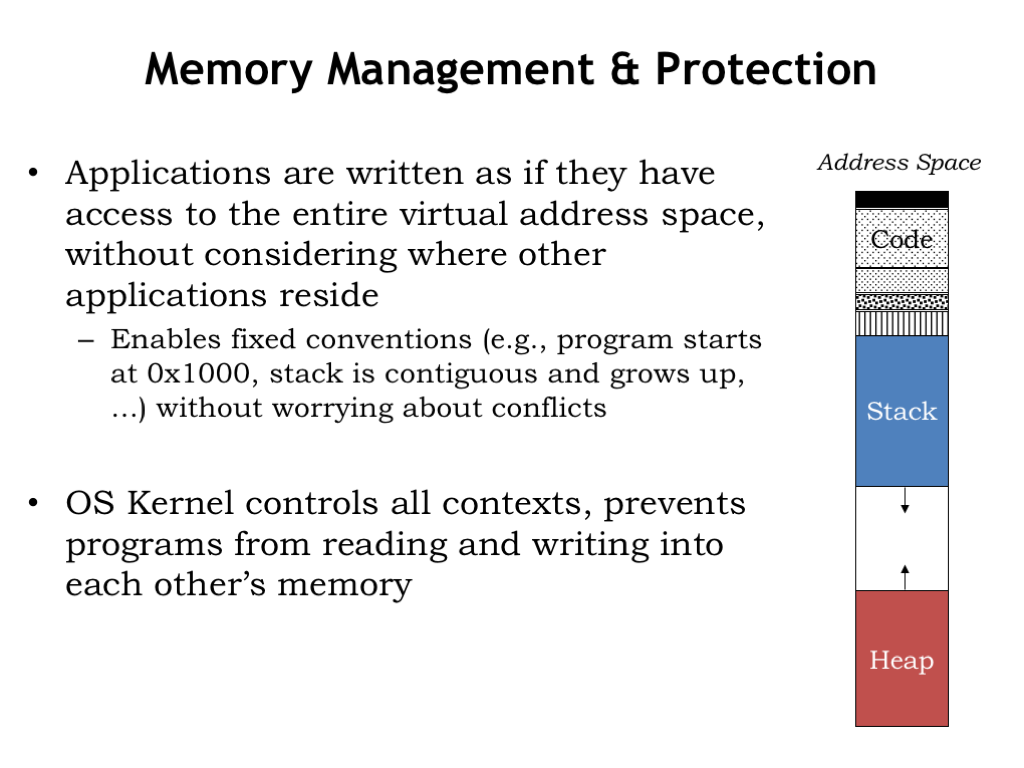
Memory Management and Protection

用户程序仿佛独占整个虚地址空间,常遵守相同约定(入口、栈初值等);OS 靠不同 context 隔离。典型布局:虚页 0 不可访问(抓空指针);接着只读代码(及共享库);再读写静态数据;其余由向高地址增长的栈与向低地址增长的堆对向扩张。区域增长时 fault handler 可分配新页;若中部相遇则虚存耗尽。

24. 多级页表(Multi-level Page Maps)

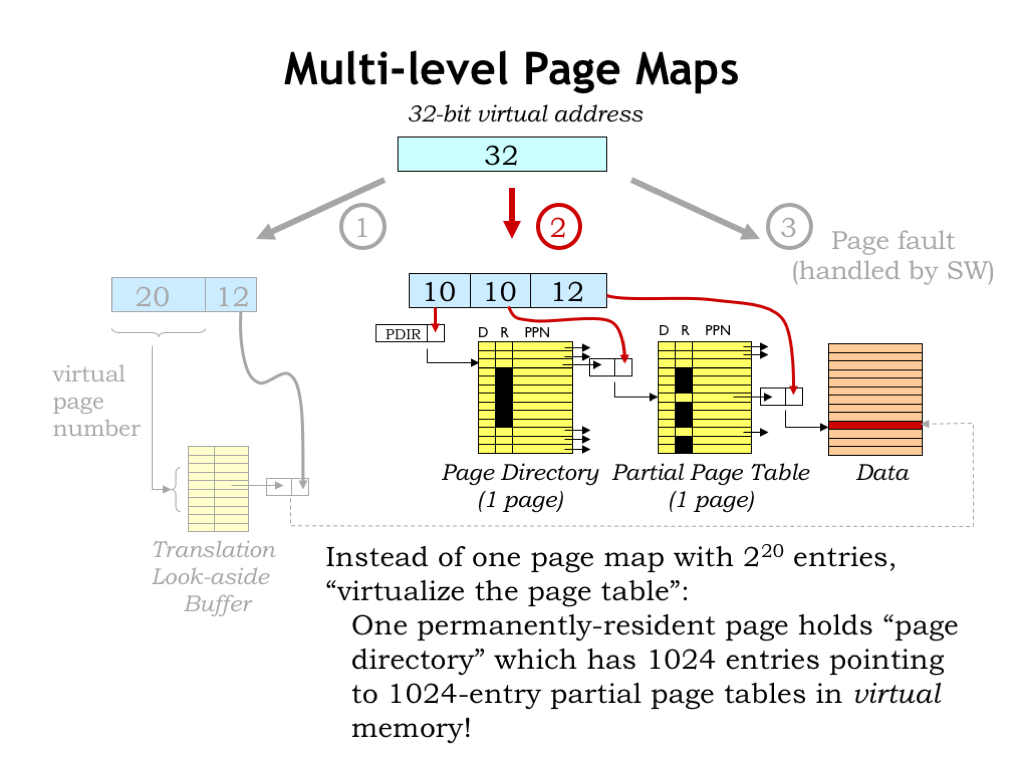
Multi-level Page Maps

扁平页表占大量物理页;多 context 时更糟。分层页表:虚地址高若干位索引 page directory,得到该段页表所在物理页;页表段本身也可在虚存中、不必全部驻留。栈与堆之间未分配区在 directory 中标不驻留,无需为“全不驻留”的海量表项占空间。代价是 walk 多一次访存,但 TLB 使额外开销通常可忽略。

25. 快速 Context 切换(Rapid Context Switching)

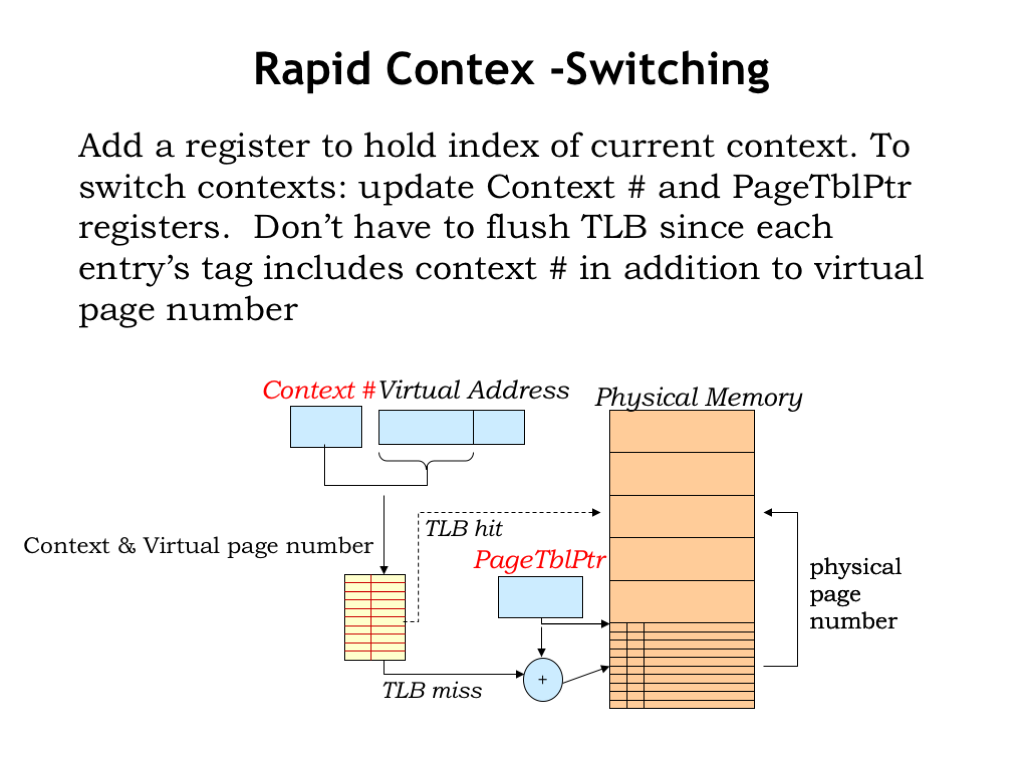
Rapid Context Switching

换 context 时重载页表指针相当于换掉整张表,常需冲刷 TLB,随后命中率骤降。改进:引入 context-number 寄存器,与 VPN 一起作 TLB 查询(tag 含 context)。切换时重载 context-number 与页表指针即可;其他 context 的 TLB 项自然不匹配,无需 flush。TLB 容量够时,多 context 映射可并存,切换对平均访存时间冲击小。

26. Cache 与虚拟内存(Using Caches with Virtual Memory)

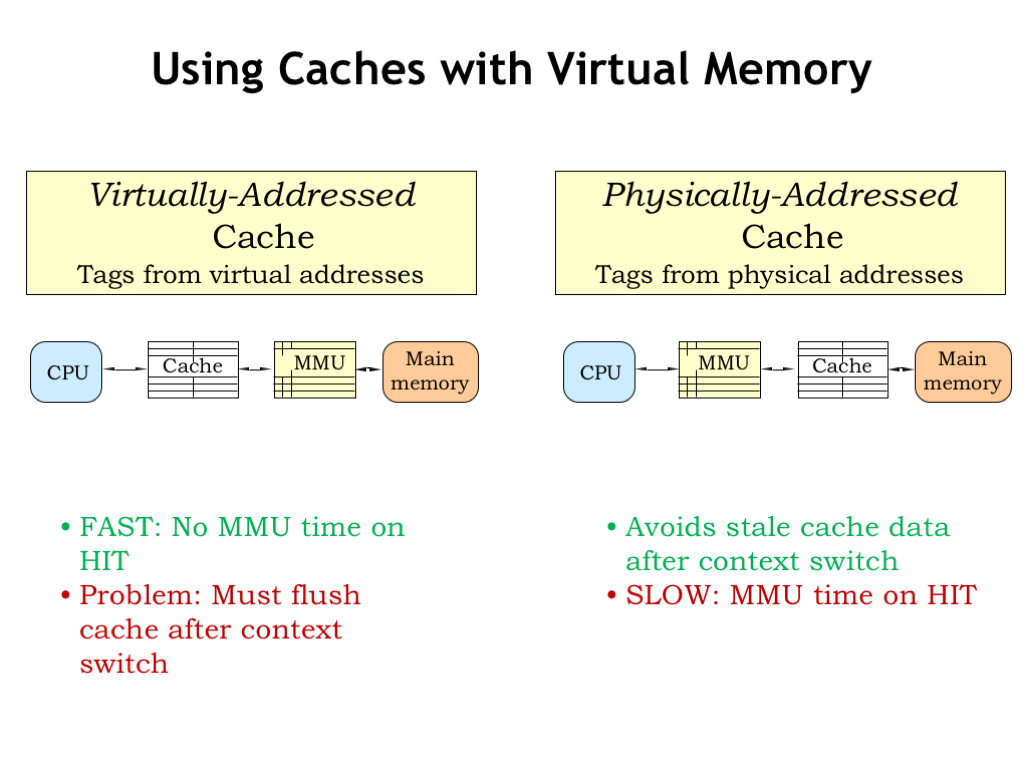
Using Caches with Virtual Memory
  • 虚地址 cache(CPU 与 MMU 之间):仅 miss 时付翻译代价;但 context 切换改变虚存含义,常需冲刷 cache,切换代价大
  • 物理地址 cache(MMU 与主存之间):切换不使 cache 语义失效;但须先翻译再查 cache,略增平均延迟

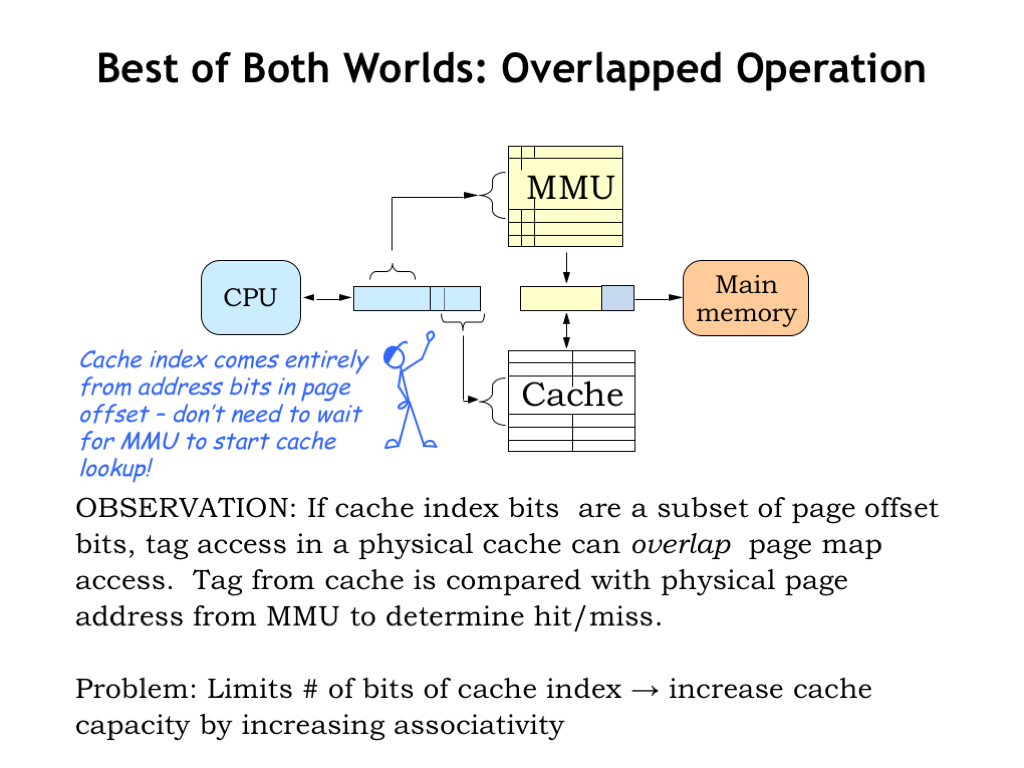
27. 并行:两全其美(Best of Both Worlds: Overlapped Operation)

Best of Both Worlds Overlapped Operation

若 cache 的 line index 完全落在页偏移内,则这些位不受 MMU 影响,可与 TLB/翻译并行启动查 cache;再用物理地址 tag 做比较。TLB 命中时,物理地址与 cache tag 大致同时就绪 → 物理寻址 cache,几乎无翻译惩罚。

推论:增大 cache 容量时,若要保持 index⊆偏移,不能单靠增加 line 数或块大小(会吃掉偏移位),往往靠提高相联度。

28. 小结(Summary: Virtual Memory)

Summary Virtual Memory

MMU 提供虚→实映射的 context;切换 context 可造出多个虚地址空间,多程序共享 CPU 与物理内存而不互扰。页表做 VPN→PPN;页表放主存,用 TLB 省掉多数页表访问;不驻留页触发 page fault,由 OS 公平管理物理页。Context 是迈向虚拟机 / 处理器虚拟化的第一步——即下一讲主题。

整理自 MIT OCW 6.004 Computation Structures(Spring 2017)L15 注解幻灯片。

源网页:15.1 Annotated Slides | Pipelining the Beta

讲师:Chris Terman。图片直接引用 OCW 原站链接。

L15:Beta 流水线(Pipelining the Beta)

本讲把早先的电路流水技术用到 32 位 Beta:经典 5 级流水(IF/RF/ALU/MEM/WB),并用 stall、bypass(forwarding)、speculation 处理 data hazard 与 control hazard,以及异常/中断下的正确性。

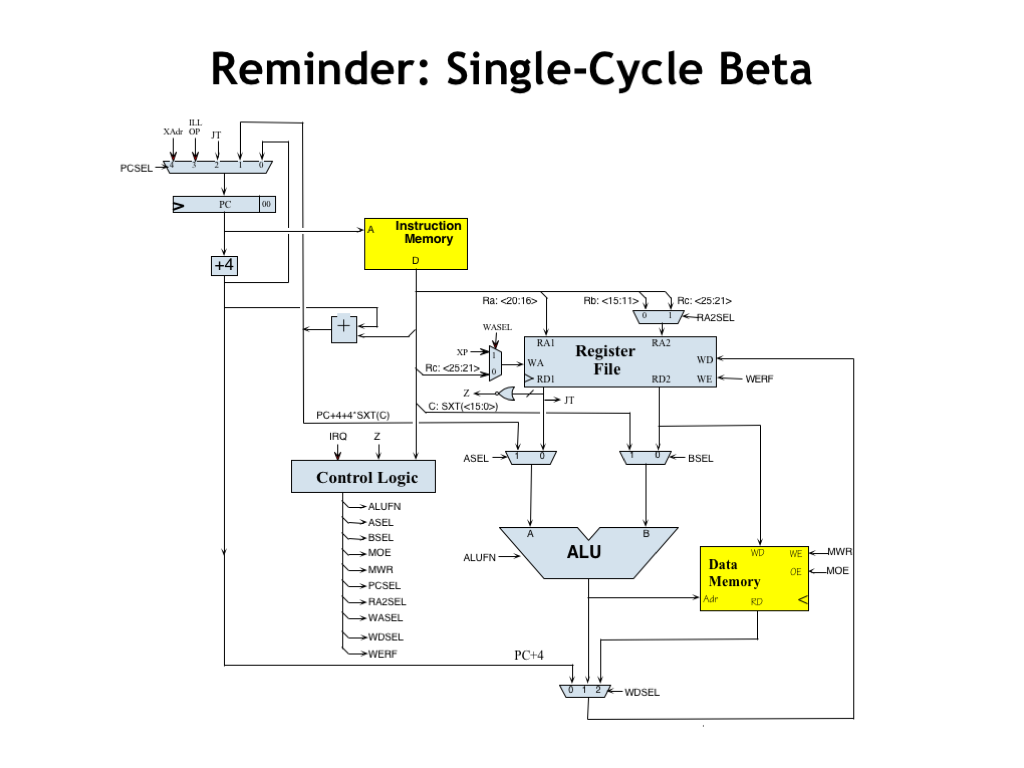
1. 回顾:单周期 Beta(Reminder: Single-Cycle Beta)

Reminder Single-Cycle Beta

单周期 Beta 每拍执行一条指令:周期初装入新 PC → 取指 → 译码控制 → 读寄存器 → ALU;访存类再用 ALU 结果当地址,LD 的数据在周期末写回寄存器文件;也可写回 PC+4 或 ALU 结果。tCLKt_{\mathrm{CLK}} 由整条执行路径累计延迟决定。问题:如何更快?

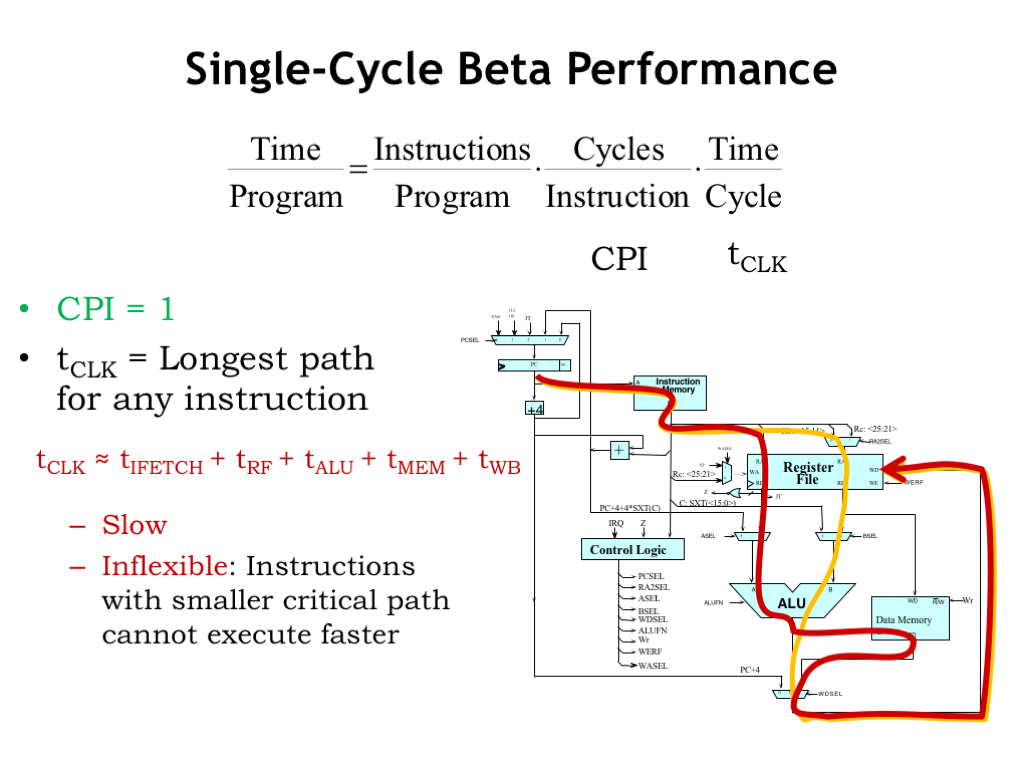
2. 单周期性能(Single-Cycle Beta Performance)

Single-Cycle Beta Performance

程序时间 ≈(动态指令数)×(CPI)×(tCLKt_{\mathrm{CLK}})。CPU 设计者主要能动 CPI 与 tCLKt_{\mathrm{CLK}};改指令数需动 ISA 或编译器。单周期 Beta 的 CPI=1,但 tCLKt_{\mathrm{CLK}} 取最坏路径:LD 需 tIFETCH+tRF+tALU+tMEM+tWBt_{\mathrm{IFETCH}}+t_{\mathrm{RF}}+t_{\mathrm{ALU}}+t_{\mathrm{MEM}}+t_{\mathrm{WB}}。简单指令也被拖慢。是否让复杂指令多拍、简单指令一拍?本讲用流水重叠执行来提吞吐。

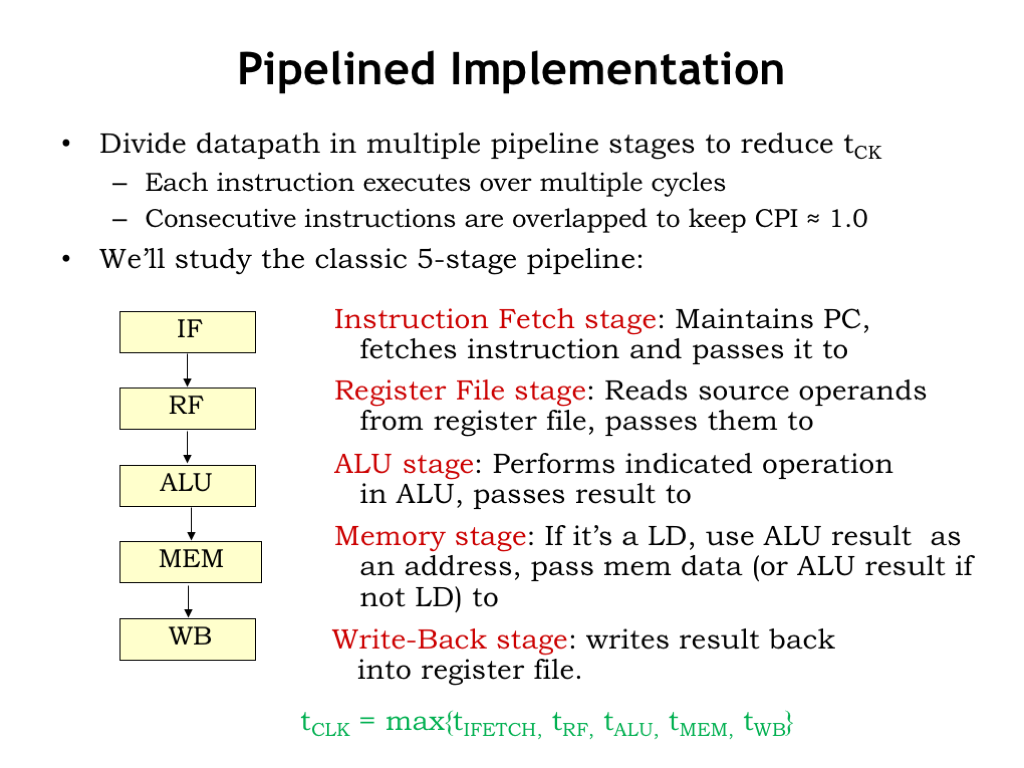
3. 流水实现(Pipelined Implementation)

Pipelined Implementation

把执行拆成多级、每级少几个部件 → 时钟可更短;多条指令重叠 → 吞吐提高。单条延迟可能略增,但理想下每拍仍完成一条指令的末级。经典 5 级:

级 作用
IF 按 PC 取指
RF 读寄存器操作数
ALU 运算
MEM LD/LDR/ST 二次访存;非访存则旁路 ALU 结果
WB 写回目的寄存器

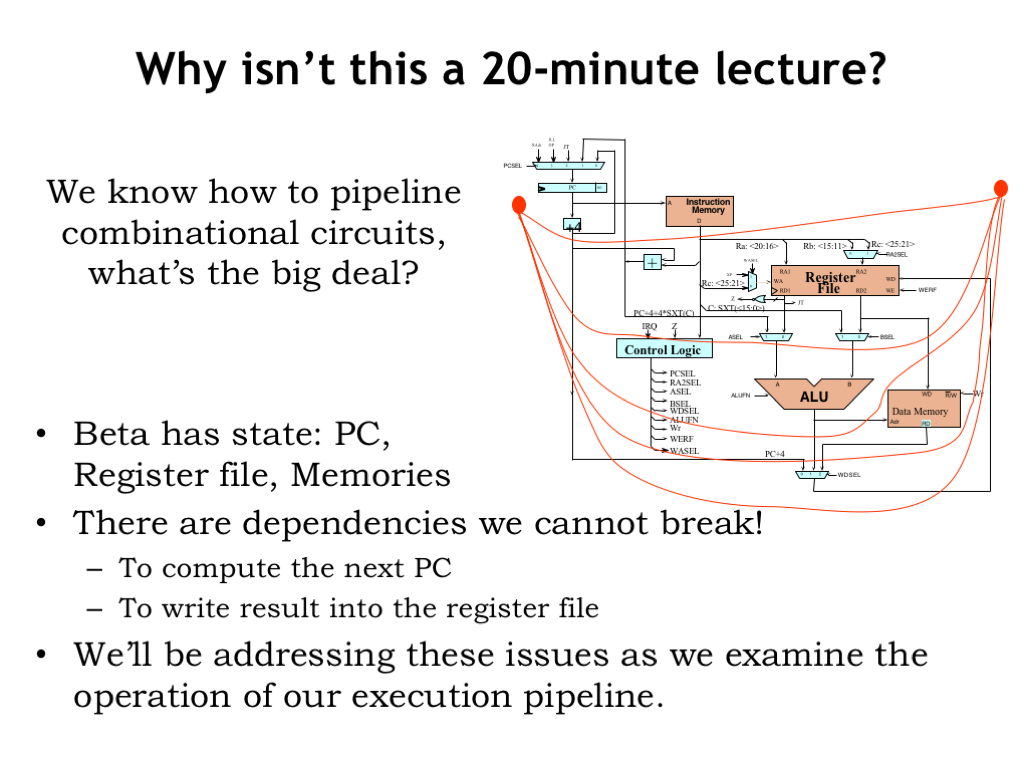
4. 为何不是 20 分钟讲完?(Why Isn’t This a 20-Minute Lecture?)

Why Isnt This a 20-Minute Lecture

组合电路流水:画轮廓、交叉处插流水寄存器即可。但 CPU 有状态(寄存器/存储器),后级结果会影响前级(如 WB 写寄存器文件影响 RF 读)——存在指令间依赖,须专门处理。

5. 流水线冒险(Pipeline Hazards)

Pipeline Hazards

两类问题依赖:

  • Data hazard:当前指令要用更早指令产生的数据(如读 R0 依赖先前写 R0)
  • Control hazard:分支/跳转/异常改变执行顺序

当被依赖指令仍在流水线中即触发 hazard。计划:先做无 hazard 序列正确的 5 级流水 → 修 data hazard → 再修 control hazard。

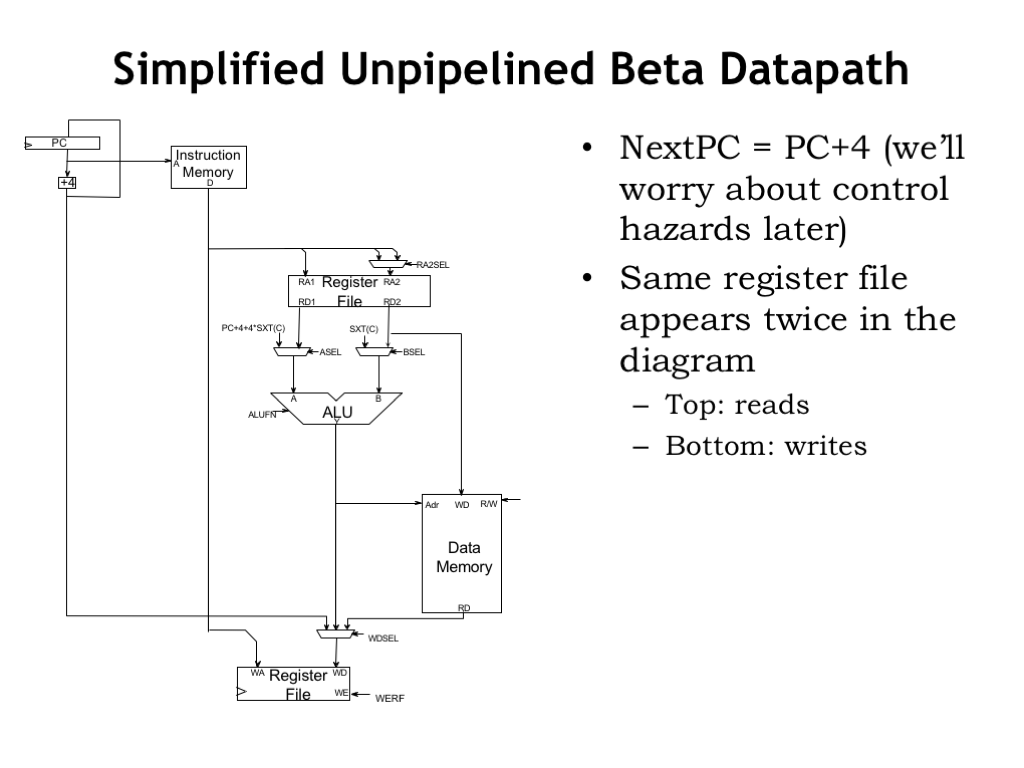
6. 简化单周期数据通路(Simplified Unpipelined Beta Datapath)

Simplified Unpipelined Beta Datapath

为便于加流水:先只谈顺序执行,去掉分支地址与 PC MUX(总是 PC+4;control hazard 时再加回)。寄存器文件画两次:上方组合读口(RF),下方时钟写口(WB)——物理上仍是同一组 32 个寄存器。
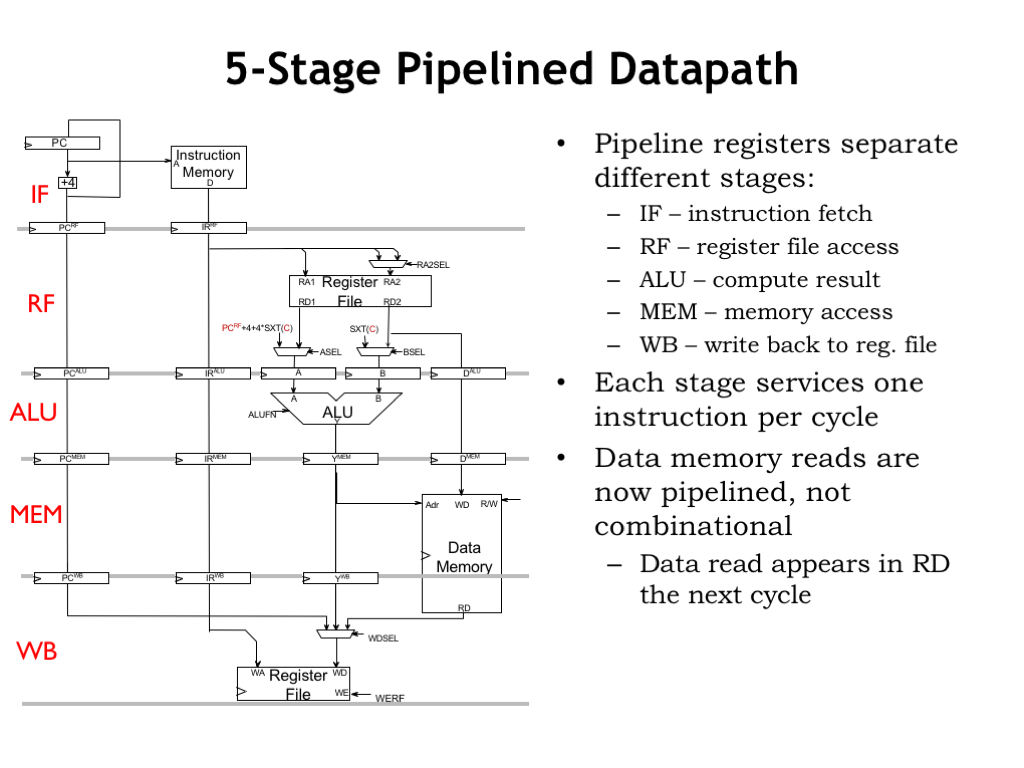
7. 五级流水数据通路(5-Stage Pipelined Datapath)

5-Stage Pipelined Datapath

插入流水寄存器后,无 data hazard 时信息自上而下流动,重叠正确。每拍五级各处理不同指令。数据访存可跨近两拍启动/返回;存储器本身也可流水,同时结束上一访问并开始下一访问。控制逻辑如何按级拆分?

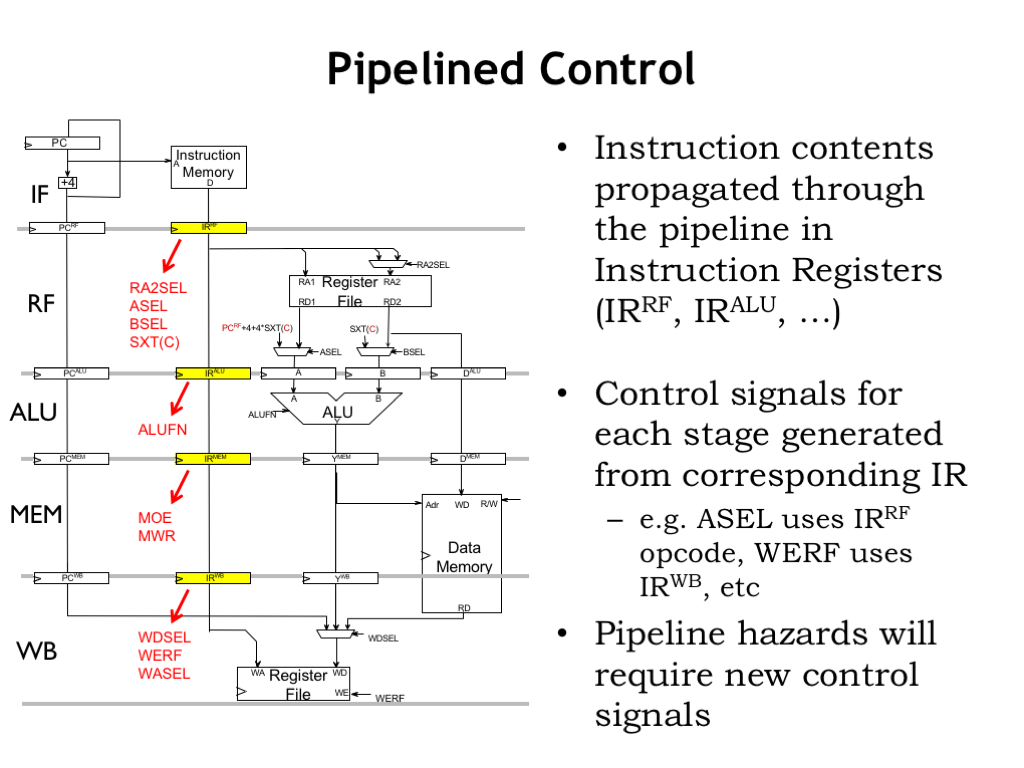
8. 流水控制(Pipelined Control)

Pipelined Control

每级带指令寄存器,由本级 opcode 产生本级控制;编码指令随流水向前传。RF 需 RA/RB/literal,WB 需 RC。逻辑与单周期类似,只是拆到各级;处理 hazard 时还要加额外控制。
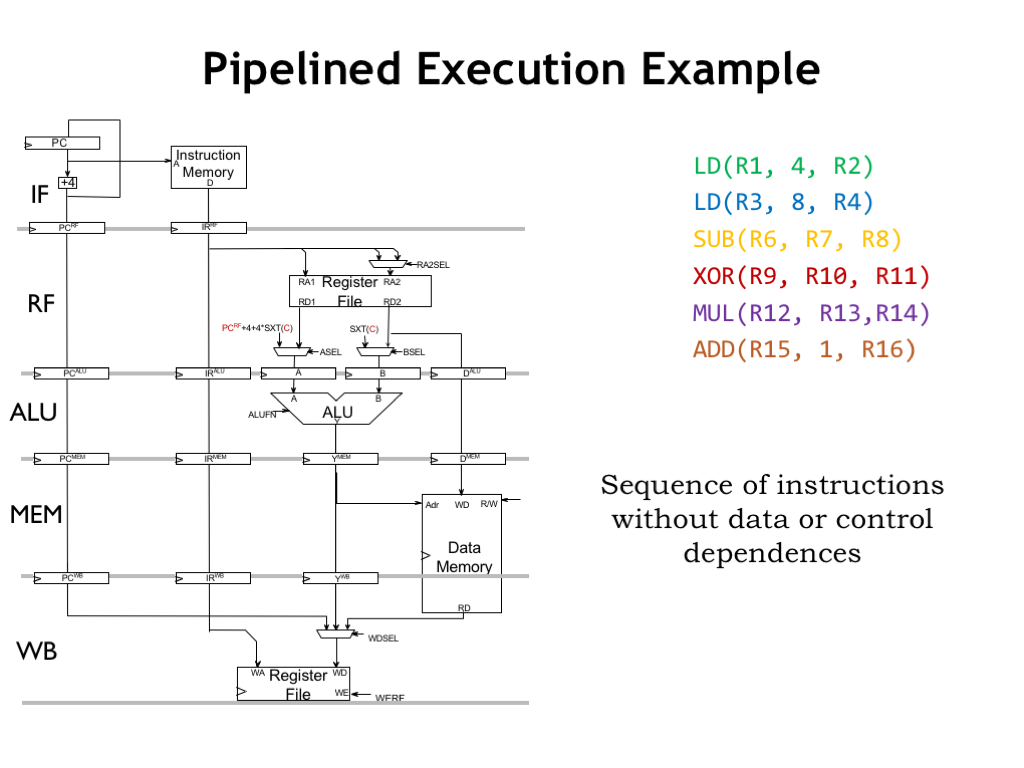
9. 流水执行例(Pipelined Execution Example)

Pipelined Execution Example

六条指令读写不同寄存器、无分支 → 无潜在 data/control hazard,可安全重叠。逐步跟踪。

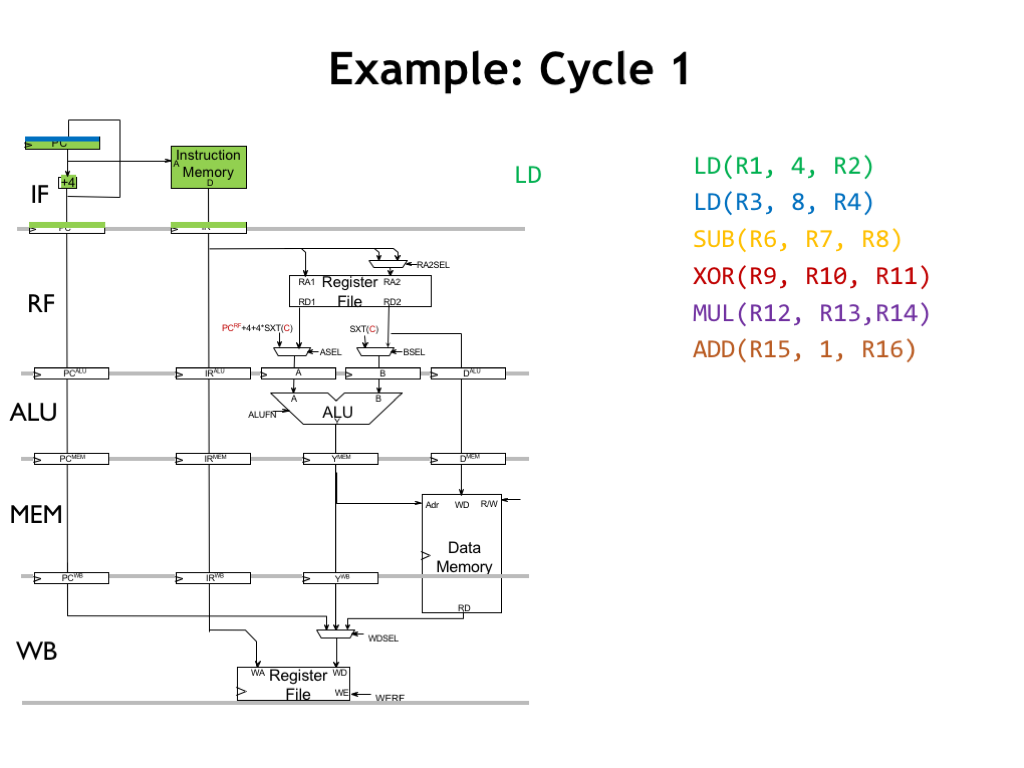
10. 例:第 1 拍(Example: Cycle 1)

Example Cycle 1

IF 用 PC 取绿色 LD,周期末写入 RF 级指令寄存器;同时算 PC+4(下一蓝指令地址)。用颜色标注各级正在处理的指令。

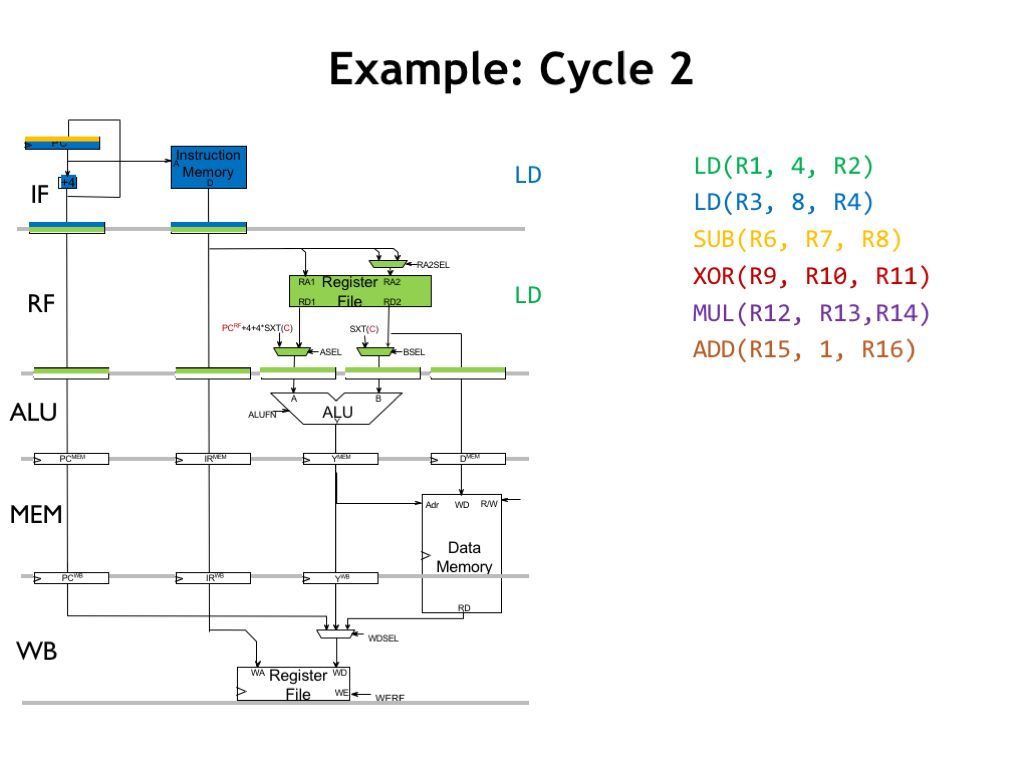
11. 例:第 2 拍(Example: Cycle 2)

Example Cycle 2

RF:绿指令读 R1;LD 使 ASEL=0、BSEL=1,选操作数写入 A/B 寄存器。IF 同时取蓝指令并更新 PC。

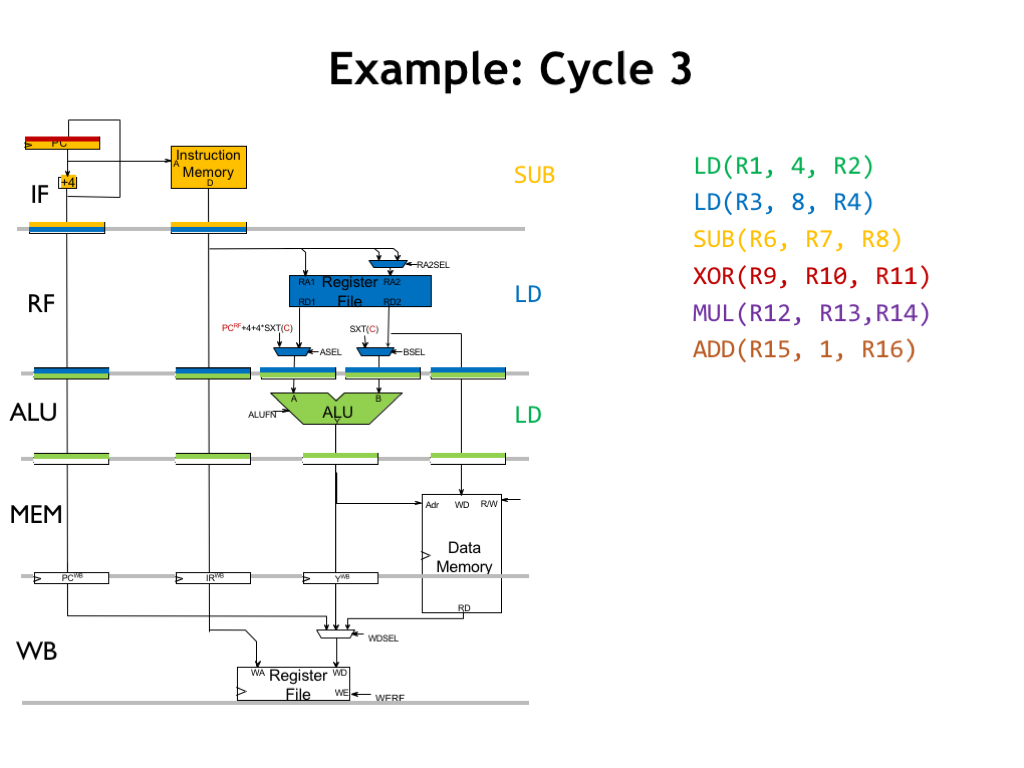
12. 例:第 3 拍(Example: Cycle 3)

Example Cycle 3

绿指令在 ALU:R1+4,结果写入 Y_MEM。

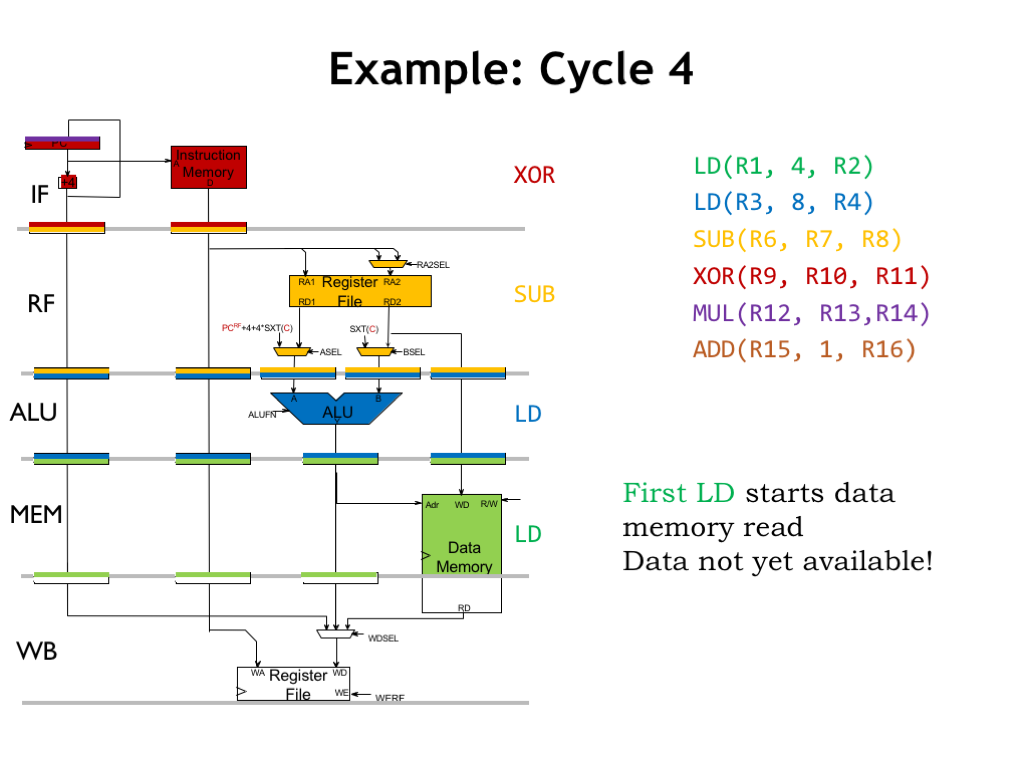
13. 例:第 4 拍(Example: Cycle 4)

Example Cycle 4

四条指令重叠。MEM 为绿 LD 启动读;读数据要到 WB 才对 CPU 可用,本拍尚不可用。

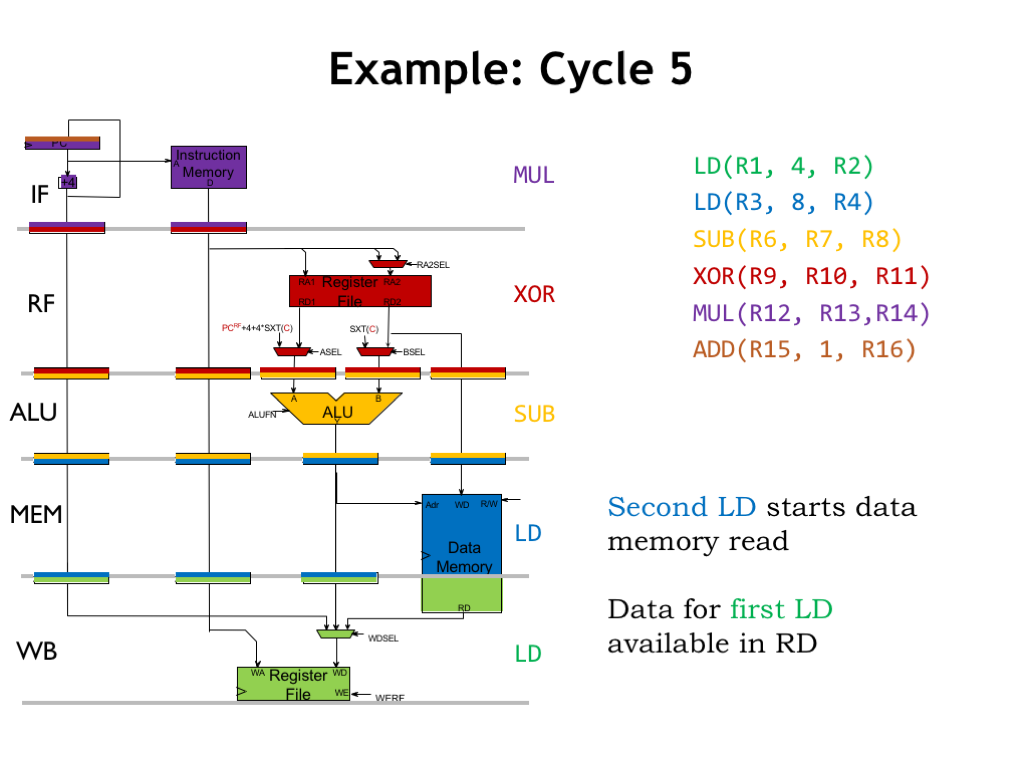
14. 例:第 5 拍(Example: Cycle 5)

Example Cycle 5

WB 把上拍启动的读数据写入 R2,绿 LD 完成。MEM 同时为蓝 LD 启动读。单指令延迟 5 拍,吞吐 1 指令/拍——与单周期同 CPI,但 tCLKt_{\mathrm{CLK}} 更短。注意:R2 新值在第 5 拍末上升沿才写入,第 6 拍起才对其它指令可见——这就是 data hazard 的温床。

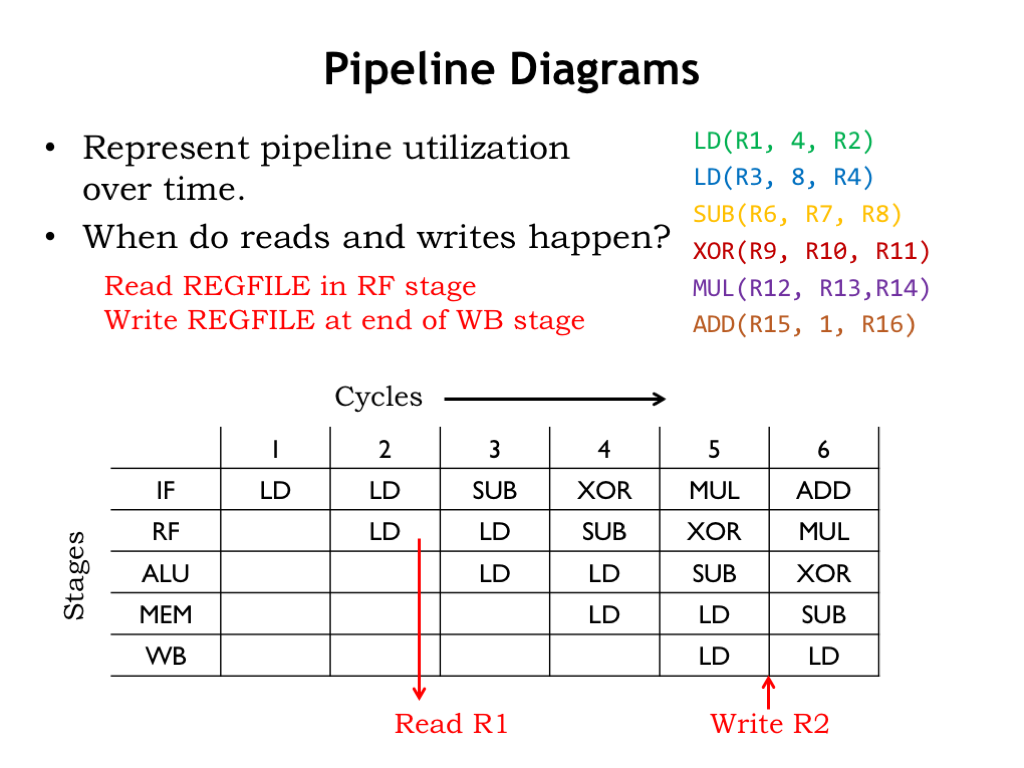
15. 流水线图(Pipeline Diagrams)

Pipeline Diagrams

数据通路图每拍要一张;更紧凑的是流水线图:行=流水级,列=周期,格内为指令。正常时指令沿对角线穿过五级。读寄存器在 RF,写在 WB 末。例:首条 LD 第 2 拍读 R1,第 5 拍末写 R2。

16. Data Hazard(Data Hazards)

Data Hazards

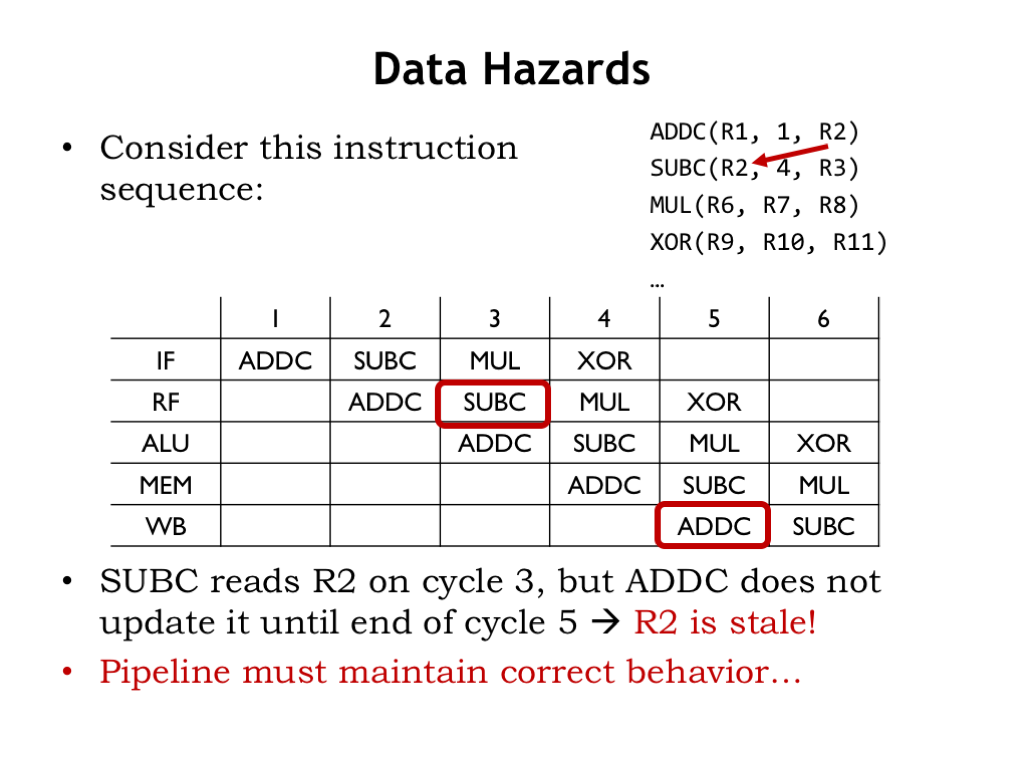
ADDC 写 R2,紧接 SUBC 读 R2——read-after-write。ADDC 第 5 拍末才写 R2,SUBC 第 3 拍已在 RF 读 → 读到旧值。流水结果须与单周期语义一致,必须修复。

17. 解决冒险策略 I(Resolving Hazards I)

Resolving Hazards I

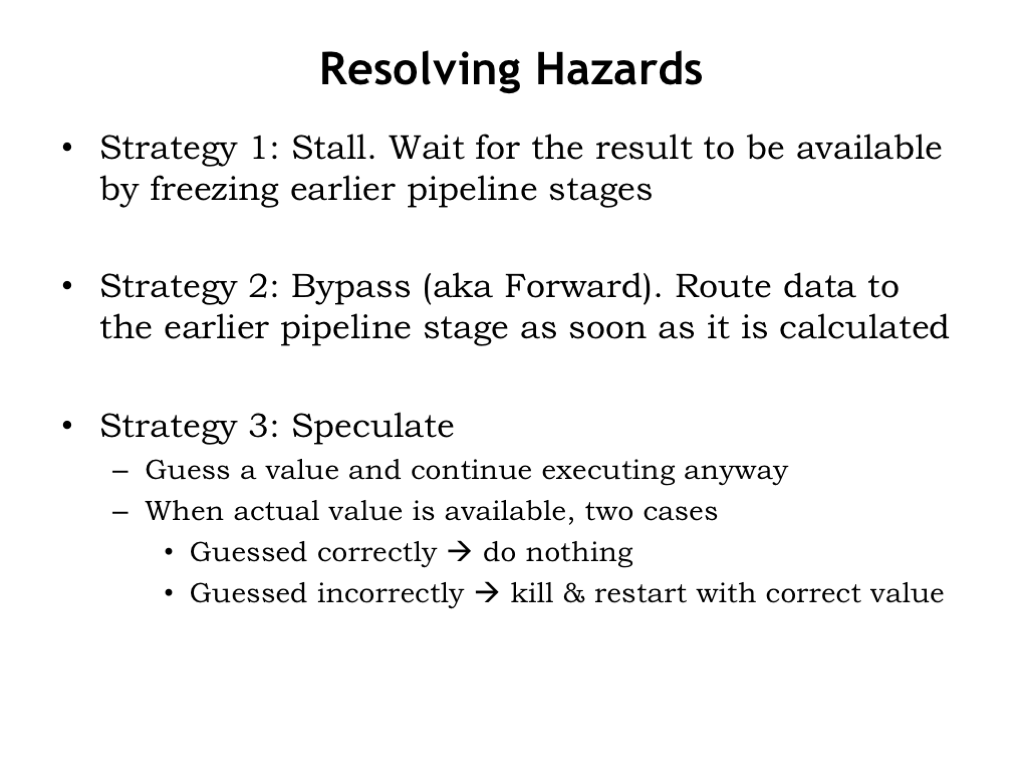
三种通用策略:

  1. Stall:在 RF 卡住直到依赖满足;更早各级一并停。可靠但伤吞吐
  2. Bypass / forwarding:结果已在后级数据通路中则直接前递,常可免 stall
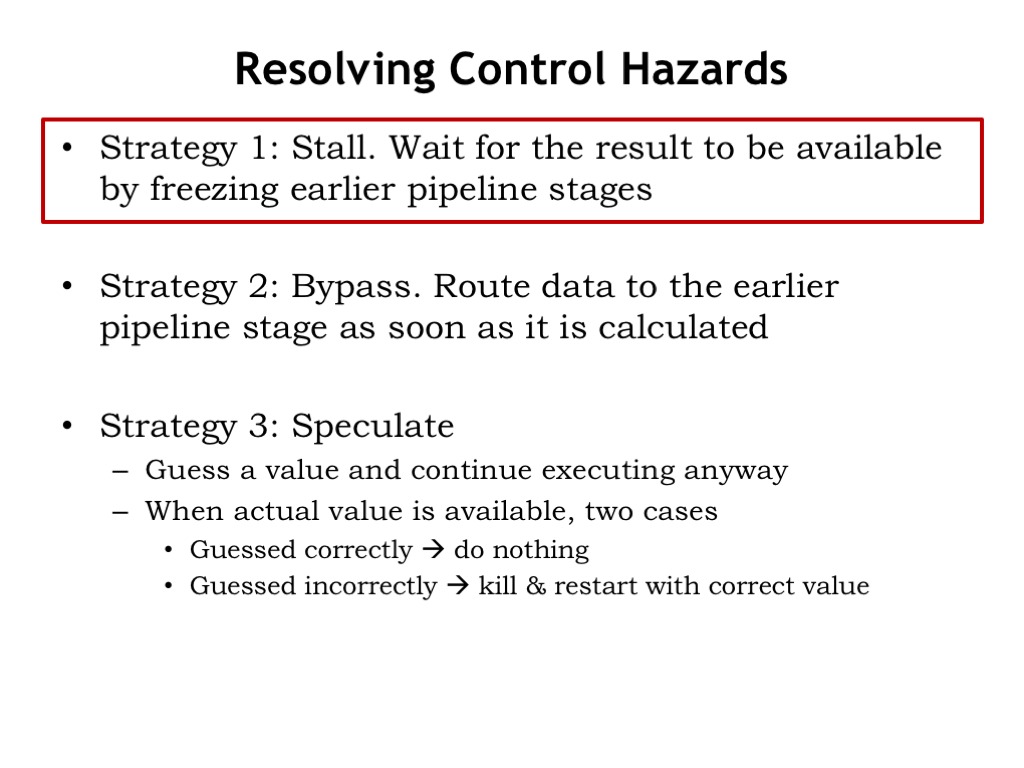
  3. Speculation:先猜,猜错再回退;适合 control hazard

18. 用 Stall 解 Data Hazard(Resolving Data Hazards I)

Resolving Data Hazards I

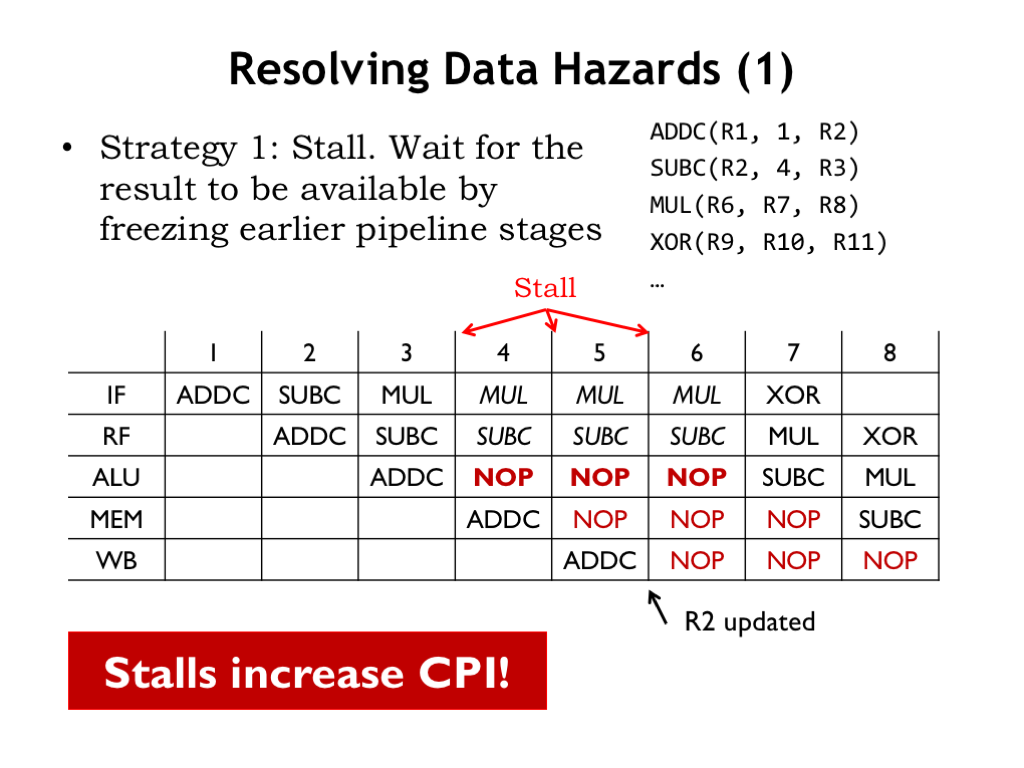
SUBC 在 RF stall 三次,到第 6 拍才从寄存器文件读到新 R2;IF 同步 stall。RF 停时向 ALU 塞入 NOP(如目的为 R31 的 OP/OPC)——流水中的 bubble。检测:比较 RF 的 RA/RB 与 ALU/MEM/WB 的 RC(注意:有的指令不读两寄存器;ST 的 RC 含义不同;R31 恒可“匹配忽略”)。Stall 提高有效 CPI。

19. Stall 逻辑(Stall Logic)

Stall Logic

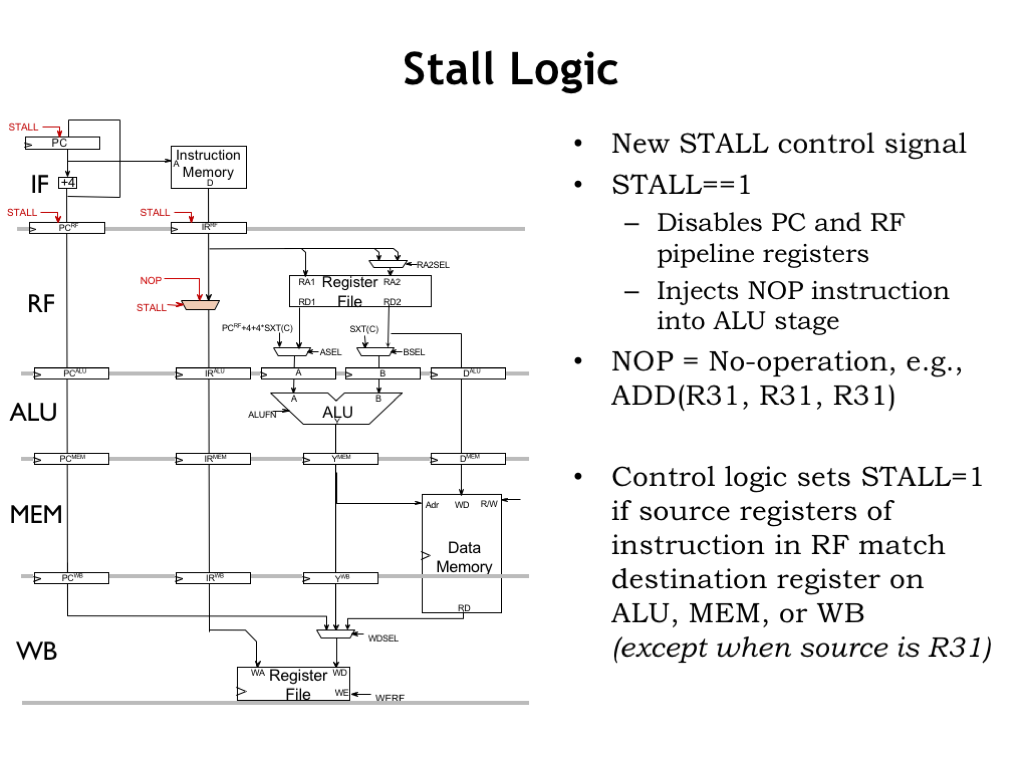
STALL=1:禁止 IF/RF 输入流水寄存器装载;MUX 向 ALU 送 NOP,否则送当前 RF 指令。硬件不多;权衡是 CPI↑ vs tCLKt_{\mathrm{CLK}}↓。

20. 用 Bypass 解 Data Hazard(Resolving Data Hazards II)

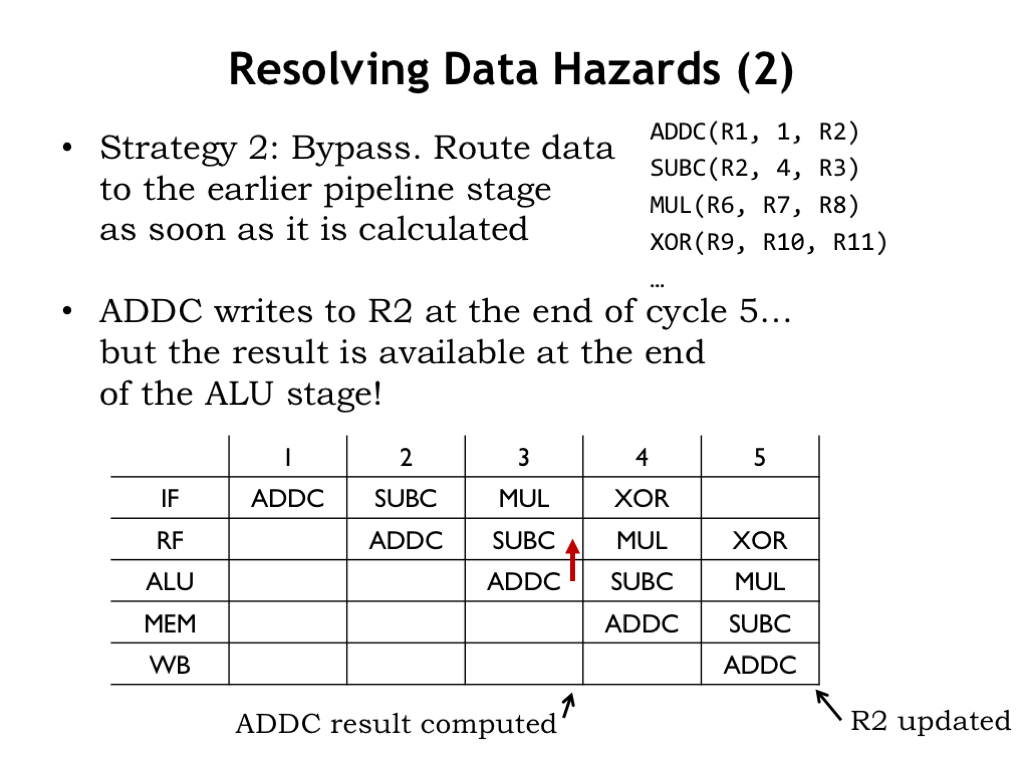
Resolving Data Hazards II

ADDC 在第 3 拍 ALU 已算出将写入 R2 的值,恰可供给同拍 RF 中的 SUBC。若 RF 的源寄存器号匹配 ALU 的 RC,用 ALU 输出代替寄存器文件陈旧读值——红箭头即 bypass。

21. Bypass 逻辑(Bypass Logic)

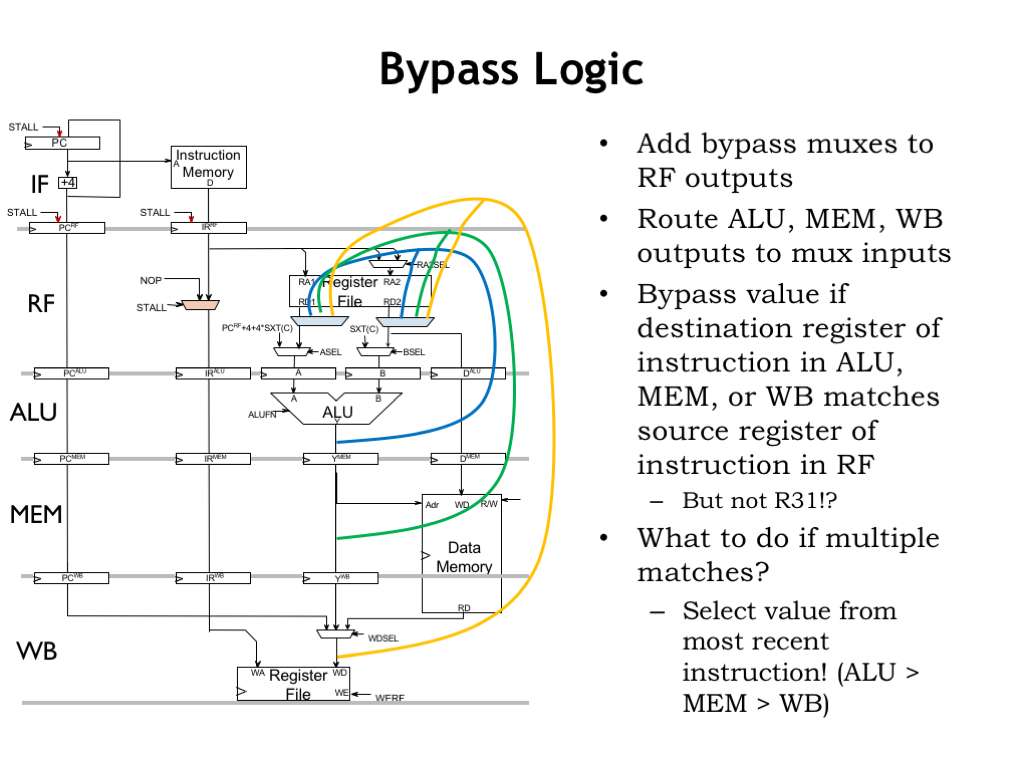
Bypass Logic

在读口加多路 MUX,可从 ALU/MEM/WB 前递。多路同时匹配时选最近指令:优先 ALU,再 MEM,再 WB,最后才是寄存器文件(注意 R31)。

22. 全 Bypass 流水线(Fully Bypassed Pipeline)

Fully Bypassed Pipeline

分支/跳转写回 PC+4,故 PC+4 路径也要 bypass。前递发生在周期末(如 ALU 算完后),MUX 的 tPDt_{\mathrm{PD}} 略拉长 tCLKt_{\mathrm{CLK}}。可折中:只 bypass ALU 级结果,其余靠 stall。全 bypass 后还要不要 STALL?

23. Load-to-Use Stall(Load-to-Use Stalls)

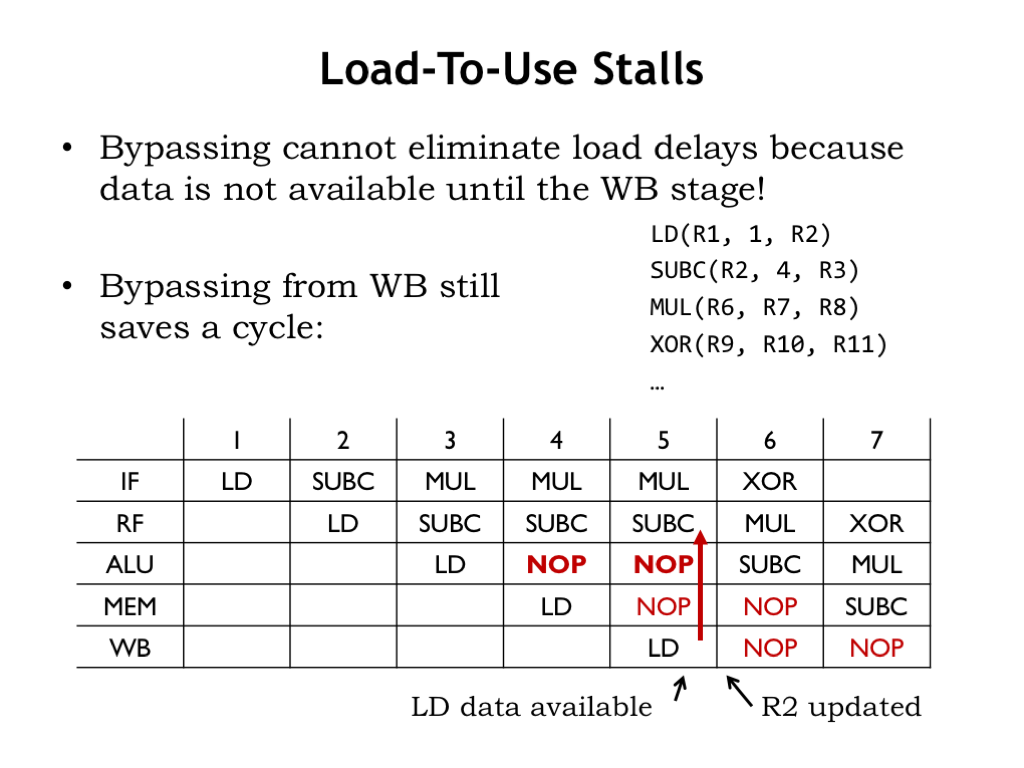
Load-to-Use Stalls

Load-to-use:紧接使用 LD 结果。LD 数据要到 WB 才在通路中可用,即便全 bypass,SUBC 仍须在 RF stall(例中 stall 到第 5 拍,插入 2 个 NOP);若无 WB bypass 则更久。

24. 小结:带 Data Hazard 的流水(Summary: Pipelining with Data Hazards)

Summary Pipelining with Data Hazards

Stall:硬件简单,bubble 抬高 CPI。Bypass:硬件更多,一般不抬 CPI;但仍须 stall 处理 load-to-use。级数越多同拍在飞指令越多,hazard/stall 更频繁,CPI 压力更大。

25. 编译器可帮忙(Compilers Can Help)

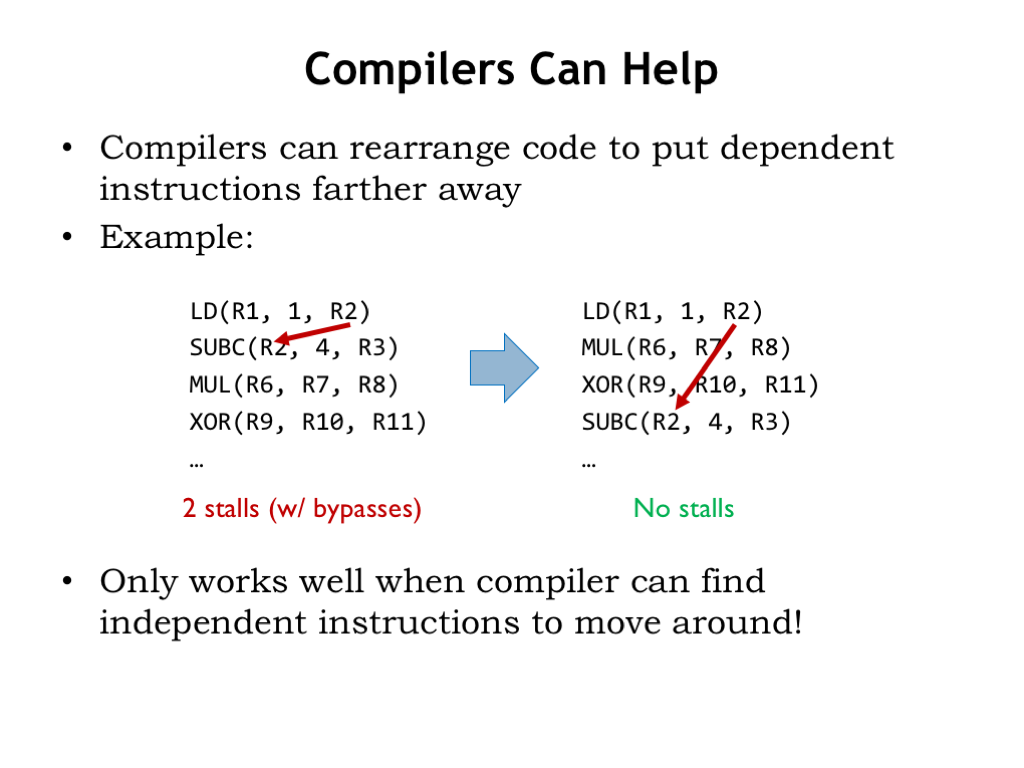
Compilers Can Help

重排无关指令可拉开 load-to-use 距离:把独立的 MUL/XOR 挪到 SUBC 前,使 LD 到 WB 时使用方才到 RF → 零 stall。前提是找得到可移动的独立指令。

26. 懒办法:改 ISA(Or Take the Lazy Route…)

Or Take the Lazy Route

把“写回延迟 3 条指令”写进 ISA,让程序员/编译器显式插 NOP——硬件省、软件苦;改流水深度还得再改 ISA。成功 ISA 寿命长,不宜绑定短期实现折中。

27. Control Hazard I(Control Hazards I)

Control Hazards I

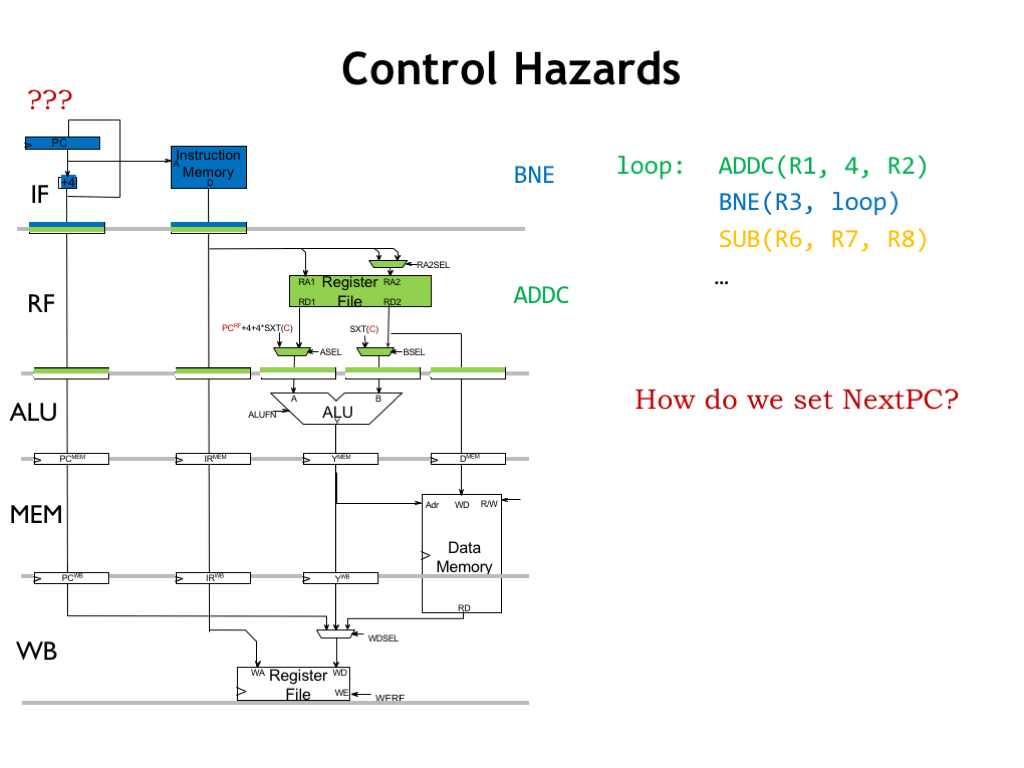
BNE 后执行谁取决于 R3 是否非零。显式控制转移使下一条依赖当前指令执行结果——对流水意味着什么?

28. Control Hazard II(Control Hazards II)

Control Hazards II

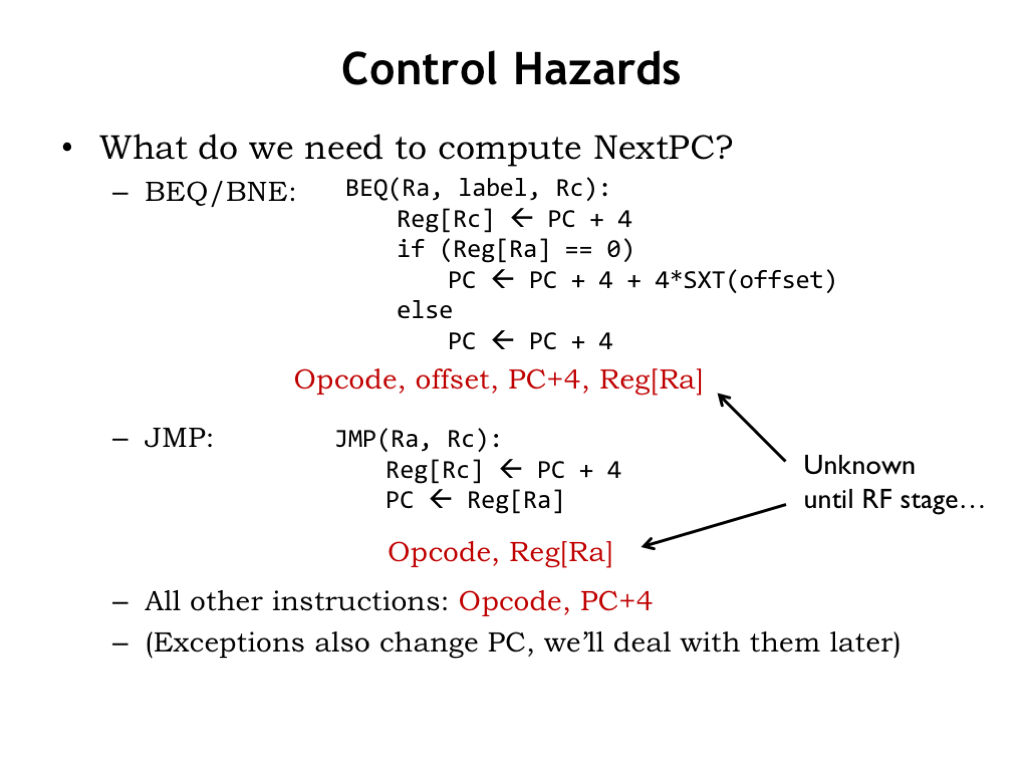
分支下一 PC 依赖 opcode、当前 PC(算偏移)与 RA;JMP 依赖 opcode 与 RA;其它指令多为 PC+4。异常也改 PC(后文)。问题在于:JMP/分支在 RF 才读到 RA(bypass 可保证 RA 值正确),但同拍 IF 已在取“下一条”——取谁?

29. 解决 Control Hazard(Resolving Control Hazards)

Resolving Control Hazards

对 JMP 与 taken 分支,IF 在 RF 算出目标前不知道该做什么。一策:stall IF 直至 RF 算完。

30. 用 Stall 解 Control Hazard(Resolving Control Hazards with Stalls)

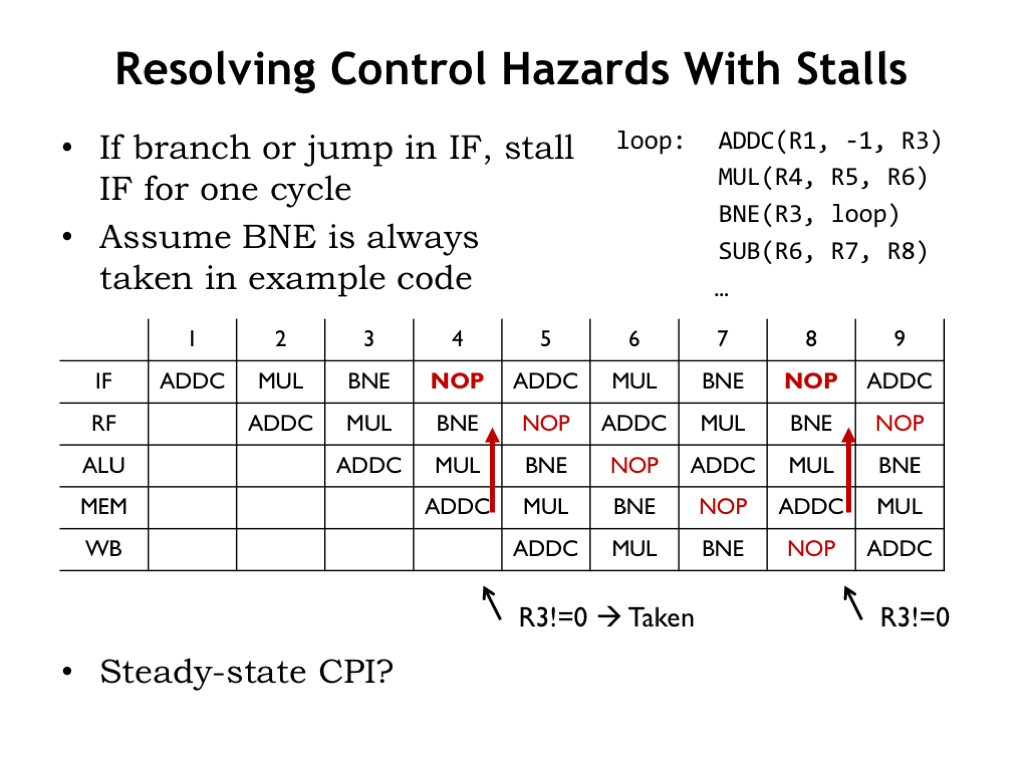
Resolving Control Hazards with Stalls

RF 中为 JMP/BEQ/BNE 时 stall IF 一拍,插入 NOP;RF 确定目标后再继续。例中循环还叠加 data hazard,靠 bypass 从 MEM 取 R3。3 指令循环实际 4 拍一轮 → 有效 CPI=4/34/3(约 +33%)。

31. Control Hazard 的 Stall 逻辑(Stall Logic for Control Hazards)

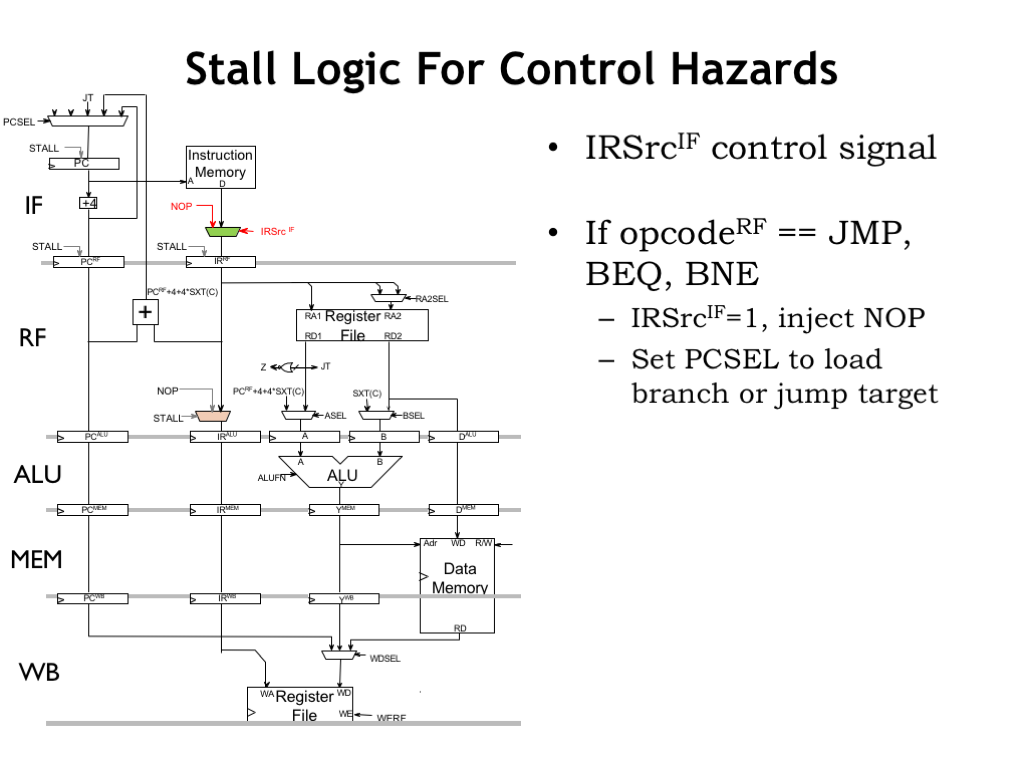
Stall Logic for Control Hazards

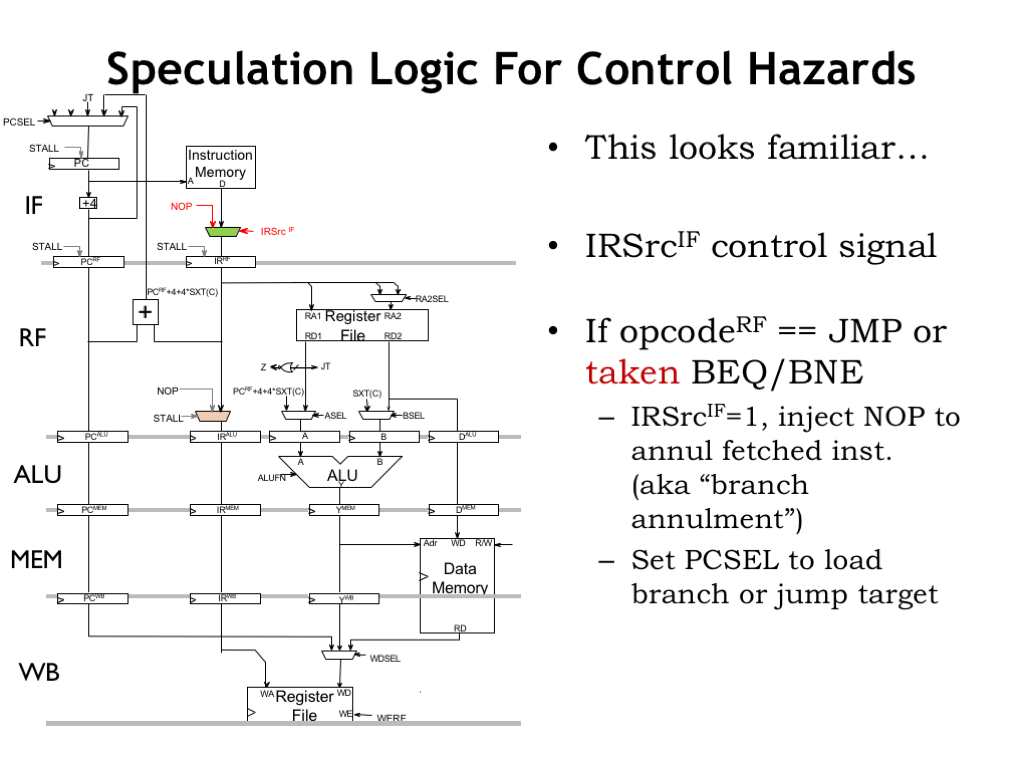
IF 指令路径加 MUX,由 IRSrc_IF 控制:RF 为 JMP/BEQ/BNE 时选 NOP,annul 刚取出的指令;同时 PCSEL 选正确下一 PC。上标表示控制逻辑所在流水级。

32. ISA:简单 vs 复杂分支(ISA Issues: Simple vs. Complex Branches)

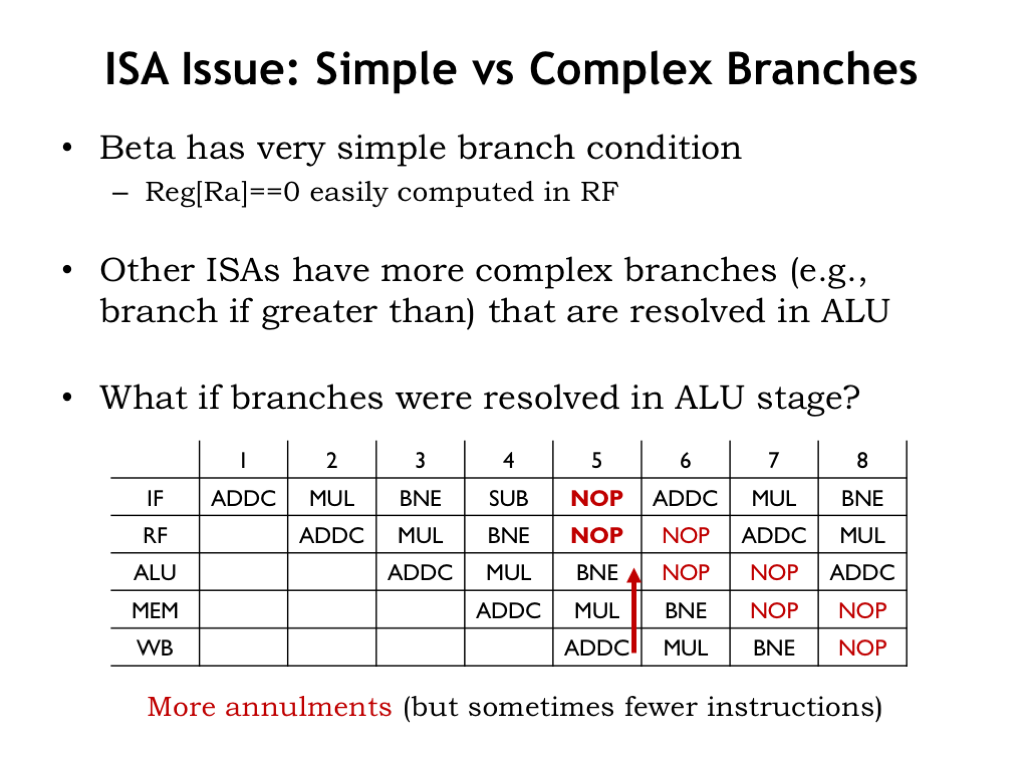
ISA Issues Simple vs Complex Branches

Beta 分支在 RF 决策。若 ISA 把决策放到 ALU,须 annul IF 与 RF 两条 → 两 NOP,CPI 更差;但复杂分支可能减少静态指令数。提前各级全部 annul 称 flush——代价大,仅在别无他法保正确时用。

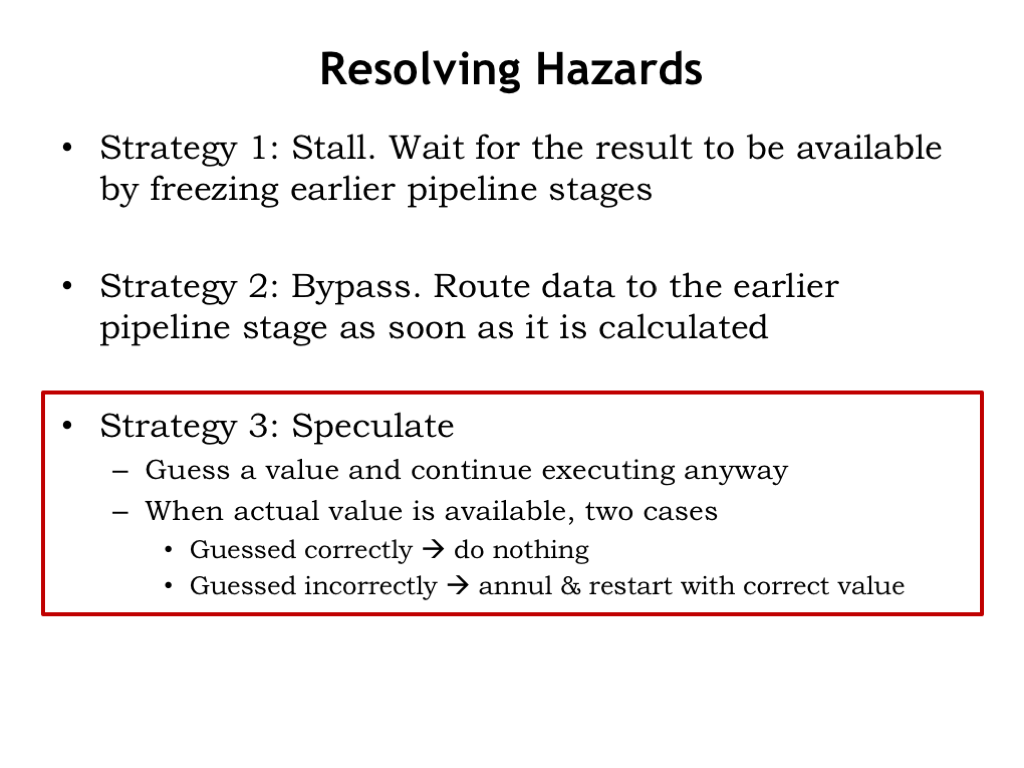
33. 解决冒险策略 II:推测(Resolving Hazards II)

Resolving Hazards II

未 taken 时,流水本来按 PC+4 取指就是对的。在不确定时仍开始执行称 speculation;须能在产生副作用(写寄存器/主存)前 annul。副作用在后级,故指令可先走过 IF/RF/ALU 再最终决定。

34. 推测 I(Resolving Hazards with Speculation I)

Resolving Hazards with Speculation I

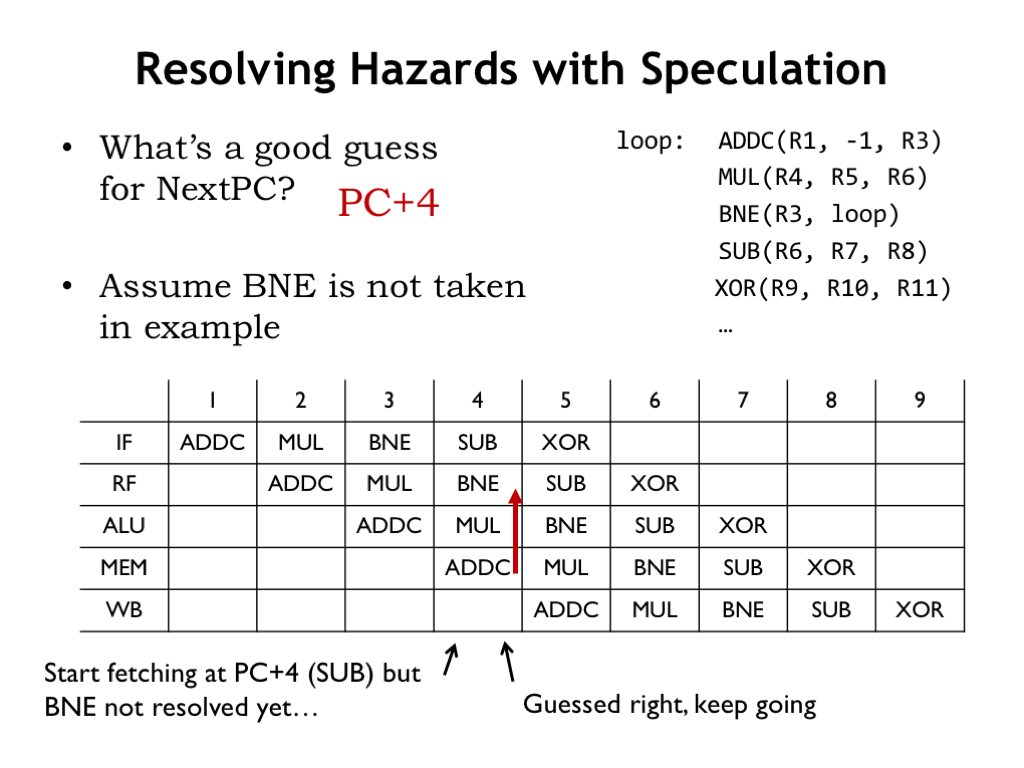
默认猜下一 PC=PC+4,仅对 JMP/taken 分支错。若 BNE 未 taken:后续 SUB 进入流水,第 4 拍末确认后放行——猜对则零 annul。

35. 推测 II(Resolving Hazards with Speculation II)

Resolving Hazards with Speculation II

若 BNE taken:第 4 拍末 annul SUB,第 5 拍执行 NOP。仅 taken 时插入 bubble,对 CPI 冲击小于“分支一律 stall”。

36. 推测控制逻辑(Speculation Logic For Control Hazards)

Speculation Logic For Control Hazards

数据通路同前,只是更聪明地置 IRSrc_IF=1:不是所有分支,仅 taken 时 annul IF。

37. 分支预测(Branch Prediction)

Branch Prediction

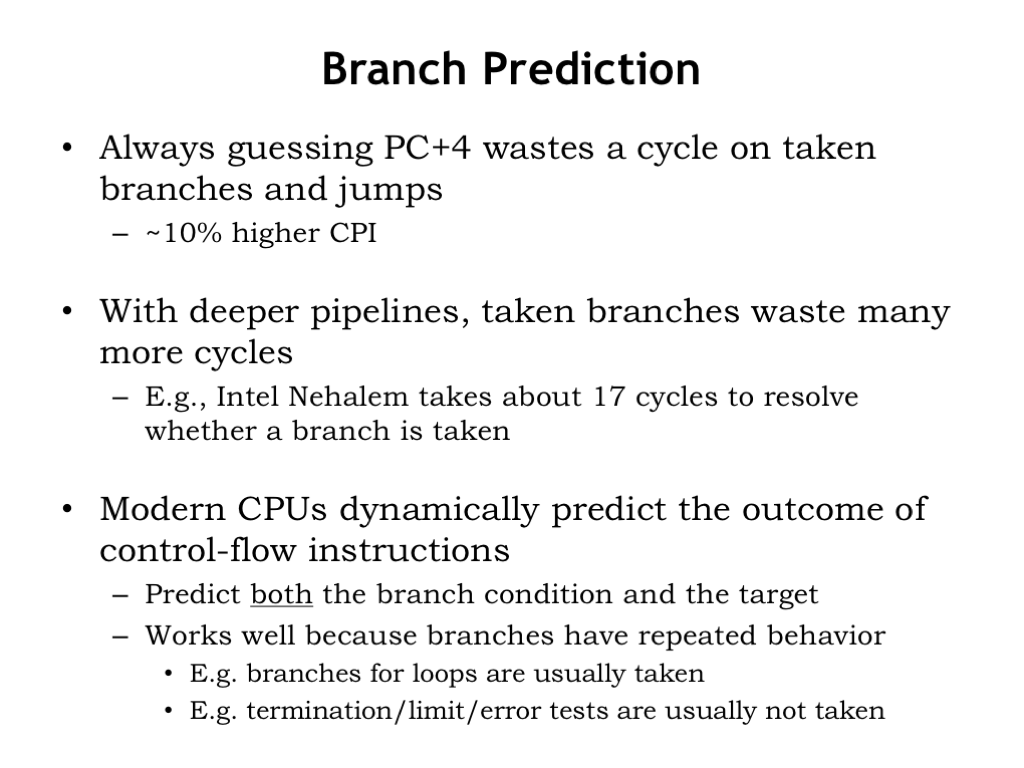
总猜 PC+4 对 JMP/taken 常错,仿真约抬高有效 CPI ~10%。深流水(如 Nehalem)分支很晚才决出,flush 代价极大。现代做法:非分支仍猜顺序;分支按历史、循环反向偏移、甚至分支间相关做预测,正确率可达 95%–99%。

38. 分支延迟槽 I(Branch Delay Slots I)

Branch Delay Slots I

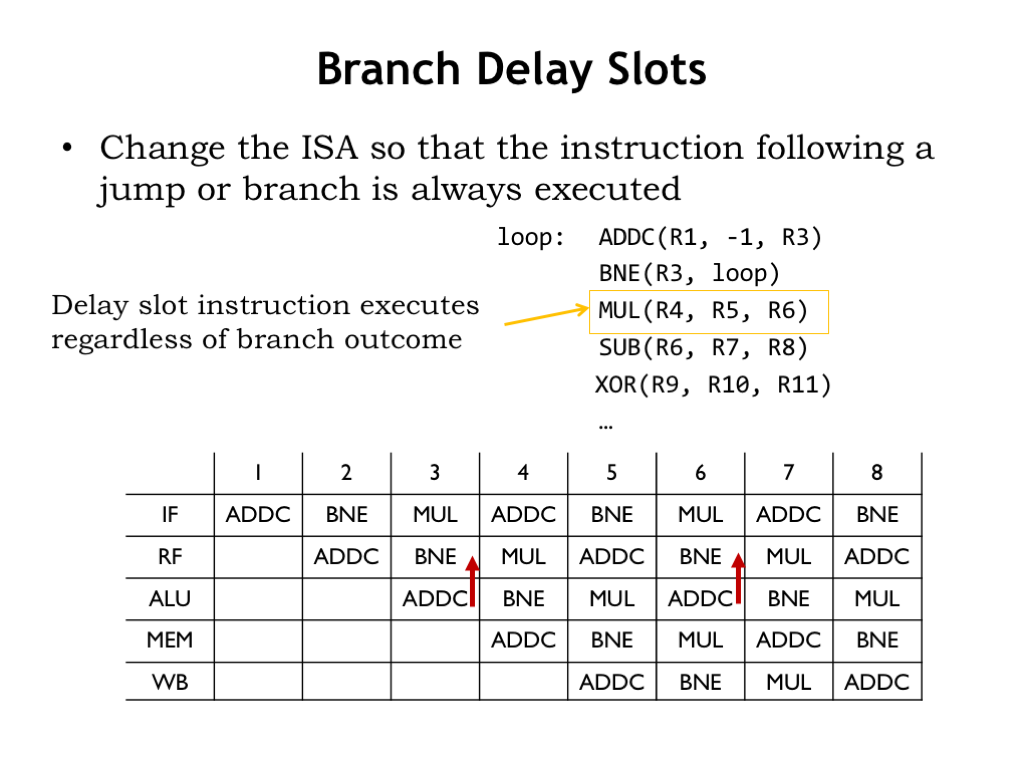
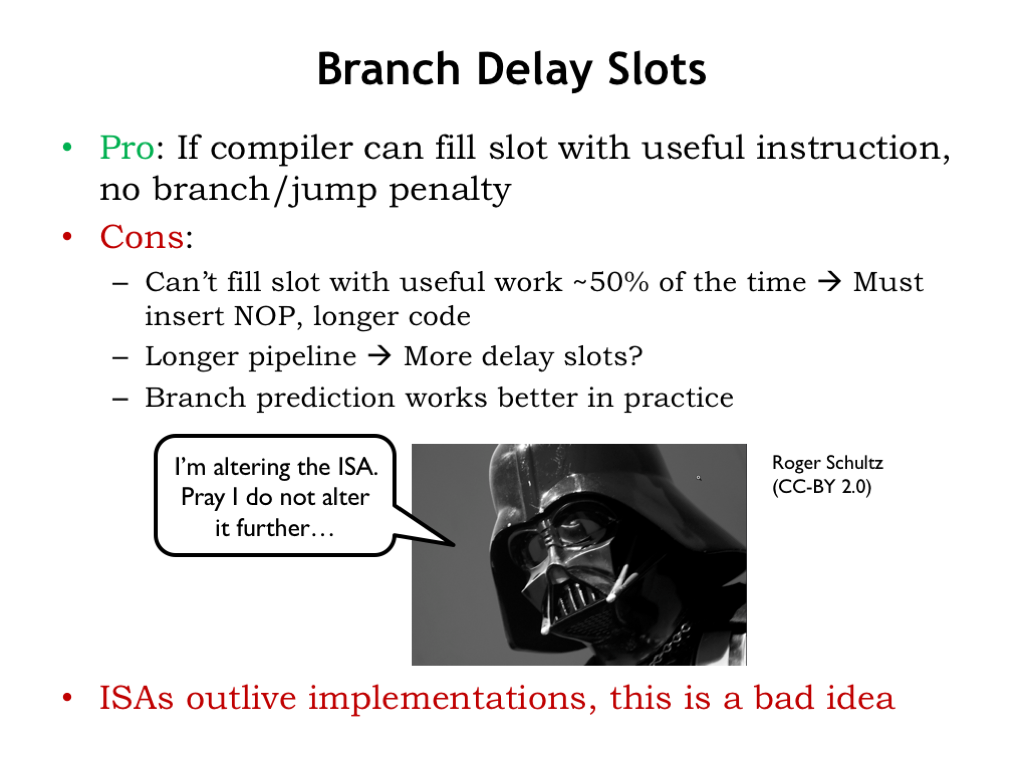
改 ISA:跳转/分支后的下一条总是执行(延迟槽)。则猜 PC+4 恒对。把循环中 MUL 放到 BNE 后的 delay slot,可零 CPI 惩罚(若填得满)。

39. 分支延迟槽 II(Branch Delay Slots II)

Branch Delay Slots II

实践中约一半情况找不到有用指令填槽,只好显式 NOP,代码变大;决策越晚槽越多越难填。分支预测通常优于 delay slot。再次:勿为某一实现改 ISA 语义。

40. 异常(Exceptions)

Exceptions

非法指令或外部中断:存 PC+4 到 XP,PC←相应 handler。异常是隐式控制转移。单周期中异常作用于“当前指令”;流水中须认定哪一条受影响,保证更早指令完成,并 annul 该指令及其后已进流水者。

41. 异常何时发生?(When Can Exceptions Happen?)

When Can Exceptions Happen

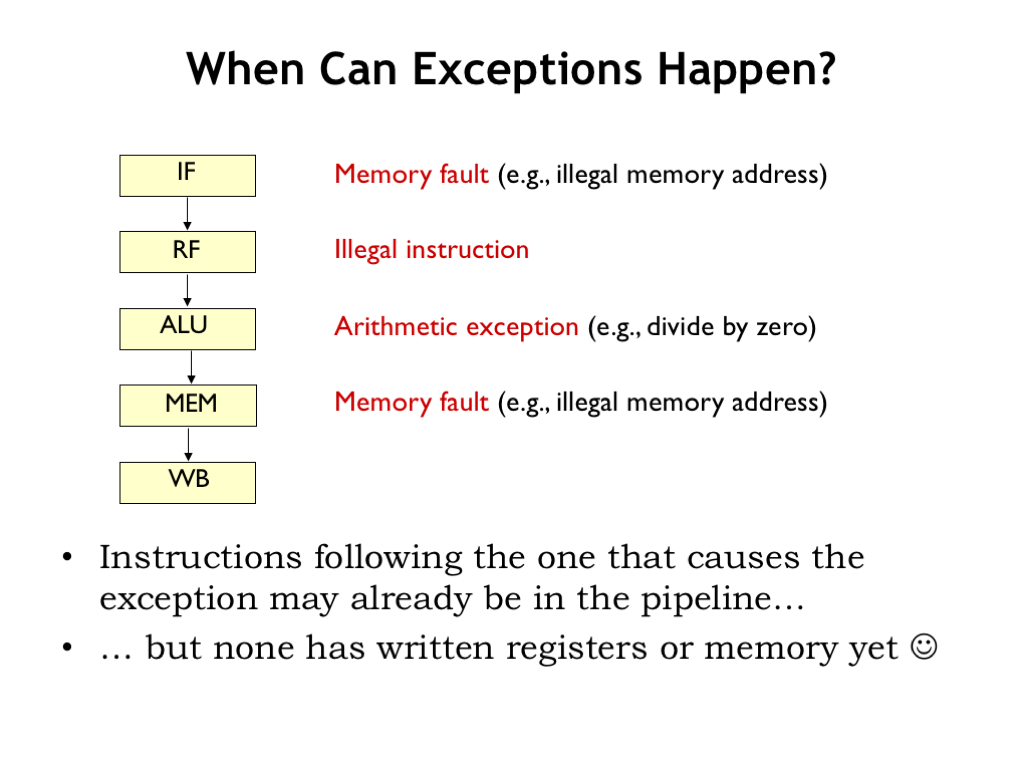
RF:非法 opcode;ALU:如 DIV 除 0;MEM:非法地址;IF:取指地址异常。后续已进流水的指令须 annul。好消息:寄存器只在 WB 更新,annul 只需换成 NOP,不必回滚已写值。

42. 处理异常(Resolving Exceptions)

Resolving Exceptions

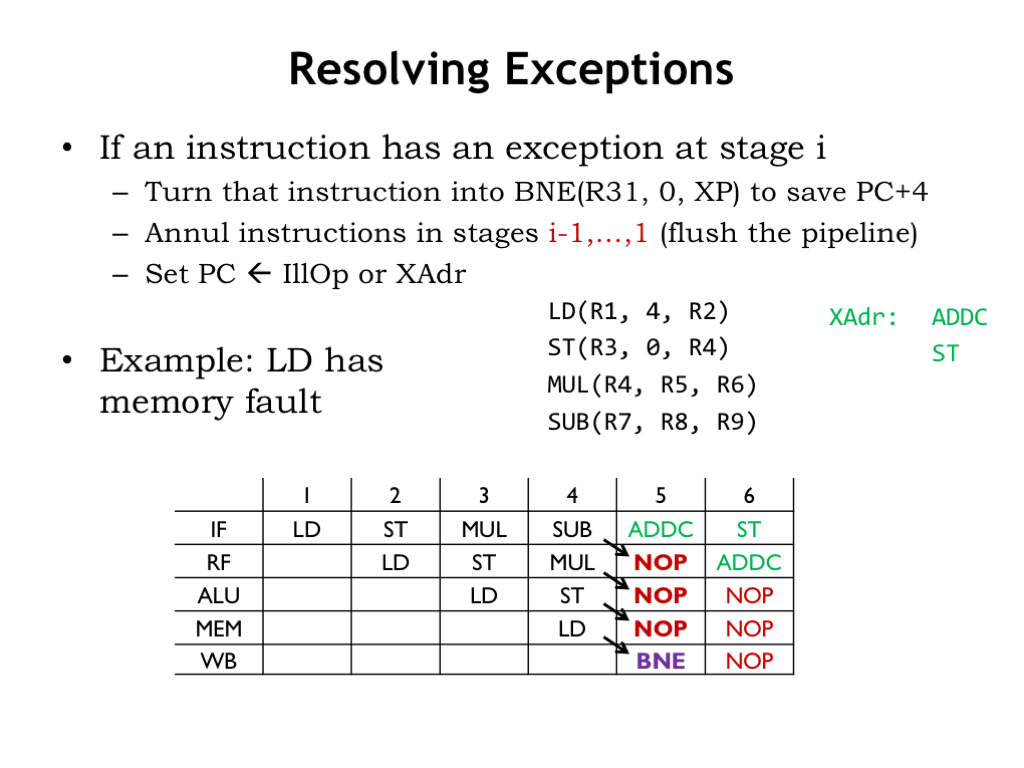
若指令在第 ii 级引发异常:用一条副作用仅为把 PC+4 写入 XP 的“魔法” BNE 替换它 → flush 更早各级 → PC←handler。例:LD 在第 4 拍 MEM 异常,第 5 拍起 IF 取 handler。

43. 异常处理逻辑(Exception Handling Logic)

Exception Handling Logic

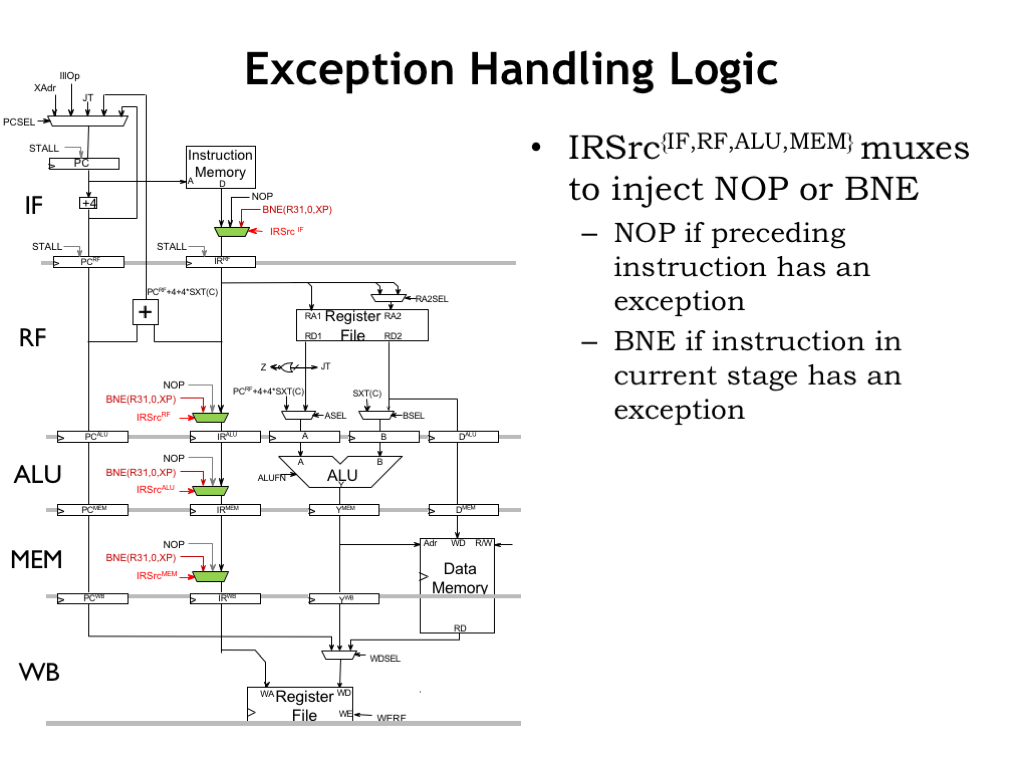
改造指令路径 MUX:可换成 NOP(annul)或魔法 BNE(肇事指令)。

44. 多重异常?(Multiple Exceptions?)

Multiple Exceptions

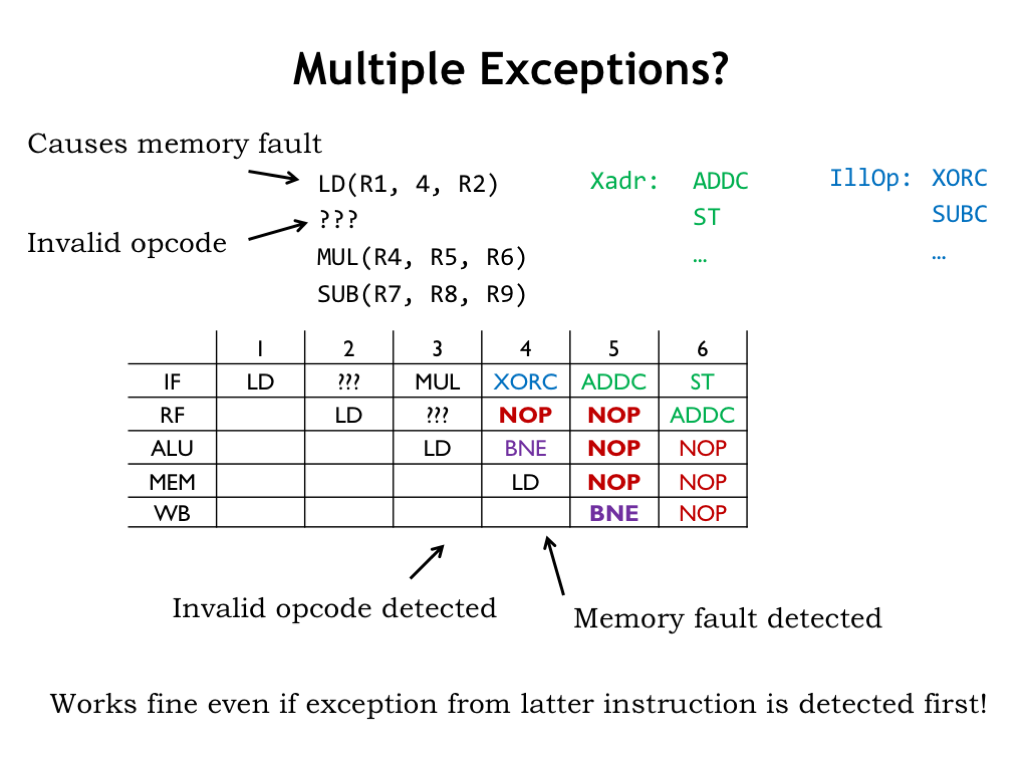
多指令并行时可能同时/先后检出多个异常。例:非法 opcode 在 RF 先被发现,但更早的 LD 随后在 MEM 也异常——应让更早指令(流水中更靠后级)的异常优先,因放弃 LD 后其后指令本就不该执行。同拍多异常:优先流水线中更靠前(更接近完成)的那条。

45. 异步中断(Asynchronous Interrupts)

Asynchronous Interrupts

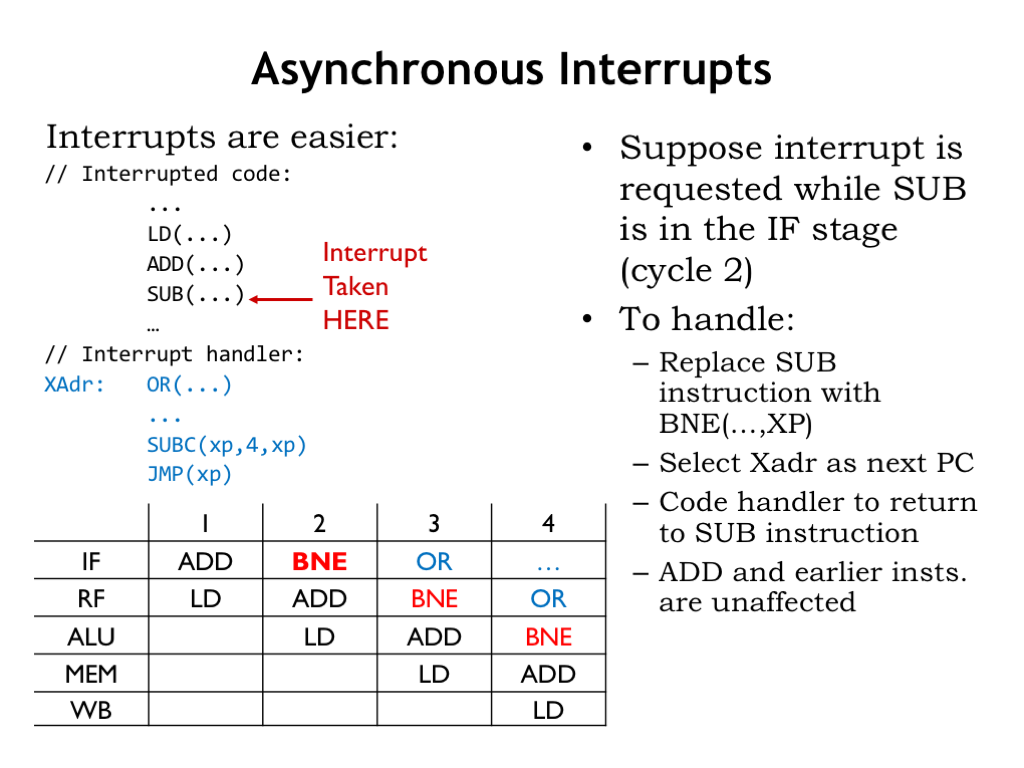
外部中断也像隐式分支,但可当作作用于 IF 的异常:用魔法 BNE 捕获 PC+4,下一 PC←中断 handler;handler 返回前修正 XP 指向被打断指令(如 SUB)。更早的 ADD/LD 等不受影响。

46. 异常+中断逻辑(Exception + Interrupt Handling Logic)

Exception Interrupt Handling Logic

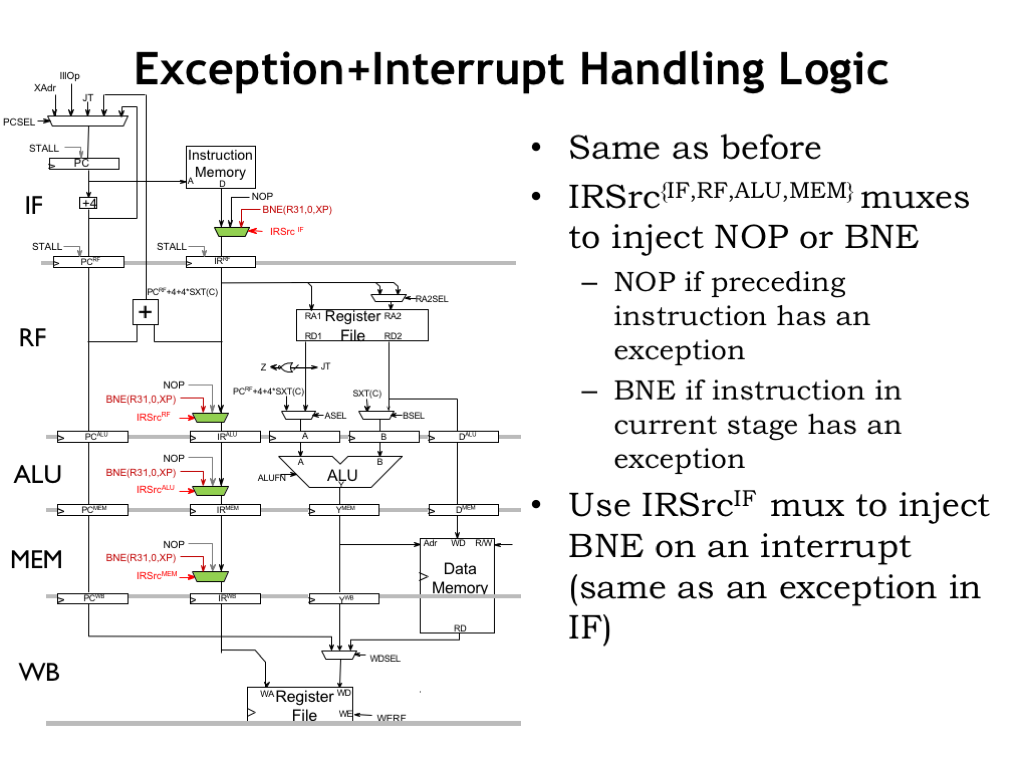
沿用指令路径 MUX;调整 IRSrc_IF:有中断请求时也为 1。

47. 五级 Beta 最终版(5-Stage Beta: Final Version)

5-Stage Beta Final Version

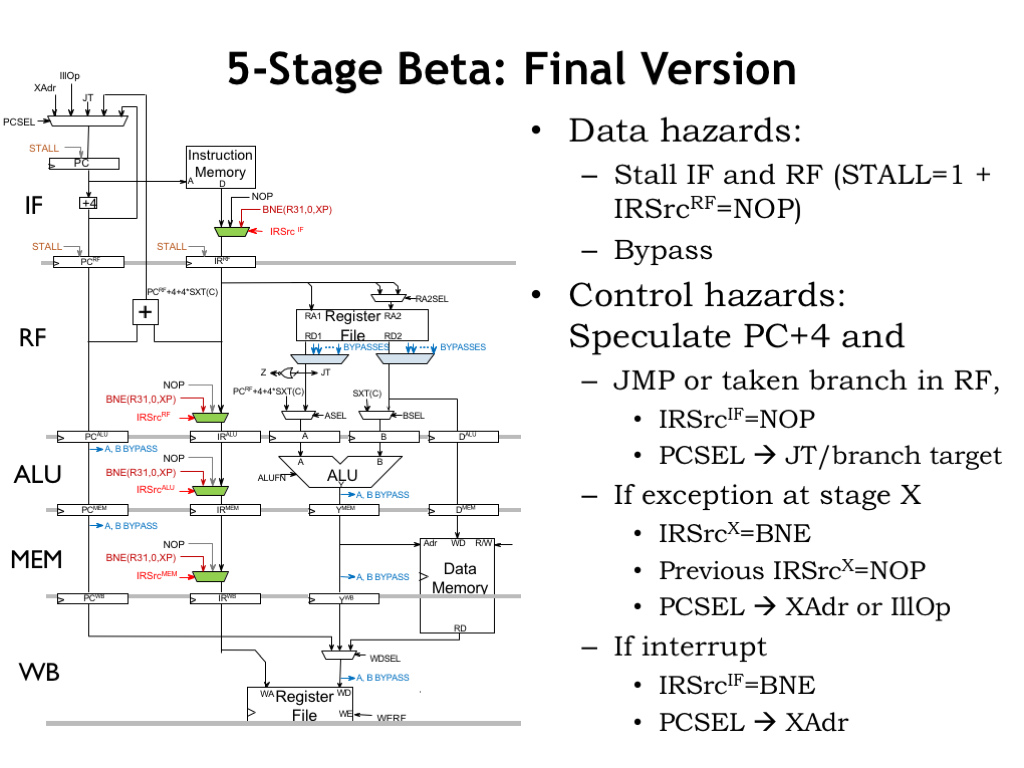
汇总:IF/RF stall + 读口 bypass MUX + stall 时向后塞 NOP;控制上默认推测 PC+4,JMP/taken 时 annul IF;异常/中断在除 WB 外各级可换指令(肇事→魔法 BNE,更早→NOP)。额外电路保证流水语义≡单周期;bypass 与分支预测使 hazard 对有效 CPI 冲击有限,短时钟换来大幅吞吐提升。

48. 回顾:解决冒险(Reminder: Resolving Hazards)

Reminder Resolving Hazards

记住三板斧:stall、bypass、speculation。高性能流水设计几乎总能落到其中之一。流水讨论至此;更高性能的其它途径(并行等)留待后续讲座。