0%

整理自 MIT OCW 6.004 Computation Structures(Spring 2017)L14 注解幻灯片。

源网页:14.1 Annotated Slides | Caches and the Memory Hierarchy

讲师:Chris Terman。图片直接引用 OCW 原站链接。

L14:高速缓存与存储层次(Caches and the Memory Hierarchy)

本讲从“Beta 其实是内存机”出发,纵览 SRAM/DRAM/Flash/硬盘,引入局部性与隐藏的存储层次;再系统讲 cache 命中率与 AMAT、直接映射 / 全相联 / NN 路组相联、块大小、替换与写回策略。

1. 我们的内存机(Our Memory Machine)
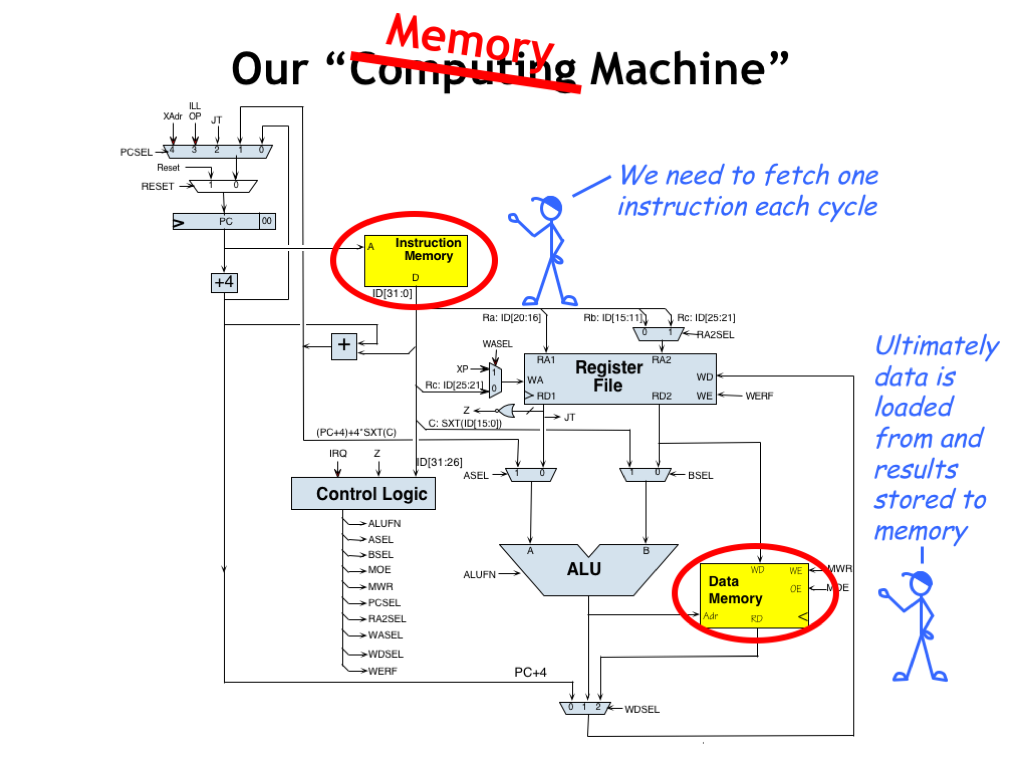
Our Memory Machine

Beta 结构简单,但三端口主存在面积与周期占比上往往最贵——更像“内存机”而非“计算机”。每条指令先取指;数据最终都经主存进出;寄存器只能留极少热数据。现代机性能常受 CPU↔主存带宽(memory bottleneck)限制。本讲目标:理解瓶颈并尽量用体系结构缓解。

2. 存储技术(Memory Technologies)
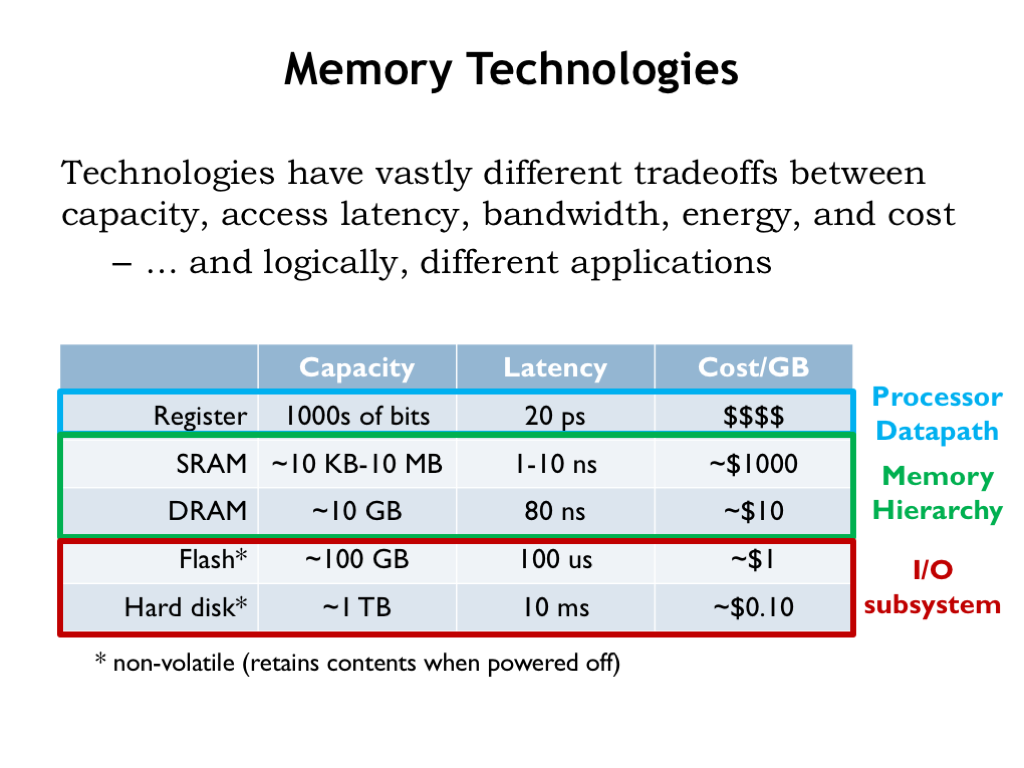
Memory Technologies
技术 特点(量级)
寄存器(时序逻辑) 延迟极低(~20 ps),容量千比特级
SRAM 低延迟(ns 级),数千~更多单元
DRAM 大容量、低成本,延迟更长
Flash / HDD 非易失;HDD 最底层、极大且便宜

容量↑ → 面积↑ → 线长/电容↑ → 更慢:根本的尺寸–性能权衡。将用 SRAM+DRAM 建层次,追求低平均延迟与高容量(依赖访问统计,最坏情况仍可能慢)。Flash 相对 HDD 类似 SRAM 相对 DRAM。

3. 静态 RAM(Static RAM)
Static RAM SRAM

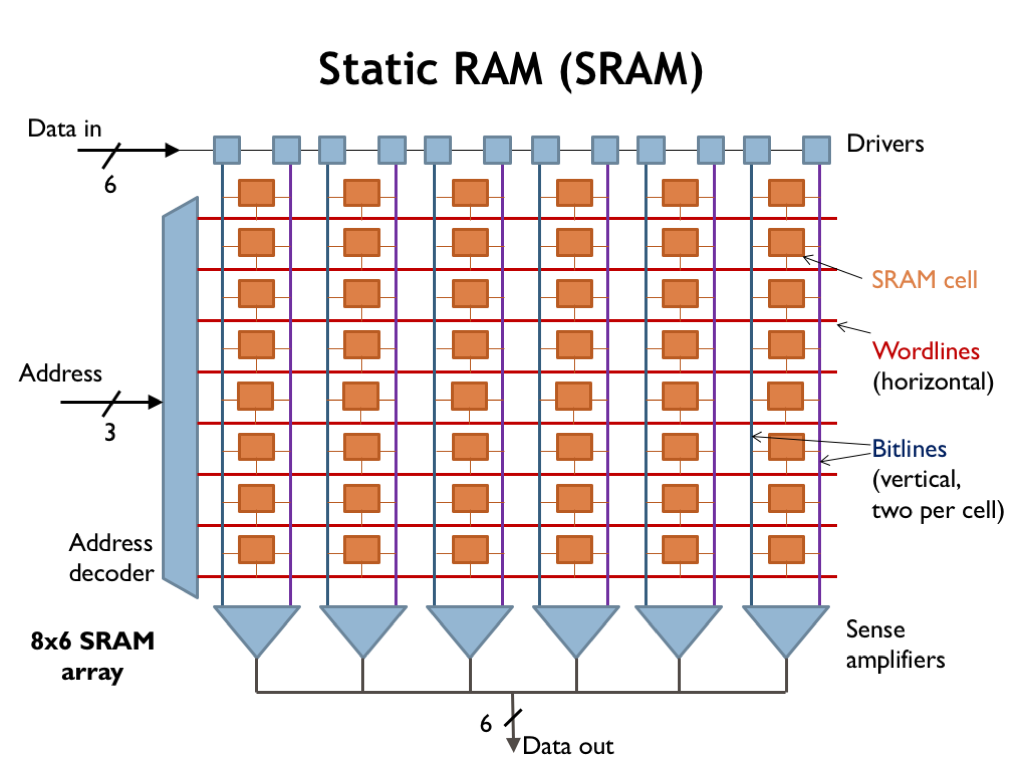
SRAM:按地址读写一整行(一个 location)。例:8 行 × 6 列 → 需 3 位地址。译码器拉高一条 wordline 选中一行;该行各单元接到垂直 bitline;读时 sense amp 把模拟差转为数字,写时驱动器把数据打上 bitline。大容量 SRAM 会组织得更复杂以缩短 bitline。

4. SRAM 单元(SRAM Cell)
SRAM Cell

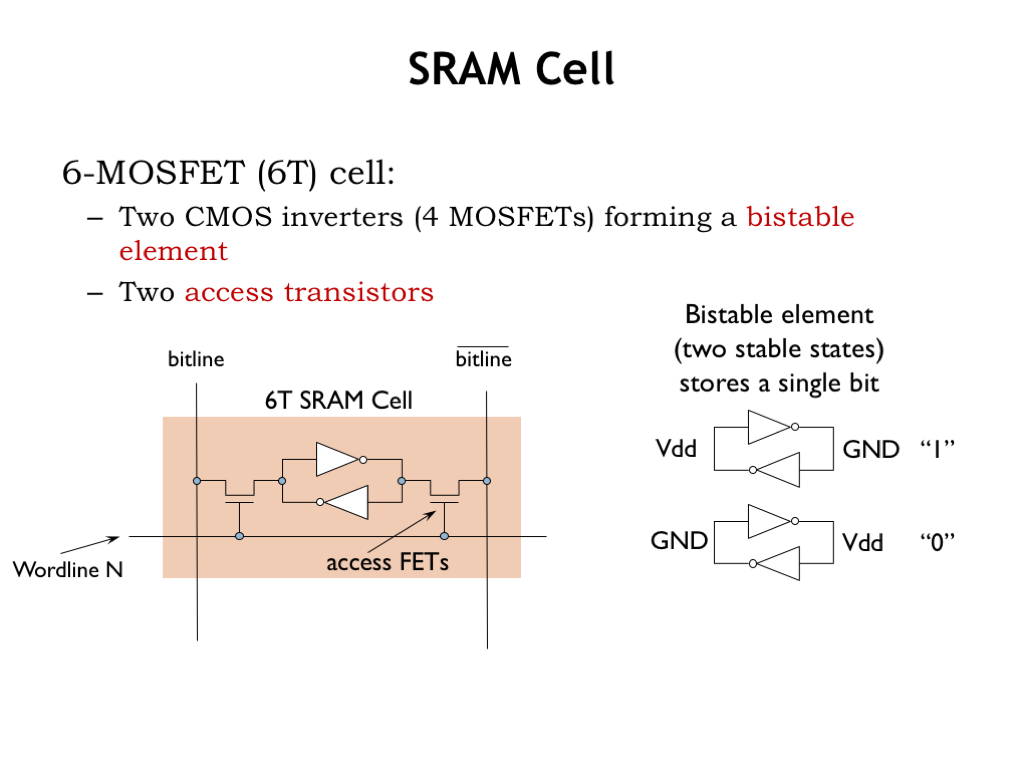
典型 6T 单元:两 CMOS 反相器正反馈形成双稳态;两侧经 access FET 接一对 bitline。wordline 高 → 接通;低 → 与 bitline 隔离,有电即可保持。

5. SRAM 读(SRAM Read)

SRAM Read

先预充 bitline 到 VDD 再浮空;拉高 wordline 后小尺寸反相器缓慢拉低一侧 bitline。Sense amp 检测微小差分电压即出数字结果——读本质是模拟;差分 + 双 bitline 提高抗噪。

6. SRAM 写(SRAM Write)
SRAM Write

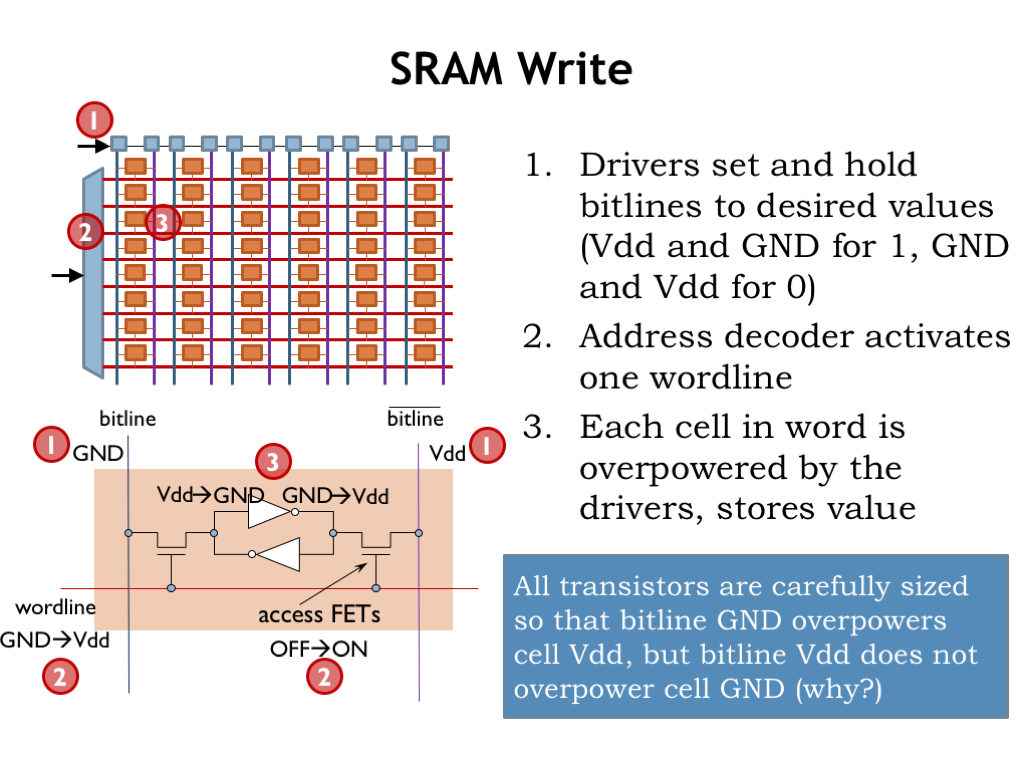
先把 bitline 驱动到目标值,再开 wordline;大驱动管压过单元内小逆变器,双稳态翻转到新态。几乎由接 0 的大 nFET 下拉完成(克服单元内小 pFET)。尺寸须仔细平衡以保证快且可靠——亦是模拟操作。

7. 多端口 SRAM(Multiported SRAMs)
Multiported SRAMs

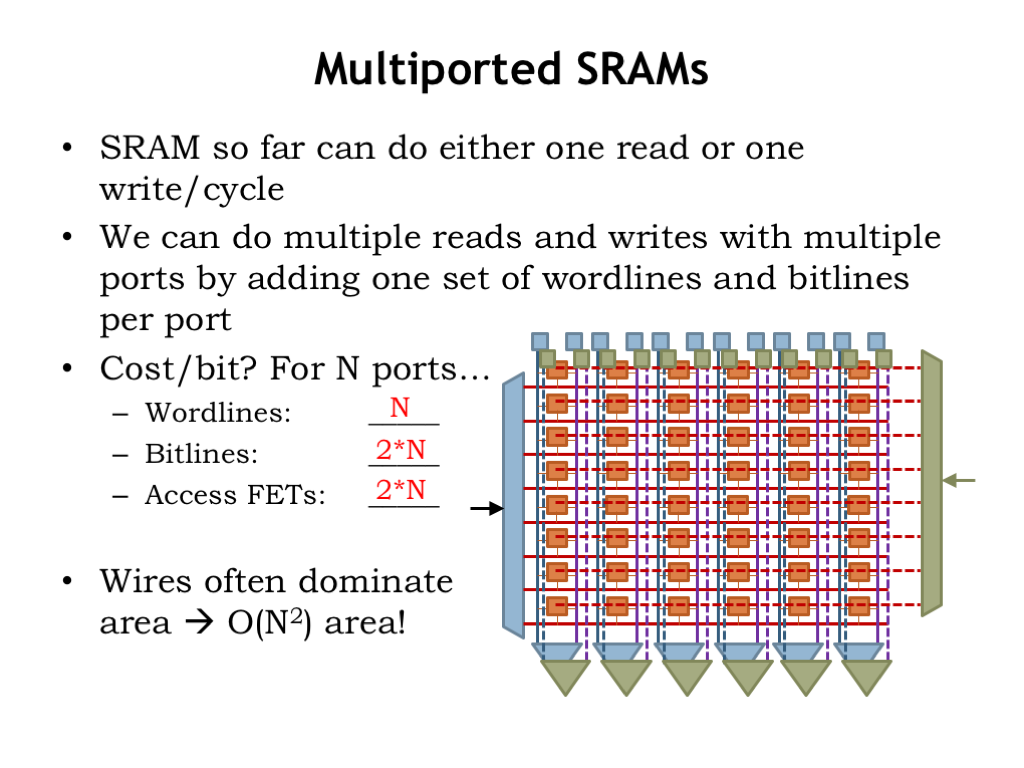
加套 wordline/bitline/驱动/sense → 多独立端口(寄存器堆常用)。每 bit 需 NN 条 wordline、2N2N 条 bitline、2N2N 个 access FET;面积大致随端口数平方增长——勿滥加端口。

8. SRAM 小结(Summary: SRAM)
Summary SRAM

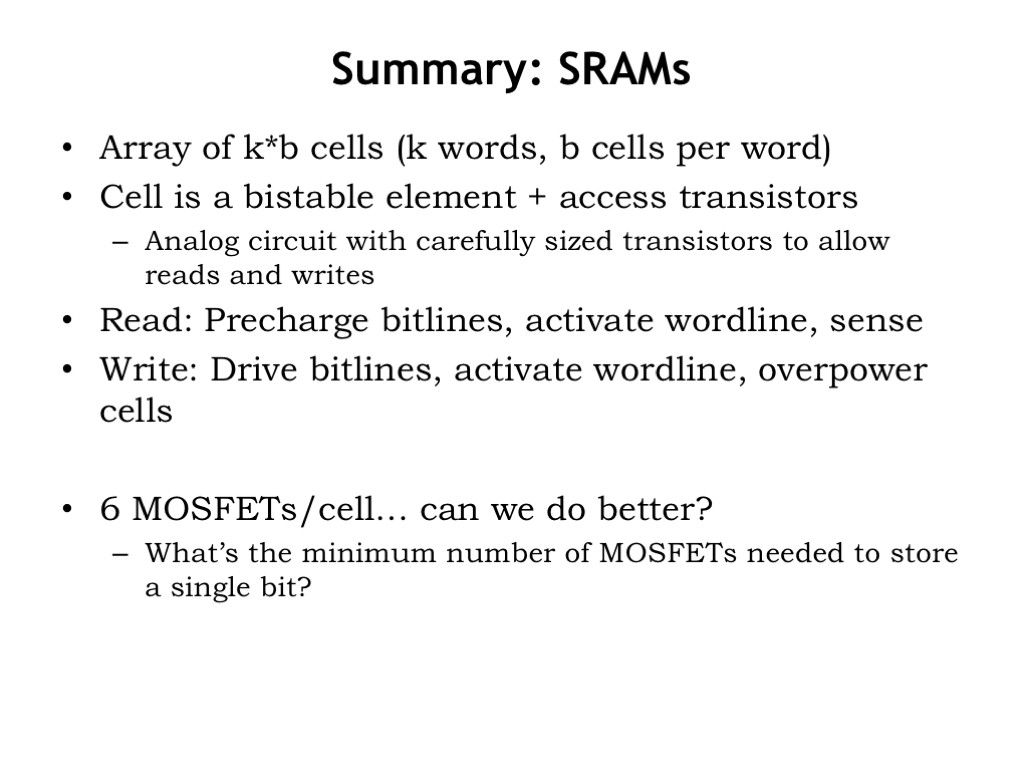
阵列组织;双稳态存 1 bit;读写经 bitline 的模拟操作;每 bit 约 6 MOSFET。能否更少?

9. 1T 动态 RAM 单元(1T Dynamic RAM Cell)
1T Dynamic RAM Cell

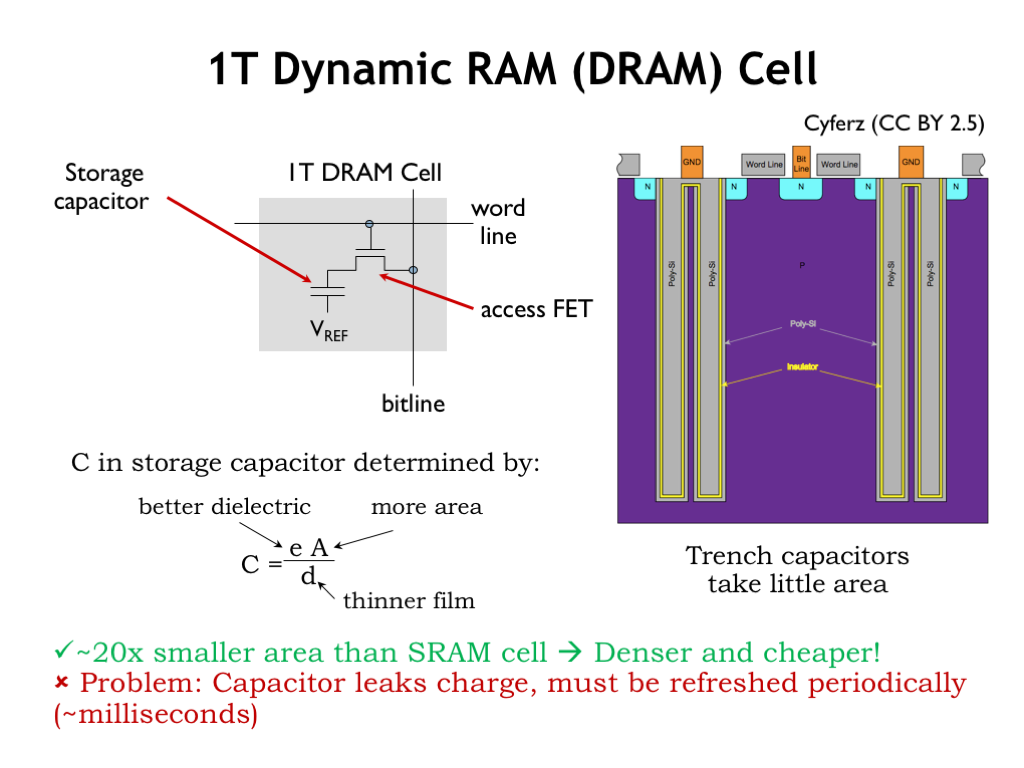
至少 1 个 access FET;用电容电压表示 0/1 → DRAM。沟槽电容增大极板面积而不占单元面积。约比 SRAM 密 20×。电荷会漏(PN 结、亚阈导通)→ 须约每 10 ms refresh(读后写回)。

10. 1T DRAM 读写(1T DRAM Writes and Reads)

1T DRAM Writes and Reads

写:开 access FET,经 bitline 充/放电。读:bitline 预充中间电压,电荷共享导致微小电压变化,sense amp 检测;读破坏性 → 须写回。常按行(row address)宽读,再用列地址选字;同行后续列访问很快(fast column access)。

11. DRAM 小结(Summary: DRAM)

Summary DRAM

1T+电容;读后重写 + 周期刷新;容量大、首访慢、同行后续快。断电丢数据 → 长期存储需非易失技术。

12. 非易失:Flash(Non-Volatile Storage: Flash)

Non-Volatile Storage Flash

电荷存在绝缘良好的浮栅上,可保持数年。有无电荷改变导通阈值;测电流甚至可多电平存多 bit。NOR 读延迟近 DRAM(数十 ns);NAND 读更慢(~10 µs);写需高压,慢,且擦写次数有限(105∼10610^5\sim 10^6)→ 片上地址重映射磨损均衡。相对 HDD:更快但更贵。

13. 非易失:硬盘(Non-Volatile Storage: Hard Disk)
Non-Volatile Storage Hard Disk

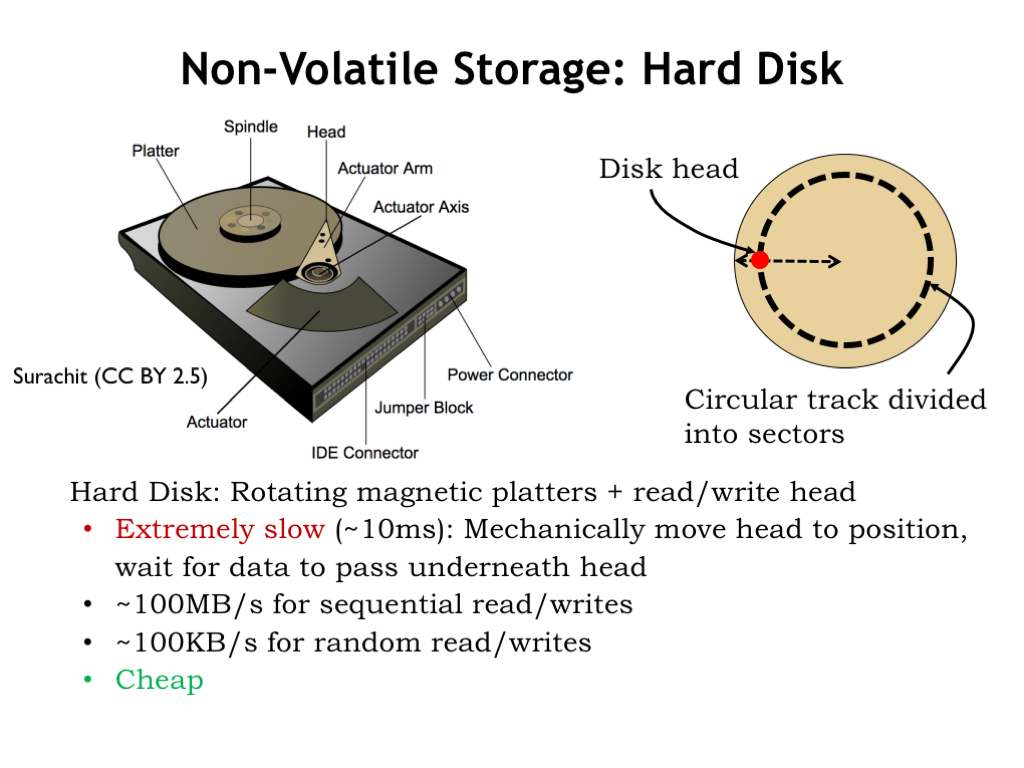
磁性盘片 5400–15000 RPM;磁头寻道 + 旋转等待,平均访问约 10 ms。就位后传输可达 ~100 MB/s;频繁寻道则有效速率骤降。TB 级廉价非易失,代价是慢。

14. 存储技术小结(Summary: Memory Technologies)

Summary Memory Technologies

容量跨约 10 个数量级,延迟约 8 个。SRAM 跟得上工艺;DRAM/HDD 容量与带宽进步快,首访延迟进步慢;Flash 填补 CPU–HDD 间隙。每层都是:更小更快 vs 更大更慢——能否兼得?

15. 存储层次接口(Memory Hierarchy Interface)
Memory Hierarchy Interface

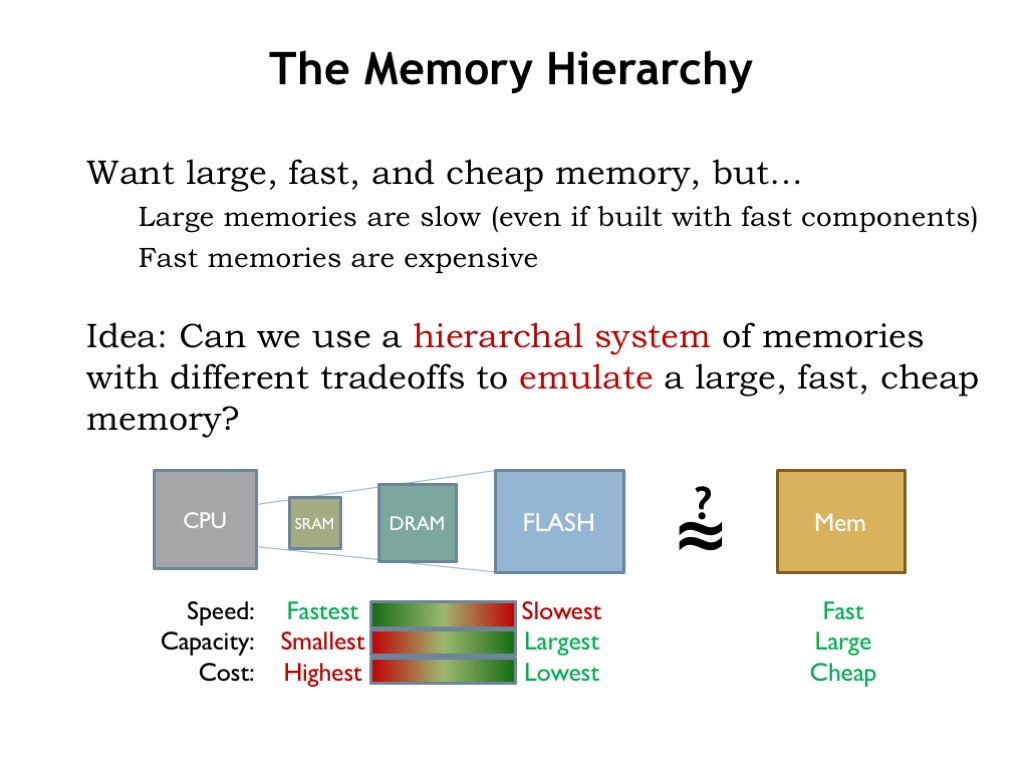
理想:大、快、便宜的统一主存。单技术做不到 → 用不同权衡的层次:常访问数据放快层(SRAM),其余在慢大层,必要时搬移。

16. 存储层次接口(续)(Memory Hierarchy Interface continued)
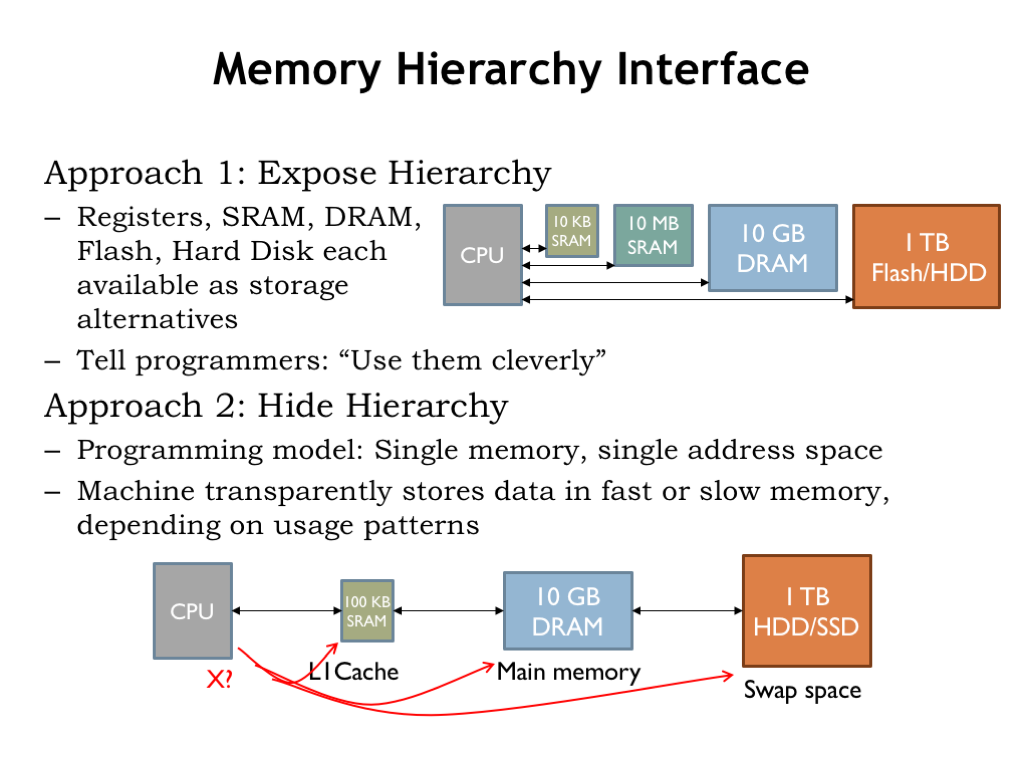
Memory Hierarchy Interface continued

两条路:

  1. 暴露层次:程序员显式搬数据(如 Seymour Cray 向量机)。
  2. 隐藏层次:给程序员平坦大地址空间;硬件按访问模式在层间自动搬移。

Cray 曾怀疑自动方案(“you can’t fake what you haven’t got”)。对通用程序,自动层次+局部性往往够好——引出 cache。

17. 局部性原理(The Locality Principle)
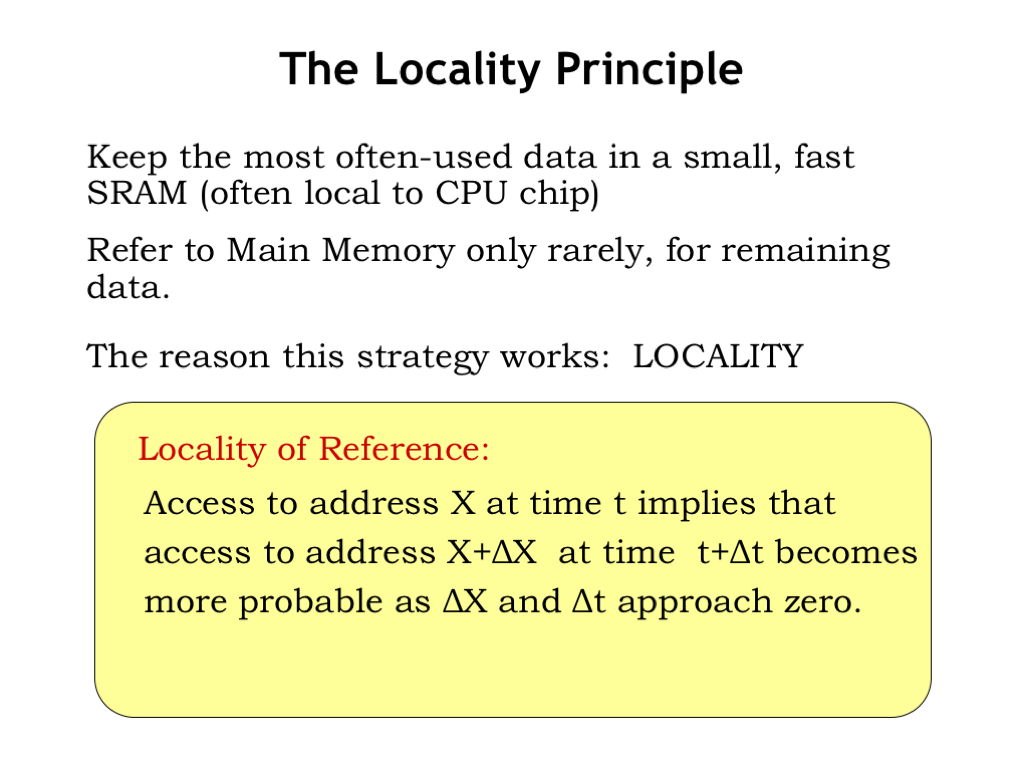
The Locality Principle

希望把频繁访问数据放在快 SRAM,并预测将访问何处;一次搬入的块应被多次命中以摊销搬移开销。局部性(locality of reference):时刻 tt 访问地址 XX → 不久很可能会访问附近地址。

18. 访存模式(Memory Reference Patterns)
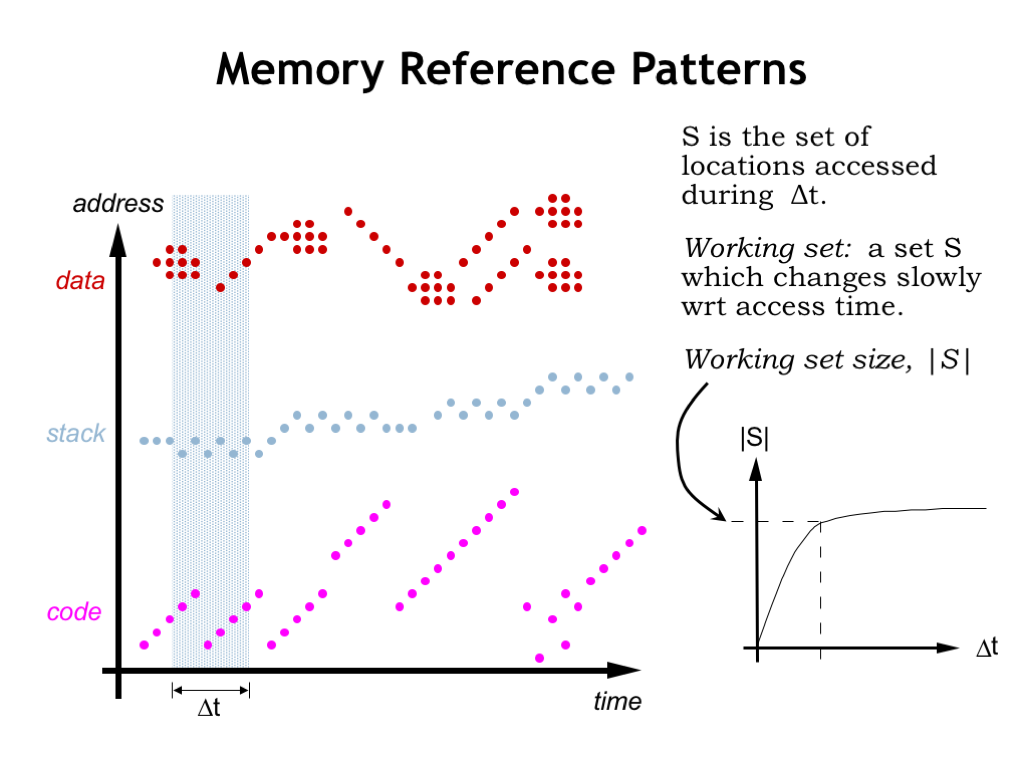
Memory Reference Patterns
  • 取指:大多顺序;循环反复同一段;调用/分支打断后很快恢复顺序。过程入口后几乎会跑完整过程代码 → 整块搬入 SRAM 有利;DRAM 快列访问摊销首访。
  • 栈帧:过程期间密集访问小区域。
  • 数据:结构体字段、数组步进、区域间拷贝等也有局部性。

工作集(working set):某时间窗内访问的不同地址数;窗变大后规模趋于平稳。

19. 高速缓存(Caches)
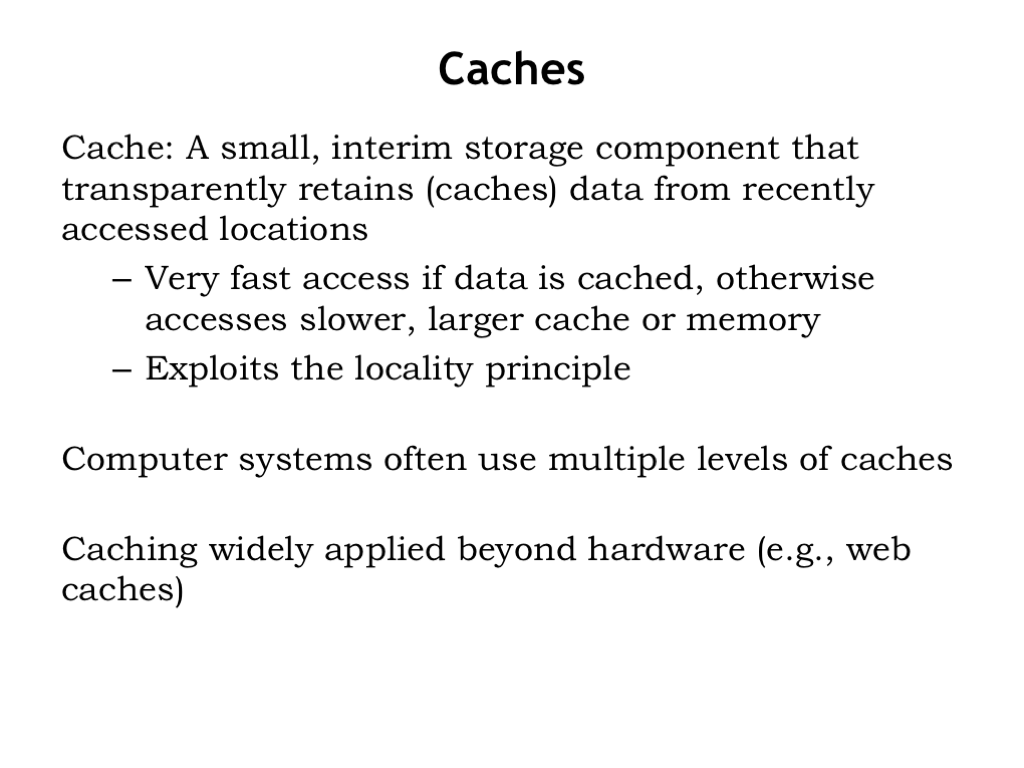
Caches

层次中靠近 CPU 的 SRAM 称 cache。命中(hit)由 SRAM 供数;缺失(miss)从 DRAM 搬入含该地址的块。局部性 ⇒ 命中远多于缺失。可有多级:近 CPU 更小更快,miss 查下一级。浏览器网页缓存是同思想。

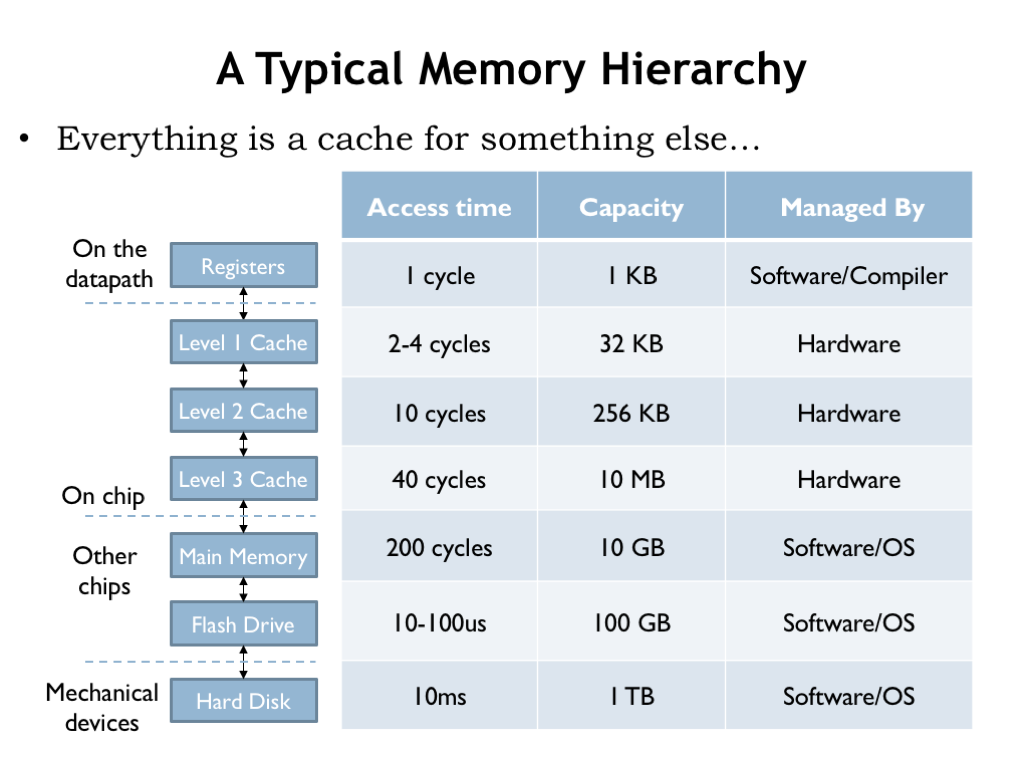
20. 典型存储层次(A Typical Memory Hierarchy)
A Typical Memory Hierarchy

例:片上 L1/L2/L3 SRAM → DRAM 主存 → Flash 作 HDD 缓存。寄存器由编译器管理;片上 cache 与 DRAM 访问由硬件;更慢层常由软件管理。每层都试图对下一慢层的热数据提供更低延迟。

21. Cache 访问(Cache Access)
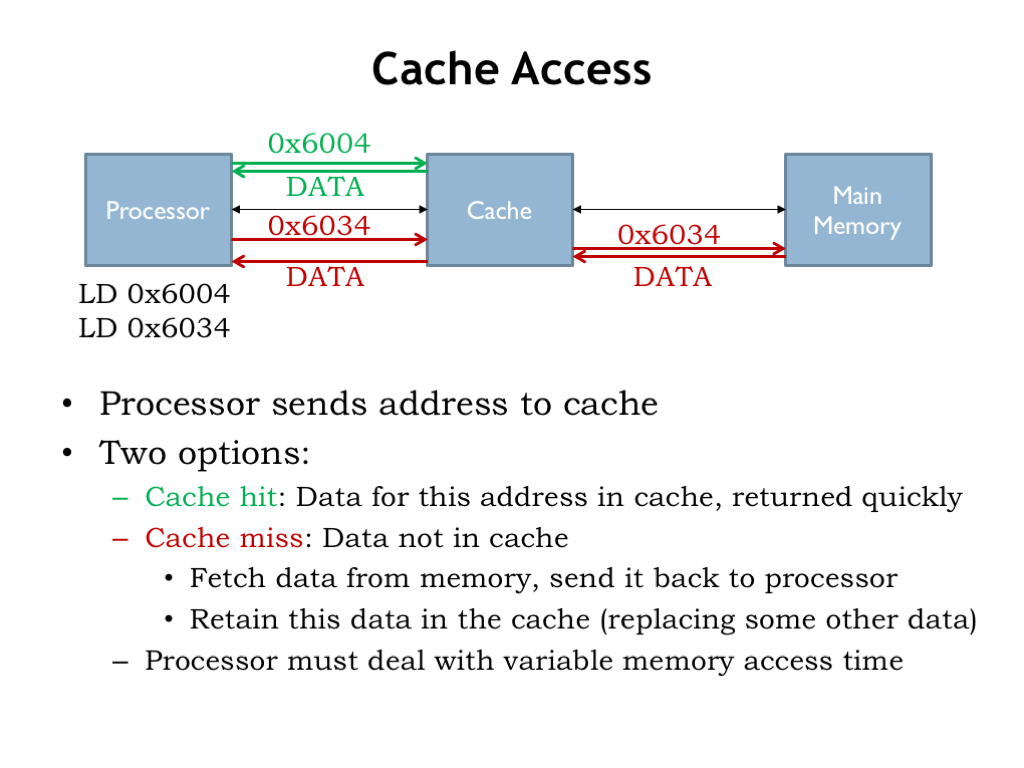
Cache Access

CPU 发地址:命中则快返回;缺失则请主存、常把新数据写入 cache(可能替换旧块)。例:cache 4 ns、主存 40 ns → 命中 4 ns,缺失约 44 ns。CPU 须处理可变延迟(等待或切线程)。

22. Cache 指标(Cache Metrics)

Cache Metrics

命中率 + 缺失率 =1=1。平均访存时间:

AMAT=thit+miss_ratio×tmiss_penalty\mathrm{AMAT} = t_{\mathrm{hit}} + \mathrm{miss\_ratio}\times t_{\mathrm{miss\_penalty}}

每层可递归套用。更大更慢的下一级:hit time↑,但 miss ratio↓。

23. 例:命中率要多高?(Example: How High of a Hit Ratio?)
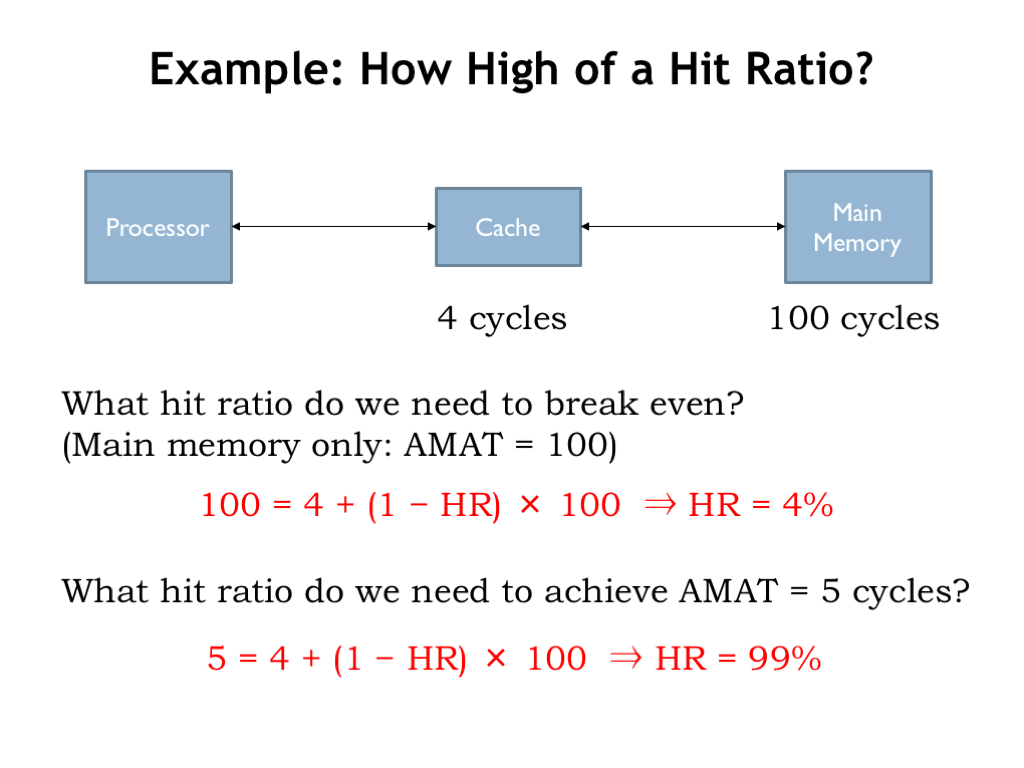
Example How High of a Hit Ratio

cache 4 周期、主存 100 周期:无 cache 恒 100;有 cache:命中 4、缺失 104。AMAT=100(打平)只需约 4% 命中率;目标 AMAT=5 则需约 99% 命中。SPEC CPU2000 上典型 L1 约 97.5%(约 101310^{13} 次访问)。

24. 基本 Cache 算法(Basic Cache Algorithm)
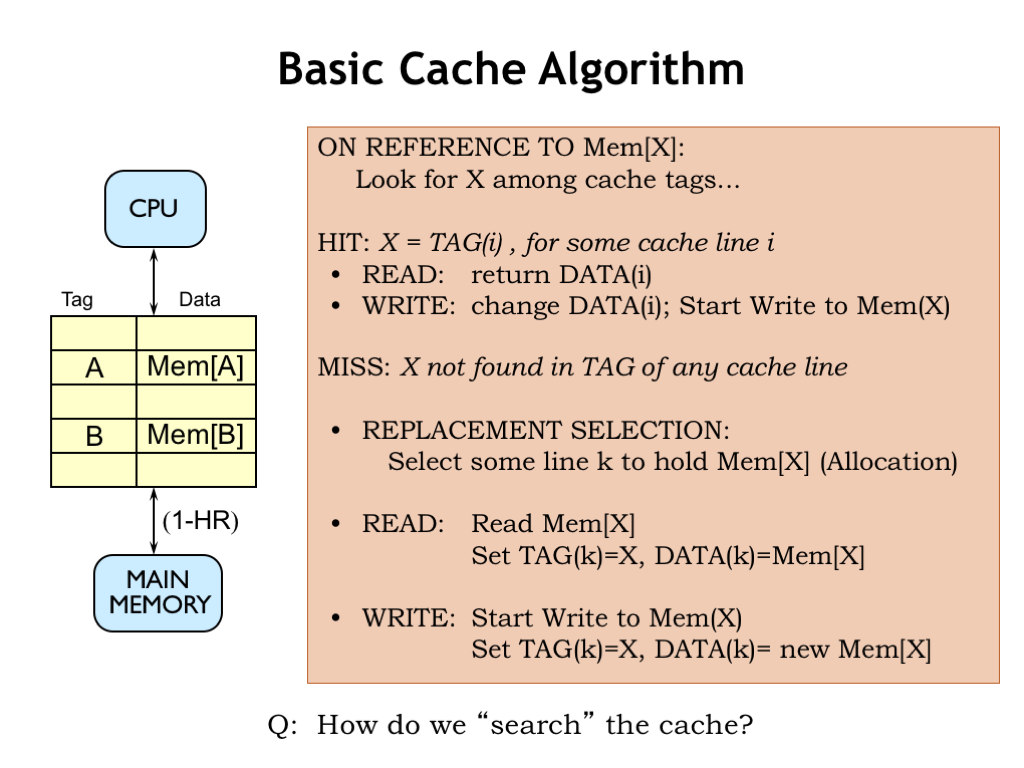
Basic Cache Algorithm

每条 cache line = 数据块 + 地址 tag。按 tag 搜索:命中则读返回/写更新(并最终更新主存);缺失则选一行替换,读则从主存填入,写则更新该行。内容由 CPU 请求塑造;工作集装得下 → AMAT 接近 hit time。关键:如何快速判断 tag 是否在某行。

25. 直接映射 Cache(Direct-Mapped Caches)
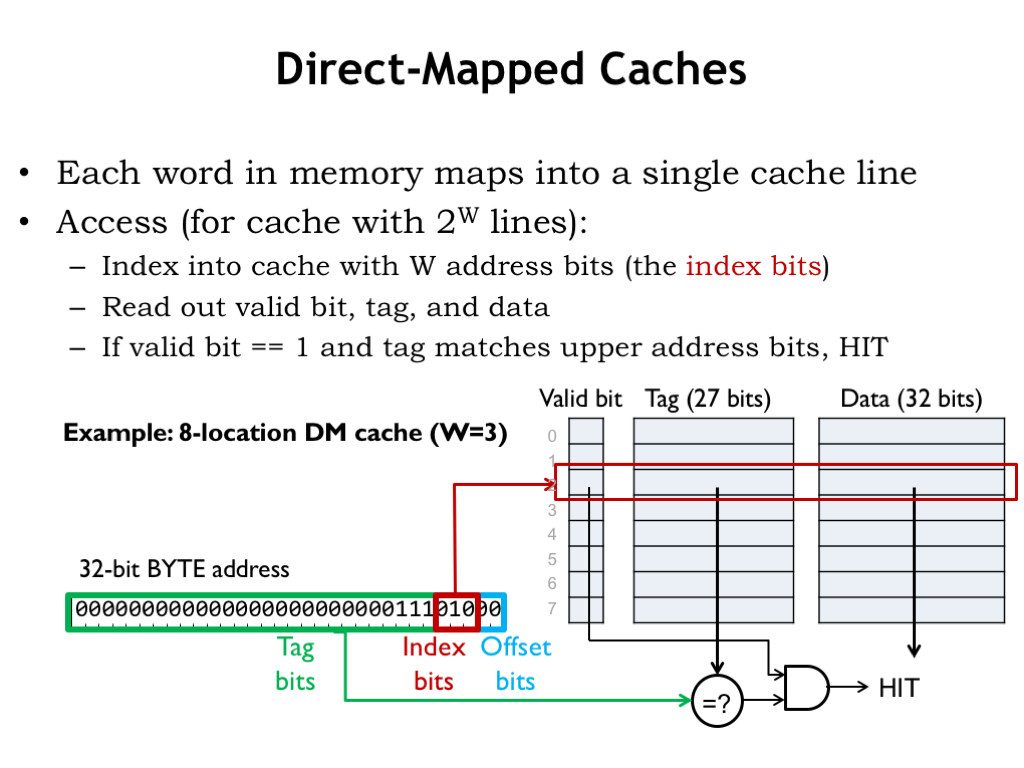
Direct-Mapped Caches

每个主存地址映射到唯一一行(DM cache)。用地址低部作 index 选一行,其余与该行 tag 比较;另有 valid 位(上电清 0)。字偏移:字寻址时低 2 位作 byte offset。index 取自低位地址位,使相邻地址映射到不同行,利于局部性。CPU 可 flush 使某些行无效(如 DMA 写入后)。

26. 直接映射示例(Example: Direct-Mapped Caches)

Example Direct-Mapped Caches

64 行 DM:地址拆成 offset / index / tag。例:0x400C → index=3、tag=0x40,行 3 tag 匹配 → 命中。0x4008 → index=2,tag 不匹配 → 缺失。由某行的 tag+index 可反推完整缓存地址(如 tag 同为 0x58 的行 0/1/2 → 0x5800/04/08)。

27. 块大小(Block Size)
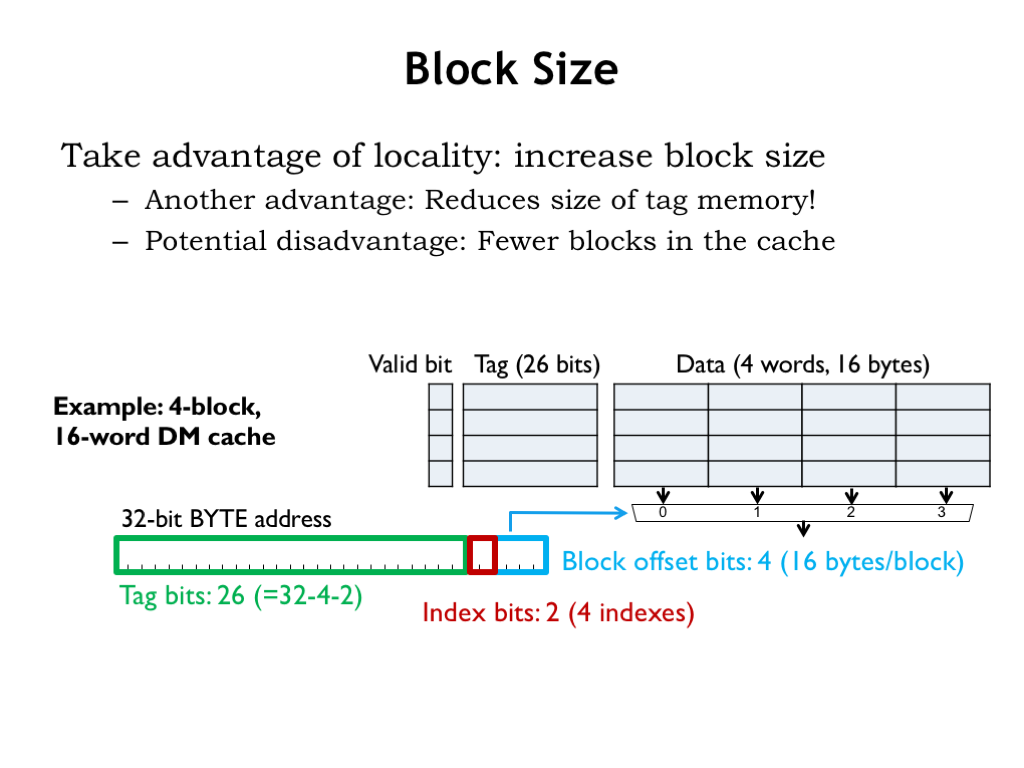
Block Size

每行可存 2k2^k 个字(block size)。缺失时多取几个字,摊销 miss、提高后续命中;tag/valid 开销占比下降(例:4 字块 ~17% vs 1 字块 ~46% 开销)。整块要么全在要么全不在(单 valid);局部性下通常值得整块装入。

28. 块大小权衡(Block Size Tradeoffs)
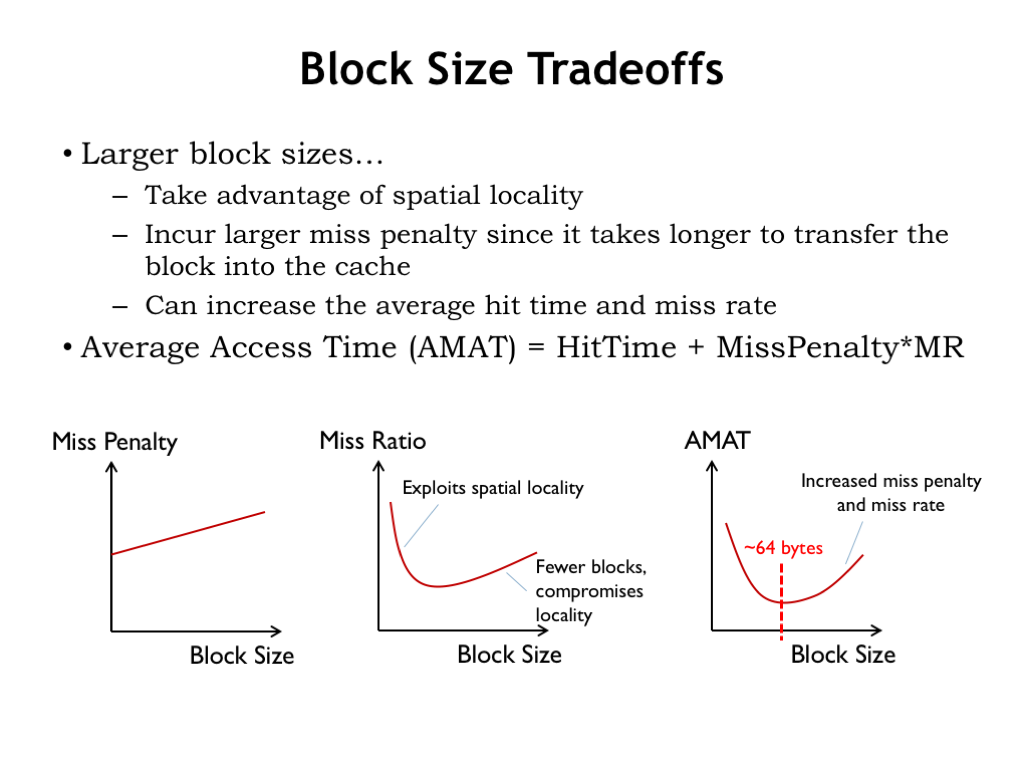
Block Size Tradeoffs

块↑ → miss penalty 近似线性↑(DRAM 首访贵,后续列访问缓和);miss ratio 先降。容量固定时块↑ ⇒ 行数↓ ⇒ 能同时容纳的独立地址区域变少,过大反伤工作集。存在最优块大小;现代常见 64 B(16 字)。用 AMAT 综合选取。

29. DM 的问题:冲突缺失(Direct-Mapped Cache Problem: Conflict Misses)
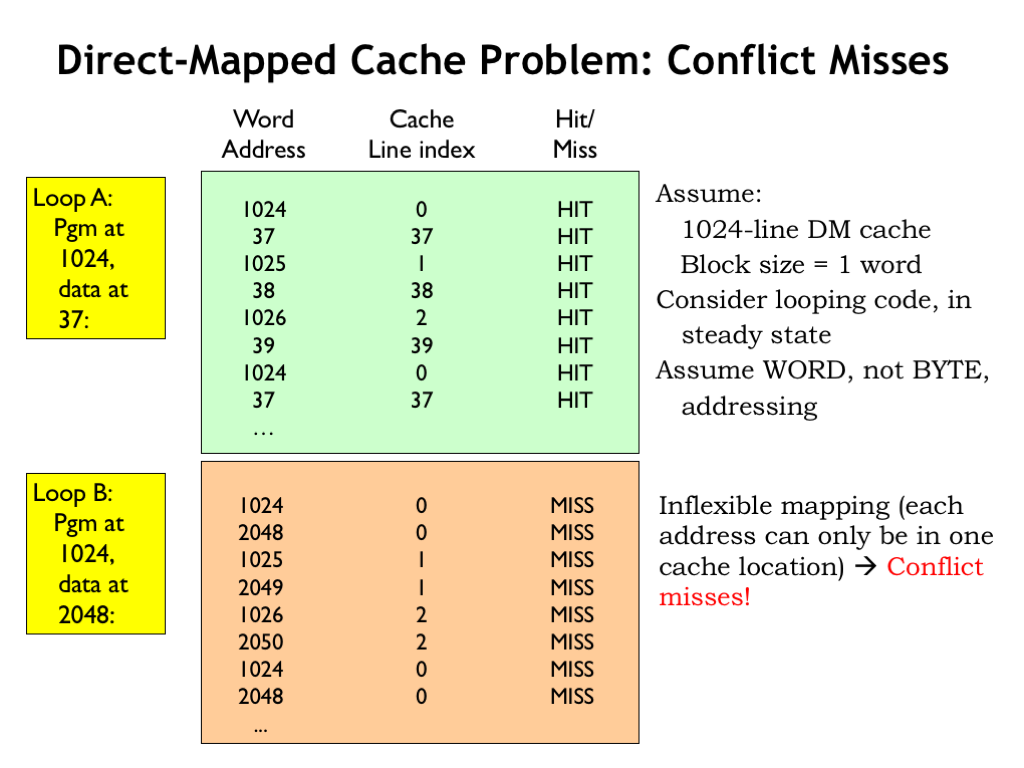
Direct-Mapped Cache Problem Conflict Misses

代码与数据若映射到相同行,会互相踢出 → conflict miss,稳态命中率可从 100% 掉到 0%,程序突然慢一个数量级——破坏“平坦地址空间”抽象。需改进结构。

30. 全相联 Cache(Fully-Associative Cache)
Fully-Associative Cache

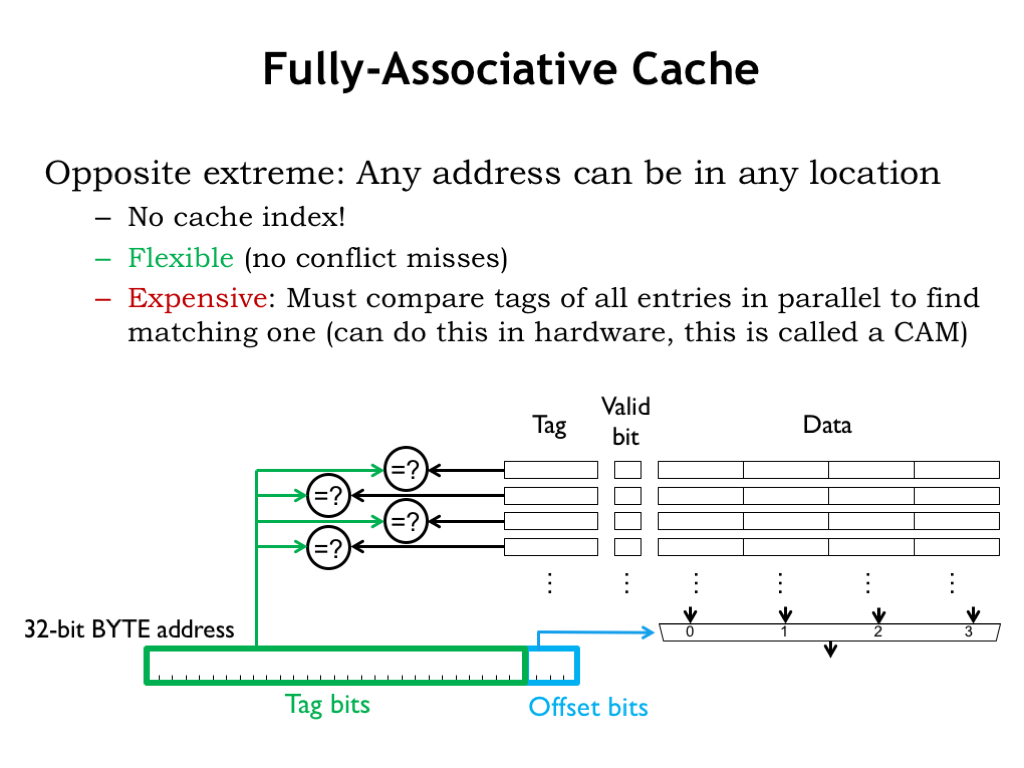
FA:每行都有比较器,并行比所有 tag → 任意块可进任意行,无地址冲突。灵活、命中率高;代价是比较器随行数线性涨(CAM 也难根本解决)。DM 只查 1 行,FA 查全部——中间地带?

31. N 路组相联 I(N-way Set-Associative Cache I)
N-way Set-Associative Cache I

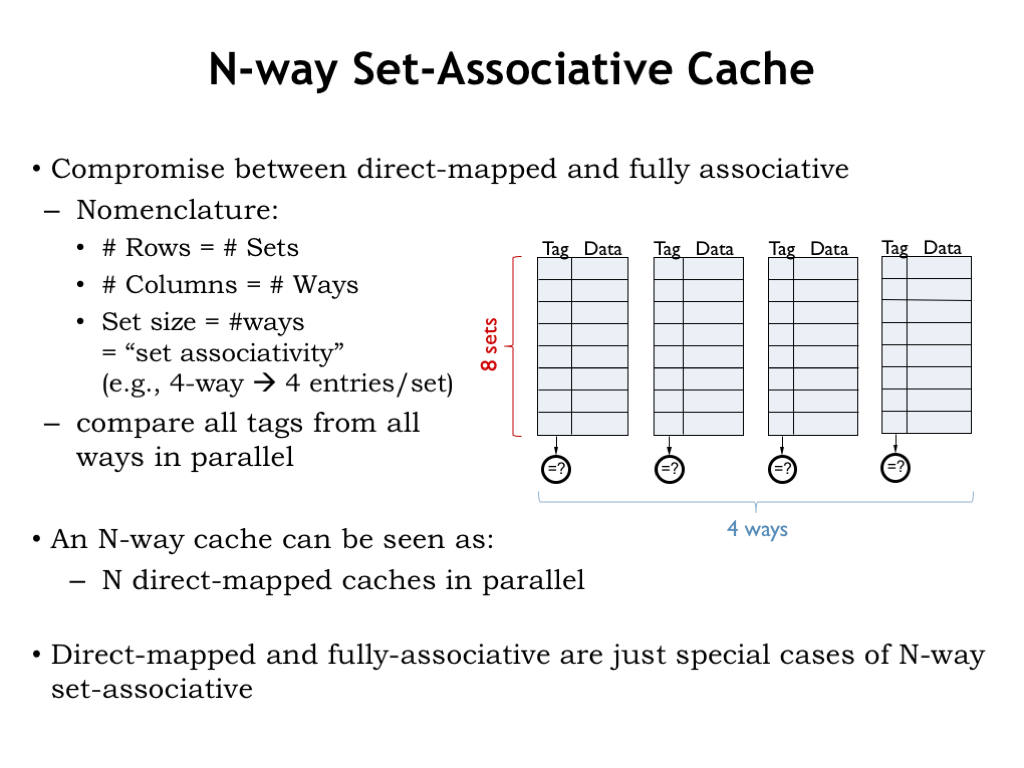
NN-way SA:相当于 NN 个 DM 子 cache 并行。同一 index 的 NN 行组成一个 set;地址冲突最多可容 NN 个块。比较器只需 NN 个,可有大量行。在冲突敏感的 DM 与昂贵 FA 之间折中。

32. N 路组相联 II(N-way Set-Associative Cache II)
N-way Set-Associative Cache II

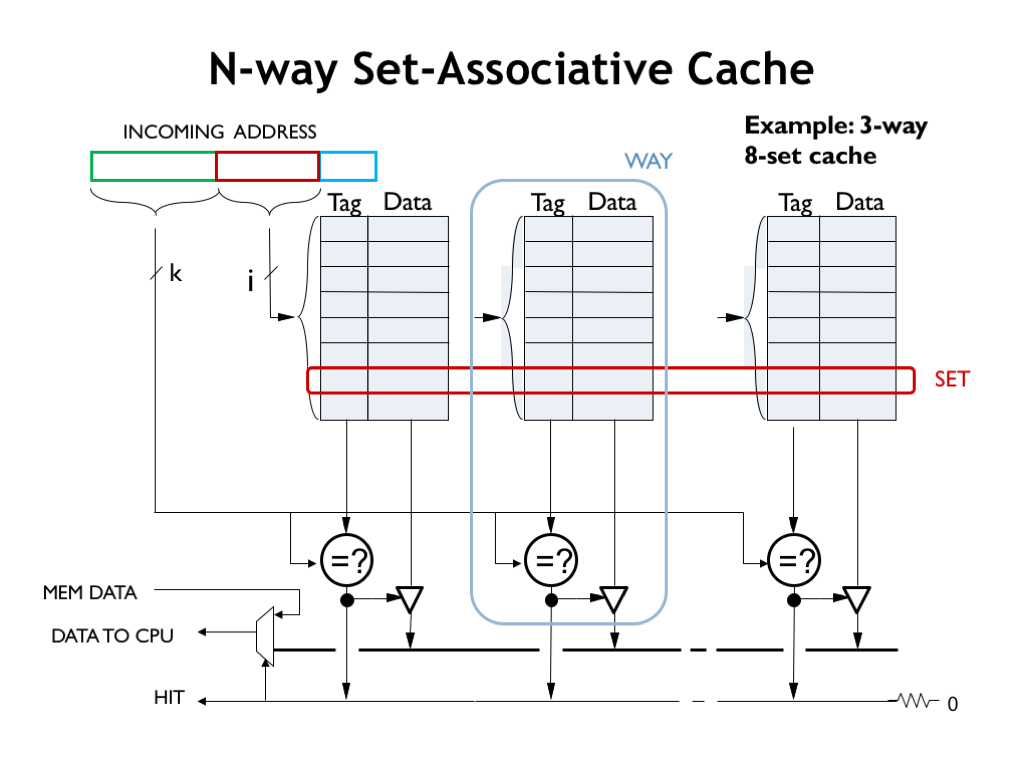
术语:set = 同 index 的 NN 行;way = 每个子 cache。路数不必是 2 的幂。管理保证同一地址不会出现在多 way(miss 时只写入一路)。

33. “数一数有几路”(Let me count the ways)
Let me count the ways

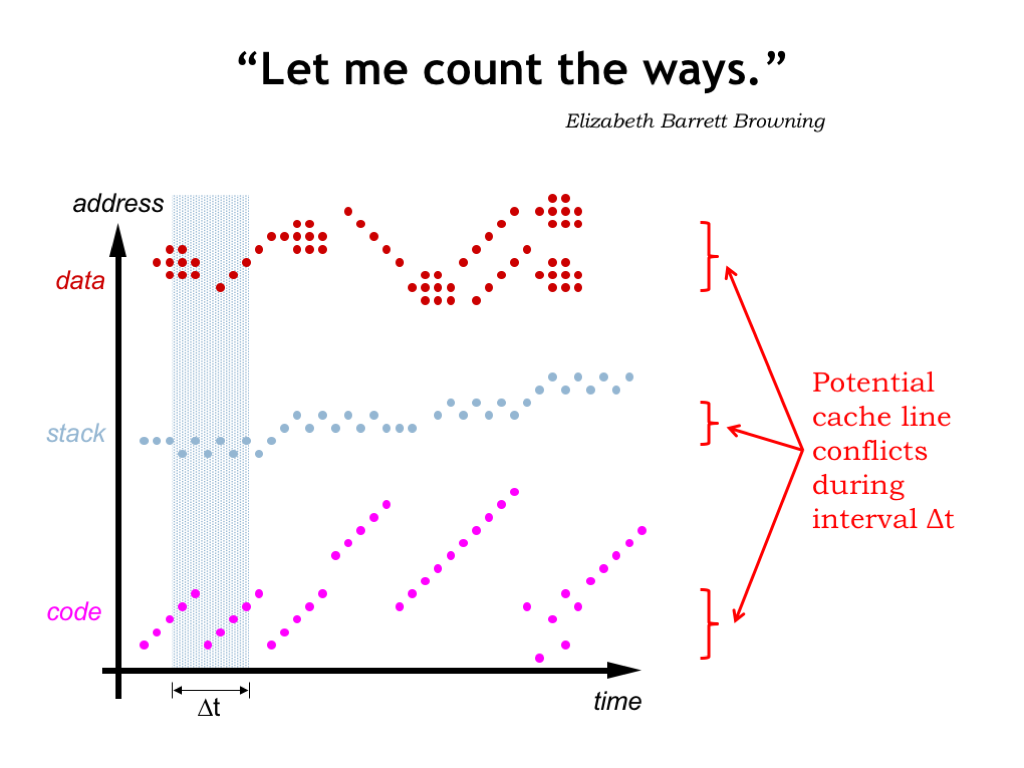
所需路数大致对应时间窗内可能冲突的区域数(代码、栈、数据,拷贝时或需两块数据区);大时间窗或再加倍。小数目的 way 通常足以消除绝大多数冲突。

34. 相联度权衡(Associativity Tradeoffs)

Associativity Tradeoffs

路数过多:合并 hit 信号的延迟抬高 hit time;miss ratio 在约 4–8 路后收益很小。大容量 8-way SA 常接近同容量 FA。

35. 相联意味着选择(Associativity Implies Choices)
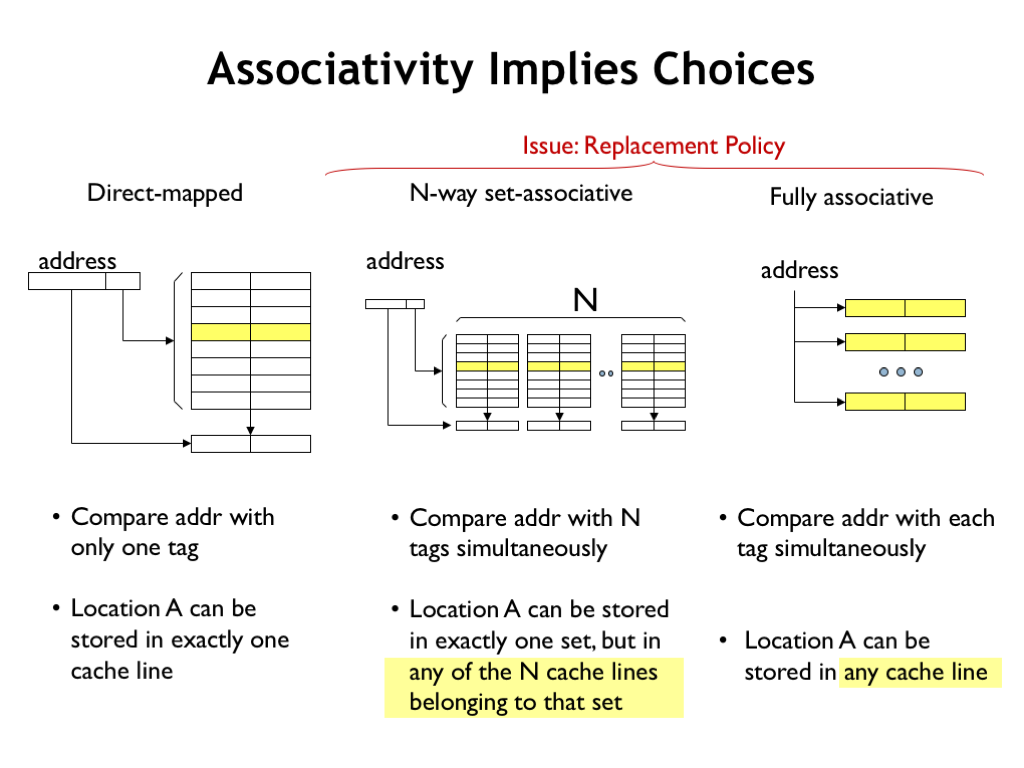
Associativity Implies Choices

Miss 时选哪一行替换?DM 无选择;SA/FA 有。目标:选对未来命中率损害最小的那一行。

36. 替换策略(Replacement Policies)
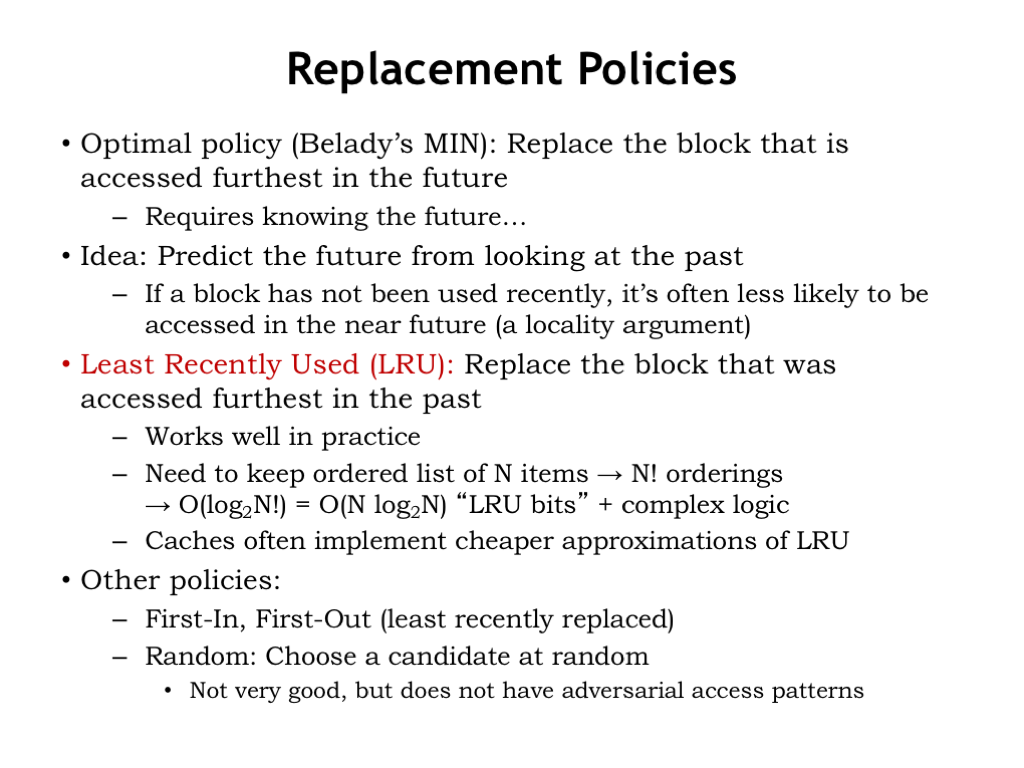
Replacement Policies

最优:换掉最远将来才用(或永不用)的块——需预知未来。实用:LRU(least-recently-used)用过去近似未来。精确 LRU 状态大(8-way:8!8! 序 → 约 16 bit)且更新逻辑贵 → 常用近似。其他:FIFO、随机。除随机外都可被恶意访问模式打穿;实践中 LRU/近似 LRU 仍合理。

37. 写策略(Write Policy)
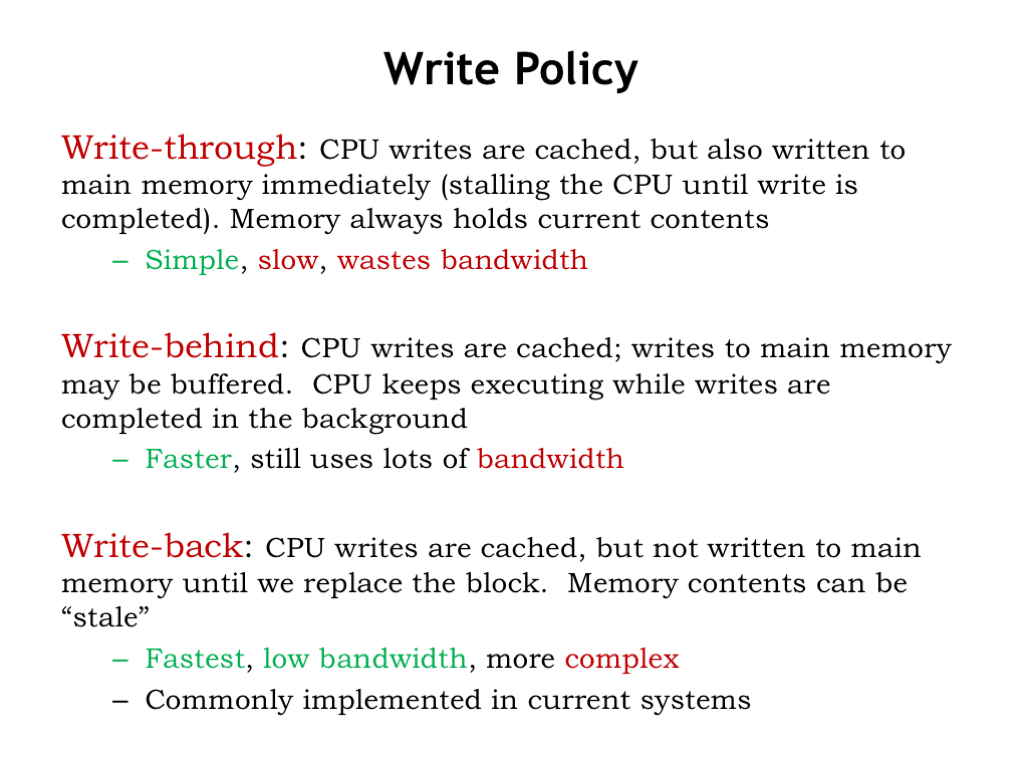
Write Policy
  • Write-through:写 cache 同时写主存——主存始终新,但写可能成瓶颈;热局部变量反复写浪费带宽。
  • Write-behind:CPU 不等写完继续跑,重叠延迟;若随后 miss,仍须等写与填完成。
  • Write-back:只改 cache,换出时才写回主存——最少写主存,现代主流。

38. 写回(Write-Back)

Write-Back

写请求只更新 cache。替换时须先把旧行写回主存(若可能已被改过)——否则会写回从未写过的行,浪费带宽。

39. 带 Dirty 位的写回(Write-Back with Dirty Bits)
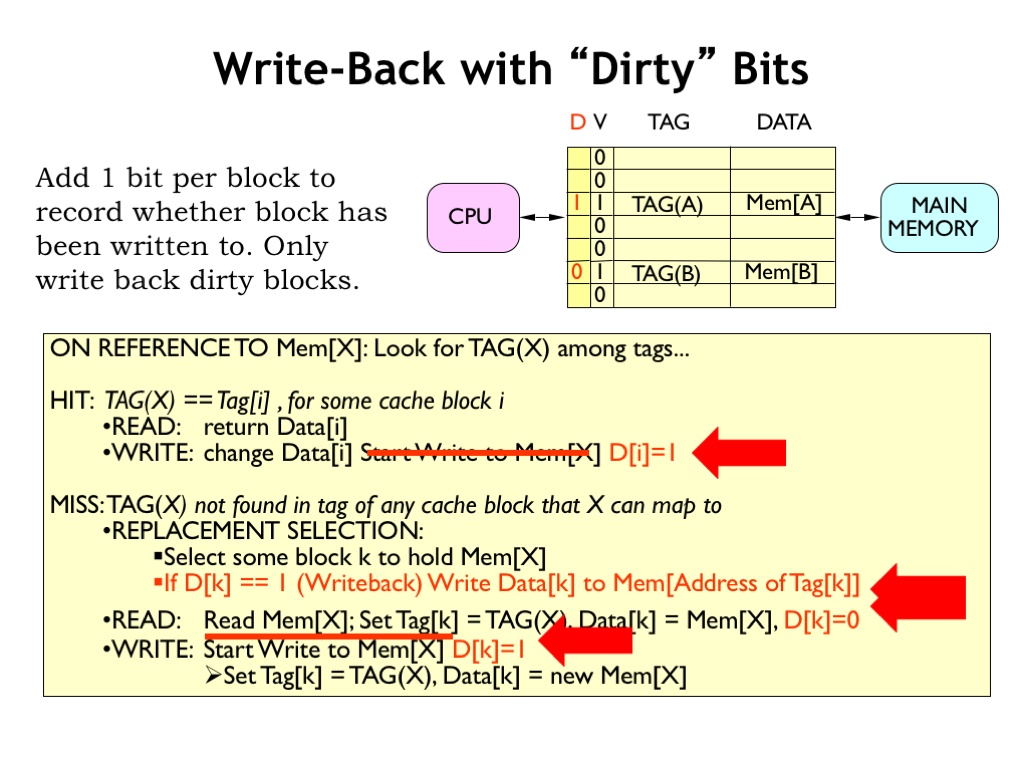
Write-Back with Dirty Bits

每行加 dirty 位:填入时清 0;写命中置 1。仅 dirty=1 时换出才写回。CPU 只在 miss(且可能需写回脏行)时等待。

40. 小结:Cache 权衡(Summary: Cache Tradeoffs)

Summary Cache Tradeoffs

目标:层次存储 → 低 AMAT + 高容量。手段:更多行↓ miss ratio;合适块大小利用 DRAM 列突发;更多 way↓ 冲突;LRU(近似)选替换;write-back + dirty。最终用基准仿真在各项之间取最优组合。
整理自 MIT OCW 6.004 Computation Structures(Spring 2017)L13 注解幻灯片。

源网页:13.1 Annotated Slides | Building the Beta

讲师:Chris Terman。图片直接引用 OCW 原站链接。

L13:构建 Beta(Building the Beta)

本讲增量搭建单周期 Beta:寄存器堆、ALU / 访存 / 分支 / LDR 数据通路,以及异常与中断;并汇总控制信号 ROM 方案。目标是“每时钟一条指令”的可工作 32 位 RISC。

1. CPU 设计权衡(CPU Design Tradeoffs)

CPU Design Tradeoffs

正确执行 Beta ISA 是底线;还要权衡:性能(常用 MIPS = Millions of Instructions Per Second)、芯片面积(成本)、性能/价格、性能/瓦特等。Intel 8080(1974)约 0.29 MIPS;现代多核可达 104∼10510^4\sim 10^5 MIPS。Apple Watch 与高端桌面目标集不同。

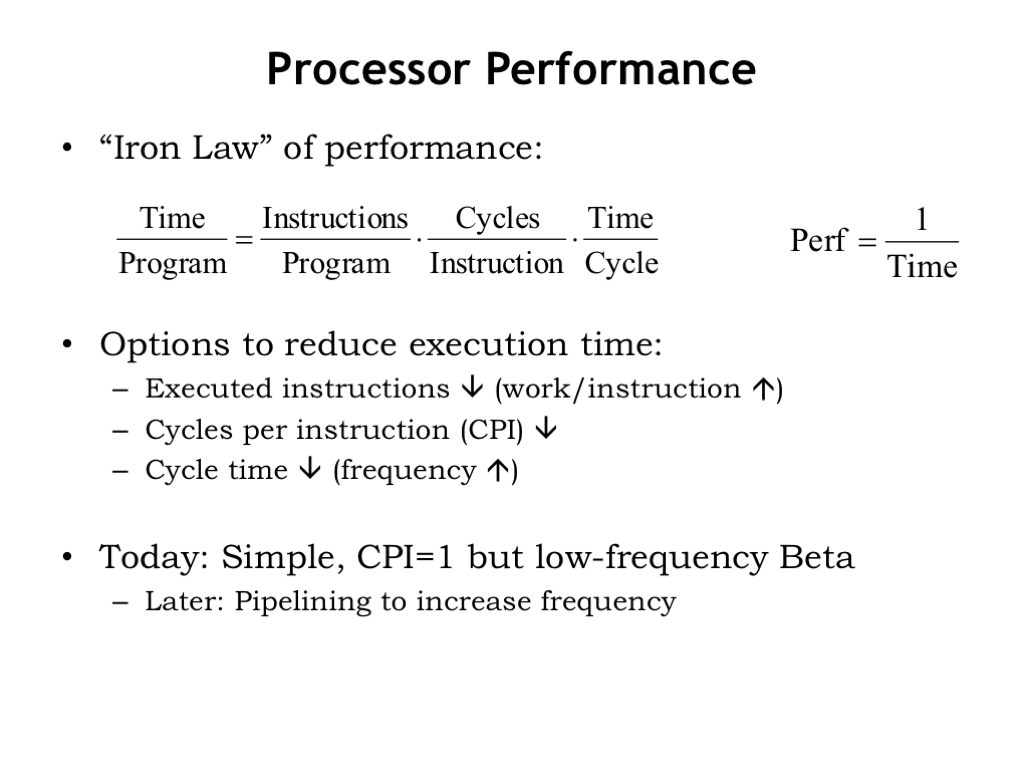
2. 处理器性能(Processor Performance)

Processor Performance

执行时间 ∝\propto 程序指令数 ×\times 每条平均时钟数 ×\times 时钟周期。可减少指令数、降低 CPI、或缩短周期(简化逻辑)。本讲实现每时钟一条指令;组合路径较长,日后可用流水线提吞吐。

3. 回顾:Beta ISA(Reminder: Beta ISA)

Reminder Beta ISA

32 个 32 位寄存器。两类主要格式:

  • opcode 高 2 位 0b10:双寄存器操作数(Ra、Rb)→ Rc
  • 高 2 位 0b11:第二操作数为 16 位常量(−32768∼32767-32768\sim 32767);助记符加 C;访存与分支也用此格式

操作含算术、比较、布尔、移位。仅两种格式 → 译码/控制简单,许多指令位可直接接到数据通路。

4. 方法:增量加功能(Approach: Incremental Featurism)

Approach Incremental Featurism

顺序:先 ALU 指令 → 访存与分支 → 异常。构件:多位寄存器(上升沿加载)、大量 MUX、Part 1 的 ALU、以及寄存器堆与主存。

5. 多端口寄存器堆(Multi-ported Register File)

Multi-ported Register File

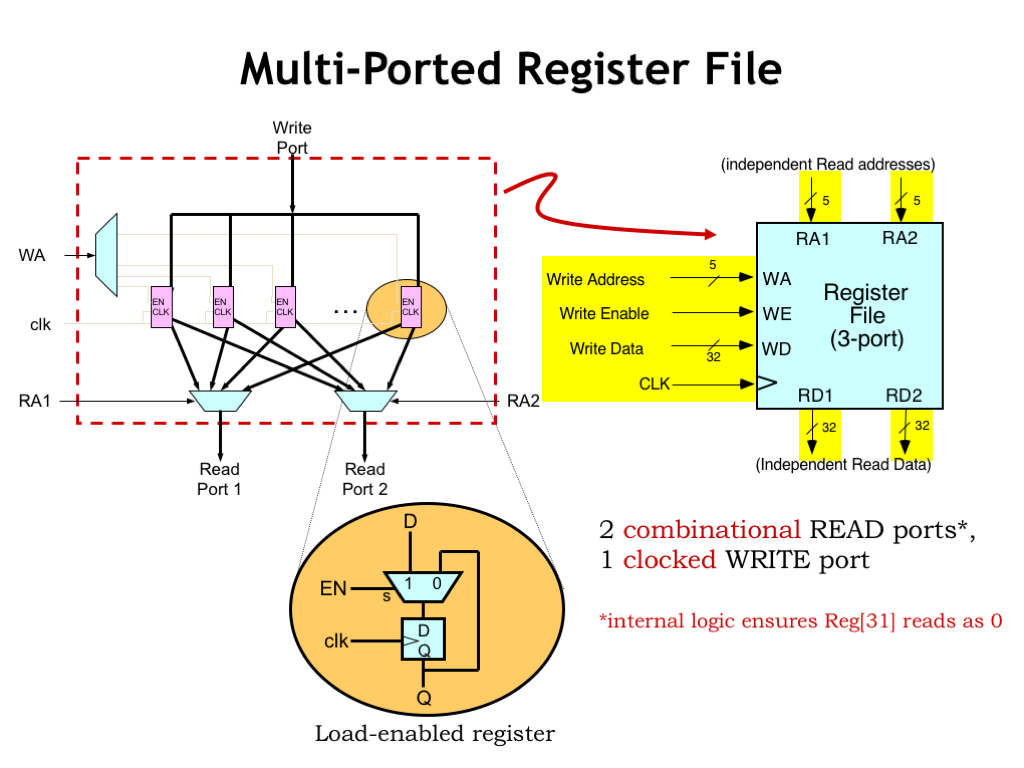
32 个带 EN 的寄存器:EN=1 时下一上升沿装入 D;禁止门控时钟(NO GATED CLOCKS)。两套读 MUX(地址 RA1/RA2)独立读;写口用 5 位 WA 译码选中一个 WE。R31 读出恒为 0。封装为双读一写寄存器堆。

6. 寄存器堆时序(Register File Timing)

Register File Timing

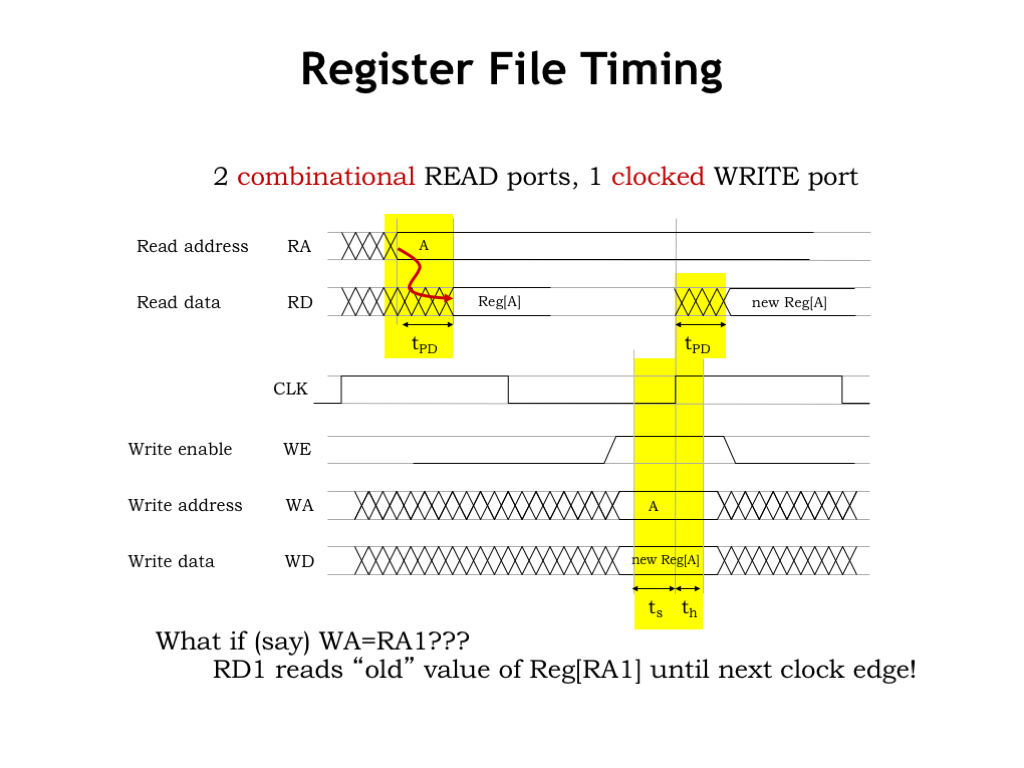
读:地址稳定后经 tPDt_{\mathrm{PD}} 出数据。写:WA/WD/WE 须满足建立/保持时间。同一周期可读旧值、周期末写入、下一周期才见新值——可同址同周期“读旧写新”。

7. ALU 指令(ALU Instructions)

ALU Instructions

五步:Fetch(按 PC 取指)→ Decode(opcode→控制)→ Read(Ra/Rb)→ Execute(ALU + 下一 PC)→ Write-back(写 Rc)。时钟上升沿更新寄存器堆与 PC,标志当前指令结束。周期须覆盖五步总延迟;若 tCLK=10 nst_{\mathrm{CLK}}=10\,\mathrm{ns} → 100 MHz → 100 MIPS。

8. 取指/译码(Instruction Fetch/Decode)

Instruction Fetch Decode

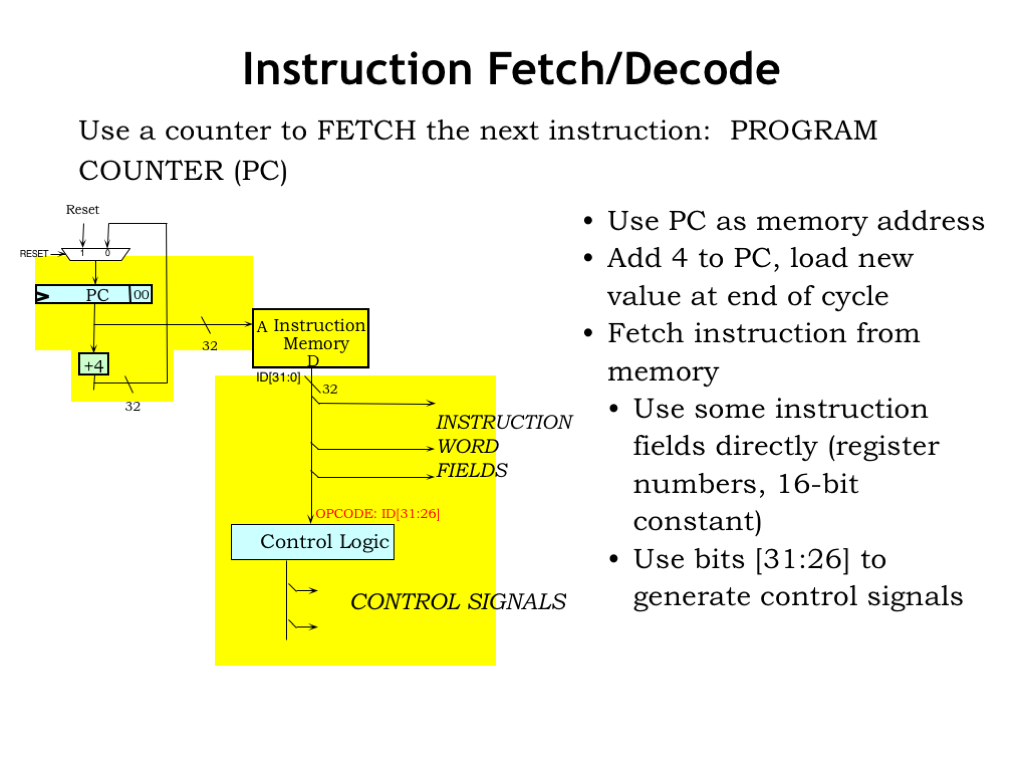
PC → 主存取指;ALU 类下一地址为 PC+4(专用加法器)。RESET 时 MUX 选初始 PC。部分指令字段可直连;其余控制由 opcode 逻辑产生。

9. ALU 操作数据通路 I(ALU Op Datapath I)

ALU Op Datapath I

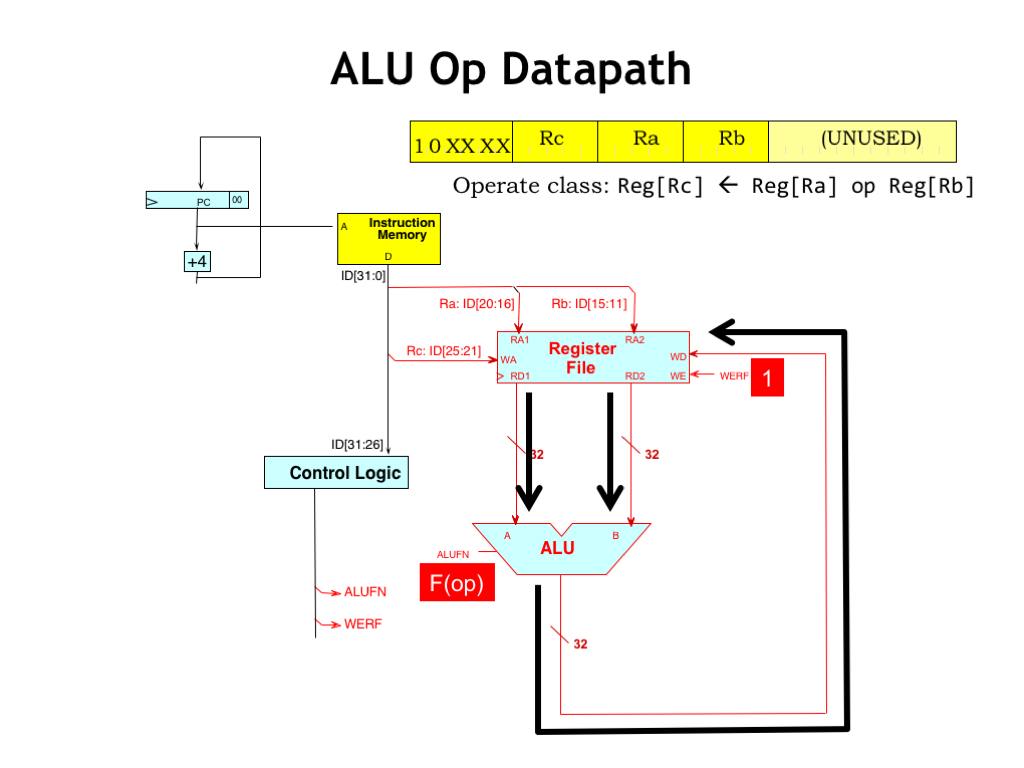
Ra/Rb/Rc 字段直连寄存器堆读写地址;读数进 ALU;ALUFN 由 opcode 经控制逻辑(可实现为 26=642^6=64 项 ROM)给出。ALU 结果回写 Rc;WERF(write-enable register file)=1 时写入。课程吉祥物 Werf 即以此命名。

10. ALU 操作数据通路 II(ALU Op Datapath II)

ALU Op Datapath II

取指后 Ra/Rb 读出 → ALUFN 选定 → 结果经 WERF=1 写回 Rc。RISC 优势:执行所需数据通路直观。

11. 带常量的 ALU I(ALU Operations with constant I)

ALU Operations with constant I

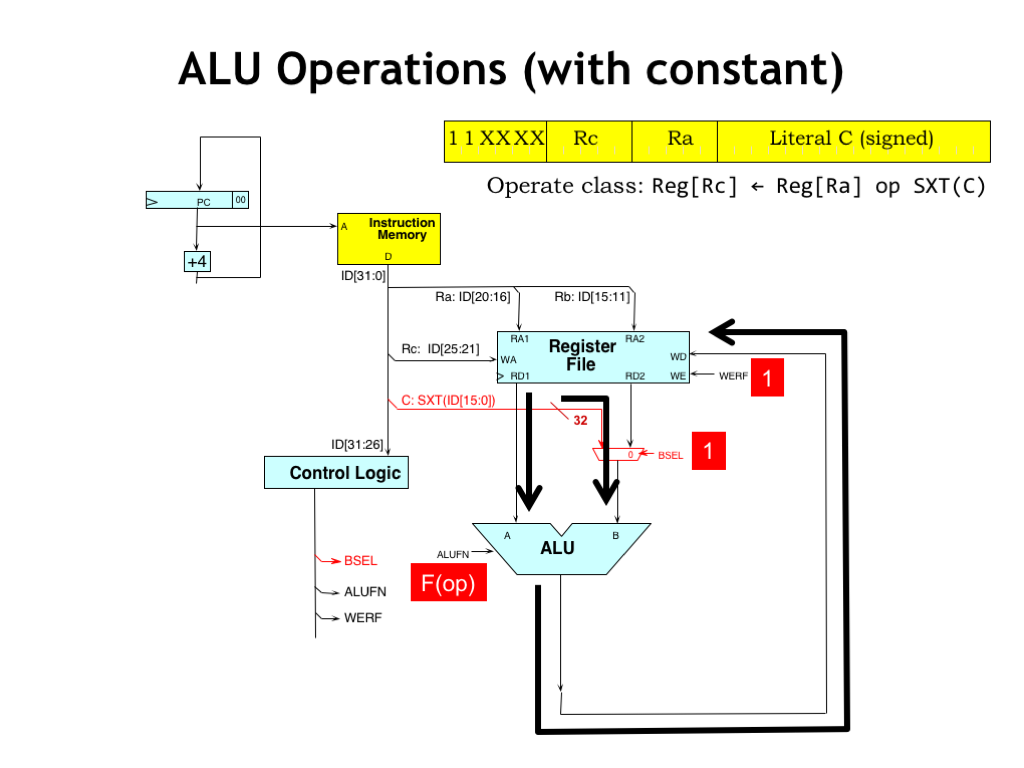
第二操作数 = 指令低 16 位符号扩展。加 BSEL MUX:0 选寄存器,1 选常量。符号扩展纯接线:复制 ID[15] 十六次,无需门。

12. 带常量的 ALU II(ALU Operations with constant II)

ALU Operations with constant II

BSEL=1,其余同双寄存器 ALU。至此已能执行大部分 ISA;剩下访存与分支。

13. Load 指令 I(Load Instruction I)

Load Instruction I

LD/ST 访问与指令同一主存(图上分画两盒)。地址计算同 ADDC:Ra + 符号扩展字面量,复用 ALU。LD:ALU 结果作地址;MOE=1 读出;经 WDSEL 三选一 MUX(另两路留给分支写回 PC+4 等)写回 Rc。MWE 用于写存。

14. Load 指令 II(Load Instruction II)

Load Instruction II

操作数选法同 ADDC,ALU 做 ADD;WDSEL=2 选存返回数据写寄存器堆。

15. Store 指令 I(Store Instruction I)

Store Instruction I

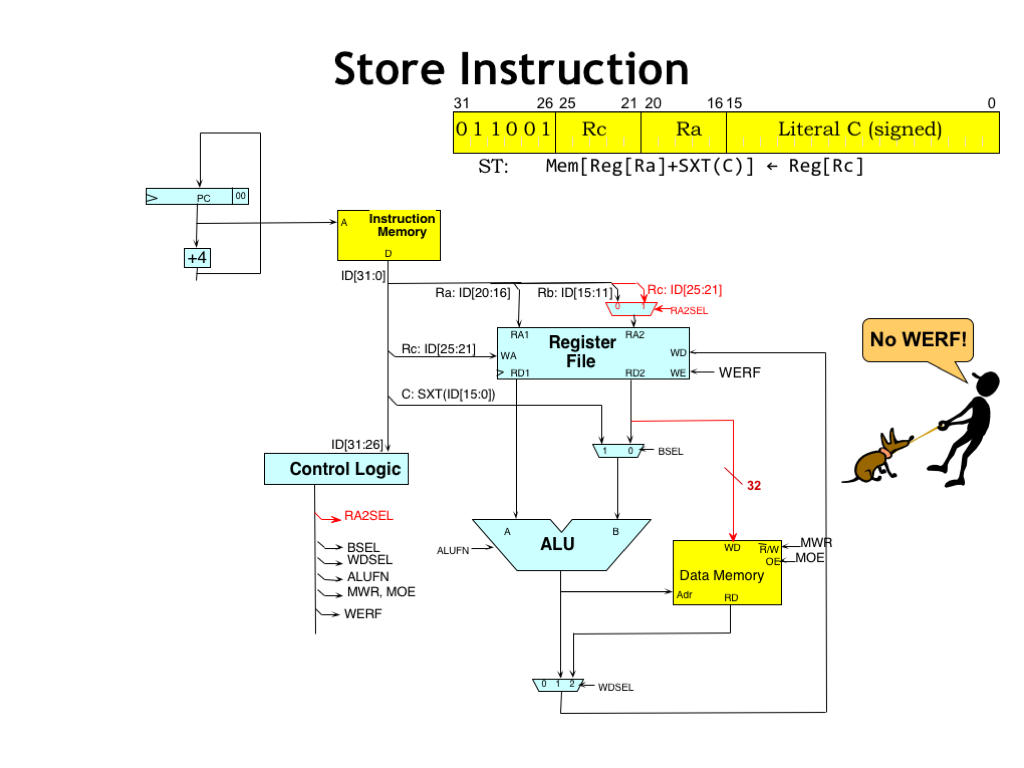
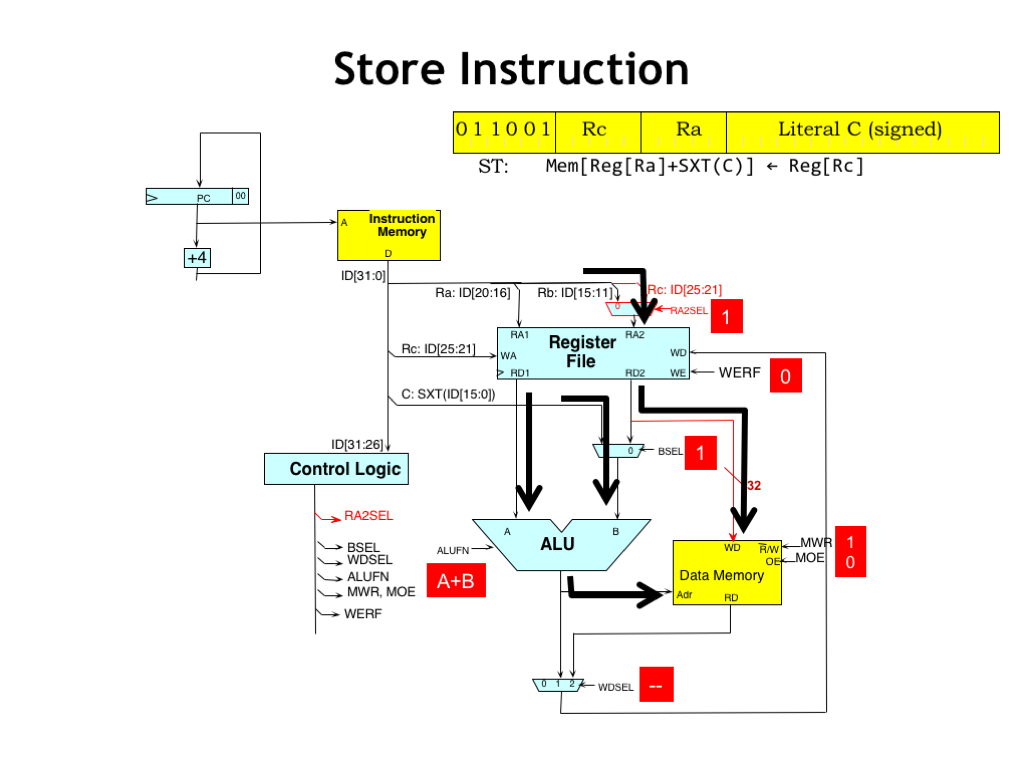
要写的数据来自 Rc,但 Rc 未接读口;ST 不用 Rb → 加 RA2SEL MUX:1 时第二读口地址用 Rc。该读数进主存 WD。ST 不写寄存器堆 → WERF=0。

16. Store 指令 II(Store Instruction II)

Store Instruction II

地址同 LD;MWR/MWE=1 在周期末写存;WERF=0;WDSEL 为 don’t care(可任选便于逻辑最小化)。注意:MWE 绝不能是 don’t care,以免误写。

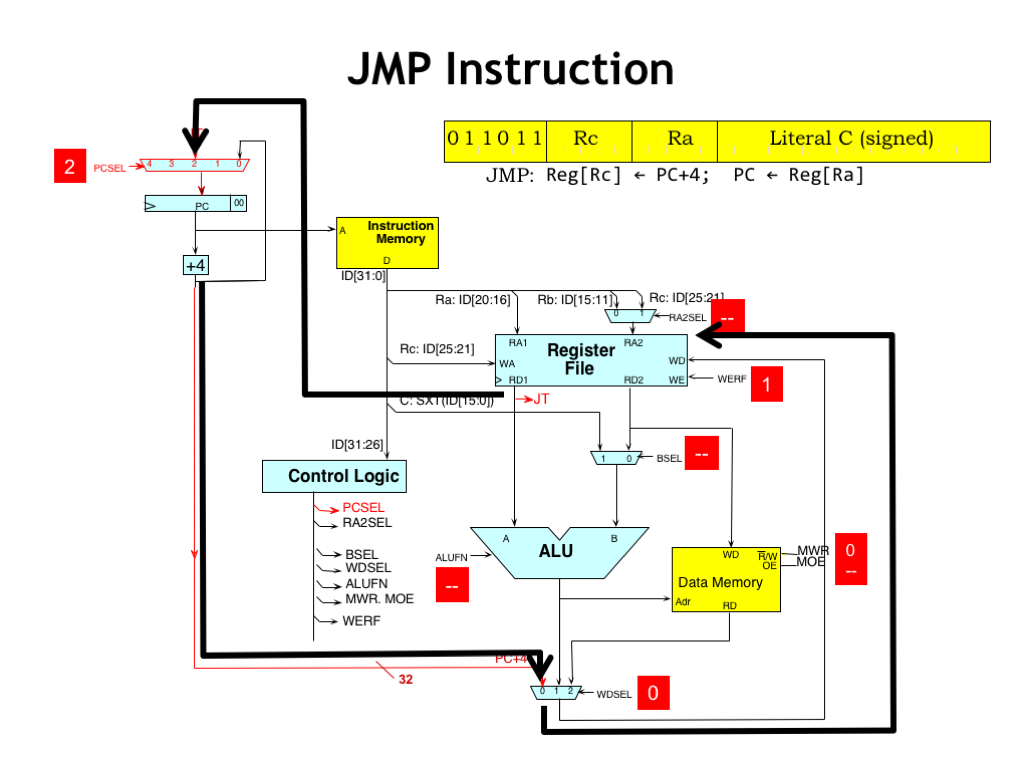
17. JMP 指令 I(JMP Instruction I)

JMP Instruction I

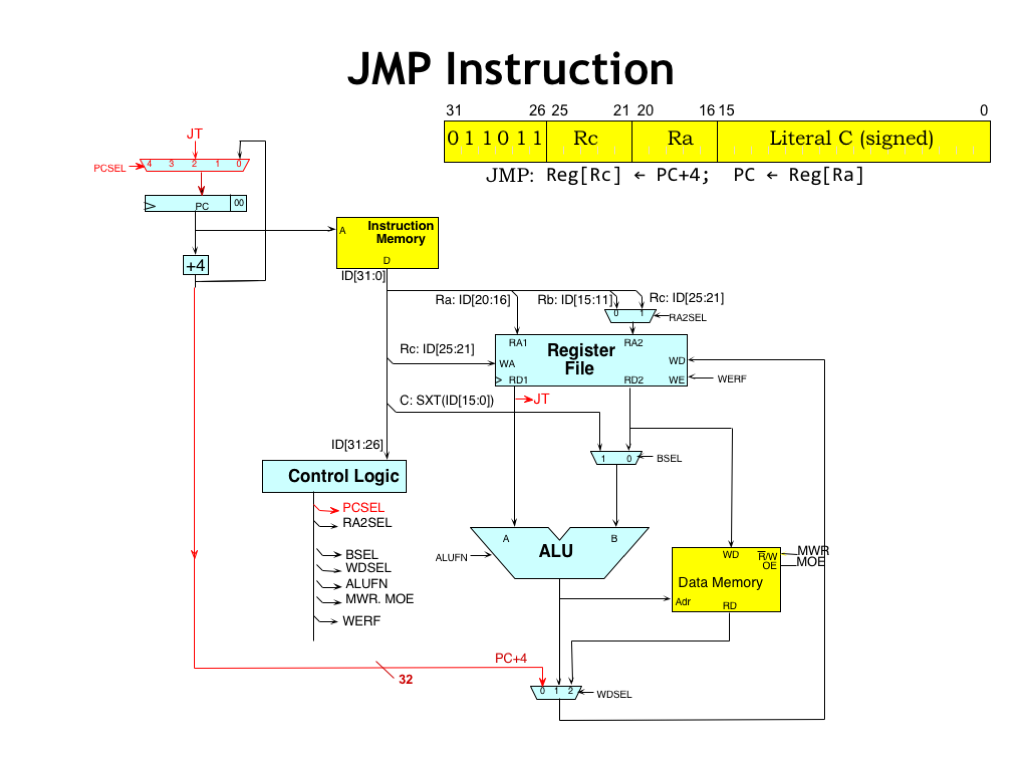
PCSEL MUX 选下一 PC:0→PC+4,2→Ra。JMP/分支还把 PC+4 写入 Rc(WDSEL=0)。

18. JMP 指令 II(JMP Instruction II)

JMP Instruction II

WERF=1 写回 PC+4;PCSEL=2 选 Ra。其余多为 don’t care,但 MWR 必须安全为 0。

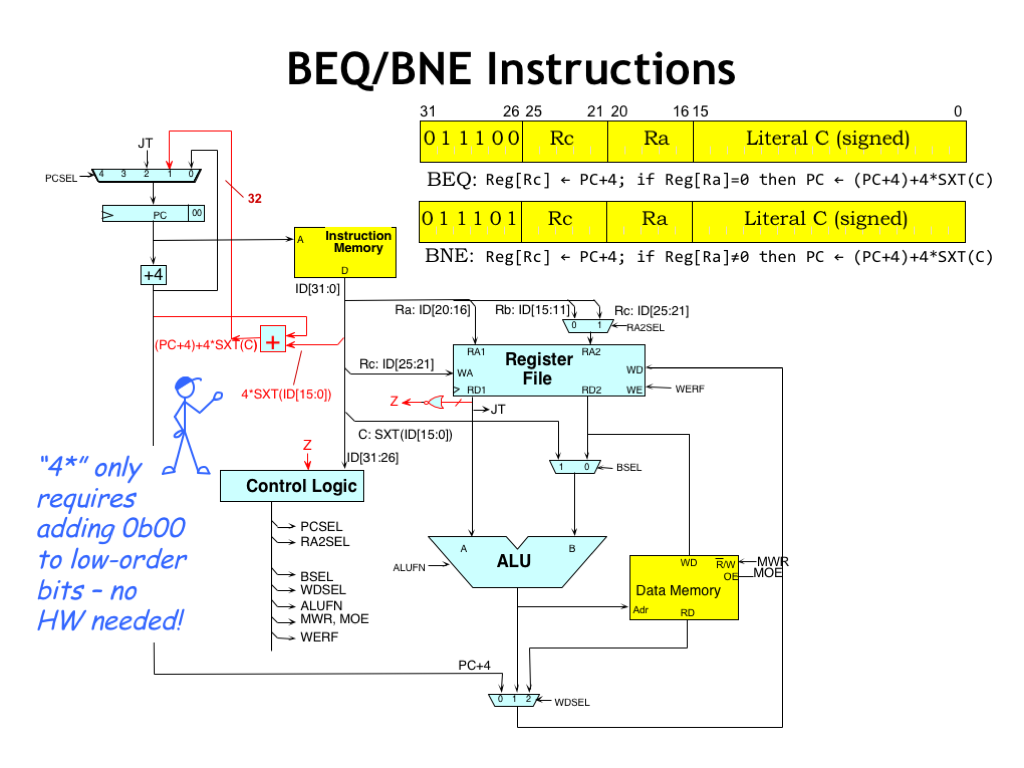
19. BEQ/BNE 指令 I(BEQ/BNE Instructions I)

BEQ BNE Instructions I

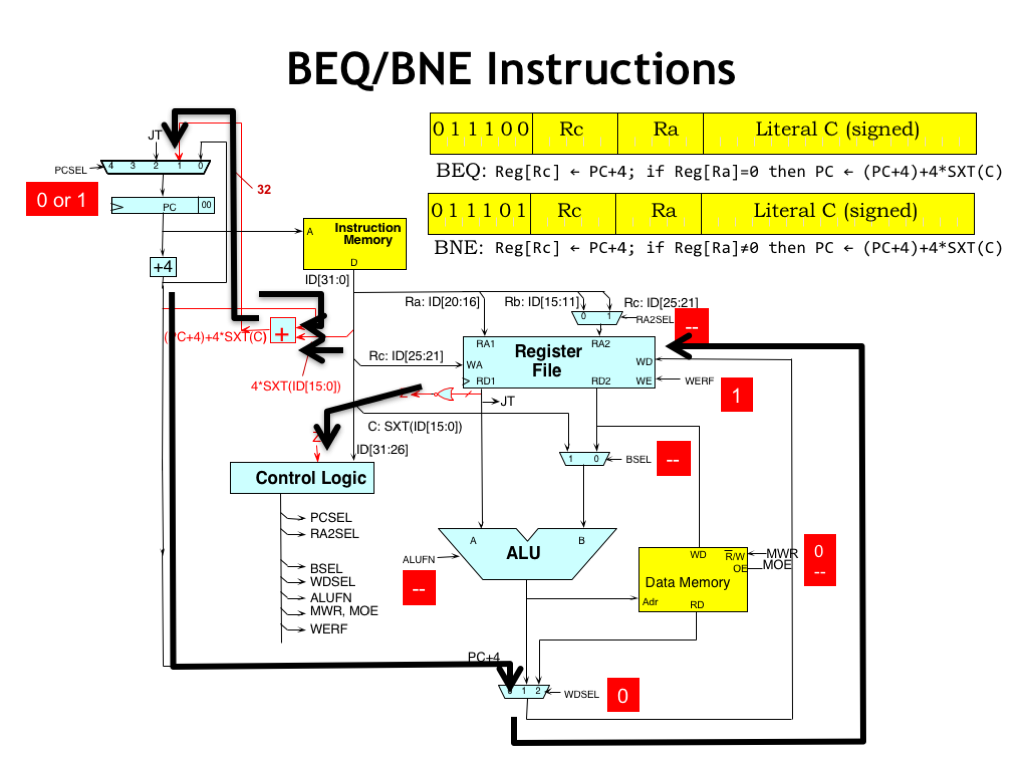
偏移加法器:PC+4 +(字面量左移 2 位的符号扩展偏移)。乘 4 靠接线插两个 0;符号扩展复制 ID[15] 十四次。32 位 NOR 得 Z(Ra 全 0)。分支成立 → PCSEL=1 选目标;否则 PCSEL=0。

20. BEQ/BNE 指令 II(BEQ/BNE Instructions II)

BEQ BNE Instructions II

PC+4 写 Rc;Z 与偏移加法器结果共同决定 PCSEL。

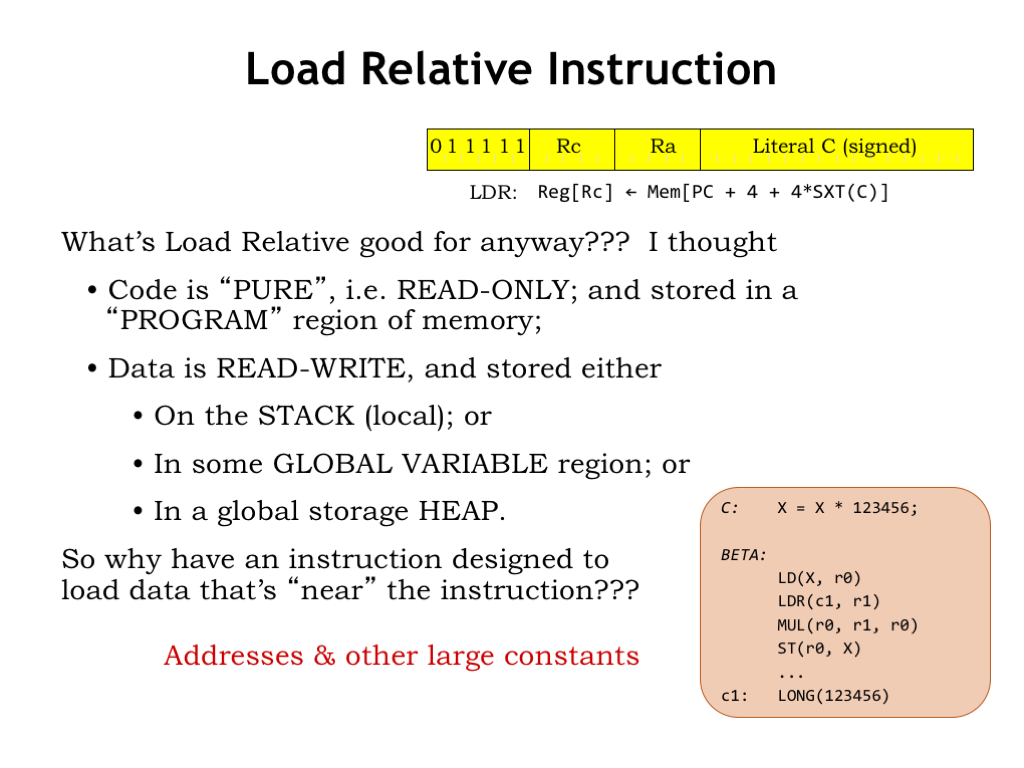
21. 相对加载 LDR(Load Relative Instruction)

Load Relative Instruction

LDR 像 LD,但地址来自分支偏移加法器——用于加载放在代码旁、装不下 16 位字面量的大常量。常量放过程后等位置,且须避免被当作指令执行。

22. LDR 指令 I(LDR Instruction I)

LDR Instruction I

加 ASEL MUX:1 时第一 ALU 操作数来自偏移加法器;ALU 做布尔 “A” 把该值送到地址口。为何不把 ASEL 直接接到存地址?那样 LD/ST 地址会多串一级 MUX,拉长关键路径、拖慢所有指令时钟;ASEL 与 BSEL 延迟重叠则几乎零性能代价。

23. LDR 指令 II(LDR Instruction II)

LDR Instruction II

偏移 → ASEL → ALU(“A”) → 存地址 → 数据经 WDSEL 写 Rc。

24. 异常(Exceptions)

Exceptions

指令无法执行时(非法 opcode / illop、地址越界、除零等):停止用户程序,转入处理程序——可转储状态、或用软件模拟未实现指令再恢复。外部 I/O 事件则需中断当前程序、处理后无感恢复。硬件把异常当成强制过程调用,保存 PC+4 以便返回。这是用户程序与 OS 接口的关键。

25. 异常处理(Exception Processing)

Exception Processing

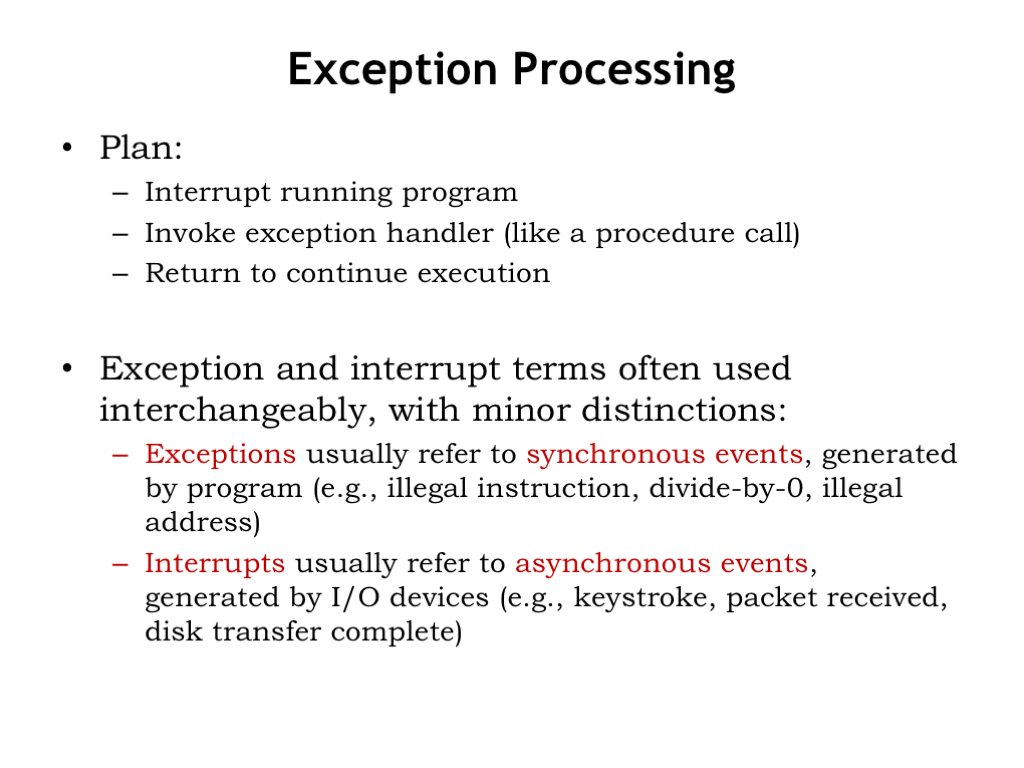
打断当前程序,如同当前指令变成对 handler 的调用;handler 可用普通过程返回恢复。Exception:由当前程序某指令引起的同步异常。Interrupt:与程序无关的异步外部事件。

26. 异常实现(Exception Implementation)

Exception Implementation

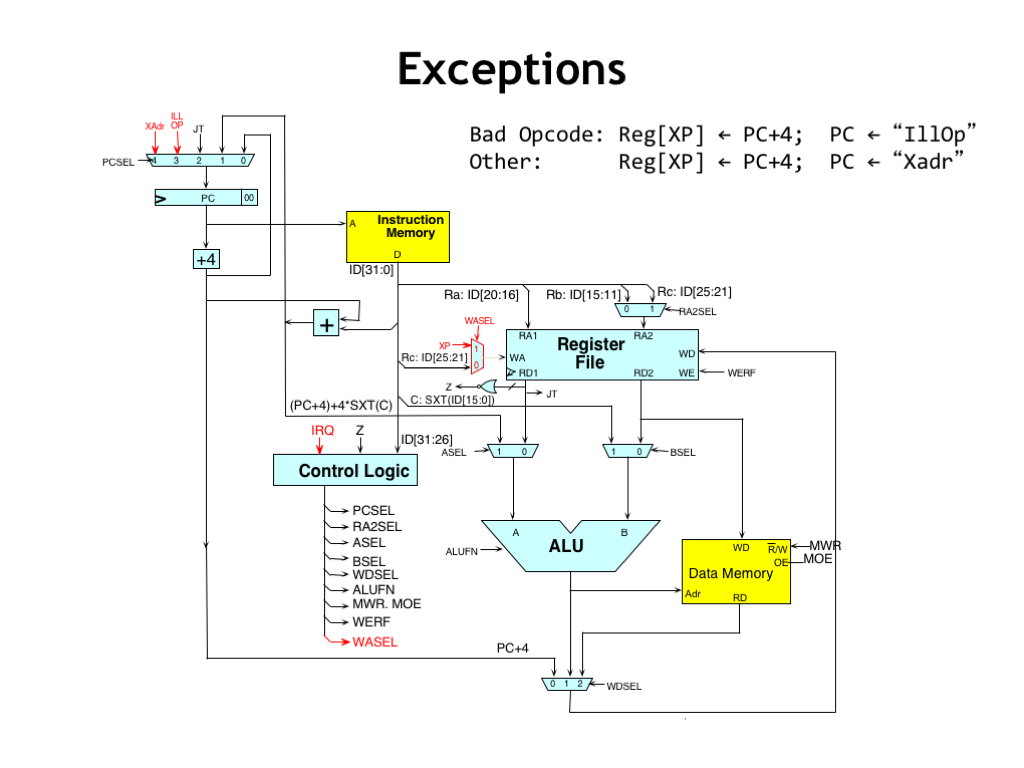
两类实现相同:硬件表现得像 taken BR 到 0x4(同步)或 0x8(异步);PC+4 写入 R30 = XP(exception pointer)。用户程序不可用 XP(随时可能被中断覆盖)。例:未实现 DIV → illop → 0x4 → handler 用 XP 取非法指令并模拟,再 JMP(XP) 继续。

27. 异常 I(Exceptions I)

Exceptions I

WASEL MUX:1 时写回地址强制为 XP(R30),0 时用 Rc。PCSEL 增加常量输入 0x4 / 0x8。

28. 异常 II(Exceptions II)

Exceptions II

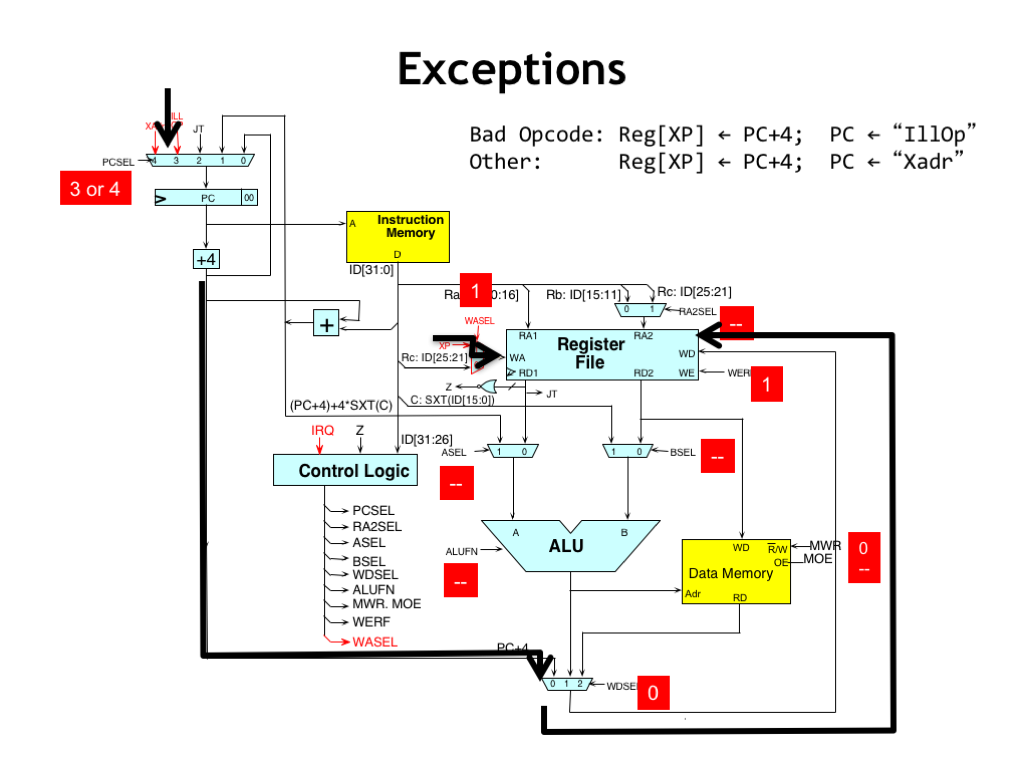
PC+4 经 WDSEL 写入 XP;PCSEL=3 或 4 进 handler。被打断指令未执行;若要重试须先对 XP 减 4 再 JMP(XP)。

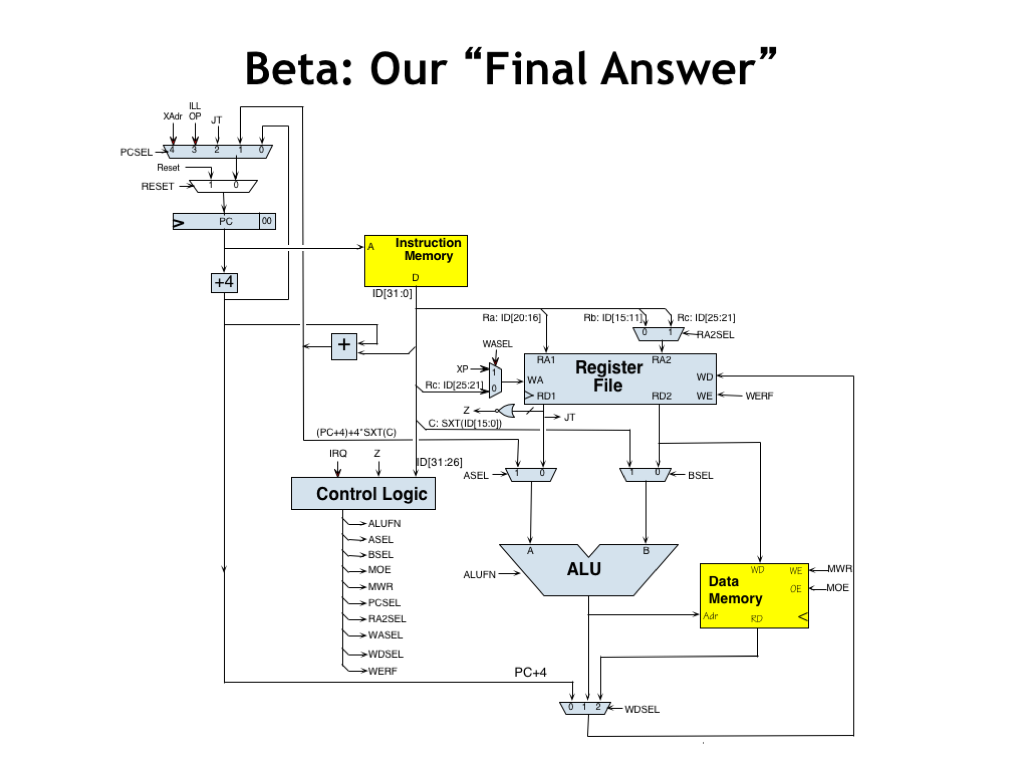
29. Beta:最终答案(Beta: Our Final Answer)

Beta Our Final Answer

完整单周期数据通路已齐。硬件量不大,适合实验课亲手完成。现代 CPU 另有流水、多发射、复杂存储层次等(后续讲)。Beta 约 1–2 mm²,现代 Intel 芯片 300–600 mm²——多出来的面积为性能服务。

30. 控制逻辑(Control Logic)

Control Logic

按指令类汇总控制表(含异常与 RESET);无关信号标 don’t care。MWE 与(多数情况下)WERF 必须有定义值。最简:opcode 索引 ROM;Z 与 IRQ 用少量逻辑修正 ROM 输出。亦可 Karnaugh 图做门级最小化——建议先 ROM 跑通再优化。

31. Beta Inside!

Beta Inside

简单编码 + 只做常见操作的硬件;复杂/少见功能交给软件;异常机制在硬件不够时把控制交给软件。完成 Beta 设计是许多 MIT 学生的 “Yes!” 时刻——并收获 “Beta Inside” 贴纸。

整理自 MIT OCW 6.004 Computation Structures(Spring 2017)L12 注解幻灯片。

源网页:12.1 Annotated Slides | Procedures and Stacks

讲师:Chris Terman。图片直接引用 OCW 原站链接。

L12:过程与栈(Procedures and Stacks)

本讲讲清过程(procedure)抽象为何需要激活记录(activation record),以及为何 LIFO 栈能自然支持嵌套与递归;随后给出 Beta 上的 SP/LP/BP 约定、栈帧布局、callee-saves 契约,并用阶乘与“栈侦探”题目串起整套调用约定。

1. 过程:软件抽象(Procedures: A Software Abstraction)

Procedures A Software Abstraction

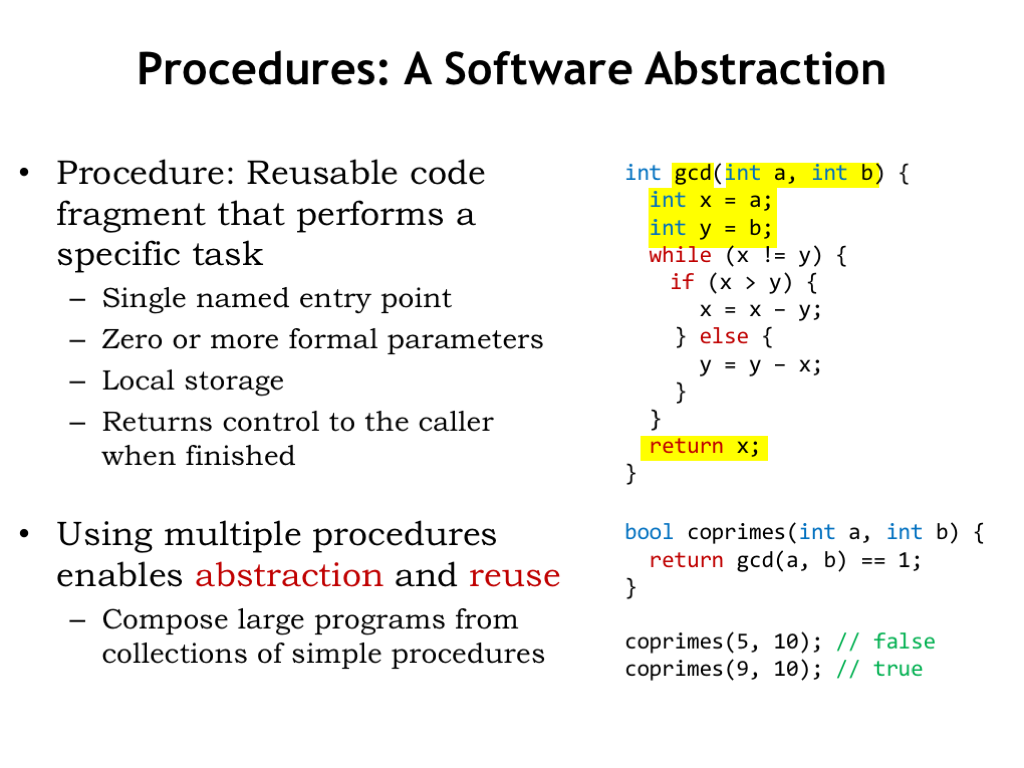
过程/子程序:完成特定任务的指令序列,有唯一命名入口。可有形式参数(formal parameters);调用时实参(arguments)与之对应。过程体可定义仅在执行期间存在的局部变量;可返回值,也可只为副作用而执行。

例:COPRIMES 只需知道 GCD 的入参/返回类型即可调用——实现被封装成黑盒。标准库提供大量预建过程(数学、容器、文件等)。过程抽象是高级语言表达力的核心。

2. 实现过程(Implementing Procedures)

Implementing Procedures

两种思路:

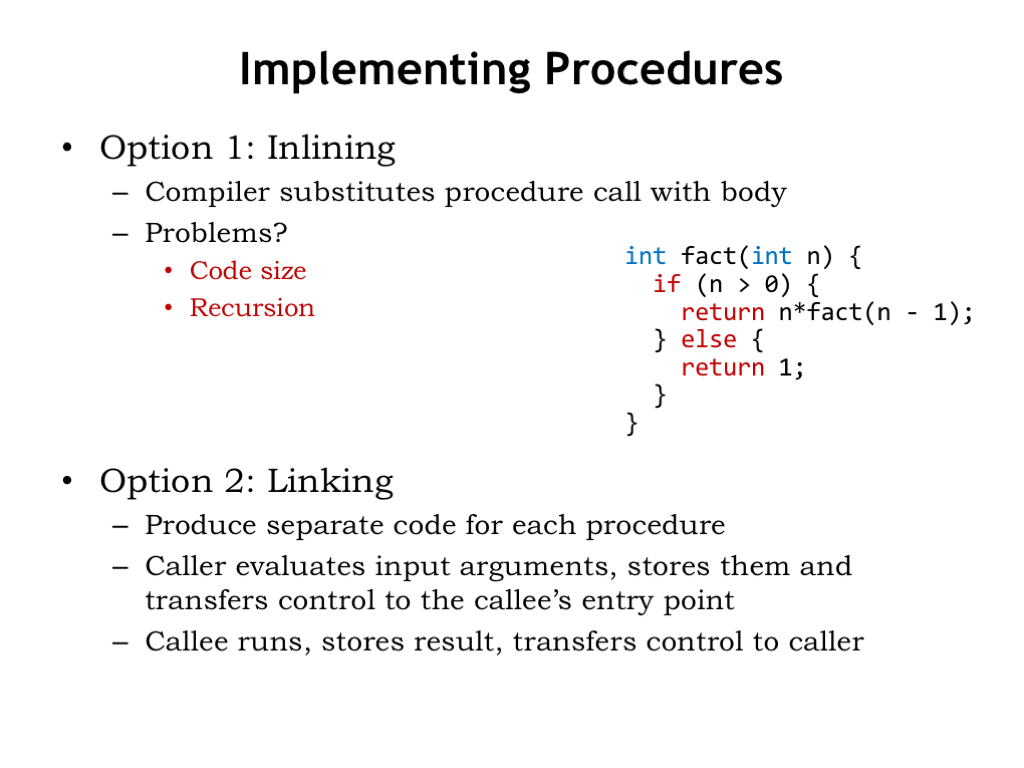
  1. 内联(inline):用过程体副本替换调用,实参代入形参(类似宏)。短过程有时值得;长过程多次调用会膨胀代码。递归在编译期无法终止展开 → 内联失败。
  2. 链接(link):过程代码只保留一份;调用方求实参、存约定位置,BR 到入口并保存返回地址(return address);过程算完把结果放约定位置,再 JMP 回返回地址。

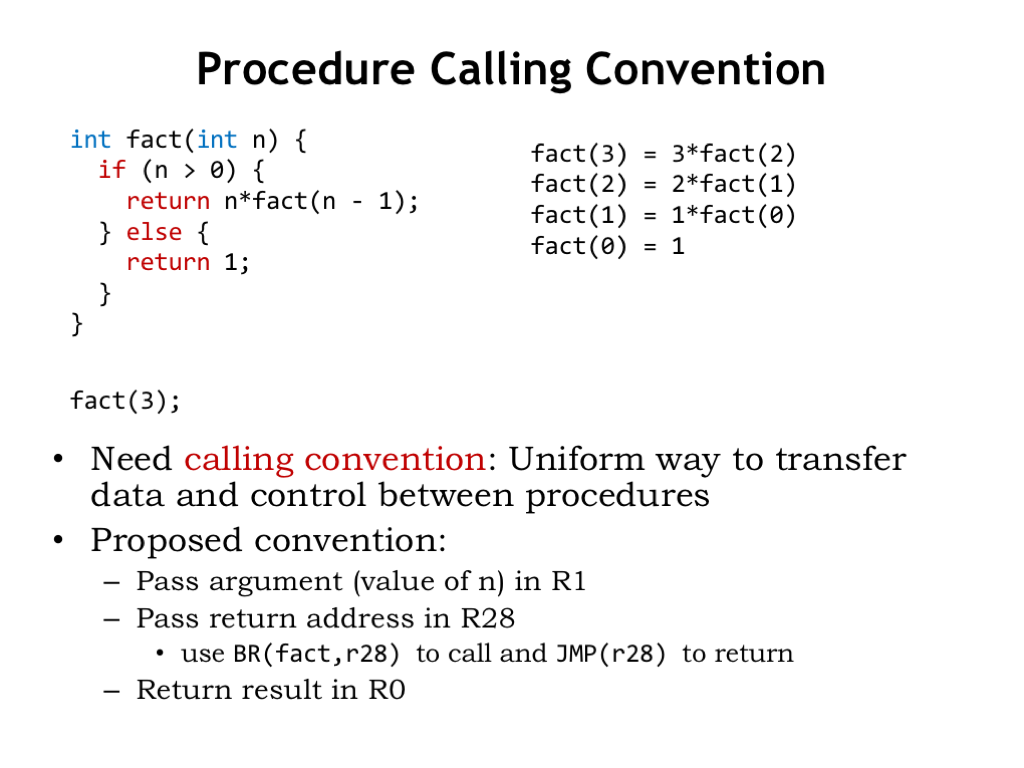
3. 过程调用约定(Procedure Calling Convention)

Procedure Calling Convention

需约定:实参放哪、返回值放哪。可尝试用寄存器:如 R1 起传参、R28 存返回地址(linkage pointer)、R0 返回值。BR/JMP 正好对应 call/return。

目标:所有调用与过程体用同一约定——含递归 fact(n-1) 与顶层 fact(3)。

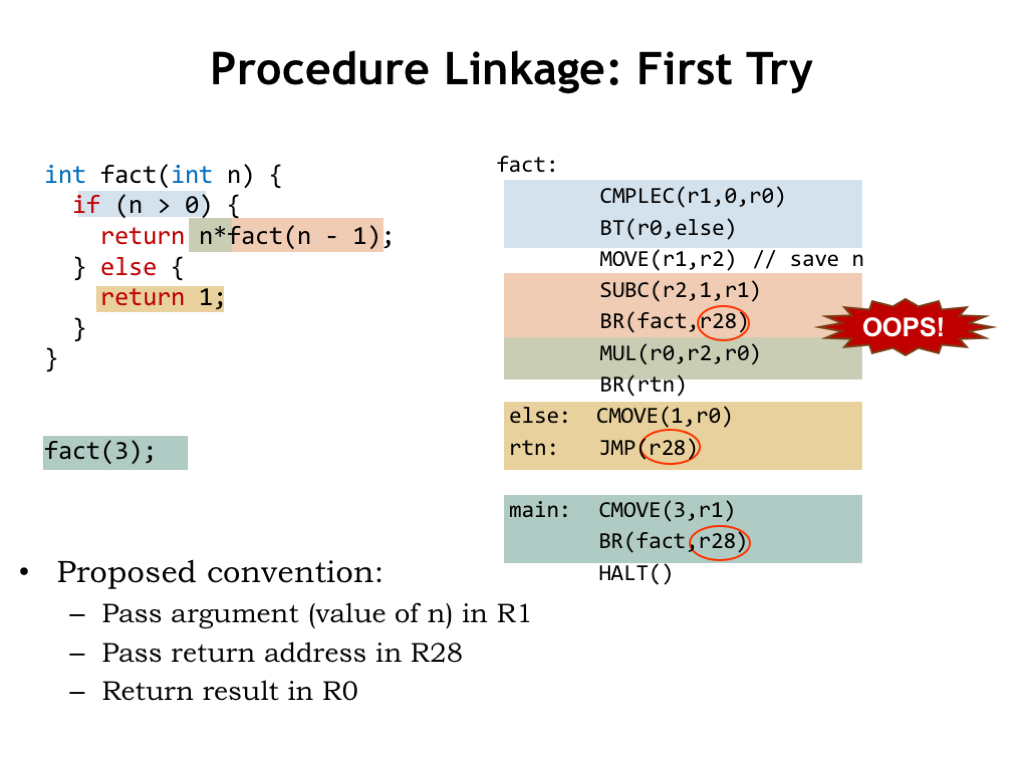
4. 过程链接:初试(Procedure Linkage: First Try)

Procedure Linkage First Try

按上述约定编译 fact():入参进 R1,BR 保存返回地址到 R28;递归时又把 n-1 写入 R1、新返回地址写入 R28——覆盖外层还需要的 n 与返回地址。深度为 dd 时需要约 2d2d 个存储槽,寄存器不够。禁止递归可绕过,但语言通常允许递归 → 必须动态为每次活跃调用分配存储。

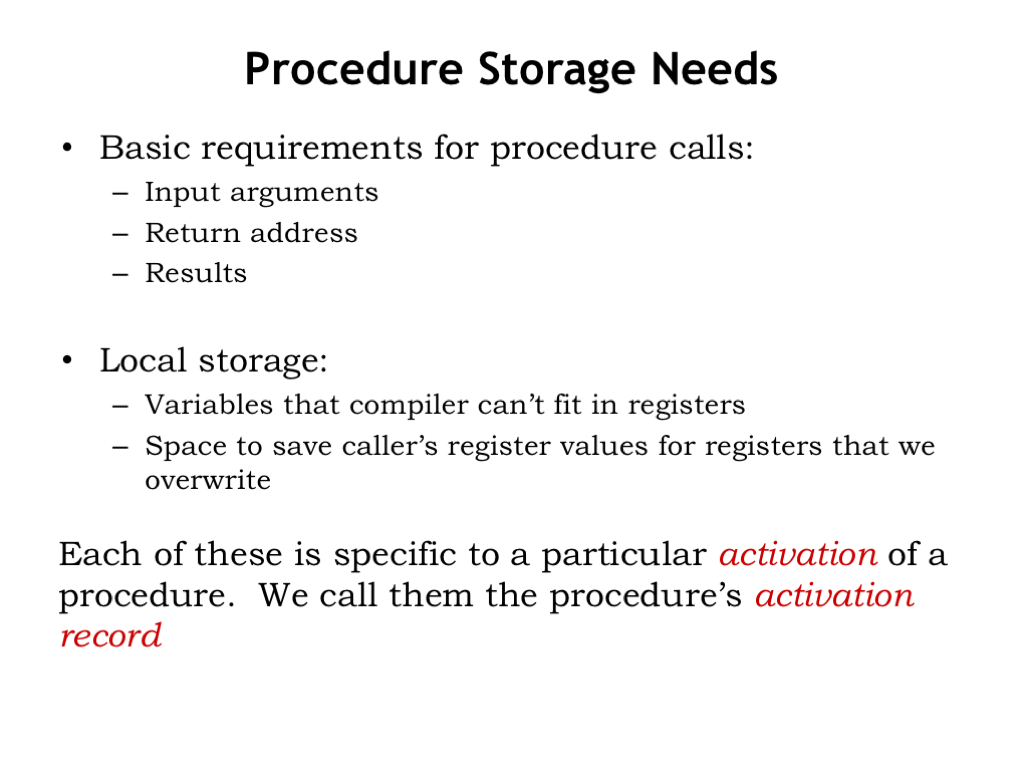
5. 过程的存储需求(Procedure Storage Needs)

Procedure Storage Needs

每次活跃调用需要:实参、返回地址、返回值、局部变量、以及调用方寄存器现场。不想限制参数/局部变量个数 → 每次调用一块存储,即激活记录。不能静态只为某过程留一块(递归有多份同时活跃)→ 调用时分配、返回时回收。

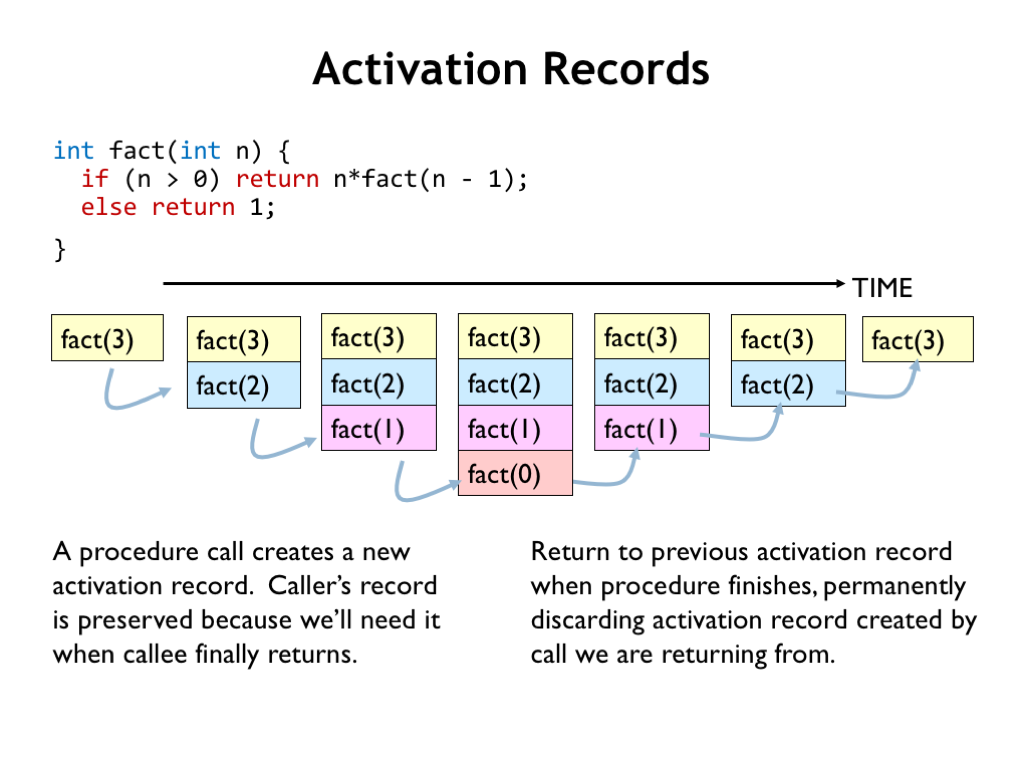
6. 激活记录(Activation Records)

Activation Records

fact(3)→fact(2)→fact(1)→fact(0):每层调用创建自己的激活记录;嵌套调用返回后其记录先丢弃。LIFO:被调方记录总在调用方之前释放——调用方必须等被调返回才能结束。需要高效支持这种分配/释放的结构。

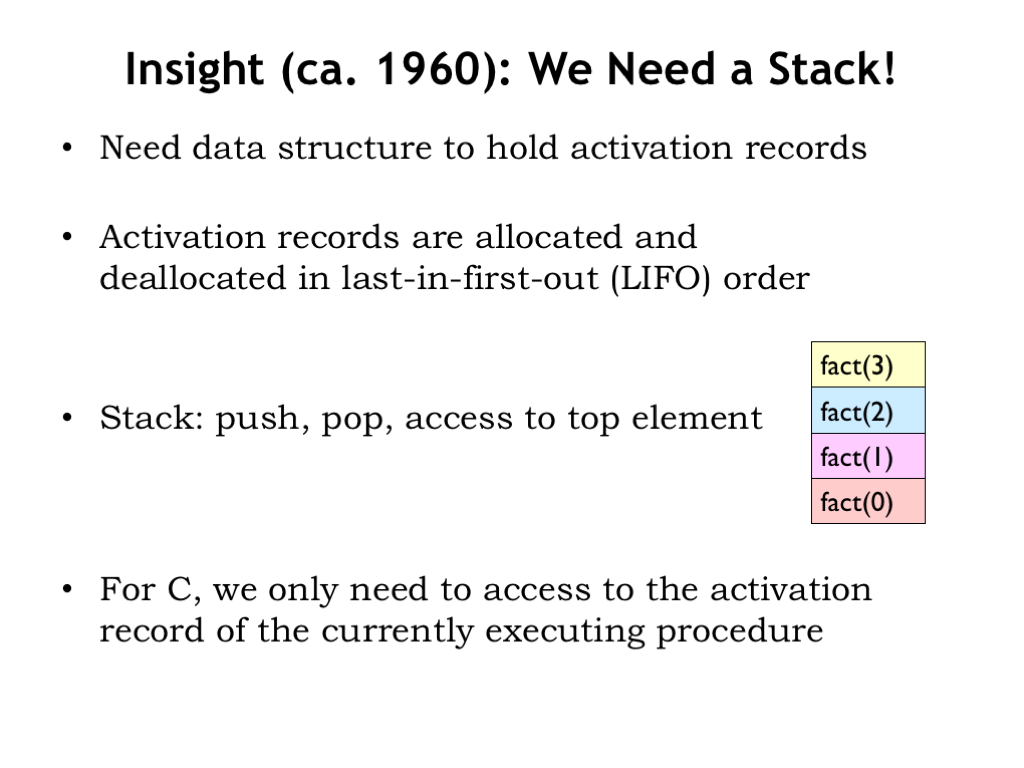
7. 洞察:需要栈!(Insight: We Need a Stack!)

Insight We Need a Stack

激活记录按 LIFO 进出 → 栈(stack):PUSH 加顶、POP 去顶。C 过程通常只访问栈顶记录;Java 等可访问其他活跃帧。闭包 / continuation(如 Python yield)需在返回后仍保留帧 → 纯栈不够,属更高级课程话题。

8. 栈实现(Stack Implementation)

Stack Implementation

Beta:专用 R29 = SP(stack pointer)。PUSH 时递增 SP,栈向高地址生长。约定:SP 指向下一个未用字;低于 SP 的地址是已分配内容。

栈纪律(stack discipline):一段代码 PUSH 的内容必须在结束前 POP 掉,使 SP 恢复原值。栈放在大块内存区,系统常设最大栈长,溢出报错。Beta 用现有指令实现栈,纯软件约定;有的 ISA 有专用栈指令。

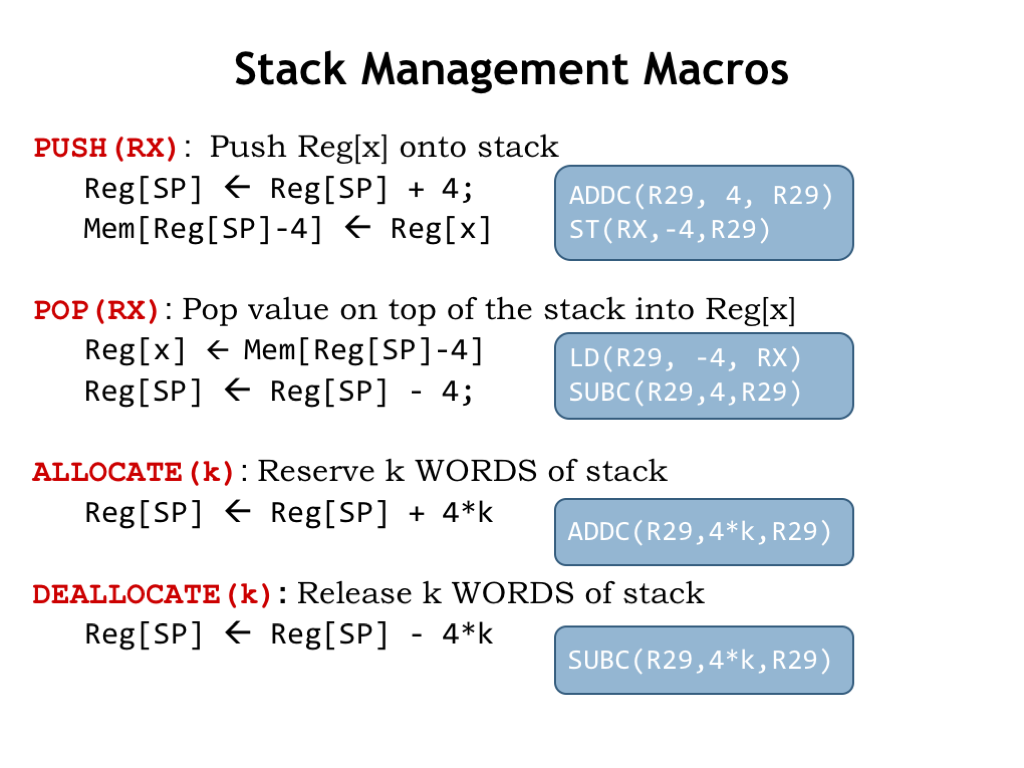
9. 栈管理宏(Stack Management Macros)

Stack Management Macros

UASM 宏:

  • PUSH:先 ADDC 分配栈顶,再 ST 初始化(顺序重要:中断可能夹在两指令之间;先分配再写更安全)
  • POP:先 LD 取值,再 SUBC 释放
  • ALLOCATE / DEALLOCATE:预留/释放 NN 个字(不必初始化)

见 PUSH/ALLOCATE 应能找到配对的 POP/DEALLOCATE。

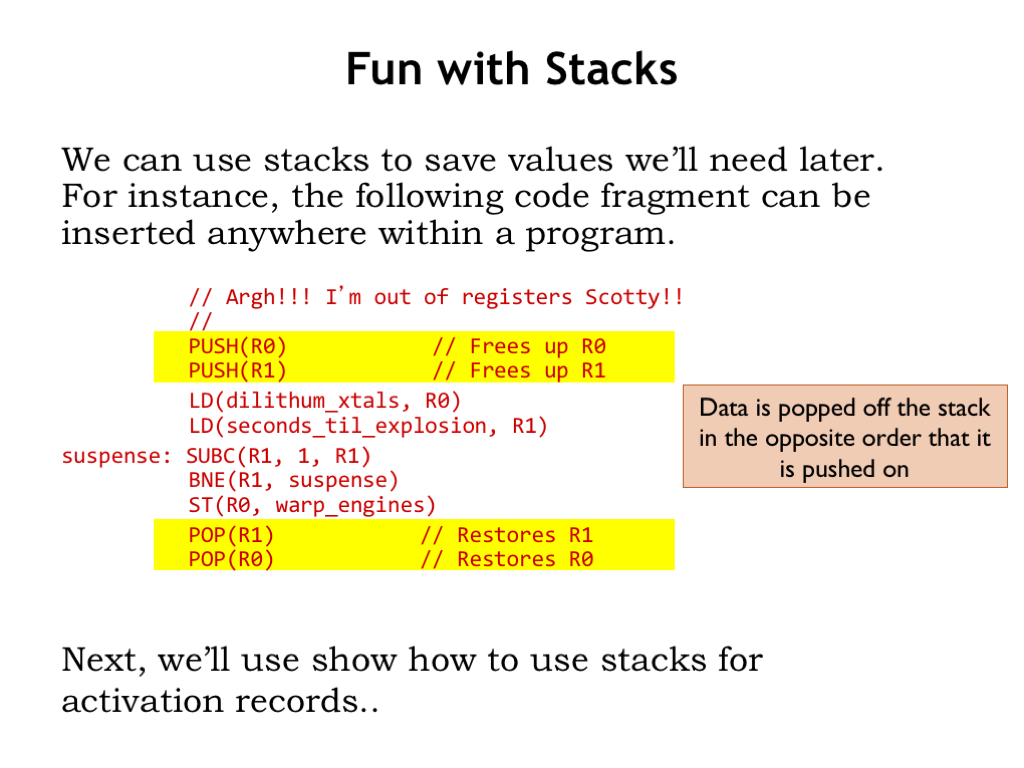
10. 玩转栈(Fun With Stacks)

Fun With Stacks

临时占用寄存器前可 PUSH 旧值,用完按相反顺序 POP 恢复(LIFO)。有了栈,即可解决激活记录的分配/释放问题。

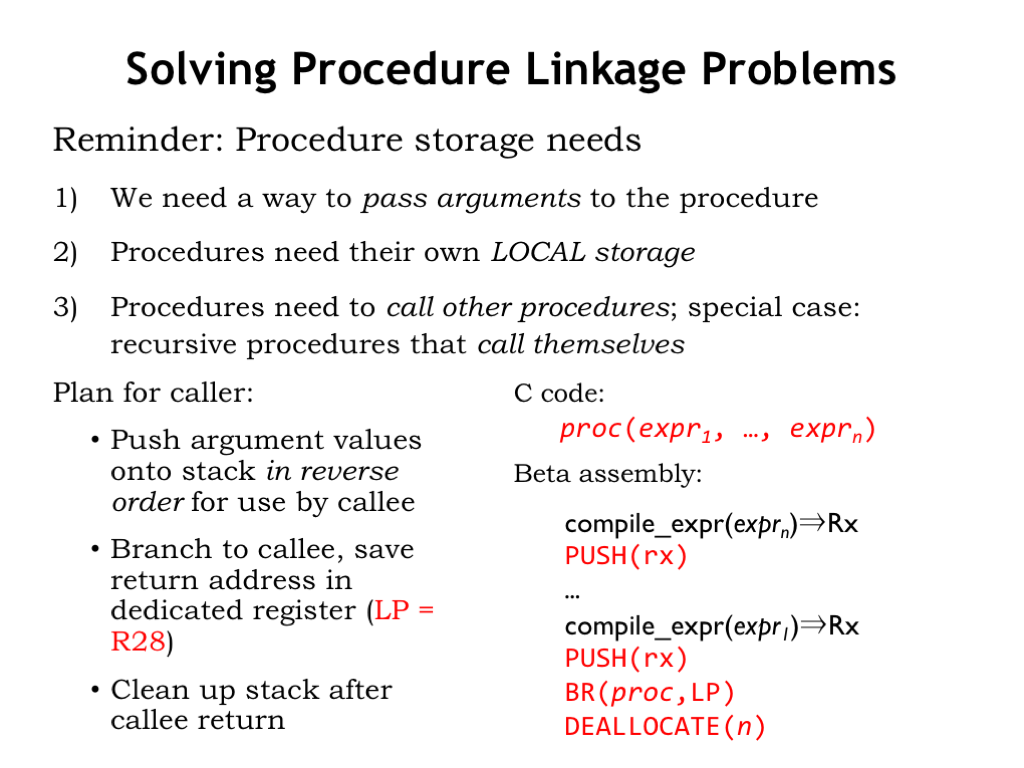
11. 解决过程链接问题(Solving Procedure Linkage Problems)

Solving Procedure Linkage Problems

栈上放激活记录:实参、局部变量、以及保存的 LP(以便嵌套调用)。职责分摊:

  • 调用方(caller):求实参并逆序 PUSH(第一实参最后压栈);BR 到入口,返回地址进 LP=R28;返回后 DEALLOCATE 去掉实参。
  • 被调方完成帧的其余部分(下页)。

逆序原因后文说明(可变参数)。

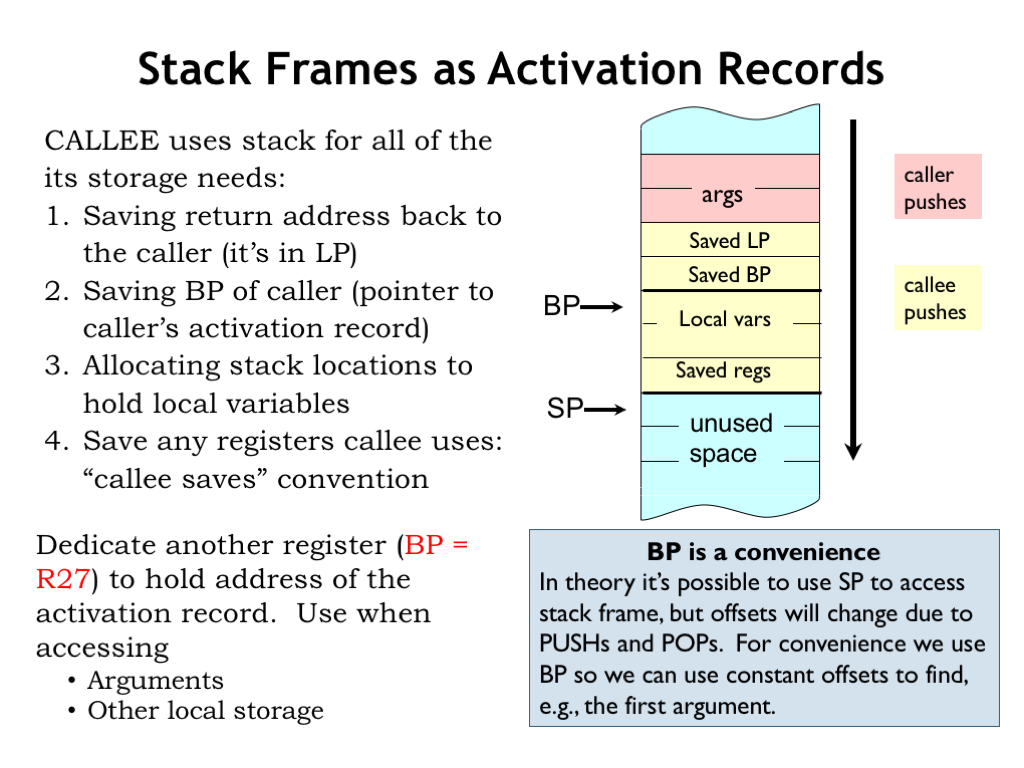
12. 栈帧作激活记录(Stack Frames as Activation Records)

Stack Frames as Activation Records

入口序列完成帧(也称 stack frame):保存 LP;再保存调用方的 BP=R27,并用当前 SP 设本帧 BP;ALLOCATE 局部变量;再 PUSH 本过程将破坏的寄存器(callee saves:除 R0 外寄存器跨调用保持)。

有了 BP,帧内访问用相对 BP 的固定偏移,比相对 SP 更稳(SP 会随 PUSH/POP 变)。

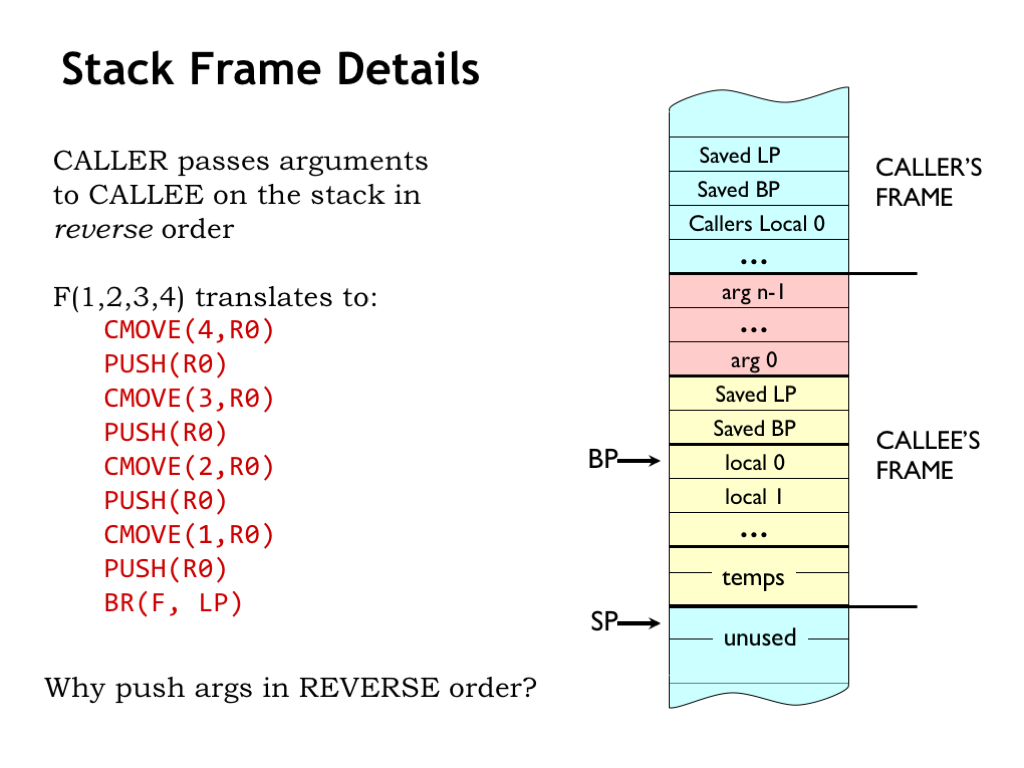
13. 栈帧细节(Stack Frame Details)

Stack Frame Details

回到问题:为何实参逆序压栈?

14. 实参顺序与 BP(Argument Order & BP Usage)

Argument Order and BP Usage

逆序后,第一实参(arg 0)相对 BP 偏移固定(如 −12-12),与共压几个实参无关;第二参 −16-16…… C 的可变参数(如 printf:格式串在第一个实参)依赖这一点。局部变量亦固定偏移:第一局部 00,第二 +4+4…… 帧上更高地址可用于嵌套调用建新帧。

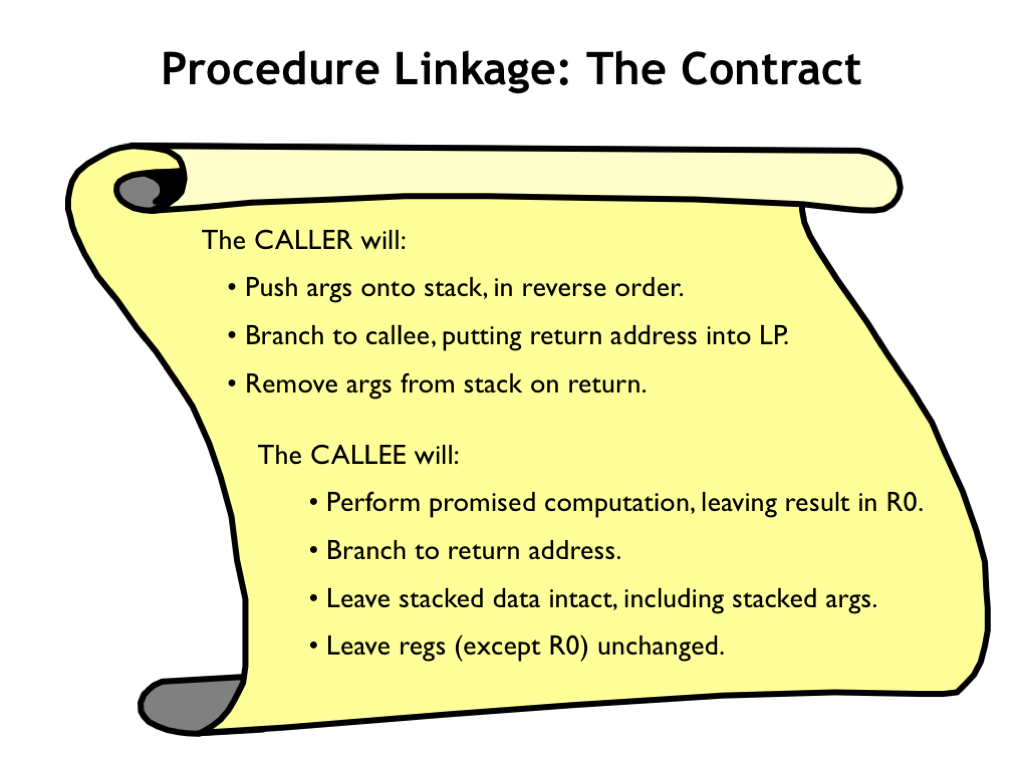
15. 过程链接契约(Procedure Linkage: The Contract)

Procedure Linkage The Contract

Caller:逆序压实参 → BR 到入口(返回地址→LP)→ 返回后卸掉实参。

Callee:计算结果放 R0 → JMP 返回地址 → 卸掉自己压上的内容,栈恢复入口时模样 → 除 R0 外保持所有寄存器。

16. 过程链接模板(Procedure Linkage Templates)

Procedure Linkage Templates

入口:保存 LP、BP;MOVE(SP,BP);ALLOCATE 局部;PUSH 将用寄存器。出口:按相反顺序 POP 恢复;MOVE(BP,SP) 隐式撤销 ALLOCATE;最后 JMP(LP) 回调用方。

17. 综合:阶乘(Putting It All Together: Factorial)

Putting It All Together Factorial

C 版 fact 的编译结果:入口/出口序列清晰;嵌套调用栈上传参并在返回后 DEALLOCATE;体用上讲模板。链接开销约十余条指令;对极短非递归过程,优化器可能选择内联。

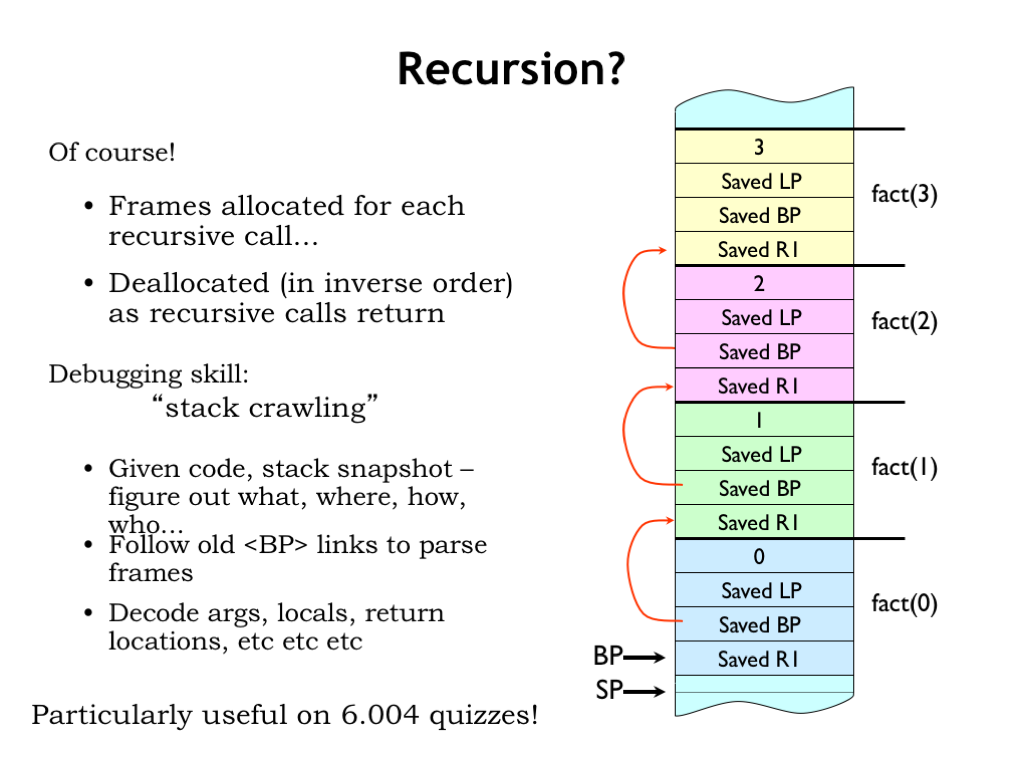
18. 递归?(Recursion?)

Recursion

已解决:每次调用新栈帧;返回按逆序释放。沿 BP 链可读出活跃调用、实参、局部变量 → stack trace(运行时出错时常打印)。能解读栈帧 ≈ 理解调用约定(测验常见题)。

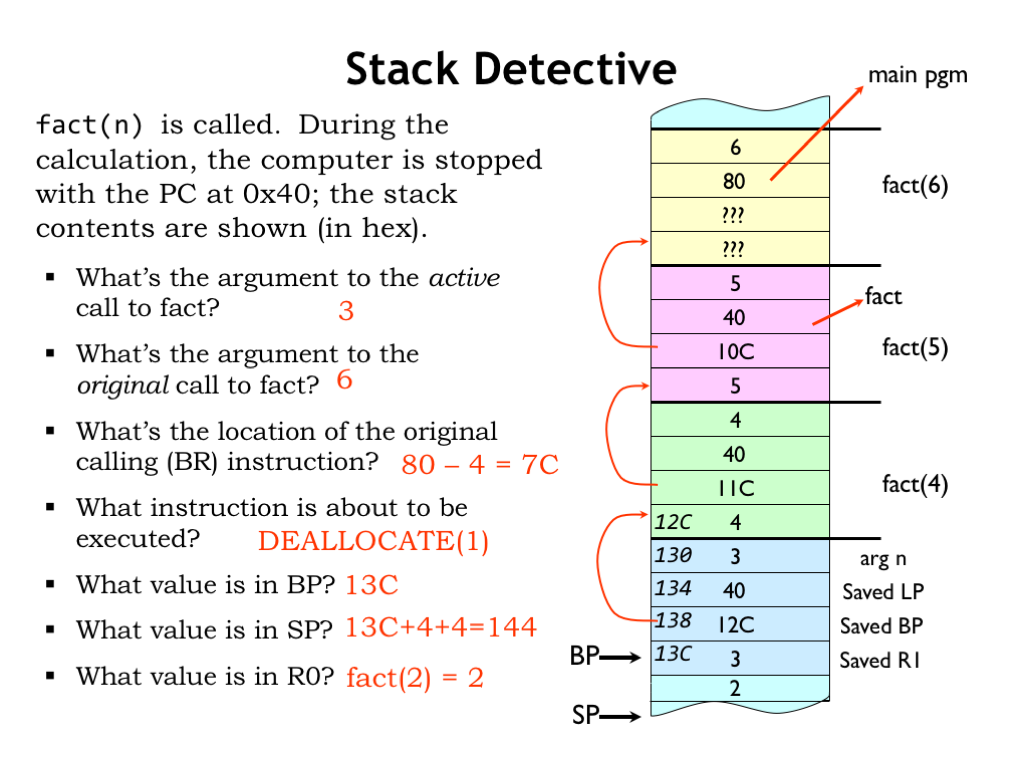
19. 栈侦探(Stack Detective)

Stack Detective

练习:已知 PC=0x40、栈转储,推断:

  • 当前 fact 实参为 3;沿保存的 BP/LP 找到原始调用实参为 6
  • 原始调用的 BR 在 0x7C(保存的 LP=0x80 为下一指令)
  • 即将执行的是 DEALLOCATE(1)(递归返回后的指令)
  • BP 等可由帧布局与十六进制地址推出

关键:会读帧布局、十六进制算术、区分递归返回地址与外部返回地址。

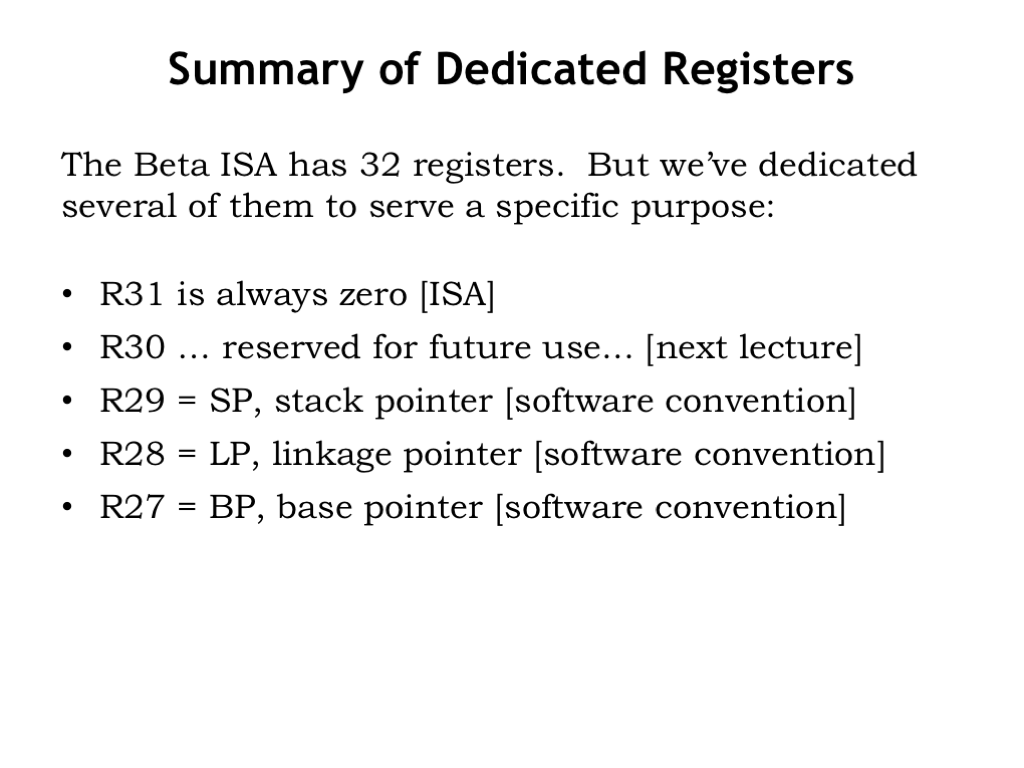
20. 专用寄存器小结(Summary of Dedicated Registers)

Summary of Dedicated Registers
寄存器 角色
R31 ISA 规定恒为 0
R30 留给下讲 Beta 实现(XP);用户代码勿用
R29 (SP) 栈指针
R28 (LP) 链接指针(返回地址)
R27 (BP) 基址指针(当前帧)

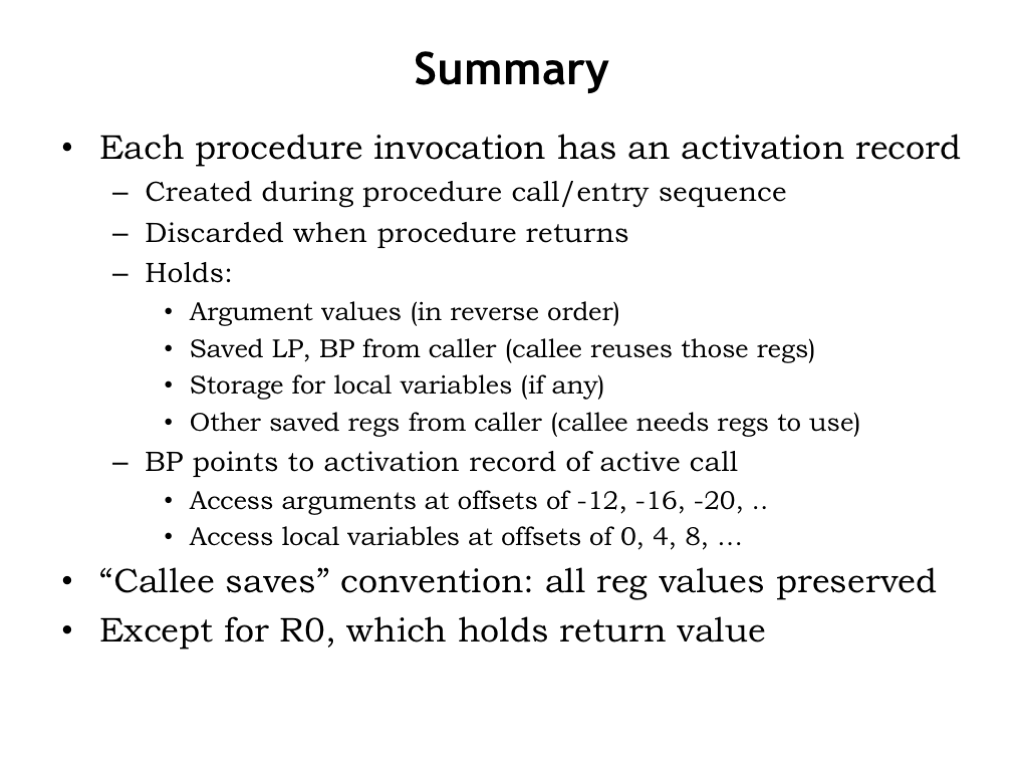
21. 小结(Summary)

Summary

激活记录由 caller/callee 共同建造,返回时丢弃;含实参、保存的 LP/BP、其他被保存寄存器、局部变量。BP 指向当前帧;callee saves(除 R0)保证嵌套与递归安全。至此可编译并执行任意 C 程序(在约定意义下)。

整理自 MIT OCW 6.004 Computation Structures(Spring 2017)L11 注解幻灯片。

源网页:11.1 Annotated Slides | Compilers

讲师:Chris Terman。图片直接引用 OCW 原站链接。

L11:编译器(Compilers)

本讲从高级语言出发,对比解释(interpretation)与编译(compilation),再用递归下降模板把 C 表达式/语句翻译成 Beta 汇编;随后拆解现代编译器前端(词法/语法/语义)、中间表示(IR / CFG)与多遍优化,最后做代码生成。

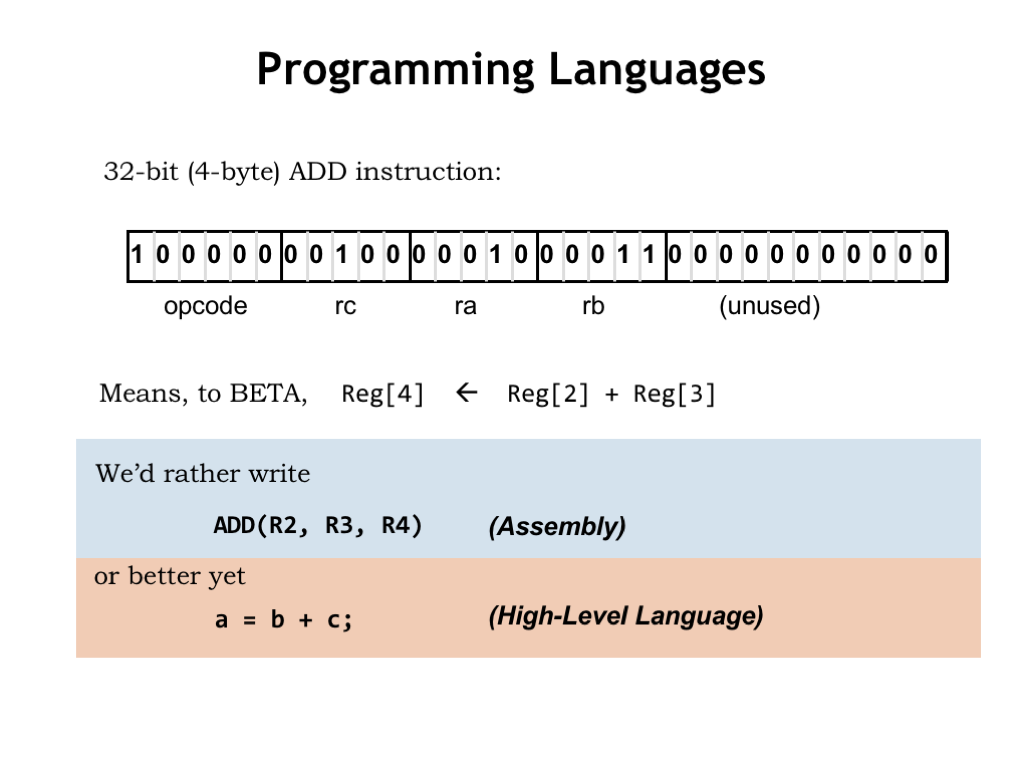
1. 编程语言(Programming Languages)

Programming Languages

已学 Beta ISA:对寄存器中的 32 位数据做 datapath 操作,并访存、改 PC;指令由 opcode / 源 / 目的等字段组成 32 位字。汇编一句对应一条指令,程序员自己管寄存器与主存,并把数组访问等拆成 Beta 操作序列。

高级语言用变量与数据结构抽象存储与搬移;用表达式与赋值 = 等紧凑描述本需大量汇编的计算。本讲核心:如何把高级语言程序翻译成可在 Beta 上运行的代码。

2. 高级语言(High-Level Languages)

High-Level Languages

以欧几里得求 GCD 的 C 代码为例;课程用 C 的简单子集作示例语言。C 由 Dennis Ritchie 在 AT&T Bell Labs 为 Unix 而开发;此后语言不断加入 OOP、新数据结构与控制结构。

用高级语言可不提寄存器、具体指令等 ISA 细节 → 写得更快、更易读、更易维护;类型检查可拦下把字符串赋给数值变量等错误;动态分配等可自动化。因抽象掉具体 ISA,同一源码可移植到不同机器。代价取决于执行策略:解释还是编译。

3. 解释(Interpretation)

Interpretation

在真实机器 M1 上跑解释器,模拟易编程的抽象机 M2:每条 M2 操作由一段 M1 指令序列实现。解释器 + M1 ≡ M2 的一种实现。

常见多层解释:笔记本 x86 跑 Python 解释器 → 加载 SciPy → 一条 SciPy 命令展开为大量 Python 语句 → 每条 Python 再变成数百条 x86。适合一次性计算或探索算法;不必手写全部机器指令。

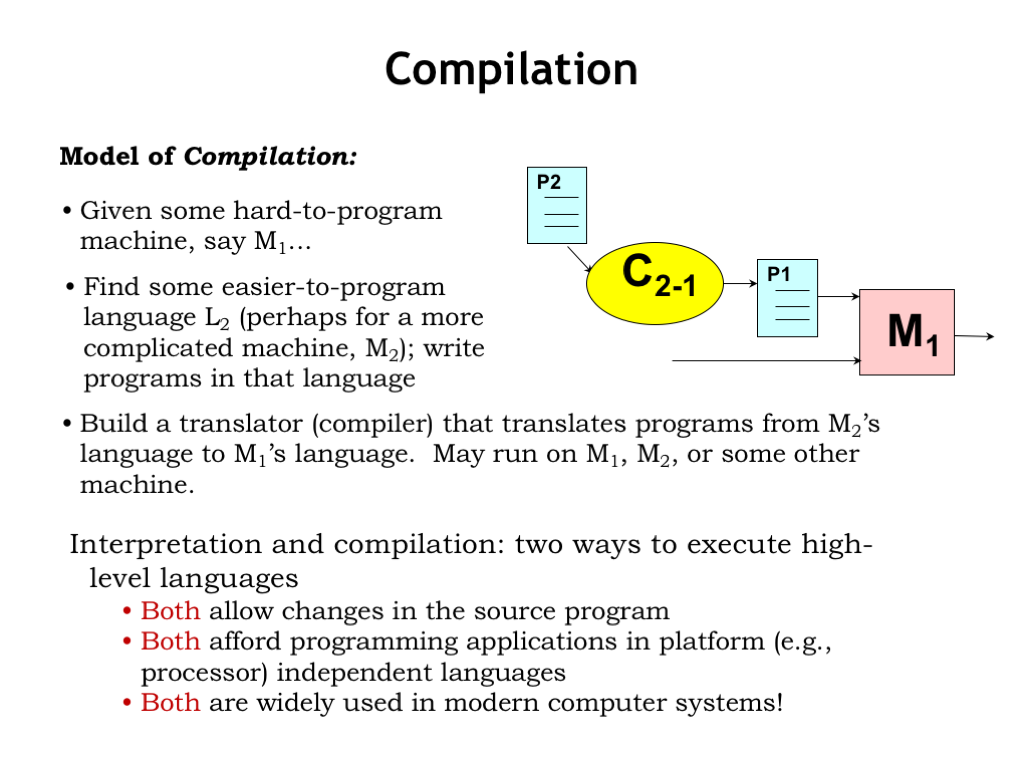
4. 编译(Compilation)

Compilation

对需反复执行、愿付前期成本的任务用编译:把高级程序 P2 逐语句翻译成 M1 上的等价程序 P1(并不在翻译时“跑”P2)。做翻译的程序叫编译器(compiler)。

编译一次得 P1,之后直接跑 P1,避免运行时解析源码与多层解释开销。换不同编译器可把同一 P2 落到 M2、M3… 而不改写源码。解释与编译都能改源码、抽象真实机器,且在现代系统中并存。

5. 解释 vs. 编译(Interpretation vs. Compilation)

Interpretation vs Compilation

对语句 x+2:解释器处理时立刻取 x 并加 2;编译器则生成 LD/ADD 等指令,留待以后执行。循环中解释器会反复处理同一语句;编译器只生成指令一次。

解释 编译
开销时机 执行中反复处理源码 一次性编译,执行更快
类型/操作决策 运行时,更灵活 编译期,换速度
开发循环 改完即可跑 compile–run–debug 可能更慢

一般编译代码快得多;解释器可按 x 的实际类型改变行为。

6. 编译器(Compilers)

Compilers

编译器:把高级语言程序翻译成功能等价的机器指令序列(汇编)。先检查良构性:语句是否合法、有无无意义的运算(字符串+整数)、未初始化就用等;并警告浮点转整型可能溢出等。

通过检查后生成高效指令,常重排计算使序列更短更快。现代优化编译器耐心探索替代方案,往往难被手写汇编全面超越。本节先看简单编译策略,再看现代编译器结构。

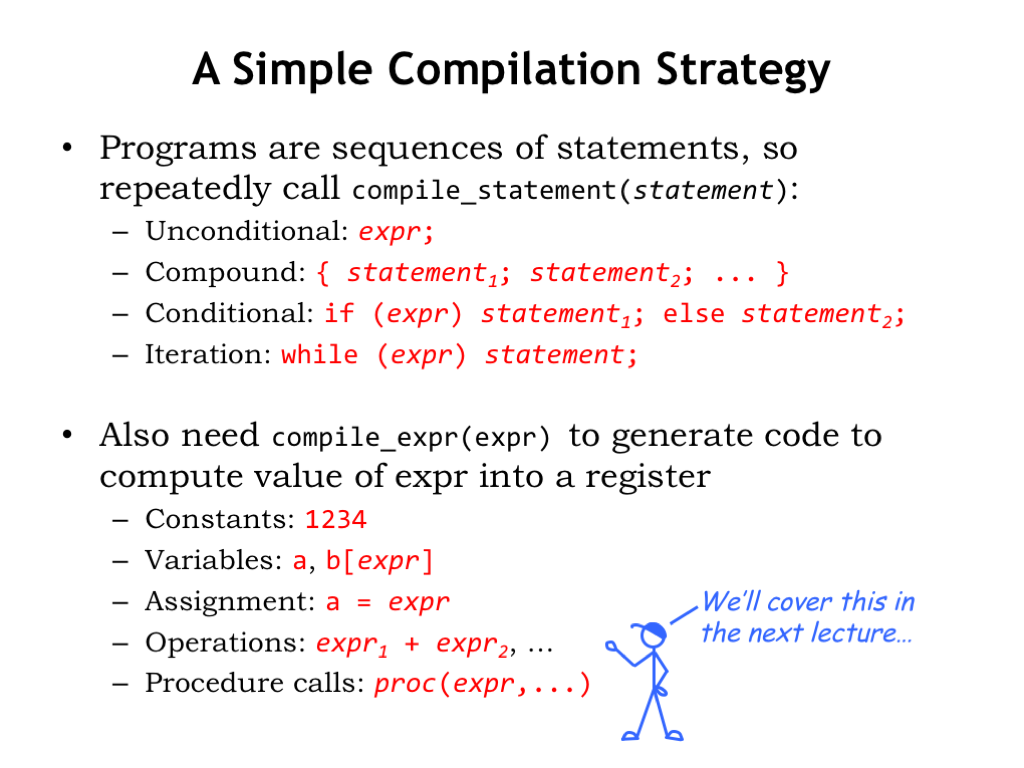
7. 简单编译策略(A Simple Compilation Strategy)

A Simple Compilation Strategy

两主例程:compile_statement 与 compile_expr。源程序是语句序列,反复调前者。关注四类语句:无条件(求一次表达式)、复合(顺序执行子语句)、条件(if:测表达式真则执行 then)、以及迭代(后文 WHILE)。

compile_expr:生成求值表达式并把结果放在某寄存器的代码。表达式含常量、标量/数组变量、赋值、一元/二元运算、过程调用等。复杂算术可拆成一元/二元序列。过程调用留待下讲;其余表达式与语句可直接模板化。

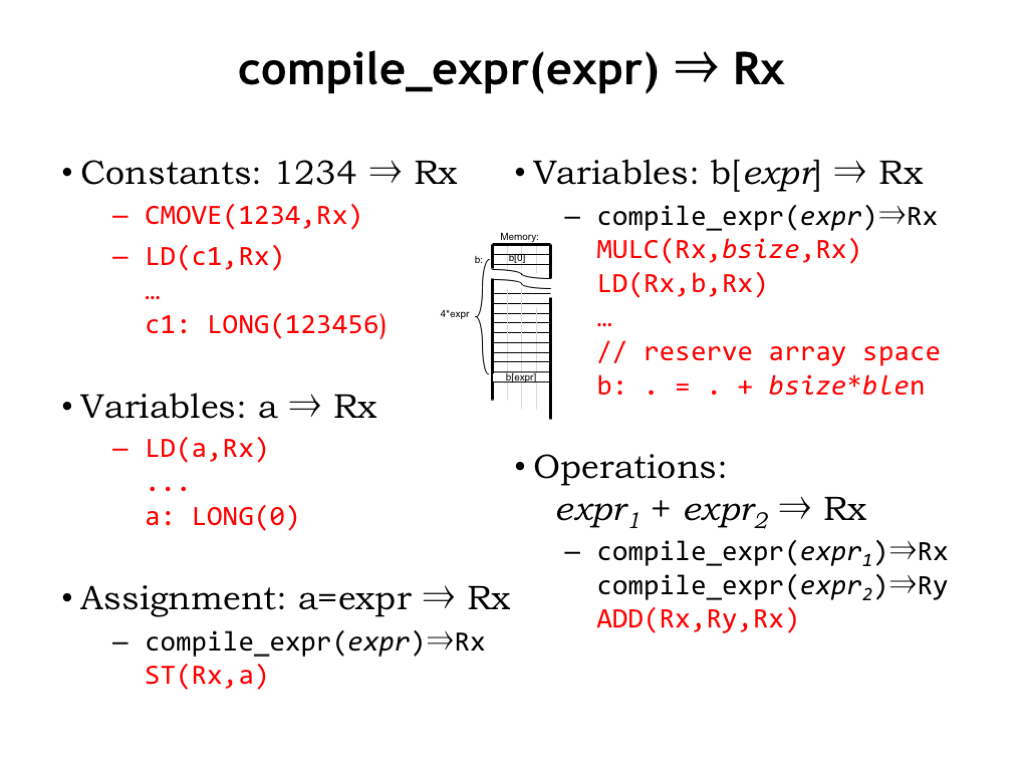
8. compile_expr(expr) → Rx

compile_expr expr to Rx
  • 小常量(−32768∼+32767-32768\sim +32767):CMOVE 符号扩展进寄存器;过大则存主存再 LD。
  • 变量:与大常量类似,LD 对应地址。
  • 数组访问:元素连续存放;先 compile_expr 得下标于 Rx,再乘元素字节数 bsize(如 int 为 4)得字节偏移,LD 基址+偏移取元素。
  • 赋值:compile_expr 得右值,再 ST 到左值变量。
  • 算术:分别编译操作数到寄存器,再生成对应 ALU 指令。

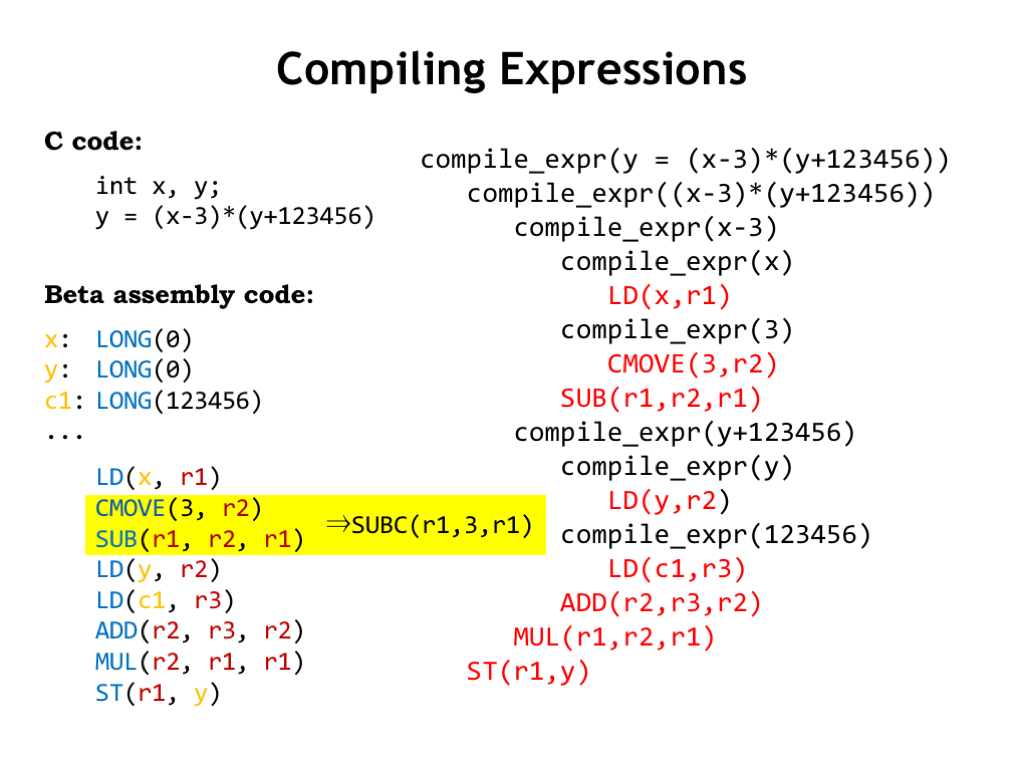
9. 编译表达式(Compiling Expressions)

Compiling Expressions

例:含减、乘、加的赋值。按赋值模板递归编译 RHS;遇乘则再编译左操作数(减)……直至叶节点(变量/常量)生成 LD/CMOVE,再沿表达式树上返回生成 SUB/MUL/ADD 等。

此即递归下降(recursive descent):每层表达式更简单,直到叶。相邻指令还可做窥孔优化(peephole):如 CMOVE 后跟算术常可合并为带常量操作数的单条指令。

10. compile_statement

compile_statement
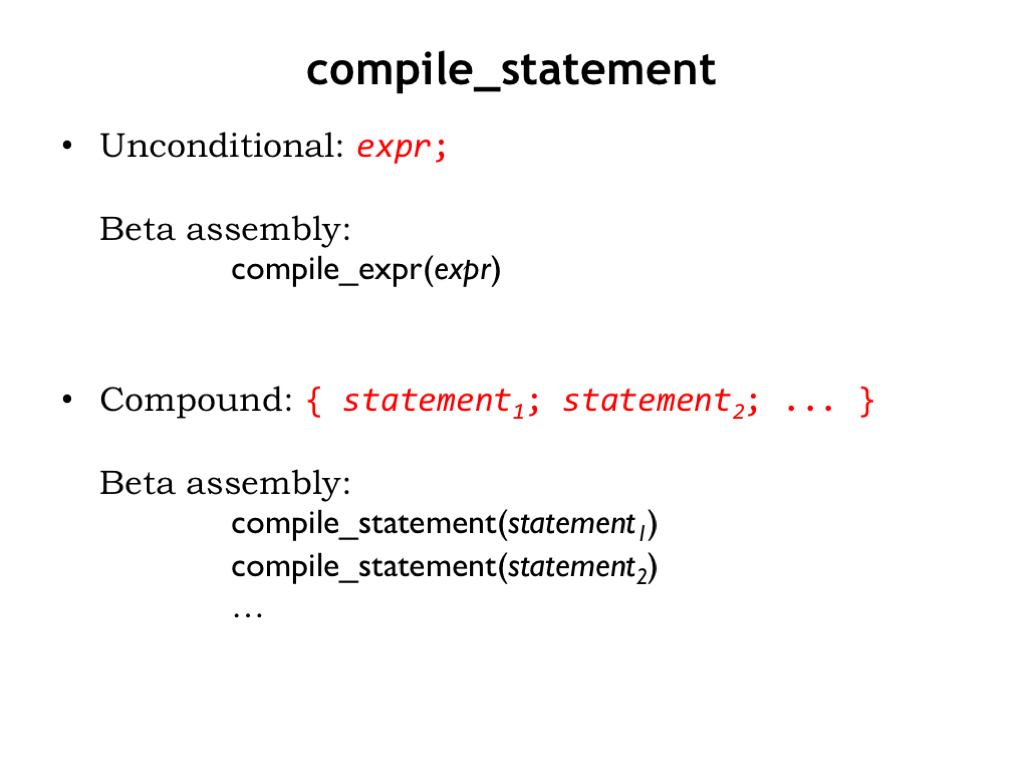
  • 无条件语句:多为赋值或过程调用 → 交给 compile_expr。
  • 复合语句:对每个子语句递归 compile_statement;生成代码首尾相接,顺序执行。

11. compile_statement:条件(Conditional)

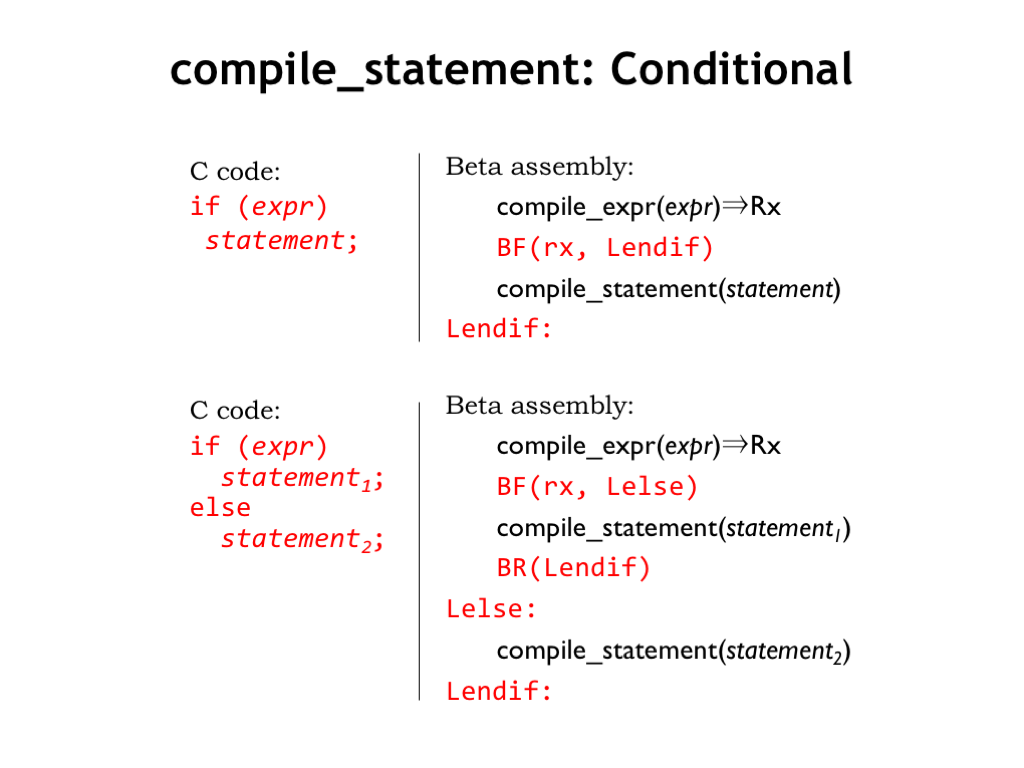
compile_statement Conditional

最简 if:编译 test;若寄存器为 FALSE,分支跳过 THEN 子句代码。完整 if–else 用分支与标签保证:真走 then,假走 else,最后汇合。
编译本质:套用许多小模板,逐步把代码生成拆成更小任务,并用分支把碎片粘成正确控制流。

12. compile_statement:迭代(Iteration)

compile_statement Iteration

while 模板类似 if,末尾再分支回测表达式,直到为假。可重组使每轮只需一条 BT(原模板每轮 BF+BR),循环内小优化可累积为大收益。
for 可改写成带更新的 while,再套上述模板。

13. 综合:阶乘(Putting It All Together: Factorial)

Putting It All Together Factorial

把模板套到迭代版阶乘:生成代码可与前述模板一一对应。非最优,但递归下降已够用。

14. 优化:值留在寄存器(Optimization: keep values in regs)

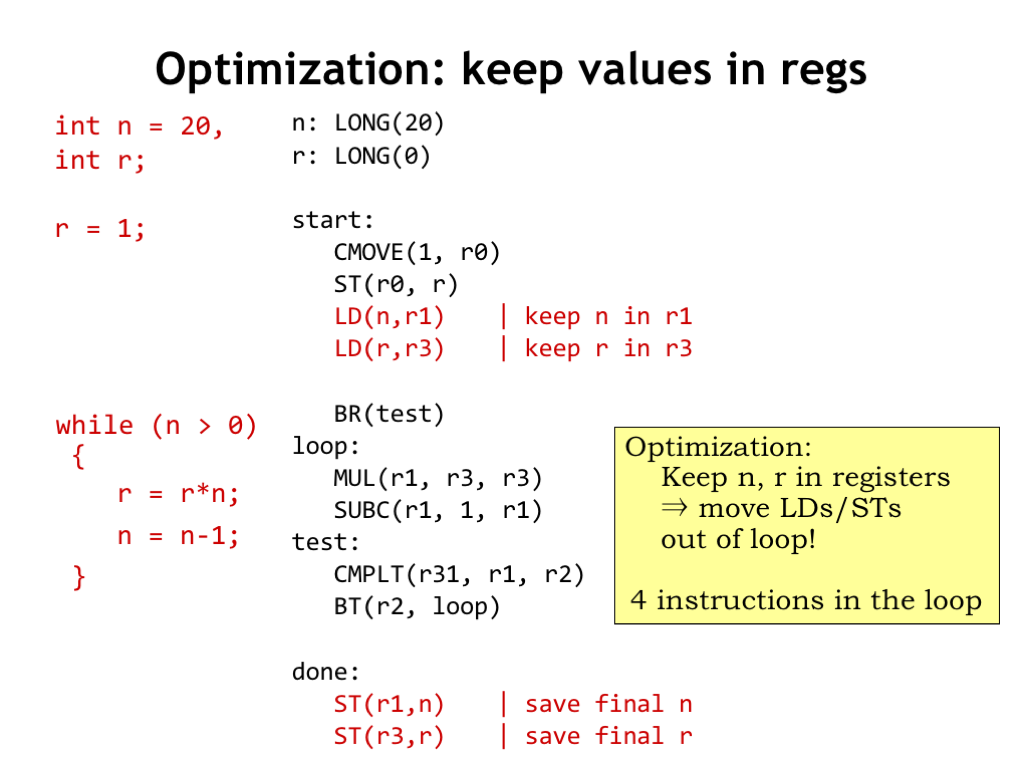
Optimization keep values in regs

让变量住在专用寄存器而非主存,可少掉大量 LD/ST。例:循环内指令从 10 条减到 4。优化编译器擅长找此类机会。下文改谈更一般的现代编译器流程。

15. 现代编译器解剖(Anatomy of a Modern Compiler)

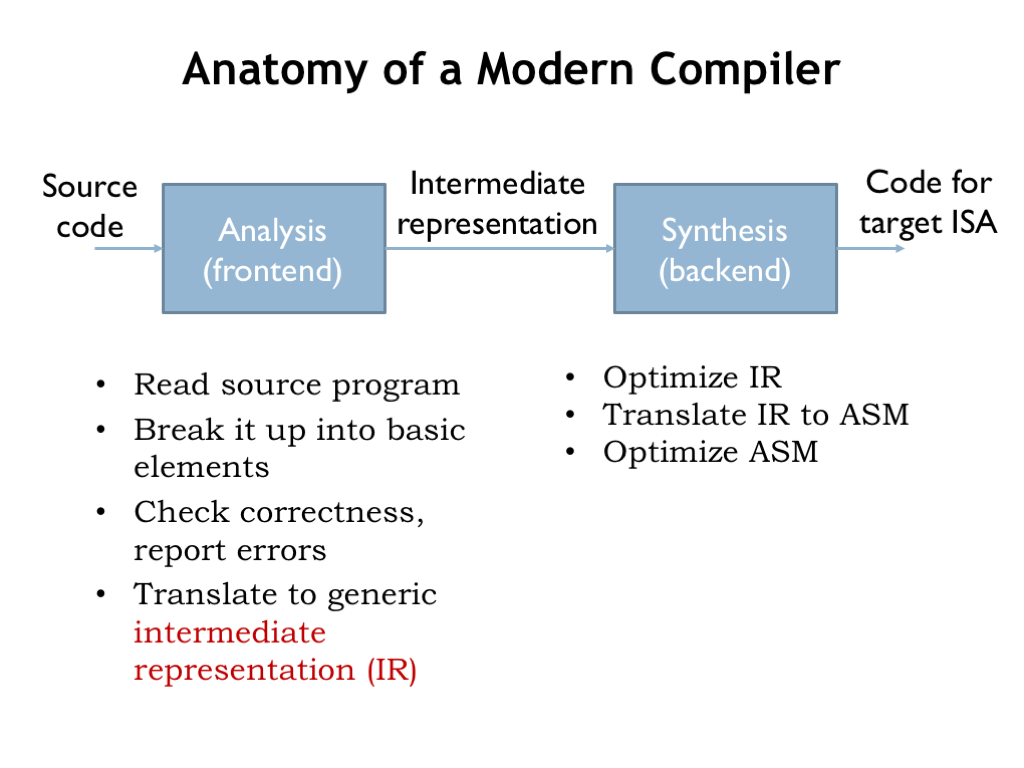
Anatomy of a Modern Compiler
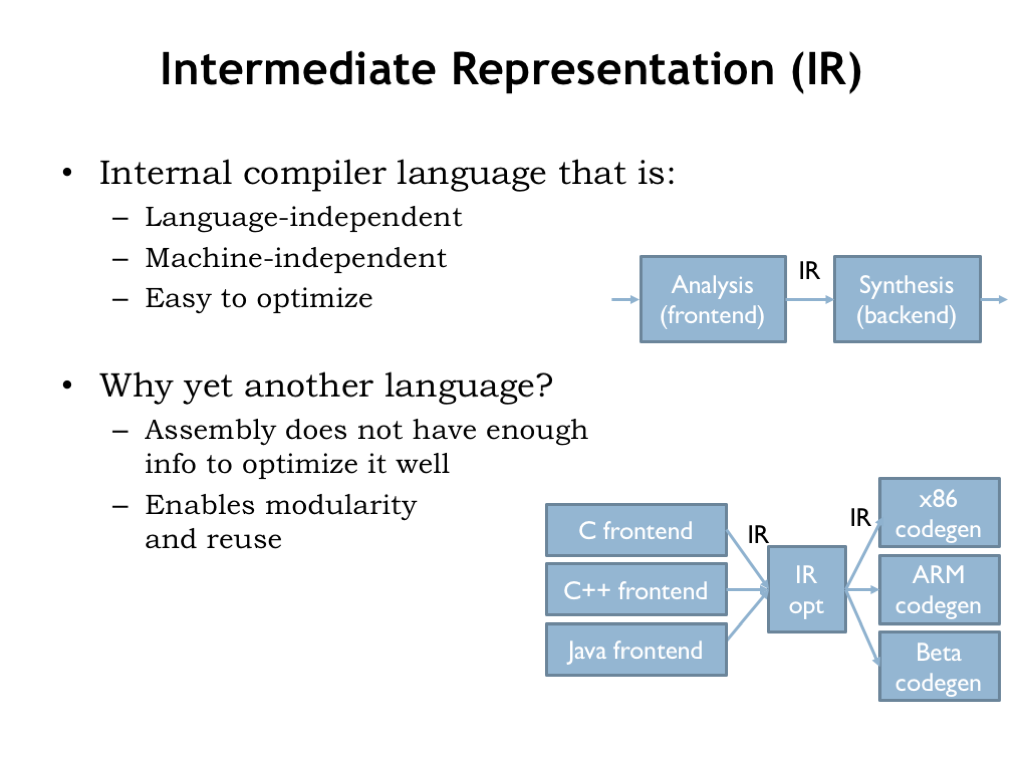
  • 前端 / 分析:检查语法与语义(类型等),把源程序变成机器无关的中间表示(IR)。多语言前端可共享同一 IR。
  • 后端 / 综合:先对 IR 做优化(如把与循环下标无关的运算提出循环),再为目标 ISA 生成指令,并做 ISA 相关窥孔优化(如 Beta 上 CMOVE+算术合并)。

16. 前端:词法分析(Frontend Stages: Lexical Analysis)

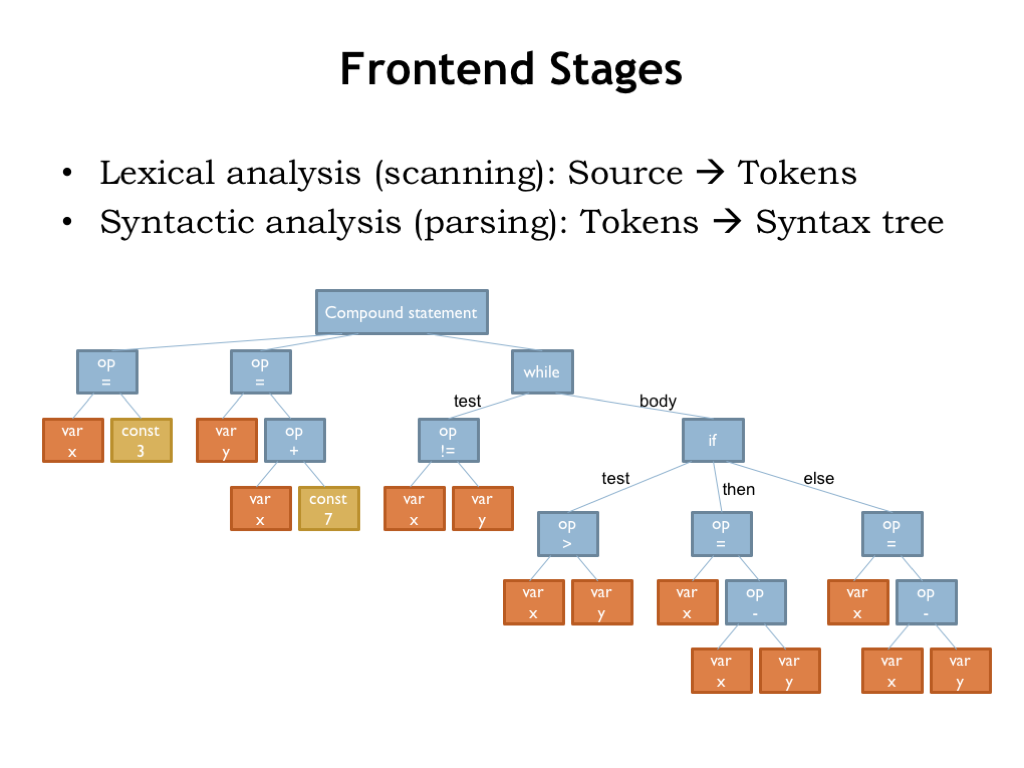
Frontend Stages Lexical Analysis

扫描源文本 → token 序列;空格/制表/换行仅作分隔,扫描后去掉。token 带文件名、行号、列号以便报错。非法 token(如 C 中 3x)在此阶段报错。

17. 前端:语法分析(Frontend Stages: Syntactic Analysis)

Frontend Stages Syntactic Analysis

解析(parsing)把 token 建成语法树(syntax tree):操作数挂到一元/二元结点,语句各部件标好角色。树结点标签与前述代码模板对应;深度优先遍历即可按标签选模板——但先还要做语义分析与变换。

18. 前端:语义分析(Frontend Stages: Semantic Analysis)

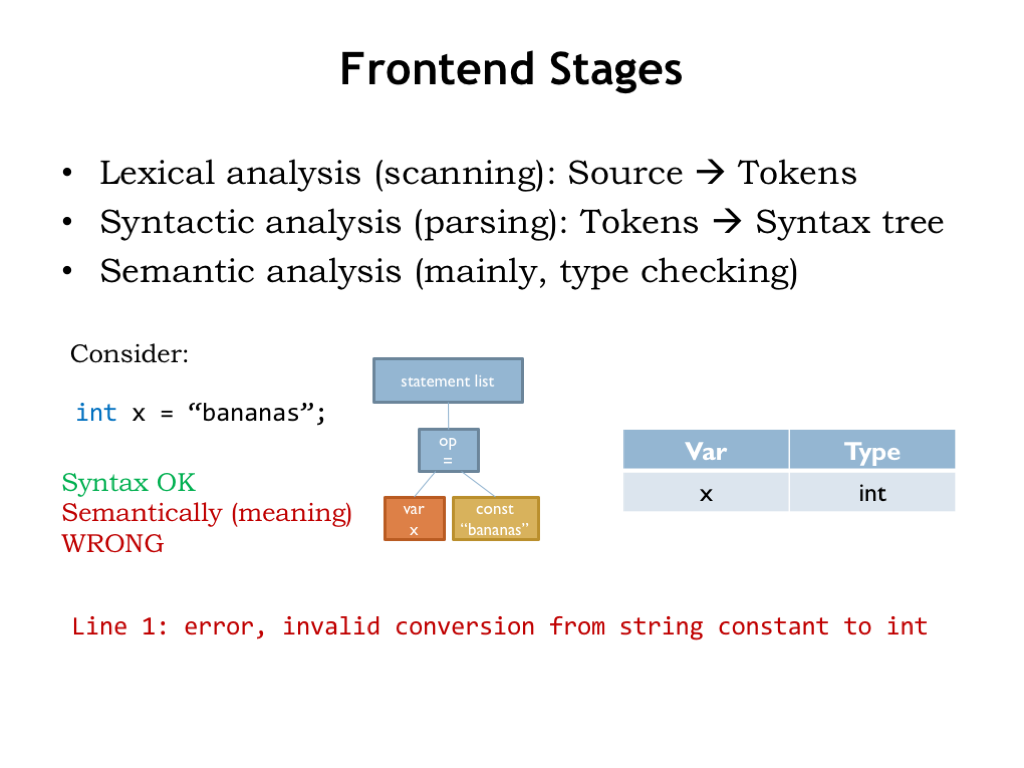
Frontend Stages Semantic Analysis

在语法树上检查语义:如 x = "bananas" 语法合法(左变量、右表达式),但若 x 声明为 int、右为 string,则类型不兼容。查符号表比对类型。完成后:语法树表示语法正确且语义有效的、语言无关的操作序列。

19. 中间表示 IR(Intermediate Representation)

Intermediate Representation IR

语法树是常用 IR:独立于源语言与目标 ISA;保留运算顺序与分组信息;允许多前端共用一后端。后端可再分:机无关 IR 优化 → 代码生成到目标 ISA。

20. 常用 IR:控制流图(Common IR: Control Flow Graph)

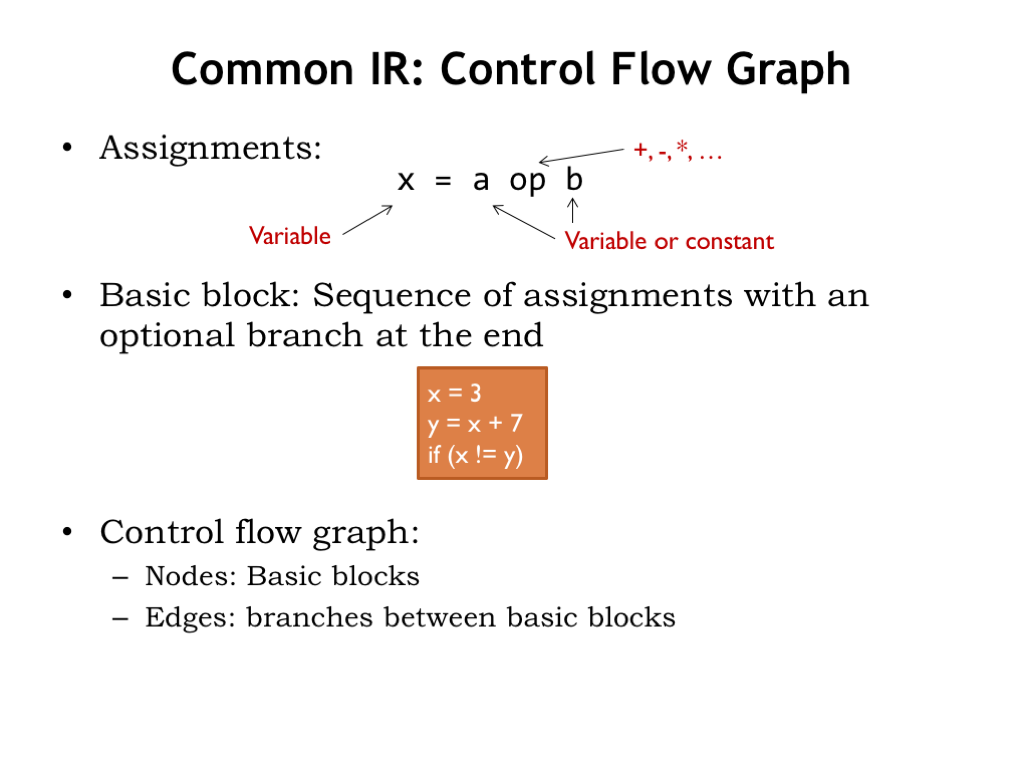
Common IR Control Flow Graph

把语法树重组为控制流图(CFG):结点为基本块(basic block)——以分支结束的赋值/表达式序列;一旦进入块,块内其余操作会连着执行。边表示跳转到哪一块。基本块边界清晰,便于寄存器暂存变量等优化。

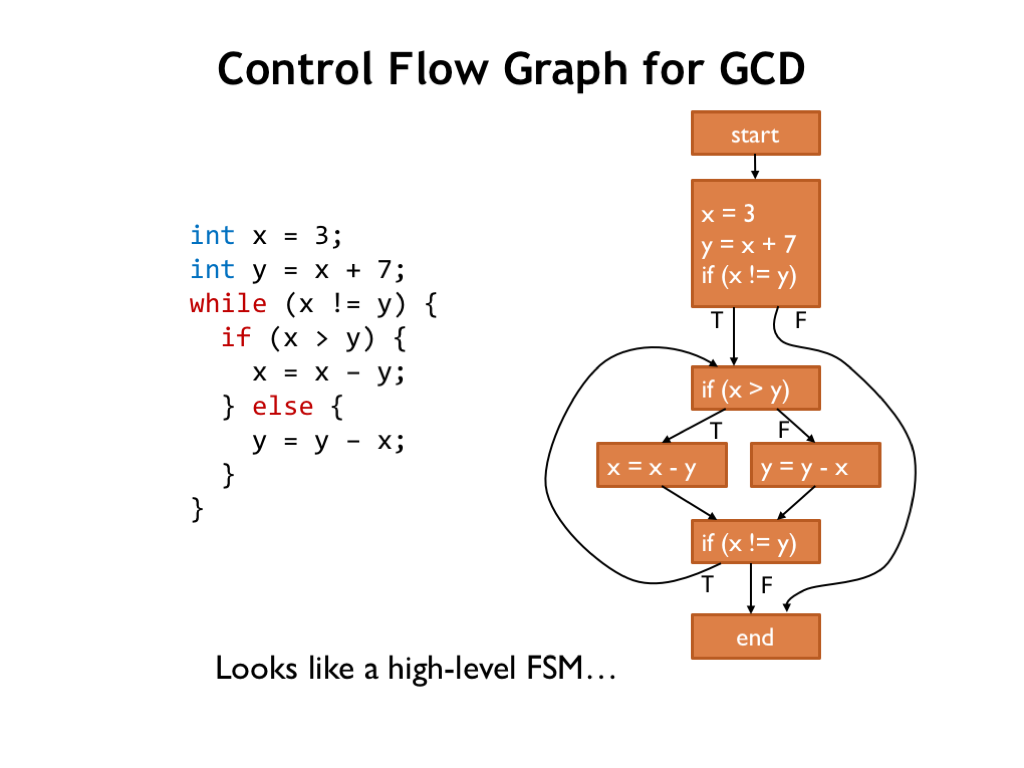
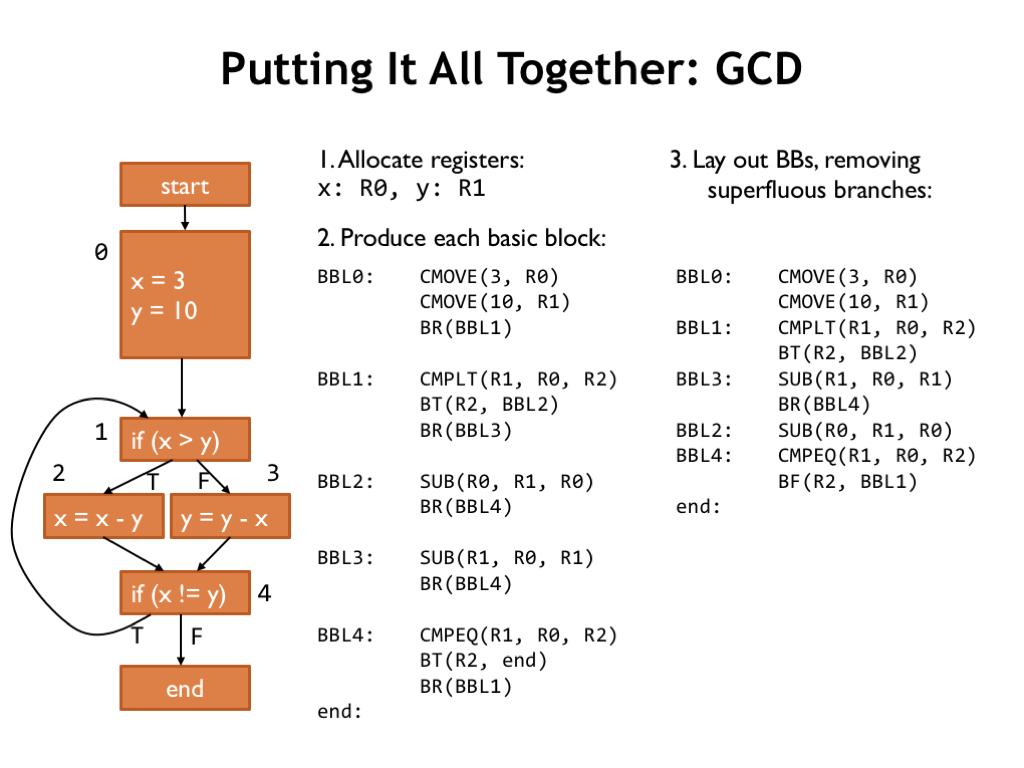
21. GCD 的控制流图(Control Flow Graph for GCD)

Control Flow Graph for GCD

条件分支块有标 T/F 的两条出边;无条件则单出边。若某块仅一个前驱,可继承前驱关于寄存器中已有 x、y 等知识;多前驱时只能用所有前驱共有的知识。CFG 很像高级 FSM 的状态转移图。

22. IR 优化(IR Optimization)

IR Optimization

对 CFG 多遍简单优化,反复直到无进展;简单变换可叠加出复杂效果。例:

  • 死代码消除(dead code elimination):删从未用的赋值、不可达块
  • 常量传播(constant propagation):已知常量的变量用常量替换引用
  • 常量折叠(constant folding):编译期求常量表达式

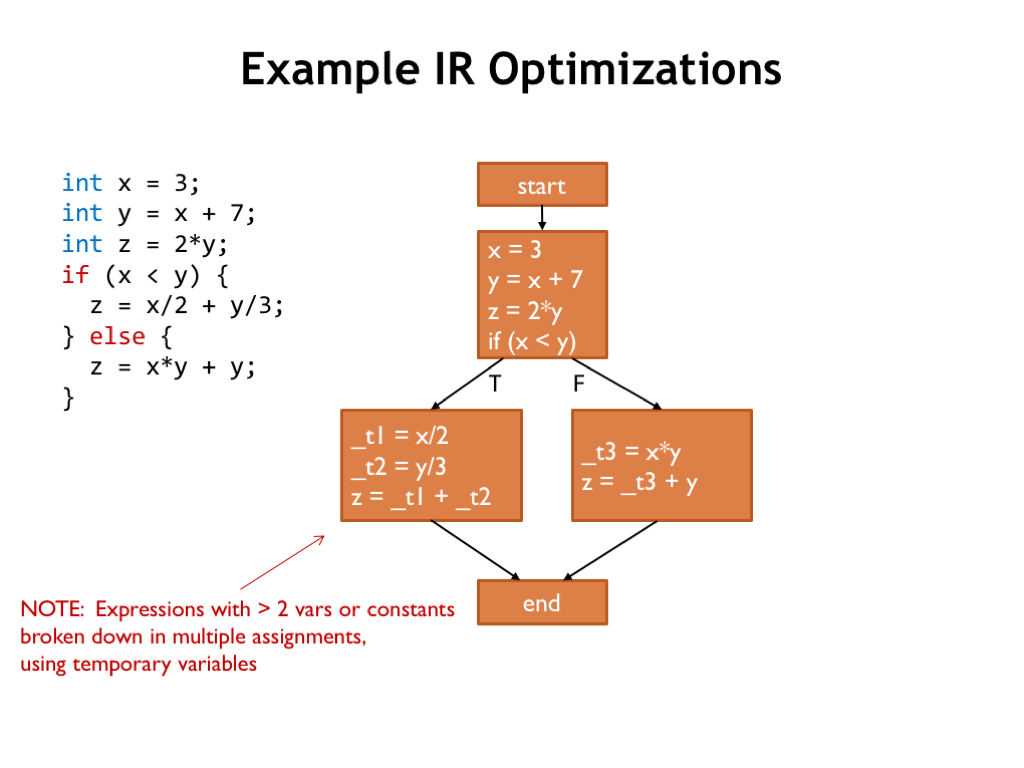
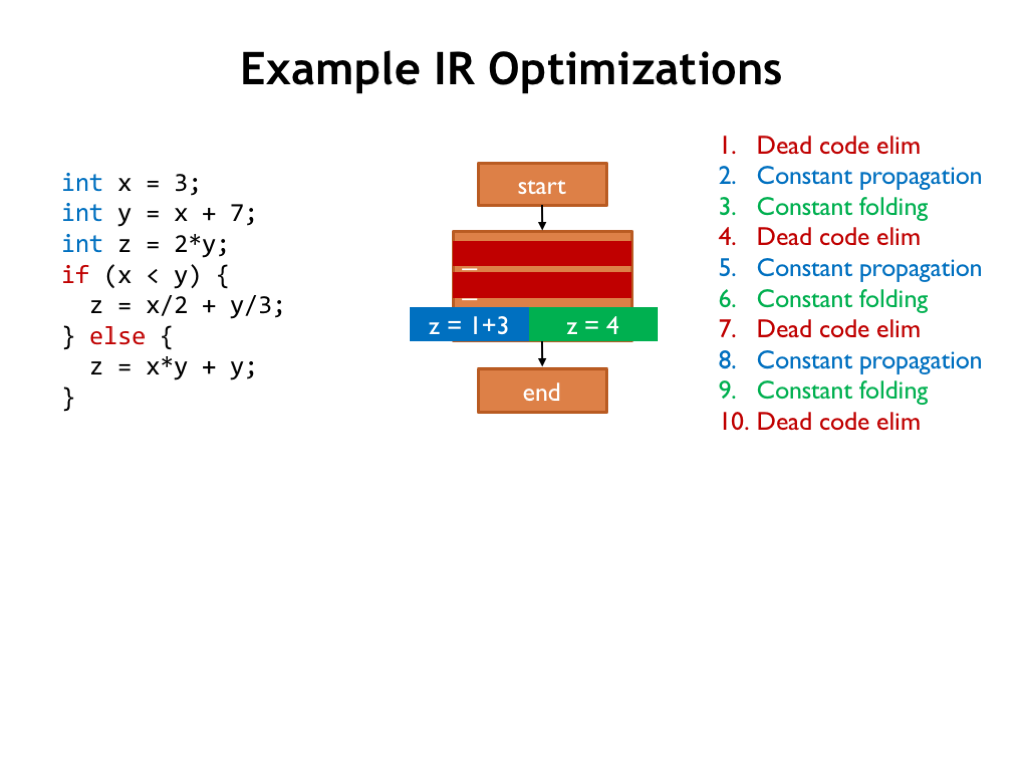
23. IR 优化示例 I(Example IR Optimizations I)

Example IR Optimizations I

略造作的源程序及其 CFG:复杂表达式拆成简单二元运算,中间结果用临时名如 _t1。

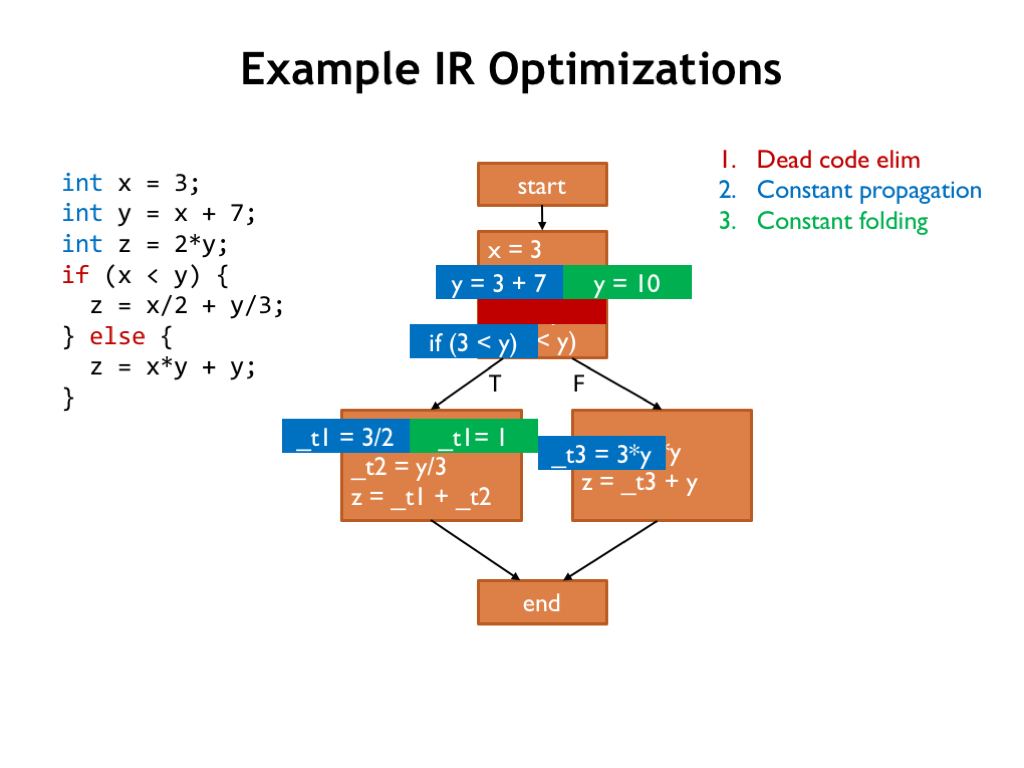
24. IR 优化示例 II(Example IR Optimizations II)

Example IR Optimizations II

死代码消除去掉第一块中对 Z 的赋值(后续再赋且中间未用);发现 X=3 且不再赋值 → 传播常量 3;再常量折叠。

25. IR 优化示例 II(续)(Example IR Optimizations II continued)

Example IR Optimizations II continued

更新后的 CFG 再一轮:死代码 → 常量传播 → 常量折叠。

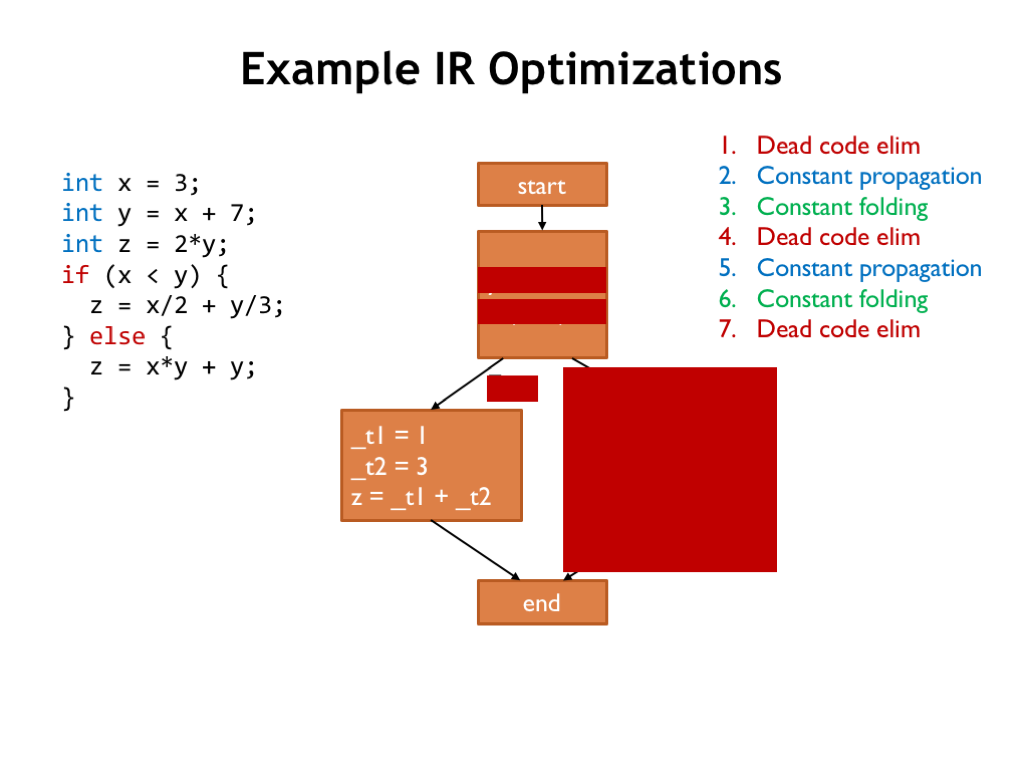
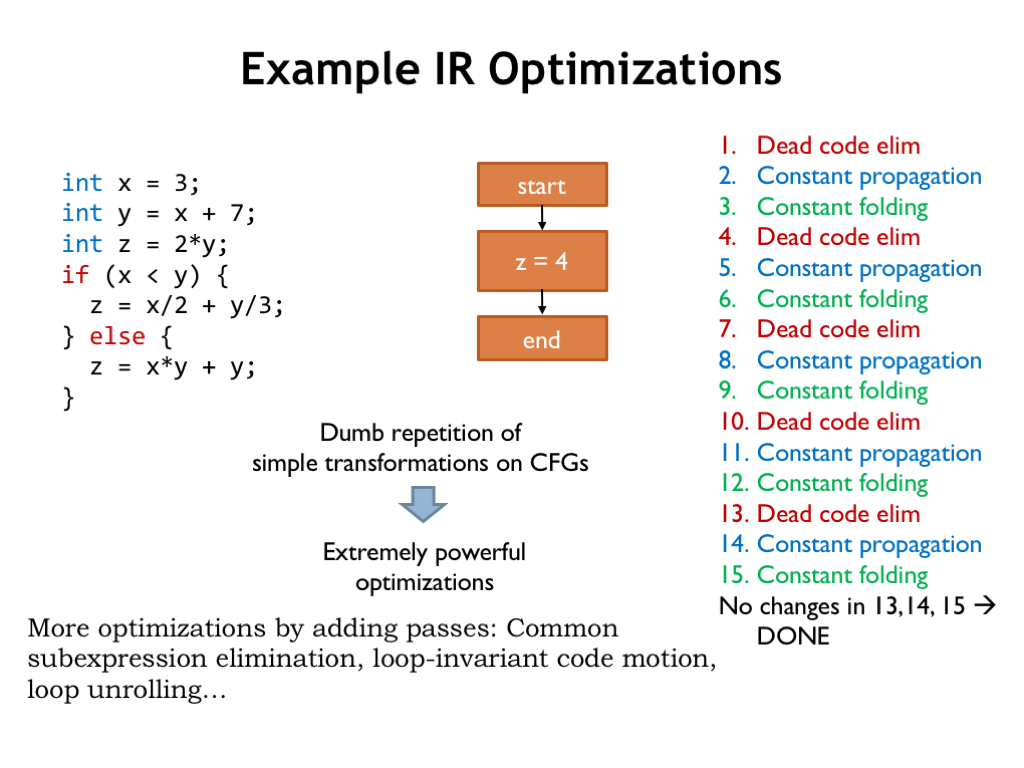
26. IR 优化示例 III(Example IR Optimizations III)

Example IR Optimizations III

两轮后赋值大减。第三轮:死代码;并可判定条件分支结果 → 删空块或不可达块。

27. IR 优化示例 IV(Example IR Optimizations IV)

Example IR Optimizations IV

IR 明显变小。继续常量传播、折叠、死代码消除。

28. IR 优化示例 IV(续)(Example IR Optimizations IV continued)

Example IR Optimizations IV continued

直到无更多优化。简单变换反复应用,得到算同一最终 Z 的更小程序。还可加:公共子表达式消除、循环无关代码外提、短循环展开等。

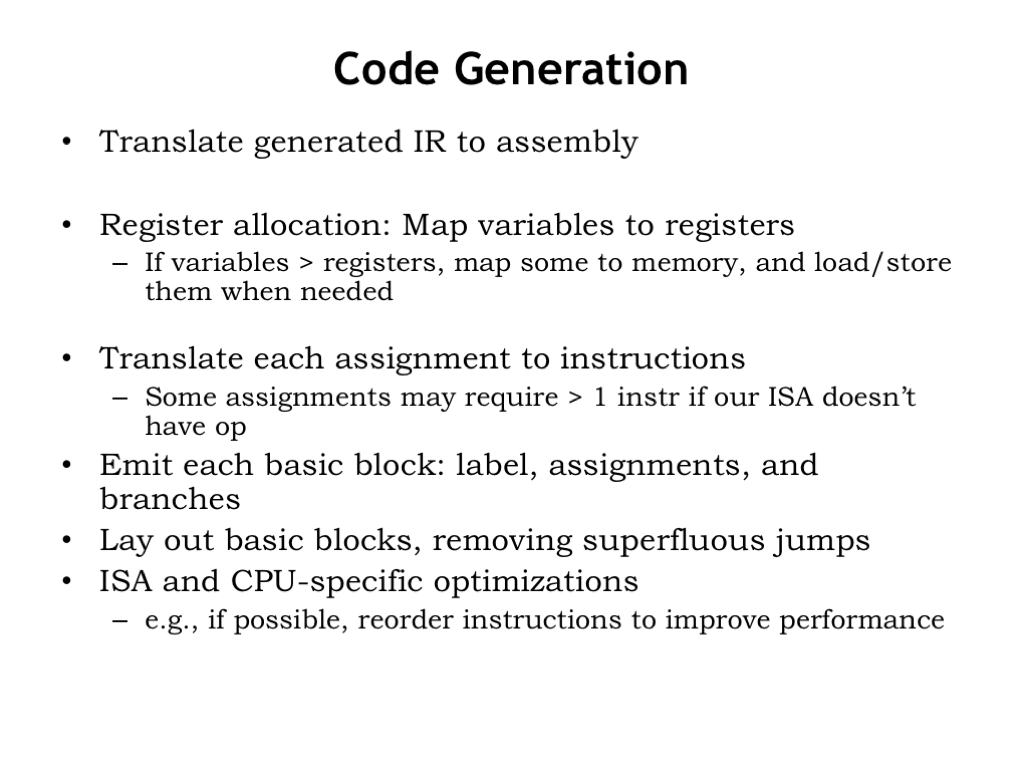
29. 代码生成(Code Generation)

Code Generation
  1. 为变量分配专用寄存器;不够则部分进内存,必要时 LD/ST
  2. 用模板把赋值/运算译成指令
  3. 按块发射,加标签与分支
  4. 重排基本块以尽量消除无条件跳转
  5. 目标相关窥孔优化

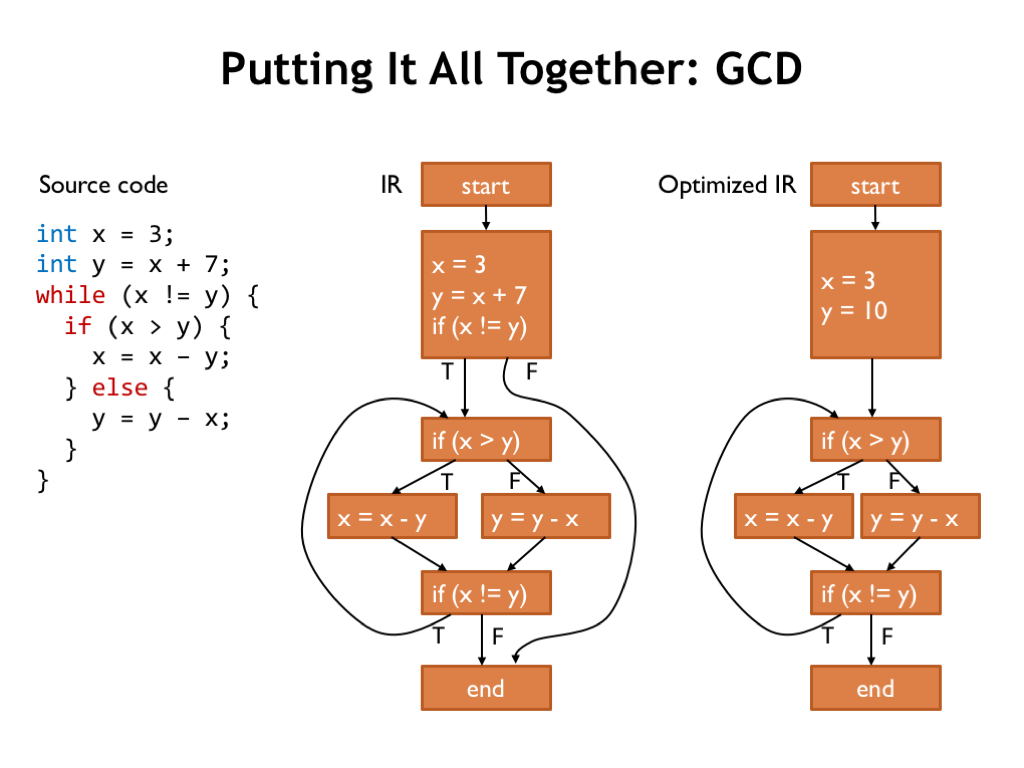
30. 综合 I(Putting It All Together I)

Putting It All Together I

GCD 的原 CFG 与略优化 CFG:主要是常量传播/折叠。顶块关于变量的知识不能简单传到多前驱的 if 块。

31. 综合 II(Putting It All Together II)

Putting It All Together II

为 x、y 专配寄存器;按块生成;重排消除无条件分支。结果已接近人手难再明显改进的质量。

32. 小结(Summary)

Summary

编译流水线按序把源码变为高质量汇编:词法 → 语法 → 语义 → IR/CFG 优化 → 代码生成。耐心多遍优化常优于手写汇编;程序员专注功能正确性,细节交给编译器。

整理自 MIT OCW 6.004 Computation Structures(Spring 2017)L10 注解幻灯片。

源网页:10.1 Annotated Slides | Assembly Language, Models of Computation

讲师:Chris Terman。图片直接引用 OCW 原站链接。

L10:汇编语言与计算模型(Assembly Language, Models of Computation)

本讲介绍 Beta 的 UASM 汇编(符号、标号、宏、伪指令),再上升到计算模型:FSM 局限、图灵机、Church 论题、通用机与不可计算性(停机问题),说明 Beta ISA 的图灵完备性。

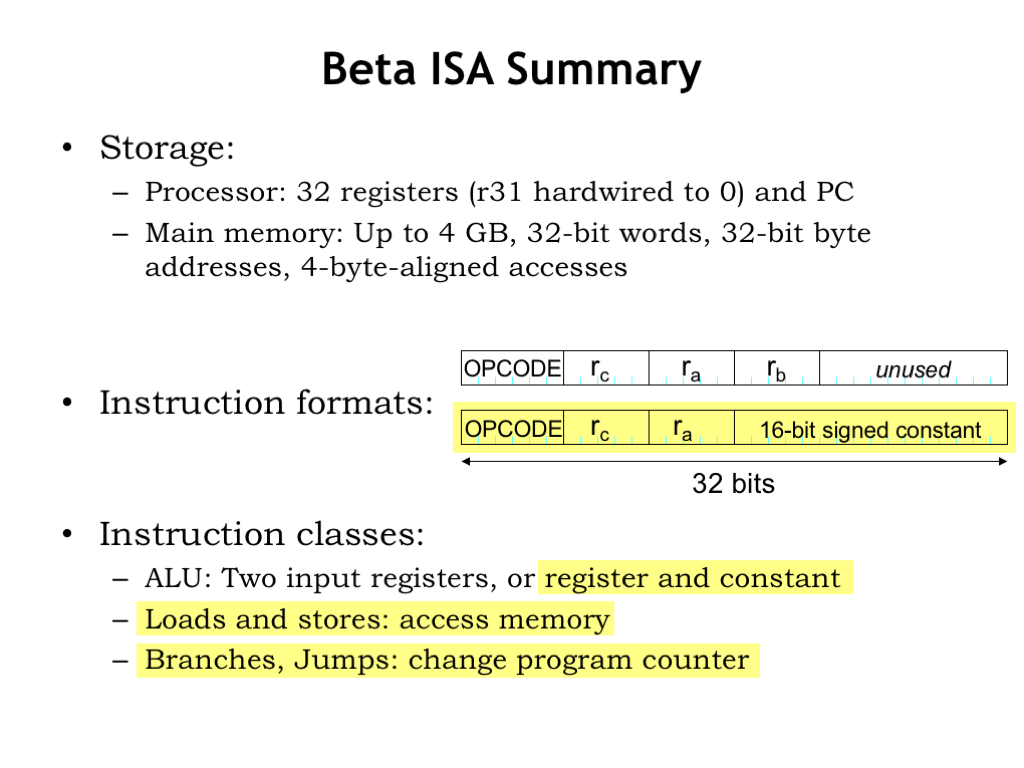
1. Beta ISA 回顾(Beta ISA Summary)

Beta ISA Summary

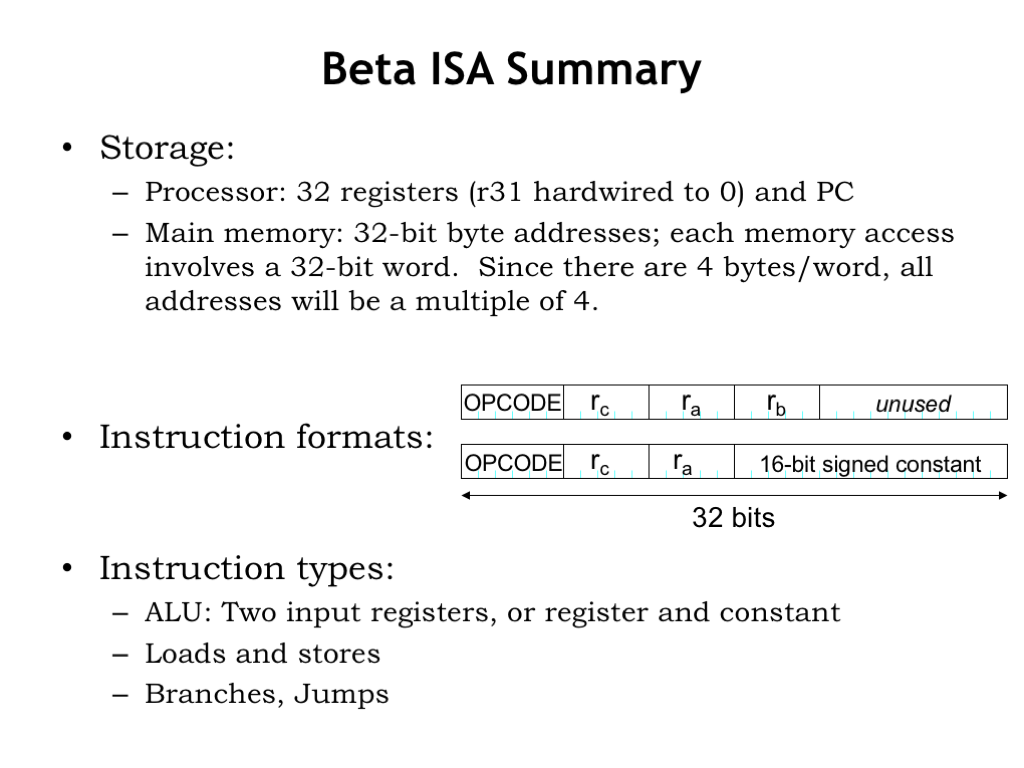
回顾:32 个通用寄存器 + PC;主存最多 2322^{32} 字节(2302^{30} 个 32 bit 字),指令与数据同存。指令 32 bit:6 bit OPCODE,5 bit Ra/Rb/Rc;两种格式(三寄存器 / 两寄存器+16 bit 常数)。三类:ALU、Load/Store、分支与跳转。

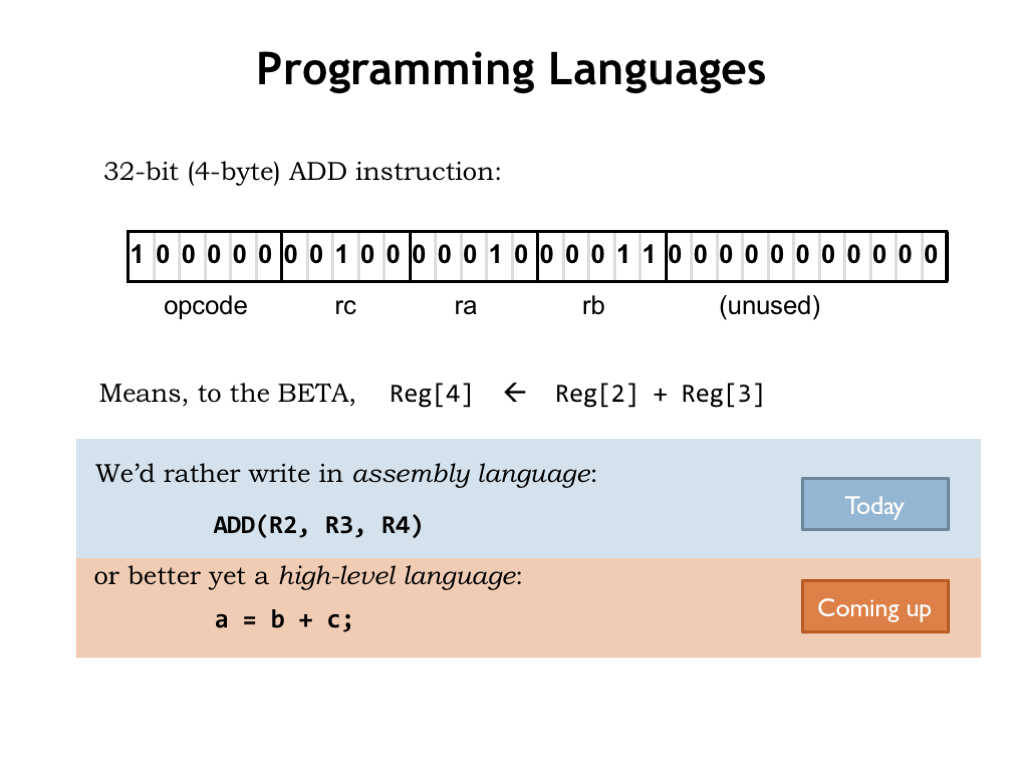
2. 编程语言(Programming Languages)

Programming Languages

手写二进制编码不现实 → 汇编用符号写 opcode 与操作数;仍需管寄存器与指令序列。高级语言再升一层:变量与数学运算。本讲 UASM;下讲 C→汇编。还可再叠解释器(如 C 实现 Python)——选合适语言表达,经多层翻译落到 Beta 指令。

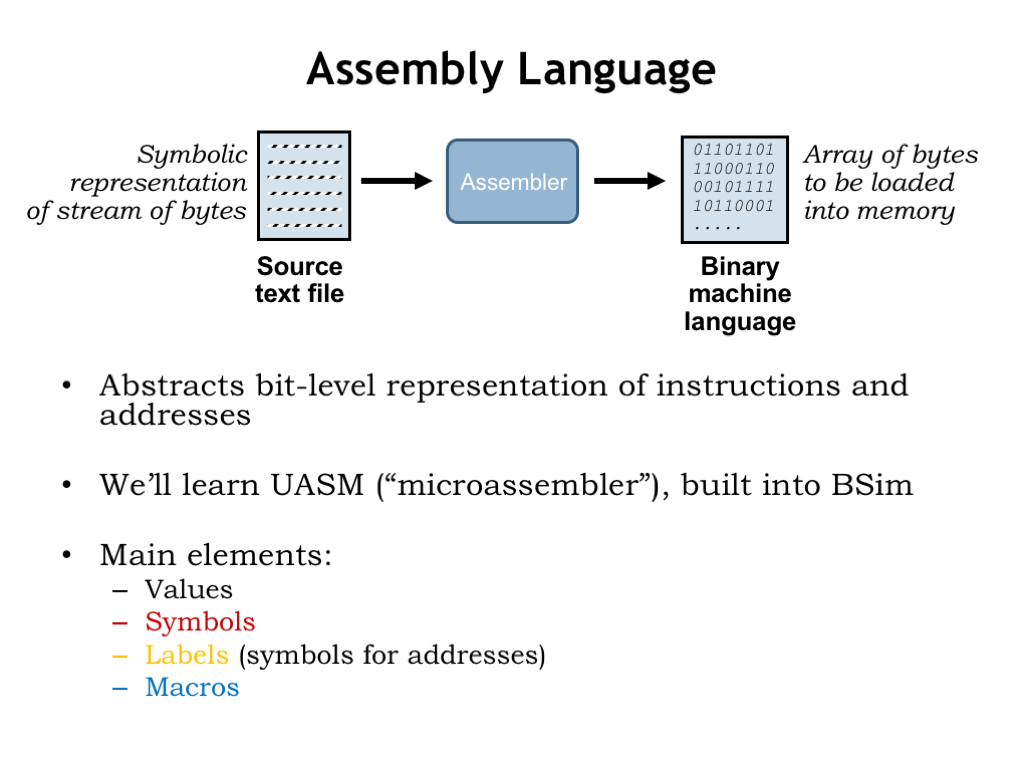
3. 汇编语言(Assembly Language)

Assembly Language

汇编器读文本 → 产出初始化主存的 32 bit 字数组。BSim 内建 UASM:实质是花哨计算器——求值算术表达式得字节,依次填入字节数组。支持符号/标号命名值与地址,宏封装指令/数据的字段拼装。

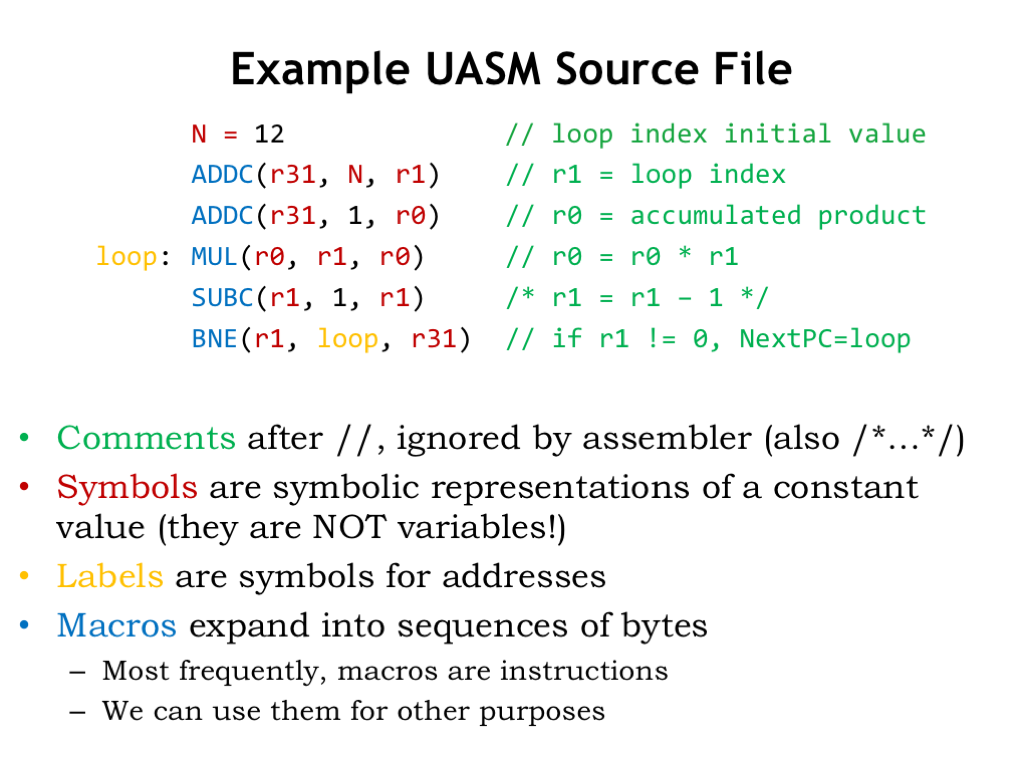
4. UASM 源文件例子(Example UASM Source File)

Example UASM Source File

通常一行一条语句。注释:// 至行末,或 /* … */ 跨行。

  • 符号(symbol):常量的名字,如 N=12;改一处即可。R0–R31 预定义为 0–31,便于区分寄存器与立即数
  • 标号(label):某内存地址的名字(如下文 loop)

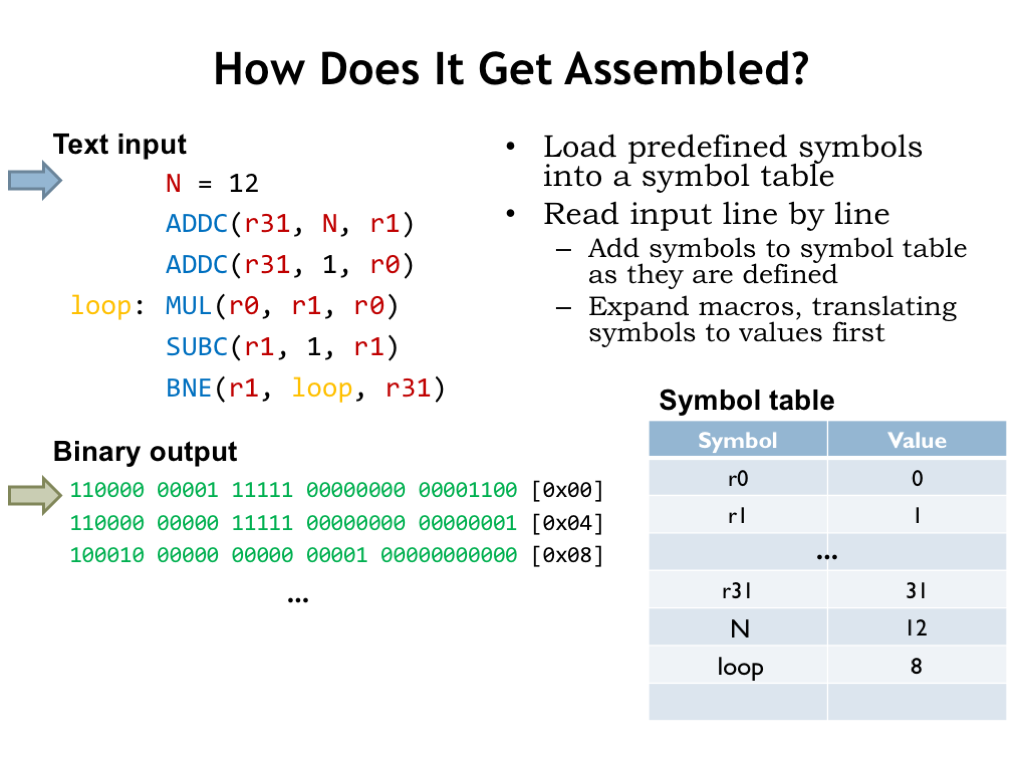
5. 如何汇编?(How Does It Get Assembled?)

How Does It Get Assembled

维护符号表(初含寄存器符号)。逐行:定义符号/标号、展开宏、求值写字节。例:N=12 入表;ADDC(r31,N,r1) 展开为地址 0 的 32 bit 字;loop: 记下当前地址后展开 MUL。

两遍扫描:第一遍收齐符号/标号;第二遍生成二进制 → 支持前向引用(如向前分支)。

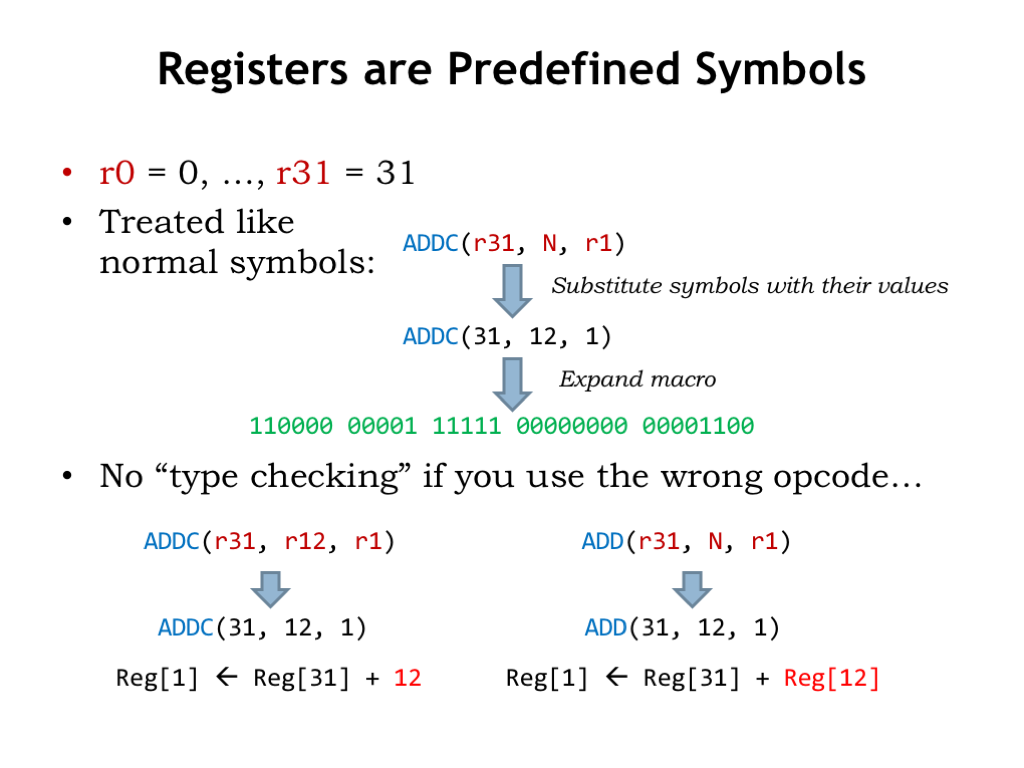
6. 寄存器是预定义符号(Registers Are Predefined Symbols)

Registers Are Predefined Symbols

寄存器无魔法:只是 0–31 的符号。ADDC(r31,N,r1) 实际变成 ADDC(31,12,1)。若把寄存器符号用在期望立即数处(或反之),UASM 仍按数值解释——操作数含义由 opcode 宏决定,不由写法直觉决定,写汇编须清醒。

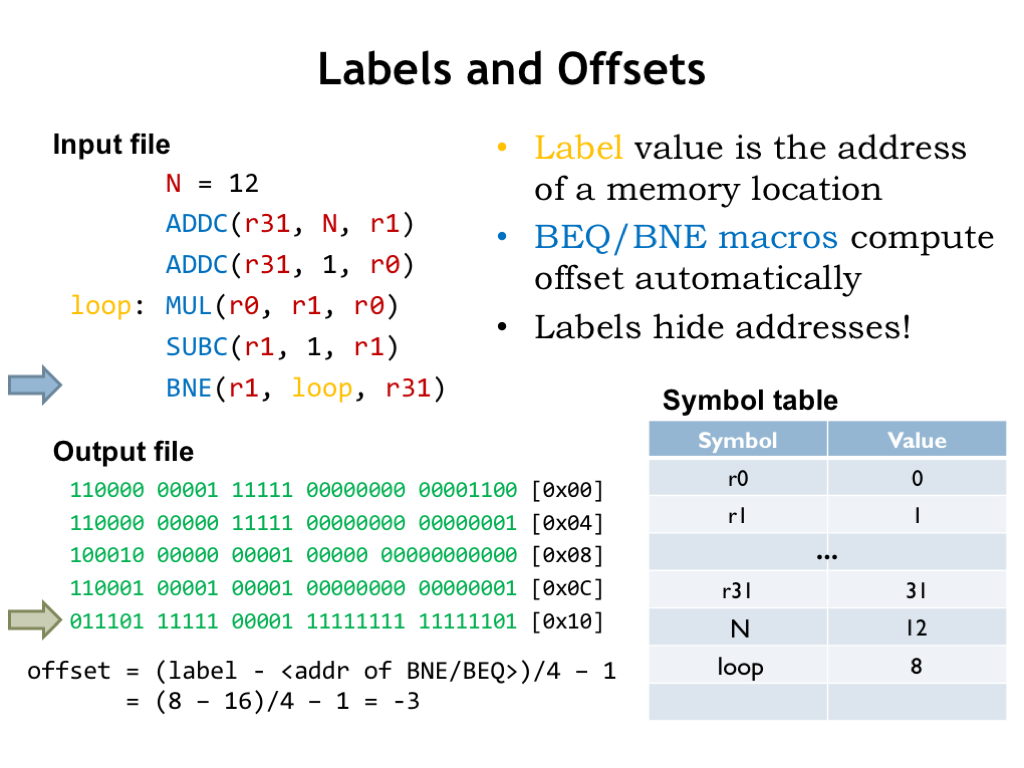
7. 标号与偏移(Labels and Offsets)

Labels and Offsets

分支用相对下一条指令的字偏移(−1-1 指向分支自身)。宏内嵌偏移公式:程序员写目标标号,UASM 算 16 bit 补码。例:BNE 回跳 3 条 → 偏移 −3-3。

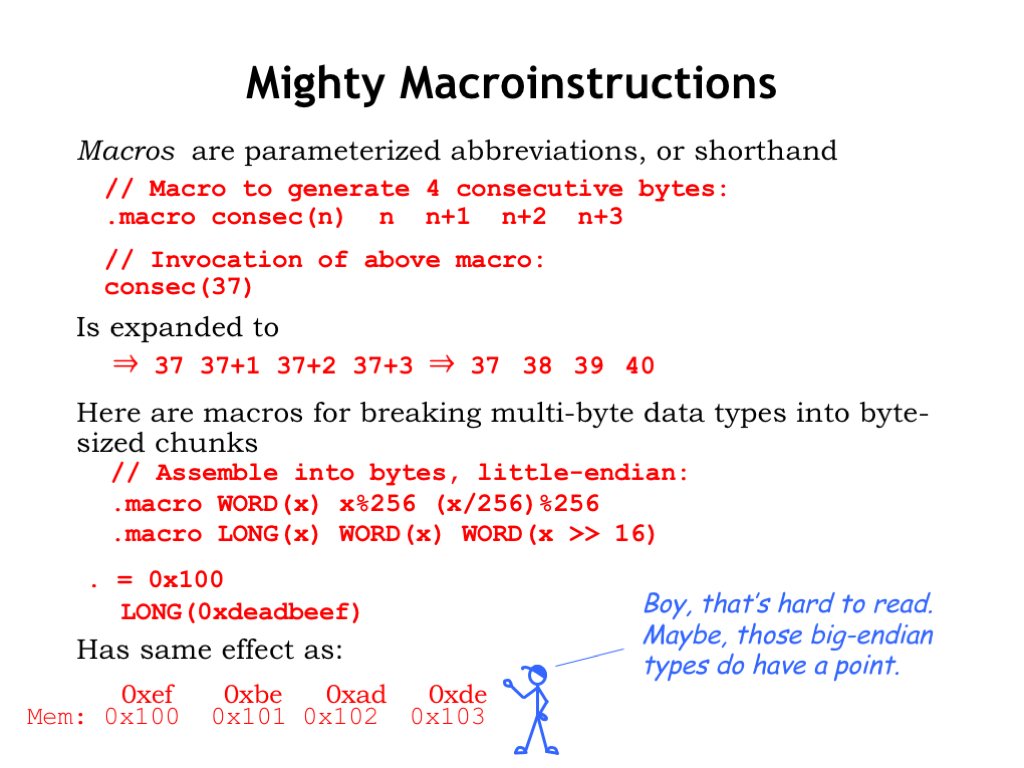
8. 强大的宏指令(Mighty Macroinstructions)

Mighty Macroinstructions

宏:参数替换后当原文再处理,可嵌套。WORD/LONG 把值拆成 2/4 字节。Beta 为 little-endian:最低有效字节在最低地址(如 0xDEADBEEF 在 0x100 处先存 0xEF)。亦有 big-endian;跨 ISA 传多字节值常需转换。名称源自《格列佛游记》大小端之争。

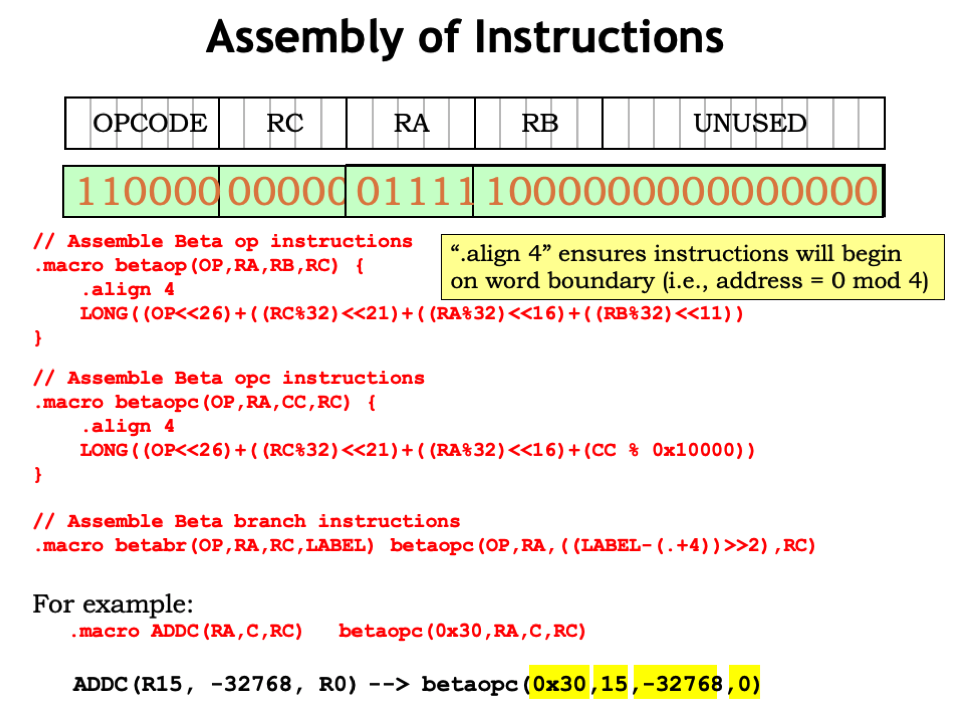
9. 指令的汇编(Assembly of Instructions)

Assembly of Instructions

辅助宏 BETAOP:三寄存器格式;.align 4 保证字对齐;LONG 拼字段:各域 % 截断再 << 到位。BETAOPC 处理含 16 bit 常数的格式。例:ADDC 把 opcode 0x30、RA、常数、Rc 移位或运算拼成一字——“assemble” 字面义。

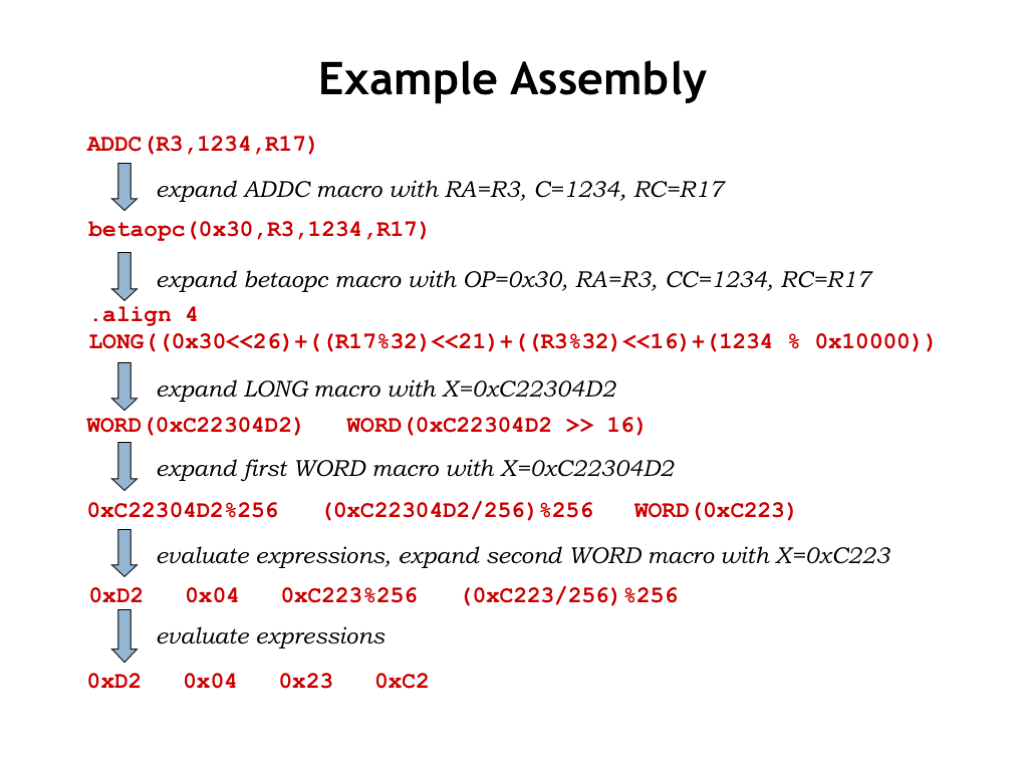
10. 汇编例子(Example Assembly)

Example Assembly

一次 ADDC 的完整宏展开链:格式与 opcode 知识封在宏体里。换一套宏定义,UASM 可服务几乎任意 ISA。

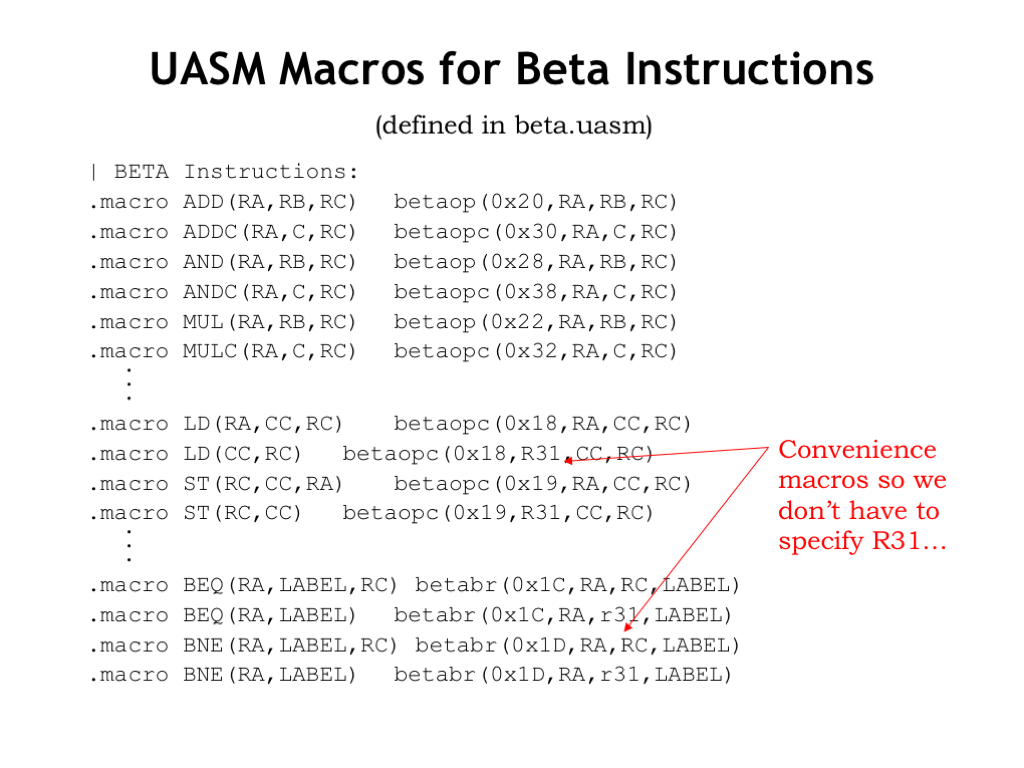
11. Beta 指令的 UASM 宏(UASM Macros for Beta Instructions)

UASM Macros for Beta Instructions

定义在 beta.uasm(实验会 include)。便利宏:分支常丢弃 PC+4 → 两参数形式默认 Rc=R31,少打字、更易读。

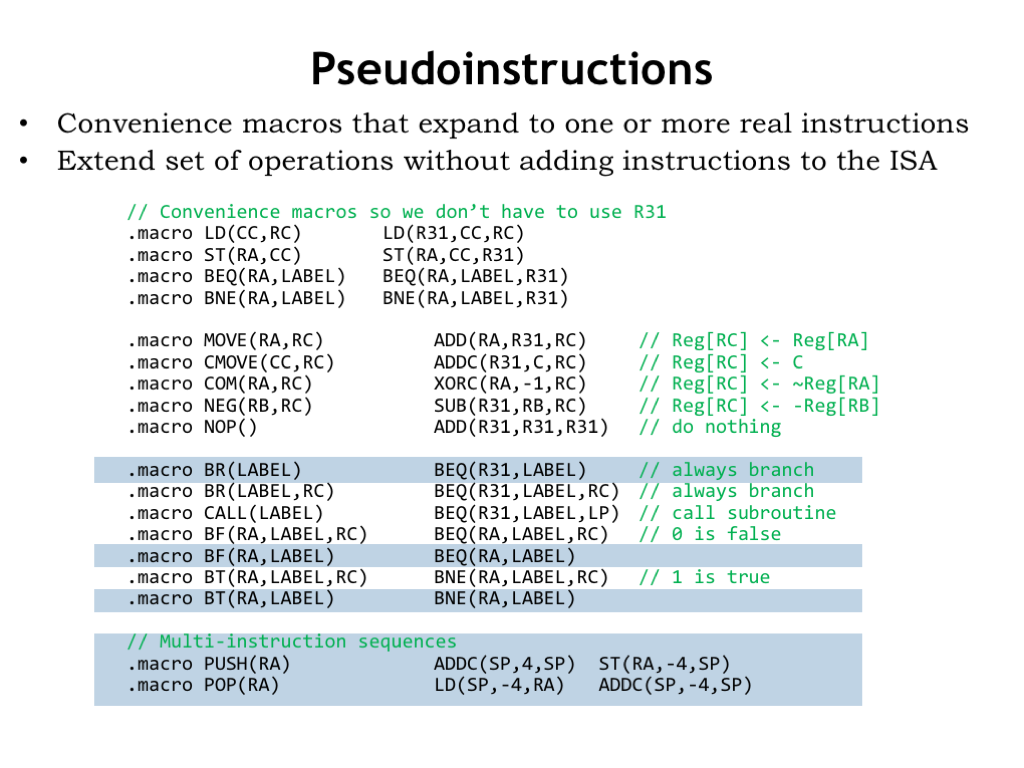
12. 伪指令(Pseudoinstructions)

Pseudoinstructions

可读性宏:BR() 代替 BEQ(R31,…);BF/BT 配合比较结果;PUSH/POP 展开为多指令操作 SP 栈。称 pseudoinstructions:表面上更大指令集,底层仍是 L09 那套。

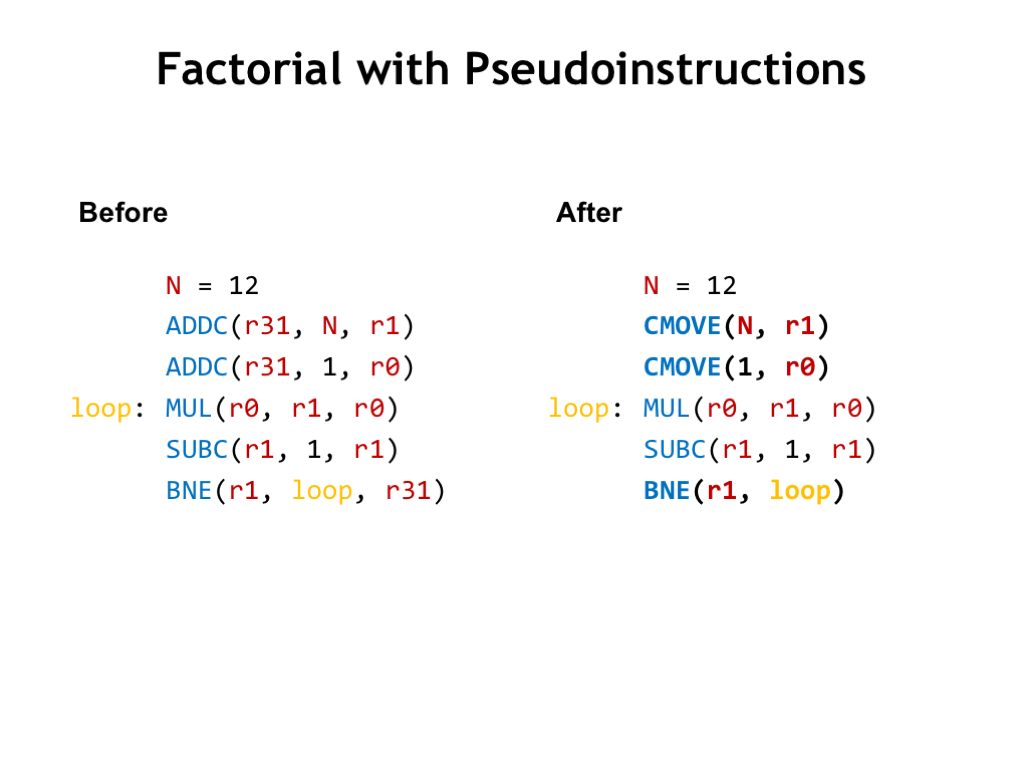
13. 用伪指令写阶乘(Factorial with Pseudoinstructions)

Factorial with Pseudoinstructions

例:CMOVE 表示“装小常数”,比展开后的 ADDC(加到 0)更易懂。减少认知噪音长期受益。

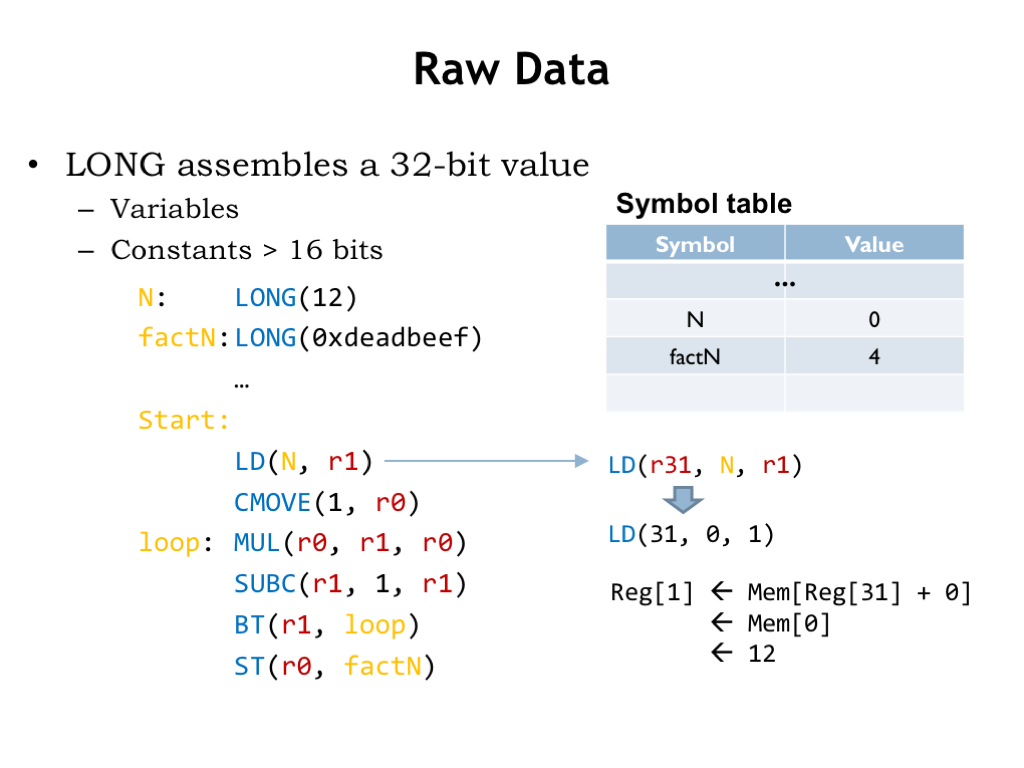
14. 原始数据(Raw Data)

Raw Data

LONG 分配并初始化数据;标号记地址(如 N→0,factN→4)。LD 便利宏默认 Ra=R31:地址 = 0 + 常数(标号值)→ 把该处字装入寄存器。

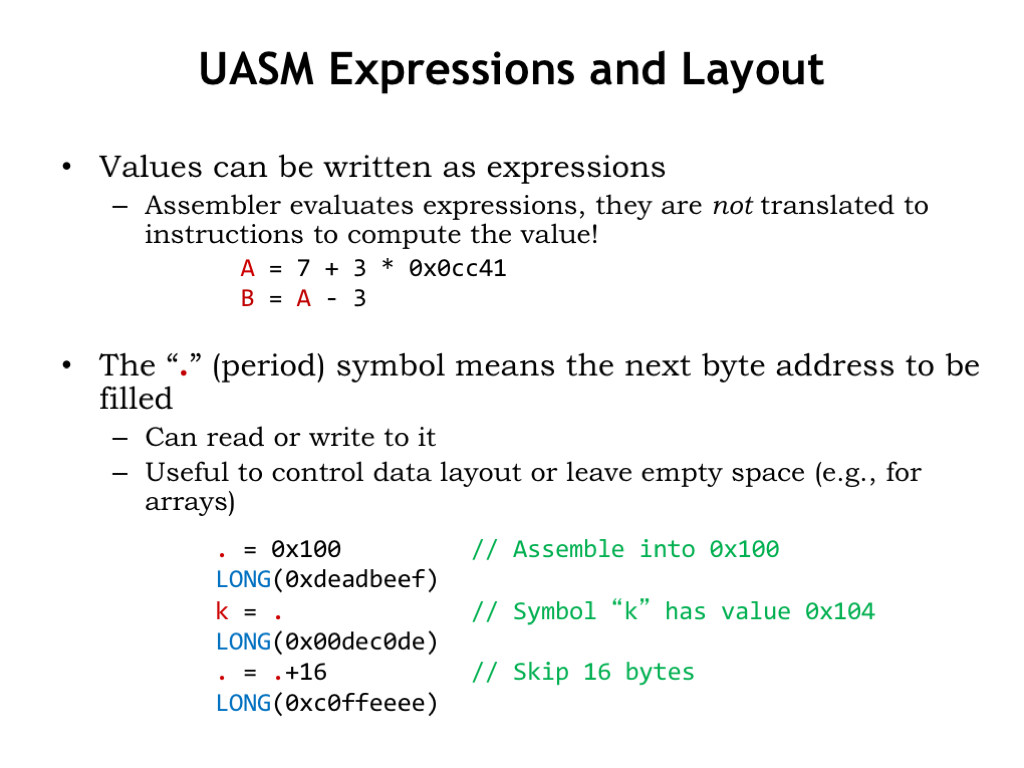
15. UASM 表达式与布局(UASM Expressions and Layout)

UASM Expressions and Layout

表达式在汇编时求值,不生成运行时 ADD/MUL。特殊符号 .(dot) = 下一个将填充的地址;初值 0,每写一字节递增。可赋 . 指定放置位置;k: 等价 k=.;也可增大 . 预留未初始化数组空间。

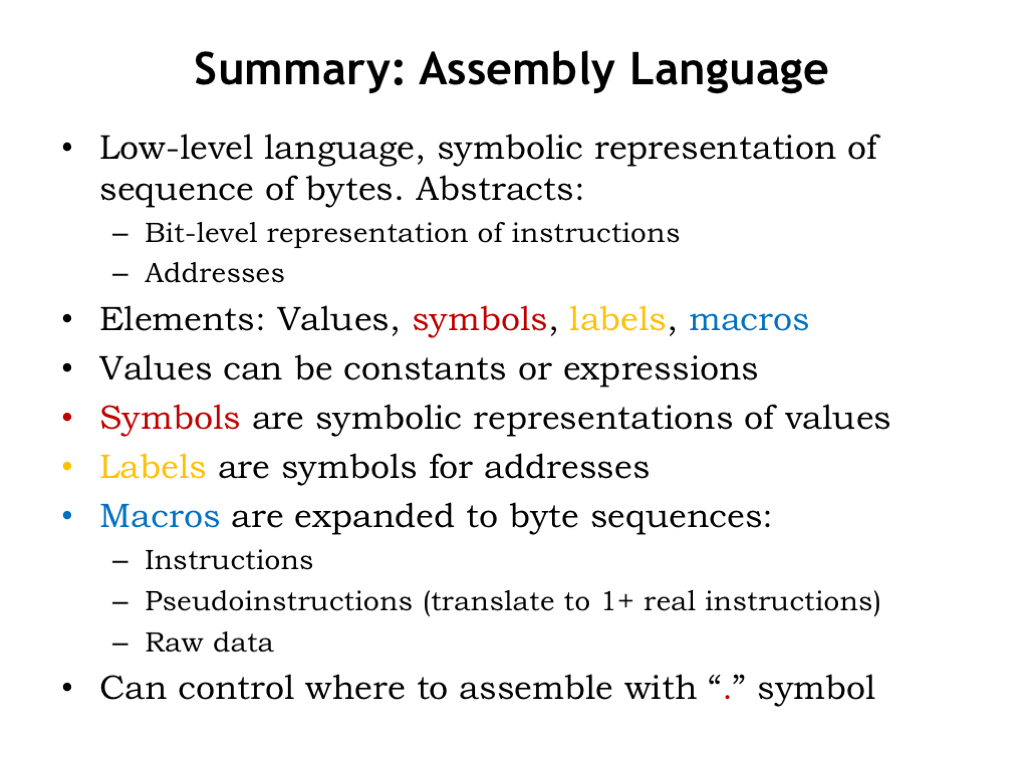
16. 小结:汇编语言(Summary: Assembly Language)

Summary: Assembly Language

汇编 = 方便生成指令/数据二进制并跟踪地址。UASM:值、符号、标号、宏、.。鸡生蛋:第一个汇编器靠手工汇编二进制,再逐步加符号/宏等特性——且务必备份二进制。

17. 通用性?(Universality?)

Universality

NAND 对布尔函数通用。ISA 是否通用?能解 FSM 能解的问题吗?有 FSM 不能解的吗?Beta 能否解?答案依赖计算的数学模型。

18. 计算模型(Models of Computation)

Models of Computation

CS 根源之一:比较各模型能表示的计算类,寻找通用模型——凡其它良构模型能描述的,通用模型也能。候选:FSM(时序逻辑可建;可用布尔与转移图 100% 预测行为)。FSM 是否万能数字计算装置?

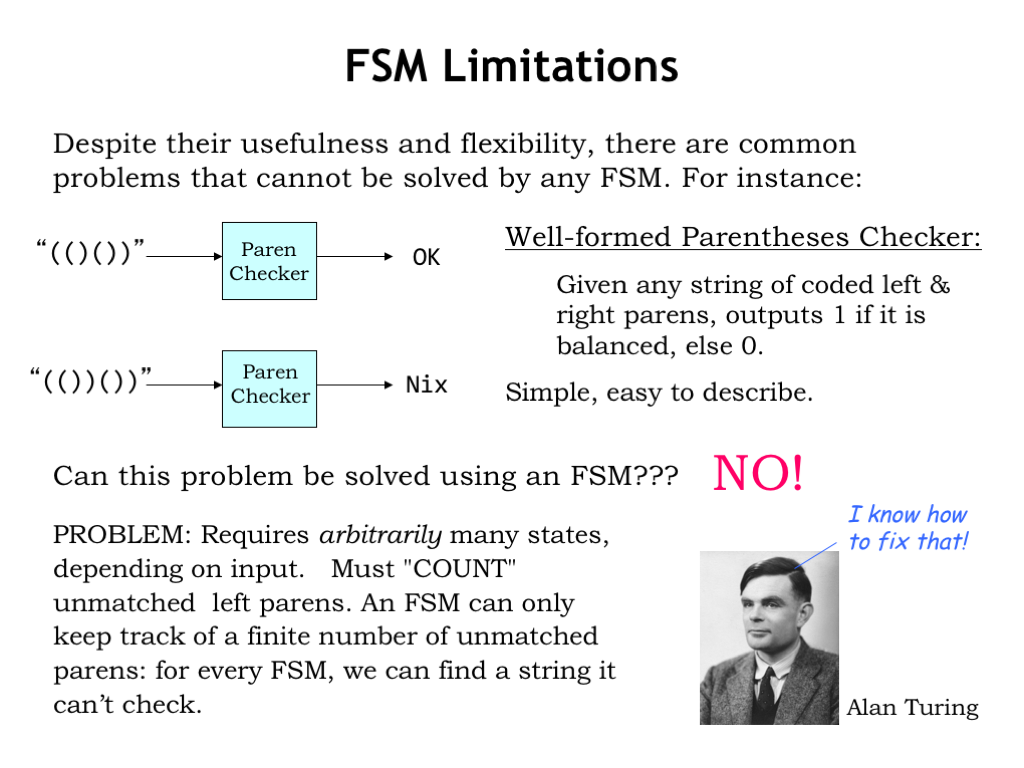
19. FSM 的局限(FSM Limitations)

FSM Limitations

括号匹配:判定括号串是否良构(每个开括号有对应闭括号)。FSM 用有限状态记历史——括号检查需计数未匹配开括号,但状态数有上限 → 输入开括号过多则无法正确判定。

有限性限制了需无界计数的问题。转向 Alan Turing 的模型。

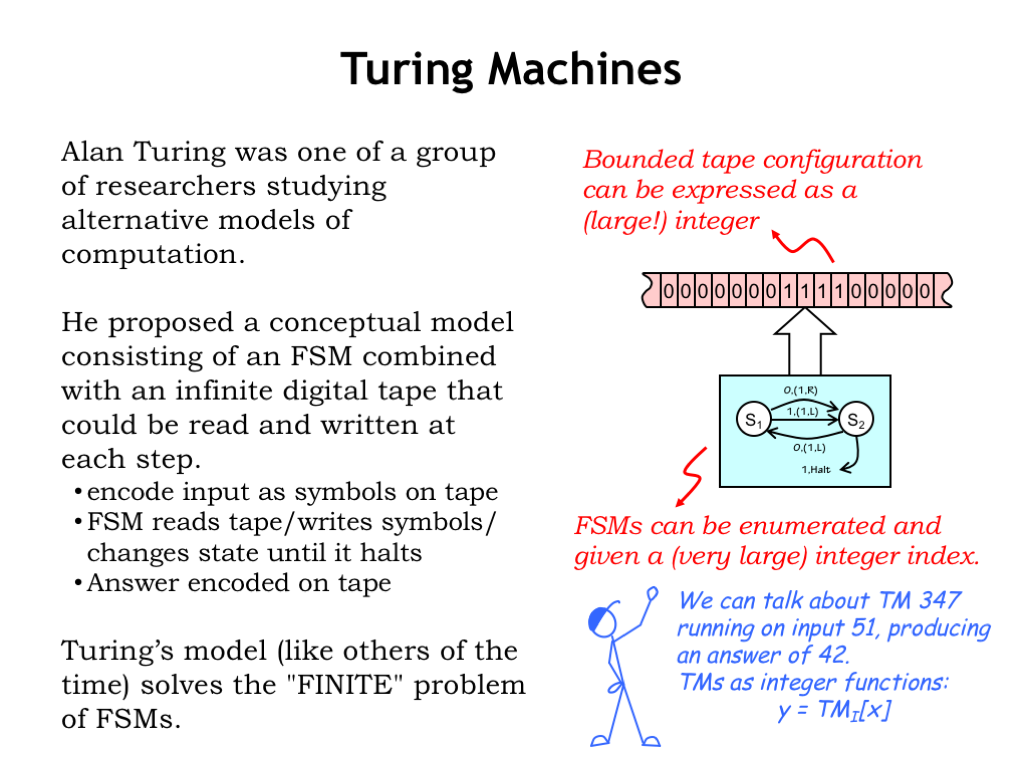
20. 图灵机(Turing Machines)

Turing Machines

1930 年代 Turing 提出:FSM + 无限纸带(可读写)。输入编码在带上;FSM 读写、改态、写答案后停机 → 图灵机(TM)。

有限非空白输入可编码成大整数;TM 实现整数到整数的函数。FSM 真值表可枚举并赋索引 → 谈“TM 347 在输入 51 上得 42”。

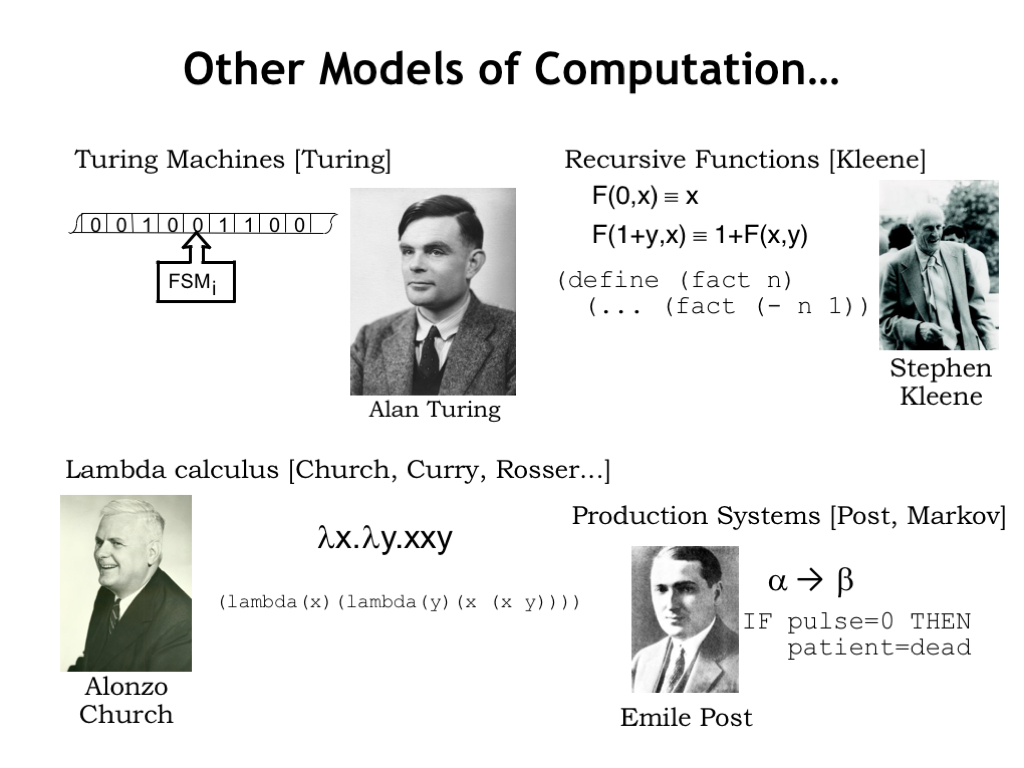
21. 其它计算模型(Other Models of Computation)

Other Models of Computation

Kleene、Post、Turing 等(Church 学生)探索递归函数、字符串重写、λ 演算等,并关注不可实现机解决的问题——亦即刻画可解决类。

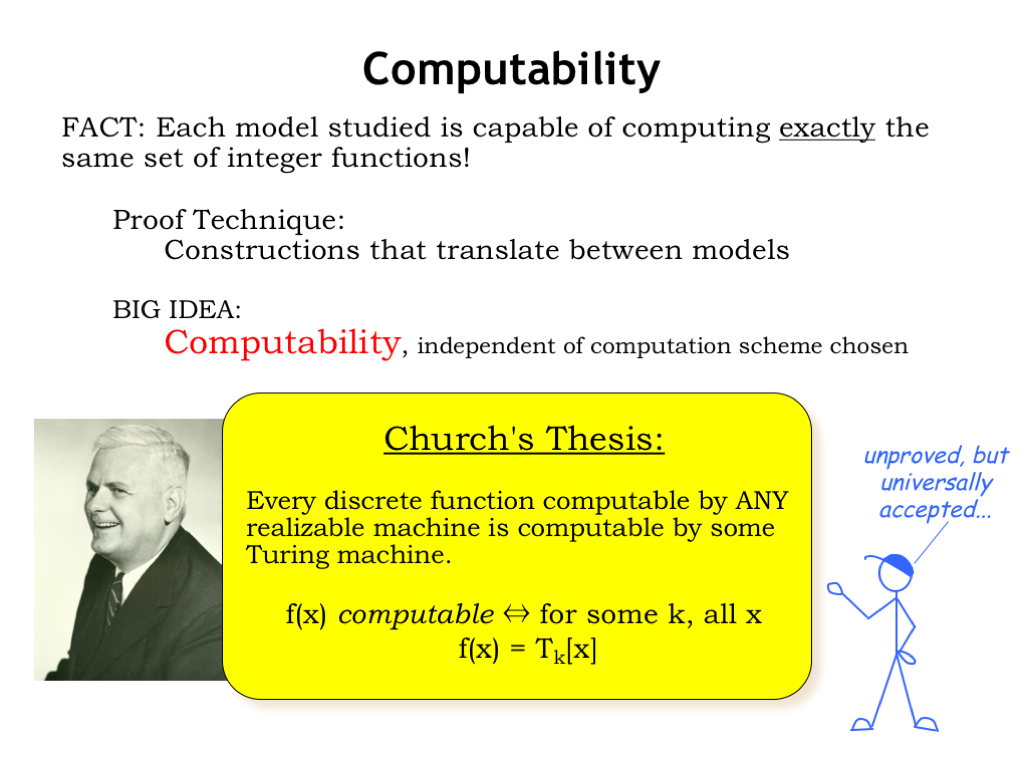
22. 可计算性?(Computability?)

Computability

各模型能算的整数函数集相同(可互译)。Church 论题:凡可实现机可算的离散函数,皆可由某 TM 计算。尚无严格证明,但被普遍接受。“可计算”≈“某 TM 可计算”。不可计算函数见本讲可选视频。

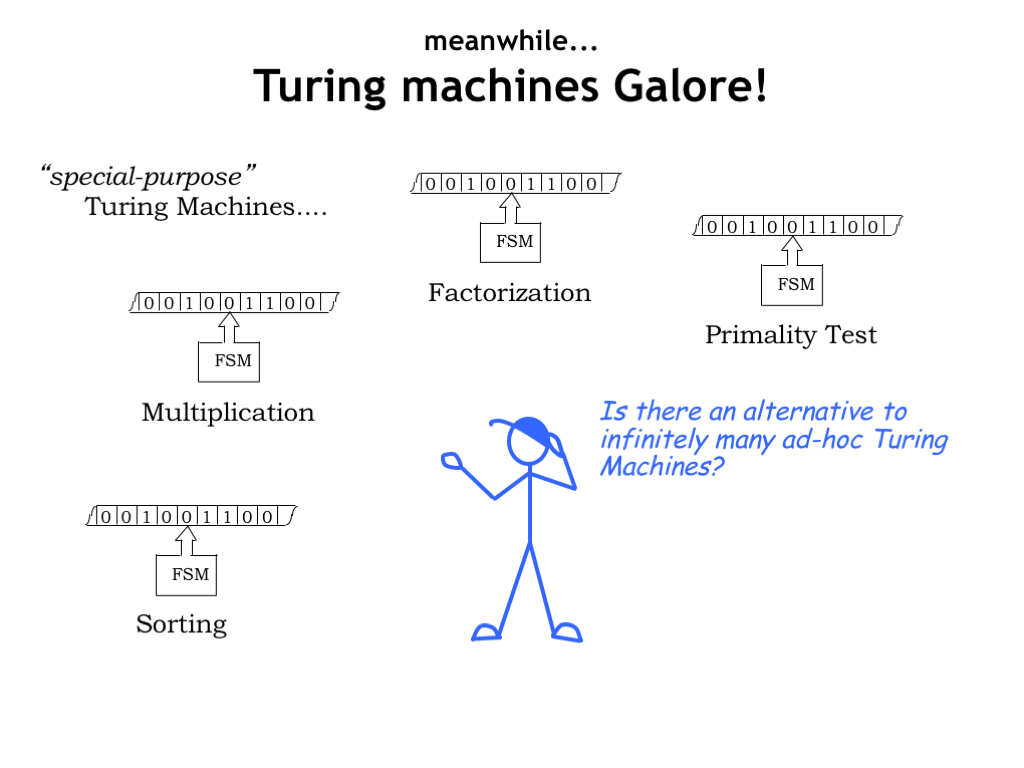
23. 众多图灵机!(Turing Machines Galore!)

Turing Machines Galore

每种想做的计算对应一台(不同)TM。这对通用计算机设计有何启示?是否有些计算永远需要专用机?

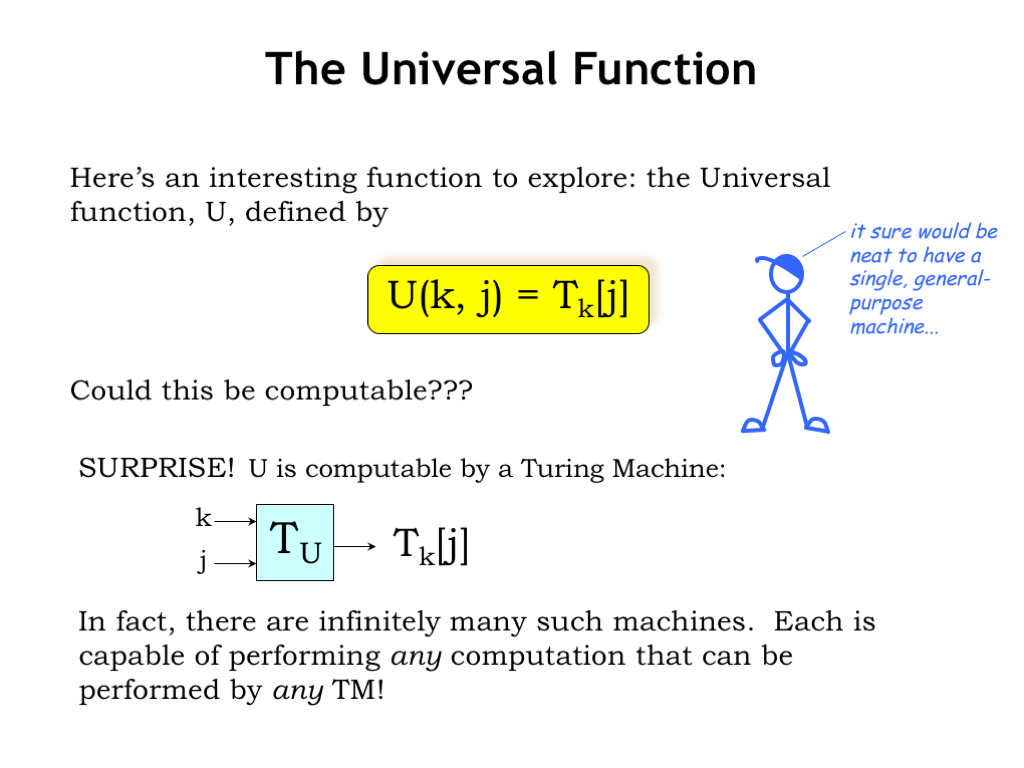
24. 通用函数(The Universal Function)

The Universal Function

希望有 U(k,j)=U(k,j)= 运行 TkT_k 于输入 jj 的结果。UU 可计算:存在通用图灵机 TUT_U(且有无穷多;已知最小者约 4 态、6 带符号)。一台通用机可完成任意 TM 能做的计算。

25. 通用性(Universality)

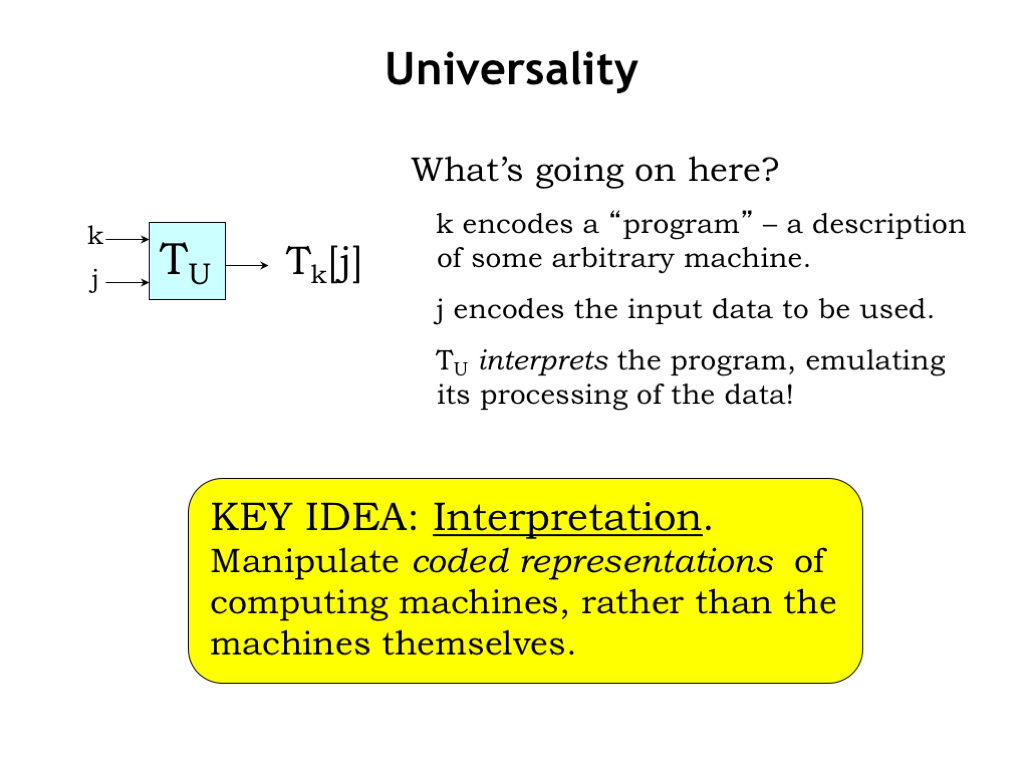
Universality

kk 编码“程序”(某 TM 描述),jj 编码数据;TUT_U 解释程序、模拟 TkT_k。解释编码计算 = 存储程序计算机的核心思想。

26. 图灵通用性(Turing Universality)

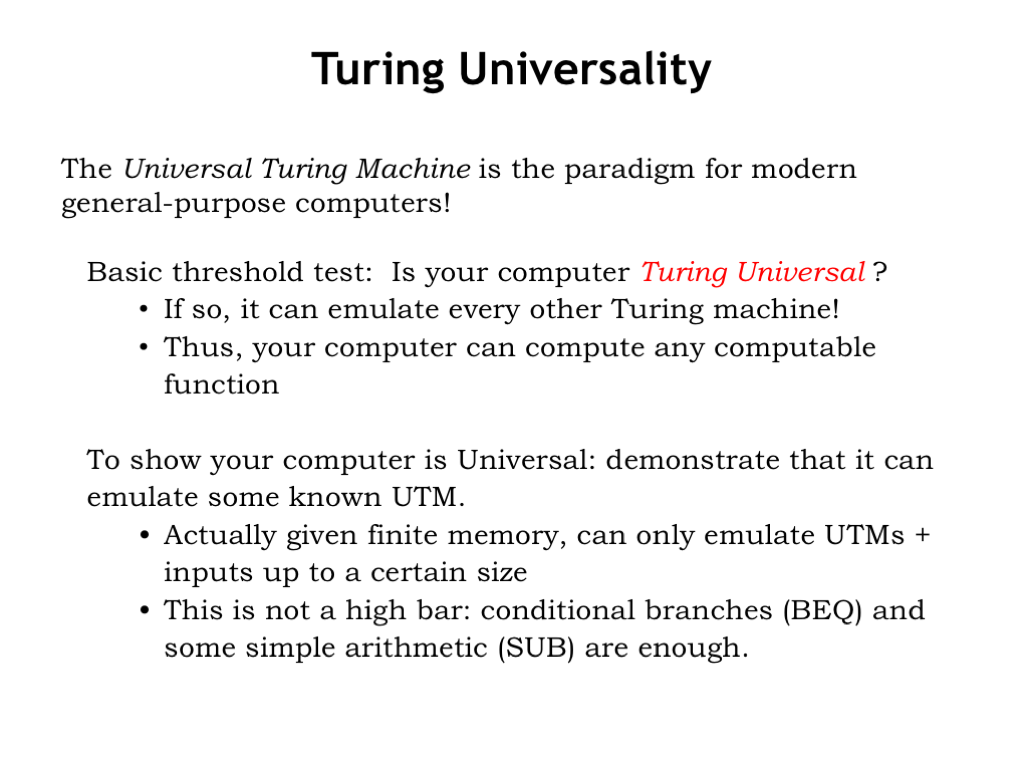
Turing Universality

通用 TM 是现代通用计算机的范式。证明 ISA 图灵通用:展示能模拟某已知通用 TM。实际机器内存有限 → 仅对放得下的输入等价。门槛不高:有条件分支 + 简单算术 通常即足够。

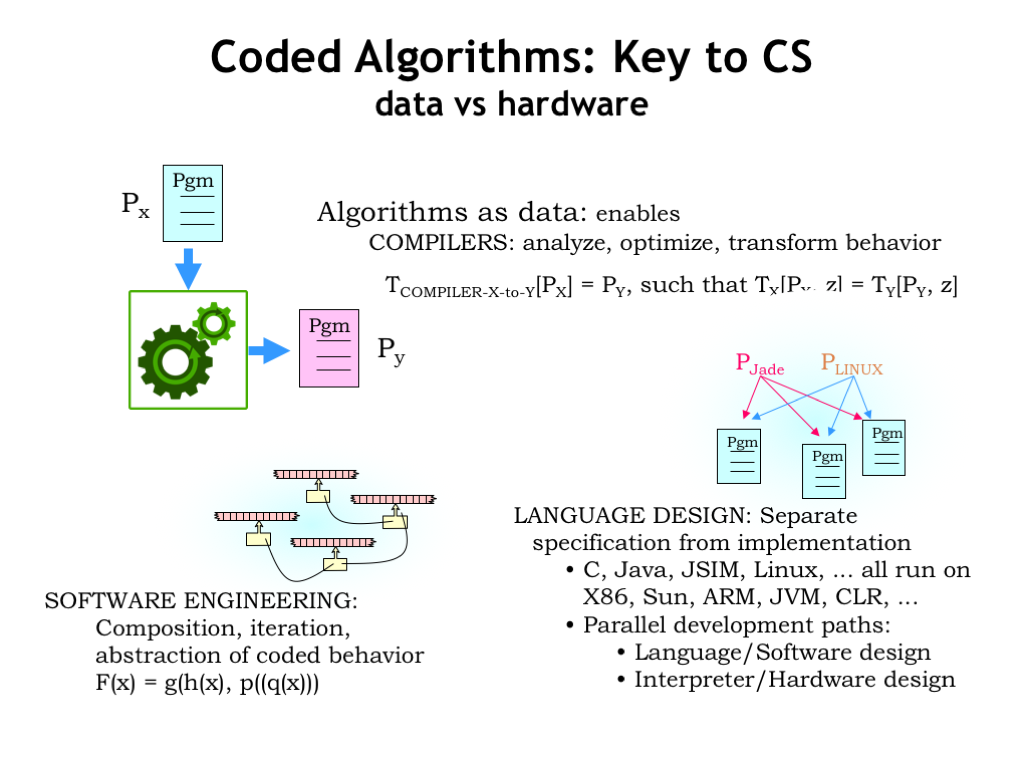
27. 编码算法:CS 关键(Coded Algorithms: Key to CS)

Coded Algorithms: Key to CS

程序可作为另一程序的数据 → 编译(高级语言→汇编)、软件组件复用、设计面向任务的语言。结论:拟建引擎能做任意可实现机上的计算;通用 TM 为存储程序机铺路 → Beta ISA 够用。

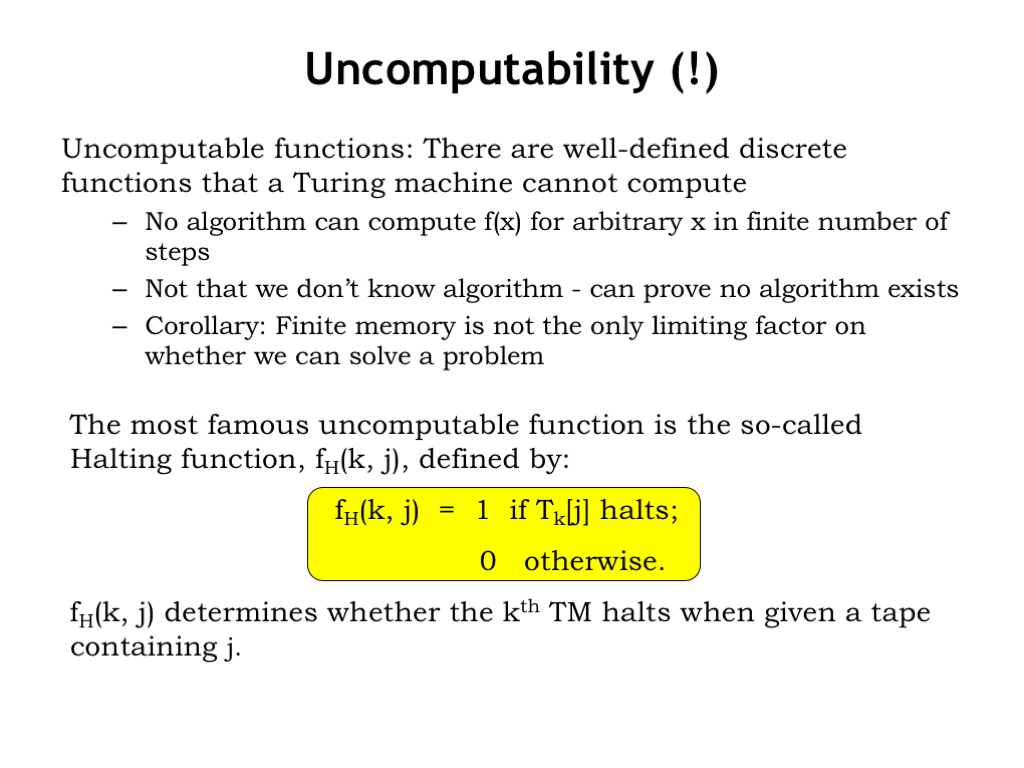
28. 不可计算!(Uncomputability!)

Uncomputability

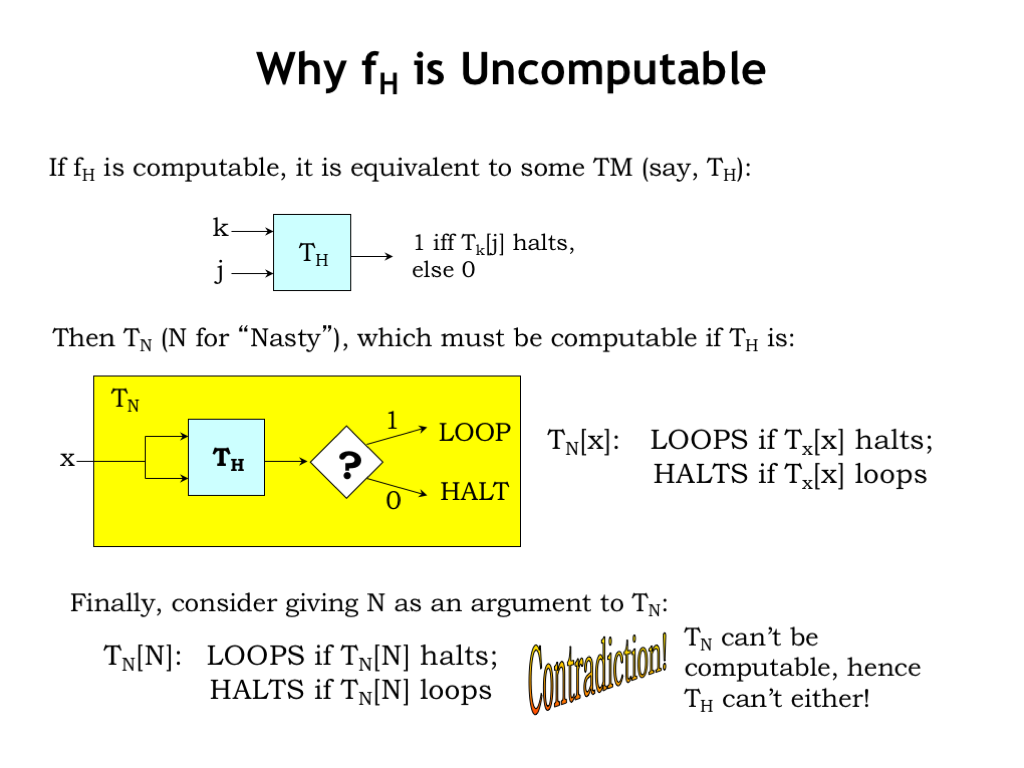
存在良定义离散函数,无任何 TM 能在有限步对任意有限输入算出 f(x)f(x)——可证明算法不存在。最著名:停机函数——给定 (k,j)(k,j),判定第 kk 个 TM 在输入 jj 上是停机还是永远循环。

29. 为何 fHf_H 不可计算(Why fH is Uncomputable)

Why fH is Uncomputable

反证:若停机函数可算,则有 THT_H。构造“nasty”机 TNT_N:TN[X]T_N[X] 在 TX[X]T_X[X] 停机时循环,在 TX[X]T_X[X] 循环时停机(靠 THT_H 查询)。再喂 NN 给 TNT_N:TN[N]T_N[N] 必须既停又不停 → 矛盾。故 THT_H 不存在,停机函数不可计算。

整理自 MIT OCW 6.004 Computation Structures(Spring 2017)L09 注解幻灯片。

源网页:9.1 Annotated Slides | Designing an Instruction Set

讲师:Chris Terman。图片直接引用 OCW 原站链接。

L09:指令集设计(Designing an Instruction Set)

从专用阶乘硬件出发,抽象出可编程 datapath 与控制 FSM,引入 von Neumann 存储程序模型,并定量设计本课的 Beta RISC ISA:寄存器、定长指令、ALU/访存/分支。

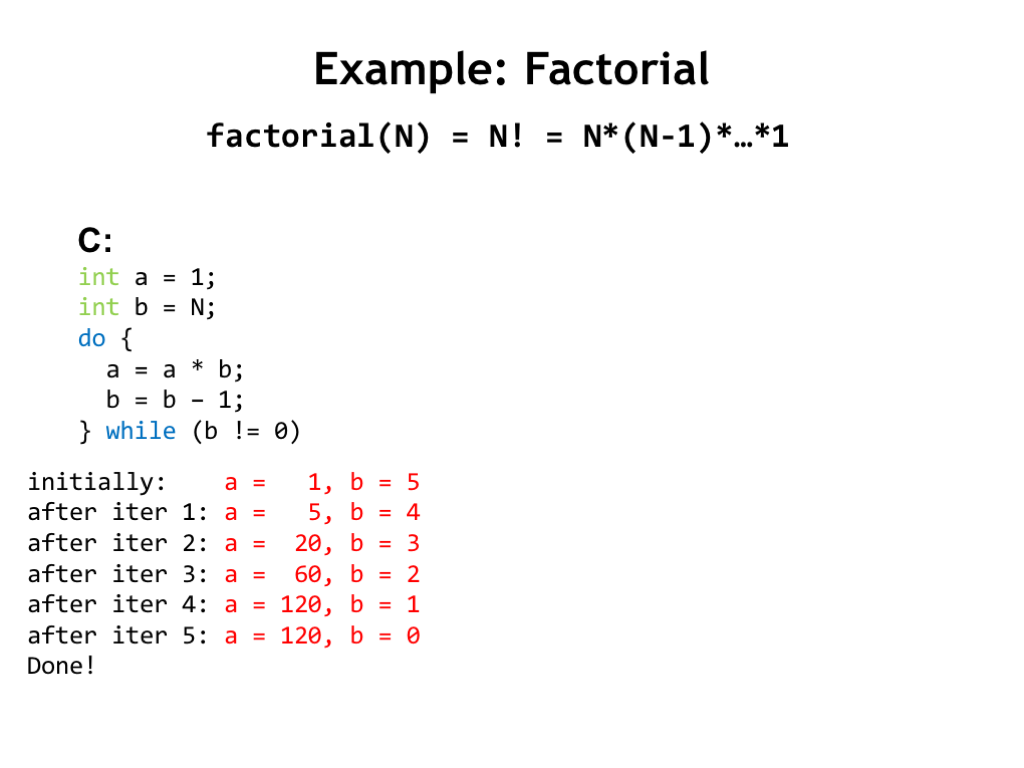
1. 例子:阶乘 I(Example: Factorial I)

Example: Factorial I

N!=N⋅(N−1)⋯1N!=N\cdot(N-1)\cdots 1。用 C 描述:变量 a 累乘结果,b 为下一乘数(初值 NN);循环中 a=a*b,b=b-1。

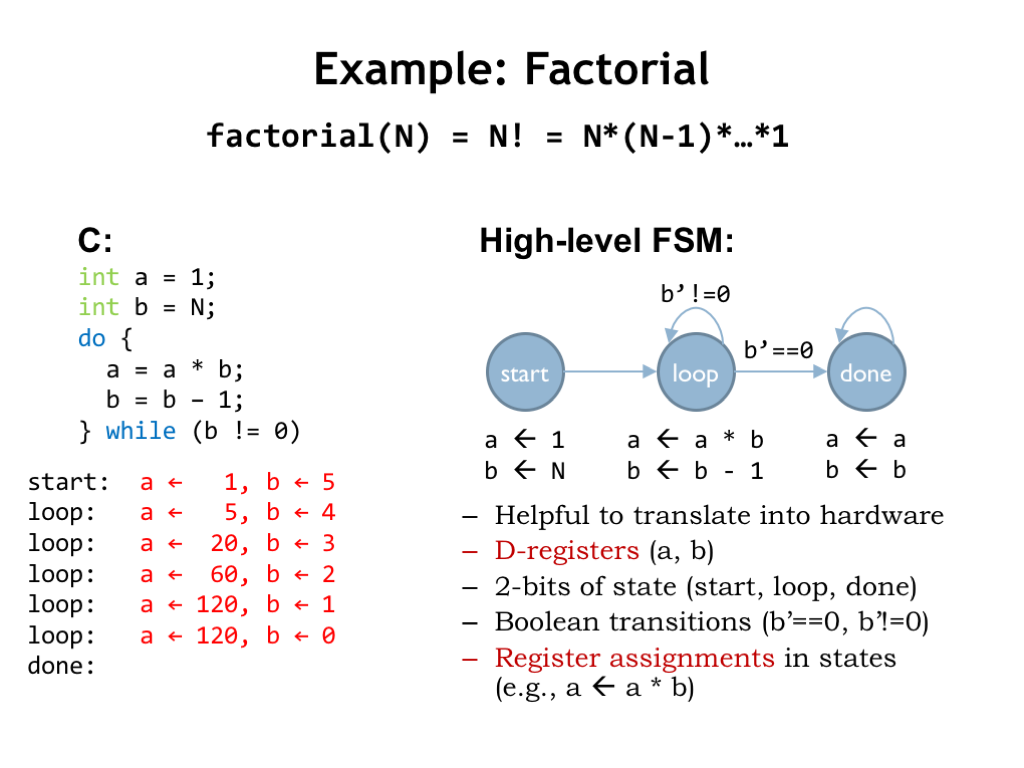
2. 例子:阶乘 II(Example: Factorial II)

Example: Factorial II

用高层 FSM 描述:各态“输出”是对变量的运算公式,而非简单电平。状态序列对应 C 程序步骤;b 新值为 0 时进入 DONE。

实现:32 bit 寄存器存 a/b,2 bit 状态寄存器;逻辑判断 b==0,并实现乘、减一与选通写入。

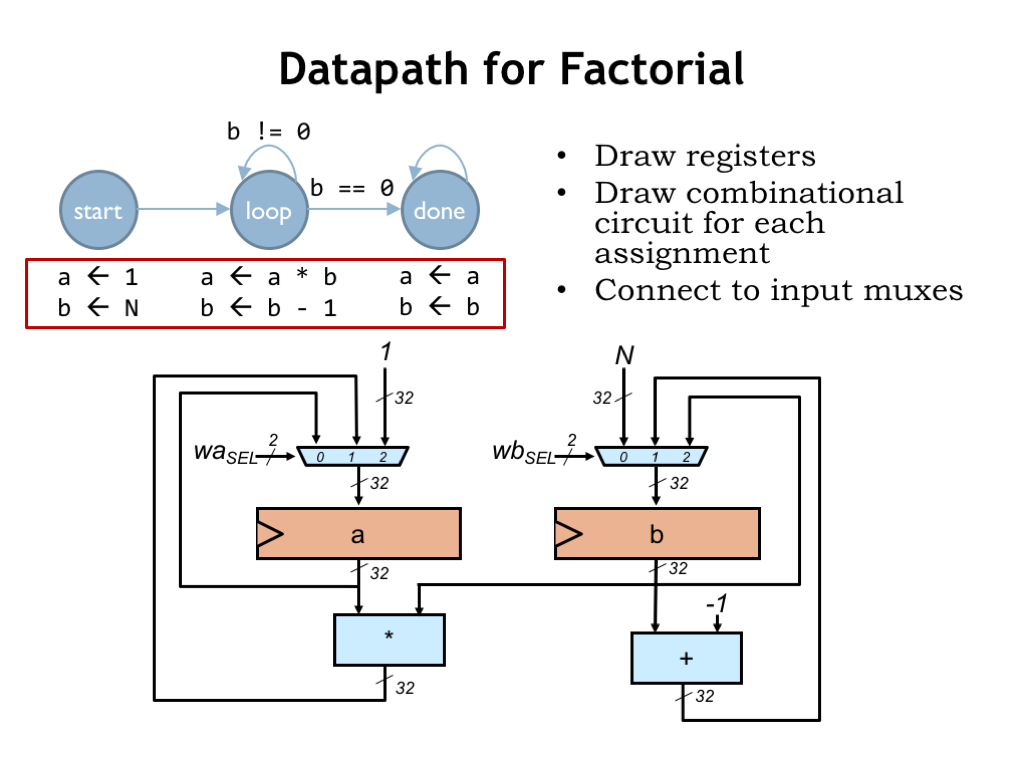
3. 阶乘的 Datapath(Datapath for Factorial)

Datapath for Factorial

Datapath:存值寄存器 + 组合运算。START:a←1,b←N;LOOP:a←a*b,b←b-1;DONE:保持。MUX(WASEL/WBSEL)选择写入值。

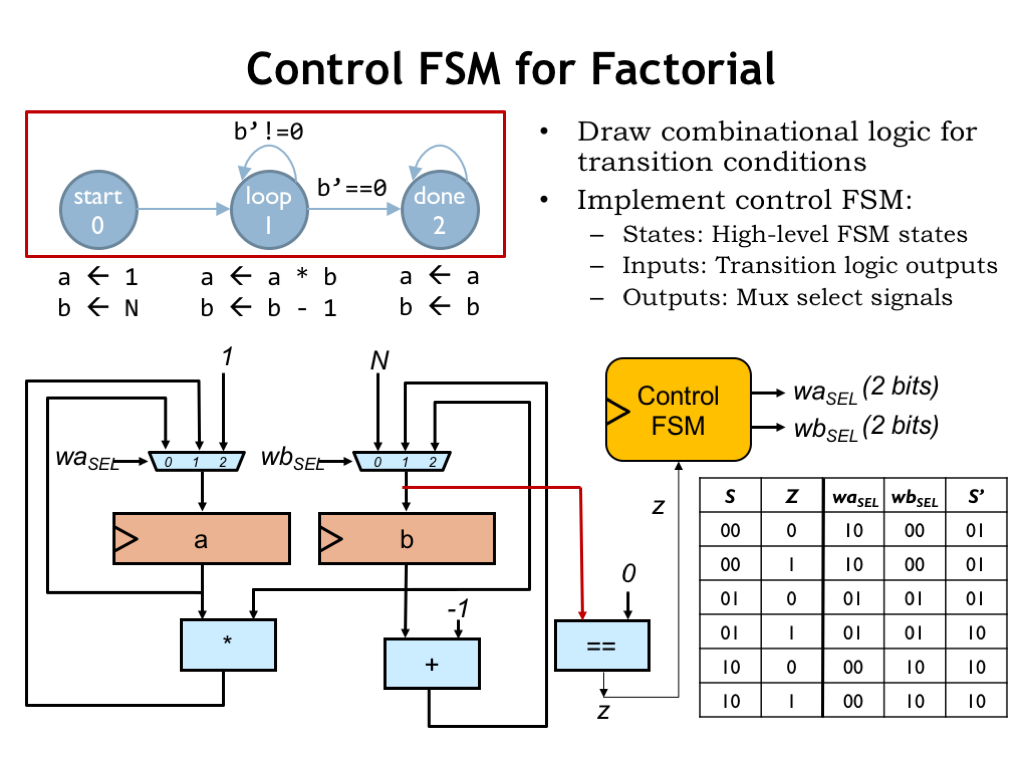
4. 阶乘的控制 FSM(Control FSM for Factorial)

Control FSM for Factorial

Datapath 给出 Z(新 b 是否为 0)。控制 FSM:输入 Z,输出 WASEL/WBSEL;真值表含当前态 SS 与下一态 S′S'。

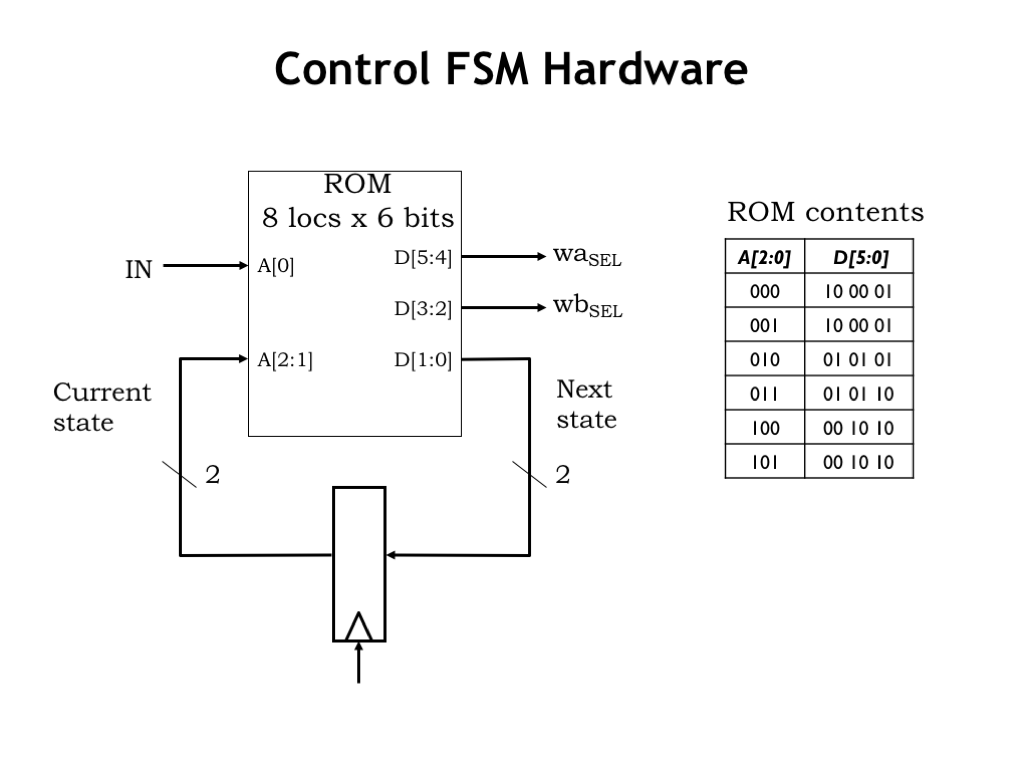
5. 控制 FSM 硬件(Control FSM Hardware)

Control FSM Hardware

乘/减一用组合电路;控制用寄存器+ROM:ZZ+2 bit 状态 → 3 输入,23=82^3=8 单元,每单元 6 bit(WASEL、WBSEL、下一态各 2 bit)。

6. 目前:专用硬件(So Far: Single-Purpose Hardware)

So Far: Single-Purpose Hardware

流程:高层 FSM → datapath → 控制 FSM。整体也是 FSM,但 datapath 寄存器也算“状态”则约 66 bit → 2662^{66} 行真值表不可行 → datapath 与控制 FSM 分离思考。

通用化:更多存储、更丰富运算集(最小充分集出人意料地小;复杂运算常拆成加减乘序列)。架构乐趣在折衷。

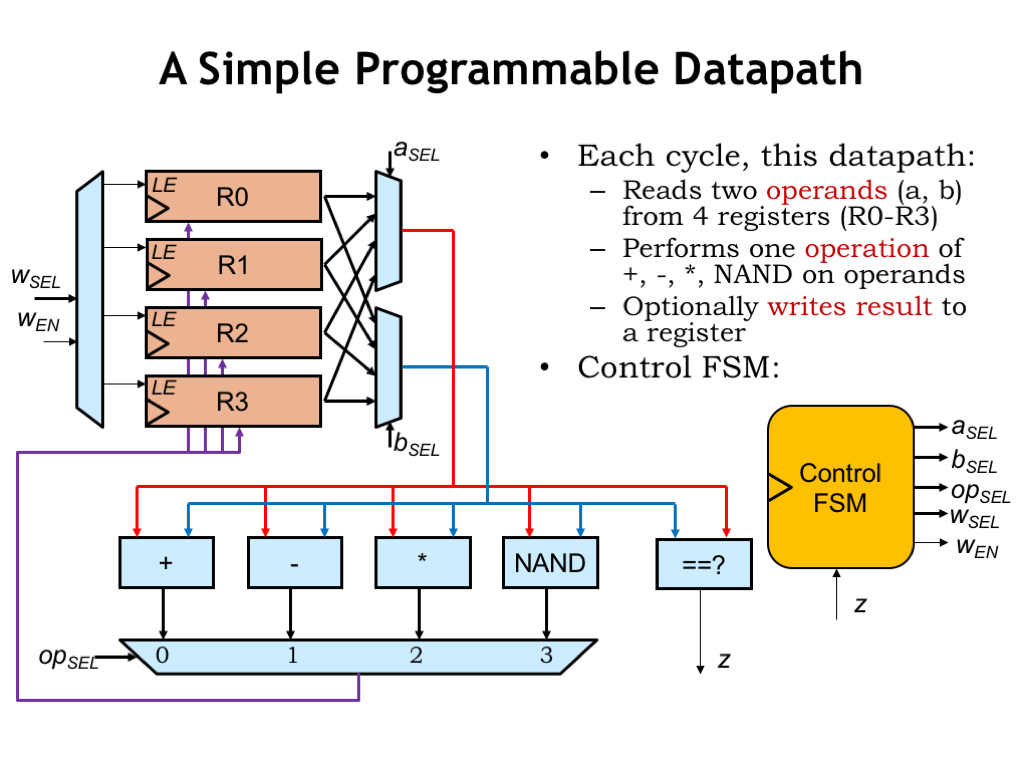
7. 简单可编程 Datapath(A Simple Programmable Datapath)

A Simple Programmable Datapath

4 个数据寄存器;ASEL/BSEL 选操作数;OPSEL 选运算结果;WEN+WSEL 写回(寄存器带 load-enable)。控制 FSM 序列产生控制信号;Z 支持数据相关转移。

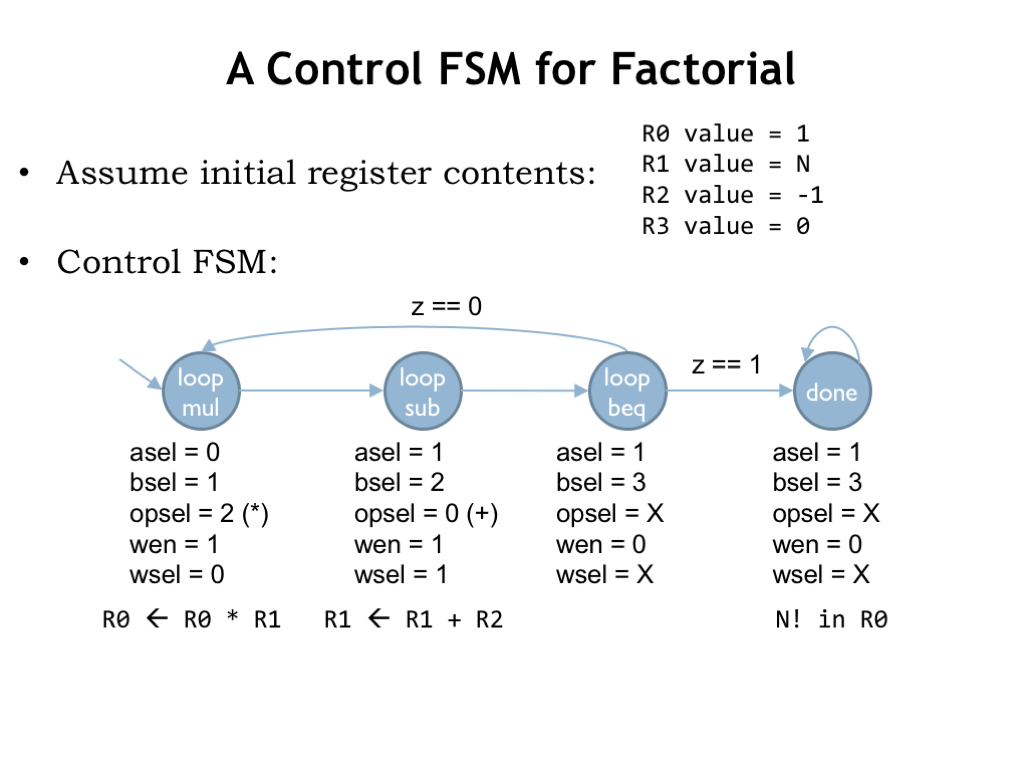
8. 阶乘的控制 FSM(A Control FSM for Factorial)

A Control FSM for Factorial

通用 datapath 每拍一运算 → 每轮循环需乘、减一、判零三态。通用机往往比专用电路更多周期、可能更多硬件。

9. 新问题 → 新控制 FSM(New Problem → New Control FSM)

New Problem New Control FSM

同一硬件可做幂、除、开方等(寄存器 ≤4)。设计控制 FSM ≈ 编程:规定运算序列。

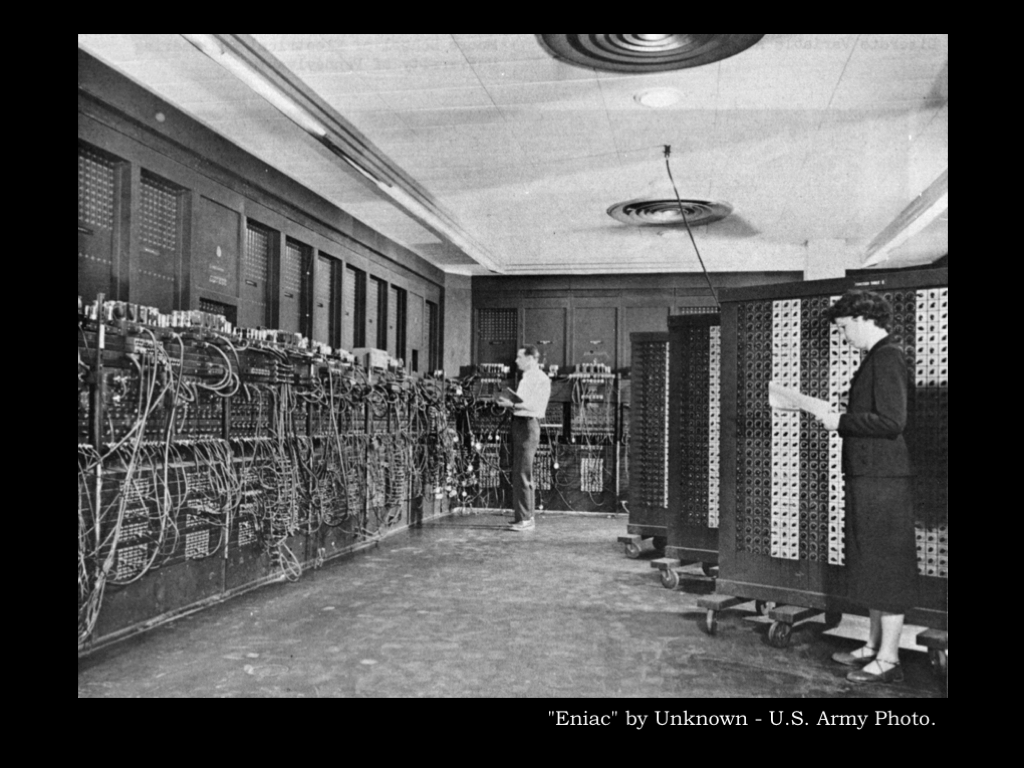
10. ENIAC 计算机(The ENIAC Computer)

The ENIAC Computer

早期数字计算机正是如此工作。图为 1943 宾大 ENIAC。

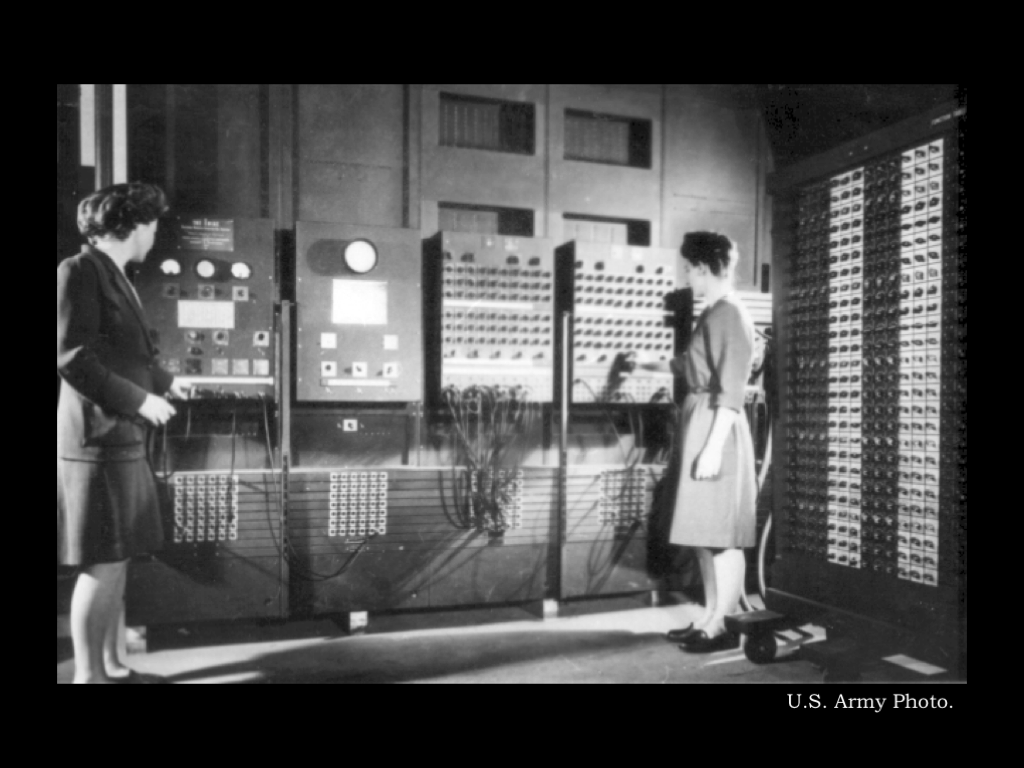
11. 给 ENIAC 编程(Programming The ENIAC)

Programming The ENIAC

ENIAC 支持循环、分支、子程序,但映射到机器常需数周;拨开关、插线需数日,再单步调试。急需更轻便的编程方式。

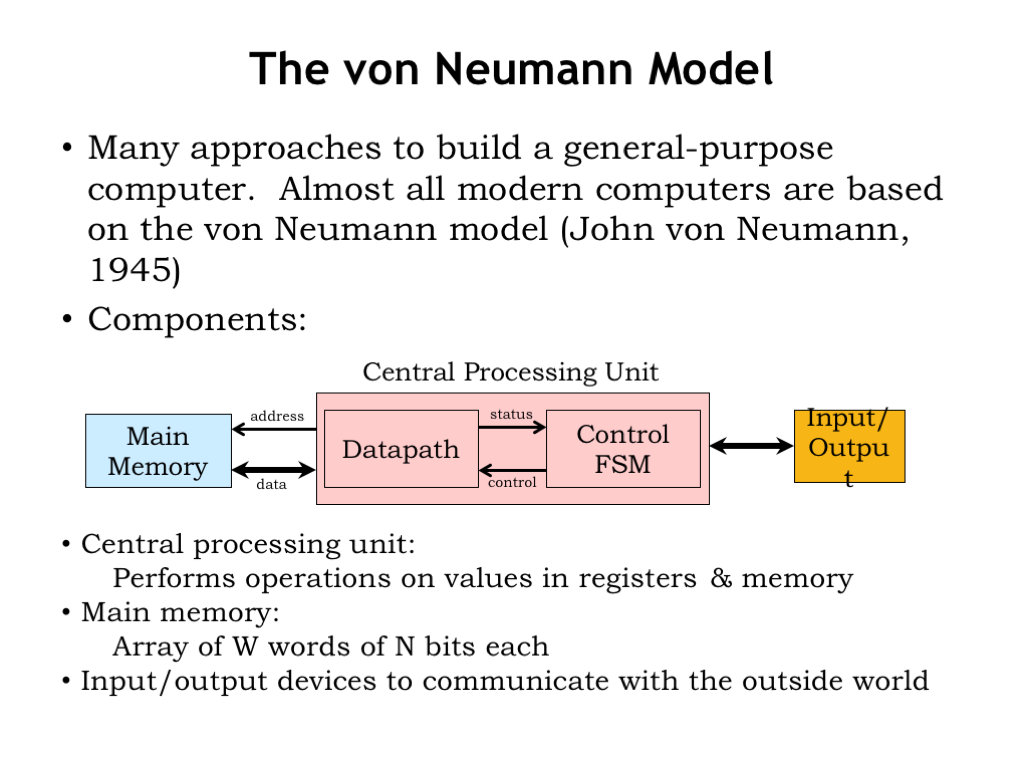
12. von Neumann 模型(The von Neumann Model)

The von Neumann Model

现代机多基于 1945 von Neumann 存储程序模型,三部分:

  1. CPU:datapath + 控制 FSM
  2. 主存:约 WW 个 NN bit 字;CPU 发地址读写(延迟约数十 ns)
  3. I/O:与外界通信、非易失存储等

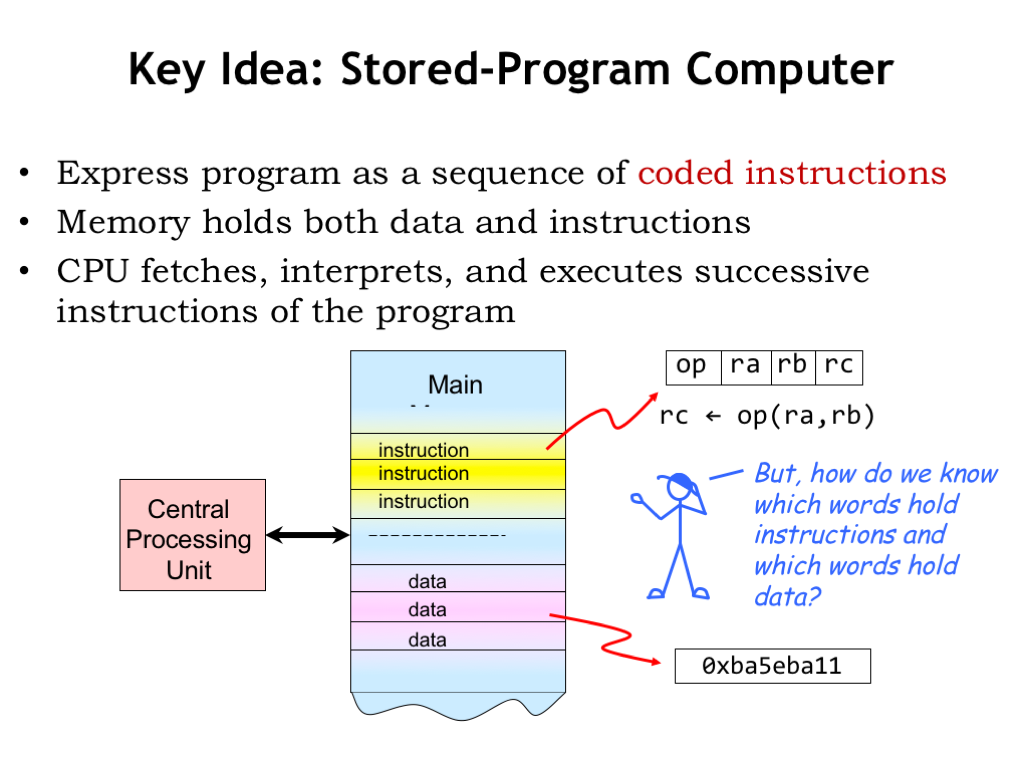
13. 关键思想:存储程序计算机(Key Idea: Stored-Program Computer)

Key Idea: Stored-Program Computer

指令与数据同存主存,皆为二进制。指令含 opcode、源/目的寄存器等字段;CPU 解释并执行,再取下一条。

如何区分指令与数据?看值本身不行——看用法:进 datapath → 数据;被控制逻辑取用 → 指令。

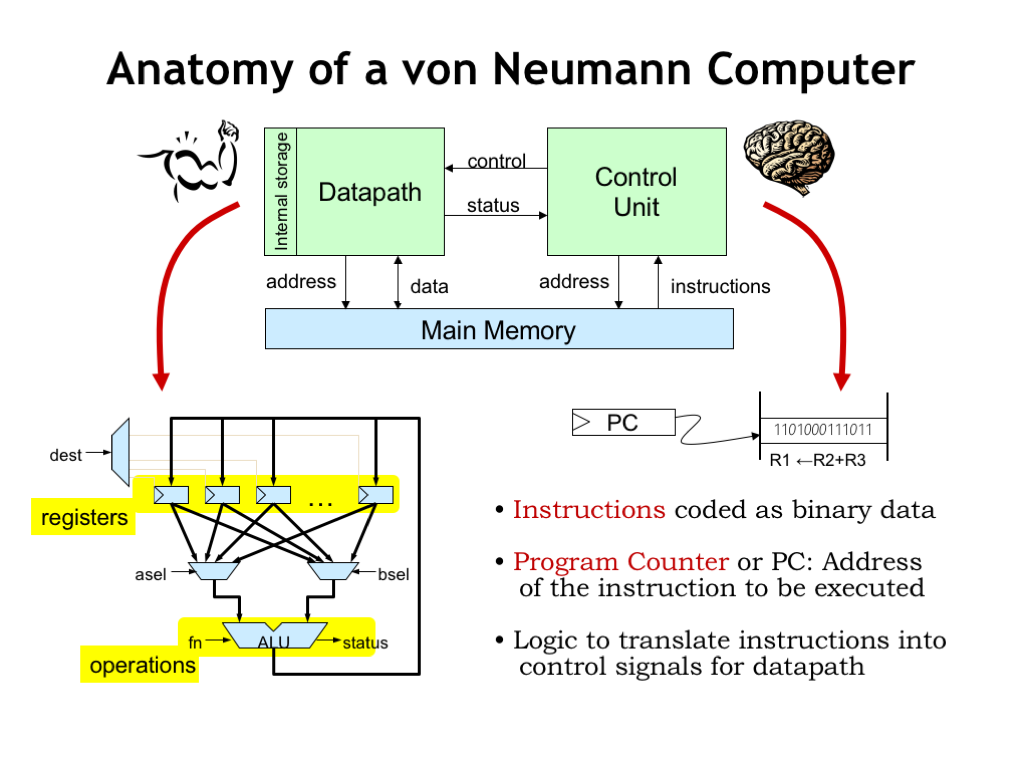
14. von Neumann 机解剖(Anatomy of a von Neumann Computer)

Anatomy of a von Neumann Computer
  • Datapath(肌肉):寄存器、ALU、访存通路
  • 控制单元(大脑):从主存取指令,译成 ASEL/BSEL/DEST/FN 等;含 PC(program counter) 指向下一条;接收状态以支持条件执行

32 个寄存器 → 选择信号各 5 bit;ALU 功能码可 6 bit。

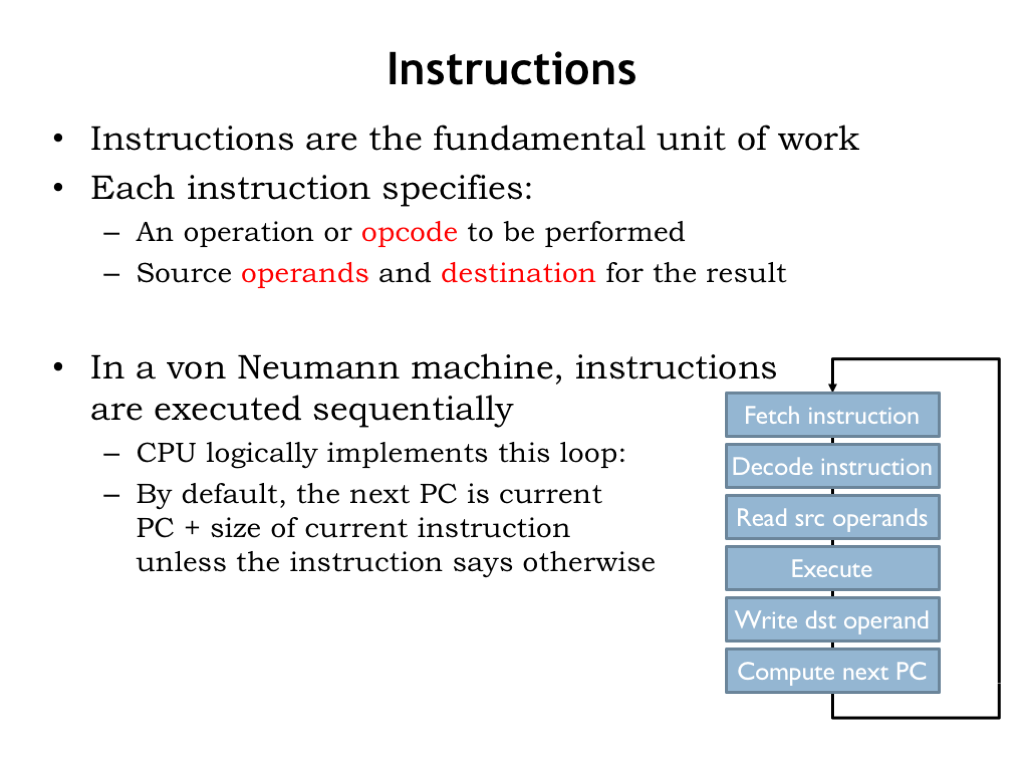
15. 指令(Instructions)

Instructions

指令是基本工作单元。执行循环:按 PC 取指 → 译码控制 datapath → ALU 运算写回 → PC ← 下一指令地址。现代机能每秒数十亿条。

16. 指令集架构 ISA(Instruction Set Architecture)

Instruction Set Architecture

ISA = 指令字段含义 + 存储/运算的功能规格,是硬件与程序员的契约。可换软件;硬件可升级而软件不变(x86 从约 30 万 IPS 到约 50 亿 IPS)。

警告:ISA 中嵌入的技术约束(寄存器数、字宽、地址空间)成功后难改——旧软件要跑在新机器上,坏选择可能背几十年。

17. ISA 设计(ISA Design)

ISA Design

难题:支持哪些运算?多少寄存器?多大内存?编码偏紧凑还是译码简单?

定量方法:选代表性 benchmark → 用拟议 ISA 实现并模拟 → 按速度/能耗/面积/成本评估。原则:识别常见操作并优化它们(通用计算中算术与访存极常见)。本课机器称 Beta。

18. Beta ISA:存储(Beta ISA: Storage)

Beta ISA: Storage

Beta 是 RISC:多数指令只访问内部寄存器;访存用独立 LD/ST,地址计算简单。同类:ARM、MIPS;x86 更复杂。

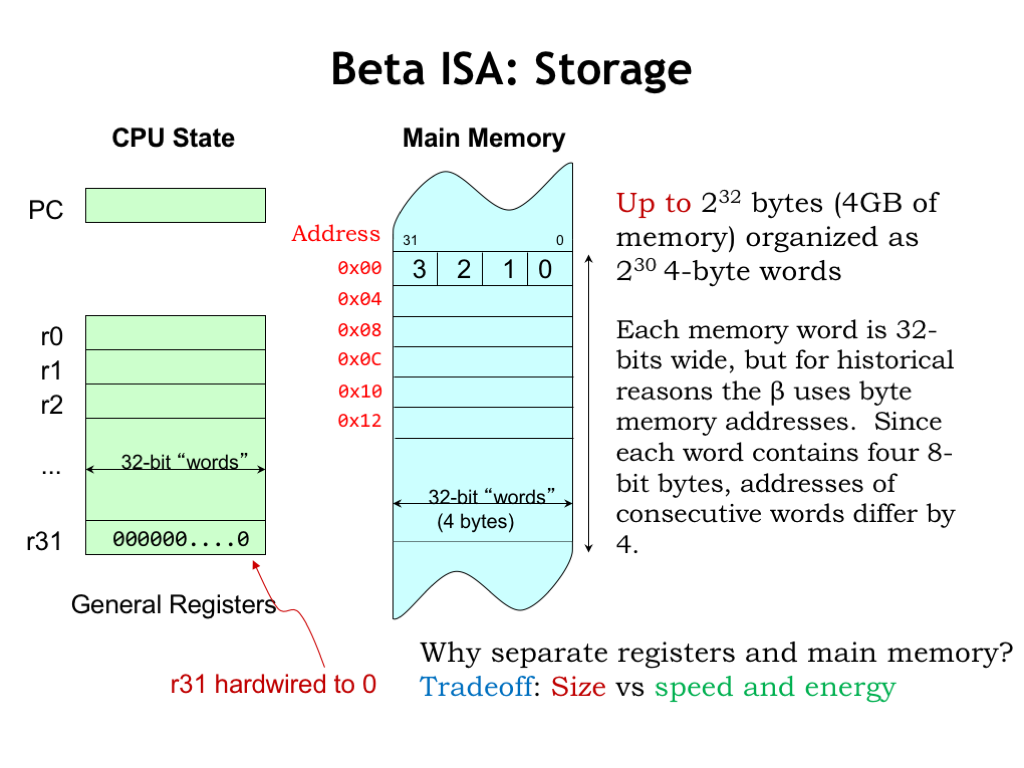
CPU 状态:32 bit PC;32 个 32 bit 寄存器 R0–R31(指令中 5 bit 编号)。R31 恒为 0,写入无效。主存为 32 bit 字(4 字节),仅支持字访问,但用字节地址:相邻字地址差 4。常用 0x 十六进制。

19. 存储约定(Storage Conventions)

Storage Conventions

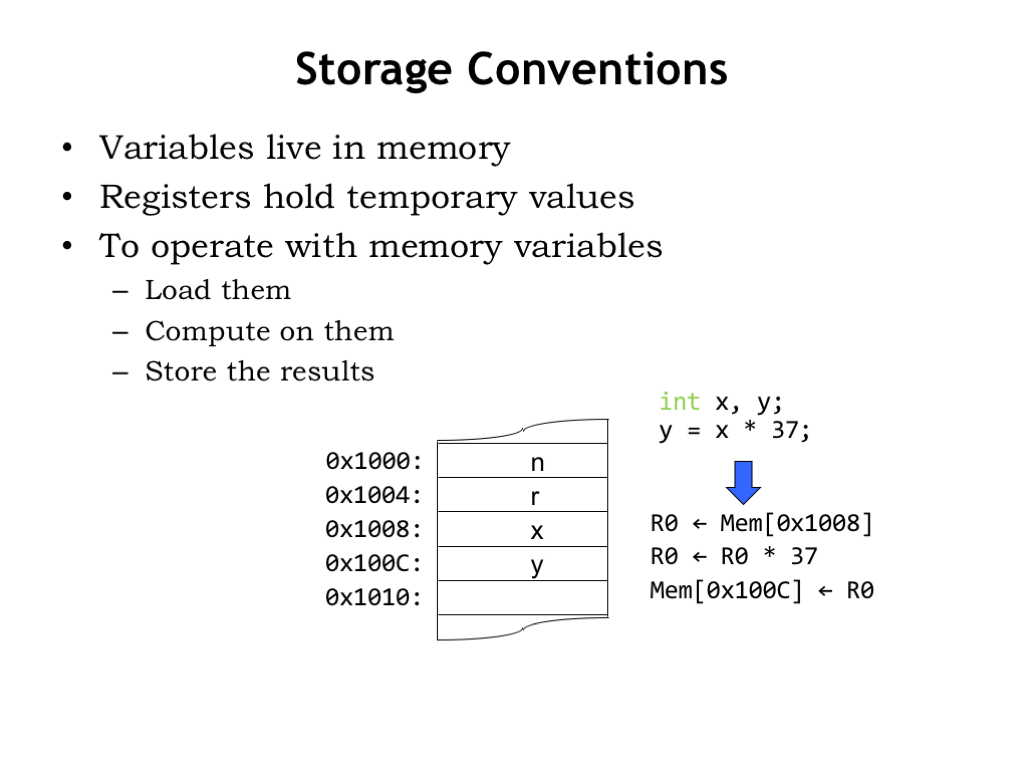
变量住在主存固定地址。算 y=x*37:LD x→R0,乘 37,ST 回 y。热数据尽量留在寄存器。模板:load → 计算 → store → load-store 架构。

20. Beta ISA:指令(Beta ISA: Instructions)

Beta ISA: Instructions

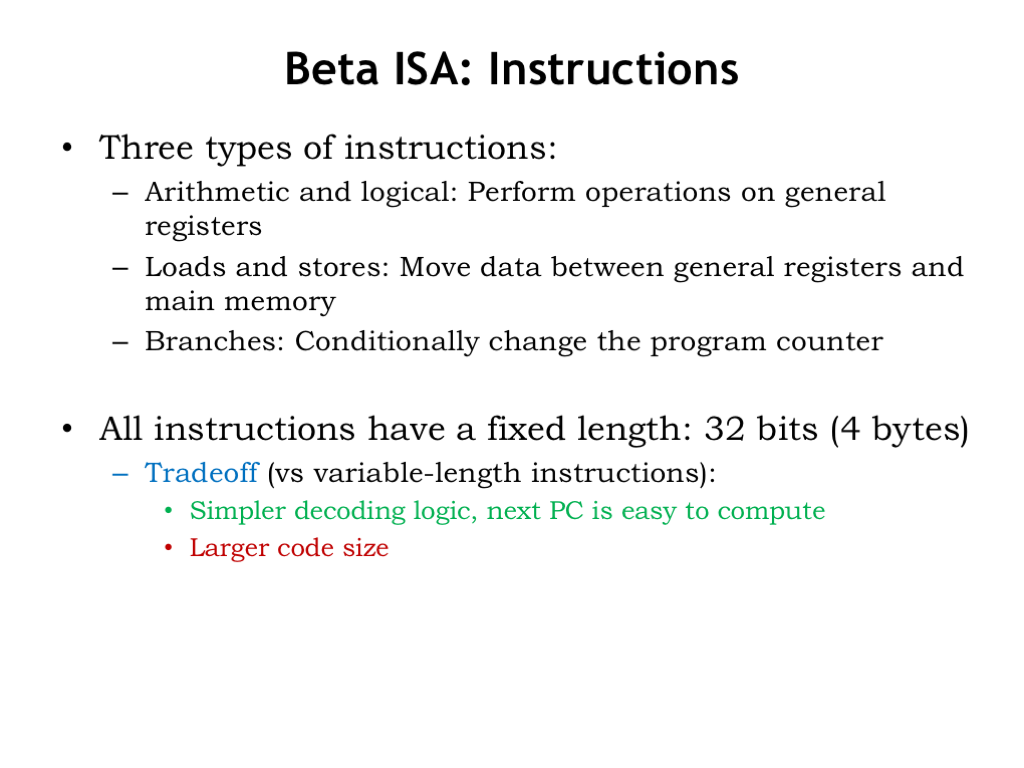
三类:计算、LD/ST、分支。全部 32 bit 定长,占一字 → 译码简单;多数指令下一地址 = PC+4。

定长常不如变长紧凑,但变长译码复杂、能耗/性能代价高;当今内存相对充裕,Beta 选择定长以换小而快的执行引擎。

21. Beta ALU 指令(Beta ALU Instructions)

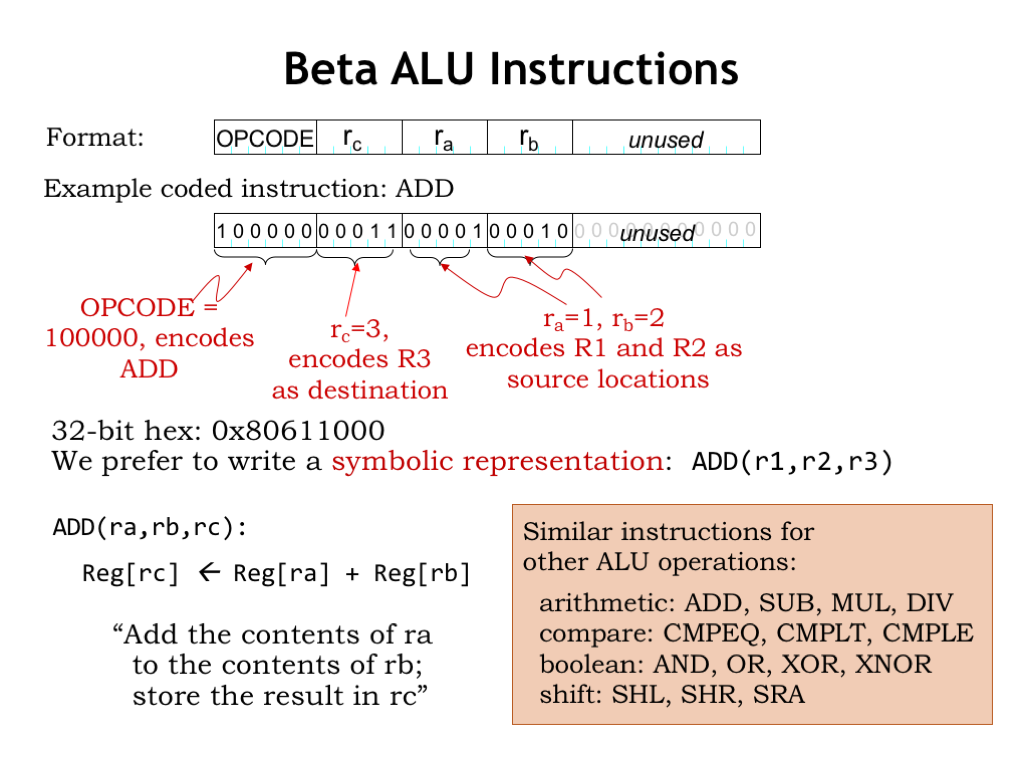
Beta ALU Instructions

字段:6 bit opcode,5 bit ra/rb 源,5 bit rc 目的;其余填 0。Opcode 固定在 [31:26]。

例:ADD,opcode 0b100000,ADD(r1,r2,r3) → R3←R1+R2;编码 0x80611000。同一寄存器可兼源与目的(如 R1←R1+R1 即 ×2)。助记符比二进制好写。

22. 实现草图 #1(Implementation Sketch #1)

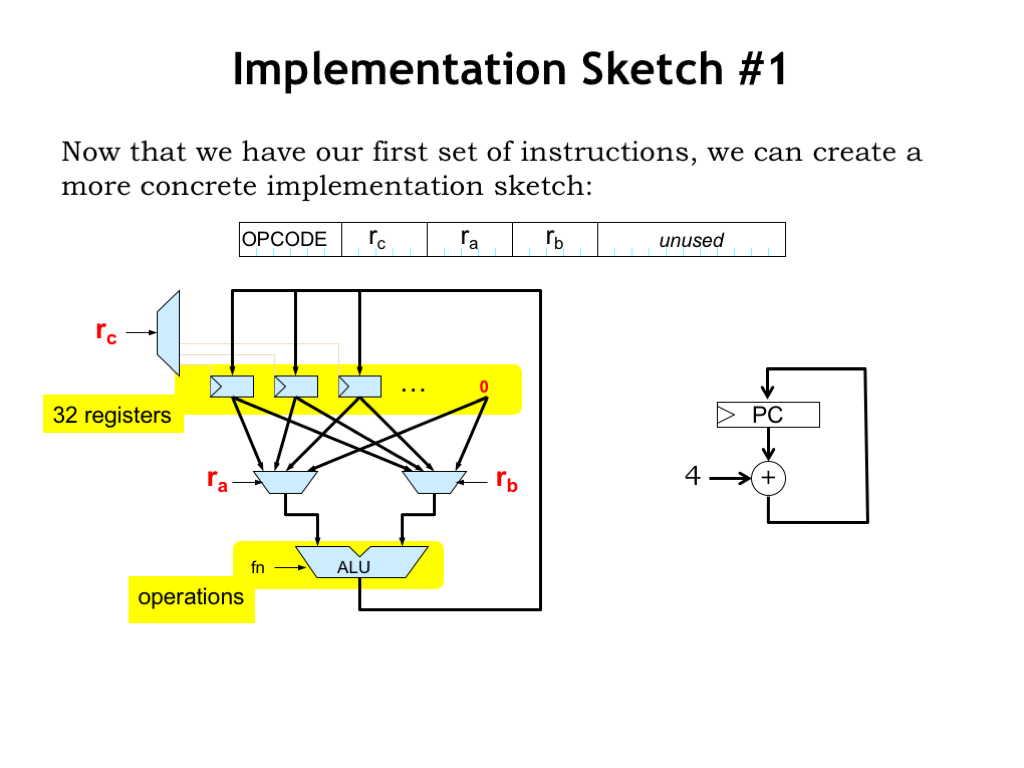
Implementation Sketch #1

ra/rb 选操作数(R31→常数 0);rc 选写回。Opcode→ALU 功能可用 64 项 ROM。PC 每指令 +4。RISC 好处:许多字段可直接作控制信号。

23. 是否支持常数操作数?(Should We Support Constant Operands?)

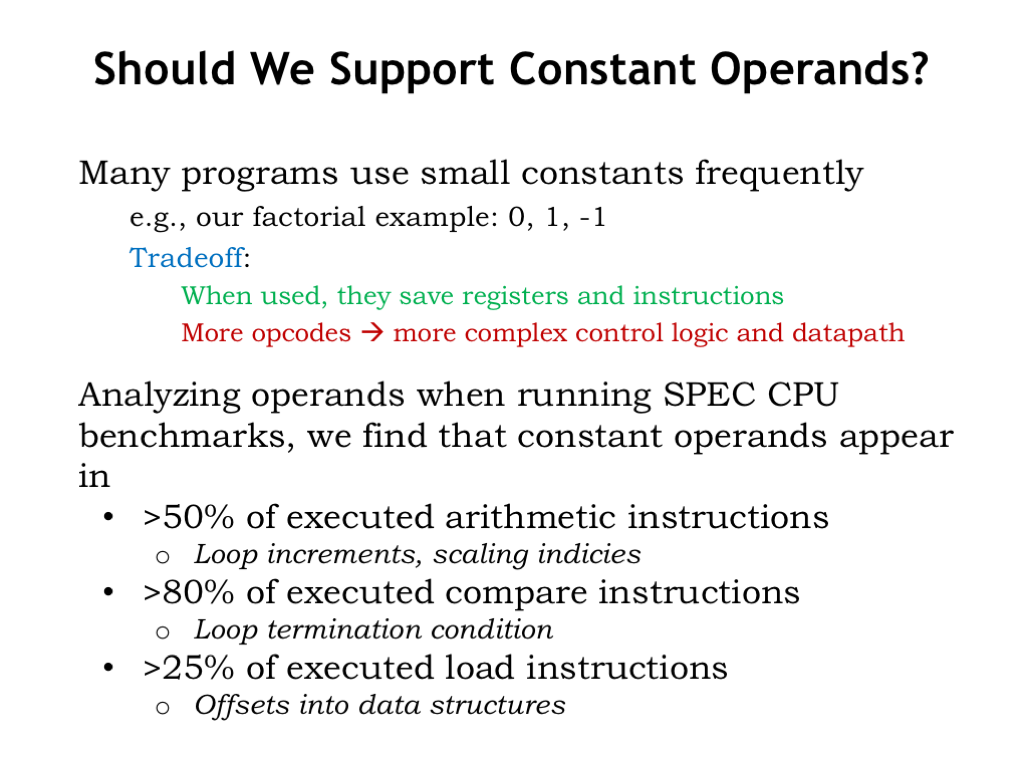
Should We Support Constant Operands

用定量法评估“第二操作数可为小常数”:腾出 16 bit 常数域。看实际执行(非静态出现次数):算术指令过半第二操作数为小常数;比较约 80%;地址计算亦常见 → 批准该特性(程序更小更快)。

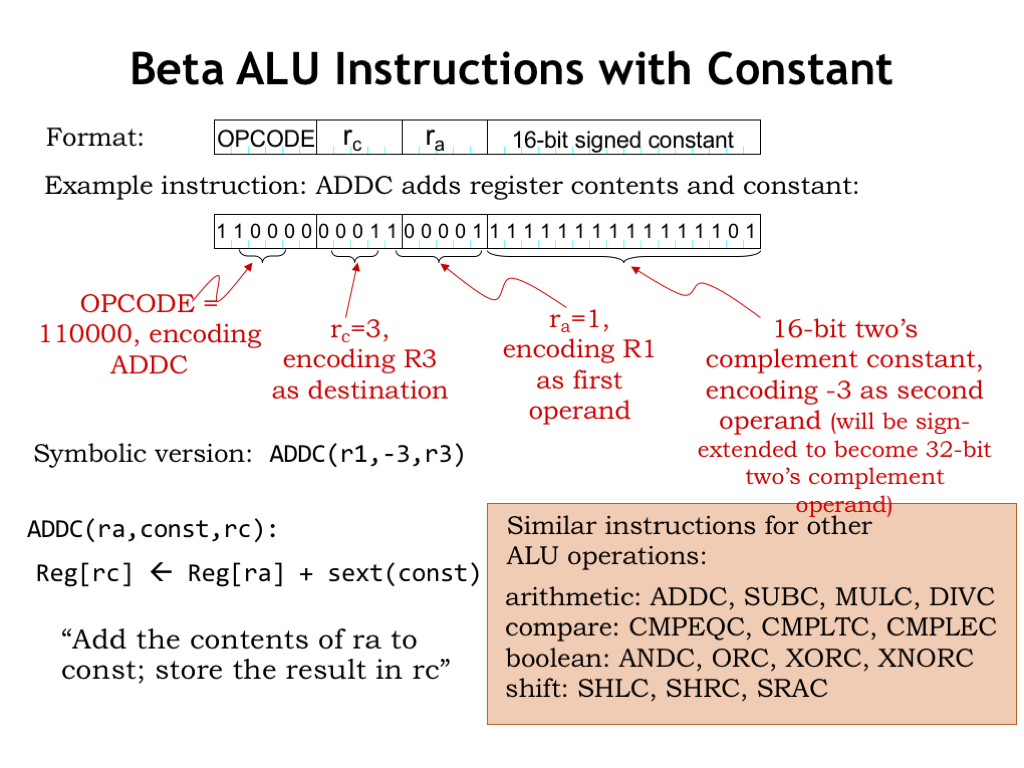
24. 带常数的 Beta ALU 指令(Beta ALU Instructions with Constant)

Beta ALU Instructions with Constant

第二格式:rb 换为 16 bit 补码常数(−32768∼32767-32768\sim 32767)。例:ADDC(r1,-3,r3)。16→32 bit 用符号扩展(复制符号位),纯布线即可。助记符加后缀 C;超 16 bit 常数须放主存再 LD。

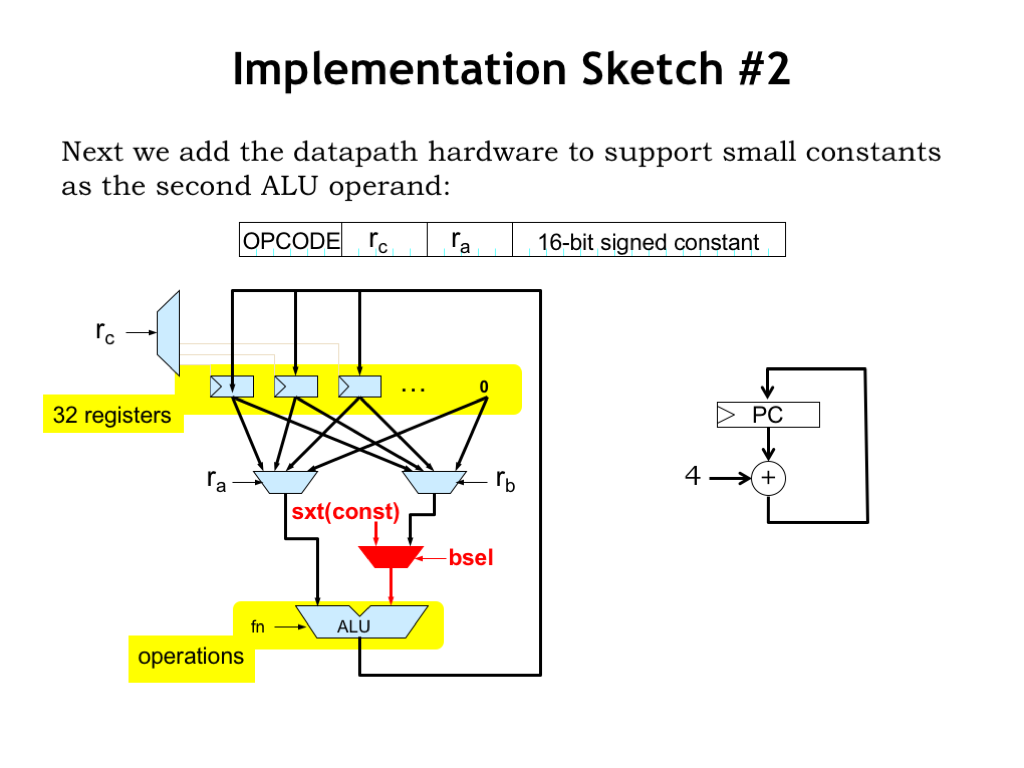
25. 实现草图 #2(Implementation Sketch #2)

Implementation Sketch #2

多一个 MUX:BSEL=1 选符号扩展常数,否则选 rb。细节后几讲再展开。

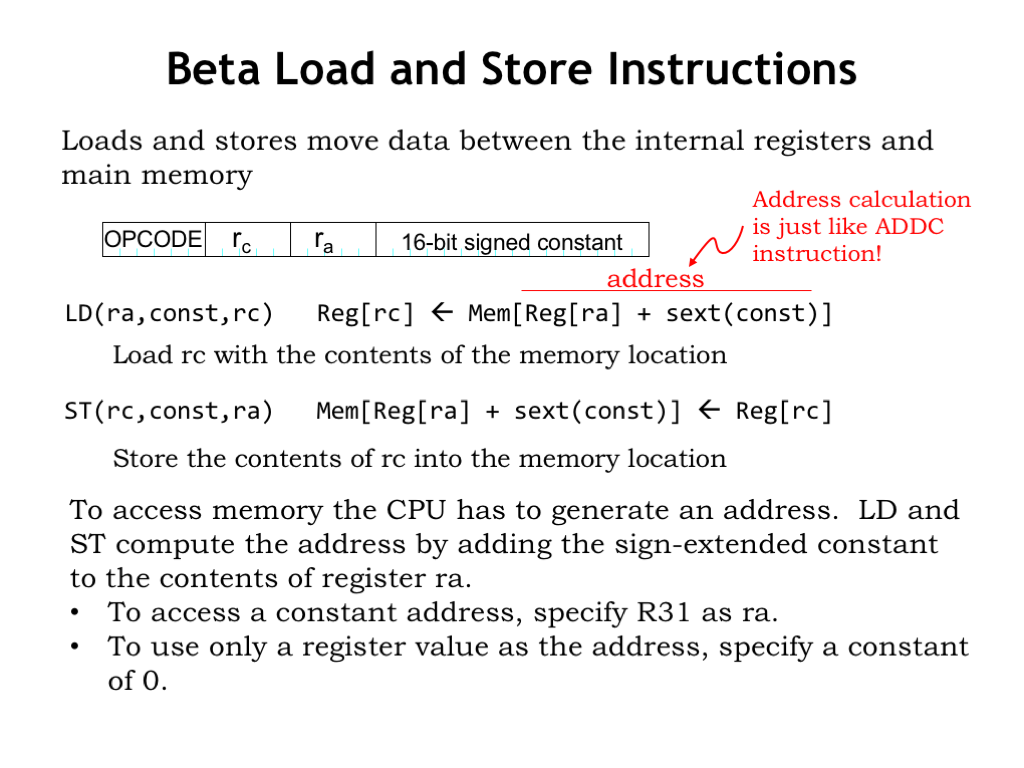
26. Beta 的 Load / Store(Beta Load and Store Instructions)

Beta Load and Store Instructions

访存唯一途径。地址 = Ra + 符号扩展(const)(与 ADDC 同硬件)。LD:内存→Rc;ST:Rc→内存。ST 特殊:唯一需读 Rc;符号形式中 Rc 写在前;唯一不写寄存器堆的指令。

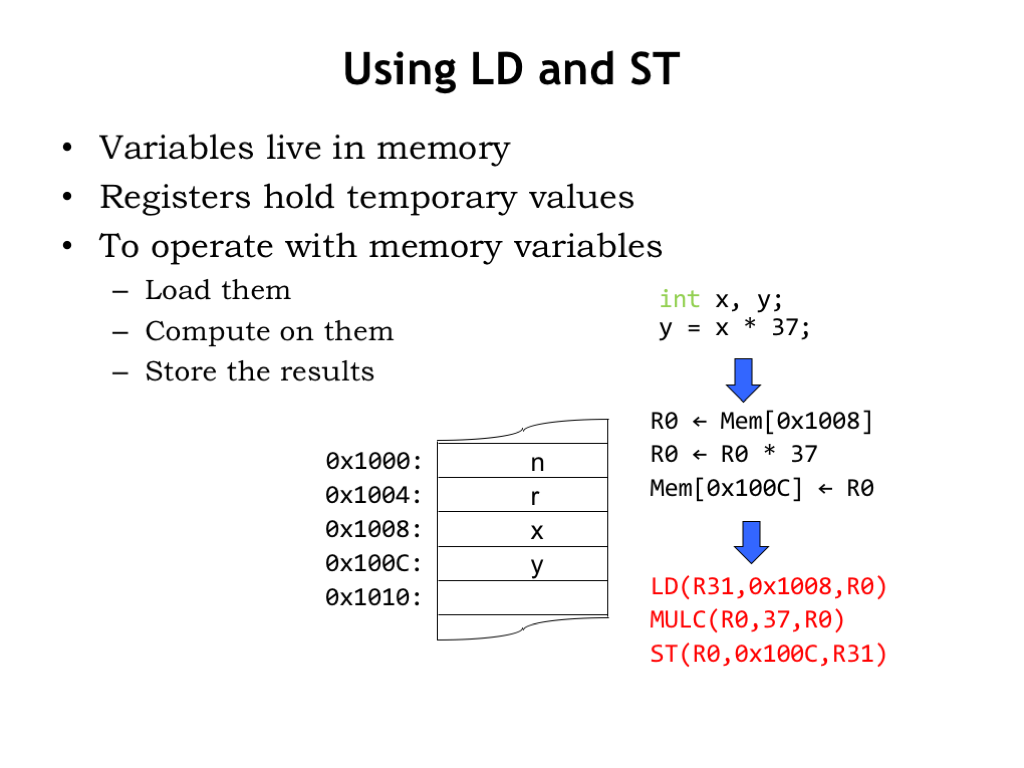
27. 使用 LD 与 ST(Using LD and ST)

Using LD and ST

y=x*37 三条:LD(0x1008,r31,r?) 等。地址适合 16 bit 常数时直接编入;更大地址当大常数存内存。低内存放不下全部大常数时,可用后讲的 LDR(load relative)。

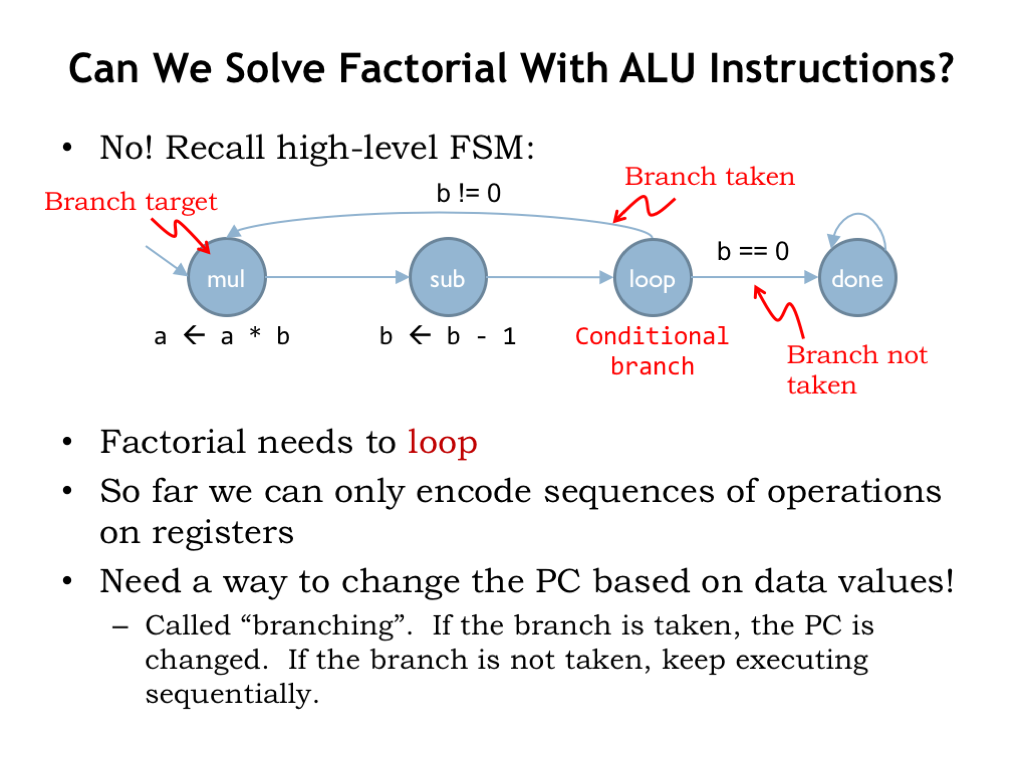
28. 仅用 ALU 能解阶乘吗?(Can We Solve Factorial with ALU Instructions?)

Can We Solve Factorial with ALU Instructions

顺序执行不够:需循环/跳过 → 条件分支。条件成立则 PC 改到 branch target;否则 PC+4。用于循环、if、过程调用等。

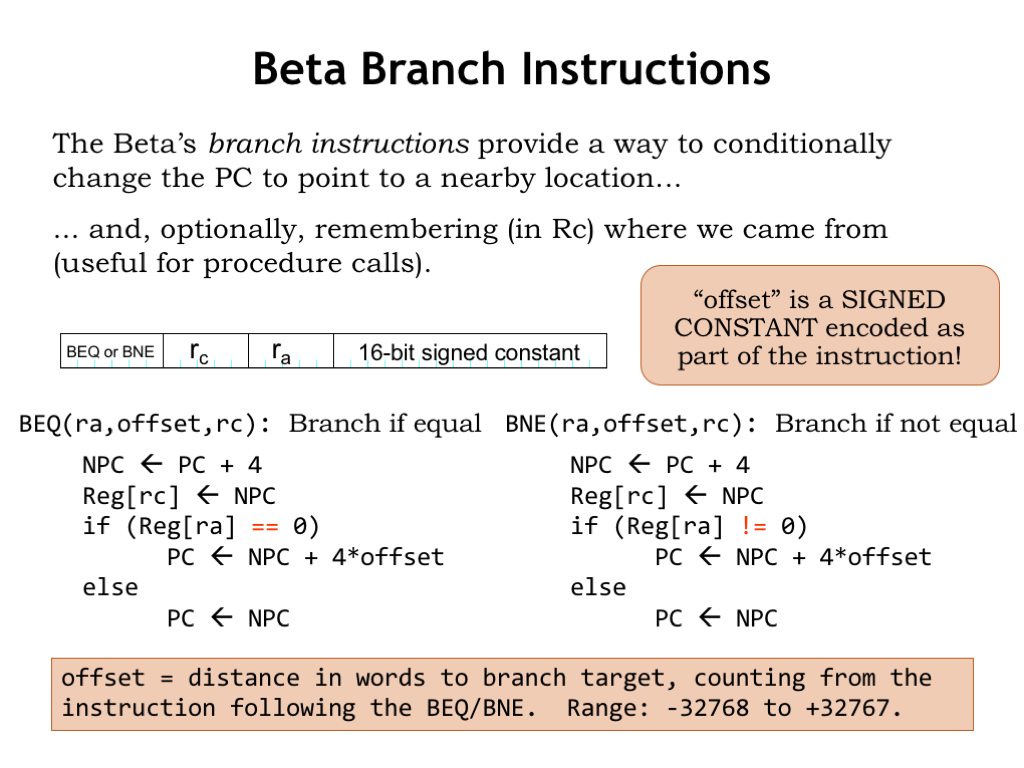
29. Beta 分支指令(Beta Branch Instructions)

Beta Branch Instructions

BEQ:先把 PC+4 写入 Rc(不需要可写 R31);若 Ra==0 则 PC 加 字偏移×4(PC-relative);否则 PC+4。偏移 0 = 下一条;−1-1 = 分支自身。负偏移常用于循环回跳;正偏移用于 if 前跳。

BEQ(R31,…) 恒成立 → 无条件分支。BNE:Ra≠0 时跳转。

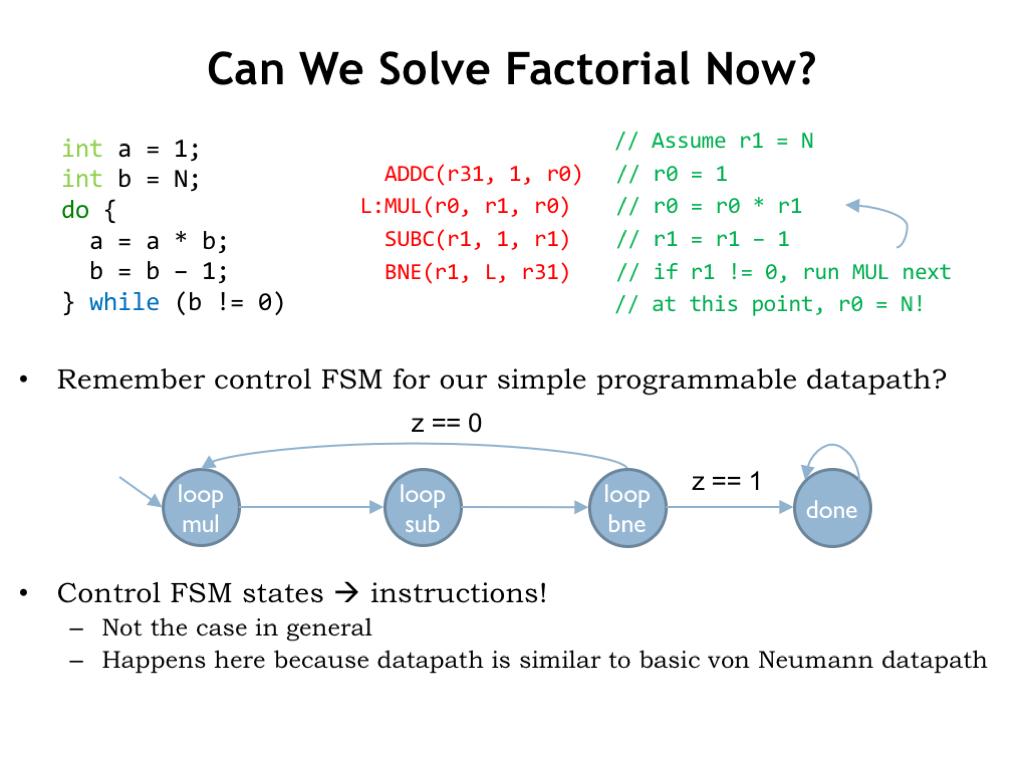
30. 现在能写阶乘了吗?(Can We Solve Factorial Now?)

Can We Solve Factorial Now

迭代阶乘:标号 L: 处 MUL、减一,BNE 回 L。符号形式写标号,由汇编器算偏移。与早先高层 FSM 各态高度对应(datapath 相似时常见)。

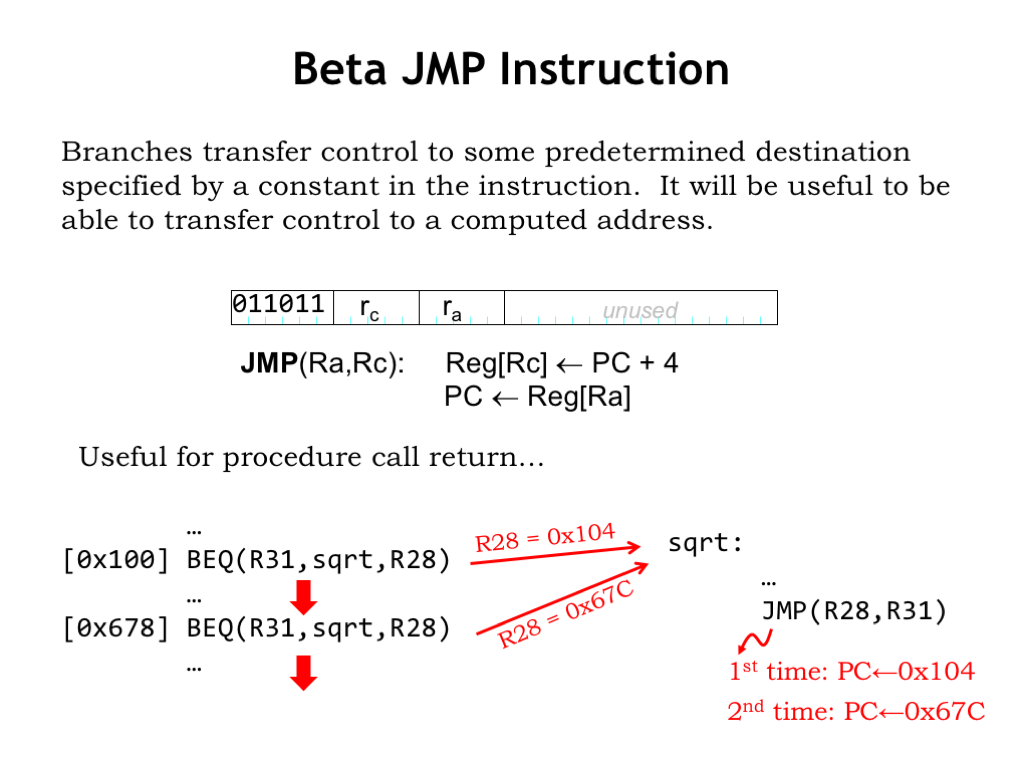
31. Beta JMP 指令(Beta JMP Instruction)

Beta JMP Instruction

JMP:PC←Ra,并可选保存 PC+4 到 Rc。配合无条件分支:调用时 BEQ 跳到过程并保存返回地址;过程末 JMP 返回。同一过程可从多处调用(返回地址不同)。过程细节后讲。

32. Beta ISA 小结(Beta ISA Summary)

Beta ISA Summary
  • 32 个寄存器;程序与数据在主存;2322^{32} 字节地址空间;字访问、地址为 4 的倍数
  • 两种格式:opcode+三寄存器,或 opcode+两寄存器+符号扩展 16 bit 常数
  • 三类指令:ALU、LD/ST、分支与 JMP

下一讲:用这套简单运算表达任意可计算过程。

整理自 MIT OCW 6.004 Computation Structures(Spring 2017)L08 注解幻灯片。

源网页:8.1 Annotated Slides | Design Tradeoffs

讲师:Chris Terman。图片直接引用 OCW 原站链接。

L08:设计折衷(Design Tradeoffs)

本讲讨论功耗(静态/动态)、降耗手段,以及加法器(ripple / carry-select / CLA)与乘法器(组合 / 流水 / 时序 carry-save)在延迟、吞吐与面积上的 Θ\Theta 折衷。完成本课程 Part 1 的收束。

1. 优化你的设计(Optimizing Your Design)

Optimizing Your Design

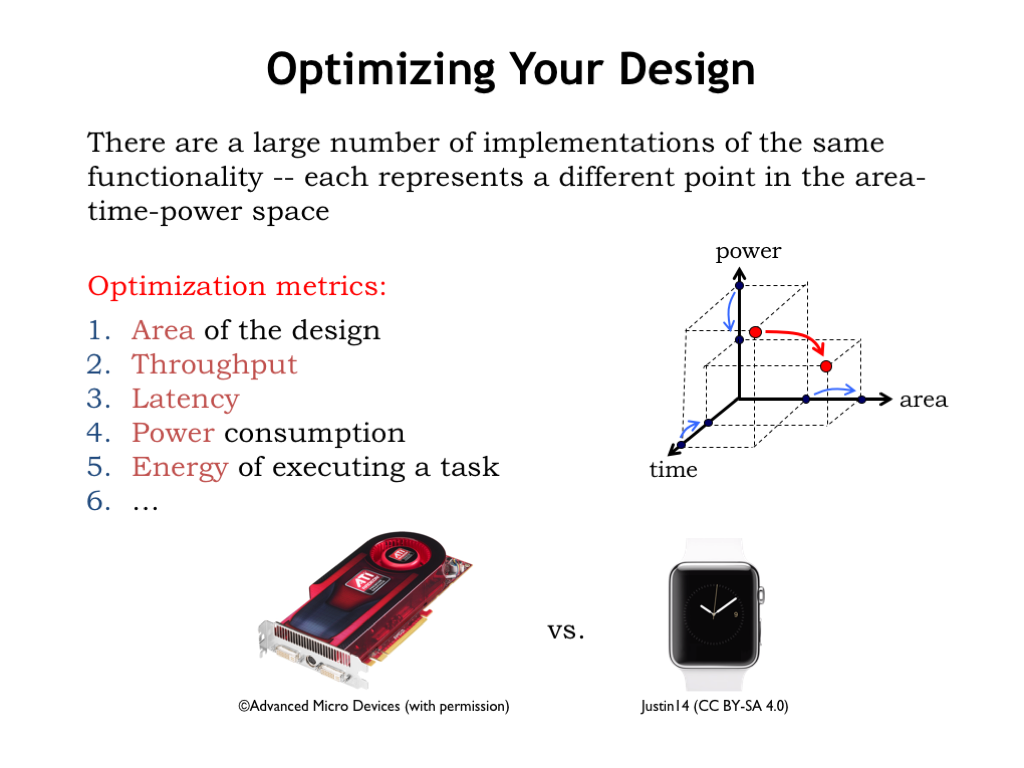
正确折衷取决于设计目标。显卡团队:优先性能,可在限度内换成本与功耗;尺寸有硬上限,再小收益不大。手表团队:尺寸与功耗关键(戴一天、不烫手腕)。

同一“是否流水”决策:流水寄存器增加成本;重叠执行与更高 tCLKt_{\mathrm{CLK}} 抬高功耗与散热需求 → 两队结论可能相反。本章列举可用折衷;选对约束下的权衡是工程师的乐趣。

2. CMOS 静态功耗(CMOS Static Power Dissipation)

CMOS Static Power Dissipation

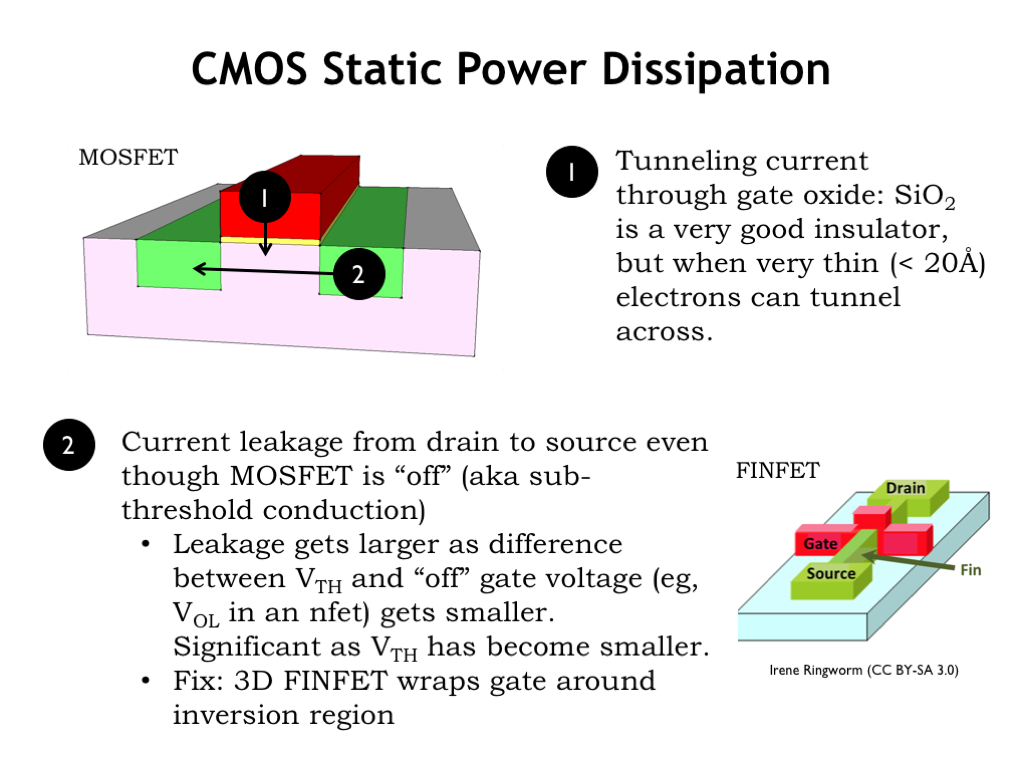
静态功耗:电路空闲(节点不变)时仍消耗的功率。理想开关模型下 CMOS 静态功耗为 0;早期接近理想,但尺寸缩小、电压降低后两大效应凸显(n/p 沟道皆有):

  1. 栅氧变薄 → 电场增强、速度提升,但电子可隧穿绝缘层,产生栅→衬底漏电流;数十亿管累积不可忽视
  2. 亚阈导通(sub-threshold conduction):名义截止(VGS<VTHV_{\mathrm{GS}}<V_{\mathrm{TH}})时仍有漏电,与 VGS−VTHV_{\mathrm{GS}}-V_{\mathrm{TH}}(截止时为负)指数相关;VTHV_{\mathrm{TH}} 降低使漏电增大

缓解:FinFET / tri-gate(沟道成鳍、栅三面包围)可把亚阈漏电降一个数量级以上。

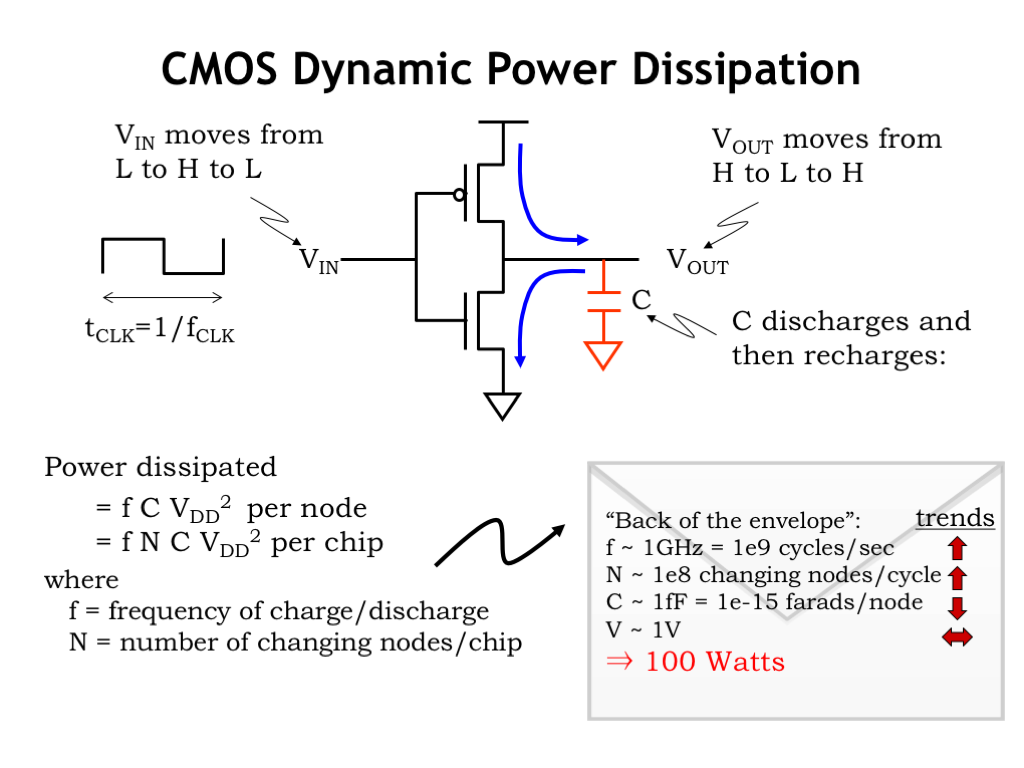
3. CMOS 动态功耗 I(CMOS Dynamic Power Dissipation I)

CMOS Dynamic Power Dissipation I

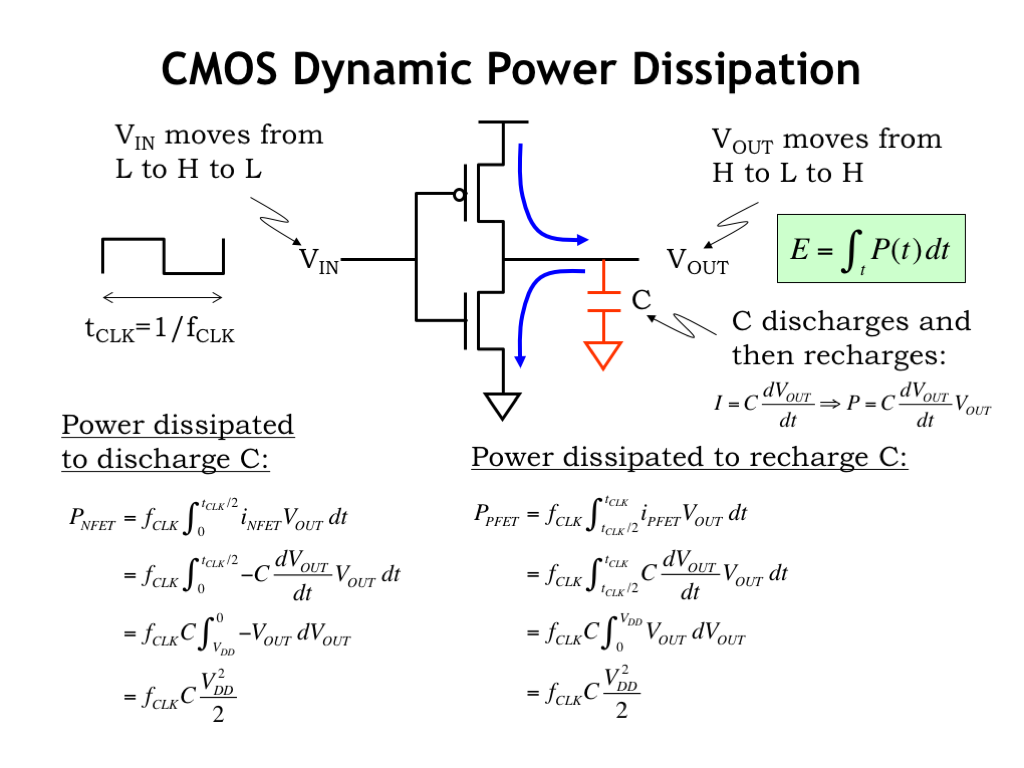
动态功耗:节点翻转充放电电容时消耗。以反相器为例:充/放电时电流经 MOSFET,瞬时功率 IDSVDSI_{\mathrm{DS}}V_{\mathrm{DS}}。对 1→0 积分(I=C dV/dtI=C\,dV/dt),若时钟周期 tCLKt_{\mathrm{CLK}}、每半周期一次翻转,经 pulldown 耗散的功率约为 0.5 f C VDD20.5\,f\,C\,V_{\mathrm{DD}}^2(ff 为每秒翻转次数)。

完整充→放一周期耗散 CVDD2CV_{\mathrm{DD}}^2 焦耳;频率 ff 时平均功率为 fCVDD2fCV_{\mathrm{DD}}^2 瓦;能量全部来自电源:一半充电容时耗散,一半存于电容后放电耗散。

4. CMOS 动态功耗 II(CMOS Dynamic Power Dissipation II)

CMOS Dynamic Power Dissipation II

整电路:每周期约 NN 个节点翻转时,可据此估算总能耗。信封估算:1 GHz、1 亿内部节点、每节点 ∼1 fF\sim 1\,\mathrm{fF}、VDD∼1 VV_{\mathrm{DD}}\sim 1\,\mathrm{V} → 约 100 W——接近白炽灯泡,散热困难。笔记本 CPU 远低于此,靠设计技巧压功耗。

单独降低 VDDV_{\mathrm{DD}}(如 3.3 V→1 V)可降功耗一个数量级以上(因 ∝V2\propto V^2)。技术趋势使晶体管更多更快,若不精打细算会撞上功耗墙。

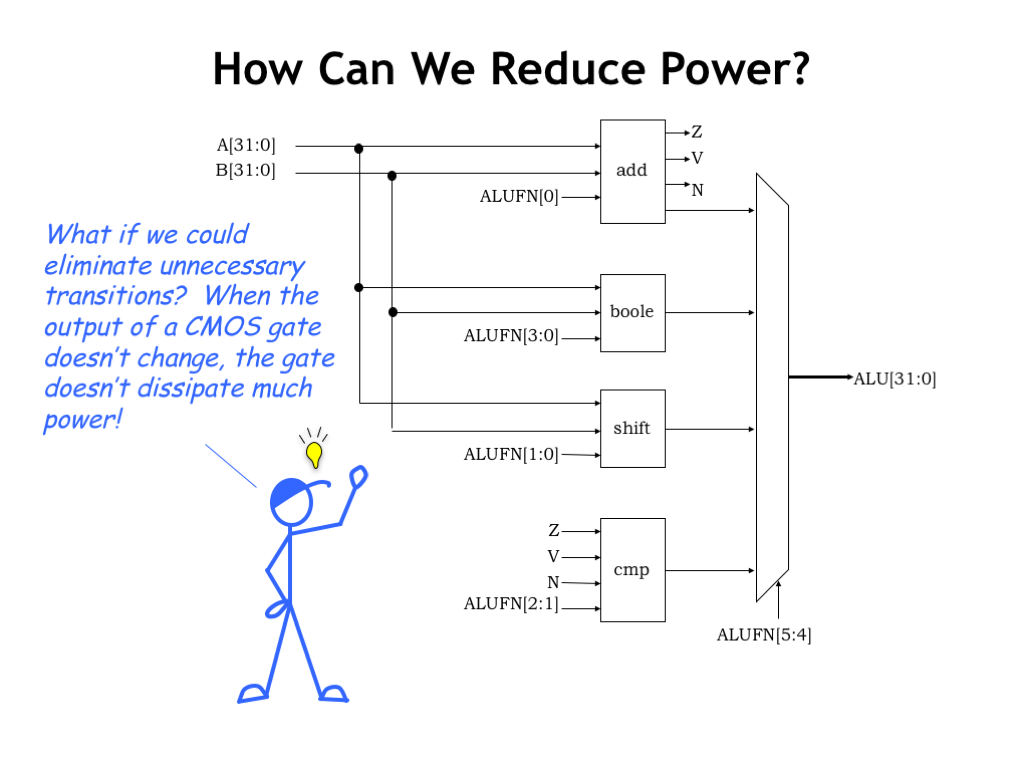
5. 如何降低功耗?(How Can We Reduce Power?)

How Can We Reduce Power

ALU 常含算术、布尔、移位、比较等独立模块;控制只选其一,其余结果被忽略——但仍在耗动态功耗。机会:关掉不需要的模块。

思路:阻止其输入变化 → 内部节点不动 → 动态功耗为零。

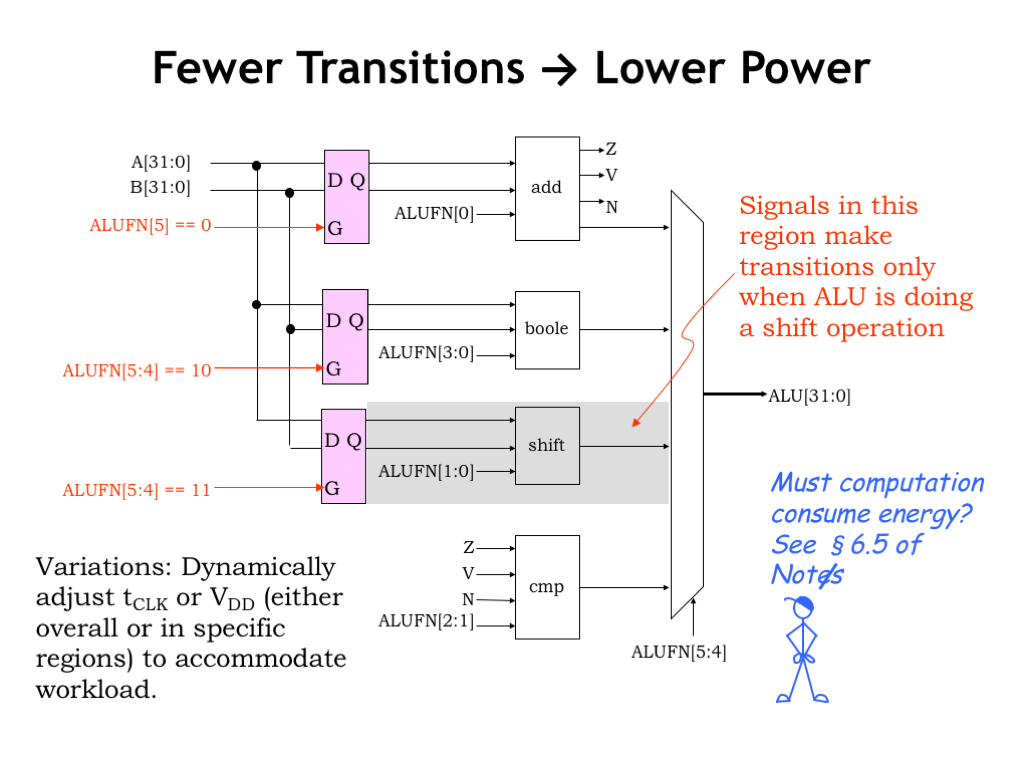
6. 更少翻转 → 更低功耗(Fewer Transitions → Lower Power)

Fewer Transitions Lower Power

手段:

  • 各模块输入加 latch,仅当本周期需要该结果时打开 → 移位器等大模块多数时间不翻转
  • 切断电源关断整块(更复杂,常用于特殊省电模式)
  • 降频:无事时减慢时钟(对毫秒级外部事件尤其有效),有事件再加速

移动设备广泛使用上述技巧。计算是否必然耗能见课程笔记 §6.5。

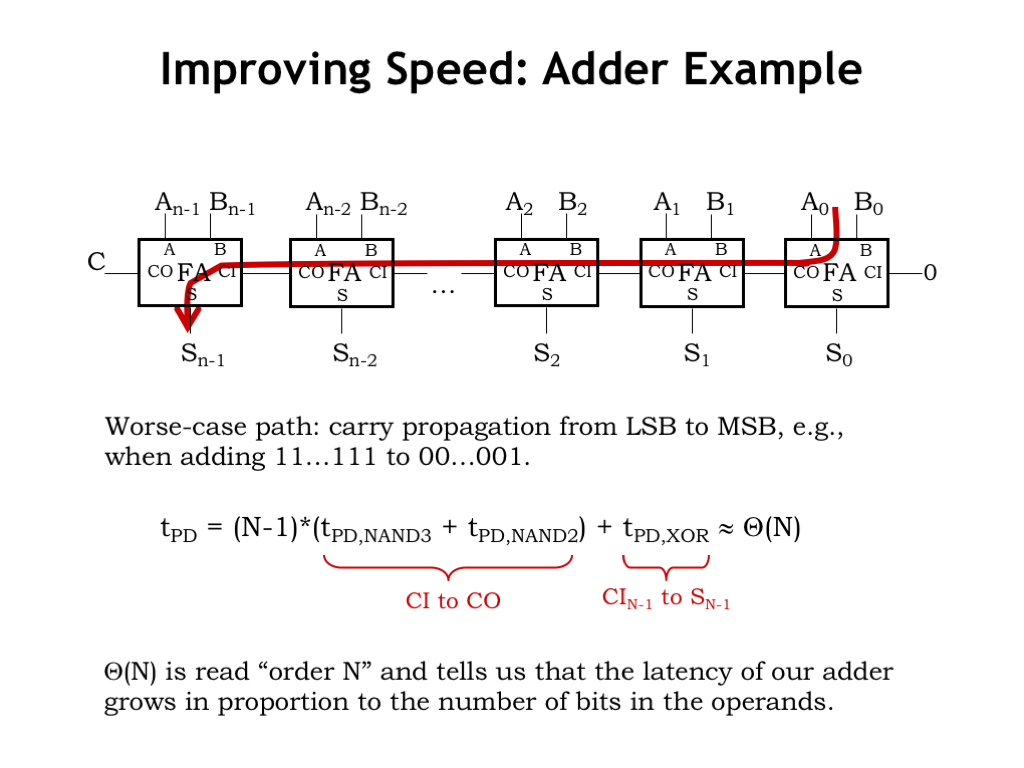
7. 提速:加法器例子(Improving Speed: Adder Example)

Improving Speed: Adder Example

瓶颈常在行波进位加法器(ripple-carry):最长路径是进位链。触发:A 全 1、B 最低位 1 其余 0(加 −1-1 与 11)→ 进位逐级 ripple。

延迟 ≈(N−1)×tcarry+tsum\approx (N-1)\times t_{\mathrm{carry}}+t_{\mathrm{sum}}。NN 翻倍则延迟约翻倍 → 延迟 Θ(N)\Theta(N)(阶记号忽略相对次要项)。

8. 性能/成本分析(Performance/Cost Analysis)

Performance/Cost Analysis

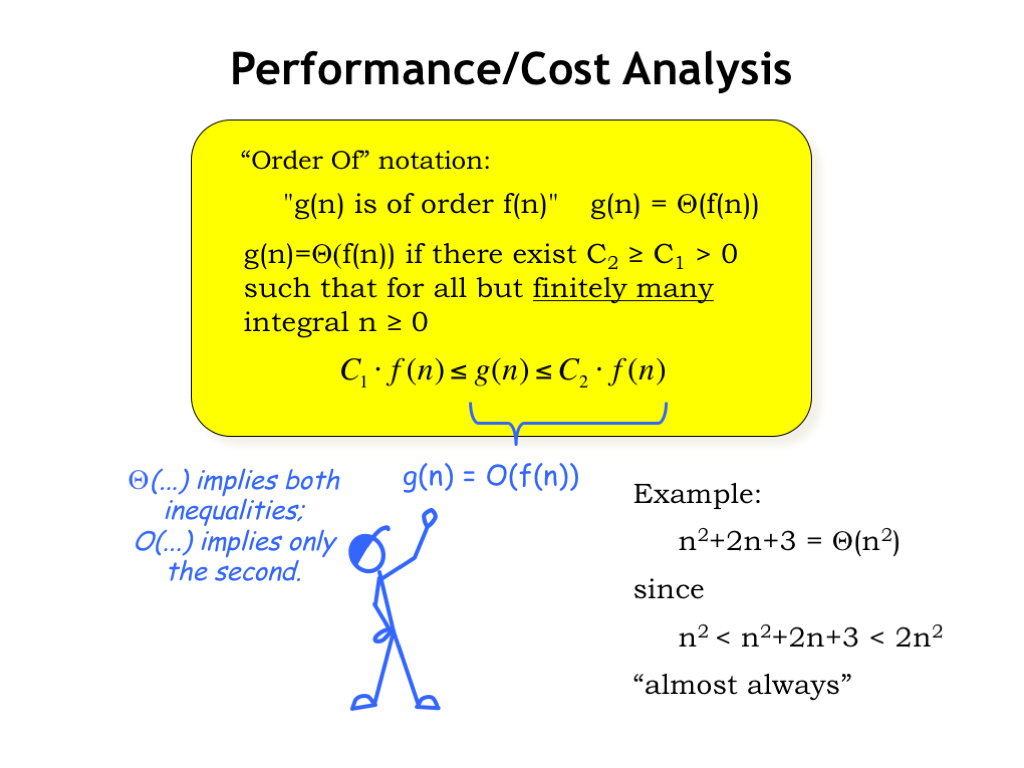
渐近分析:标出 N→∞N\to\infty 时主导项。例:n2+2n+3n^2+2n+3 被常数倍的 n2n^2 上下夹住(除有限个 nn)→ Θ(n2)\Theta(n^2)。

  • Θ(f)\Theta(f):上下皆被 ff 的常数倍界定
  • O(f)O(f):仅上界

9. 进位选择加法器(Carry-Select Adders)

Carry-Select Adders

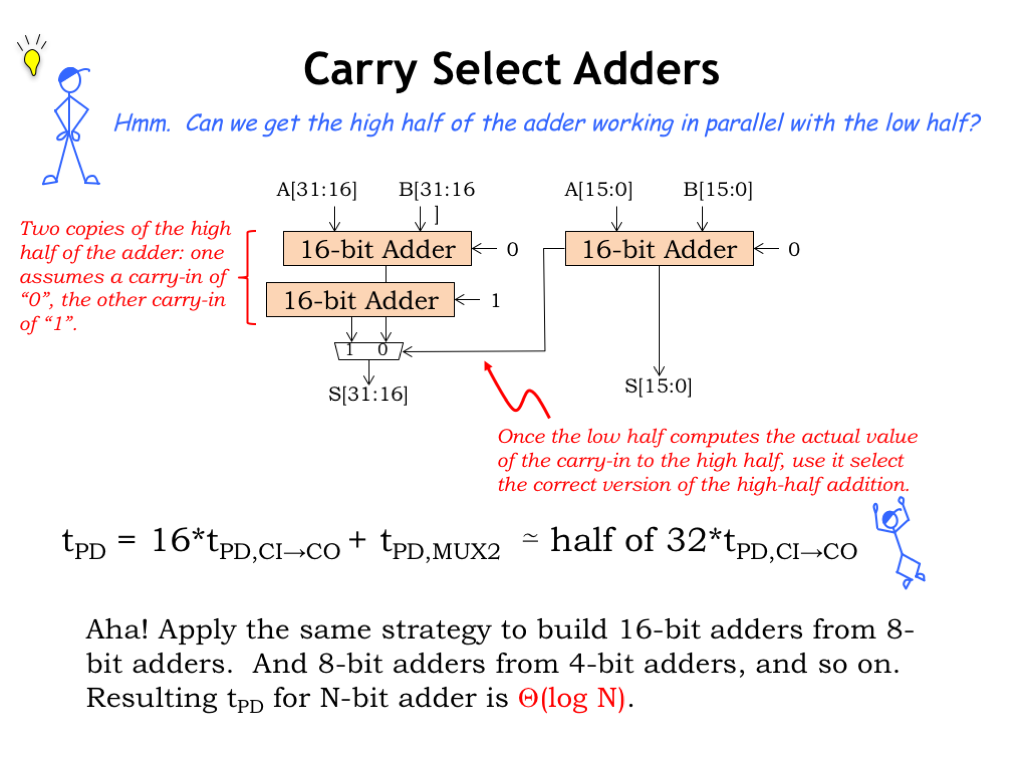
高半部不必等低半部进位:做两份高 16 位加法(假设 Cin=0C_{\mathrm{in}}=0 与 11),与低半部并行;再用低半部真实进位选结果 → carry-select adder。

32 bit 延迟约略高于 16 bit ripple,∼\sim 减半延迟,代价约 +50% 电路。递归对更小块做同样事:log⁡2N\log_2 N 层后延迟为常数加法 + log⁡N\log N 个 MUX → Θ(log⁡N)\Theta(\log N)。清晰的性能–面积折衷。

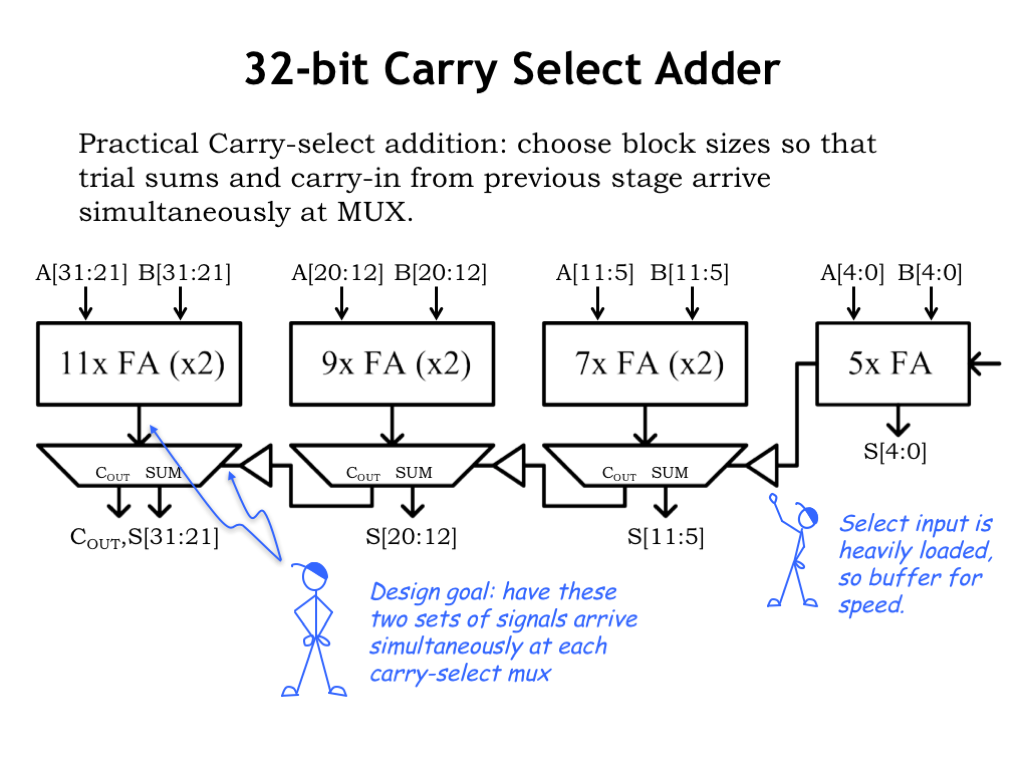
10. 32 位进位选择加法器(32-Bit Carry-Select Adder)

32-Bit Carry-Select Adder

工程版:块大小使试算和与前级进位几乎同时到达 select MUX;select 负载大时加 buffer。相对 32 bit ripple:约 2.5× 更快,约 2× 电路——ALU 提速常记方案。

11. 要更快的进位逻辑!(Wanted: Faster Carry Logic!)

Wanted: Faster Carry Logic

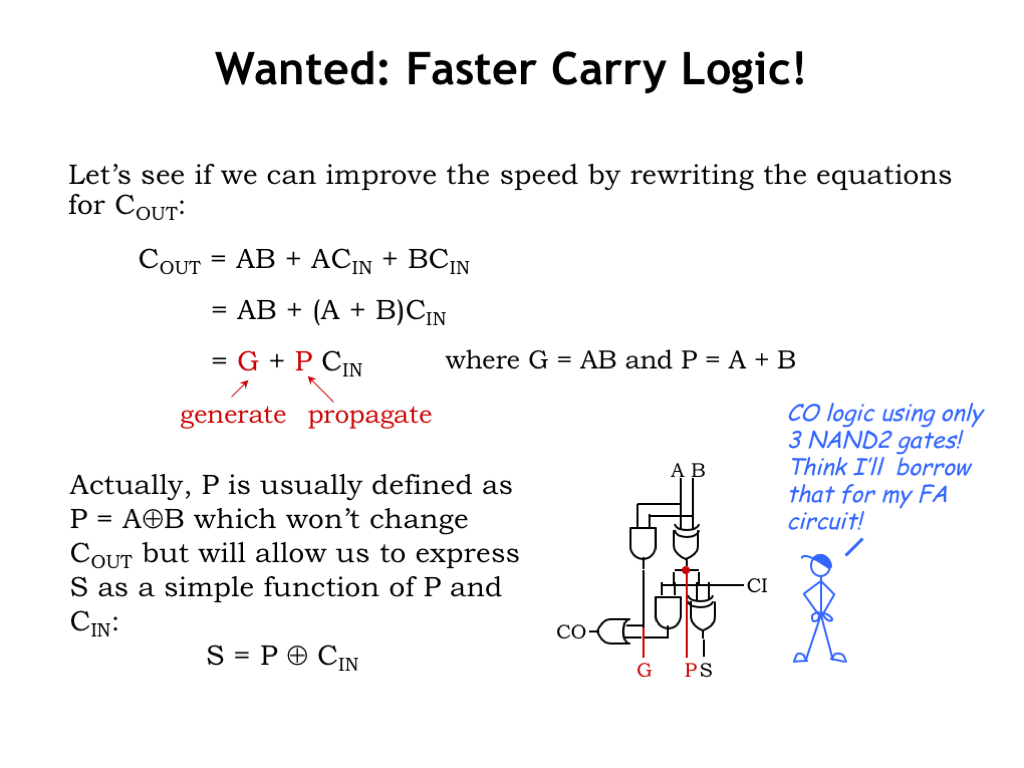
链 → 树可把线性延迟变对数。改写全加器进位:

  • G(generate):无需等 CinC_{\mathrm{in}} 即产生进位
  • P(propagate):有 CinC_{\mathrm{in}} 才传出

Cout=G∨(P∧Cin)C_{\mathrm{out}}=G\lor(P\land C_{\mathrm{in}})。常把 P 从 A∨BA\lor B 改为 A⊕BA\oplus B,则和可写 S=P⊕CinS=P\oplus C_{\mathrm{in}}。进位 SOP 可用三个 2 输入 NAND 实现。

12. 超前进位加法器(Carry Look-Ahead Adders, CLA)

Carry Look-Ahead Adders

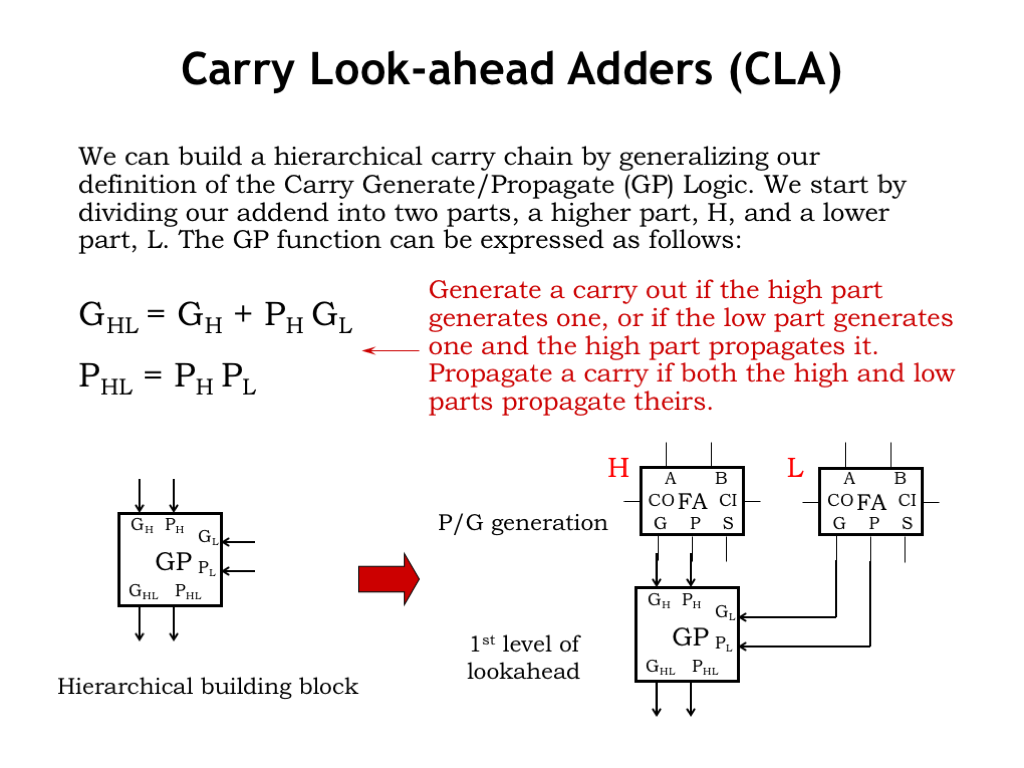
相邻两模块 H、L:块 generate / propagate:

Gblock=GH∨(GL∧PH),Pblock=PL∧PH.G_{\mathrm{block}}=G_H\lor(G_L\land P_H),\quad P_{\mathrm{block}}=P_L\land P_H.

用 GP 模块组合两级进位信息,把两模块当作更大块。

13. 8 位 CLA(生成 G 与 P)(8-Bit CLA: generate G & P)

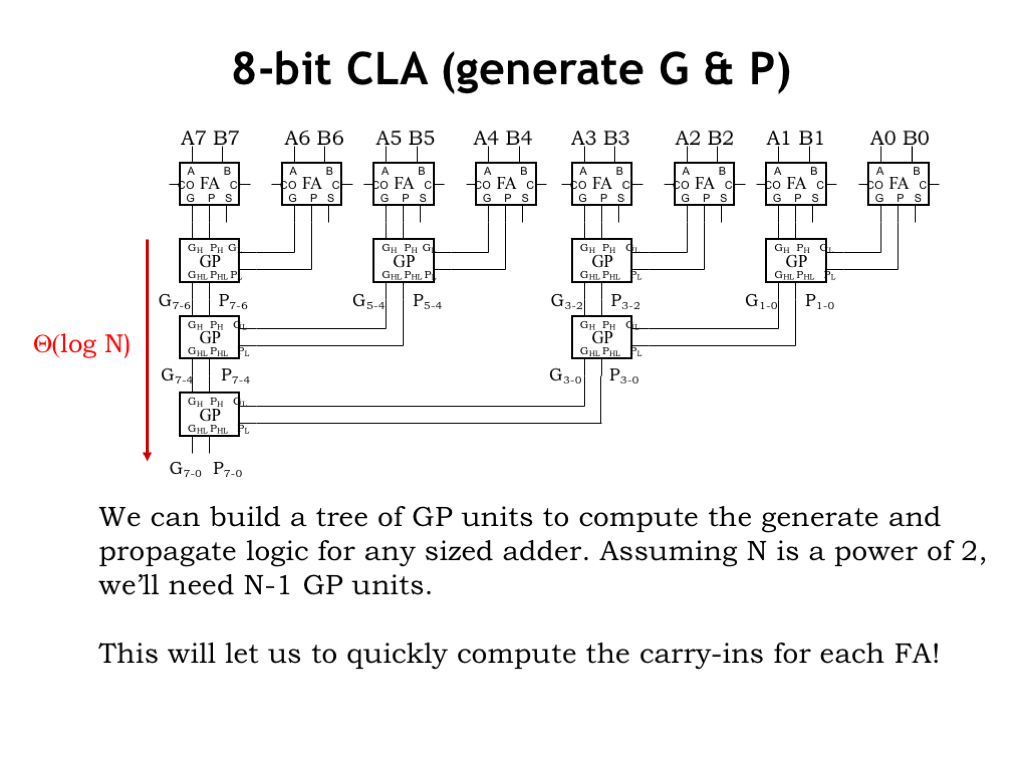
8-Bit CLA generate G and P

多层 GP 成树:NN 输入共 N−1N-1 个 GP 模块,延迟 Θ(log⁡N)\Theta(\log N)。下一步用 G/P 快速算各全加器的 CinC_{\mathrm{in}}。

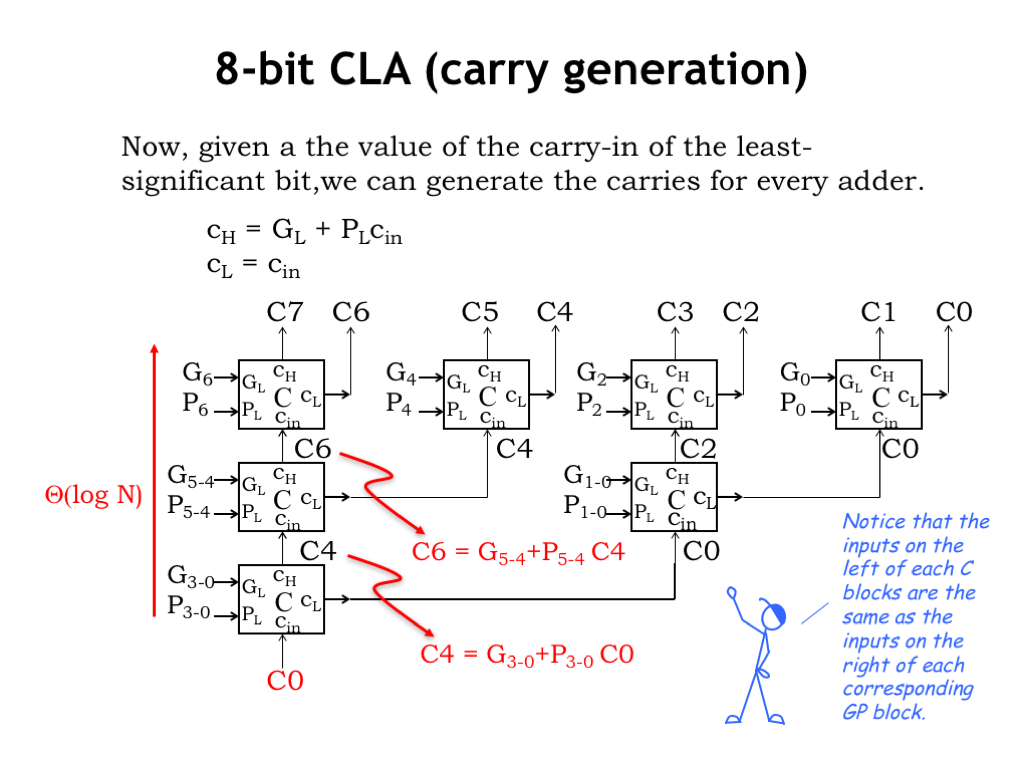
14. 8 位 CLA(进位生成)(8-Bit CLA: carry generation)

8-Bit CLA carry generation

给定最低位 C0C_0:块的低半直接用该进位;高半进位用低半 G/P 算出。C 模块再排成树,层层算出各全加器 CinC_{\mathrm{in}},延迟仍 Θ(log⁡N)\Theta(\log N)。注意同一位置 C 的 GL,PLG_L,P_L 与 GP 树输入对应。

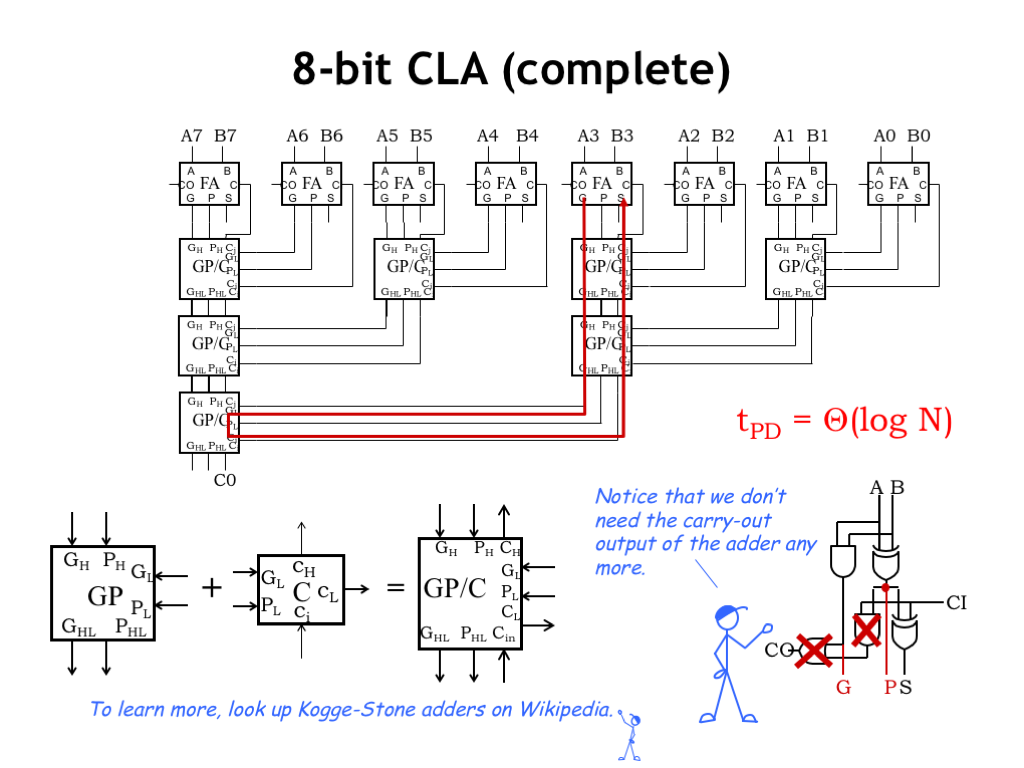
15. 8 位 CLA(完整)(8-Bit CLA: complete)

8-Bit CLA complete

GP 与 C 合成 carry-lookahead 模块:向上传 G/P,向下传进位。上行+下行总延迟 Θ(log⁡N)\Theta(\log N),再加一级 XOR 得和 → 整加法器延迟 Θ(log⁡N)\Theta(\log N),远优于 ripple 的 Θ(N)\Theta(N)。全加器内原 carry-out 逻辑可删。同类策略的极致见 Kogge-Stone 等。

16. 二进制乘法(Binary Multiplication)

Binary Multiplication

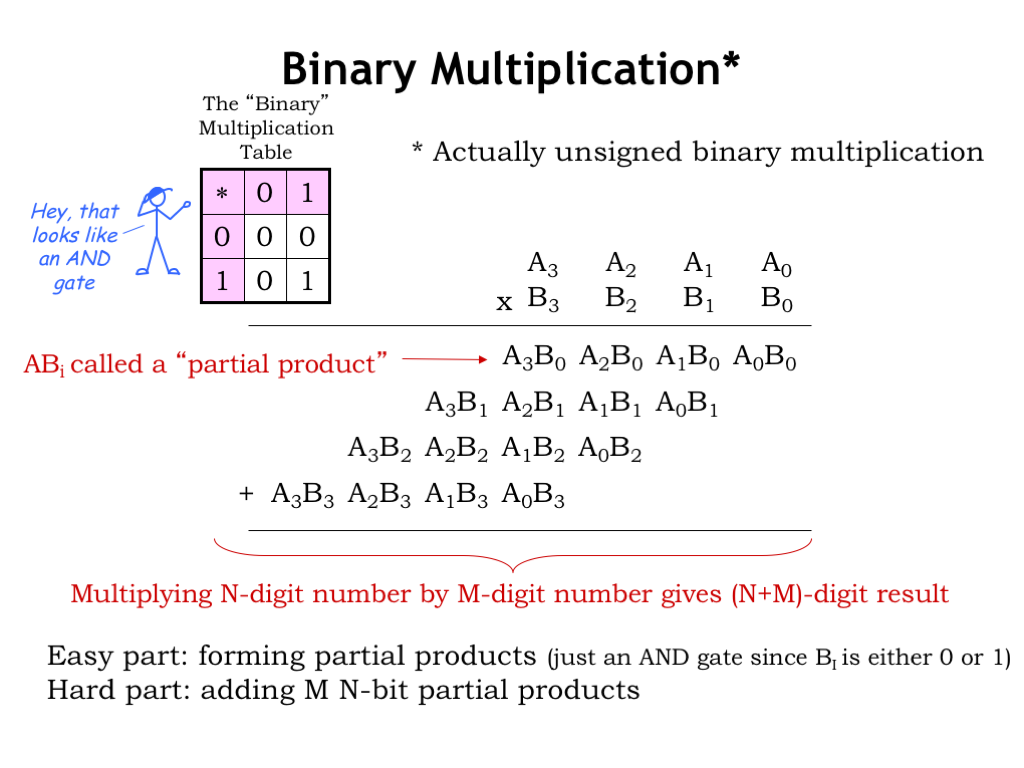
小学竖式:乘数每位 × 被乘数得部分积,左移对齐后相加。1 bit×1 bit 即 AND,无进位;部分积宽 NN。MM 位乘数 → MM 个部分积;相加得 N+MN+M 位结果。贵在把 MM 个 NN 位部分积相加。

17. 组合乘法器(Combinational Multiplier)

Combinational Multiplier

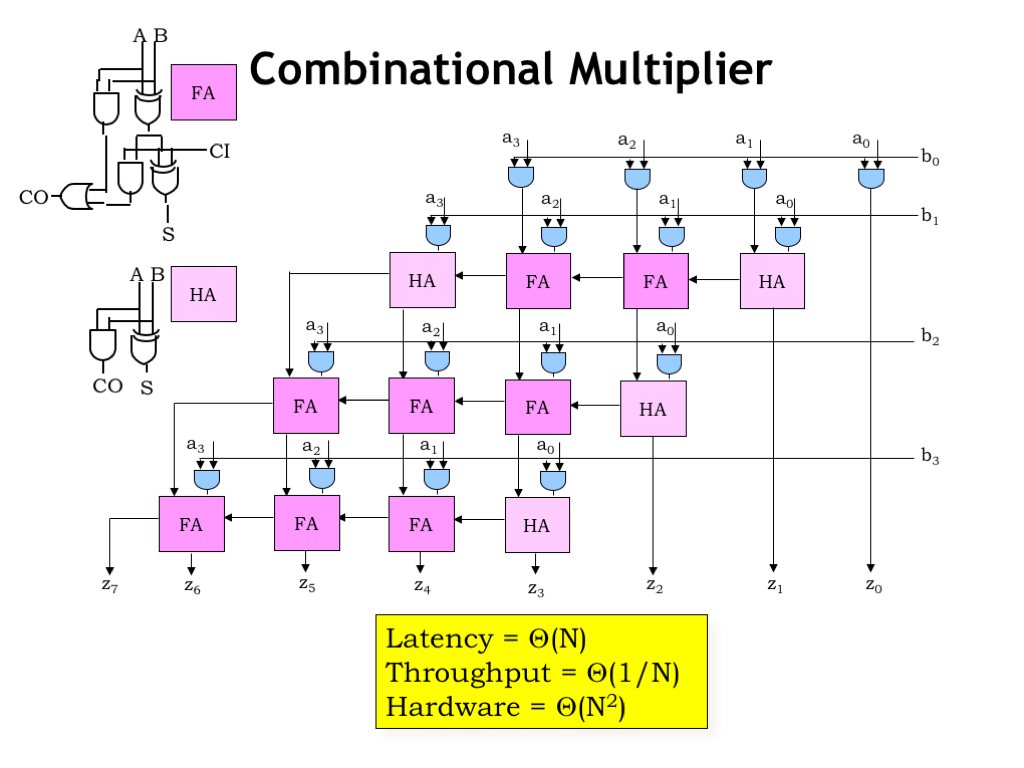
M×NM\times N 个 AND 算部分积;行间用全加器/半加器累加。信息只向下或向左,最长路径至多 N+MN+M 个模块 → 延迟 Θ(N)\Theta(N)(M,NM,N 差常数倍);吞吐 =1/latency=1/\textrm{latency};硬件 Θ(N2)\Theta(N^2)。

18. 补码乘法(2’s Complement Multiplication)

2's Complement Multiplication

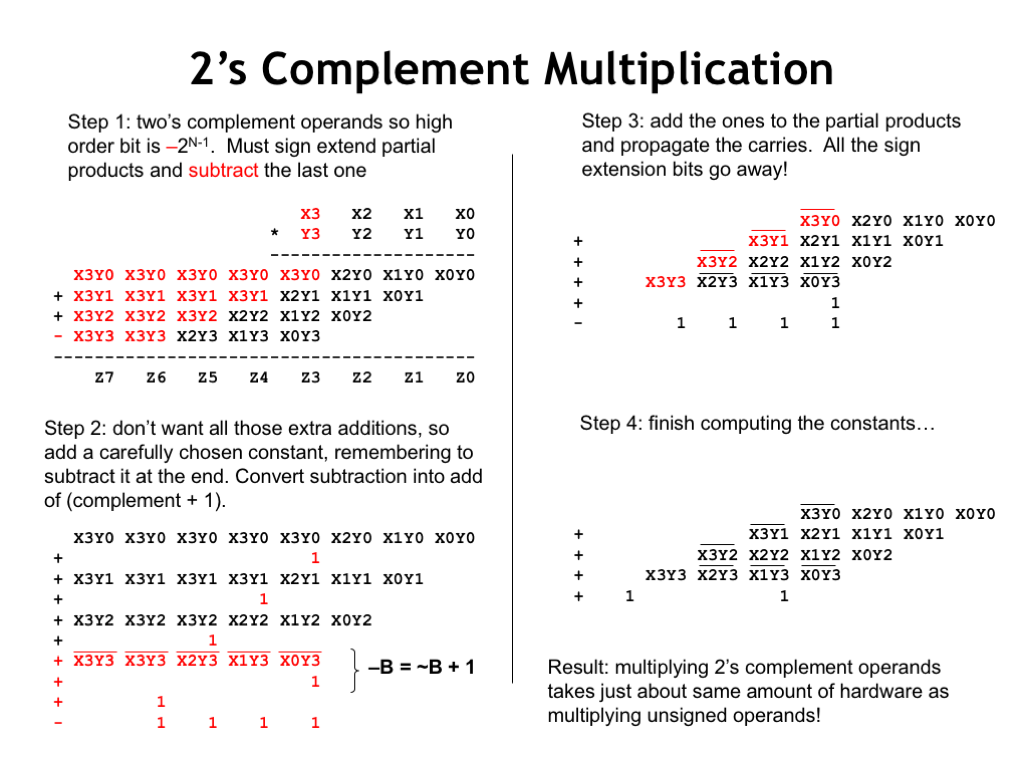
补码最高位负权重 → 部分积需符号扩展到 N+MN+M 位;末个部分积因乘数符号位而改为减。技巧:在若干列加 1 再抵消,把符号扩展与减法化成:若干位取反 + 两处加常数 1——最终表几乎与无符号竖式同形。

19. 补码乘法器电路(2’s Complement Multiplier)

2's Complement Multiplier

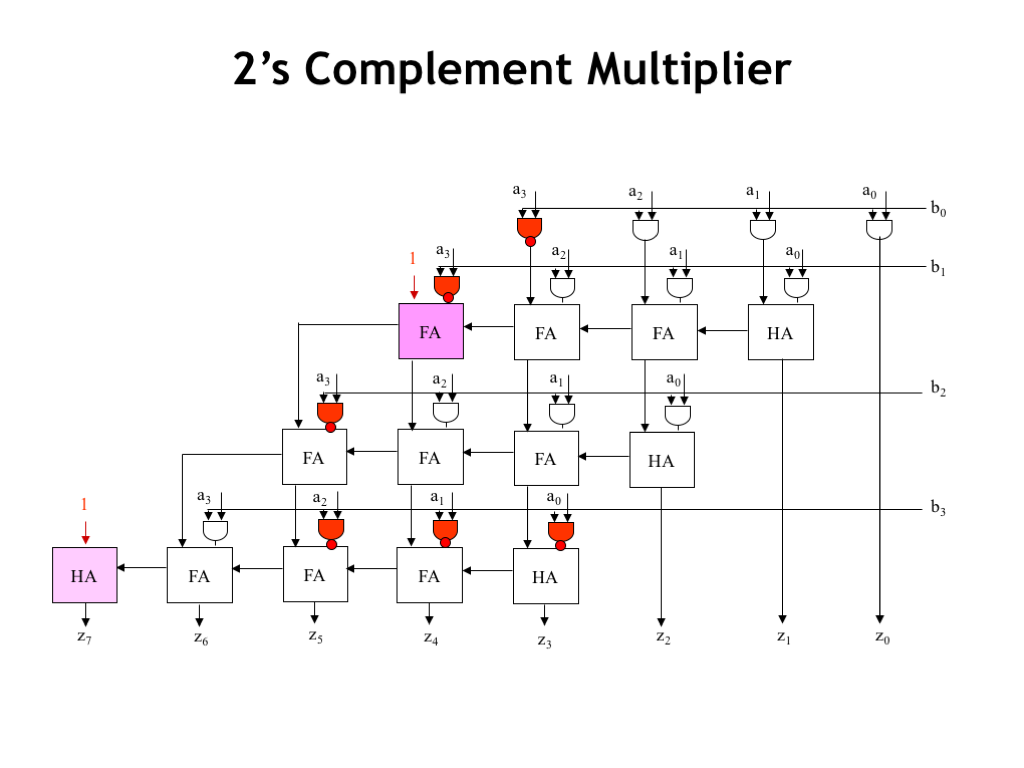
相对无符号版:部分 AND→NAND(取反),并改两处加 1 的逻辑。延迟、吞吐、硬件代价与无符号版同阶。

20. 流水提高吞吐(Increase Throughput with Pipelining)

Increase Throughput with Pipelining

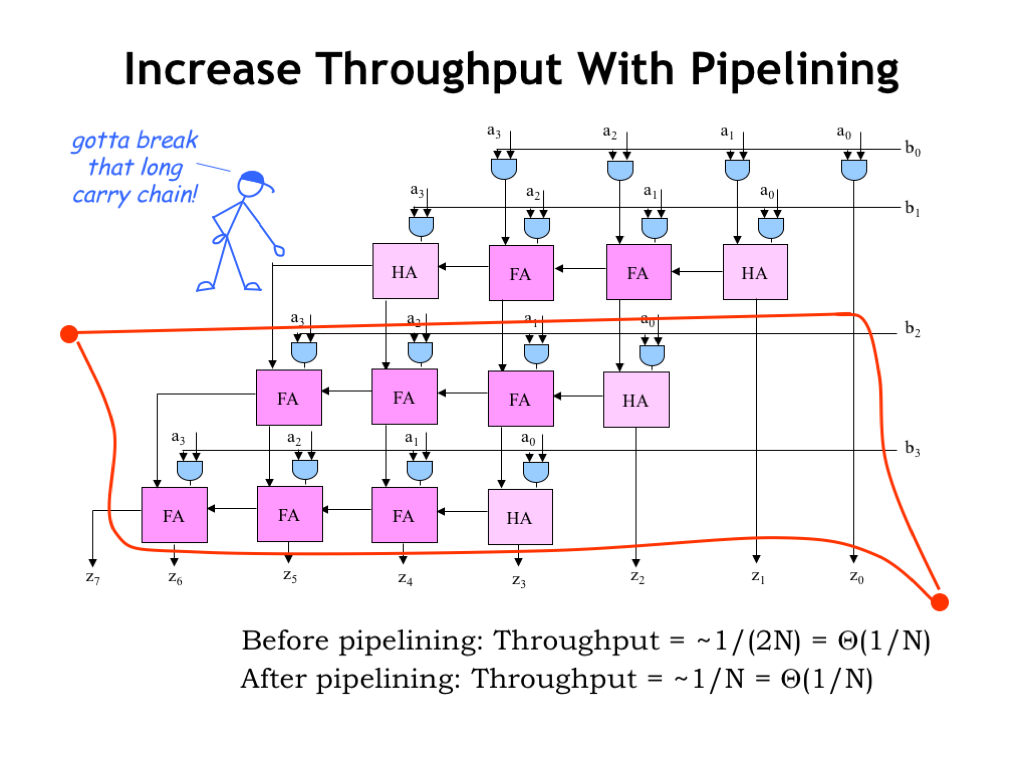
原组合乘吞吐约每 2N2N 拍出一个结果。画输出轮廓得 1-pipeline;再对半切可翻倍吞吐,但仍 Θ(1/N)\Theta(1/N)。关键洞察:整行在同一级 → 级延迟仍含 NN bit ripple → Θ(N)\Theta(N)。

21. Carry-Save 流水乘法器(Carry-Save Pipelined Multiplier)

Carry-Save Pipelined Multiplier

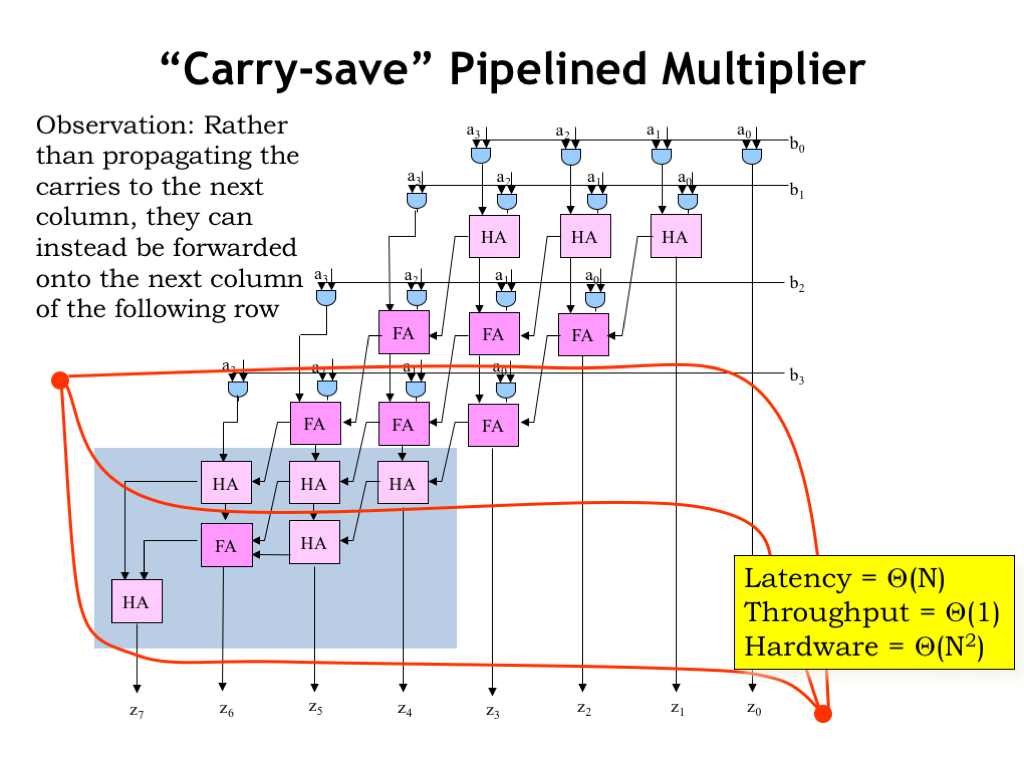
重画进位链:进位仍向左一列,但接到下一行同列。水平流水线切断长进位;每级延迟常数(与 NN 无关)。需 Θ(N)\Theta(N) 额外行收尾进位。

Θ(N)\Theta(N) 级 → 级延迟/时钟/吞吐皆 Θ(1)\Theta(1);系统延迟 Θ(N)\Theta(N);硬件仍 Θ(N2)\Theta(N^2)。吞吐显著提升的折衷。

22. 时序逻辑减面积(Reduce Area with Sequential Logic)

Reduce Area with Sequential Logic

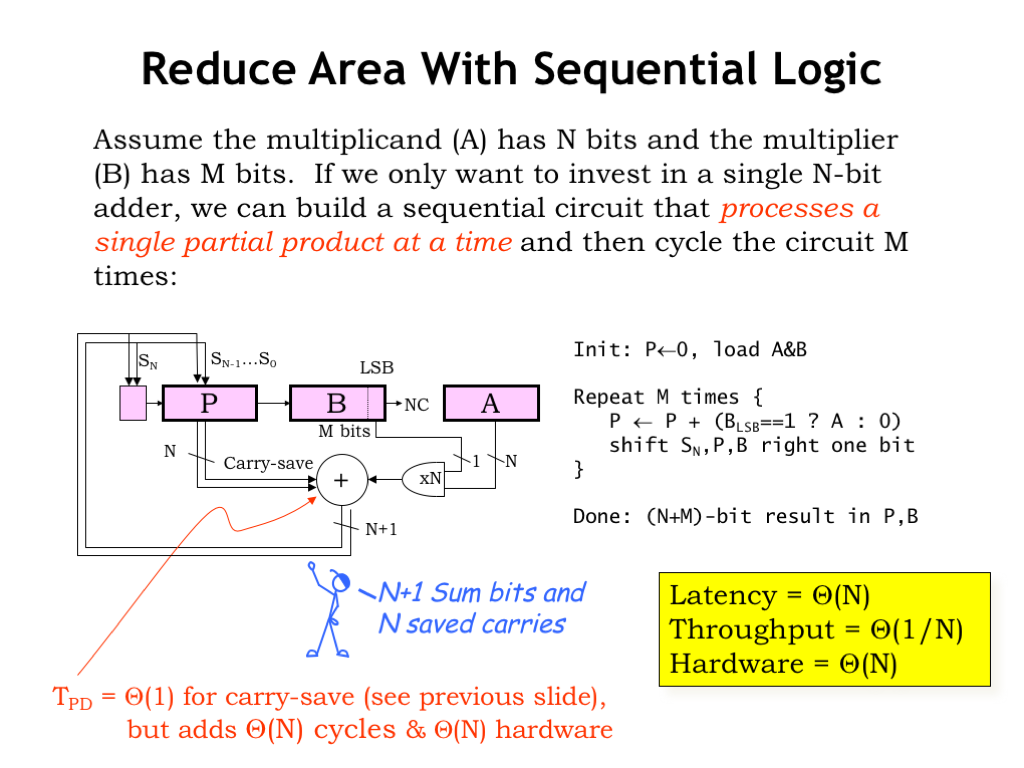
时序乘法器:每拍算一个部分积并累加到 P,共 Θ(N)\Theta(N) 步。B 最低位 × 被乘数 → carry-save 加法器;P 与加法器输出为 carry-save 格式(数据和 + 保存的进位)。每拍 P、B 右移 1——等价于“部分积左移”的对偶。

无完整进位传播 → 时钟周期与 NN 无关(约一个全加器延迟)。再 Θ(N)\Theta(N) 步收尾进位 → 总延迟仍 Θ(N)\Theta(N),吞吐 Θ(1/N)\Theta(1/N),硬件 Θ(N)\Theta(N)(相对组合 Θ(N2)\Theta(N^2) 大降)。Carry-save:可同硬件提吞吐,或同吞吐省面积。

23. 小结(Summary)

Summary

Part 1 收束:信息与编码 → 冗余检错/纠错 → 数字抽象与噪声容限 → MOSFET/CMOS 与组合综合 → 双稳态存储与动态纪律 → FSM 与亚稳态/同步 → 延迟与吞吐 → 本讲功耗与加法/乘法折衷。

设计时可在功耗、延迟 Θ(N)\Theta(N) vs Θ(log⁡N)\Theta(\log N)、吞吐 Θ(1)\Theta(1) vs Θ(1/N)\Theta(1/N)、面积 Θ(N)\Theta(N) vs Θ(N2)\Theta(N^2) 之间按目标选型。

整理自 MIT OCW 6.004 Computation Structures(Spring 2017)L07 注解幻灯片。

源网页:7.1 Annotated Slides | Performance Measures

讲师:Chris Terman。图片直接引用 OCW 原站链接。

L07:性能度量(Performance Measures)

本讲引入电路性能的两个核心指标——延迟(latency)与吞吐(throughput),并用洗衣店类比说明流水线如何用略增延迟换取更高吞吐;随后给出构造良构 K 级流水线(K-pipeline)的系统方法,以及用交错(interleaving)与并行突破瓶颈;最后对比同步全局定时、握手与自定时等控制结构。

1. 先放下电路… 解决一个真实问题(Forget Circuits… Let’s Solve a Real Problem)

Forget Circuits Let's Solve a Real Problem

目标:提出衡量电路性能的指标,并研究如何提升。先放下电路,用日常例子帮助理解这些指标。

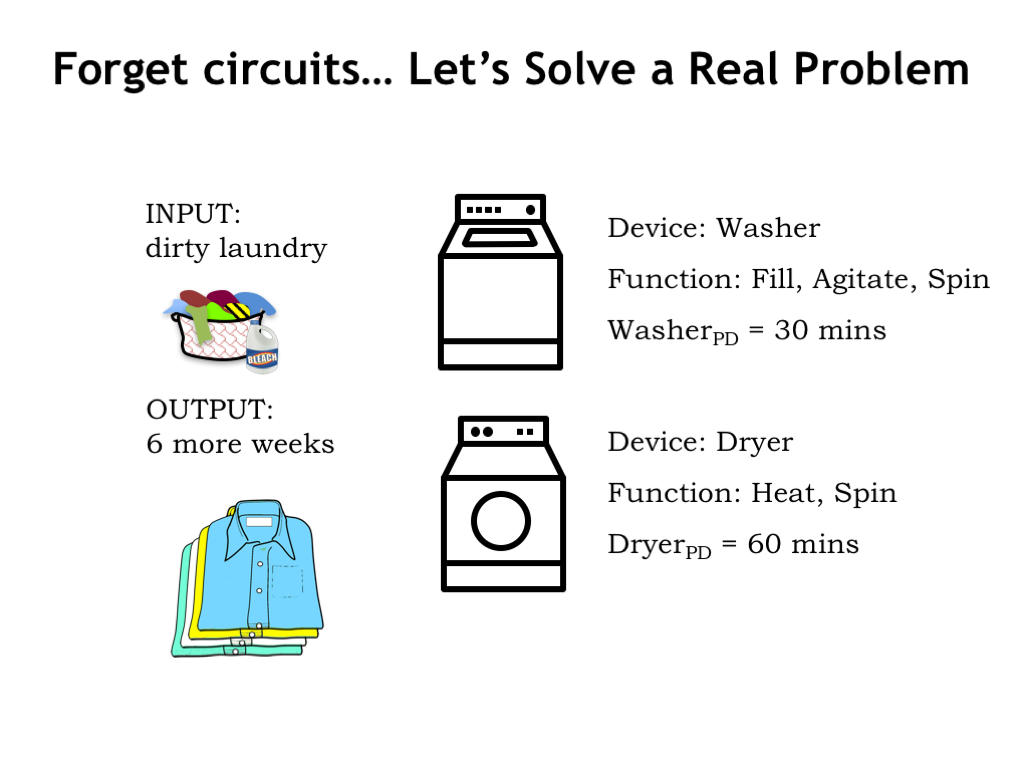
洗衣是人人都会遇到的“处理任务”。系统输入是若干篮脏衣,输出是洗净、烘干并叠好的同批衣物。两个部件:洗衣机 30 分钟洗一篮,烘干机 60 分钟烘一篮。路径简单:先洗后烘;假设尽快推进,一步能走就走下一步。攒多篮再洗往往更划算——下面说明原因。

2. 一次一篮(One Load at a Time)

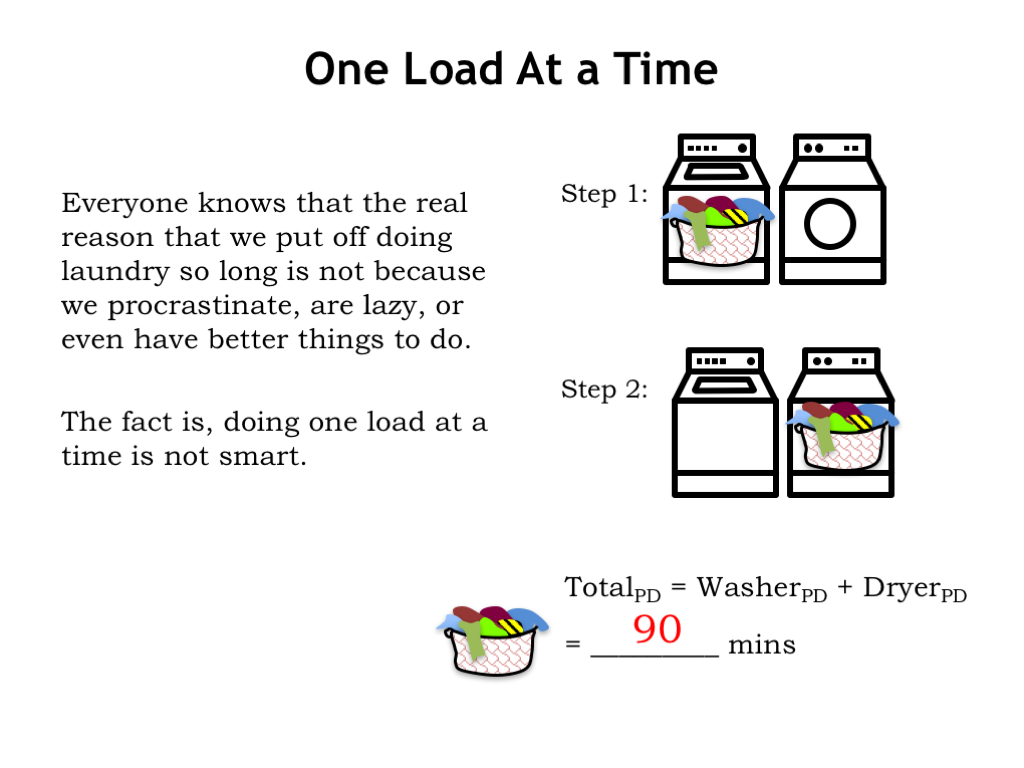
One Load at a Time

单篮:洗 30 分钟 + 烘 60 分钟 = 从输入到输出共 90 分钟。若比作组合逻辑,传播延迟就是 90 分钟。接着考虑 NN 篮。

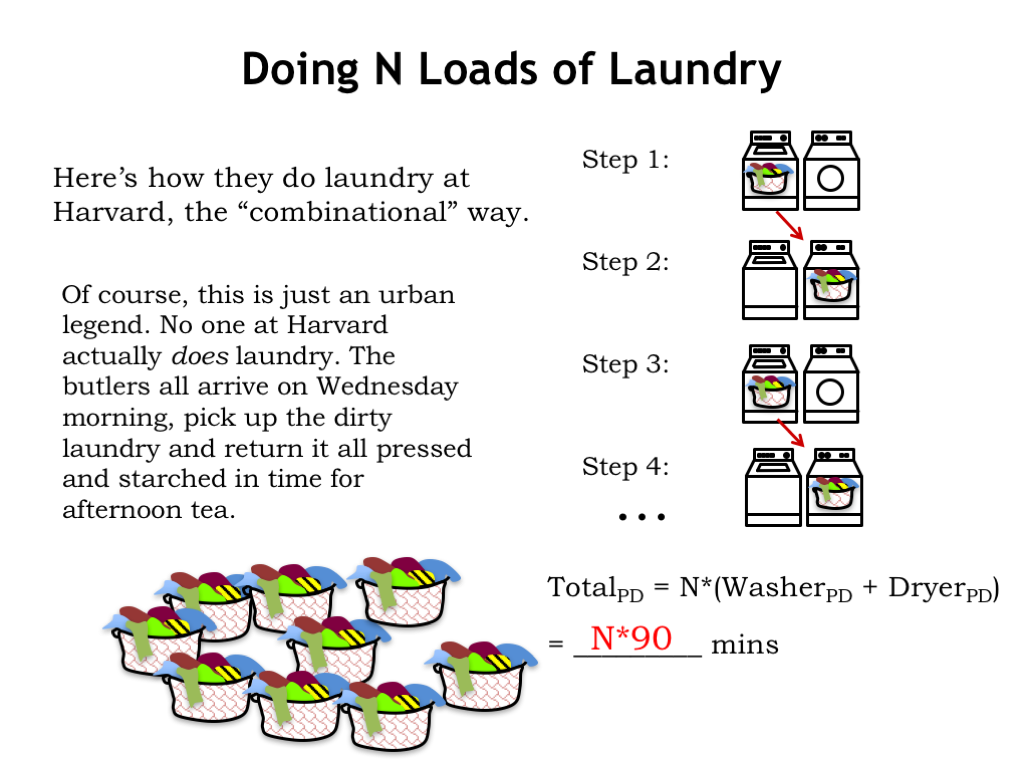
3. 洗 N 篮:哈佛式(Doing N Loads of Laundry)

Doing N Loads of Laundry Harvard way

想象“哈佛式”做法:严格按组合逻辑节奏——上一组输入算完、输出有效后,才喂下一组。步骤 1 洗第一篮,步骤 2 烘第一篮,共 90 分钟;再进入步骤 3 处理第二篮……总时间 N×90N\times 90 分钟。

类比清晰:烘干时洗衣机空闲,吞吐受拖累。

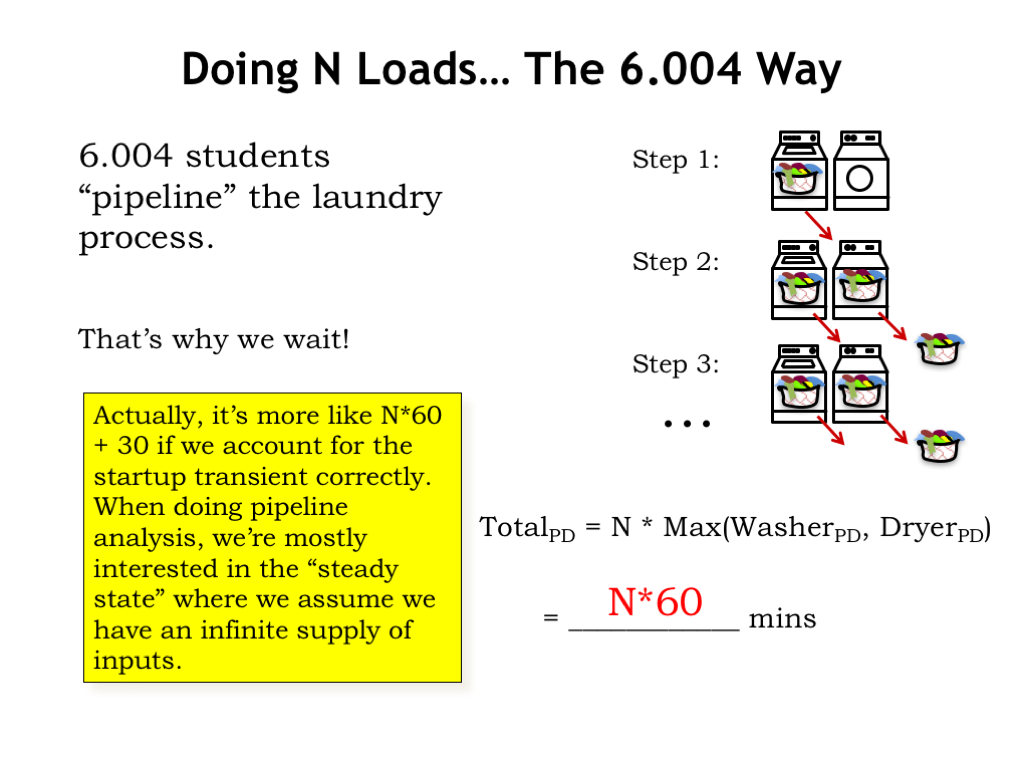
4. 洗 N 篮:6.004 式(Doing N Loads… The 6.004 Way)

Doing N Loads the 6.004 Way

重叠洗与烘:步骤 1 洗第一篮;步骤 2 烘第一篮的同时开始洗第二篮。步骤时长由烘干机决定为 60 分钟;洗衣机虽提早完成,但只有一台烘干机,系统节拍由最慢级决定。

这种重叠处理输入序列的系统叫流水线(pipelined system),每步叫一级(stage)。洗衣是 2 级流水线,每级处理时间 60 分钟。稳态下每 60 分钟开一篮洗、出一篮干——有效吞吐为每 60 分钟一篮;NN 篮约 N×60N\times 60 分钟。某一篮要经两级,约 120 分钟(首篮略不同;流水线性能分析关心有无穷输入的稳态)。

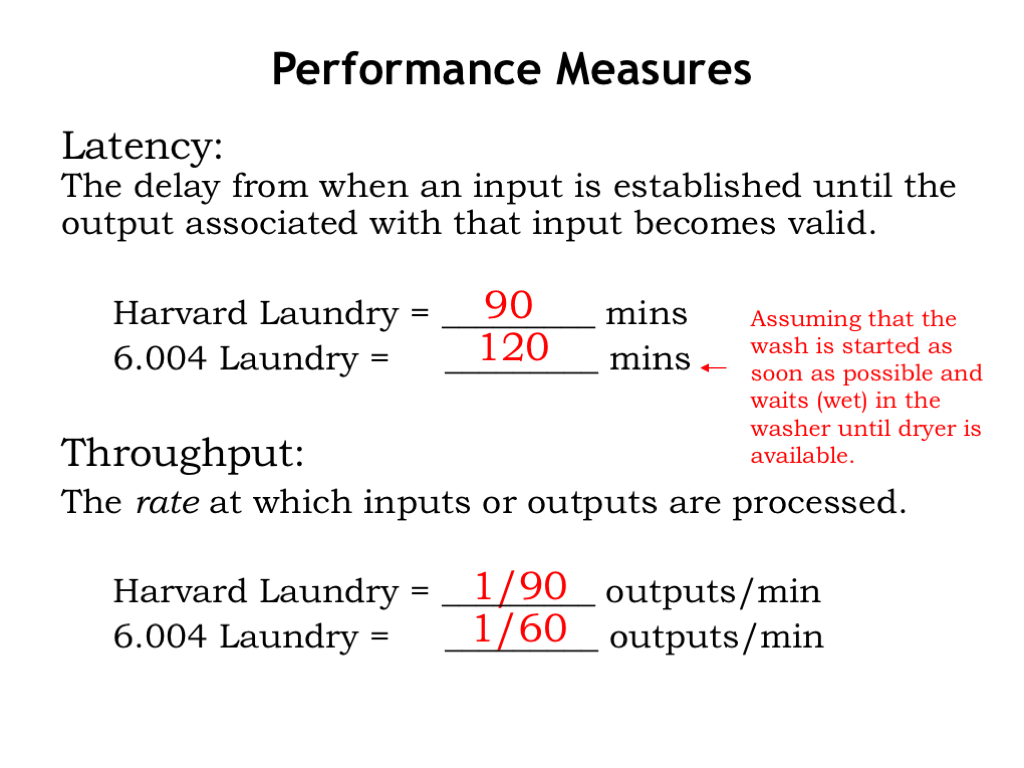
5. 性能度量(Performance Measures)

Performance Measures

两个指标:

指标 含义 哈佛洗衣 6.004 洗衣
延迟(latency) 某一输入从进到出的时间 90 min 120 min(非首篮)
吞吐(throughput) 系统产生输出的速率 每 90 min 一篮 每 60 min 一篮

一入一出系统中,吞吐也等于输入被消耗的速率。哪个更好取决于目标:洗 100 篮要高吞吐;约会前 90 分钟内要干净内衣则更关心延迟。用流水线提吞吐时,各级需锁步,节拍由最慢级决定,延迟通常上升——这是常见的延迟–吞吐权衡。

6. 回到电路(Okay, Back to Circuits…)

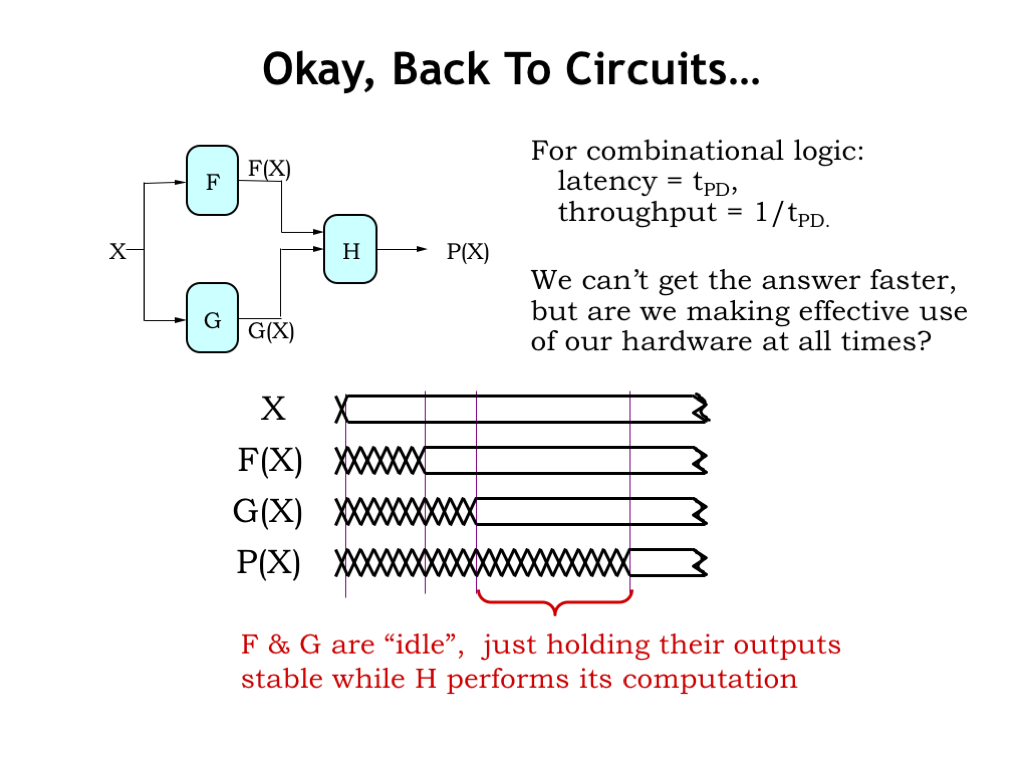
Okay Back to Circuits

组合电路:延迟 =tPD= t_{\mathrm{PD}},吞吐 =1/tPD= 1/t_{\mathrm{PD}}(算完当前才开下一组)。

例:F、G 并行,结果再进 H。输入 XX 稳定后,F、G 出 F(X)F(X)、G(X)G(X),再经 H 的 tPDt_{\mathrm{PD}} 得 P(X)P(X)。模块不变则延迟难再压;但 F、G 出结果后空闲等 H——能否让 F、G 处理下一输入,同时 H 仍在算上一拍?即把电路拆成两级:第一级算 F(X)F(X)、G(X)G(X),第二级算 HH。

7. 流水线电路(Pipelined Circuits)

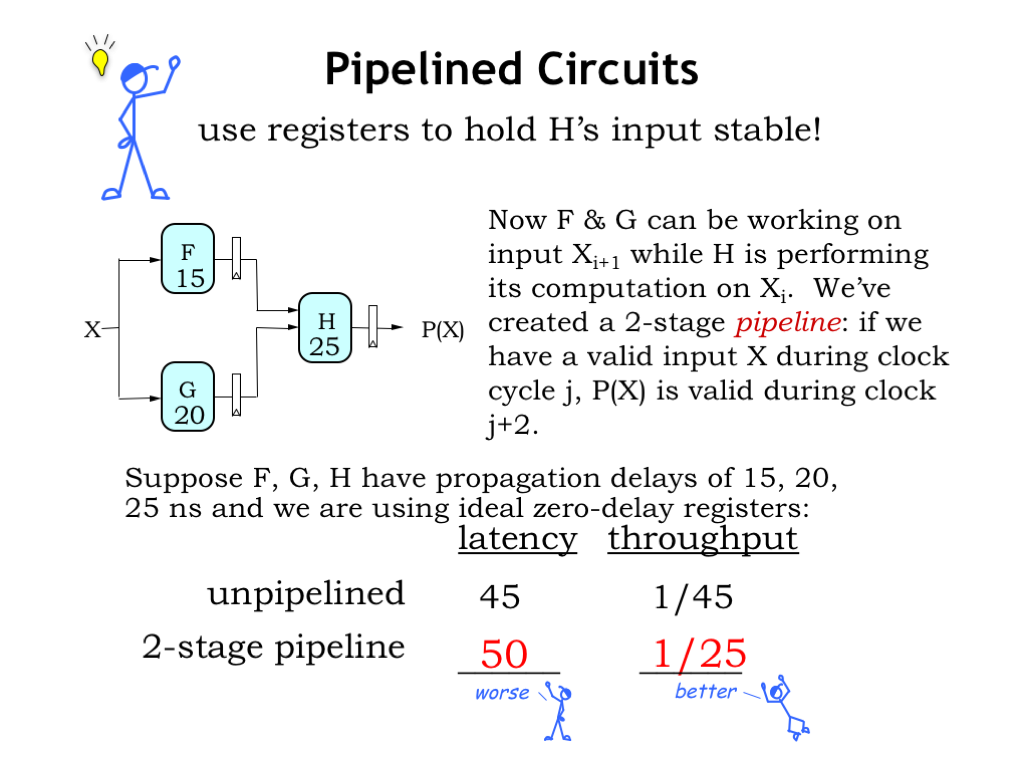
Pipelined Circuits

用寄存器锁住 F(X)F(X)、G(X)G(X) 供 H 使用,同时让 F、G 开下一输入。分析时先假定流水寄存器 tPDt_{\mathrm{PD}}、建立时间为 0。

时钟周期由最慢级决定:含 F、G 的级至少需 20 ns;含 H 的级需 25 ns → 系统 tCLK=25 nst_{\mathrm{CLK}}=25\,\mathrm{ns}。一般做法:寄存器把组合逻辑切成若干级,每拍推进一级。本例 2 级、周期 25 ns → 延迟 50 ns(略高于未流水),吞吐每 25 ns 一个输出——吞吐明显提升,延迟略增。

8. 流水线时序图(Pipeline Diagrams)

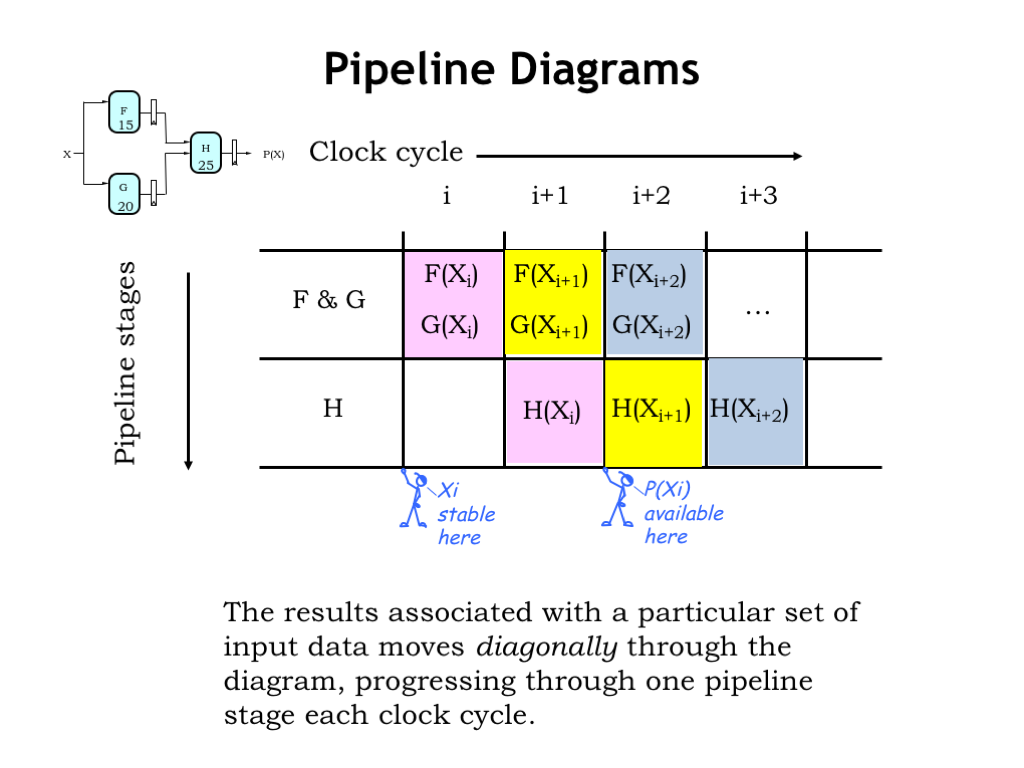
Pipeline Diagrams

行表示各级,列表示连续时钟周期。周期 ii 初输入 XiX_i 有效;该周期内 F、G 处理,ii 末结果写入级间寄存器。周期 i+1i+1 中 H 处理 XiX_i,同时 F、G 处理 Xi+1X_{i+1}。某一输入沿对角线每拍下移一级;i+1i+1 末 H 结果写入末级寄存器,于 i+2i+2 可用。总延迟两拍;之后每拍出一个结果。

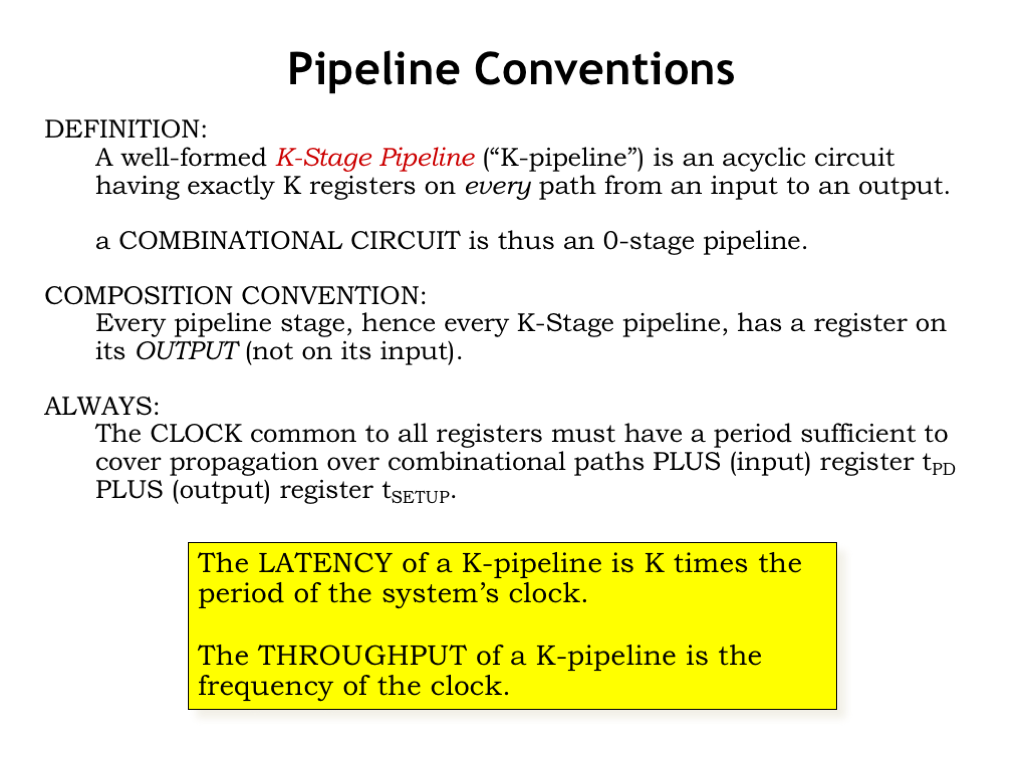
9. 流水线约定(Pipeline Conventions)

Pipeline Conventions

K 级流水线(K-pipeline):无环电路,从输入到输出每条路径恰有 K 个寄存器。未流水的组合电路是 0 级流水线。

约定:每一级(因而每个 K-pipeline)在输出端有寄存器,便于把流水部件拼成更大流水系统。用时序电路计时方法:对每条寄存器→寄存器、输入→寄存器路径,求输入寄存器 tPDt_{\mathrm{PD}} + 组合 tPDt_{\mathrm{PD}} + 输出寄存器建立时间,取最大者作为 tCLKt_{\mathrm{CLK}} 下界。时钟正确且每条路径恰 K 个寄存器时,K-pipeline 与原组合电路功能等价。

  • 延迟:K⋅tCLKK\cdot t_{\mathrm{CLK}}
  • 吞吐:1/tCLK1/t_{\mathrm{CLK}}

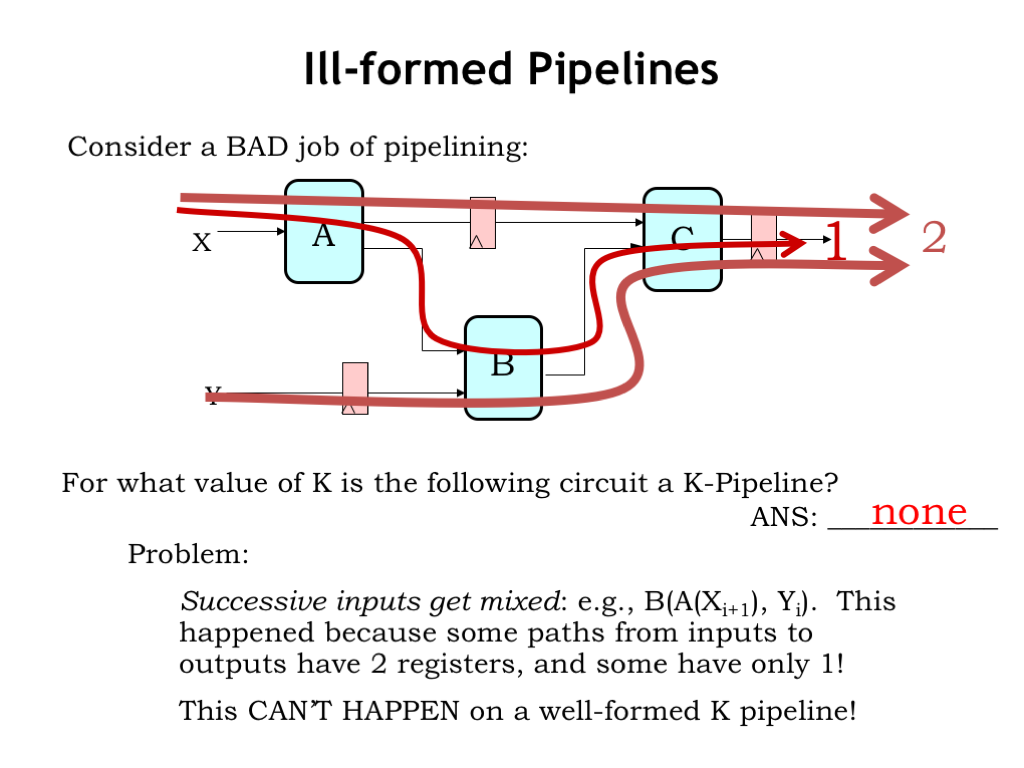
10. 病态流水线(Ill-Formed Pipelines)

Ill-Formed Pipelines

反例:经 A、C 的上路径 2 个寄存器,经 B、C 的下路径 2 个,经 A、B、C 的中路径只有 1 个——不是良构 K-pipeline。后果:不同“代”的输入混算(如周期 i+1i+1 中 B 用当前 XX 与上一拍 YY),结果与未流水电路不同。需要一种方法:在一条路径加寄存器时,保证所有路径同步加。

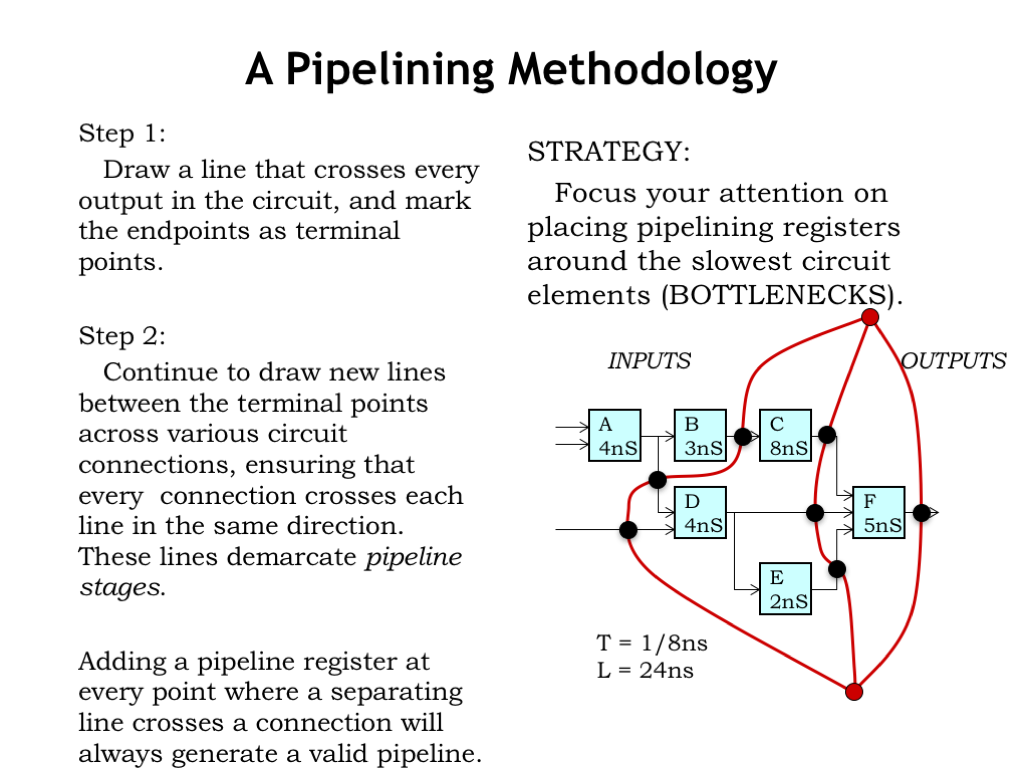
11. 流水线方法论(A Pipelining Methodology)

A Pipelining Methodology

步骤:

  1. 画一条穿过所有输出的等高线,两端记为后续等高线的端点。
  2. 继续在模块间信号上画等高线,两端仍落在同一对端点;每条信号同向穿越等高线(输入一侧、输出另一侧)。等高线划分流水级。
  3. 在信号与等高线交点放置流水寄存器。

端点到端点保证每条输入–输出路径都被穿过 → 良构。再找最长寄存器→寄存器或输入→寄存器延迟定 tCLKt_{\mathrm{CLK}}。例:理想零延迟寄存器时,C 模块要求 8 ns → 吞吐每 8 ns 一个;3 条等高线 → 3-pipeline,延迟 3×8=24 ns3\times 8=24\,\mathrm{ns}。

通常目标:用尽量少的寄存器达到最大吞吐——找出最慢部件(如 C),在其输入输出两侧画等高线,把 tCLKt_{\mathrm{CLK}} 钉在该延迟,再布置其余等高线使级间最长路径不超过此时钟。同吞吐/延迟下画法可有多种(如 E 可与 F 同级)。

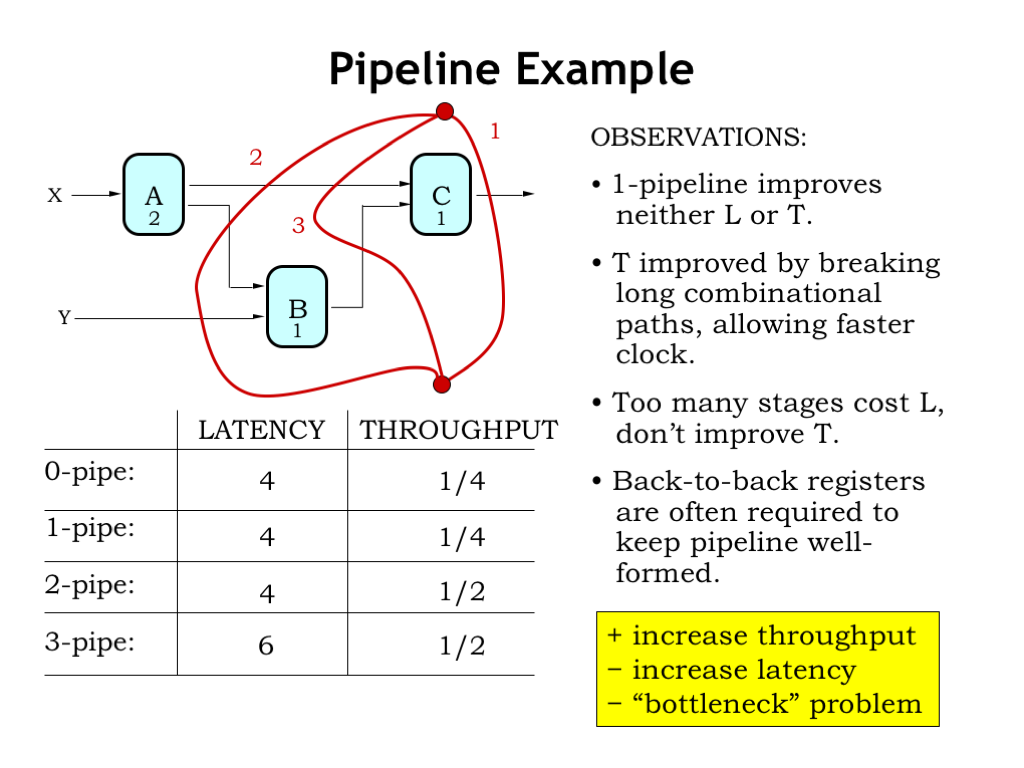
12. 流水线示例(Pipeline Example)

Pipeline Example

复习:先过全部输出 → 1-pipeline,吞吐/延迟与原组合相同。再画线隔离最慢件 → 2-pipeline,tCLK=2t_{\mathrm{CLK}}=2,吞吐翻倍。再加等高线只会加级数、增延迟,不提吞吐(合法但不划算)。路径长短不一时会出现背靠背寄存器,正常。

策略:流水通常提吞吐、增延迟;各级完美平衡时延迟可不增。流水电路的延迟不会低于未流水电路。隔离最慢件后吞吐无法再靠加级提升——瓶颈在该部件本身。

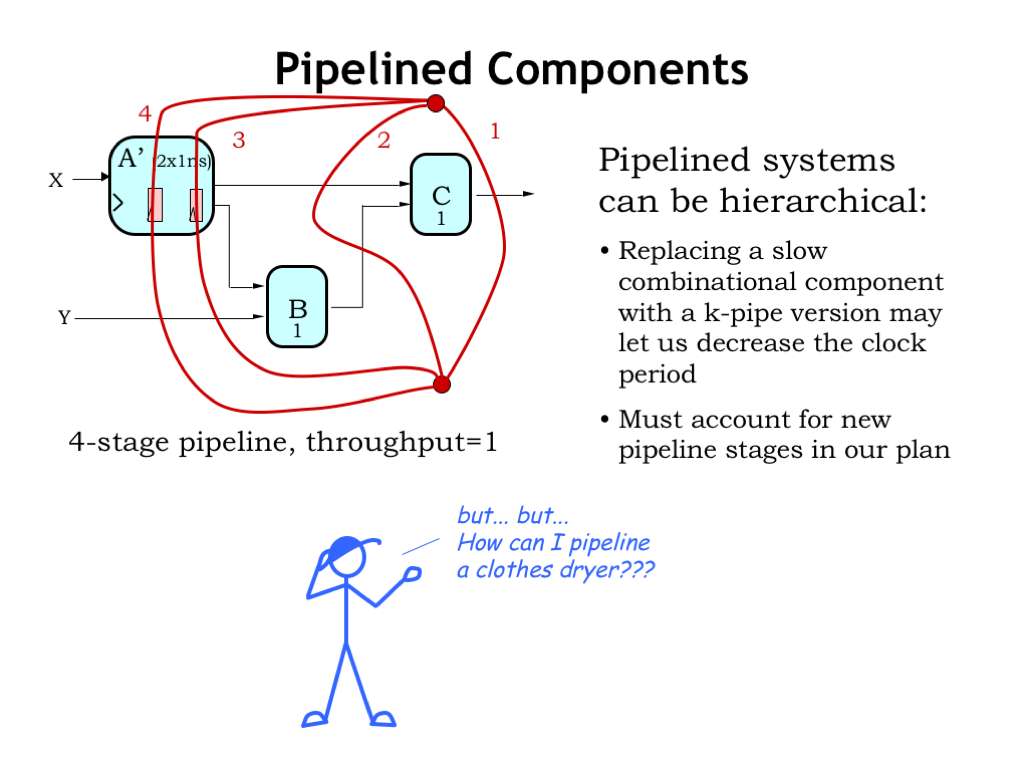
13. 流水线部件(Pipelined Components)

Pipelined Components

若有流水版部件可用:把 A 换成 2 级流水的 A′,重画等高线时须让 2 条等高线穿过 A′(计入内部寄存器),从而在系统其余处补上对齐两拍延迟的寄存器。例中各级最大 tPDt_{\mathrm{PD}} 降到 1 ns,吞吐从 1/21/2 升到 1/11/1;4-pipeline,延迟 4 ns。若瓶颈无流水替代品,见下一节。

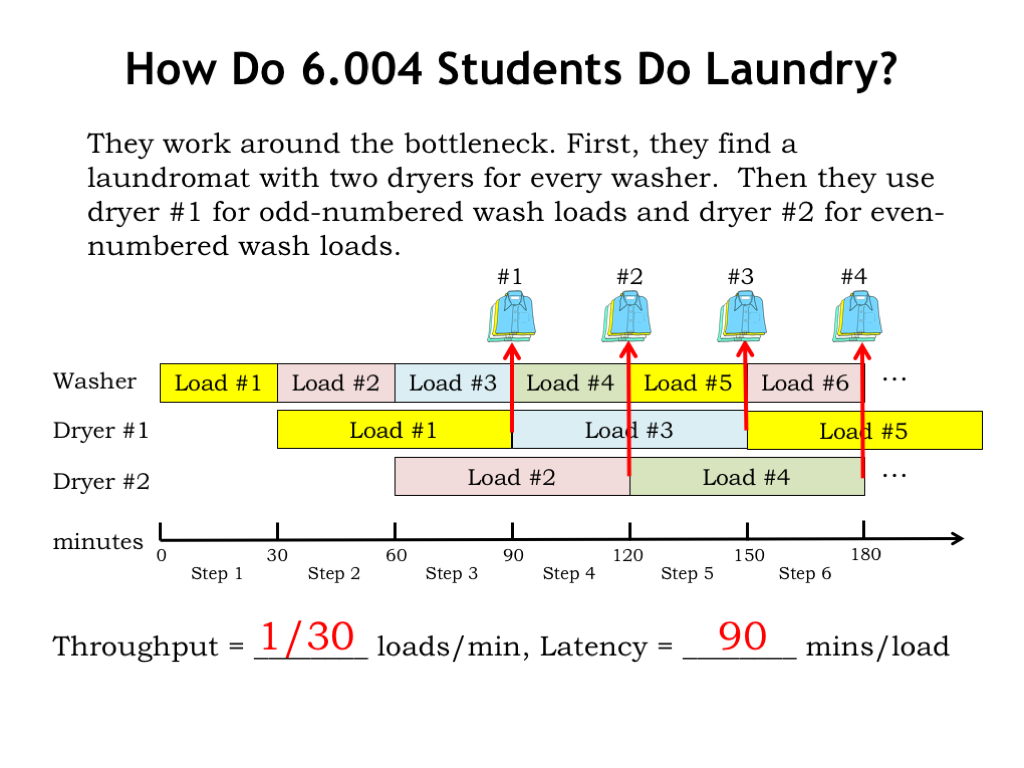
14. 6.004 学生怎么洗衣?(How Do 6.004 Students Do Laundry?)

How Do 6.004 Students Do Laundry

绕过烘干机瓶颈:找“一台洗衣机配两台烘干机”的店。时间轴按 30 分钟一步:洗衣机每步都在用,每 30 分钟出一篮湿衣;烘干机交错——#1 烘奇数篮、#2 烘偶数篮,各烘两步(60 分钟)。整体每 30 分钟出一篮干净干衣。稳态吞吐每 30 分钟一篮,单篮延迟仍 90 分钟。

要点:烘干机本身未流水,但两台交错表现得像周期 30 分钟、延迟 60 分钟的 2 级流水线——用两份未流水部件交错,可等效 2 级流水。

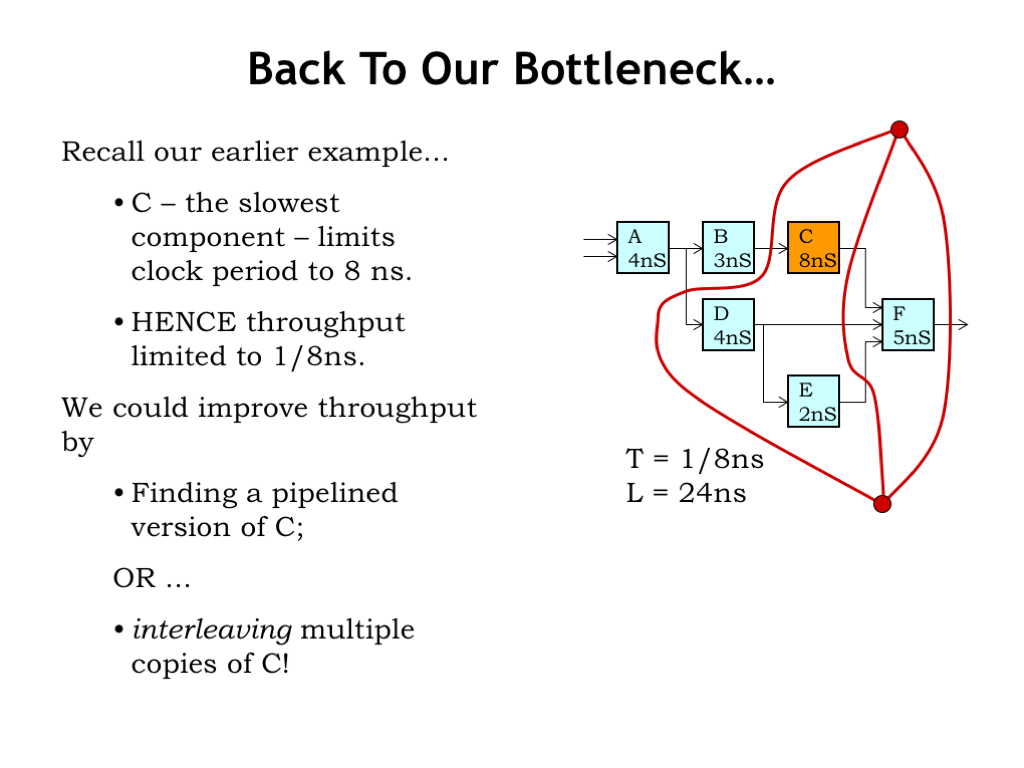
15. 回到瓶颈(Back to Our Bottleneck…)

Back to Our Bottleneck

前例吞吐卡在 1/8 ns1/8\,\mathrm{ns}(C 的 8 ns 延迟定最小时钟)。要再提吞吐:要么找 C 的流水版,要么用两份未流水 C 做交错等效 2 级流水。

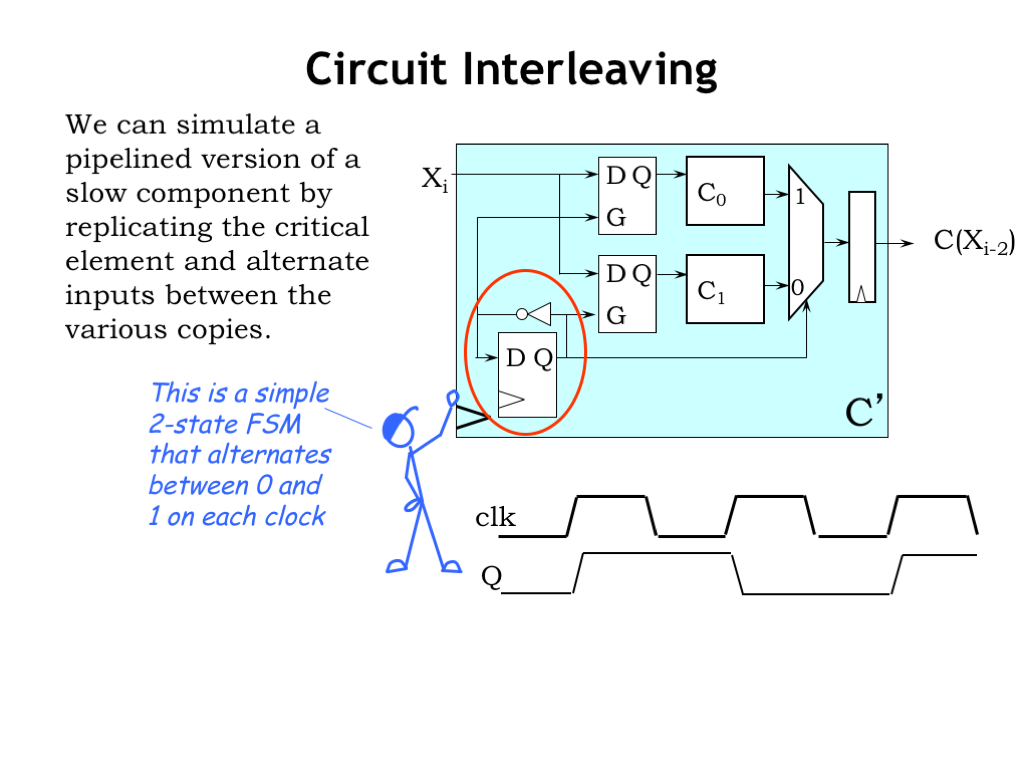
16. 电路交错 I(Circuit Interleaving I)

Circuit Interleaving I

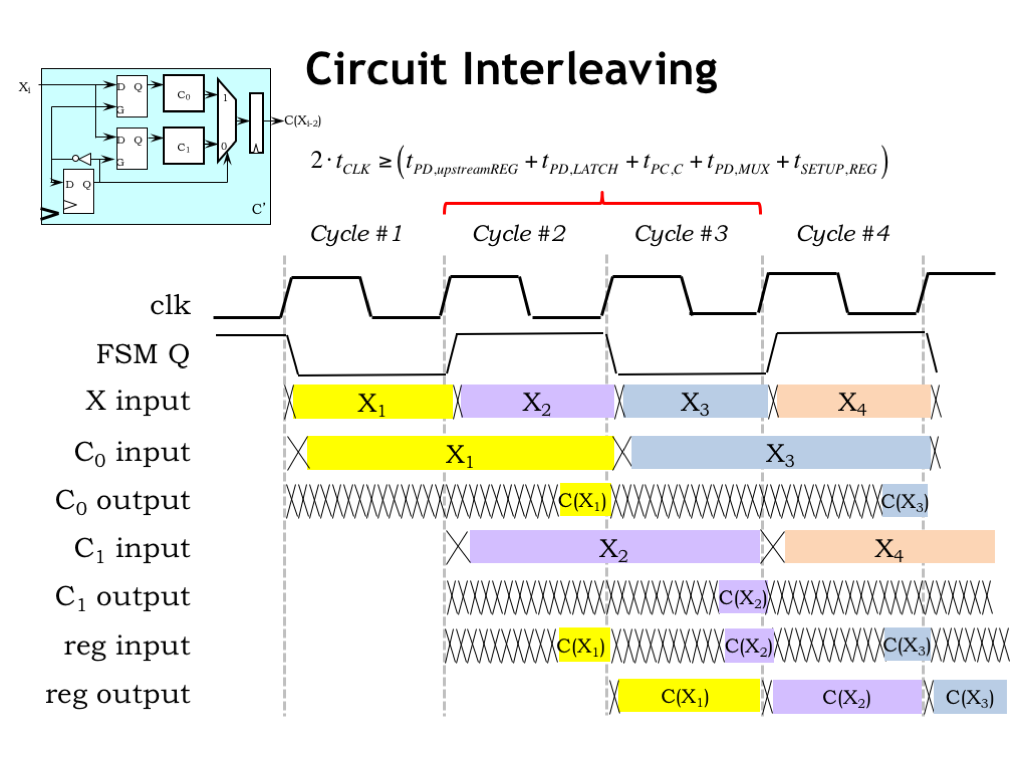
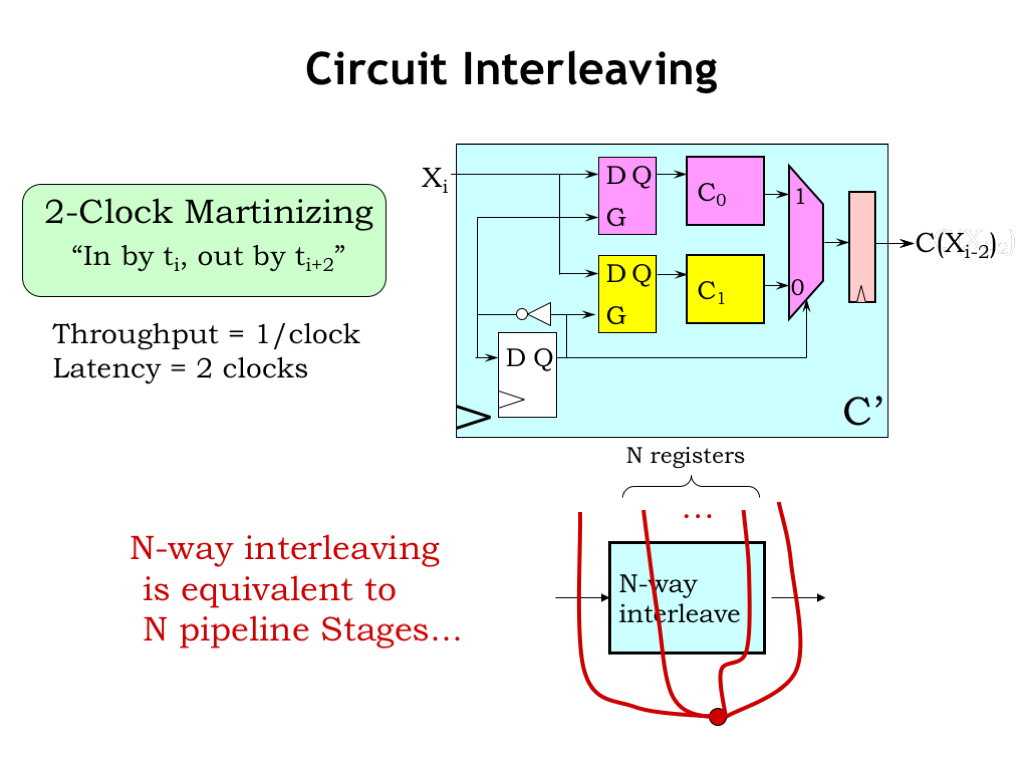
通用双路交错:两份 C(C0C_0、C1C_1)。各输入来自 D 锁存器(捕获并保持输入);MUX 选哪路 C 输出写入输出寄存器。左下角极简 2 状态 FSM:下一状态为单反相器,状态在 0/1 间交替;状态位在上升沿后翻转。

17. 电路交错 II(Circuit Interleaving II)

Circuit Interleaving II

波形:新 XX 在时钟上升沿后到达。FSM QQ 为低时 C0C_0 输入锁存打开,X1X_1 进入,C0C_0 在约第 2 拍末出结果;第 2 拍初锁存关闭,保持 X1X_1 稳定,使 C0C_0 有近两拍时间计算。C1C_1 类似,错开一拍。MUX:QQ 高选 C0C_0,低选 C1C_1;上升沿时输出寄存器采样。行为像 2 级流水:周期 ii 到达的输入经两拍,于 i+2i+2 可用。

18. 电路交错 III(Circuit Interleaving III)

Circuit Interleaving III

时钟周期:上游流水寄存器、内部锁存与 MUX 的传播延迟,以及输出寄存器建立时间,使 tCLKt_{\mathrm{CLK}} 须略大于 C 的 tPD/2t_{\mathrm{PD}}/2。可把交错电路当作 2 级流水:每拍吃一个输入,两拍后出结果。

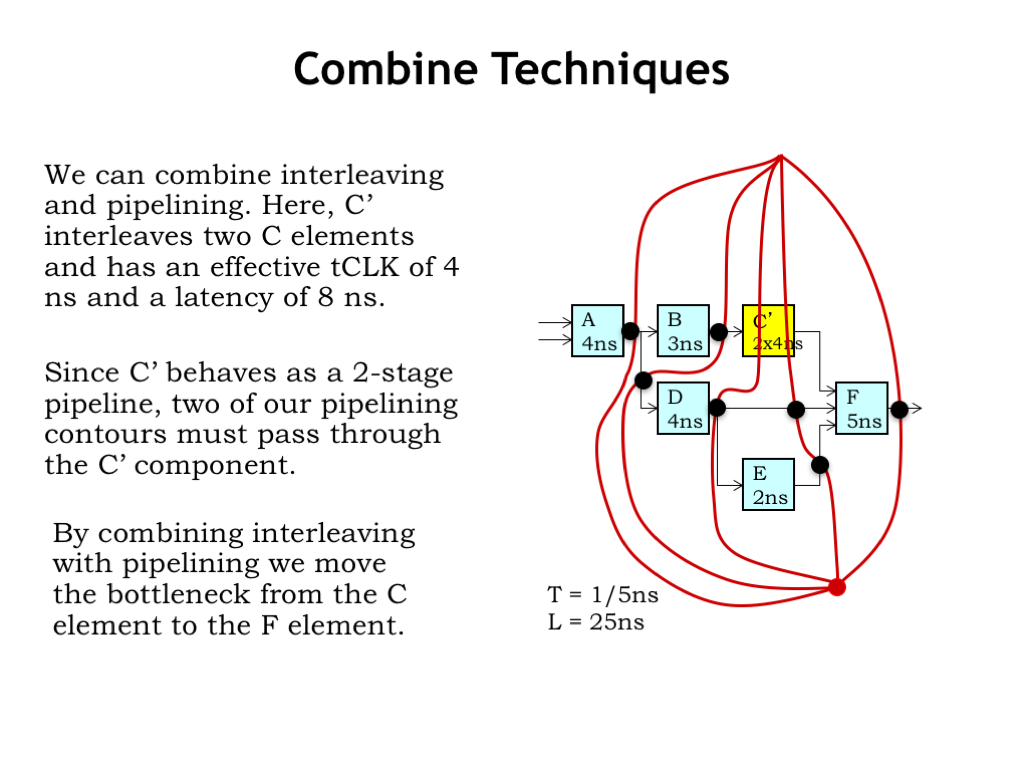
19. 组合技巧(Combine Techniques)

Combine Techniques

在流水图中,N 路交错部件当作 N 级流水,须有 N 条等高线穿过它。用 2 路交错的 C′ 替换慢 C:先过全部输出,再保证两条等高线穿过 C′,在交点加寄存器——穿过 C′ 的等高线会在 F 的其他输入上多加寄存器,以匹配 C′ 的两拍延迟。乐观设 C′ 最小 tCLK=4 nst_{\mathrm{CLK}}=4\,\mathrm{ns},则系统时钟由 F 的 5 ns 决定 → 吞吐每 5 ns 一个;5 条等高线 → 5-pipeline,延迟 5×5=25 ns5\times 5=25\,\mathrm{ns}。

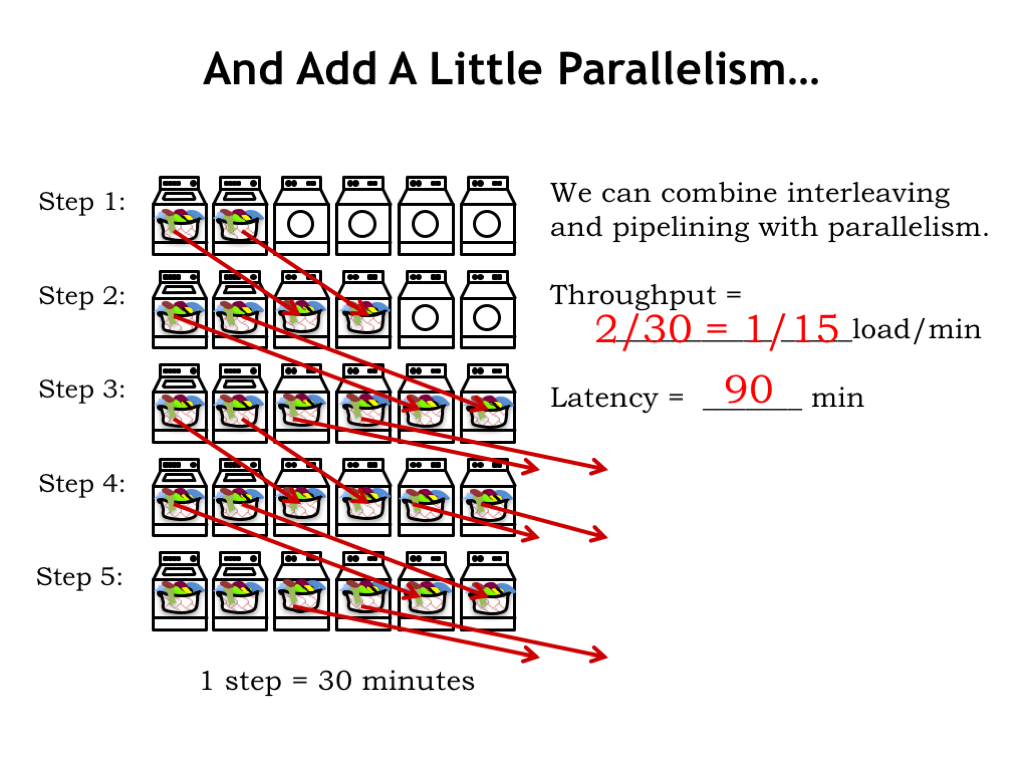
20. 再加一点并行(And Add a Little Parallelism…)

And Add a Little Parallelism

流水系统再并行:两台洗衣机 + 四台烘干机 ≈ 两份“1 洗 2 烘”。每步消耗/产出两篮 → 吞吐 2 篮 / 30 min,等效每 15 分钟一篮;单篮延迟仍 90 分钟。

即便部件慢,也可靠交错与并行继续提吞吐。上界存在:流水寄存器与交错逻辑的时序开销给出最小可行 tCLKt_{\mathrm{CLK}},从而限制最大吞吐——现实世界没有无限加速。

21. 控制结构备选(Control Structure Alternatives)

Control Structure Alternatives

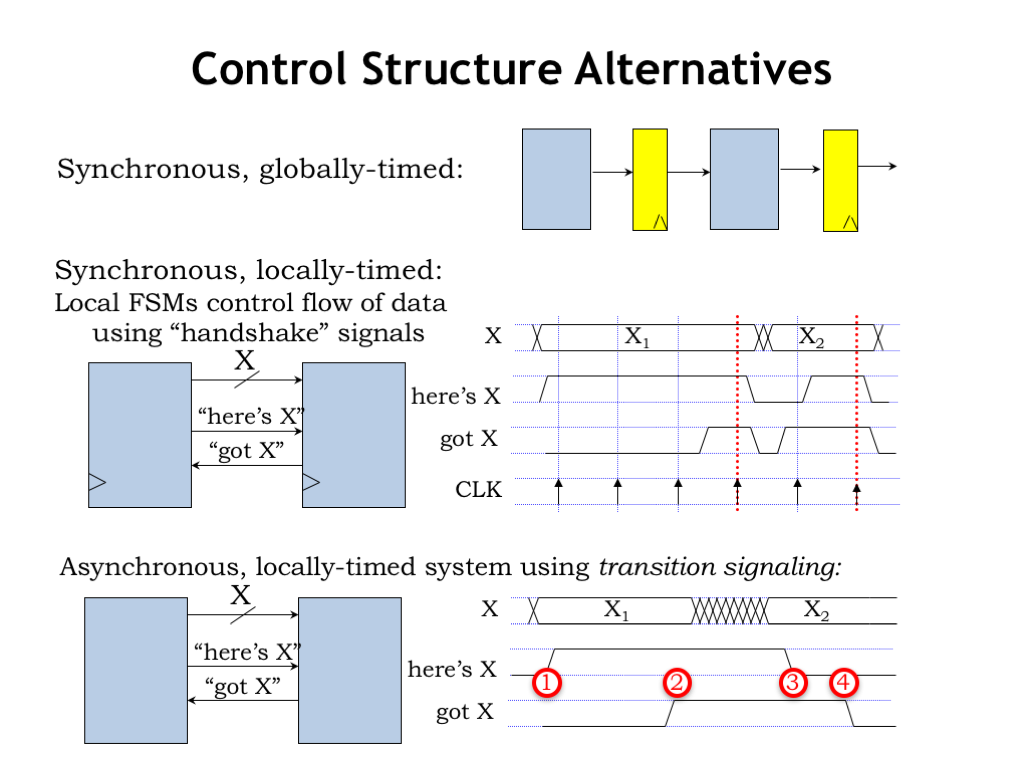
此前流水各级锁步,时钟按各级最坏情况选取——同步、全局定时系统。

若处理时间有数据相关性(某些输入某级可更快)?一种做法:仍用单一系统时钟,但各级用握手表明“准备好要新输入 / 有新输出给下级”。两信号协议:上游 HERE-IS-X 表示下一上升沿将有新数据;下游 GOT-X 表示愿意在上升沿取数。仅在上升沿检查信号:两边同时看到两者为真则握手完成、该沿完成传输;任一方仍在忙可推迟。

也可做无全局时钟的异步自定时:四相握手——(1) 上游有新输出且 GOT-X 已撤时断言 HERE-IS-X;(2) 下游消费后断言 GOT-X;(3) 下游等 HERE-IS-X 变低;(4) 下游撤 GOT-X,准备下一轮。时序由握手边沿决定,无需全局时钟。

22. 自定时示例(Self-Timed Example)

Self-Timed Example

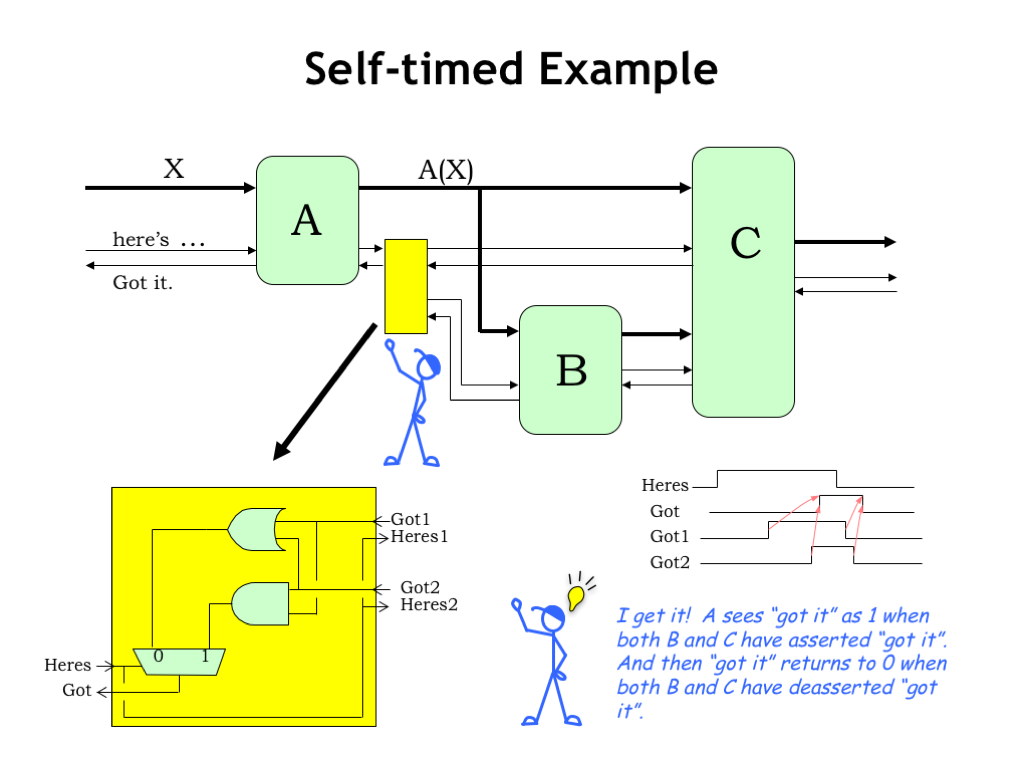
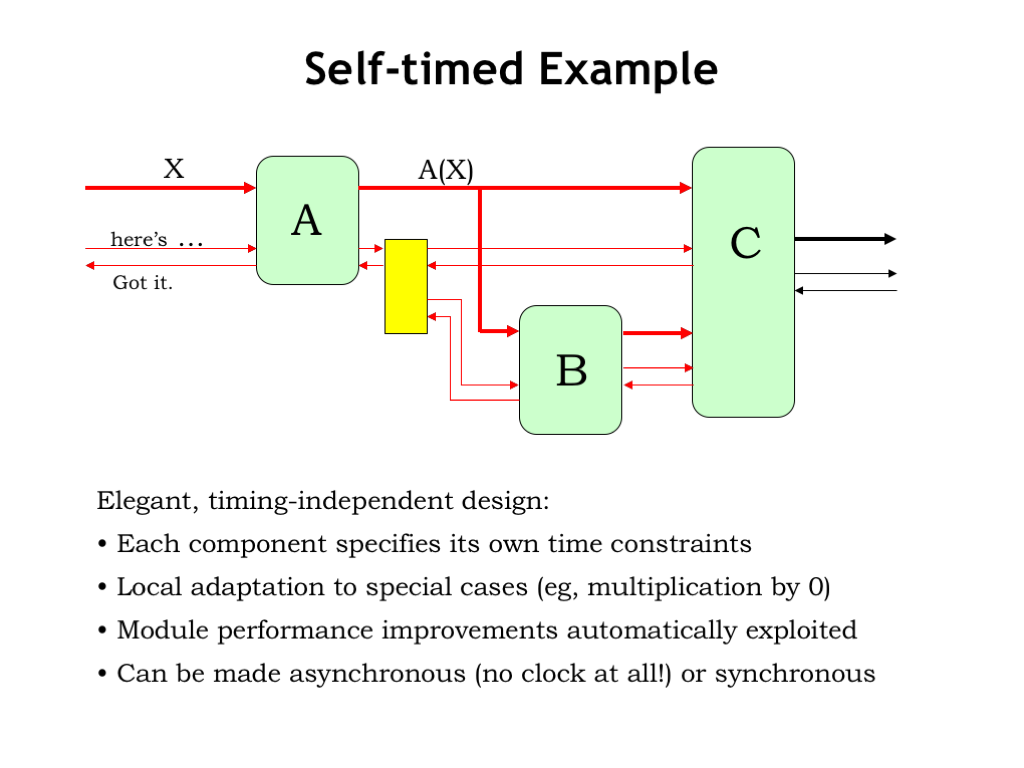
多下游时:A 的输出同时给 B、C。黄色组合块合并 B、C 的 GOT-X,汇总给 A——两边都断言 GOT-X 后才向 A 断言;两边都撤消后才向 A 撤消。

23. 自定时示例(续)(Self-Timed Example continued)

Self-Timed Example continued

动画式时序:上游向 A 传输入 → A 回 GOT-X → 完成四相。A 向 B、C 发 HERE-IS-X;B 先就绪断言 GOT-X,C 尚等第二输入。B 算完再给 C 第二输入;C 两边都收到后断言,黄盒才让 A 知道传输完成。整系统纯靠翻转信令:各模块自主决定消费/产出时刻,可按实际速度跑,而不必等全局最坏延迟。

24. 控制结构分类(Control Structure Taxonomy)

Control Structure Taxonomy
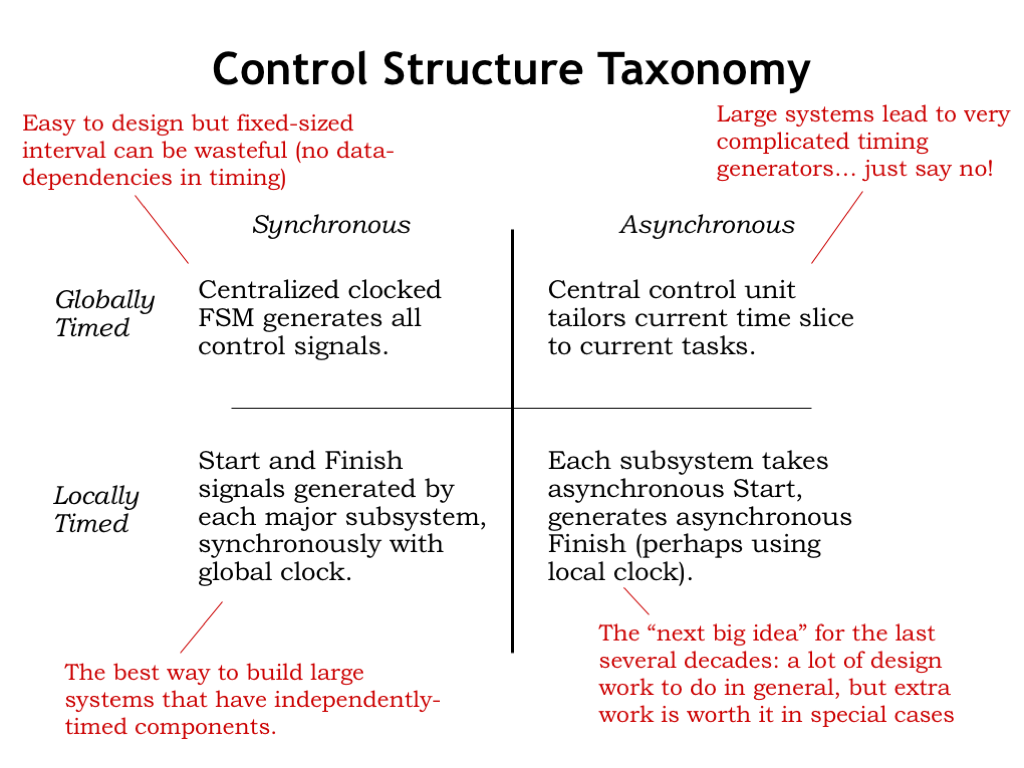
方式 特点
同步全局定时 时钟按最坏情况;易设计;无法利用数据相关加速
同步 + 握手 仍在时钟上升沿通信;具体哪一拍传输由级间握手决定
调节全局时钟 理论上可跟数据相关提速;大系统定时器极复杂,通常不如局部通信
局部定时异步 每代工程师都会被吸引;大系统(如现代 CPU)难做出可证明可靠的设计;特殊场景(如整数除法)数据相关加速值得额外投入

25. 小结(Summary)

Summary
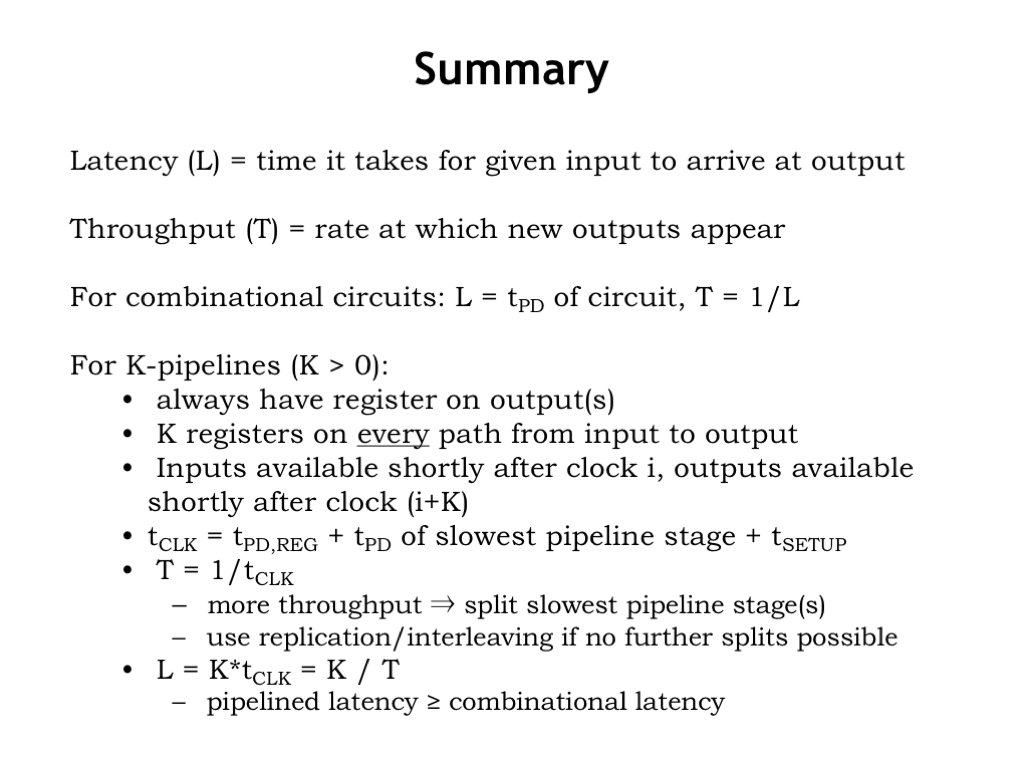
  • 用延迟与吞吐刻画性能;组合电路延迟 =tPD= t_{\mathrm{PD}},吞吐 =1/latency= 1/\text{latency}。
  • K-pipeline:每级输出有寄存器;输入到输出每条路径恰 K 个寄存器;tCLKt_{\mathrm{CLK}} 由最慢级决定;吞吐 =1/tCLK= 1/t_{\mathrm{CLK}},延迟 =K tCLK= K\, t_{\mathrm{CLK}}。
  • 流水线是多数高性能数字系统提升吞吐的关键;交错与并行可在慢部件存在时继续推高吞吐,但受寄存器/交错开销限制。

整理自 MIT OCW 6.004 Computation Structures(Spring 2017)L06 注解幻灯片。

源网页:6.1 Annotated Slides | Finite State Machines

讲师:Chris Terman。图片直接引用 OCW 原站链接。

L06:有限状态机(Finite State Machines)

本讲在时序逻辑之上引入 FSM 抽象:状态转移图、Moore/Mealy、ROM/门级实现、等价状态化简,以及异步输入与亚稳态、同步器隔离策略。

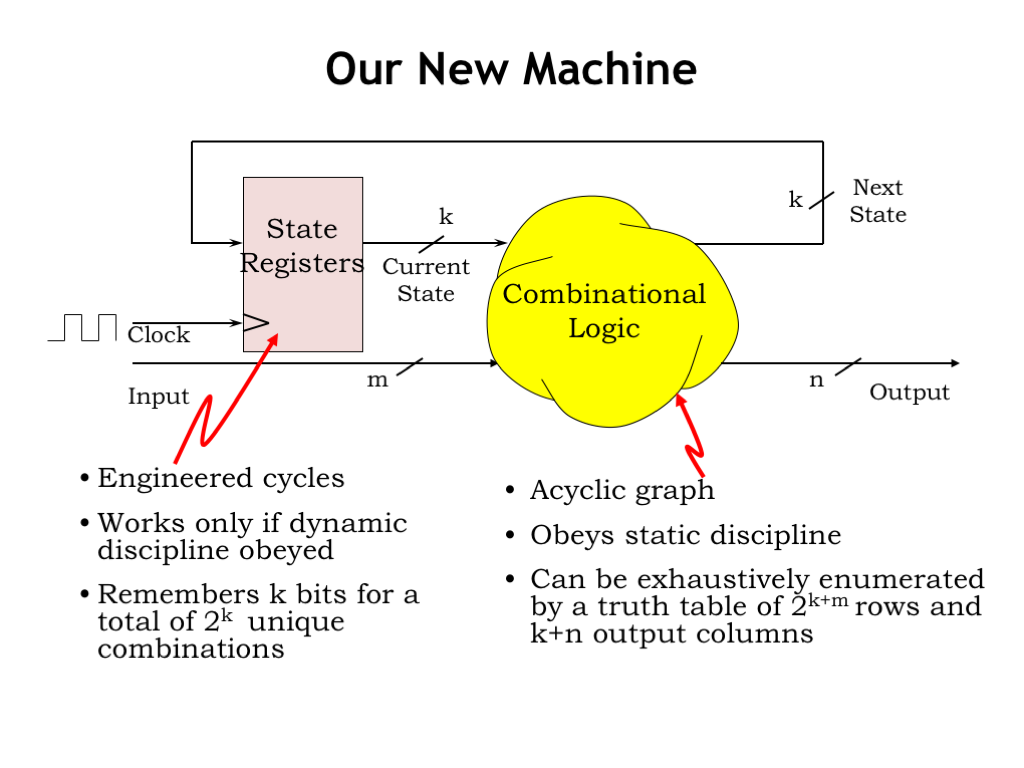
1. 我们的新机器(Our New Machine)

Our New Machine

上一章得到时序逻辑:组合逻辑云 + 状态寄存器。

  • 组合逻辑:无环图,服从静态纪律——合法且稳定的数字输入 → 在最后一次输入跳变后的规定时间内得到合法且稳定的数字输出;功能规格给出每种输入组合的输出。图中有 k+mk+m 个输入、k+nk+n 个输出(kk 位指代 Next State, nn 位指代 Output),真值表有 2k+m2^{k+m} 行、k+nk+n 列输出。
  • 状态寄存器:记住当前状态,用 kk 比特编码,最多 2k2^k 个互异状态。状态以合适方式捕获输入序列中相关历史;过去输入若影响后续行为,正是通过这些状态比特。典型地,周期时钟上升沿触发 LOAD,把组合逻辑算出的新状态写入寄存器。

设计任务:决定期望输入序列应对应怎样的输出序列(一次输入可能引出一长串输出,或输出暂不变、靠内部状态逐步记住信息)→ 写出计算输出与下一状态的功能规格 → 画出实际电路。

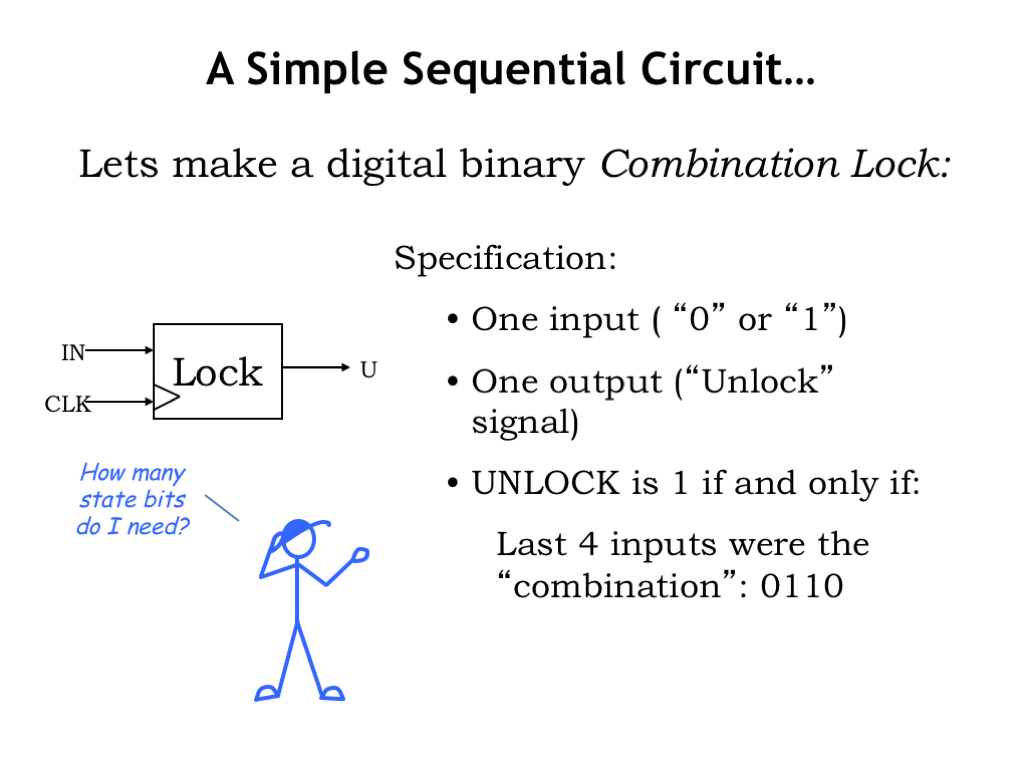
2. 一个简单的时序电路(A Simple Sequential Circuit)

A Simple Sequential Circuit

例:密码锁。1 比特输入按位串入口令;输出 UNLOCK 仅当最近四位输入为 0-1-1-0 时为 1。

是否必须记住最近四位(4 个状态比特)?不必。只需知道“最近输入是否构成正确口令的某个前缀”——输入不对时,不必记录“错成什么样”,只需知道“不对”。由此引入描述时序行为的抽象。

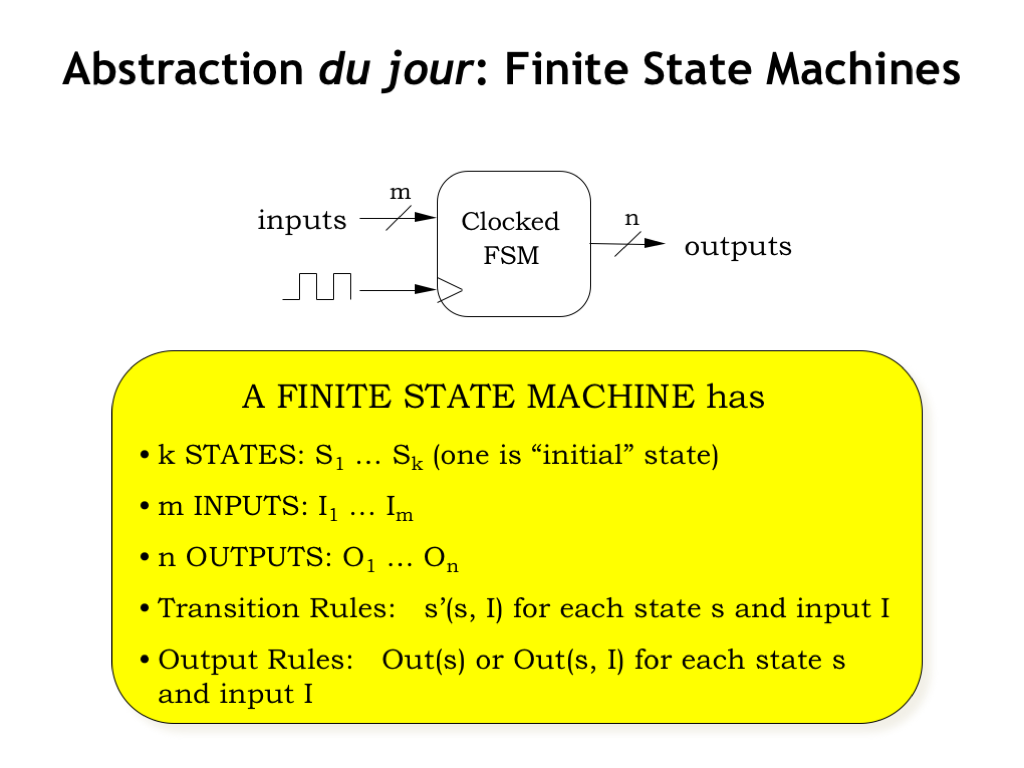
3. 今日抽象:有限状态机(Abstraction du jour: Finite State Machines)

Finite State Machines

FSM 描述时序逻辑的输入/输出行为,与具体实现无关。要素:

  • 周期 CLOCK:上升沿触发当前状态 → 下一状态
  • 有限个状态,上电有一个初始/起始状态。状态数本身是设计题:状态比特数与计算下一状态/输出的组合逻辑复杂度常有折衷
  • 输入:传送外部信息。100 比特信息可一次并行送入,也可单线串行 100 拍——时序逻辑远快于被控物理过程时,常选比特串行以省互连,代价是传输时间
  • 输出:同理可串行/并行编码
  • 转移规则:由当前状态 SS 与输入 II 定下一状态 S′S',须对所有 S,IS,I 组合穷尽
  • 输出规则:常可仅是 SS 的函数(更简单);一般也可是 SS 与当前输入的函数

4. 状态转移图(State Transition Diagram)

State Transition Diagram

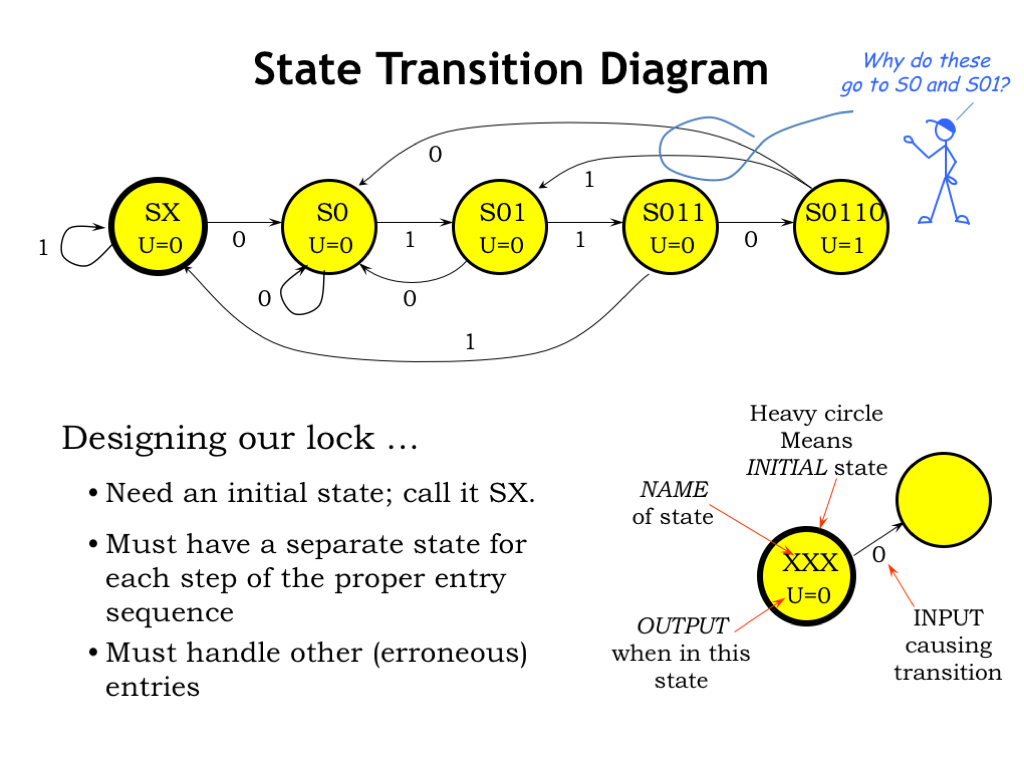
用状态转移图描述密码锁 FSM。初始状态 SX:尚未收到任何口令位;圆圈表示状态,符号名提醒“记住了什么历史”。本例解锁输出 UU 仅依赖当前状态,写在圆内;SX 中 U=0U=0。初始态用粗边框标出。

收到 0 → 转到 S0(已见口令首位)。箭头标转移条件;时钟上升沿触发转移。继续补全正确口令路径,最右态 S0110 表示已检出 0-1-1-0,U=1U=1。从 SX 输入 0-1-1-0 会停在 S0110。

输入不是期望下一位时:例如 SX 收到 1,仍无正确前缀,留在 SX。错误输入不一定回到 SX——若在 S0110 再收 1,最近四位变成 1-1-0-1,但末两位 0-1 可能是合法口令前缀,故转到 S01。

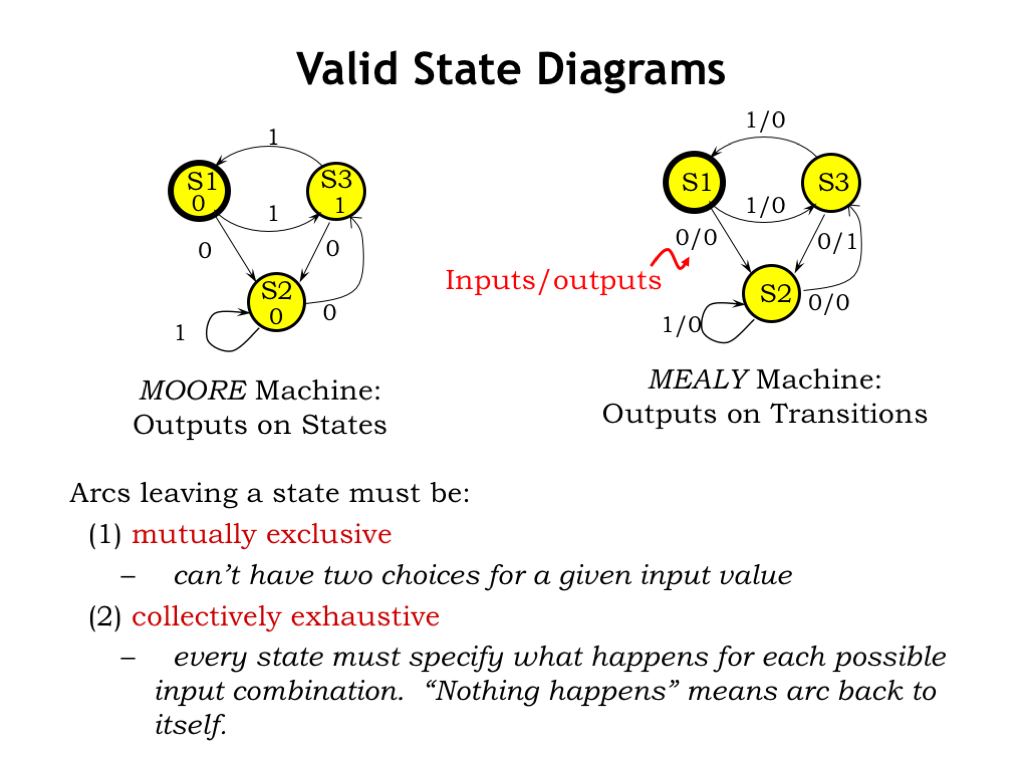
输出仅是当前状态的函数 → Moore 机(输出写在状态圆内)。输出还依赖当前输入 → Mealy 机:转移箭头上用 / 分隔输入与输出,如 0/1。

5. 合法的状态图(Valid State Diagrams)

Valid State Diagrams

良构规则:

  • 互斥(mutually exclusive):同一状态下不能有两条转移带相同输入标签——否则下一状态有歧义,行为不一致
  • 穷尽(collectively exhaustive):每个可能输入值都应有转移;若某输入下应停留,画指向自身的自环

于是对每一对(当前状态,输入)恰选一条转移。

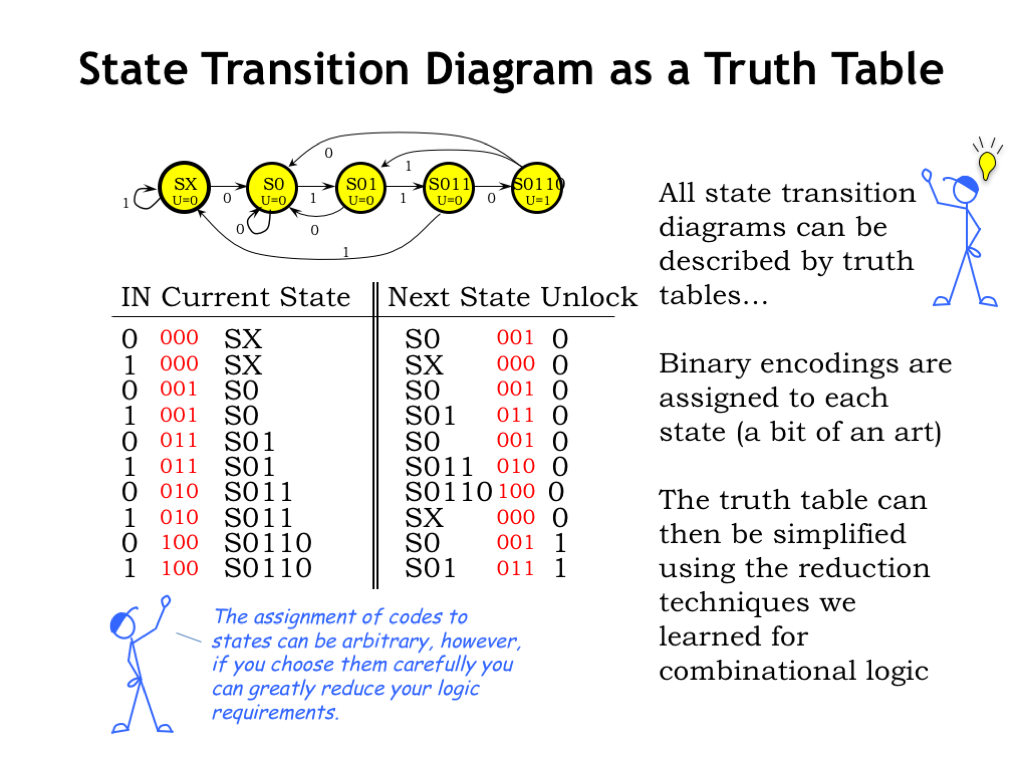
6. 状态转移图即真值表(State Transition Diagram as a Truth Table)

State Transition Diagram as a Truth Table

转移图可写成真值表:行 = 当前状态 + 输入的所有组合;输出列 = 下一状态与输出。用二进制替换符号状态名后,即第 4 章那种真值表。KK 个状态需 ⌈log⁡2K⌉\lceil\log_2 K\rceil 个状态比特(本例 5 态 → 3 比特)。

编码可任意(000、001…),但状态编码会强烈影响实现逻辑复杂度——找最简逻辑的编码本身很有趣。有了真值表,可用第 4 章方法做组合逻辑,或干脆用 ROM。

7. 落到硬件(Now Put It in Hardware)

Now Put It in Hardware

ROM 由当前状态与输入计算下一状态与输出。5 态用 3 比特编码 → 3 比特状态寄存器(边沿触发矩形为多比特寄存器的示意;线上斜杠 + 数字表示位宽)。

ROM 共 4 根地址输入(3 状态 + 1 输入)→ 24=162^4=16 个单元,对应真值表 16 行;每单元 4 比特(3 下一状态 + 1 输出)→ 16×4 ROM。状态寄存器仍须服从动态纪律(第 5 章末时序分析);暂假定输入跳变已与时钟上升沿正确同步。

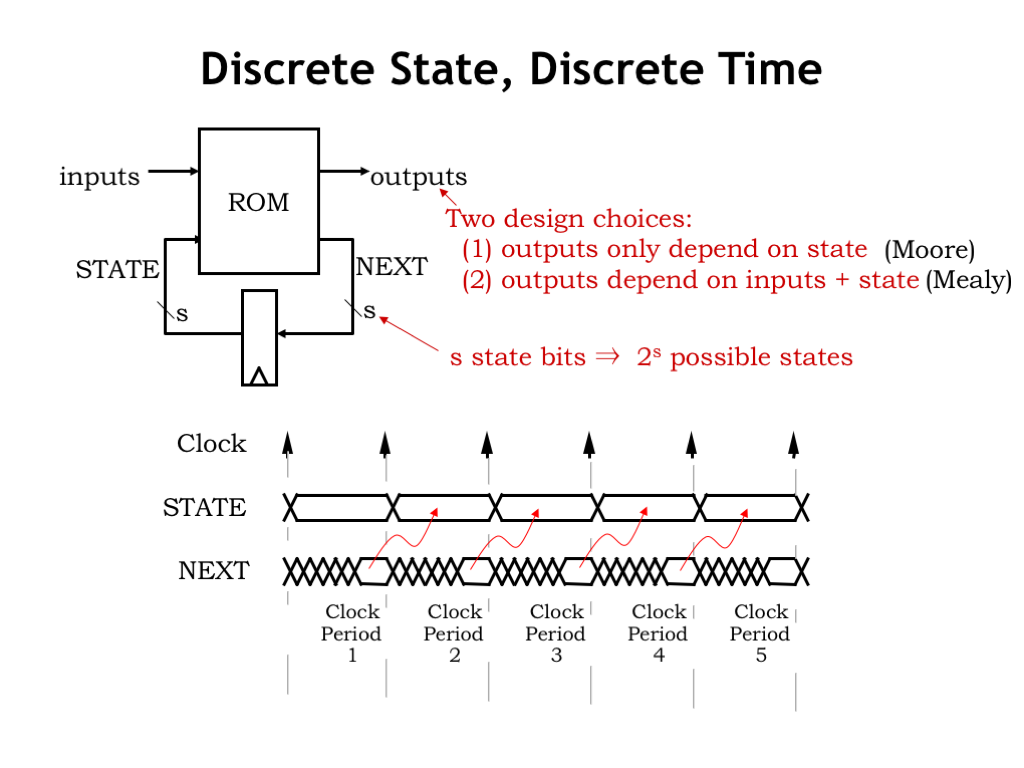
8. 离散状态、离散时间(Discrete State, Discrete Time)

Discrete State, Discrete Time

回顾设计选择:输出仅依赖状态 → Moore;依赖状态+输入 → Mealy。SS 个状态比特可编码 2S2^S 态。每多 1 个状态比特,ROM 容量翻倍——用 ROM 实现时极想减少状态比特。

波形:时钟上升沿 → 状态寄存器输出更新 → ROM 算出下一状态(本周期某时刻稳定)→ 下一上升沿装入。周而复始,跟随转移图。

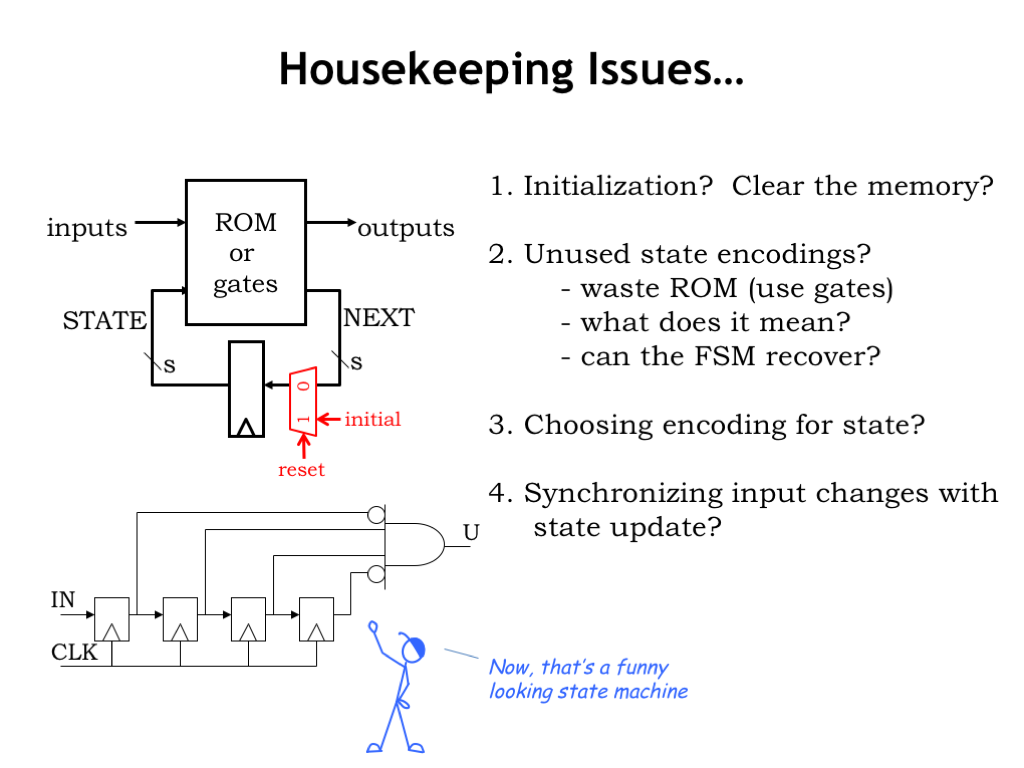
9. 杂务问题(Housekeeping Issues…)

Housekeeping Issues
  • 复位:上电需把状态寄存器置为初始态编码;常用 RESET=1 强制初态,再置 0 开始运行
  • 未用编码:3 比特最多 8 态,本例只用 5 个——可改用门级逻辑;若寄存器误入未用编码,可在 ROM 中令未用态一律指向初态,避免未知行为
  • 编码优化:CAD 可帮找使组合逻辑最简的状态编码
  • 另一实现:移位寄存器记住最近四位,再比较是否匹配口令——无需复杂的下一状态逻辑
  • 异步输入:如何保证输入跳变不破坏状态寄存器的动态纪律——本章末节讨论

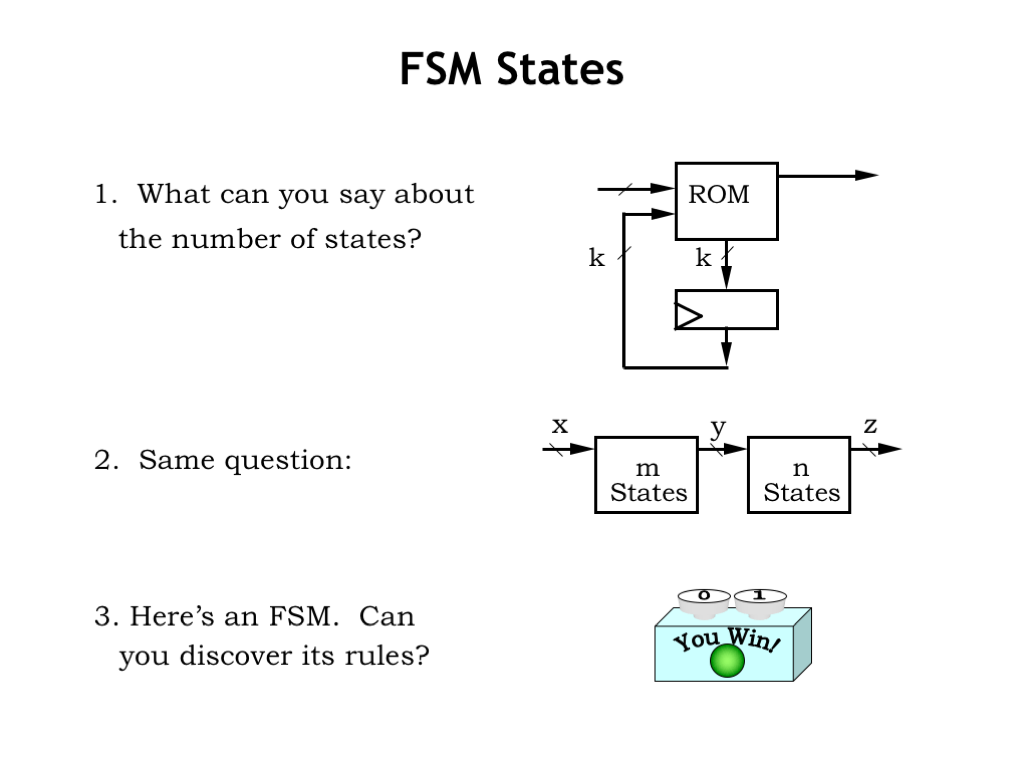
10. FSM 的状态(FSM States)

FSM States
  • 用 KK 个状态比特的 FSM,转移图中状态数至多 2K2^K
  • 两台 FSM 串联(第一台输出 = 第二台输入):整体仍是 FSM;不知内部细节时,状态数上界为 M×NM\times N(第一台可在任一 MM 态,同时第二台在任一 NN 态)。上界与输入位宽 X,YX,Y 无关——更宽输入只让转移标签更长,不直接告诉内部状态数

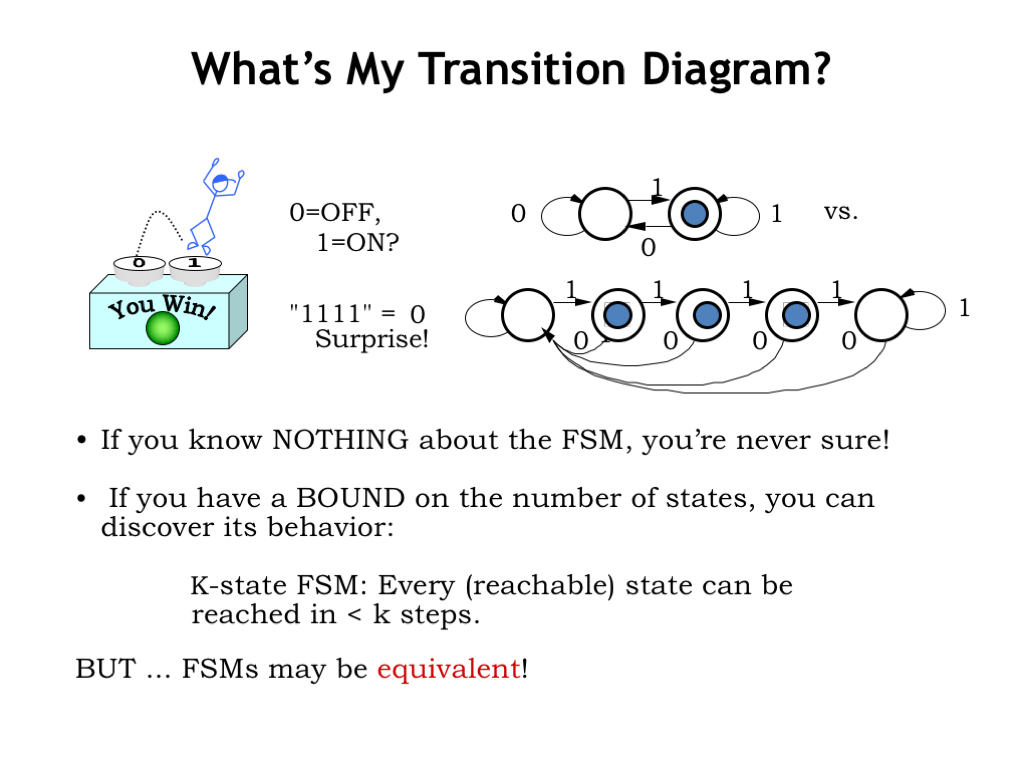
11. 我的转移图是什么?(What’s My Transition Diagram?)

What's My Transition Diagram

黑盒 FSM:按钮 0/1,灯输出。实验一小时:按 0 灯灭,按 1 灯亮。能否确定转移图?

两个图都能匹配“短时间”观察;第二个要连按 1 四次才暴露差异。若状态数无上界,永远无法确认已穷尽全部行为。 若知上界为 KK,并每次从初态复位:可达态都能在少于 KK 步到达,枚举所有长度 ≤KK 的输入序列即可保证访问全部状态。

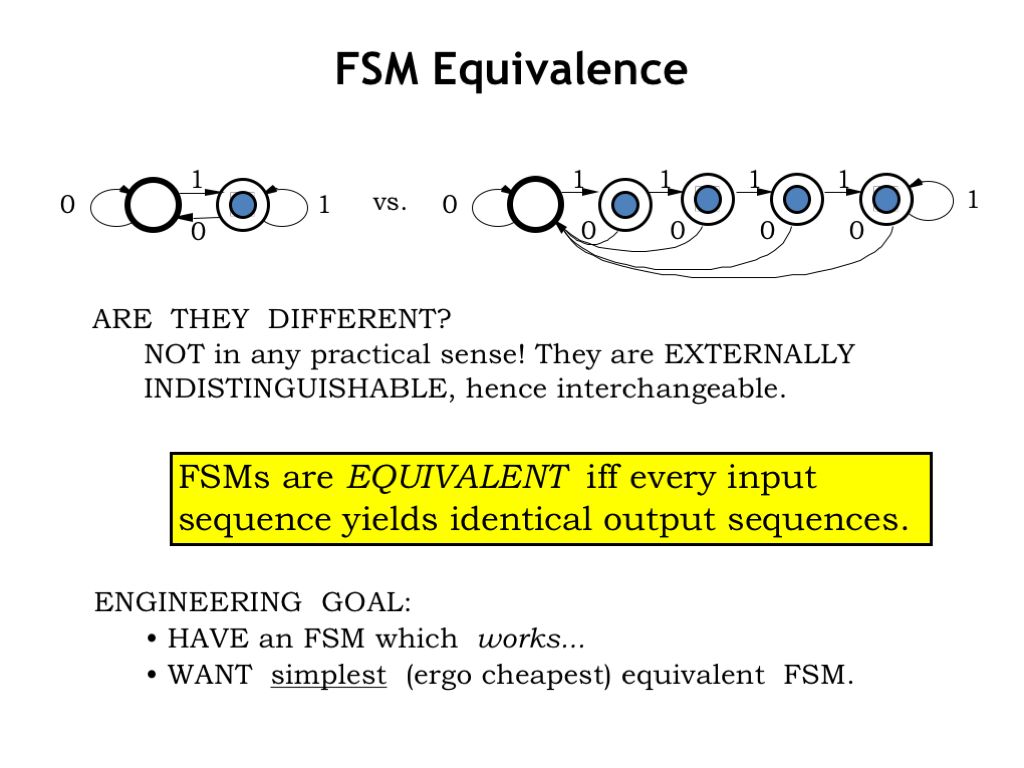
12. FSM 等价(FSM Equivalence)

FSM Equivalence

不同状态数的 FSM 可能等价:对外不可区分即可互换。定义:当且仅当任意输入序列在两机上产生相同输出序列时,两 FSM 等价。工程上希望找最简(最便宜)的等价机——下一例说明如何化简。

13. 造一只机器蚁(Let’s Build a RoboAnt)

Let's Build a RoboAnt

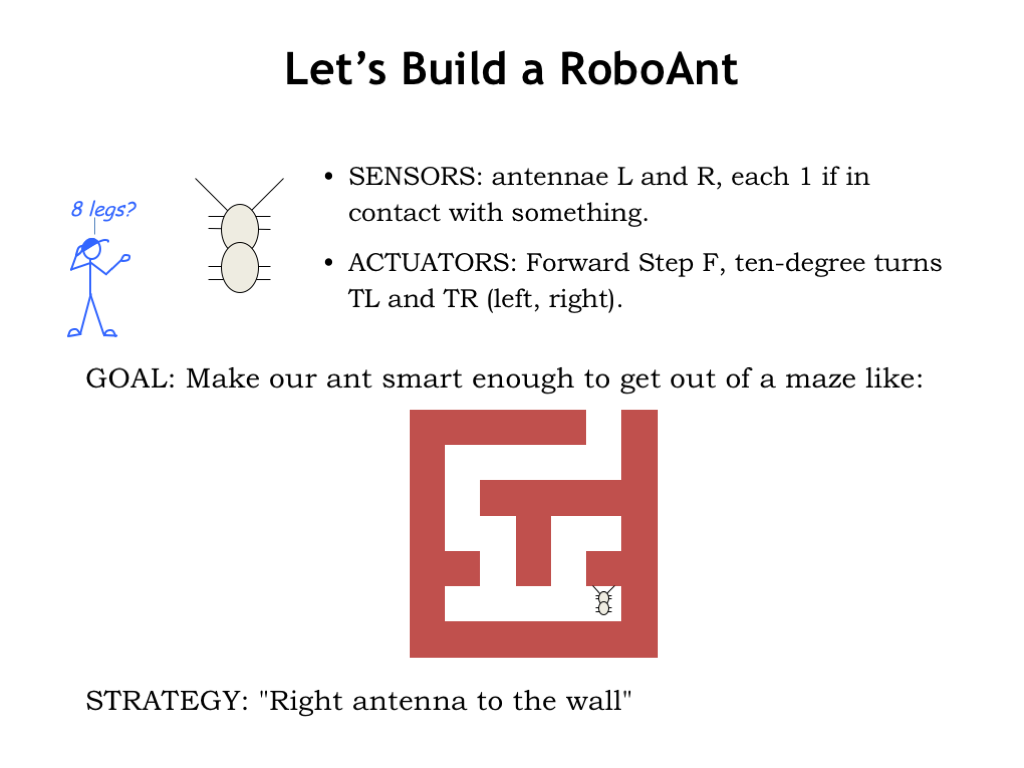
机器蚁以 FSM 为脑:触角 L、R(触碰为 1);输出 F 前进、TL/TR 左转/右转。同时请求转向与前进时先转向。触角贴墙时可转,但无法前进。任务:在无孤岛墙的迷宫中用右手定则逃出。

14. 迷失太空(Lost in Space)

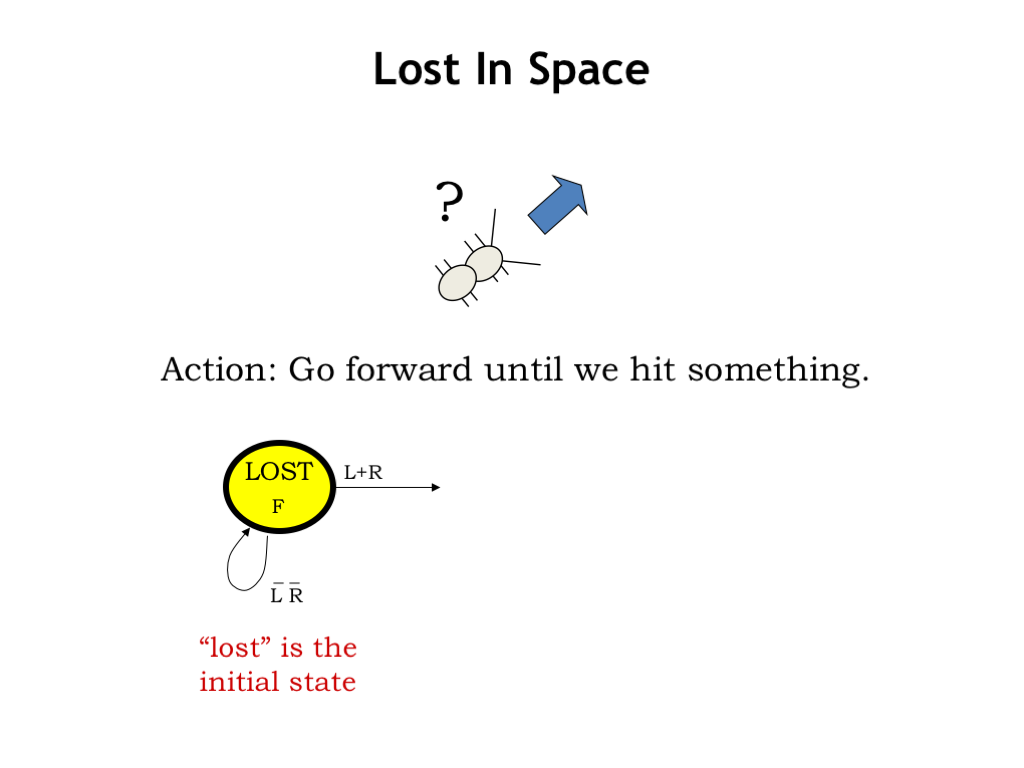
Lost in Space

初态 LOST:断言 F,一直前进直到至少一根触角碰到墙(LL 或 RR 为 1)。

15. 撞上了!(Bonk!)

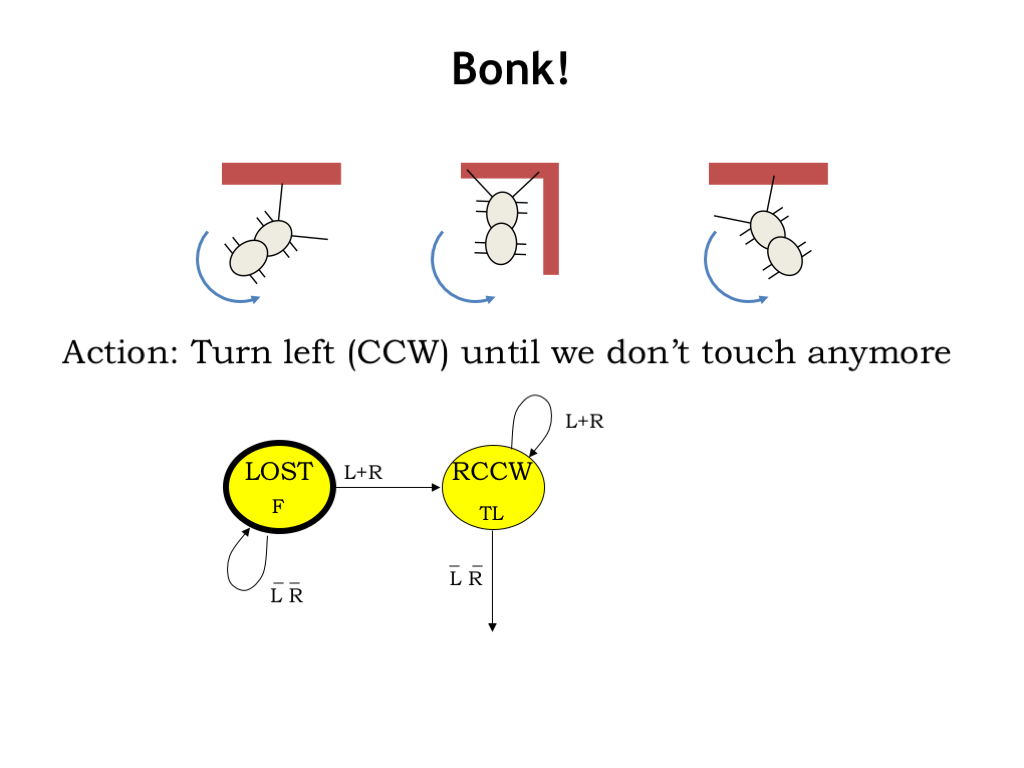
Bonk

碰到墙后的三种姿态:为实现右手定则,逆时针左转直到两触角都离开墙 → 增加 rotate-counterclockwise 态,断言 TL,直到 L=R=0L=R=0。

16. 稍向右转…(A Little to the Right…)

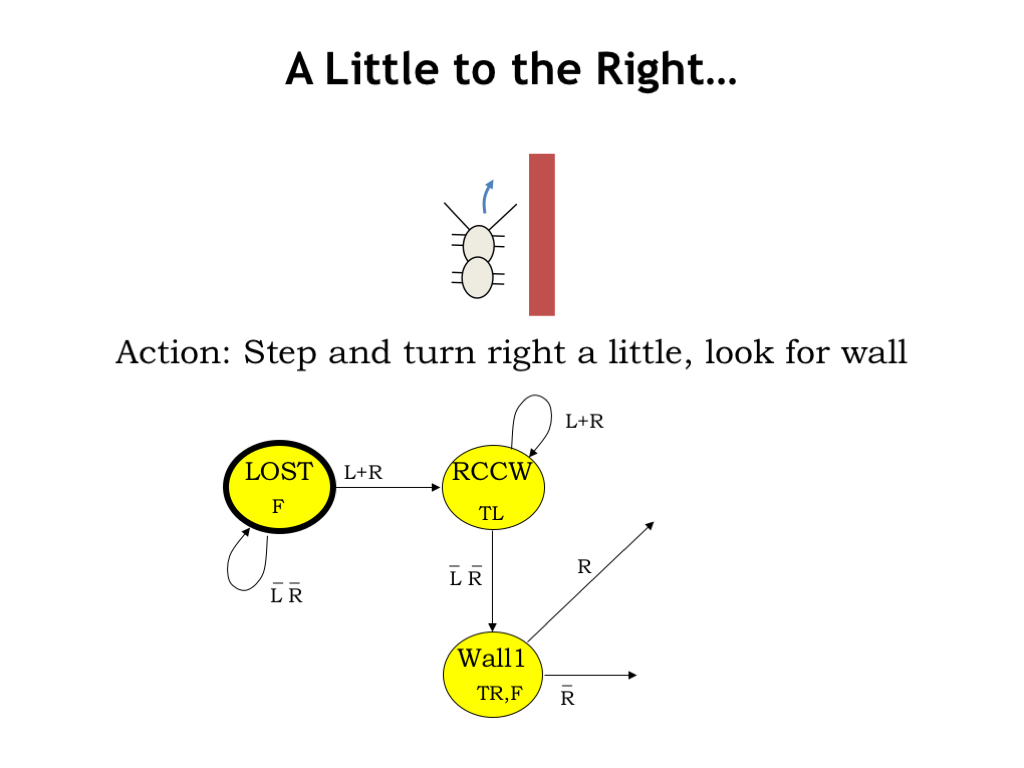
A Little to the Right

墙已在右侧,开始用右触角沿墙走:WALL1 断言 TR+F,然后看右触角决定下一步(期望立刻再碰到墙)。

17. 再稍向左转…(Then a Little to the Left…)

Then a Little to the Left

右触角如期碰到 → WALL2:TL+F,再检查触角。右触角仍碰 → 继续转;左触角碰 → 内角,回到 rotate-counterclockwise 把新墙放到右侧;两触角都空 → 回到 WALL1(与墙平行)。期望沿墙时 WALL1/WALL2 交替;遇内角则旋转后继续。

18. 处理外角(Dealing With Outside Corners)

Dealing With Outside Corners

WALL1 中前进并右转后,外角处右触角可能碰不到墙。策略:CORNER 态继续右转并前进,直到右触角再次碰到拐角后的墙,再转入 WALL2。

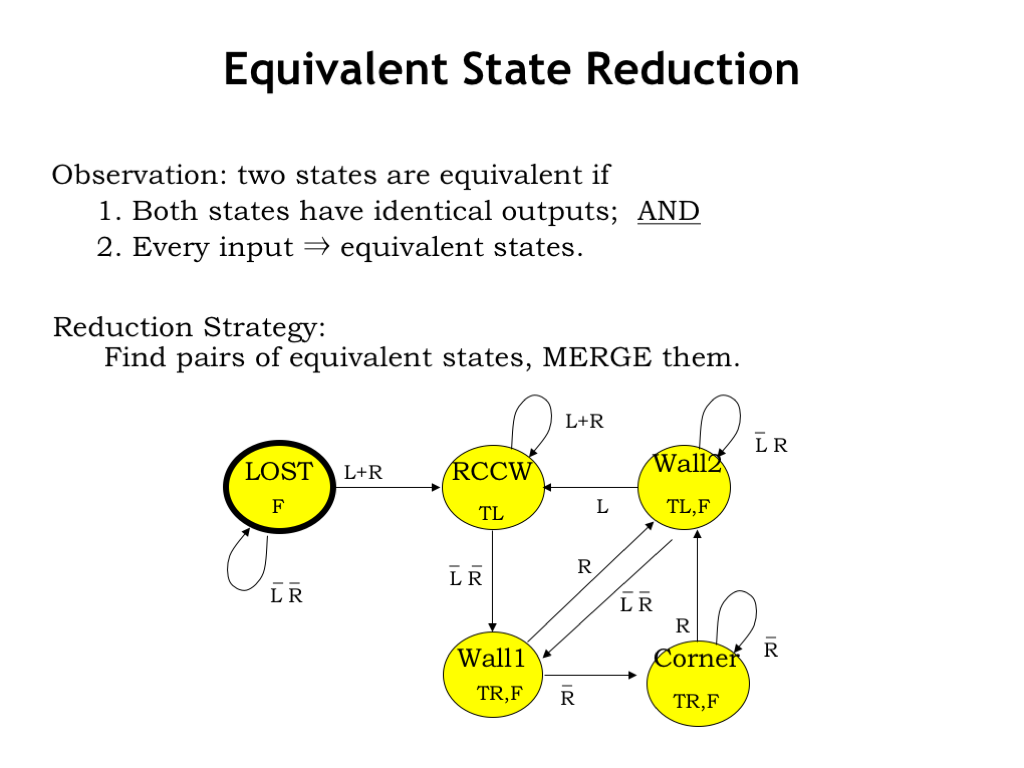
19. 等价状态化简(Equivalent State Reduction)

Equivalent State Reduction

找可合并、对外不可区分的状态对。两态等价当且仅当:

  1. 输出相同(输出对外可见)
  2. 对每种输入组合,二者转到等价的下一状态

策略:反复找等价对并合并,直到不能再合并。

20. 进化一步(An Evolutionary Step)

An Evolutionary Step

蚁 FSM 中仅 WALL1 与 CORNER 输出相同(皆 TR+F)。二者转移只依赖 RR:R=0R=0 都到 CORNER,R=1R=1 都到 WALL2 → 等价,可合并为 WALL1。

5 态 → 4 态;实现从 3 状态比特降到 2 比特——少 1 比特,ROM 减半。与布尔化简类似,合并等价态可省时序硬件。

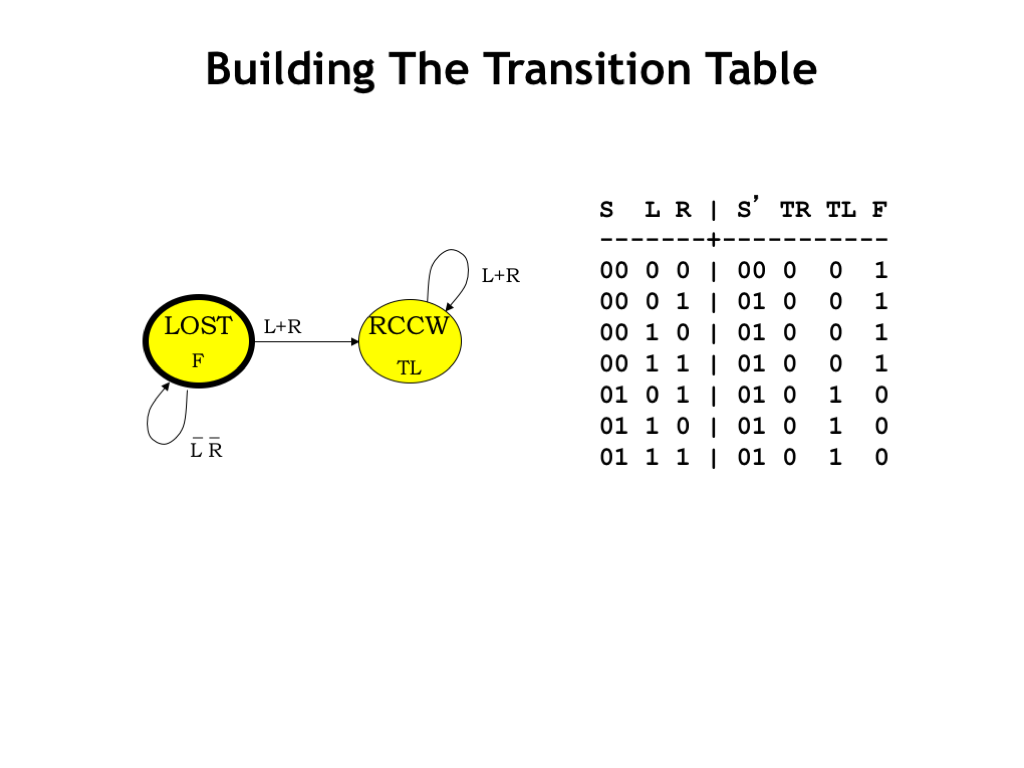
21. 建转移表(Building the Transition Table)

Building the Transition Table

不用 ROM、改用门实现时:把转移图逐条写入真值表。LOST(编码 00):F=1F=1;L=R=0L=R=0 则下一态仍 LOST;任一触角碰 → 转到 rotate-counterclockwise(01),对应 L,RL,R 的三种组合各占一行。再类似地填完其余状态的转移。

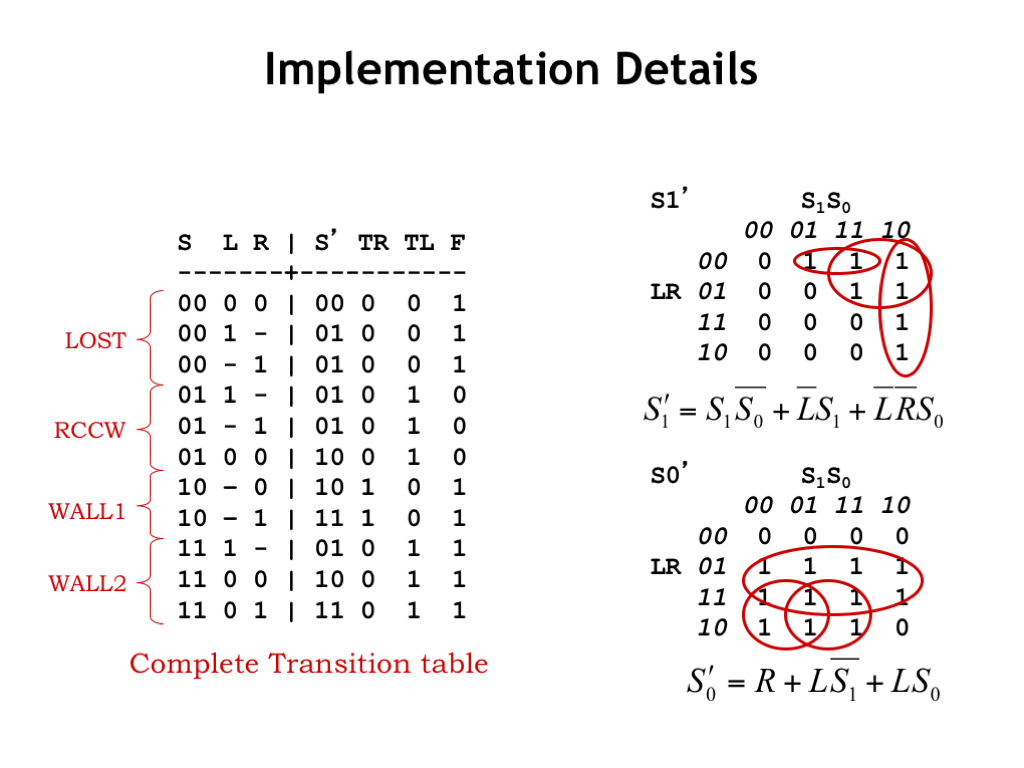
22. 实现细节(Implementation Details)

Implementation Details

完整表可用 don’t-care 压缩行数。再对组合逻辑各输出(2 个下一状态比特 + 3 个运动输出)写布尔方程。下一状态比特用第 4 章 K-map 找素蕴涵项覆盖,得最小 SOP;运动控制输出同法。

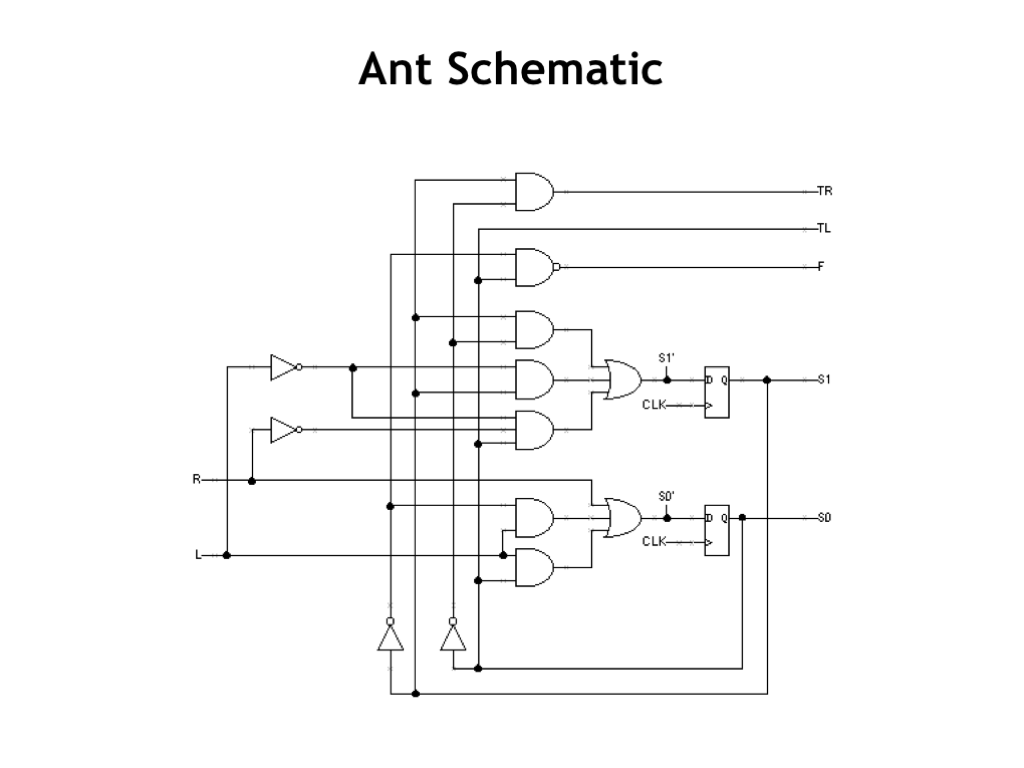
23. 蚁脑原理图(Ant Schematic)

Ant Schematic

各 SOP 用 AND/OR 直接实现,即得蚁脑原理图:几个 D 寄存器 + 一把逻辑门就能走出迷宫。

24. 一路都是 FSM?(FSMs All the Way Down?)

FSMs All the Way Down

简单 FSM 可产生复杂群体行为(群集、鸟群、鱼群);电影大战场面可想成大量并行 FSM。元胞自动机(通信 FSM 阵列)有时比解 PDE 更易建模分子约束。若允许 FSM 改自身转移表——或许可作进化的粗糙模型。FSM 无处不在。

25. 世界不跟我们的时钟跑!(The World Doesn’t Run on Our Clock!)

The World Doesn't Run on Our Clock

异步输入:跳变时刻与系统时钟完全无关(来自外界)。第 5 讲末:状态寄存器要求相对时钟上升沿满足建立/保持时间;随时可变的输入必可能违反。思路:对每个异步输入加同步器,使输出只在时钟上升沿后不久才改变。

26. 有界时间同步器(The Bounded-Time Synchronizer)

The Bounded-Time Synchronizer

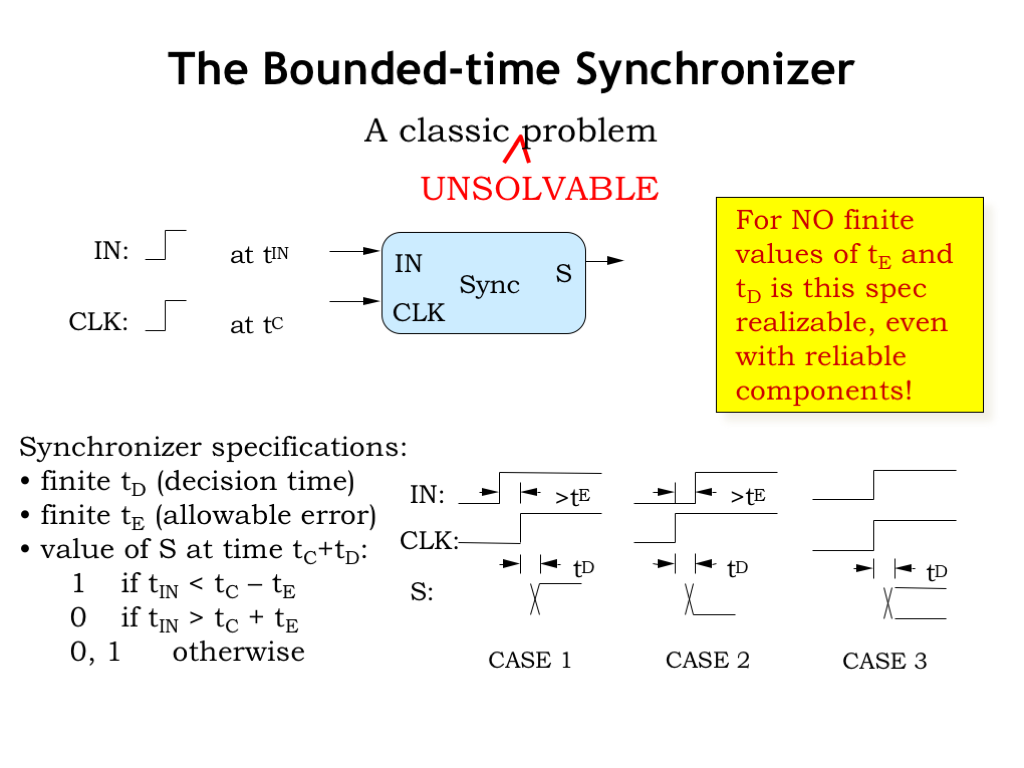
规格:输入 IN、CLK,跳变时刻 tINt_{\mathrm{IN}}、tCt_{\mathrm{C}}。

  • IN 充分早于 CLK → 在 CLK 后有界时间 tDt_{\mathrm{D}} 内输出 1
  • CLK 充分早于 IN → 在 tDt_{\mathrm{D}} 内输出 0
  • 两者间隔小于 tEt_{\mathrm{E}} → tDt_{\mathrm{D}} 内输出 0 或 1 皆可,但须是稳定的数字电平

结论:对任意有限的 tE,tDt_{\mathrm{E}},t_{\mathrm{D}},即使元件 100% 可靠,也无法造出保证满足该规格的同步器——问题不可解。

27. 不可解?那不可能…(Unsolvable? That Can’t Be True…)

Unsolvable

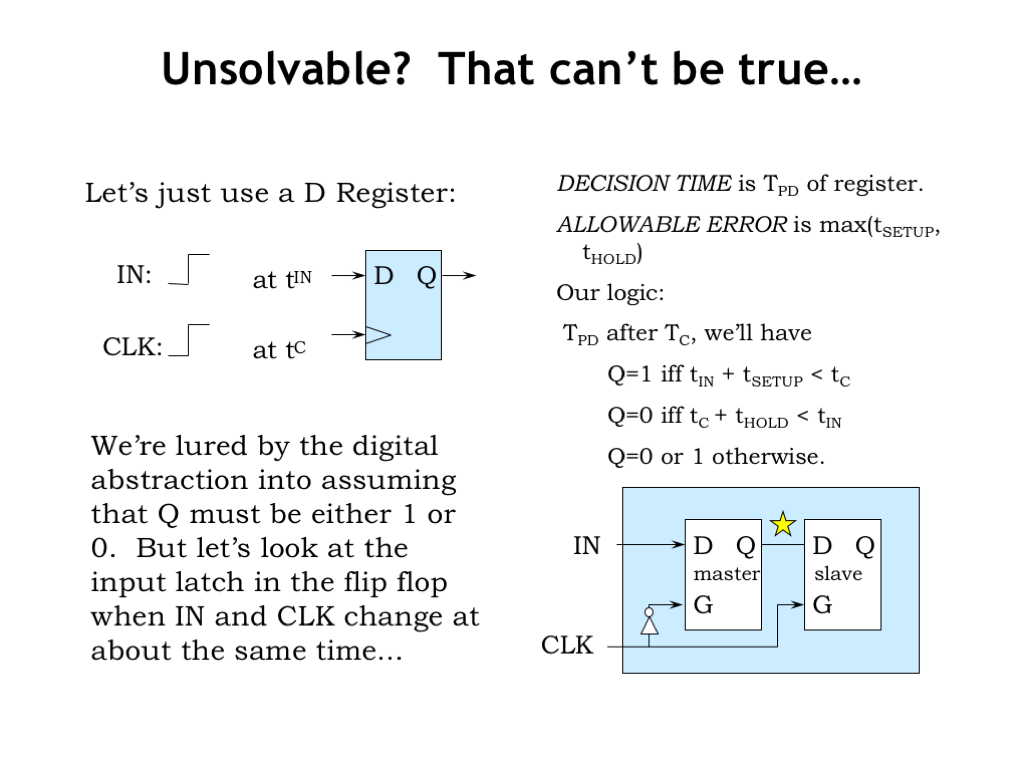
能否用一个 D 寄存器当同步器?取 tDt_{\mathrm{D}} = 寄存器传播延迟,tEt_{\mathrm{E}} = setup/hold 中较大者。满足动态纪律时输出确定;违纪时规格允许 0 或 1——看似搞定。

陷阱:数字抽象诱使我们以为违纪后 QQ 在传播延迟后仍必为 0 或 1。看主锁存:当 B、C 几乎同时变时未必如此。

28. 神秘的亚稳态(The Mysterious Metastable State)

The Mysterious Metastable State

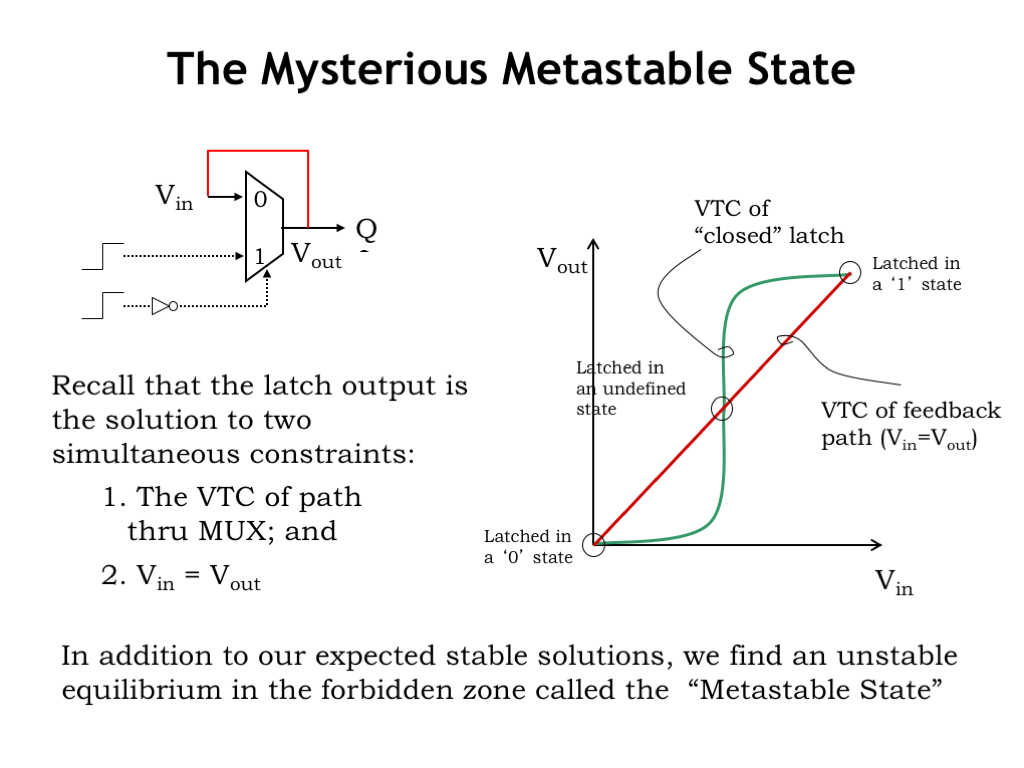
主锁存是宽容 MUX,用正反馈构成双稳态。存储模式 ≈ 两门环路:约束为两门电路的 VTC(绿)以及 VIN=VOUTV_{\mathrm{IN}}=V_{\mathrm{OUT}}(红)。两曲线交于三点;中间交点是问题所在。

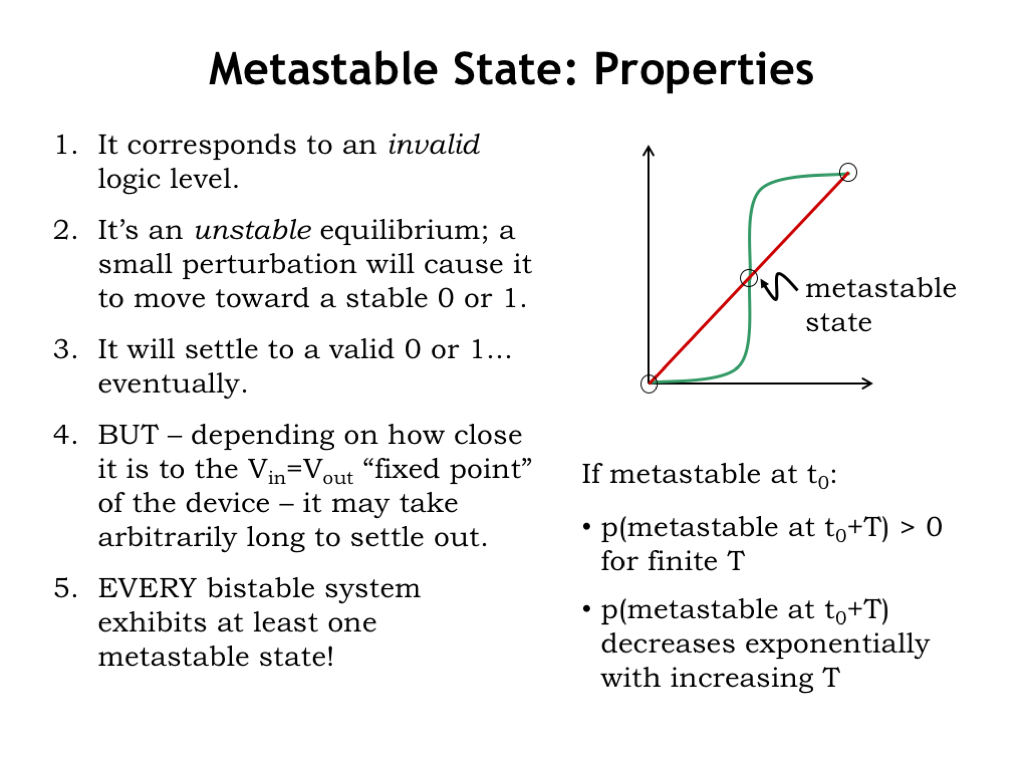
IN 与 CLK 同时变时,MUX 关闭启用反馈时 QQ 可能正处过渡,环路初值恰在或极近中间交点电压 → 亚稳态(metastable state):不稳定平衡。理论上可无限停留;微小扰动会推向稳定平衡。关键:无法给系统停留在亚稳态的时间设上界。

29. 亚稳态性质(Metastable State: Properties)

Metastable State Properties
  • 落在数字信令的禁止区 → 非法逻辑电平;违纪后寄存器不再保证有界时间内给出数字输出
  • 逻辑危害:组合门对非法输入输出不可预测,可污染状态与输出
  • 电气危害:CMOS 输入在亚稳电压时 PFET/NFET 可同时导通,VDDV_{\mathrm{DD}}–GND 直通,功耗尖峰
  • 终将落到两稳定点之一;亚稳电压在 VTC 高增益区,一旦偏离会快速走向 0 或 VDDV_{\mathrm{DD}}
  • 分辨时间取决于初值离亚稳点有多近——无下界 → 分辨时间无上界;给定 tDt_{\mathrm{D}},总有一段初值区间在时限内分不开
  • 任一有限 TT 后仍亚稳的概率 >0>0;好消息:该概率随 TT 指数下降
  • 每个双稳态系统至少有一个亚稳态——正反馈存储的代价

更细的数学见课程笔记第 10 章。

30. 解法:延迟提高可靠性(Solution: Delay Increases Reliability)

Solution: Delay Increases Reliability

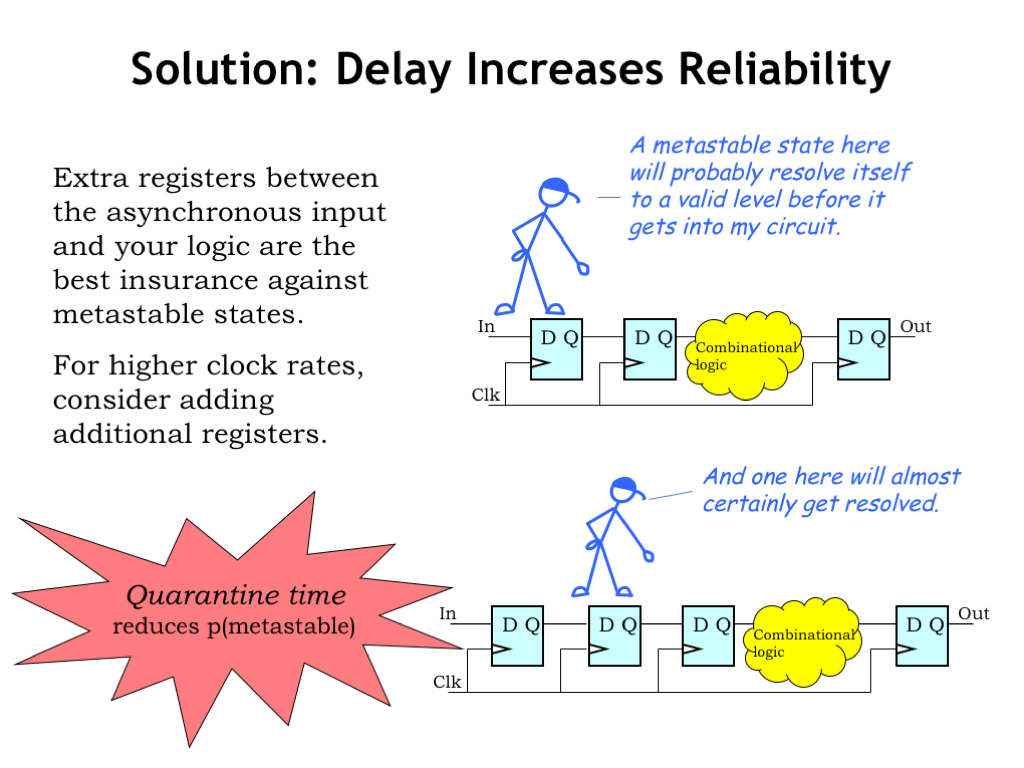
做法:D 寄存器同步后再加第二级寄存器,把可能亚稳的值隔离(quarantine)。第一级违纪亚稳时,第二级挡住;半周期内第二级主锁存关闭,完全不看该值。要到下一时钟边沿(整周期后)第二级才需要合法稳定输入。整周期后仍亚稳的概率可通过加长时钟周期压到任意低——不是 100% 保证,但失效间隔可达年/十年量级;无第二级可能每几小时就失败一次。

时钟周期短却要长隔离时间:可串多级隔离寄存器——决定失败概率的是“第一级亚稳 → 内部逻辑使用该信号”的总延迟。

结论:用同步寄存器隔离可能亚稳的信号;仍亚稳概率随隔离时间指数下降,可把失败率压到任意低。非绝对保证,但配合隔离策略时,亚稳态在实践中不再是问题。

整理自 MIT OCW 6.004 Computation Structures(Spring 2017)L05 注解幻灯片。

源网页:5.1 Annotated Slides | Sequential Logic

讲师:Chris Terman。图片直接引用 OCW 原站链接。

L05:时序逻辑(Sequential Logic)

本讲在组合逻辑之上引入状态(state)与存储(memory):从电容存储与反馈双稳态,到 D 锁存器、边沿触发 D 寄存器,再到单时钟同步电路的建立/保持时间与 tCLKt_{\mathrm{CLK}} 约束。

1. 还不能造的东西(Something We Can’t Build (Yet))

Something We Can't Build Yet

上一讲学会了按功能规格做组合逻辑:输出只由当前输入决定。

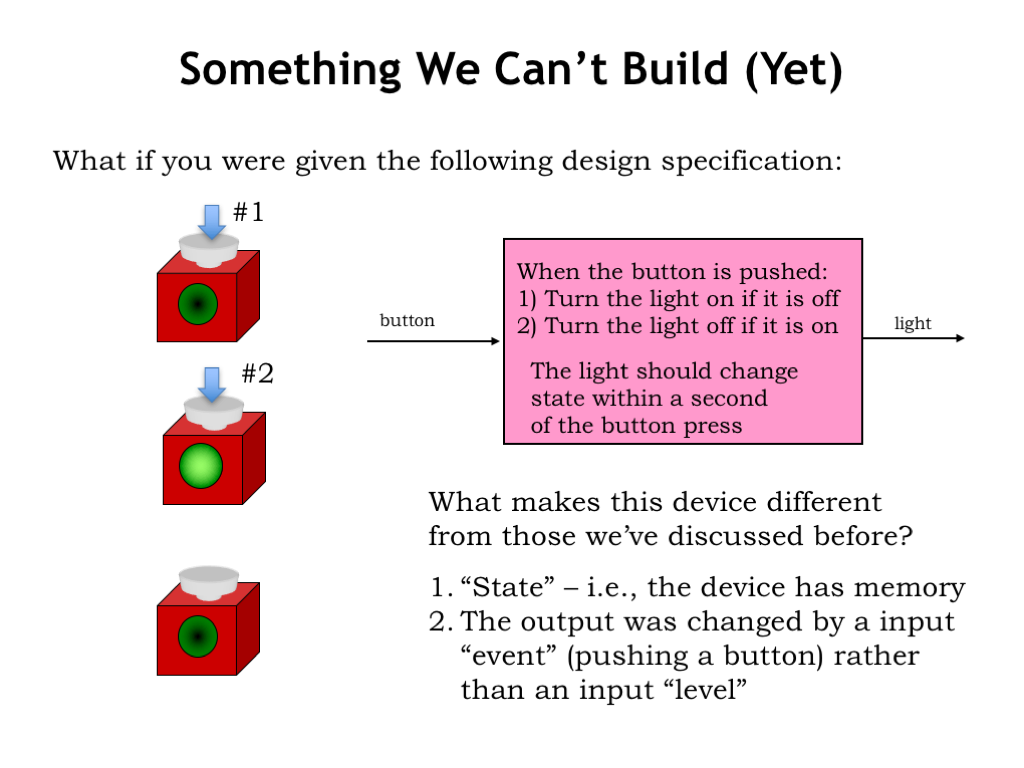
但有一类简单器件做不到:灯作输出、按钮作输入——灯灭时按一下灯亮,灯亮时再按一下灯灭。输出并不只是当前输入的函数:第奇数次按下亮、偶数次灭,器件在“记住”上次是奇次还是偶次。这种依赖输入历史的器件称为有状态。

更细微的一点:关心的是按钮从松开到按下的跳变时刻,而不只是“当前是否按下”。内部状态使相同输入可产生不同输出;纯组合器件做不到。本讲要把状态写进电路。

2. 数字状态:想造什么(Digital State: What We’d Like to Build)

Digital State What We'd Like to Build

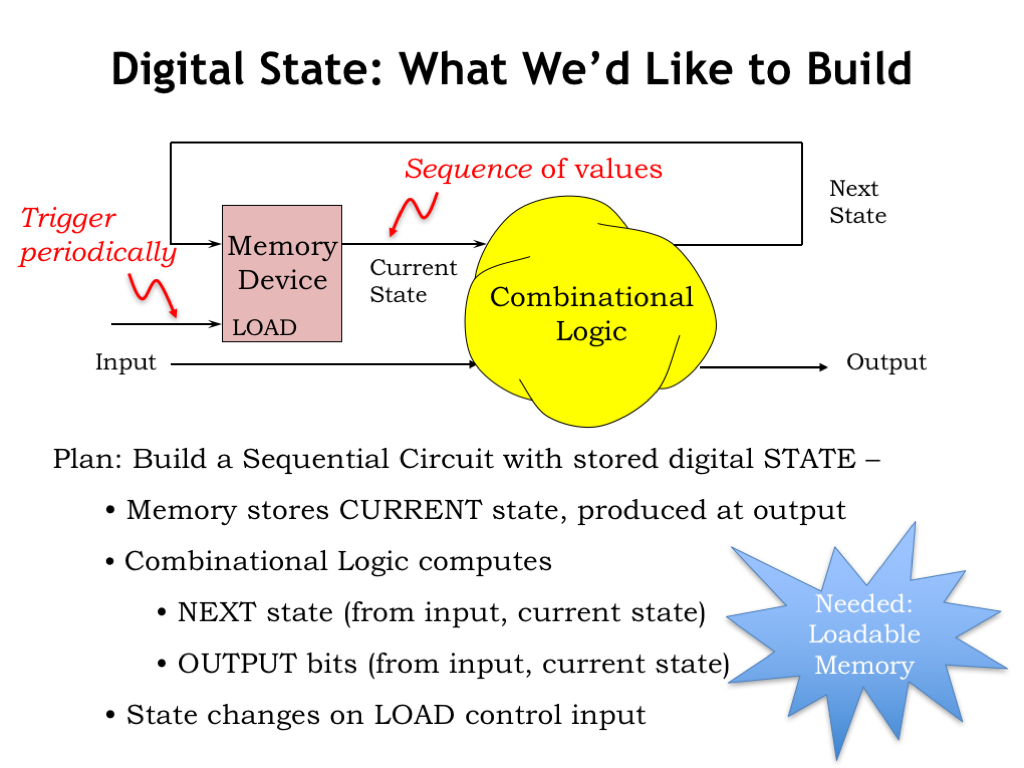
引入存储器抽象:用一个或多个比特编码系统当前状态,这些比特作为数字值出现在输出(图中 “Current State”)。

当前状态与当前输入一起进入一块组合逻辑,产生两组输出:

  • 下一状态(next state):比特数与当前状态相同
  • 系统输出:对外可见的信号

组合逻辑的功能规格(真值表或布尔方程)规定:下一状态与系统输出如何由当前状态与当前输入决定。

存储器有两个输入:LOAD 控制何时用下一状态替换当前状态,以及给出下一状态数据的输入。周期性触发 LOAD,就得到当前状态序列;序列中每一态由上一态与触发时刻的输入决定。

含组合逻辑与存储器的电路称为时序逻辑(sequential logic)。若存储器存 KK 比特,可能状态数至多为 2K2^K。本章讨论如何造可加载的存储元件;下一章讨论如何系统化设计时序行为。

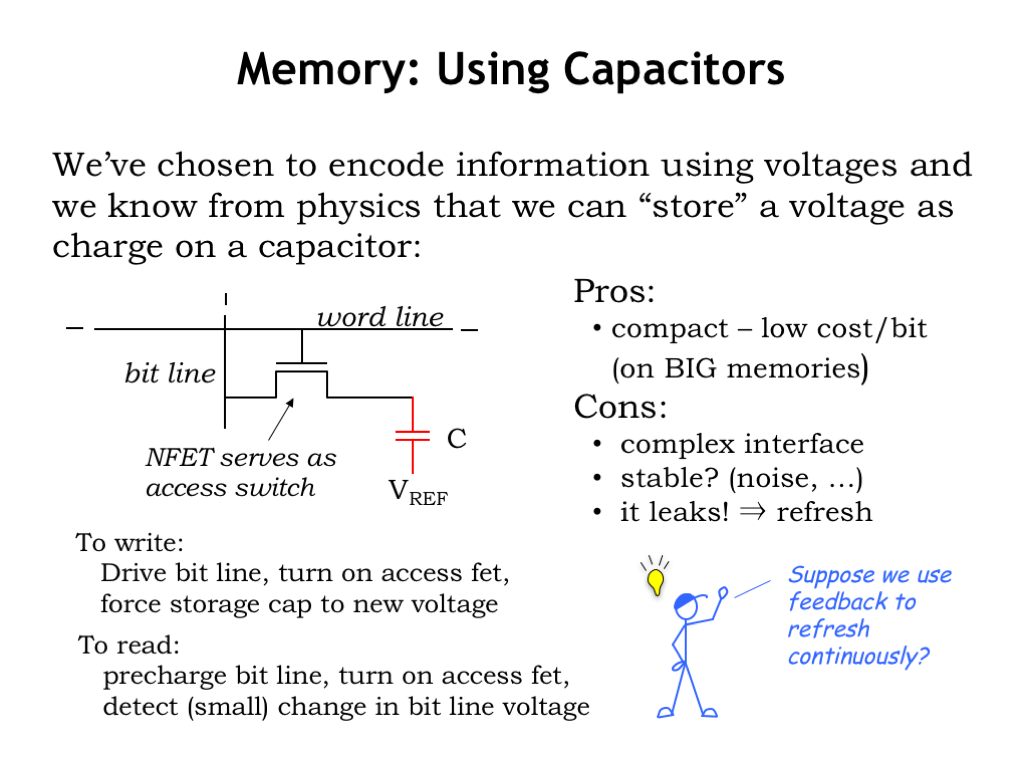
3. 用电容做存储(Memory: Using Capacitors)

Memory Using Capacitors

比特已用电压表示,可考虑用电容存某电压。电容是无源二端器件:两平行板隔绝缘体,电荷 QQ 与电压差 VV 满足 Q=CVQ=CV。接到较高电压叫充电,接到较低电压叫放电。

电容存储单元示意:电容一端接稳定参考;另一端经 NFET 开关接到 bit line;开关栅极接 word line。

  • 写:把 bit line 驱动到目标电压(数字 0/1),再令 word line 为 HIGH,电容充/放到与 bit line 同压;再令 word line 为 LOW,关断开关,理想情况下电荷可一直留在内部极板。

  • 读:先把 bit line 充到中间电压,再开 word line,使 bit line 与存储电容电荷共享。存 1(较高压)时电荷流向 bit line,电压略升;存 0 则略降。变化通常很小,需灵敏放大器(sense amp)检出并还原成合法数字电压。

  • 优点:存储电容极小,现代 IC 可在廉价 DRAM(dynamic random-access memory)上集成数十亿比特,单位比特成本低。

  • 缺点:读写需要复杂的操作,所以访问慢;必须注意在外部电噪声干扰下,小心地保持储能电容器上的电荷;NFET 关断仍有泄漏,当前技术下须约每 10 ms 刷新(refresh)——读出再写回。所以我们需要搭配精心设计的模拟电子电路(analog electronics) [1]。

或许我们可以通过设计一种利用“反馈”持续刷新存储信息的电路来克服电容式存储的缺点。

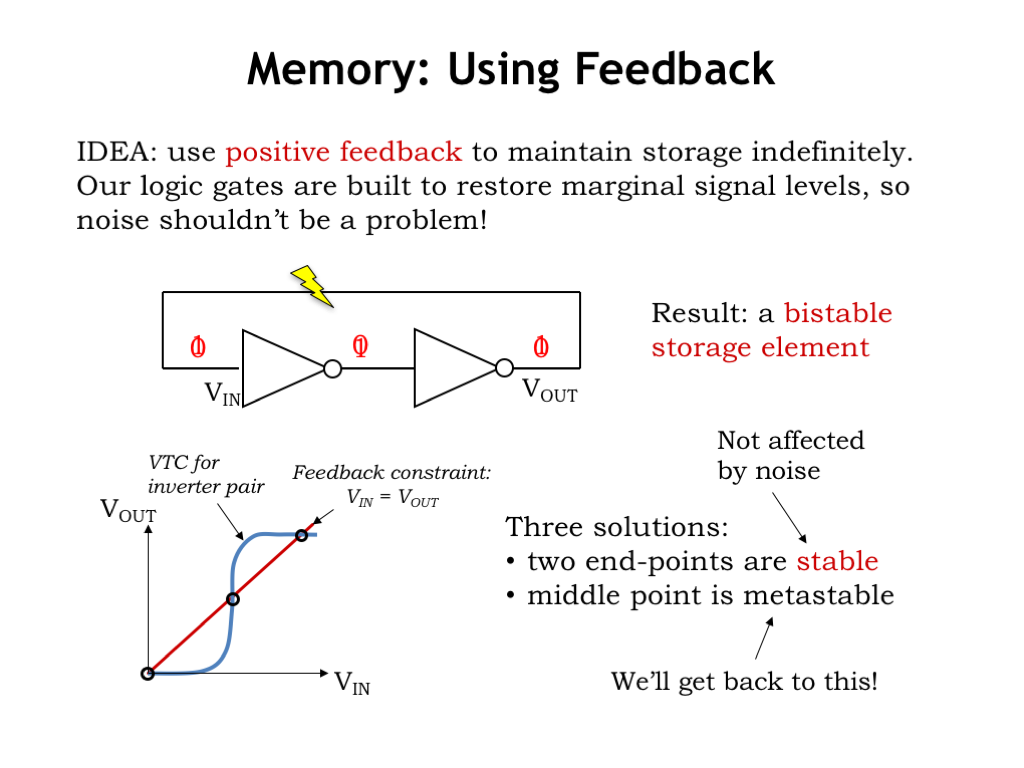
4. 用反馈做存储(Memory: Using Feedback)

Memory Using Feedback

两只组合反相器接成正反馈环:一输入为数字 0 → 其输出为 1 → 另一反相器输出为 0,又接回原输入。只要接电源与地,该配置在噪声下仍可保持;两线数字值对调也是稳定的。有两种稳定配置,称为双稳态(bi-stable)存储元件。

把两反相器看成一个系统,其 VTC 给出 VOUTV_{\mathrm{OUT}} 与 VINV_{\mathrm{IN}} 关系;输出接回输入又要求 VIN=VOUTV_{\mathrm{IN}}=V_{\mathrm{OUT}}。图解求交点:两端交点为稳定——VINV_{\mathrm{IN}} 小扰动几乎不影响 VOUTV_{\mathrm{OUT}},系统会回到稳态。中间交点为亚稳态(metastable):理论上可无限停在该电压,但极小扰动就会迅速滑向某一稳态。作存储用时须避免进入亚稳态(下章再谈)。

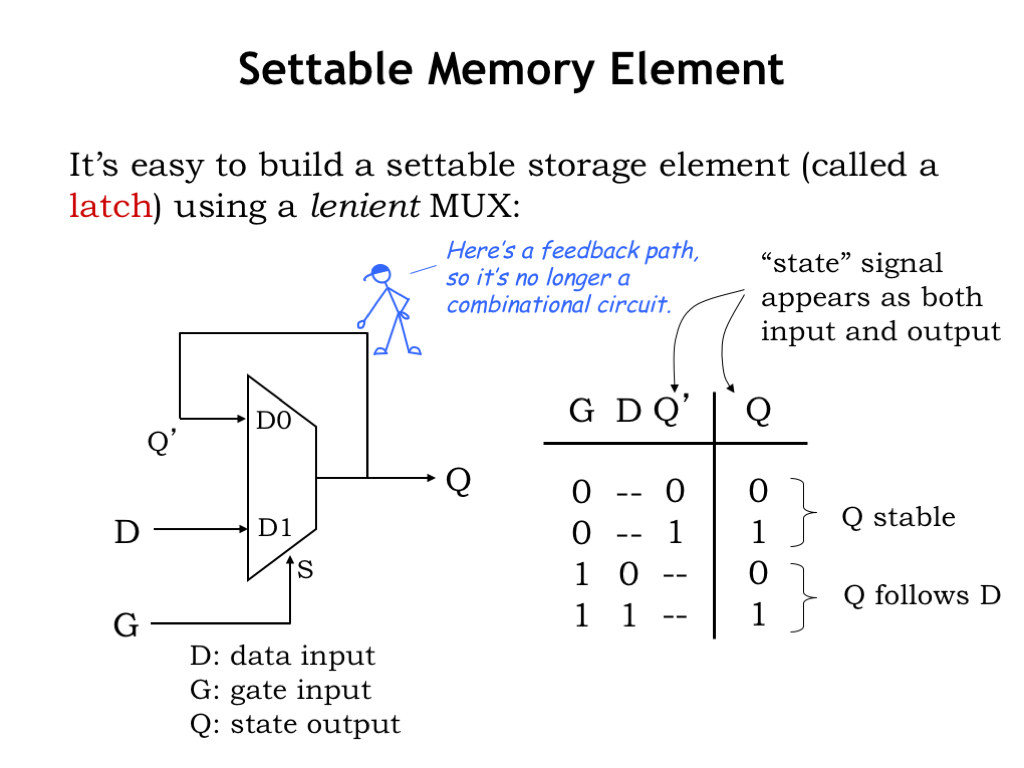
5. 可置位存储元件(Settable Memory Element)

Settable Memory Element

用 2 选 1 MUX 做可置位存储:MUX 输出作状态输出 QQ,并回接到 MUX 的 D0D_0;D1D_1 作数据输入;选择端作加载信号(此处称 gate,GG)。

  • G=LOWG=\mathrm{LOW}:输出经 D0D_0 回环,形成上节的双稳态正反馈;电路出现环路,不再是组合电路。
  • G=HIGHG=\mathrm{HIGH}:输出跟随 D1D_1(数据输入)。

加载:将 GG 置 HIGH 足够久,使 QQ 有效且稳定;真值表上 G=1G=1 时 QQ 跟随 DD,变化时序由 MUX 的 tPDt_{\mathrm{PD}} 决定。再把 GG 置 LOW,进入“记忆模式”,正反馈无限保持稳定 QQ。

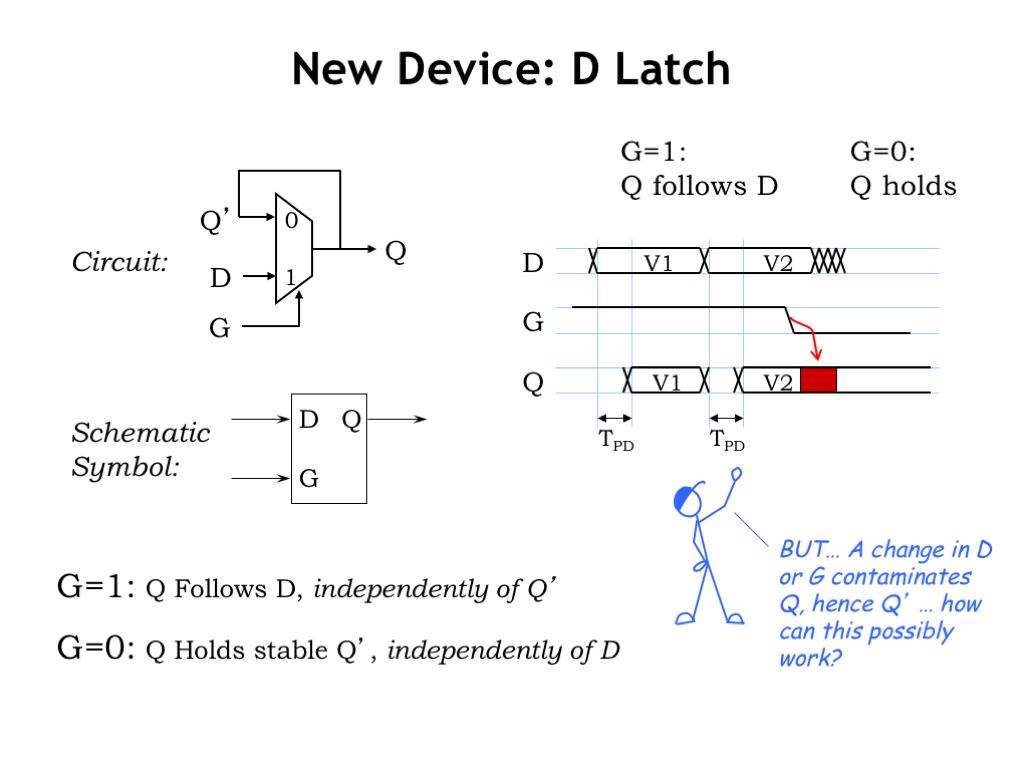
6. 新器件:D 锁存器(New Device: D Latch)

New Device D Latch

该存储器称为 D 锁存器(D latch),原理图符号如图。

  • 门控 GG 为 HIGH:打开(open),信息从 DD 流向 QQ
  • GG 为 LOW:关闭(closed),进入记忆模式,记住 GG 由 HIGH→LOW 时 DD 上的值

右侧时序图:稳定段为恒定 LOW/HIGH,变化段画成多次跳变。GG 为 HIGH 时,DD 稳定后至多再经 tPDt_{\mathrm{PD}},QQ 到达新稳定值。

理论期望:GG 变 LOW 后,QQ 保持跳变瞬间 DD 上的值。但一般组合器件在输入跳变后,tCDt_{\mathrm{CD}} 到 tPDt_{\mathrm{PD}} 之间输出可任意变化——若 GG 的 1→0 使 QQ 短暂失效,要记的正是 QQ 上的值!因此必须保证 GG 的 1→0 不影响 QQ。[2]

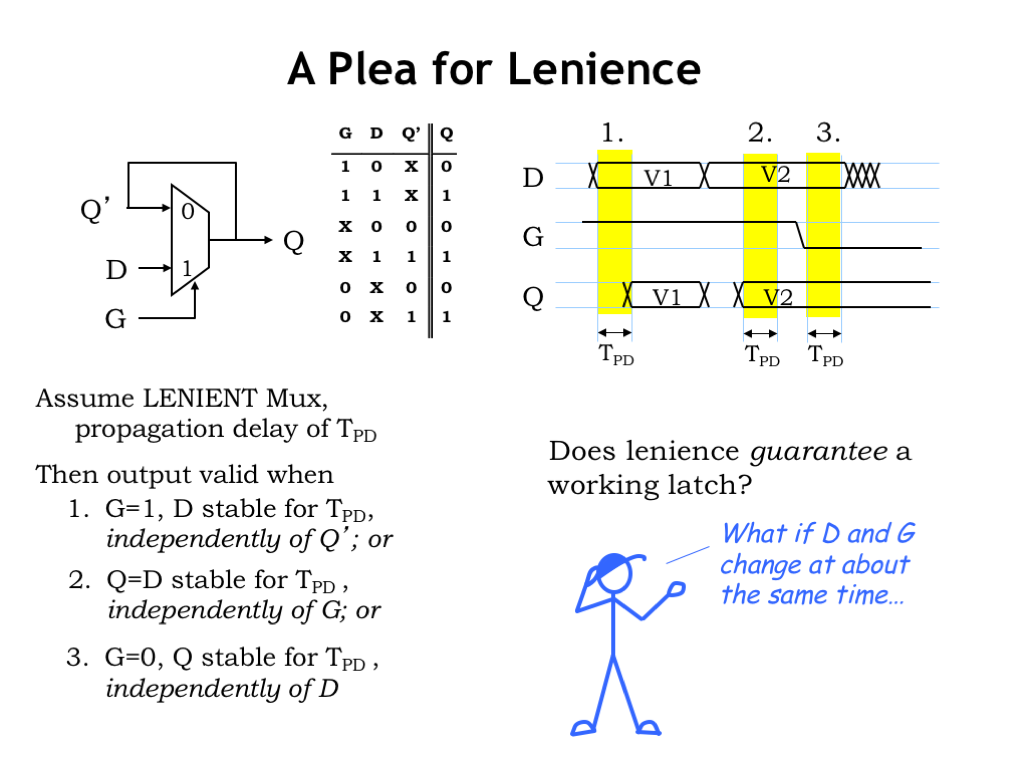
7. 请求宽容(A Plea for Lenience)

A Plea for Lenience

因此,存储元件选用的是宽容的(lenient)MUX;宽容 MUX 的真值表见上图。在下列任一条件下,即使输入发生跳变,输出仍保持有效且稳定:

  1. 将 GG 置 HIGH 以加载锁存器时:一旦 DD 已有效稳定满 tPDt_{\mathrm{PD}},即可保证 QQ 稳定有效,且取值与 DD 相同,与 QQ 的初值无关。
  2. 若 QQ 与 DD 均已有效稳定满 tPDt_{\mathrm{PD}},则此后 GG 上的跳变不影响 QQ——正是靠这一点,GG 才能做 1→0 而不污染 QQ。
  3. 若 GG 为 LOW,且 QQ 已稳定至少 tPDt_{\mathrm{PD}},则此后 DD 上的跳变不影响输出。

宽容性是否足以保证锁存器正常工作?还不够——除非我们小心保证信号在正确时刻稳定,才能用上 MUX 的宽容行为。

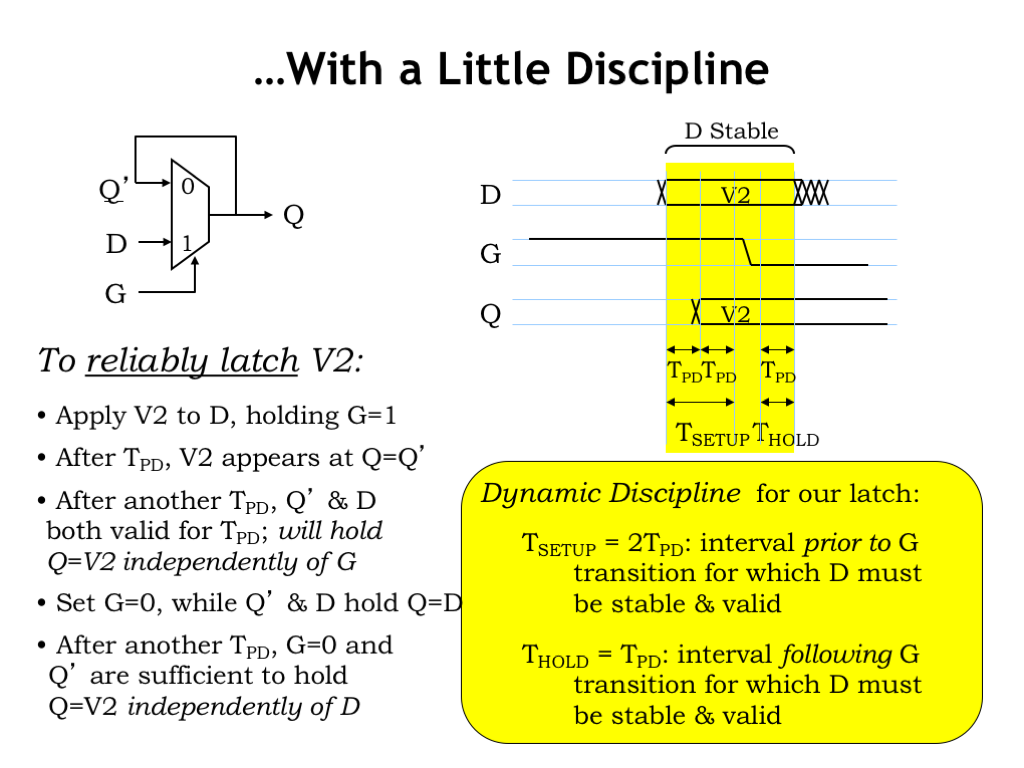
8. 还须一点纪律(… With a Little Discipline)

With a Little Discipline

保证锁存器按预期工作,需按下列步骤操作:

  1. 先在 GG 为 HIGH 时,把待存值放到 DD;经 tPDt_{\mathrm{PD}} 后,即可保证该值在 QQ 上稳定有效。这就是上节条件 1。

  2. 再等一个 tPDt_{\mathrm{PD}},让 Q′Q' 输入上新值的信息传遍锁存器内部电路。此时 DD 与 Q′Q' 都已稳定至少 tPDt_{\mathrm{PD}},从而满足上节条件 2。
    因此若 DD 稳定满 2 tPD2\,t_{\mathrm{PD}},GG 上的跳变就不会影响 QQ。对 DD 的这一要求称为锁存器的建立时间(setup time):即 GG 做 HIGH→LOW 之前,DD 必须已稳定有效多久。

  3. 这时可将 GG 置 LOW,同时仍保持 DD 稳定有效。再经一个 tPDt_{\mathrm{PD}},让新的 GG 值传遍内部电路后,就满足了上节条件 3,此后 DD 上的跳变不再影响 QQ。
    对 DD 稳定性的这一进一步要求称为锁存器的保持时间(hold time):即 GG 跳变之后,DD 还必须继续稳定有效多久。

时序参数 英文名称 概念定义 针对的对象(作用接口与角色)
建立时间 (tSETUPt_{\mathrm{SETUP}}) Setup Time 时钟沿到达之前,数据必须保持稳定不变的最短时间。 输入端 DD(外部输入信号需满足的约束/条件)
保持时间 (tHOLDt_{\mathrm{HOLD}}) Hold Time 时钟沿到达之后,数据仍需继续保持稳定不变的最短时间。 输入端 DD(外部输入信号需满足的约束/条件)
传播延迟 (tPDt_{\mathrm{PD}}) Propagation Delay 从时钟触发沿到达起,到输出彻底稳定到最终正确逻辑状态所需的最长时间。 输出端 QQ(寄存器自身产生的物理延迟/表现)
污染延迟 (tCDt_{\mathrm{CD}}) Contamination Delay 从时钟触发沿到达起,到输出开始发生改变/受到影响所需的最短时间。 输出端 QQ(寄存器自身产生的物理延迟/表现)

建立时间与保持时间合称动态纪律(dynamic discipline),锁存器要正确工作就必须遵守。

简言之,动态纪律要求:在 GG 发生跳变的前后,DD 都必须稳定有效。只要电路设计遵守动态纪律,就能保证门控做 HIGH→LOW 时,该存储元件可靠地存下 DD 上的信息。

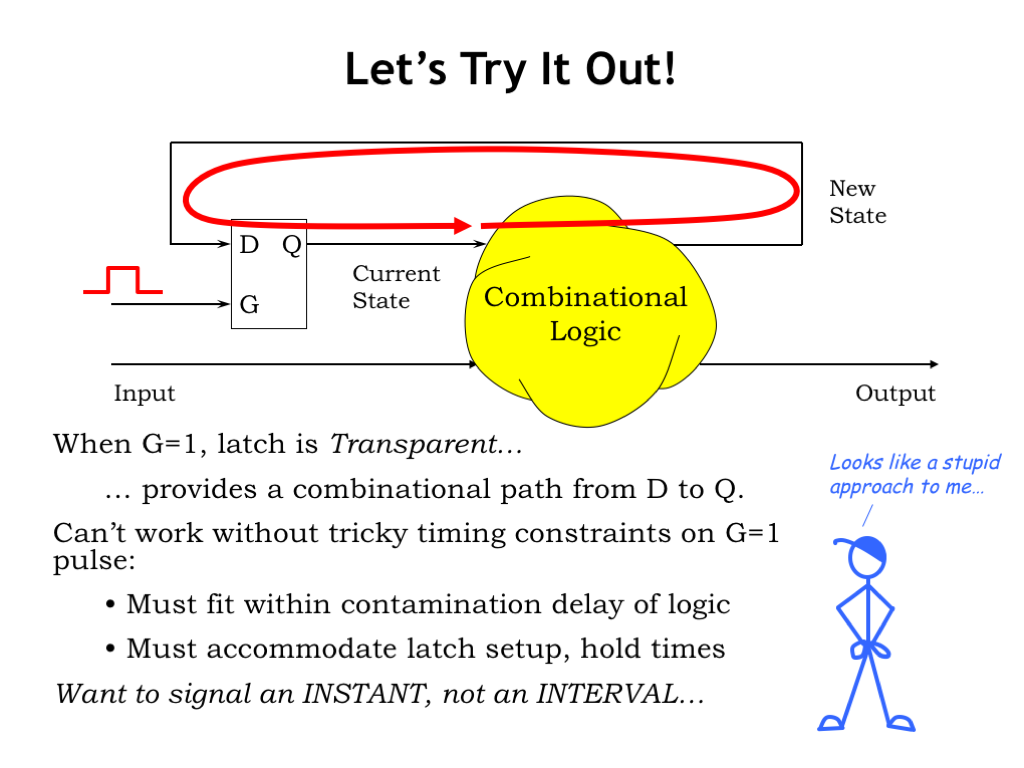
9. 试一把(Let’s Try it Out!)

Let's Try it Out

把锁存器用作时序系统的存储:打开锁存器(GG HIGH),让新状态传到 QQ(当前状态),再经组合逻辑更新下一状态。问题:GG 若 HIGH 过久,系统形成环路,新状态沿环快速变化,加载计划失败。

因此 GG 为 HIGH 的窗口既要够长以满足动态纪律,又要够短,使锁存器在新状态绕环一圈前重新关闭。精确间隔几乎无法保证——只有时序上下界,没有精确间隔。需要的是标记某一瞬间的加载信号,而不是一段时间。

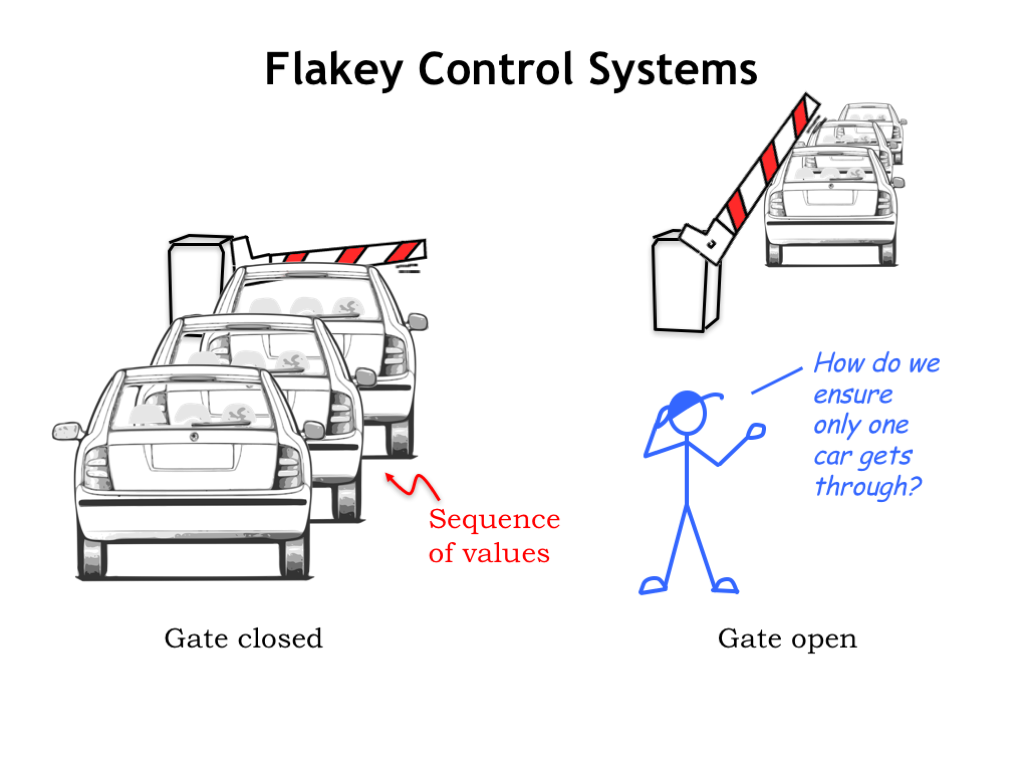
10. 不可靠的控制系统(Flakey Control Systems)

Flakey Control Systems

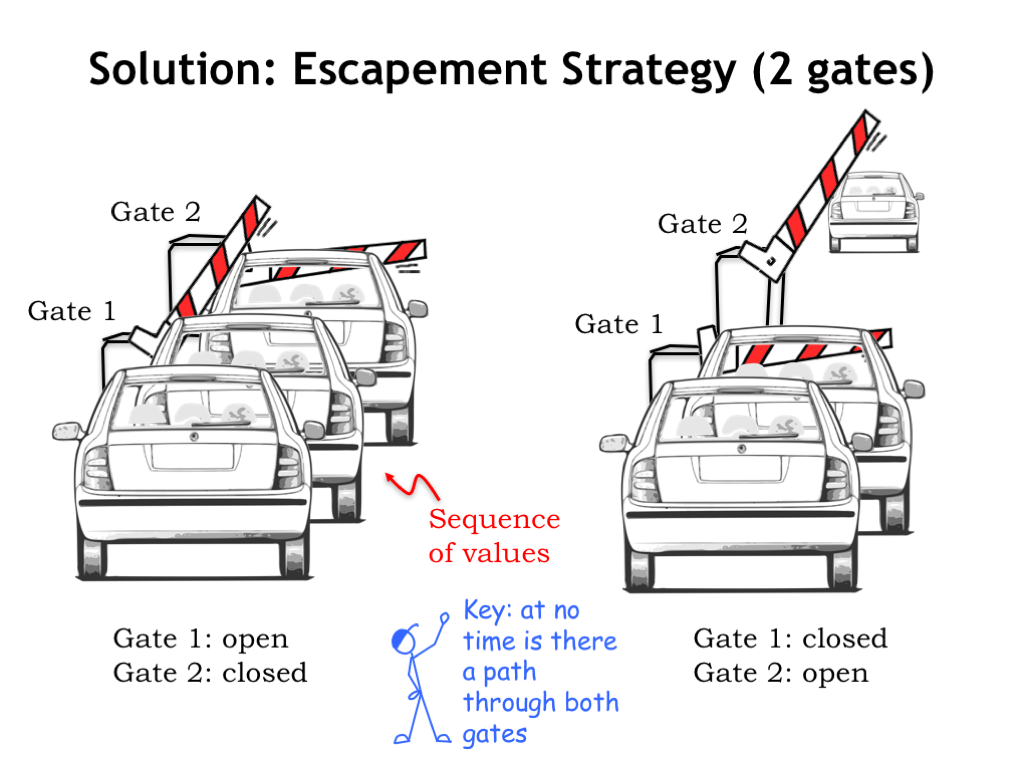
类比:收费站闸门前排队的车 = 时序逻辑中的状态序列;闸门 = 锁存器。闸门关闭时车等候;打开后第一辆驶出——但何时关闸很难:开得够久让第一辆过,又不能太久让后面的车也过。与单锁存器作存储时的问题相同。

11. 解法:擒纵策略(双闸)(Solution: Escapement Strategy (2 Gates))

Escapement Strategy Two Gates

用两道闸:起初 Gate 1 开、Gate 2 关,恰允许一辆进入;某一瞬间关 Gate 1、开 Gate 2,让站内那辆驶出,并挡住后续车辆。重复两步,逐辆处理。关键:任意时刻不存在同时穿过两道闸的通路。

这与机械钟表的擒纵机构(escapement)相同:保证发条齿轮一次只进一齿,防止整天一下子转完。观察输出:Gate 2 每次打开后不久驶出一辆;车辆按 Gate 2 打开间隔通过。把该思路用于时序逻辑的存储元件。

12. 边沿触发 D 寄存器(Edge-triggered D Register)

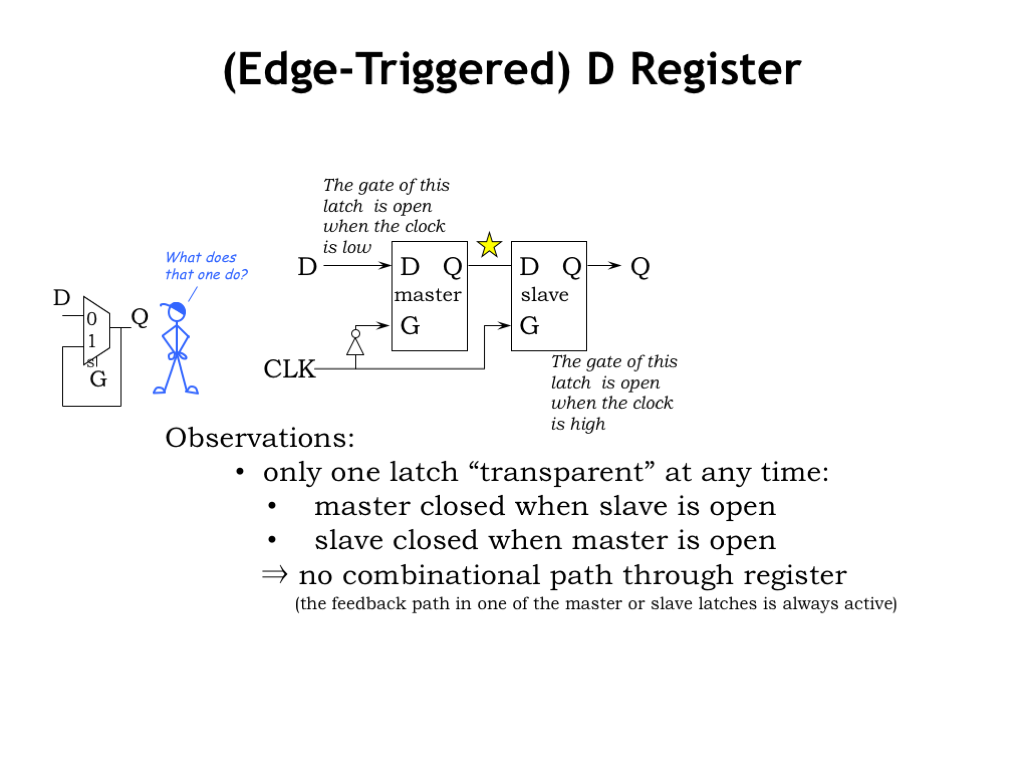
Edge-triggered D Register

用两个背靠背锁存器做 D 寄存器(D register):加载信号通常叫时钟(clock);DD/QQ 角色与锁存器相同。

从外部看,DD 接主锁存器(master),QQ 接从锁存器(slave)。时钟在进主锁存器前反相:主开则从关,反之亦然——任意时刻没有从寄存器 DD 到 QQ 的通路。

时钟反相器延迟可能会引发担心:上升沿时是否会有短暂两 Gate 都 HIGH?我们可以换用“GG LOW 时打开、GG HIGH 时关闭”类型的主锁存器,往往不必另加反相器。

因锁存器内正反馈双稳态(具有两个可以长期保持的稳定工作状态),寄存器也常被称为 flip-flop (触发器)。

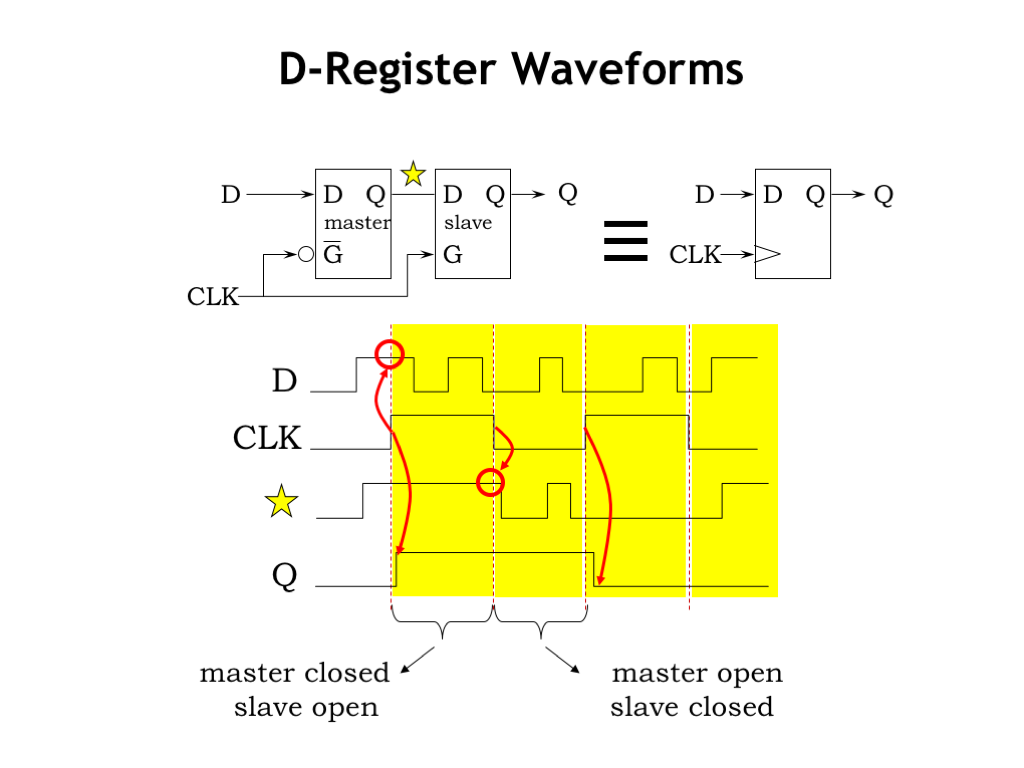
13. D 寄存器波形(D-Register Waveforms)

D-Register Waveforms

整体行为简单:时钟 0→1 上升沿采样 DD,并保持到下一上升沿;QQ 即寄存器中存的值。

时钟 LOW→HIGH 为上升沿,HIGH→LOW 为下降沿。主锁存器输出记为 STAR:

  • 上升沿:主由开→关,采样输入并进入记忆;时钟为 HIGH 期间 STAR 保持稳定。
  • 下降沿:主打开,STAR 再跟随 DD(延迟为锁存器 tPDt_{\mathrm{PD}})。

从锁存器:上升沿时打开,输出跟随 STAR;但时钟 HIGH 时主已关,STAR 稳定,故 QQ 在可能的一次跳变后也稳定。下降沿时从由开→关,采样 STAR;时钟 LOW 期间 QQ 保持稳定。

单独看 QQ:只在上升沿从锁存器打开时变化,故称正边沿触发 D 寄存器(positive-edge-triggered D register)。原理图时钟端用小三角标记。

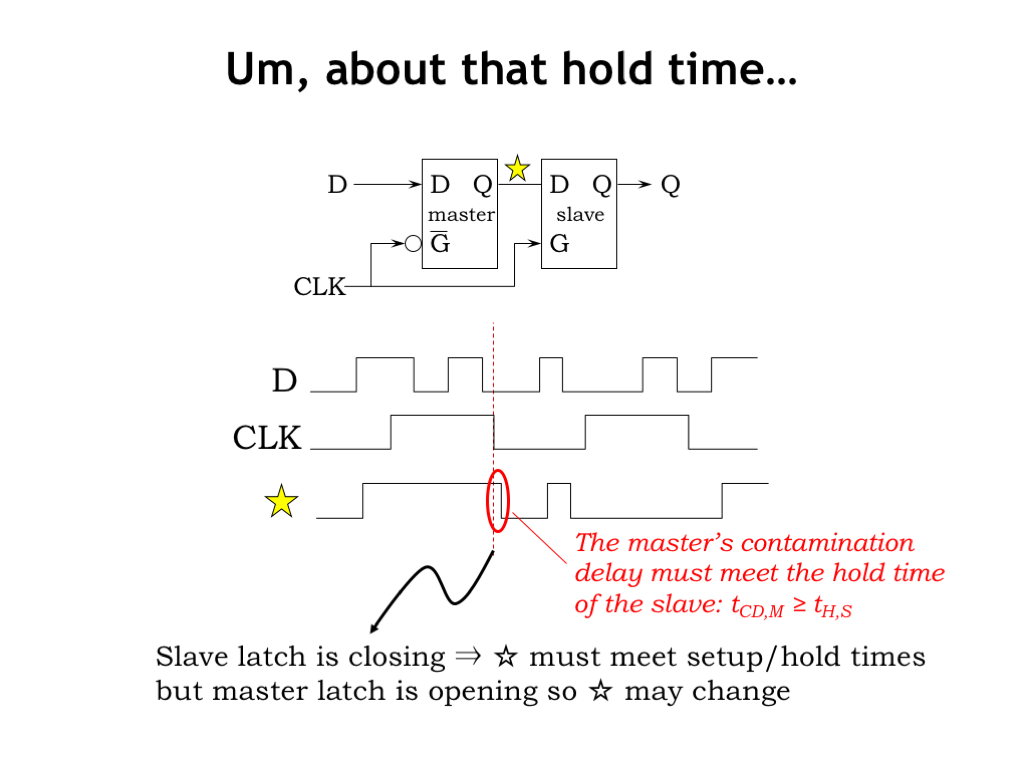
14. 关于那个保持时间…(Um, About That Hold Time…)

About That Hold Time

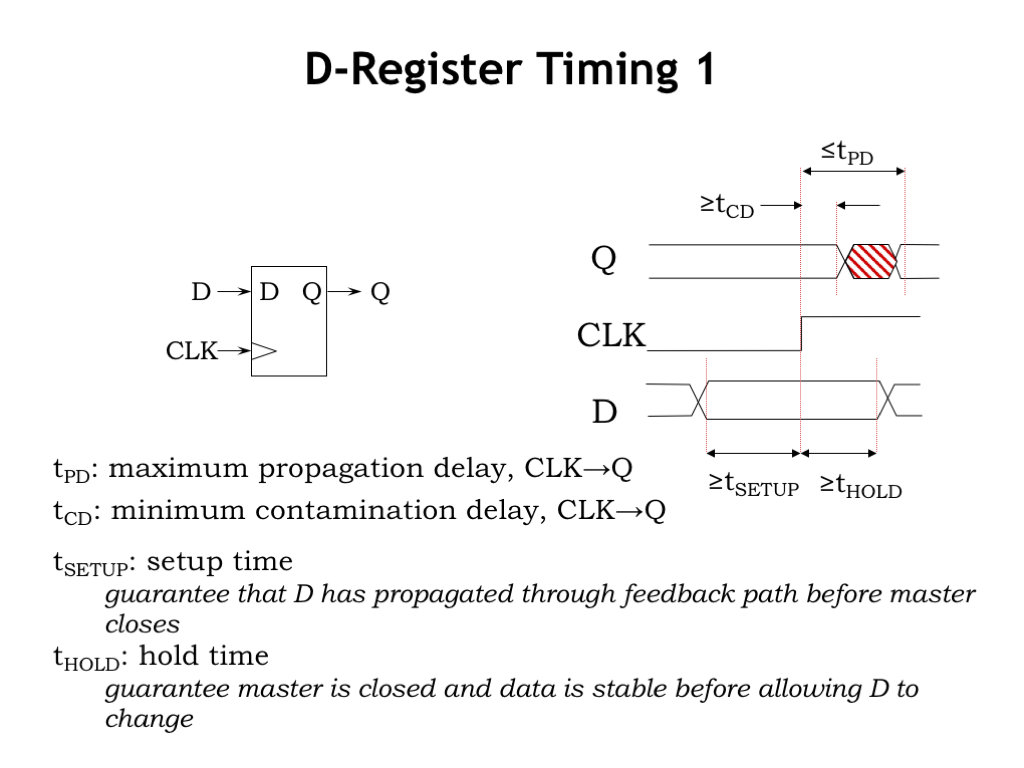
下降沿时从锁存器由开→关,其输入 STAR 必须满足从锁存器的建立/保持时间。麻烦在于:主同时打开,STAR 可能在时钟边沿后很快变化。主的污染延迟 tCDt_{\mathrm{CD}} 告诉我们其输出旧值在下降沿后还能稳多久;从的保持时间告诉我们边沿后其输入还须稳多久。

正确工作要求:主的 tCDt_{\mathrm{CD}} ≥\ge 从的保持时间。分析须考虑工艺偏差、温度、电源等。必要时可在主从之间加额外门延迟(如两级反相器)增大相对下降沿的污染延迟。从锁存器保持时间问题只能靠改电路设计解决。

15. D 寄存器时序(D-Register Timing)

D-Register Timing

D 寄存器时序规格小结:

  • tPDt_{\mathrm{PD}}:上升沿后,QQ 变为有效稳定的上界
  • tCDt_{\mathrm{CD}}:上升沿后,旧 QQ 仍保持有效的下界

二者均相对时钟上升沿度量。寄存器设计为宽容:若新旧 QQ 相同,上升沿期间 QQ 稳定性有保证——tCDt_{\mathrm{CD}}/tPDt_{\mathrm{PD}} 仅在 QQ 实际变化时适用。

为保证主锁存器正确,DD 须满足主的建立/保持:

  • tSETUPt_{\mathrm{SETUP}}:上升沿前 DD 须有效稳定多久
  • tHOLDt_{\mathrm{HOLD}}:上升沿后 DD 须再保持多久

使用厂商库中的 D 寄存器时,要从数据手册查这四个参数,再分析整电路时序。

16. 单时钟同步电路(Single-clock Synchronous Circuits)

Single-clock Synchronous Circuits

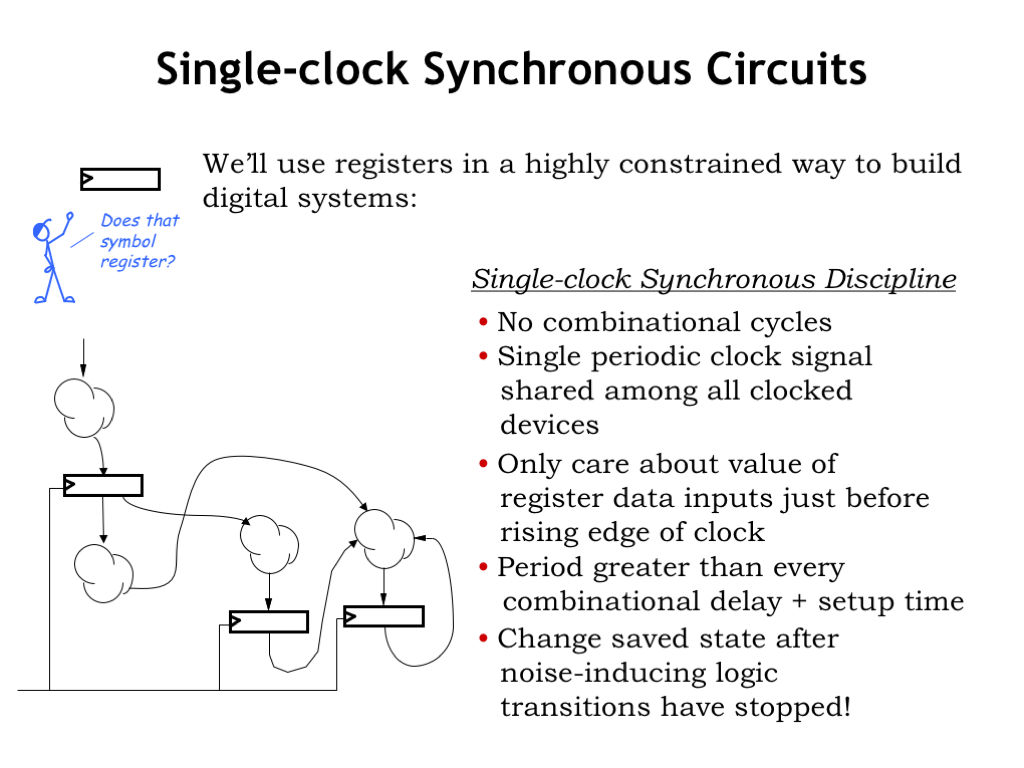
6.004 中使用寄存器的约定称为单时钟同步纪律(single-clock synchronous discipline):

上图左边的电路中,带边沿触发的符号的方形表示寄存器,小云朵表示组合逻辑电路。

  • 寄存器输入到输出无组合通路,整个电路无组合环。换句话说,从系统输入和寄存器输出到寄存器输入的路径不会两次经过同一组合块。
  • 所有时钟器件共享同一周期时钟。使用多时钟域也可以,但跨域时序很难分析,同钟更简单。
  • 各数据信号何时变化大体不重要;关键是接到寄存器输入的信号稳定够久以满足建立时间,并保持够久以满足保持时间。

选时钟周期大于“寄存器输出 → 寄存器输入”每条路径的 tPDt_{\mathrm{PD}} 再加上建立时间,即可保证遵守动态纪律:

tCLK>tPD,path+tSETUPt_{\mathrm{CLK}} > t_{\mathrm{PD,path}} + t_{\mathrm{SETUP}}

额外好处:按这种方式选时钟周期后,上升沿瞬间电路中没有其它会引入噪声的逻辑跳变,因而更新各寄存器存储状态时不应有噪声问题。[3]

17. 单时钟系统中的时序(Timing in a Single-clock System)

Timing in a Single-clock System

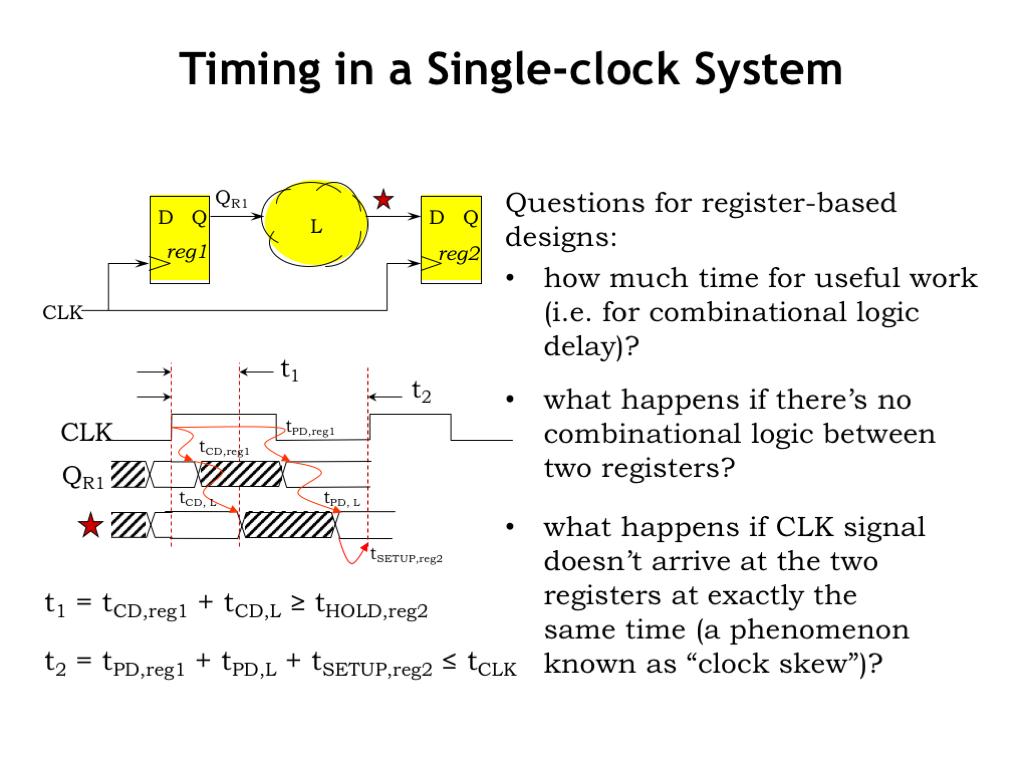
分析某条路径:上游寄存器 → 组合逻辑 → 下游寄存器(逻辑输出记 STAR)。大系统有多条路径,须逐条分析以找出决定最小可用时钟周期的路径(CAD 工具常代劳)。

上升沿触发上游寄存器:QR1Q_{\mathrm{R1}} 在至少 tCD,REG1t_{\mathrm{CD,REG1}} 内保持旧值,并在 tPD,REG1t_{\mathrm{PD,REG1}} 前达到新稳定值,直至下一上升沿。组合逻辑的 tCDt_{\mathrm{CD}}/tPDt_{\mathrm{PD}} 再决定 STAR 最早失效与最晚稳定的时刻。

对下游 REG2:

  • t1t_1 = REG1 的 tCDt_{\mathrm{CD}} + 组合逻辑的 tCDt_{\mathrm{CD}}:上升沿后 STAR 仍有效多久;须 t1≥t_1 \ge REG2 的保持时间。
  • t2t_2 = REG1 的 tPDt_{\mathrm{PD}} + 组合逻辑的 tPDt_{\mathrm{PD}} + REG2 的建立时间:下一上升沿最早允许发生的时刻;须 t2≤tCLKt_2 \le t_{\mathrm{CLK}}(时钟周期)。过早则违反 REG2 动态纪律。

每条寄存器到寄存器路径都须满足这两个不等式。tCLKt_{\mathrm{CLK}} 不等式中,上游 tPDt_{\mathrm{PD}} 与下游建立时间从可用于“有用逻辑工作”的时间里抠掉,故设计者倾向选用这两项更小的寄存器。

若上下游之间没有组合逻辑(移位寄存器、数字延迟线等),第一不等式要求上游 tCD≥t_{\mathrm{CD}} \ge 下游保持时间;实践中污染延迟常小于保持时间,往往要插入哑逻辑(如两级反相器)制造足够 tCDt_{\mathrm{CD}}。

还须考虑时钟偏斜(clock skew):因为时钟信号到达不同寄存器存在“时间差”(即时钟偏斜),为了确保数据不报错,下游寄存器不得不预留更宽裕的“稳定观察期”(即增加了等效的建立时间和保持时间)。

时钟周期 tCLKt_{\mathrm{CLK}} 刻画了系统性能。Intel 等按不同时钟频率卖处理器,例如 1.7 GHz 与 2 GHz。这些芯片有何不同?其实没有:制造工艺波动使部分芯片的 tPDt_{\mathrm{PD}} 更好;逻辑 tPDt_{\mathrm{PD}} 更小,就可取更小 tCLKt_{\mathrm{CLK}}、更高频率。同一设计量产许多颗,测 tPDt_{\mathrm{PD}} 后把快的挑出来当更高性能档卖——这是芯片生意挣钱的秘诀。

18. 模型:离散时间(Model: Discrete Time)

Model Discrete Time

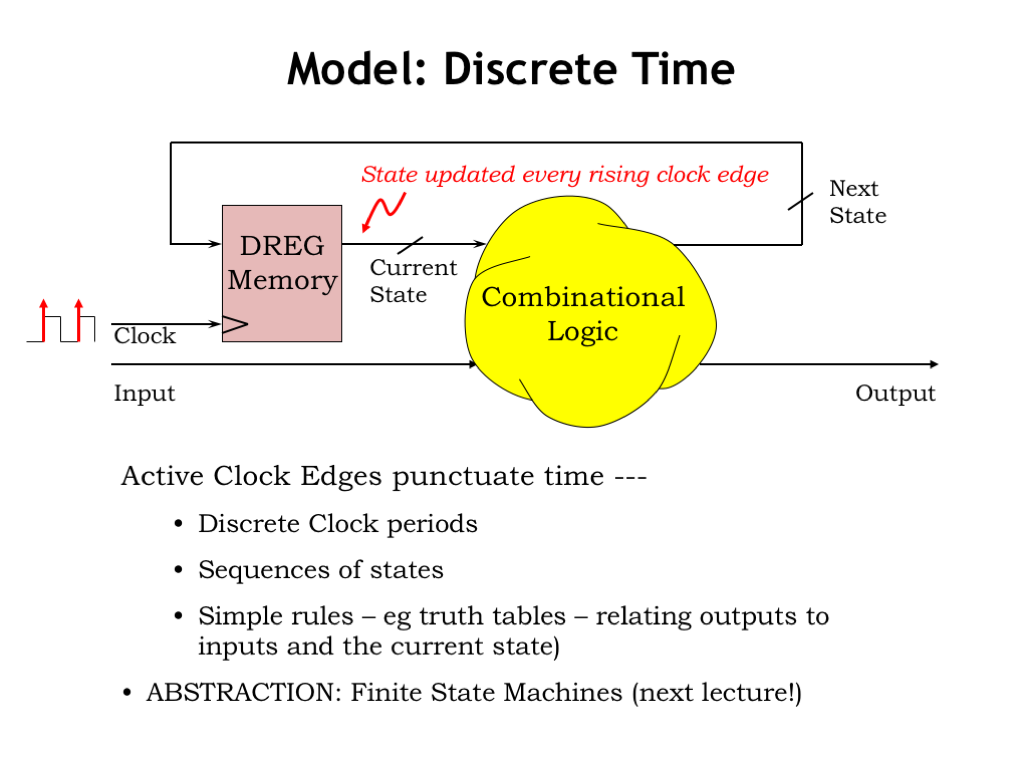
用 D 寄存器作时序系统的存储很合适:每个时钟上升沿加载下一状态,在余下时钟周期内作为当前状态出现在输出。组合逻辑用当前状态与输入计算下一状态与输出。一串上升沿与输入产生状态序列,进而产生输出序列。下一章引入有限状态机(finite state machine)抽象,便于设计时序系统。

19. 时序电路时序分析(Sequential Circuit Timing)

Sequential Circuit Timing

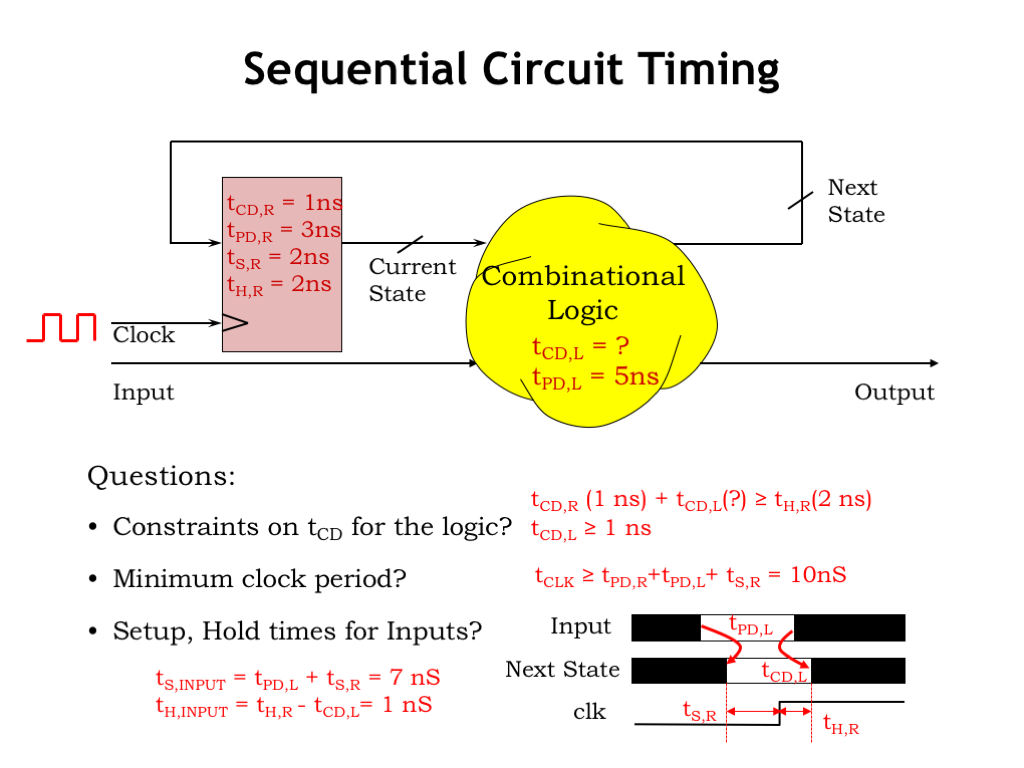
对图示时序系统套用上述分析(寄存器与组合逻辑时序参数如图):

  • 组合逻辑 tCDt_{\mathrm{CD}} 未给:要正确工作,寄存器与逻辑的 tCDt_{\mathrm{CD}} 之和须 ≥\ge 寄存器保持时间 → 逻辑 tCDt_{\mathrm{CD}} 至少 1 ns。
  • 最小 tCLKt_{\mathrm{CLK}}:须大于寄存器与逻辑的 tPDt_{\mathrm{PD}} 之和再加上建立时间 → 最小时钟周期 10 ns。
  • 相对上升沿,Input 的建立时间 = 逻辑 tPDt_{\mathrm{PD}} + 寄存器建立时间 = 7 ns;保持时间 = 寄存器保持时间 − 逻辑 tCDt_{\mathrm{CD}} = 1 ns(换句话说,如果 Input 在时钟上升沿后保持至少 1 ns,那么 Next State 就能在时钟上升沿后保持至少 2 ns)。这样 Next State 才能分别满足寄存器的建立/保持。

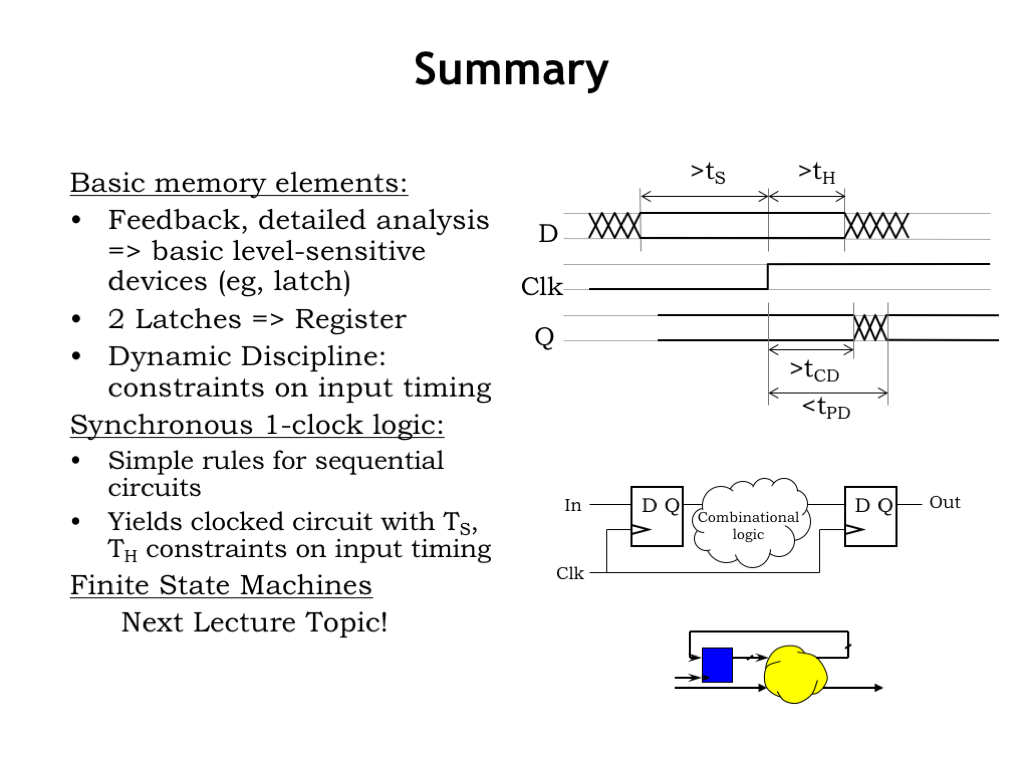
20. 小结(Summary)

Summary

本讲完成时序逻辑入门:几乎所有数字系统都是时序系统,并遵守动态纪律施加的时序约束。下次看到 “1.7 GHz 处理器” 广告,就知道 “1.7” 从何而来。


  1. 译者注:模拟电子电路(analog electronics)主要指以下几个关键的模拟电路组件和机制:

    • 敏感放大器(Sense Amplifier):

      • 在读取电容存储的数据时,电容释放或吸收的电荷极少,只能导致位线(Bit line)产生非常微小的电压变化(远未达到标准数字电路的 0 或 1 电平)。
      • 需要专门设计的高灵敏度模拟放大器来检测这一微弱的连续电压差,并将其放大还原为标准的数字逻辑电平(逻辑 0 或逻辑 1)。
    • 微小电荷与连续电压的处理(Charge Sharing & Leakage Control):

      • 电容上的电荷存储和衰减(泄漏)、位线上的电荷共享(Charge sharing)都是连续变化的模拟物理过程,而非瞬间完成的离散数字状态。
      • 电路需要精准控制 NFET 晶体管开关的导通电阻、阈值电压以及微小的泄漏电流(Leakage current),这些器件特性的设计和优化都属于模拟电路设计的范畴。
    ↩︎
  2. 译者注:上文门控信号 GG(即后文的 CLK)在 CMOS 中接到钟控反相器或传输门的栅极。以下给出两种基本单元与完整 D 锁存器电路,展示 CLK 接到 MOS 管的哪个端点。电路图由 Schemdraw 绘制(也可参考我的另一篇文章「Schemdraw 绘制 IC 原理图」)。

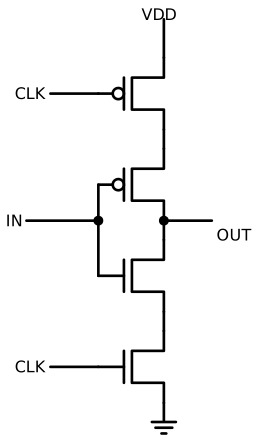
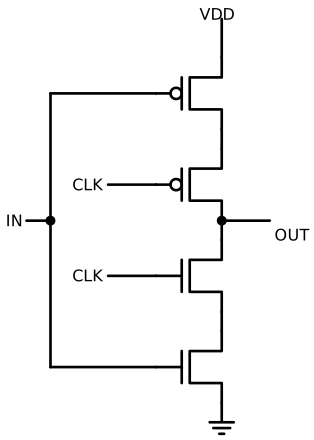
    钟控反相器(Clocked Inverter) 标准 CMOS 反相器各串一个时钟管,CLK/CLK̄ 接到时钟管的栅极。CLK=HIGH 时反相器正常工作;CLK=LOW 时输出高阻(floating)。有两种常见串联顺序:

    钟控反相器实现一 钟控反相器实现二
    钟控反相器实现一:时钟管在外侧 钟控反相器实现二:时钟管在中间
    Schemdraw 绘图代码:钟控反相器实现一
    05-seq-clk-inv-01.pyview raw
    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    28
    29
    30
    31
    32
    33
    34
    35
    36
    37
    38
    39
    40
    41
    import schemdraw
    import schemdraw.elements as elm

    # 钟控反相器实现一:时钟管在外侧
    # 栈序(上→下):MP_clk(CLK̄) → MP_in(IN) → [OUT] → MN_in(IN) → MN_clk(CLK)

    with schemdraw.Drawing() as d:
    d.config(fontsize=12, color='black', bgcolor='white')

    MP_clk = d.add(elm.PFet().right().reverse())
    d.add(elm.Line().down().at(MP_clk.drain).length(0.4))
    MP_in = d.add(elm.PFet().right().reverse().anchor('source'))
    d.add(elm.Line().down().at(MP_in.drain).length(0.4))
    MN_in = d.add(elm.NFet().right().reverse().anchor('drain'))
    d.add(elm.Line().down().at(MN_in.source).length(0.4))
    MN_clk = d.add(elm.NFet().right().reverse().anchor('drain'))

    d.add(elm.Line().up().at(MP_clk.source).length(0.8))
    d.add(elm.Label().label('VDD'))
    d.add(elm.Ground().at(MN_clk.source))

    # OUT 节点
    d.add(elm.Dot().at(MP_in.drain))
    d.add(elm.Line().right().at(MP_in.drain).length(1).label('OUT', loc='end'))
    out_y = float(MP_in.drain[1]) # OUT 所在的 y 坐标

    # 时钟管栅极
    d.add(elm.Line().left().at(MP_clk.gate).length(1)
    .label(r'$\overline{CLK}$', loc='left'))
    d.add(elm.Line().left().at(MN_clk.gate).length(1)
    .label('CLK', loc='left'))

    # IN 栅极:竖线连接 MP_in.gate → MN_in.gate,
    # 在与 OUT 同高处(out_y)打圆点并引出 IN 标签,使 IN 与 OUT 同水平
    d.add(elm.Line().at(MP_in.gate).to(MN_in.gate))
    gate_x = float(MP_in.gate[0])
    d.add(elm.Dot().at((gate_x, out_y)))
    d.add(elm.Line().left().at((gate_x, out_y)).length(1.5)
    .label('IN', loc='left'))

    d.save('05-seq-clk-inv-01.svg')
    Schemdraw 绘图代码:钟控反相器实现二
    05-seq-clk-inv-02.pyview raw
    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    28
    29
    30
    31
    32
    33
    34
    35
    36
    37
    38
    39
    40
    41
    42
    43
    44
    45
    46
    47
    48
    49
    50
    51
    import schemdraw
    import schemdraw.elements as elm

    # 钟控反相器实现二:时钟管在中间
    # 栈序(上→下):MP_in(IN) → MP_clk(CLK̄) → [OUT] → MN_clk(CLK) → MN_in(IN)

    with schemdraw.Drawing() as d:
    d.config(fontsize=12, color='black', bgcolor='white')

    MP_in = d.add(elm.PFet().right().reverse())
    d.add(elm.Line().down().at(MP_in.drain).length(0.4))
    MP_clk = d.add(elm.PFet().right().reverse().anchor('source'))
    d.add(elm.Line().down().at(MP_clk.drain).length(0.4))
    MN_clk = d.add(elm.NFet().right().reverse().anchor('drain'))
    d.add(elm.Line().down().at(MN_clk.source).length(0.4))
    MN_in = d.add(elm.NFet().right().reverse().anchor('drain'))

    d.add(elm.Line().up().at(MP_in.source).length(0.8))
    d.add(elm.Label().label('VDD'))
    d.add(elm.Ground().at(MN_in.source))

    # OUT 节点
    d.add(elm.Dot().at(MP_clk.drain))
    d.add(elm.Line().right().at(MP_clk.drain).length(1).label('OUT', loc='end'))
    out_y = float(MP_clk.drain[1]) # OUT 所在的 y 坐标,IN 也将对齐到此高度

    # CLK 管栅极(中层,较短连线居左)
    d.add(elm.Line().left().at(MP_clk.gate).length(1.0)
    .label(r'$\overline{CLK}$', loc='left'))
    d.add(elm.Line().left().at(MN_clk.gate).length(1.0)
    .label('CLK', loc='left'))

    # IN 管栅极:顶(MP_in.gate)和底(MN_in.gate)需绕过中层 CLK 管
    # 向左延伸至 in_far_x,用垂直线连接两栅,
    # 在与 OUT 同高处(out_y)打圆点并引出 IN 标签
    gate_x = float(MP_in.gate[0])
    in_far_x = gate_x - 2.2

    d.add(elm.Line().left().at(MP_in.gate)
    .to((in_far_x, float(MP_in.gate[1]))))
    d.add(elm.Line().down().at((in_far_x, float(MP_in.gate[1])))
    .to((in_far_x, float(MN_in.gate[1]))))
    d.add(elm.Line().right().at((in_far_x, float(MN_in.gate[1])))
    .to(MN_in.gate))

    # IN 引出点与 OUT 同高
    d.add(elm.Dot().at((in_far_x, out_y)))
    d.add(elm.Line().left().at((in_far_x, out_y)).length(0.5)
    .label('IN', loc='left'))

    d.save('05-seq-clk-inv-02.svg')

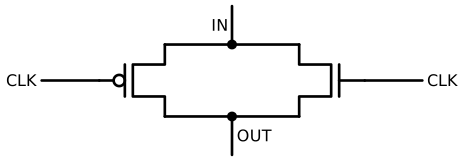
    传输门(Transmission Gate) NFET(栅 = CLK)与 PFET(栅 = CLK‾\overline{\text{CLK}})并联。CLK=HIGH 时双向导通(无阈值损失);CLK=LOW 时断开。

    传输门

    Schemdraw 绘图代码:传输门
    05-seq-tg-01.pyview raw
    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    28
    29
    30
    31
    32
    33
    34
    35
    36
    37
    38
    import schemdraw
    import schemdraw.elements as elm

    with schemdraw.Drawing() as d:
    d.config(fontsize=12, color='black', bgcolor='white')

    # PFET(左侧):source=上(IN),drain=下(OUT),gate=左(CLK̄)
    MP = d.add(elm.PFet().right().reverse())

    # NFET(右侧):drain=上(IN),source=下(OUT),gate=右(CLK)
    # 以 drain 为入笔锚点,使 drain 与 MP.source 等高
    MN = d.add(
    elm.NFet().right()
    .at((MP.source[0] + 2.8, MP.source[1]))
    .anchor('drain')
    )

    # IN 横线(顶部):MP.source → MN.drain
    d.add(elm.Line().at(MP.source).to(MN.drain))
    in_x = (MP.source[0] + MN.drain[0]) / 2
    in_y = float(MP.source[1])
    d.add(elm.Dot().at((in_x, in_y)))
    d.add(elm.Line().up().at((in_x, in_y)).length(0.8).label('IN', loc='top'))

    # OUT 横线(底部):MP.drain → MN.source
    d.add(elm.Line().at(MP.drain).to(MN.source))
    out_x = (MP.drain[0] + MN.source[0]) / 2
    out_y = float(MP.drain[1])
    d.add(elm.Dot().at((out_x, out_y)))
    d.add(elm.Line().down().at((out_x, out_y)).length(0.8).label('OUT', loc='bot'))

    # 栅极标签
    d.add(elm.Line().left().at(MP.gate).length(1.2)
    .label(r'$\overline{CLK}$', loc='left'))
    d.add(elm.Line().right().at(MN.gate).length(1.2)
    .label('CLK', loc='right'))

    d.save('05-seq-tg-01.svg')

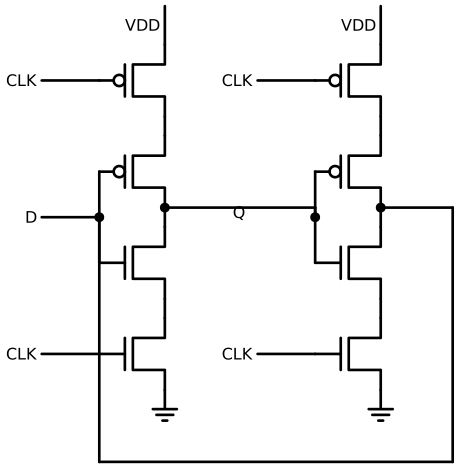
    D 锁存器(双钟控反相器) CI1(CLK=HIGH 导通)将 D 反相至 Q‾\overline{Q};CI2(CLK=LOW 导通)将 Q‾\overline{Q} 反相反馈回 D 节点,构成保持环。

    D 锁存器

    Schemdraw 绘图代码:D 锁存器
    05-seq-dlatch-01.pyview raw
    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    28
    29
    30
    31
    32
    33
    34
    35
    36
    37
    38
    39
    40
    41
    42
    43
    44
    45
    46
    47
    48
    49
    50
    51
    52
    53
    54
    55
    56
    57
    58
    59
    60
    61
    62
    63
    64
    65
    66
    67
    68
    69
    70
    71
    72
    73
    74
    75
    76
    77
    78
    79
    80
    81
    82
    83
    84
    85
    86
    87
    88
    89
    90
    91
    92
    93
    94
    95
    import schemdraw
    import schemdraw.elements as elm

    # D 锁存器:两个背靠背钟控反相器(2×4 管)
    # CI1(CLK=HIGH 时导通):D → Q̄
    # CI2(CLK=LOW 时导通):Q̄ → D(正反馈保持状态)

    with schemdraw.Drawing() as d:
    d.config(fontsize=12, color='black', bgcolor='white')

    # ── CI1 ──────────────────────────────────────────────
    MP_clk1 = d.add(elm.PFet().right().reverse())
    d.add(elm.Line().down().at(MP_clk1.drain).length(0.4))
    MP_in1 = d.add(elm.PFet().right().reverse().anchor('source'))
    d.add(elm.Line().down().at(MP_in1.drain).length(0.4))
    MN_in1 = d.add(elm.NFet().right().reverse().anchor('drain'))
    d.add(elm.Line().down().at(MN_in1.source).length(0.4))
    MN_clk1 = d.add(elm.NFet().right().reverse().anchor('drain'))

    d.add(elm.Line().up().at(MP_clk1.source).length(0.8).label('VDD', loc='top'))
    d.add(elm.Ground().at(MN_clk1.source))

    # CI1 输入门(D 节点)
    d.add(elm.Line().at(MP_in1.gate).to(MN_in1.gate))
    d_mid = 0.5 * (MP_in1.gate + MN_in1.gate)
    d.add(elm.Dot().at(d_mid))
    d.add(elm.Line().left().at(d_mid).length(1.2).label('D', loc='left'))

    # CI1 时钟管标签
    d.add(elm.Line().left().at(MP_clk1.gate).length(1.2)
    .label(r'$\overline{CLK}$', loc='left'))
    d.add(elm.Line().left().at(MN_clk1.gate).length(1.2)
    .label('CLK', loc='left'))

    # CI1 输出节点(Q̄)
    d.add(elm.Dot().at(MP_in1.drain))

    # ── CI2 ──────────────────────────────────────────────
    x2 = float(MP_clk1.source[0]) + 4.5
    y2 = float(MP_clk1.source[1])

    MP_clk2 = d.add(elm.PFet().right().reverse().at((x2, y2)))
    d.add(elm.Line().down().at(MP_clk2.drain).length(0.4))
    MP_in2 = d.add(elm.PFet().right().reverse().anchor('source'))
    d.add(elm.Line().down().at(MP_in2.drain).length(0.4))
    MN_in2 = d.add(elm.NFet().right().reverse().anchor('drain'))
    d.add(elm.Line().down().at(MN_in2.source).length(0.4))
    MN_clk2 = d.add(elm.NFet().right().reverse().anchor('drain'))

    d.add(elm.Line().up().at(MP_clk2.source).length(0.8).label('VDD', loc='top'))
    d.add(elm.Ground().at(MN_clk2.source))

    # CI2 输入门(Q̄ 节点)
    d.add(elm.Line().at(MP_in2.gate).to(MN_in2.gate))
    qbar_gate = 0.5 * (MP_in2.gate + MN_in2.gate)
    d.add(elm.Dot().at(qbar_gate))

    # CI2 时钟管标签(CLK/CLK̄ 互换)
    d.add(elm.Line().left().at(MP_clk2.gate).length(1.2)
    .label('CLK', loc='left'))
    d.add(elm.Line().left().at(MN_clk2.gate).length(1.2)
    .label(r'$\overline{CLK}$', loc='left'))

    # CI2 输出节点(反馈至 D)
    d.add(elm.Dot().at(MP_in2.drain))

    # ── CI1 输出 → CI2 输入(Q̄ 连线)──────────────────
    ci1_out = MP_in1.drain
    qbar_gate_x = float(qbar_gate[0])
    qbar_gate_y = float(qbar_gate[1])
    ci1_out_y = float(ci1_out[1])

    # 水平段
    d.add(elm.Line().right().at(ci1_out)
    .to((qbar_gate_x, ci1_out_y)))
    # 垂直修正段(如不对齐)
    if abs(ci1_out_y - qbar_gate_y) > 0.05:
    d.add(elm.Line().at((qbar_gate_x, ci1_out_y)).to(qbar_gate))

    # Q̄ 标签
    qbar_label_x = (float(ci1_out[0]) + qbar_gate_x) / 2
    d.add(elm.Label().at((qbar_label_x, ci1_out_y))
    .label(r'$\overline{Q}$', loc='top'))

    # ── CI2 输出 → D 节点(正反馈连线)────────────────
    ci2_out = MP_in2.drain
    fb_x = float(ci2_out[0]) + 1.5
    fb_y = float(MN_clk2.source[1]) - 1.5

    d.add(elm.Line().right().at(ci2_out).length(1.5))
    d.add(elm.Line().down().at((fb_x, float(ci2_out[1]))).to((fb_x, fb_y)))
    d.add(elm.Line().left().at((fb_x, fb_y)).to((float(d_mid[0]), fb_y)))
    d.add(elm.Line().up().at((float(d_mid[0]), fb_y)).to(d_mid))

    d.save('05-seq-dlatch-01.svg')
    ↩︎
  3. 译者注:这句话点出单时钟同步电路(single-clock synchronous system)的一个精妙优势——通过合理控制时钟周期,把电路噪声与状态更新彻底“解耦”(错开)。可从三层理解:

    1. 逻辑翻转是电路噪声的主要来源。 CMOS 中信号 0↔1(逻辑翻转/过渡)会产生瞬时大电流(充放电电流及导通短路电流)。电流突变导致电源电压波动(电源噪声 / ground bounce),也会经寄生电容干扰邻近信号线(串扰 crosstalk)。

    2. “按这种方式选择时钟周期”做了什么。 指将 TCLKT_{\mathrm{CLK}} 设得足够长:

      TCLK≥tPD,reg+tPD,comb+tsetupT_{\mathrm{CLK}} \ge t_{\mathrm{PD,reg}} + t_{\mathrm{PD,comb}} + t_{\mathrm{setup}}

      从而保证:上一上升沿触发后,组合逻辑里所有“中间过渡与信号震荡/翻转”(noise-inducing logic transitions)都有足够时间完全停止并稳定下来。

    3. 为何上升沿到来时没有噪声问题。 下一时钟上升沿触发寄存器锁存/更新新状态的那一瞬,组合逻辑已“静止”很久,没有线缆在发生信号翻转。电路内部没有其它翻转带来的电源噪声或串扰,寄存器可在安静环境下精准采样并写入新状态,稳定性与可靠性更高。

    形象比喻:组合逻辑计算像拍集体照前大家调整姿势、换位置(杂乱动作与噪音);足够长的时钟周期是给所有人留足时间站好不动。上升沿(快门按下)到来时所有人都已静止,拍出的照片(采样写入的数据)不会有模糊或重影(噪声干扰)。 ↩︎